Mathématiques en BCPST 2
13 chapitres, dans l'ordre du programme : cours, vidéos et exercices corrigés, gratuits au départ.
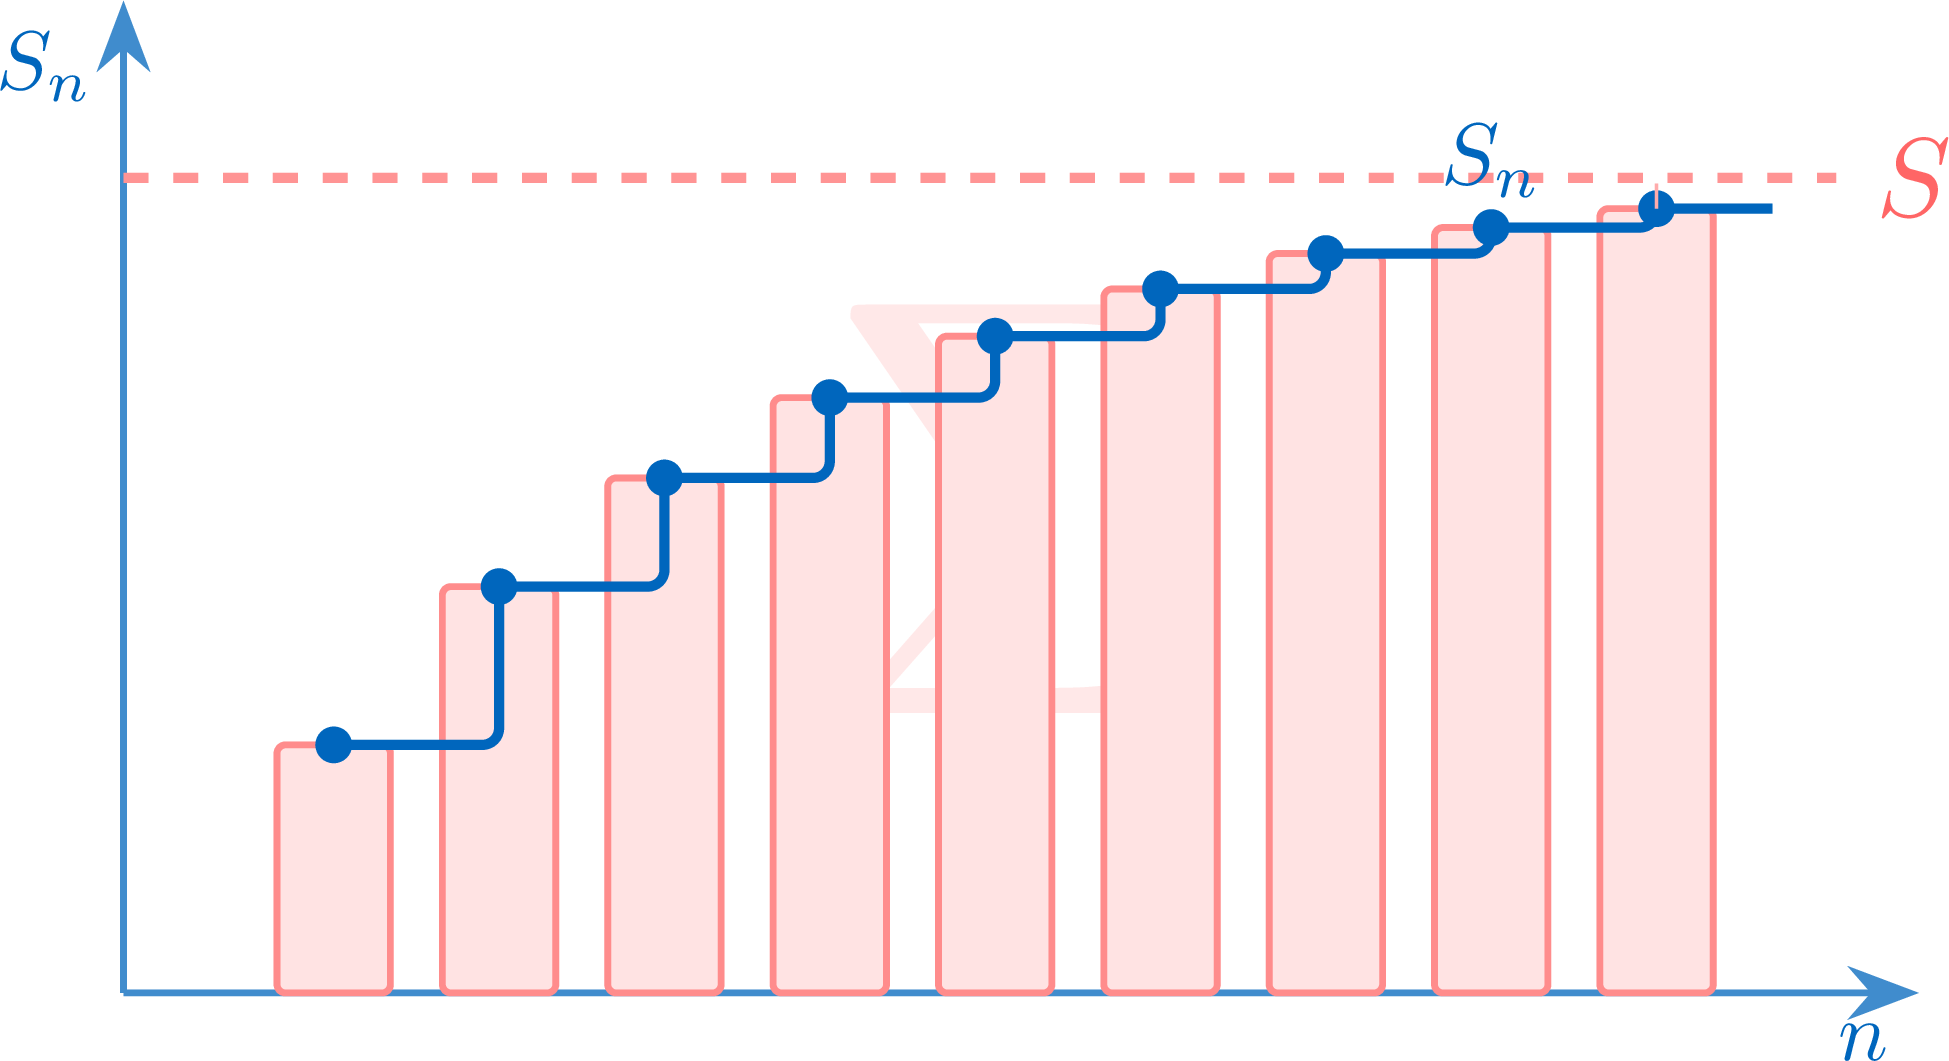
Séries réelles
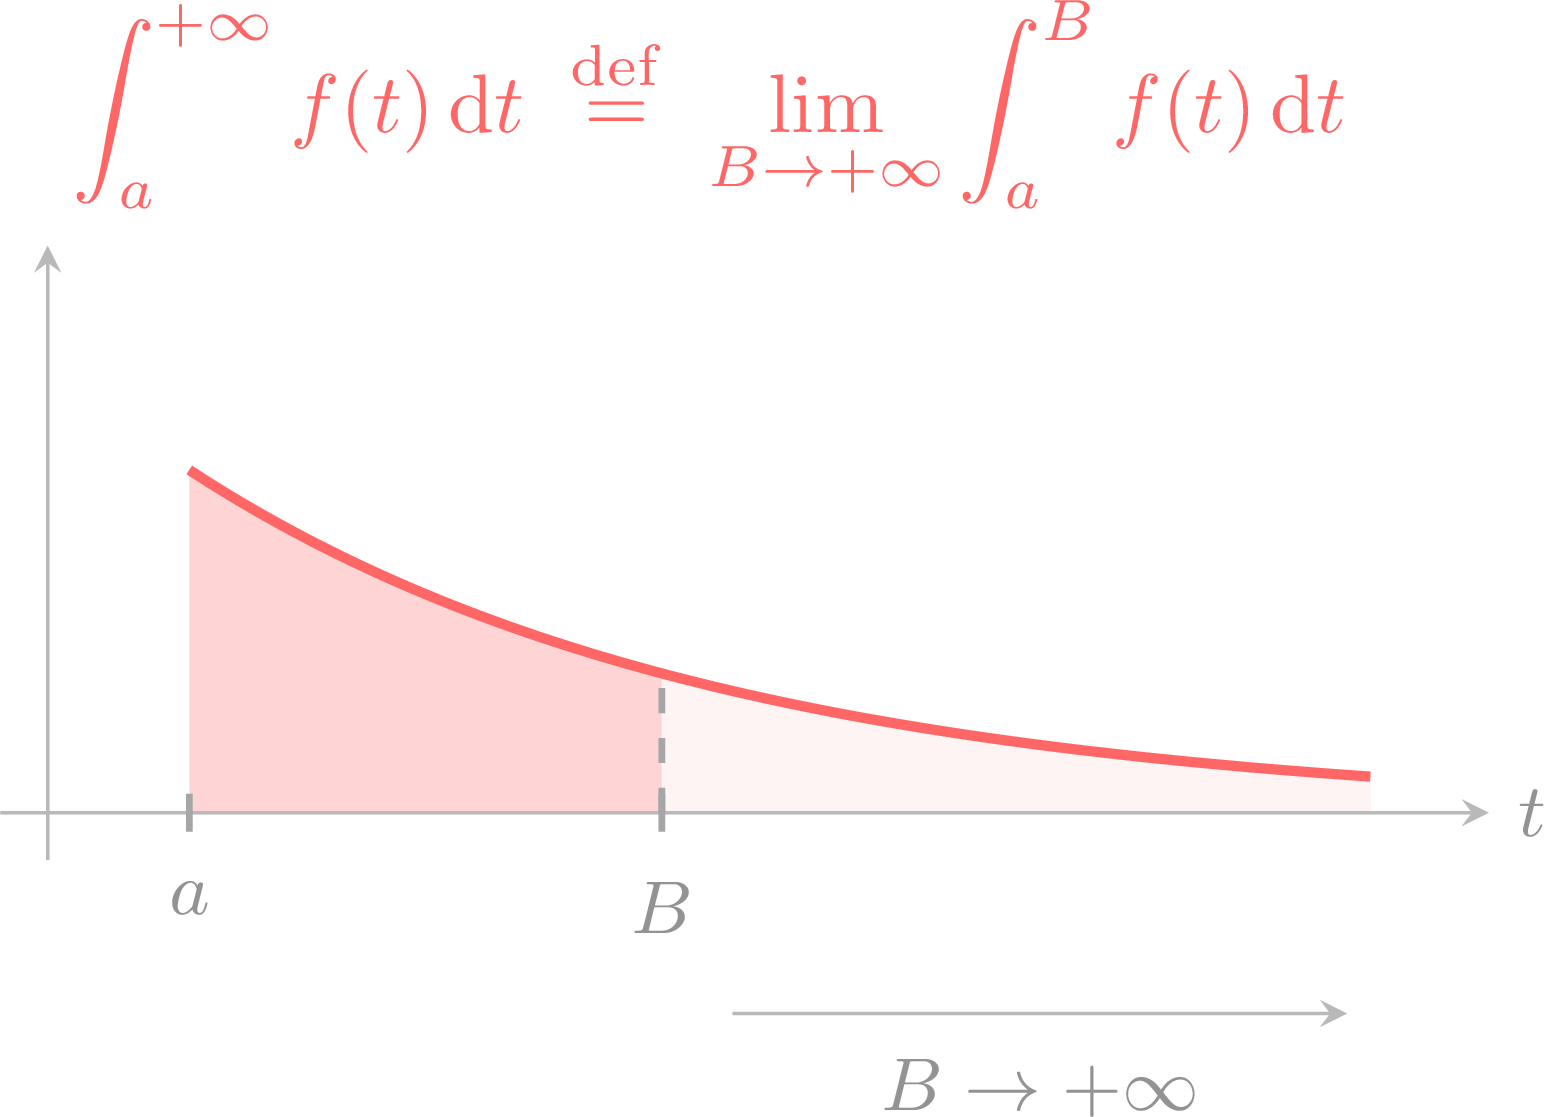
Intégrales généralisées
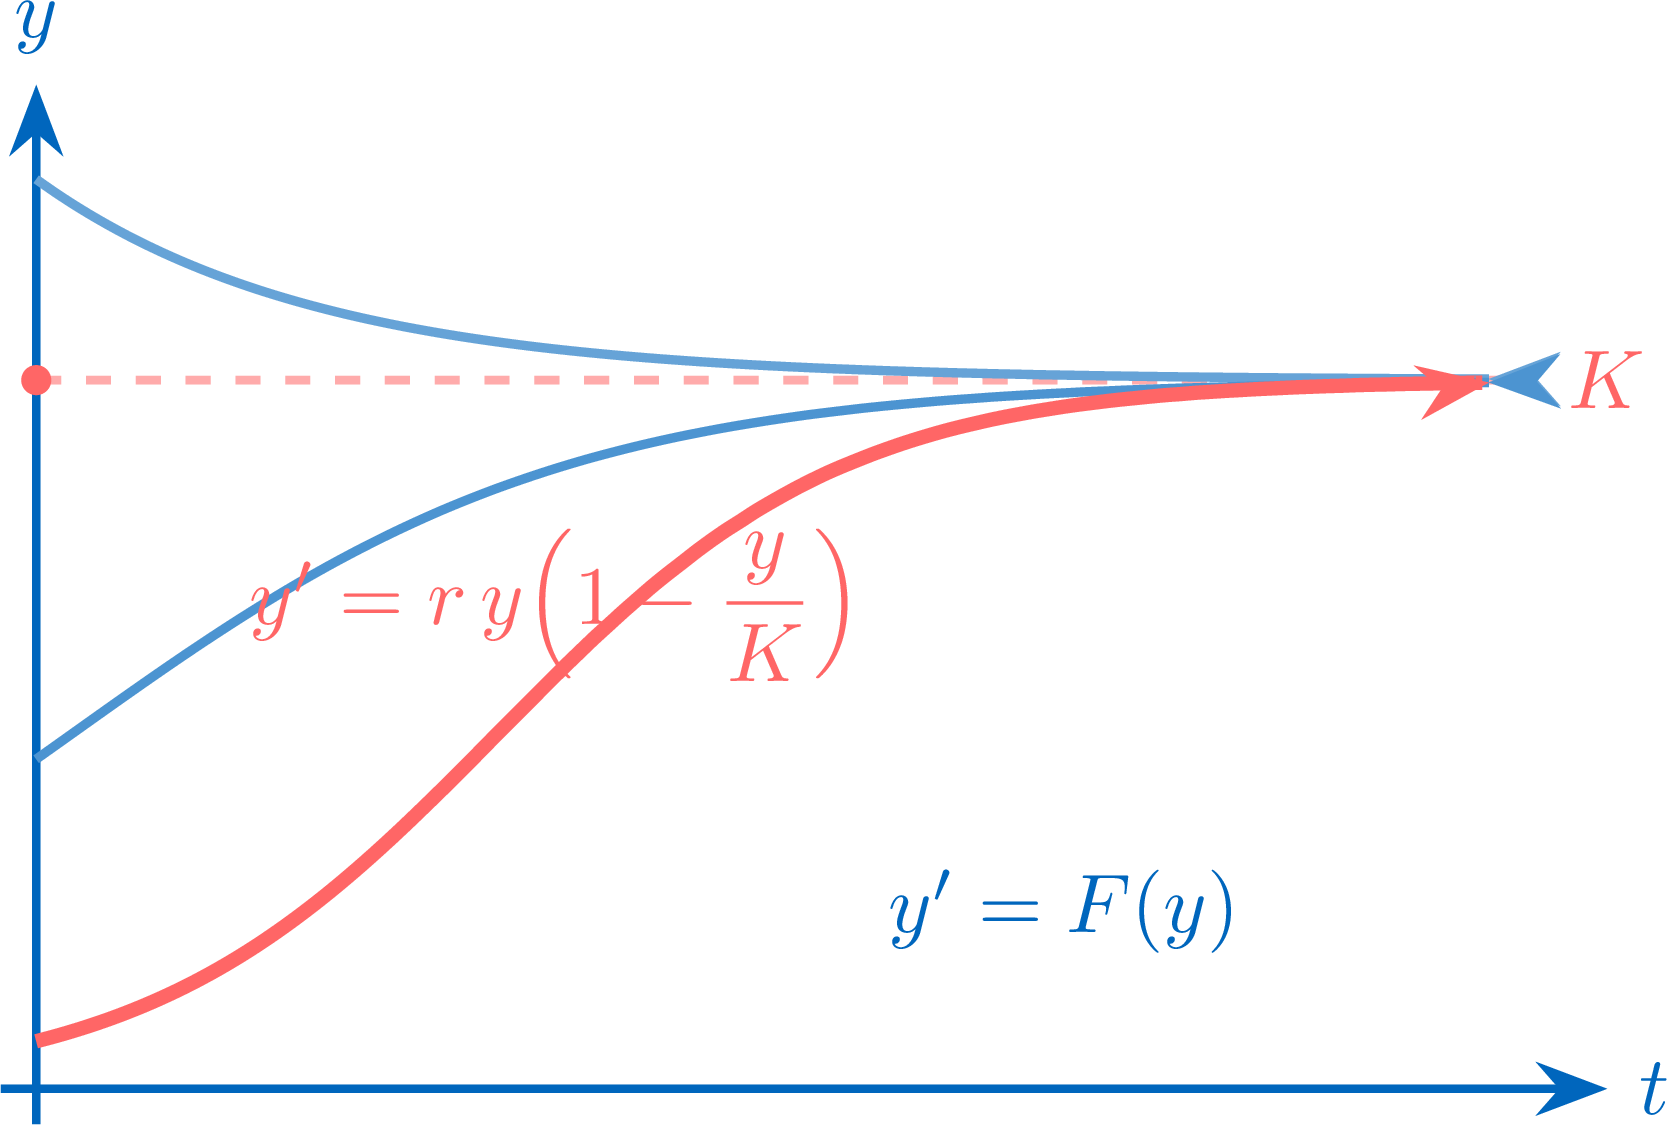
Équations différentielles autonomes
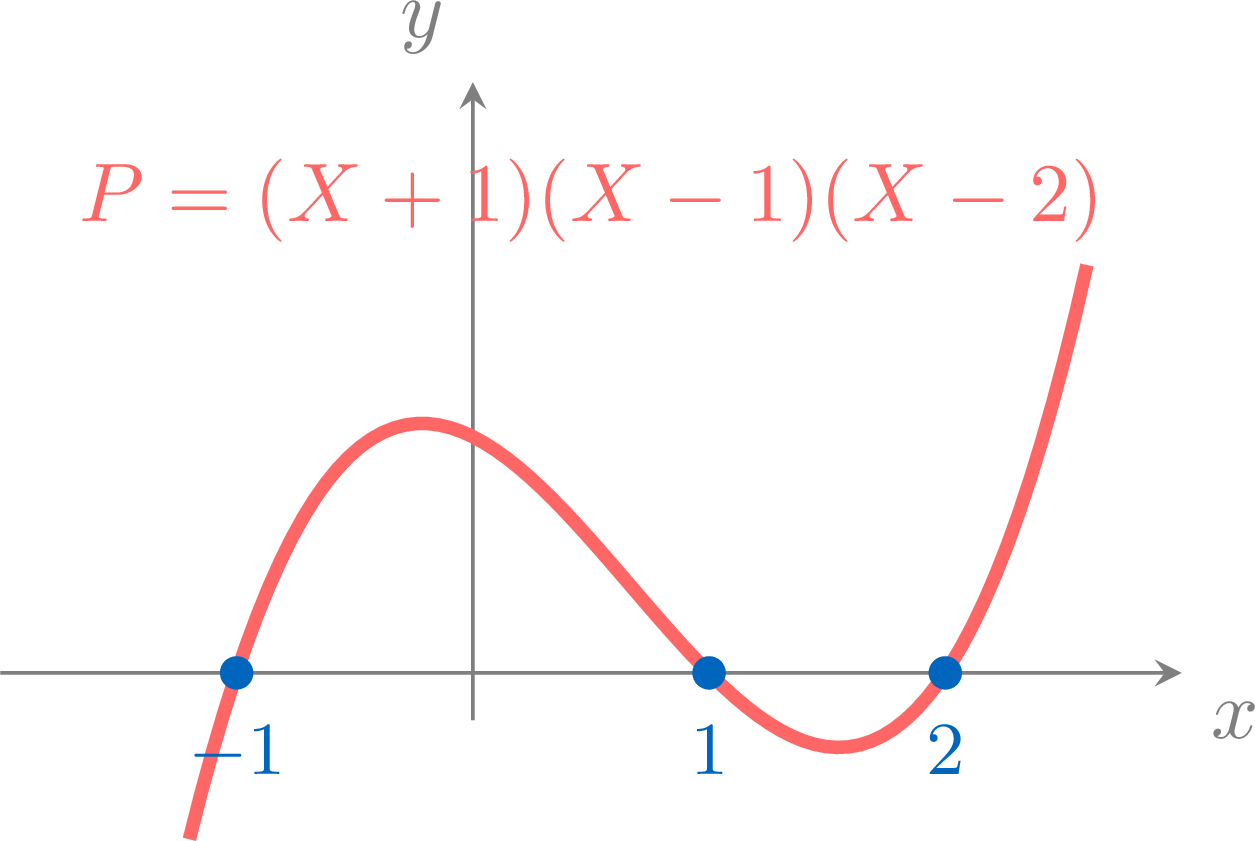
Polynômes
Espaces vectoriels
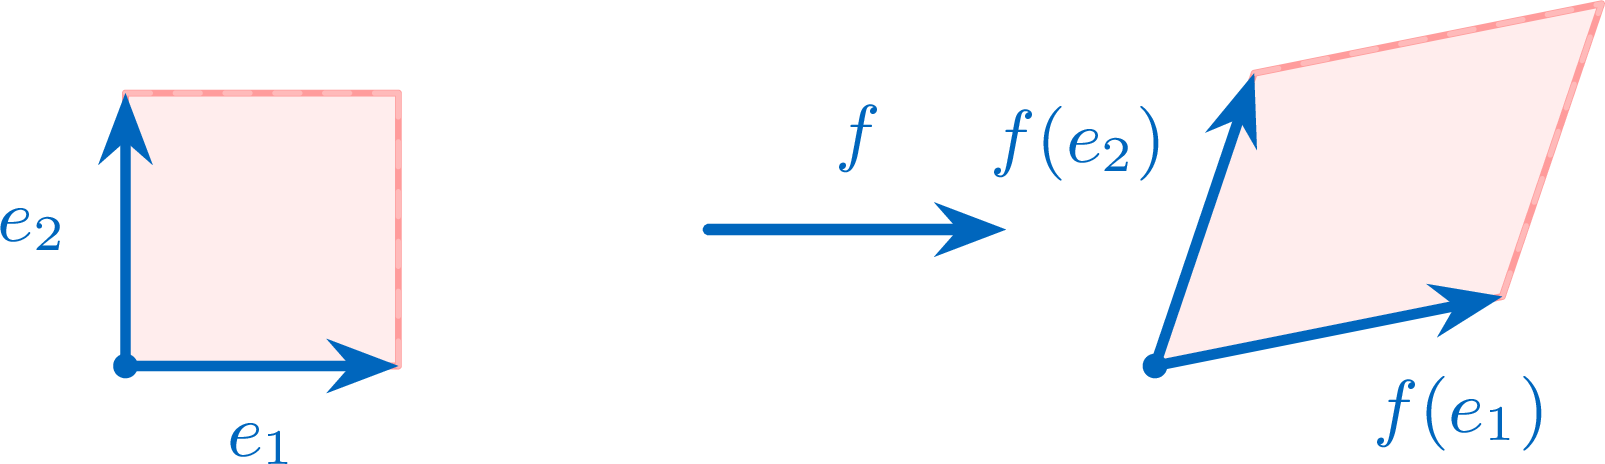
Applications linéaires et matrices
Valeurs propres et diagonalisation
Produit scalaire dans \(\mathbb{R}^n\)
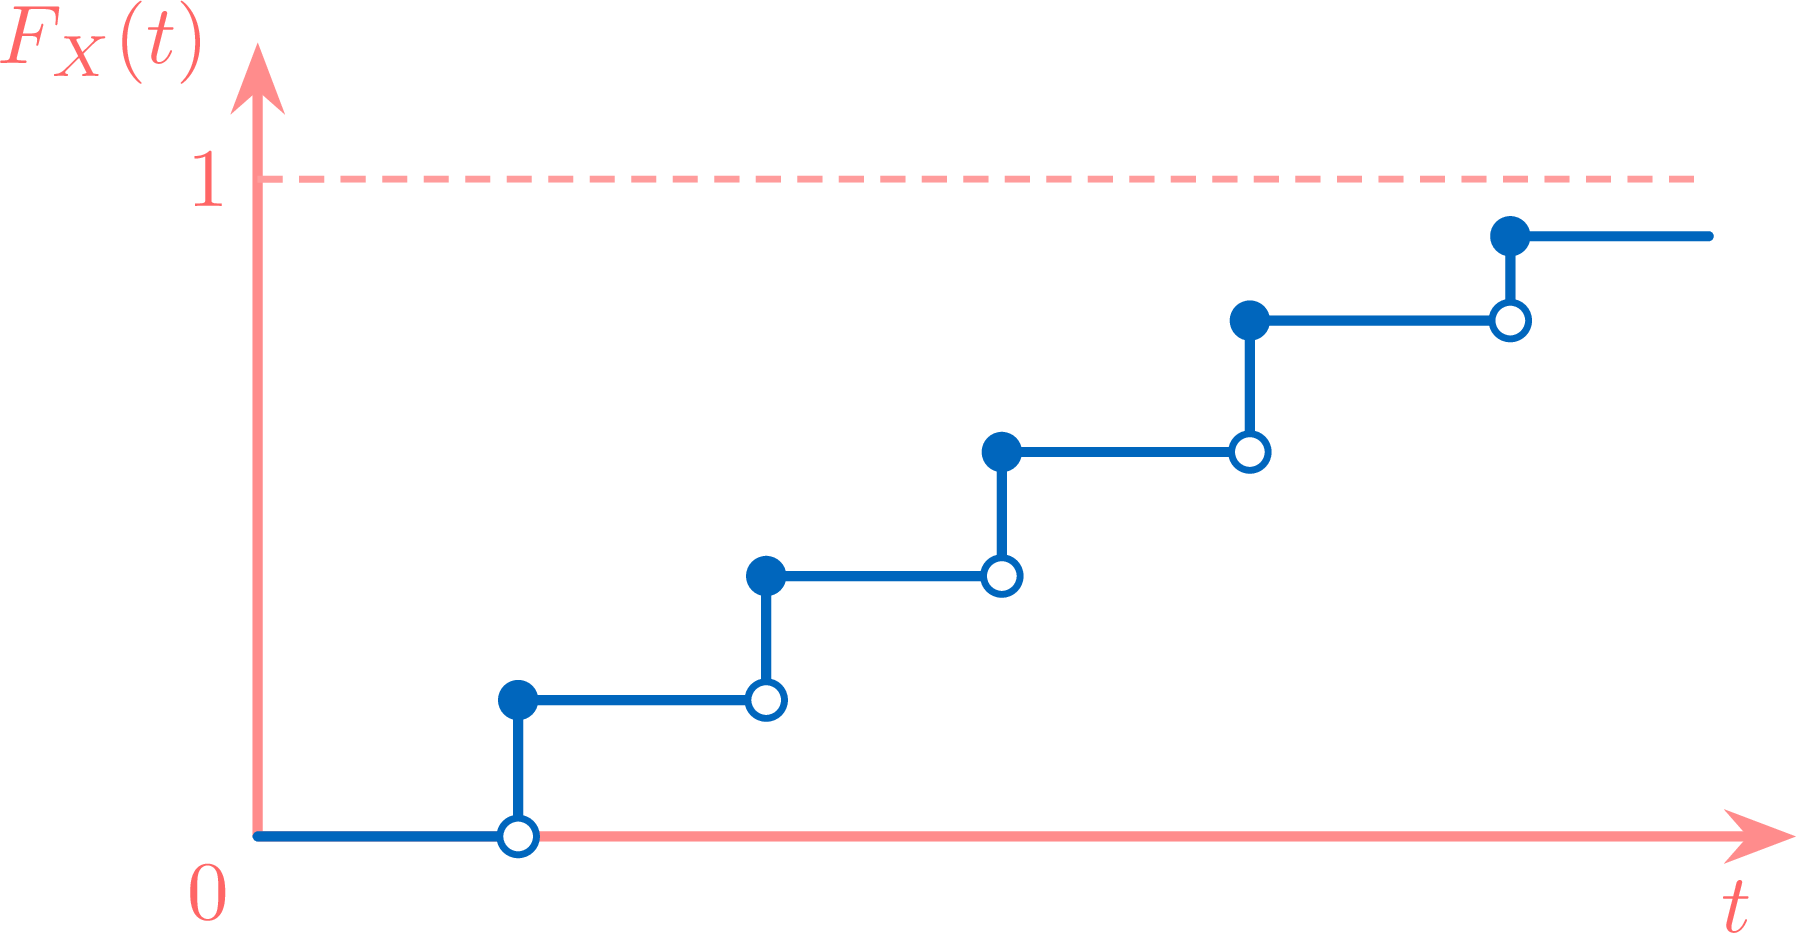
Concepts de base des probabilités et variables aléatoires
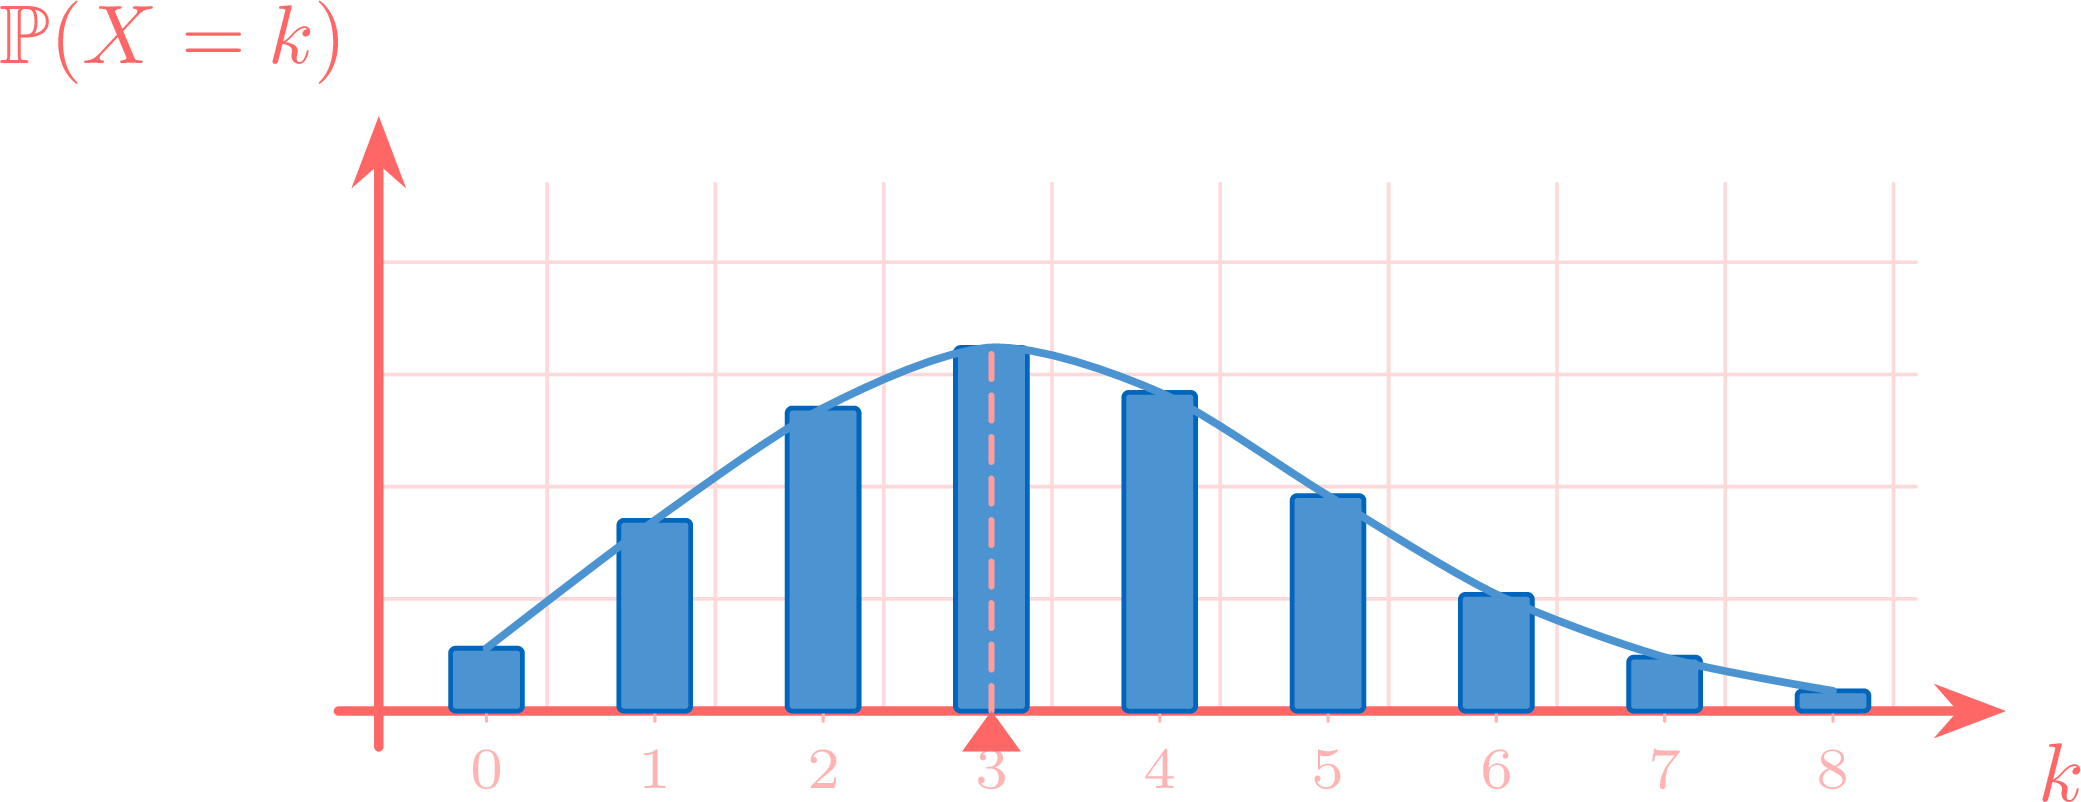
Variables aléatoires discrètes
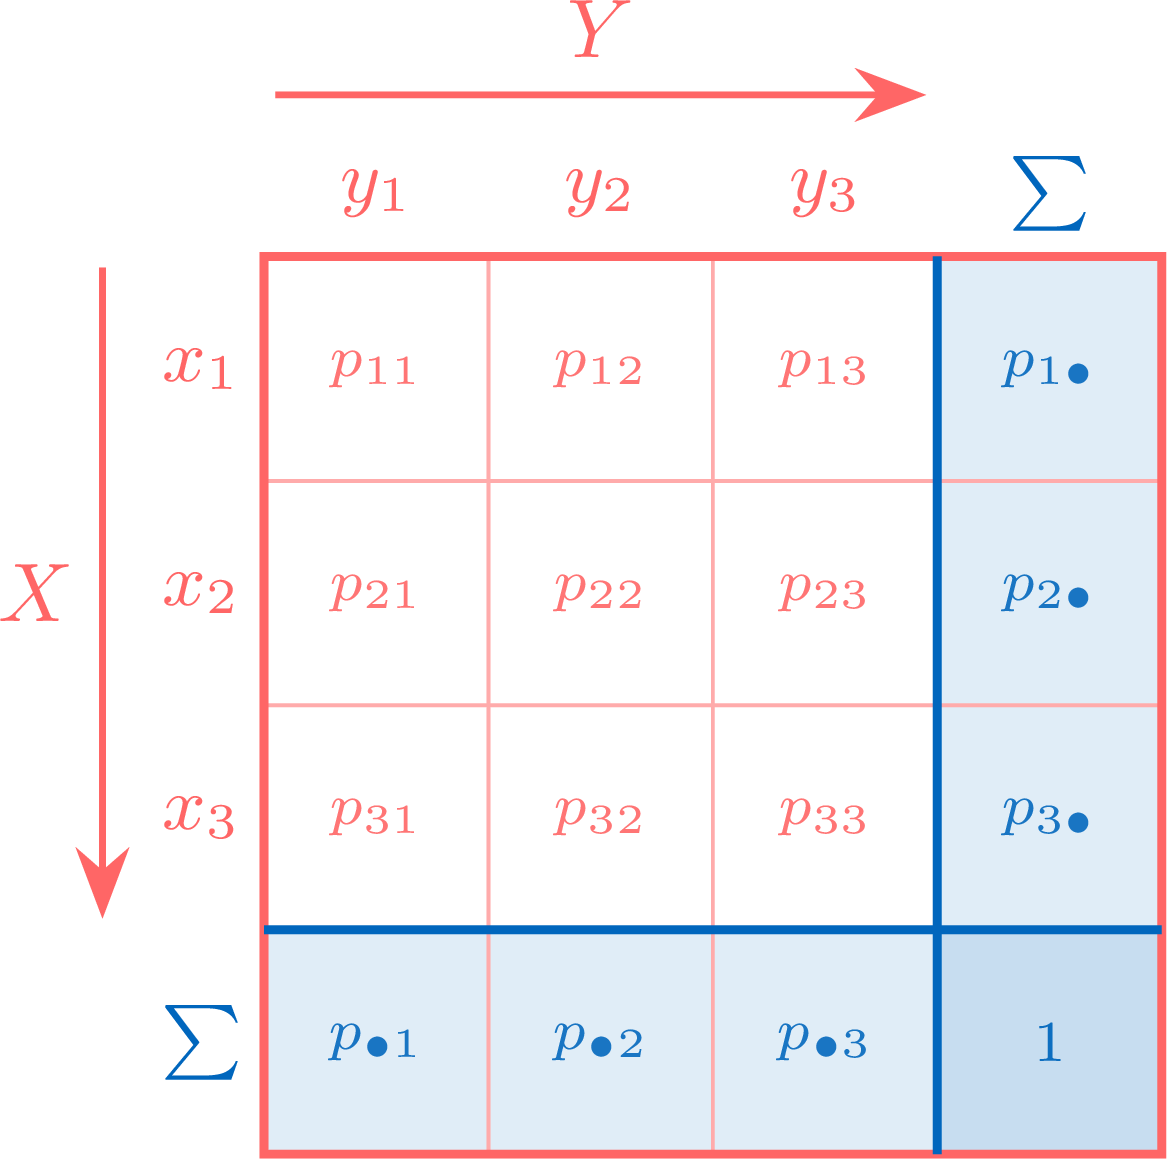
Couples de variables aléatoires discrètes
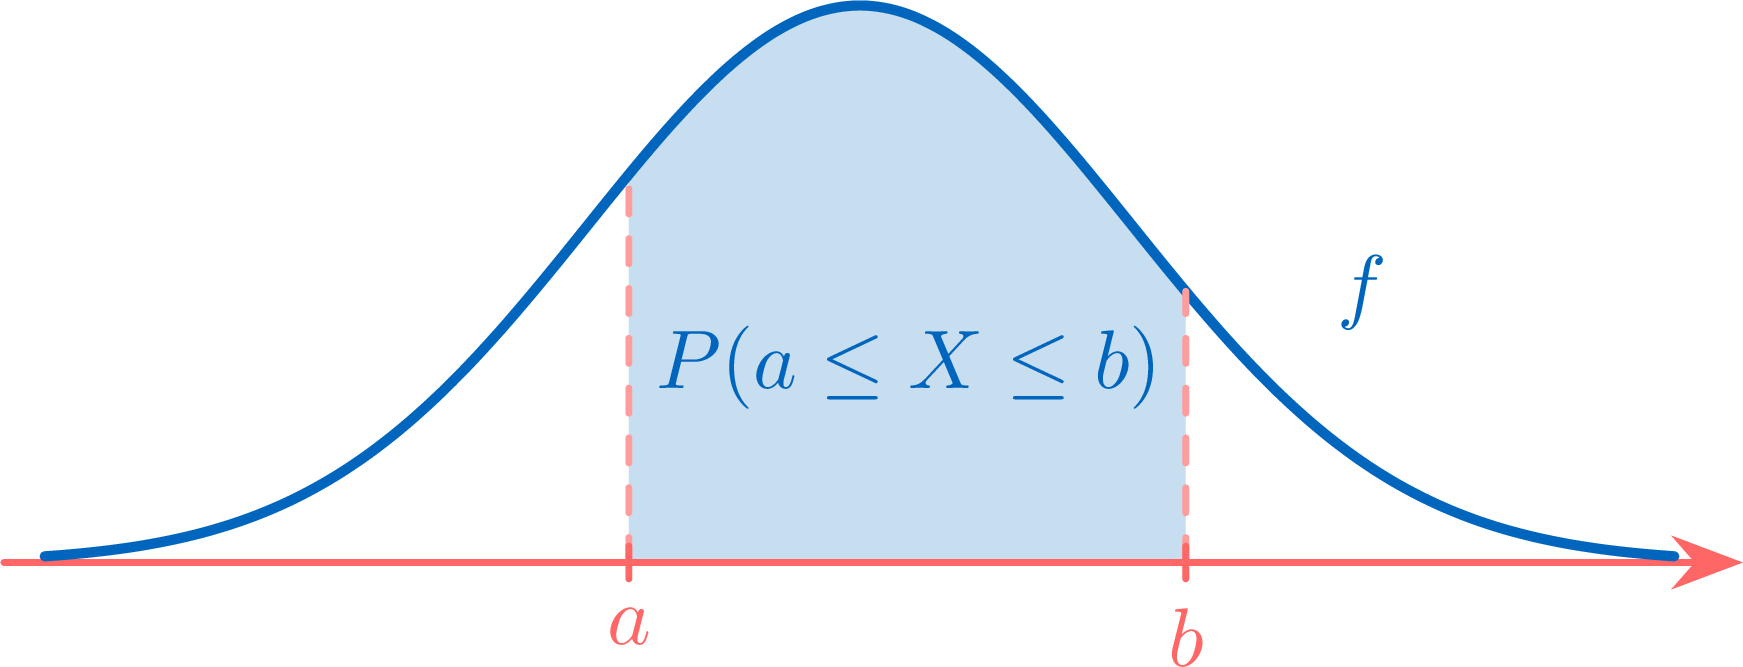
Variables aléatoires à densité
Théorèmes limites
Au programme
- Séries réelles — Séries numériques réelles vues comme la suite de leurs sommes partielles : définition, nature (convergence ou divergence) et somme totale, indépendance vis-à-vis de l'indice de départ, modification d'un nombre fini de termes, et combinaisons linéaires. Télescopage pour calculer une somme totale. Le test de divergence grossière (le terme général doit tendre vers zéro). Séries à termes positifs : sommes partielles croissantes, théorème de comparaison et théorème des équivalents. La convergence absolue implique la convergence, et l'invariance de la somme d'une série absolument convergente par réordonnancement (admise). Séries de référence : la série harmonique diverge et la série des inverses des carrés converge, les séries de Riemann pour des exposants au moins deux ou au plus un, les séries géométrique et géométrique dérivée avec leurs sommes totales, et la série exponentielle (admise).
- Intégrales généralisées — Intégrales généralisées (impropres) d'une fonction continue, prolongeant l'intégrale sur un segment aux intervalles non bornés ou aux intervalles où la fonction explose en une borne. Convergence comme limite finie de la fonction intégrale, intégrales faussement impropres, intégrales sur un intervalle ouvert, relation de Chasles, linéarité, intégration par parties et changement de variable adaptés aux intégrales impropres, et intégrandes paires ou impaires. Pour les intégrandes positives : la fonction intégrale croît, théorème de comparaison et théorème des équivalents. La convergence absolue implique la convergence. Intégrales de référence calculées par une primitive : les intégrales de Riemann (convergeant pour un exposant supérieur à un en l'infini, inférieur à un en zéro), l'intégrale exponentielle, et l'intégrale de Gauss admise.
- Équations différentielles autonomes — Équations différentielles autonomes d'ordre un y' = F(y) : le taux ne dépend que de l'état. Pas de théorie générale (comme l'exige le programme) ; plutôt la lecture qualitative des équilibres (solutions constantes) et du signe de F, la méthode d'Euler rappelée pour une solution numérique approchée, et la résolution exacte des modèles de population nommés par une substitution guidée qui ramène chacun à une équation linéaire d'ordre un : le modèle de Malthus (croissance exponentielle), le modèle logistique (substitution 1/y, saturation à la capacité de charge), et le modèle de Gompertz (substitution par le logarithme).
- Polynômes — Polynômes à coefficients complexes, prolongeant les fonctions polynomiales réelles de première année : l'indéterminée X (l'application x vers x sur C), les familles R[X], C[X] et leurs sous-ensembles bornés en degré, l'unicité des coefficients, le degré sous somme et produit, et le fait que le polynôme dérivé ne s'étend pas à C[X]. Racines et facteur (X moins alpha) rappelés de première année, l'ordre d'une racine défini par ce facteur, la symétrie des racines conjuguées d'un polynôme réel, et le théorème phare de d'Alembert-Gauss (admis) donnant la factorisation complète dans C[X] en facteurs de degré un, de sorte qu'un polynôme de degré n a exactement n racines comptées avec multiplicité.
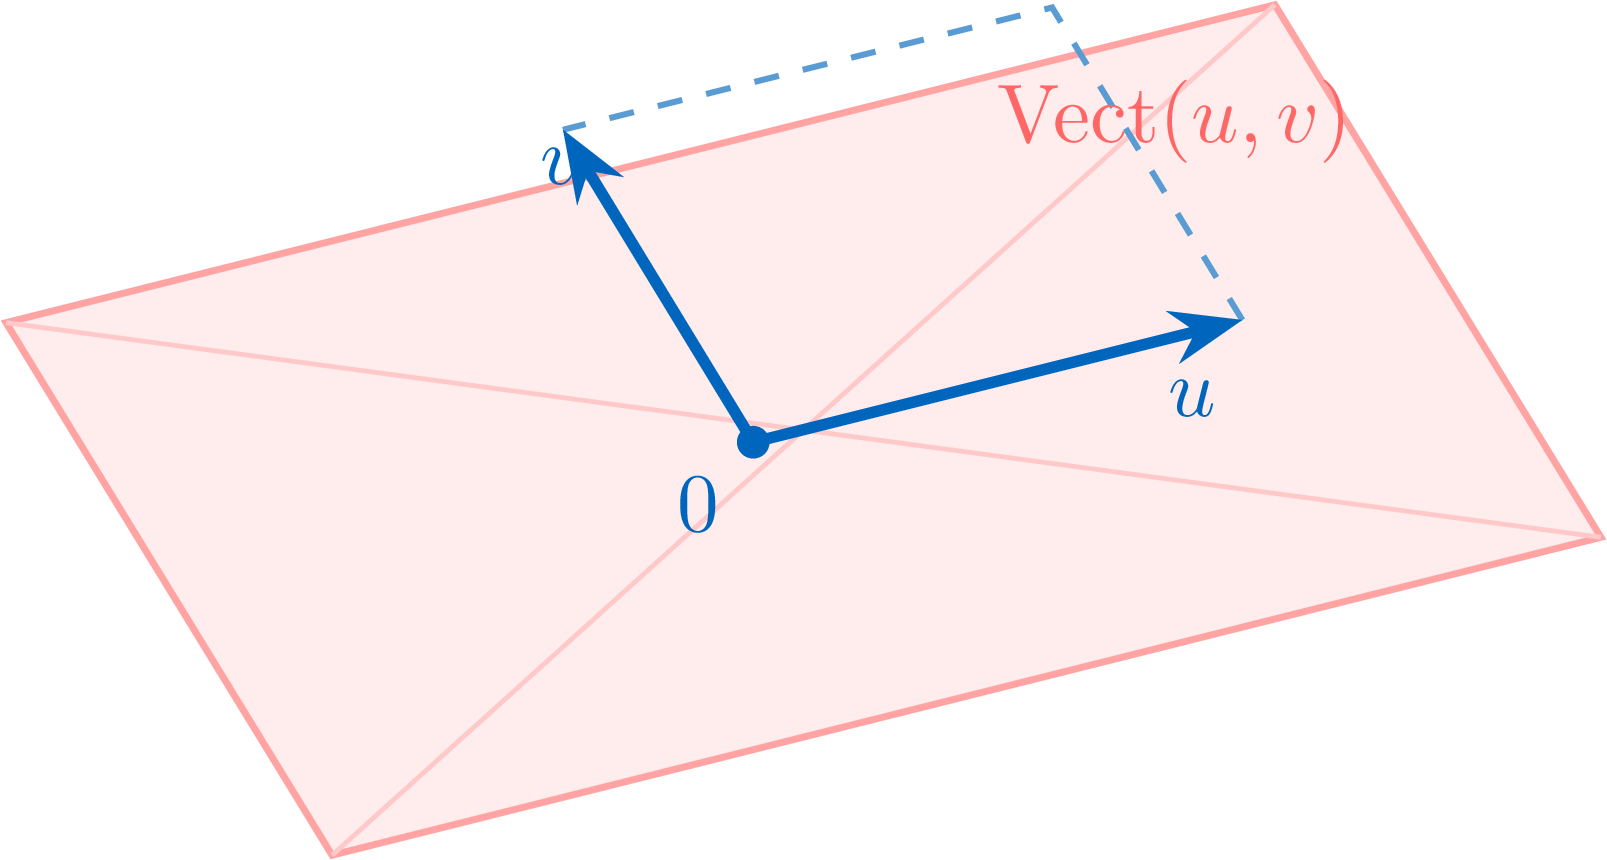
- Espaces vectoriels — Espaces vectoriels abstraits sur K = R ou C, généralisant l'espace concret K^n de première année : les règles d'espace vectoriel, les exemples standard K^n, les matrices M_{n,p}(K), les fonctions F(I,K), les polynômes K[X] et K_n[X], les règles de calcul dont lambda fois u égale zéro ssi lambda est nul ou u est nul. Sous-espaces et caractérisation par les combinaisons linéaires, intersection d'un nombre fini de sous-espaces, sous-espace engendré et familles génératrices, familles libres et bases (une famille de polynômes non nuls de degrés distincts est libre), coordonnées dans une base. Dimension finie avec les théorèmes de dimension admis, dimension d'un sous-espace, et rang d'une famille comme dimension de l'espace engendré, calculé via les coordonnées dans une base.
- Applications linéaires et matrices — Applications linéaires entre espaces vectoriels abstraits, prolongeant les applications de première année de K^p dans K^n : la définition et la caractérisation en une ligne, noyau et image comme sous-espaces, image d'un sous-espace engendré, injectivité par le noyau et surjectivité par l'image, endomorphismes, isomorphismes et automorphismes, et les opérations (somme, multiple scalaire, composition, itérées). La matrice d'une application linéaire dans des bases choisies, la relation Y = A X, la matrice d'une somme et d'une composée (produit matriciel), le lien entre automorphisme et matrice inversible. En dimension finie : une application est déterminée par l'image d'une base, le rang d'une application égale le rang de sa matrice, un isomorphisme envoie une base sur une base donc tout espace de dimension n est isomorphe à K^n, le théorème du rang (admis), et l'équivalence injective-surjective-bijective en dimension finie égale. Changement de base : la matrice de passage, le changement de coordonnées X = P X', la transformation M' = P^{-1} M P de la matrice d'un endomorphisme, les matrices semblables, et les puissances par similitude.
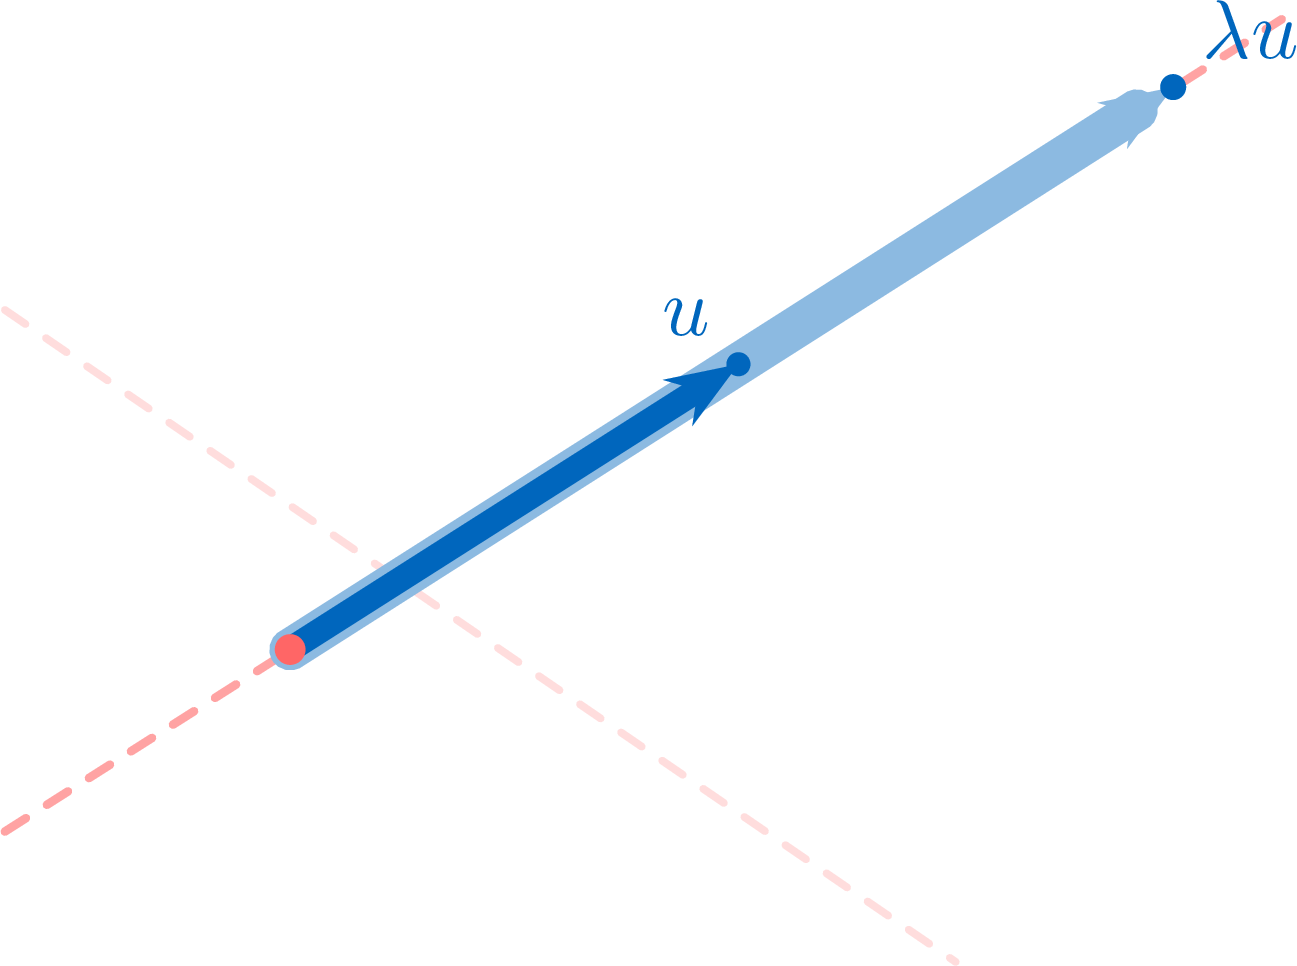
- Valeurs propres et diagonalisation — Valeurs propres, vecteurs propres, sous-espaces propres et diagonalisation, sur K = R ou C. Un scalaire lambda est valeur propre d'une matrice carrée exactement quand M - lambda I n'est pas inversible (rang strictement inférieur à n) ; le sous-espace propre E_lambda est le noyau de M - lambda I. Les valeurs propres d'une matrice triangulaire sont ses coefficients diagonaux, un endomorphisme et sa matrice partagent leurs valeurs propres, et des matrices semblables ont le même spectre. Une matrice est diagonalisable quand ses vecteurs propres forment une base, de façon équivalente M = P D P^{-1} ; des vecteurs propres de valeurs propres distinctes sont libres, donc il y a au plus n valeurs propres et n distinctes forcent la diagonalisabilité, et le critère exact est que la somme des dimensions des sous-espaces propres vaut n. Sur C toute matrice a une valeur propre (admis) tandis qu'une matrice réelle peut n'en avoir aucune ; les valeurs propres complexes d'une matrice réelle vont par paires conjuguées. Les puissances suivent par M^k = P D^k P^{-1}, résolvant les suites récurrentes et les marches aléatoires.
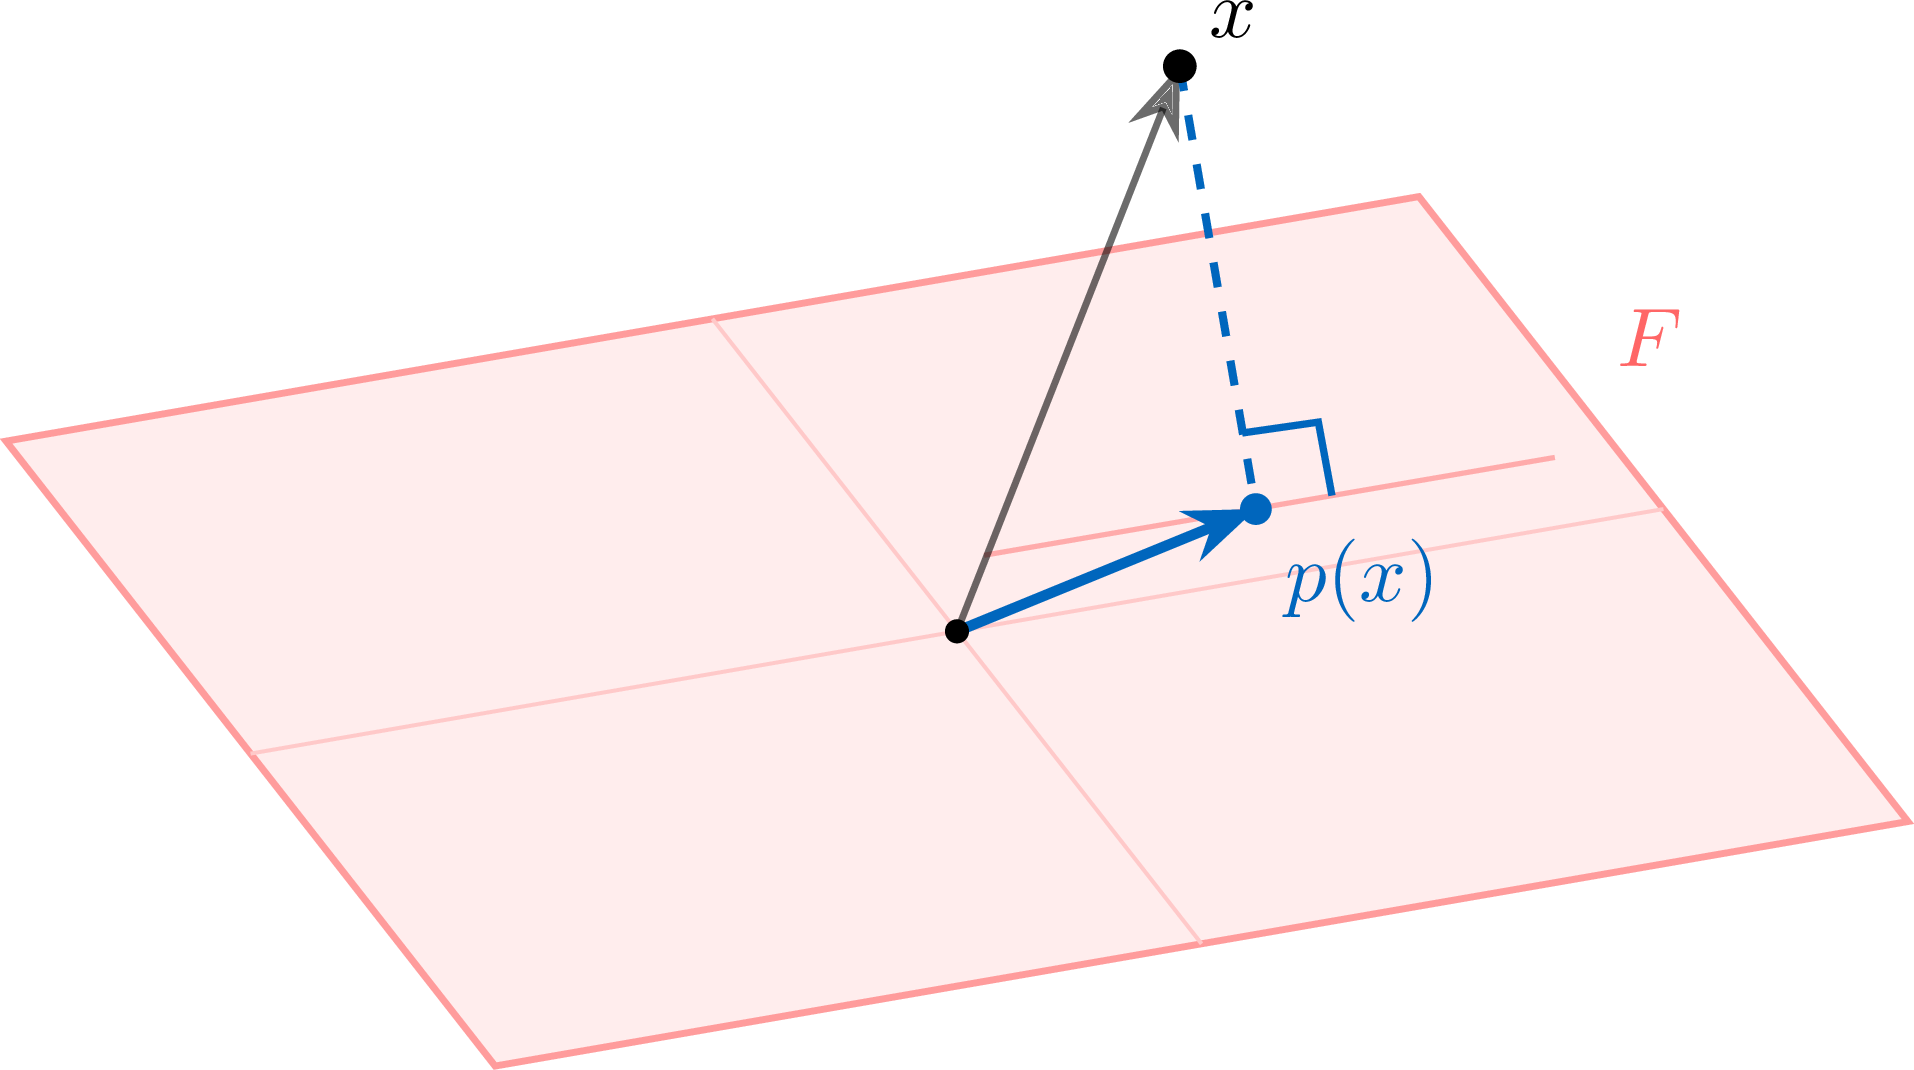
- Produit scalaire dans \(\mathbb{R}^n\) — Le produit scalaire usuel dans R^n, prolongeant la géométrie plane de première année : la définition x_1 y_1 + ... + x_n y_n et sa forme matricielle transpose(U) V, la bilinéarité, la symétrie, le caractère défini positif ; la norme euclidienne, les inégalités de Cauchy-Schwarz et triangulaire avec leurs cas d'égalité. L'orthogonalité et le théorème de Pythagore, les familles et bases orthogonales et orthonormales (une famille orthogonale de vecteurs non nuls est libre), les coordonnées et le produit scalaire lus comme dans la base canonique au sein de toute base orthonormale, et les matrices orthogonales (transpose(P) P = I, inverse = transposée). Le théorème spectral (admis) : les sous-espaces propres d'une matrice symétrique réelle sont deux à deux orthogonaux et toute matrice symétrique réelle est diagonalisable en base orthonormale. L'orthogonal F-perp et la décomposition orthogonale unique x = x_F + x_{F-perp}, la projection orthogonale (p rond p = p, image F, noyau F-perp) avec sa formule en base orthogonale, la distance à un sous-espace comme longueur de la perpendiculaire, et l'ajustement affine par moindres carrés (coefficients rappelés).
- Concepts de base des probabilités et variables aléatoires — Probabilité sur un univers infini, prolongeant la théorie finie de première année. Réunions et intersections dénombrables, l'ensemble des événements (une tribu, nommée seulement comme cadre et jamais testée), une probabilité avec l'axiome de sigma-additivité : la probabilité d'une réunion disjointe dénombrable est la somme d'une série convergente. Événements négligeables (probabilité 0 mais éventuellement non vides) et presque sûrs (probabilité 1 mais éventuellement différents de l'univers), et la continuité de la probabilité le long des suites monotones. La probabilité conditionnelle, les probabilités composées, la formule de Bayes et l'indépendance se prolongent de la première année, l'indépendance étant désormais définie pour une suite d'événements. Systèmes complets et quasi-complets d'événements (réunion presque sûre) avec somme des probabilités égale à 1, et la formule des probabilités totales P(B) = somme des P(B inter A_n) sur un système dénombrable. Variables aléatoires réelles, définies par (X <= a) événement, leurs valeurs et support, l'indépendance de variables aléatoires, et la fonction de répartition F_X(t) = P(X <= t) : croissante, de limites 0 et 1, caractérisant la loi d'une variable discrète par ses sauts.
- Variables aléatoires discrètes — Variables aléatoires discrètes, prolongeant les variables finies de première année à une image dénombrable. La loi donne les probabilités P(X=x) de somme 1, la fonction de répartition devient un escalier, et toute loi à poids positifs sommables est réalisée par une variable. L'indépendance se lit sur les événements (X=x),(Y=y) comme un produit, avec le lemme des coalitions regroupant des blocs disjoints. L'espérance E(X) = somme des x P(X=x) exige la convergence absolue ; le théorème de transfert (admis) calcule E(g(X)) ; l'espérance est linéaire (admise), positive et croissante. L'inégalité de Markov majore P(X >= a) par E(X)/a. La variance Var(X) = E((X-E(X))^2), avec moments, écart-type, König-Huygens Var(X) = E(X^2) - E(X)^2, Var(aX+b) = a^2 Var(X), la variable centrée réduite, et Bienaymé-Tchebychev P(|X-E(X)| >= eps) <= Var(X)/eps^2 ; pour des variables indépendantes E(XY) = E(X)E(Y) et Var(X+Y) = Var(X) + Var(Y) (admis). La loi géométrique G(p) (rang d'un premier succès, sans mémoire, E = 1/p, Var = (1-p)/p^2) et la loi de Poisson P(lambda) (E = Var = lambda).
- Couples de variables aléatoires discrètes — Couples de variables aléatoires discrètes, prolongeant la variable discrète unique du chapitre précédent. La loi conjointe donne les probabilités P(X=x,Y=y), présentées dans un tableau à double entrée ; les événements (X=x)∩(Y=y) forment un système complet. Sommer sur l'autre variable redonne les lois marginales, et renormaliser une ligne ou une colonne donne la loi conditionnelle de X sachant Y=y (pas d'espérance conditionnelle). Une fonction Z=u(X,Y) a sa loi obtenue par regroupement des probabilités conjointes ; pour des variables indépendantes le maximum et le minimum se traitent par la fonction de répartition (P(max≤t)=∏P(Xi≤t)), et la somme de deux variables à valeurs entières par la formule de convolution. Deux lois sont stables par somme indépendante : les binomiales de même p, et les variables de Poisson (démontré par la formule du binôme sur une seule série). Le théorème de transfert (cas fini, admis) donne E(g(X,Y)) et en particulier E(XY). La covariance Cov(X,Y)=E((X-E(X))(Y-E(Y))) se calcule par König-Huygens Cov(X,Y)=E(XY)-E(X)E(Y) (cas fini), est bilinéaire et symétrique avec Cov(X,X)=Var(X), et contrôle la variance d'une somme Var(X+Y)=Var(X)+Var(Y)+2Cov(X,Y). Des variables indépendantes sont non corrélées (Cov=0, donc Var(X+Y)=Var(X)+Var(Y)), mais la réciproque est fausse, comme le montre X uniforme sur {-1,0,1} avec Y=X².
- Variables aléatoires à densité — Variables aléatoires à densité, répartissant leur probabilité continûment le long de la droite réelle. Une densité f est positive, continue sauf en un nombre fini de points, d'intégrale 1 ; X admet la densité f lorsque sa fonction de répartition est F_X(x)=intégrale de f jusqu'à x, de sorte que chaque valeur isolée a une probabilité 0 et P(a<=X<=b) est l'aire sous f. La densité est la dérivée de la fonction de répartition en ses points de continuité, et une fonction de répartition continue sur R et C1 sauf en un nombre fini de points caractérise une densité. La loi de u(X) s'obtient par la fonction de répartition puis dérivation (pas de formule à retenir) ; aX+b admet la densité (1/|a|)f((x-b)/a). L'espérance E(X)=intégrale de x f(x) exige la convergence absolue ; le théorème de transfert (admis) donne E(g(X)) ; Markov, la variance, König-Huygens Var(X)=E(X^2)-E(X)^2, Var(aX+b)=a^2 Var(X) et Bienaymé-Tchebychev se transposent du cas discret. Trois lois usuelles : uniforme U[a,b] (E=(a+b)/2, Var=(b-a)^2/12), exponentielle E(lambda) (E=1/lambda, Var=1/lambda^2, sans mémoire, F=1-e^{-lambda x}), et normale N(0,1) puis N(mu,sigma^2) avec standardisation Z=(X-mu)/sigma, E=mu, Var=sigma^2. La somme de deux variables à densité indépendantes admet une densité donnée par la convolution (admise), et une somme de normales indépendantes est normale avec moyennes et variances ajoutées.
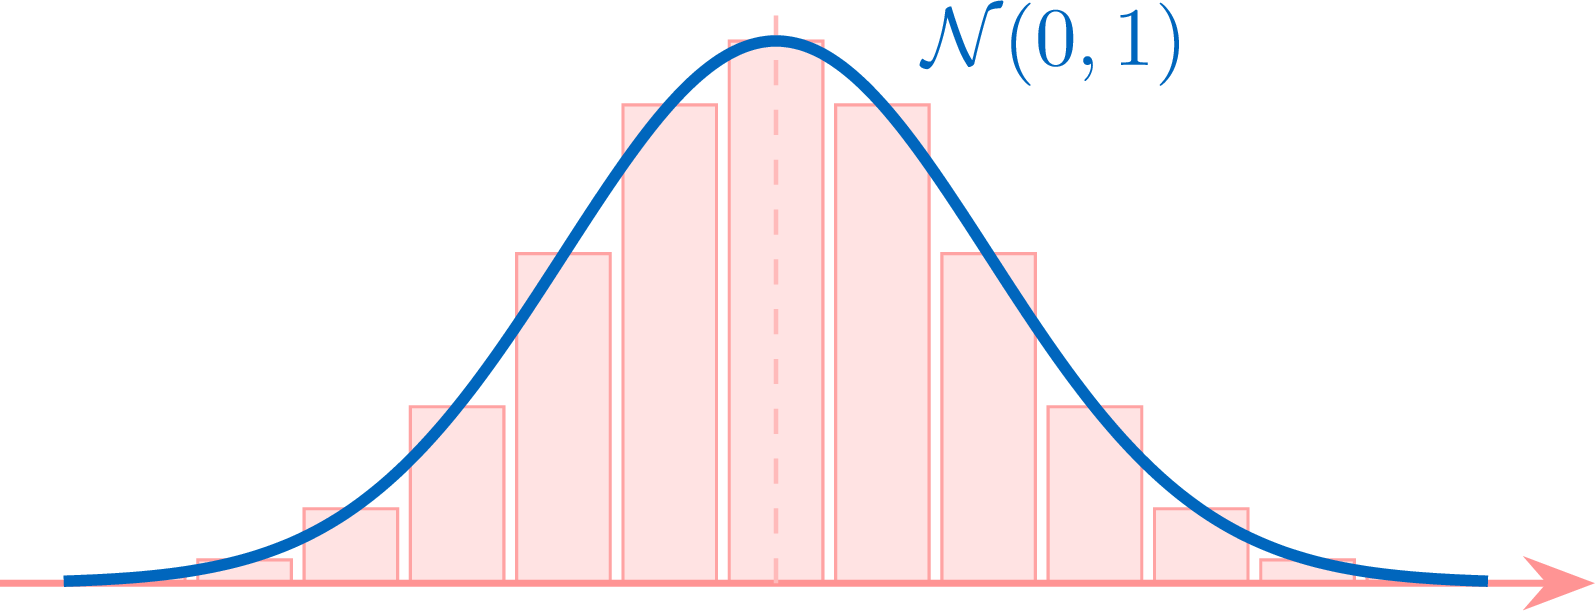
- Théorèmes limites — Théorèmes limites, étudiant le comportement d'une expérience répétée un grand nombre de fois. À partir d'un n-échantillon on forme la moyenne empirique M_n, la proportion empirique P_n et la variance empirique S_n^2 (avec E(M_n)=mu, Var(M_n)=sigma^2/n, E(S_n^2)=(n-1)/n sigma^2 et la variance corrigée). Markov et Bienaymé-Tchebychev (rappelées) donnent la loi faible des grands nombres, P(|M_n - mu| >= epsilon) -> 0, démontrée via Bienaymé-Tchebychev (théorème de Bernoulli pour une proportion). La convergence en loi (F_{Y_n} -> F_Y aux points de continuité) se lit sur les probabilités P(Y_n=k) pour des variables à valeurs entières ; une binomiale B(n, lambda/n) converge en loi vers une Poisson P(lambda) (critères n>=30, p<=0.1). Le théorème central limite (admis) fait converger en loi la moyenne empirique standardisée M_n* de n'importe quelle loi de variance finie non nulle vers N(0,1) ; de Moivre-Laplace standardise une somme binomiale ; les approximations normales de la binomiale (n>=30, np>=5, n(1-p)>=5), d'une proportion, et d'une loi de Poisson (lambda>=18) en découlent, avec une seconde forme du TCL utilisant l'écart-type empirique S_n quand sigma est inconnu. Enfin une introduction aux tests de conformité : les hypothèses nulle et alternative, un intervalle d'acceptation à un niveau de confiance proche de 1 construit à partir du théorème central limite, la zone de rejet, et le test de conformité d'une moyenne et d'une proportion.