Éducation Nationale Française · BCPST 2
Variables aléatoires à densité
Jusqu'ici une variable aléatoire répartissait sa probabilité sur une liste de valeurs. Une variable à densité la répartit continûment le long de la droite réelle : il n'y a aucune probabilité en un point isolé, seulement sur des intervalles, et la probabilité d'un intervalle est l'aire sous une courbe, la densité \(f\). La fonction de répartition \(F_X(x) = \int_{-\infty}^{x} f(t)\,\mathrm{d}t\) relie les deux, et la dériver redonne la densité. L'espérance et la variance deviennent des intégrales au lieu de sommes, avec la même exigence de convergence absolue ; le théorème de transfert, König-Huygens et Bienaymé-Tchebychev se transposent à l'identique. Trois modèles dominent : la loi uniforme (un nombre tiré au hasard dans un intervalle), la loi exponentielle (un temps d'attente sans mémoire) et la loi normale (la courbe en cloche, centrale au chapitre suivant). La somme de deux variables à densité indépendantes admet encore une densité, donnée par une convolution.
I
Densité et fonction de répartition
I.1
Densité et loi d'une variable continue
Une variable discrète place une masse de probabilité en chacune de ses valeurs. Une variable continue répartit au contraire la probabilité le long d'un intervalle, de sorte que chaque valeur isolée porte une probabilité \(0\) ; ce qui compte est la probabilité d'un intervalle, lue comme l'aire sous une courbe appelée densité. La figure ci-dessous montre \(P(a \le X \le b)\) comme l'aire grisée sous \(f\) entre \(a\) et \(b\). 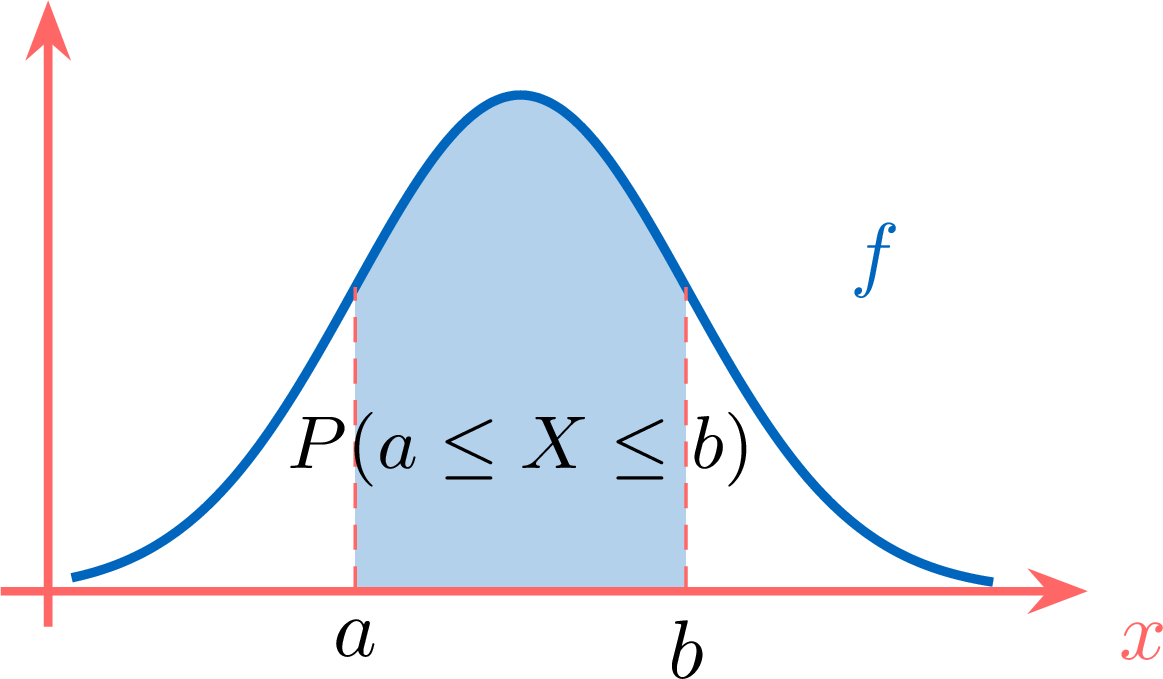
Définition — Densité
Une densité est une fonction \(f : \mathbb{R} \to \mathbb{R}\) positive, continue sauf en un nombre fini de points, et dont l'intégrale sur \(\mathbb{R}\) converge avec \(\int_{-\infty}^{+\infty} f(t)\, \mathrm{d}t = 1\). Définition — Variable à densité
Une variable aléatoire \(X\) admet la densité \(f\) si \(f\) est une densité et si sa fonction de répartition vérifie \(F_X(x) = P(X \le x) = \int_{-\infty}^{x} f(t)\, \mathrm{d}t\) pour tout \(x \in \mathbb{R}\). Proposition — L'intégrale d'une densité est une fonction de répartition
Pour une densité \(f\), la fonction \(F(x) = \int_{-\infty}^{x} f(t)\, \mathrm{d}t\) vérifie \(0 \le F \le 1\), est croissante, est continue sur \(\mathbb{R}\), et a pour limites \(\lim_{x \to -\infty} F(x) = 0\) et \(\lim_{x \to +\infty} F(x) = 1\).
Comme \(f \ge 0\), l'intégrale \(F\) est croissante (on ajoute de l'aire positive), et \(0 \le F(x) \le \int_{-\infty}^{+\infty} f(t)\,\mathrm{d}t = 1\). La limite en \(+\infty\) vaut \(\int_{-\infty}^{+\infty} f(t)\,\mathrm{d}t = 1\) par définition, et en \(-\infty\) elle vaut \(0\). La continuité vient de la continuité d'une intégrale par rapport à sa borne supérieure (l'intégrande n'ayant qu'un nombre fini de discontinuités) ; cela correspond aux propriétés de fonction de répartition du ch. 9.
Théorème — Existence
Pour toute densité \(f\), il existe une variable aléatoire \(X\) admettant \(f\) pour densité. Admis. Proposition — Probabilités à partir de la densité
Si \(X\) admet la densité \(f\) alors pour tous réels \(a < b\), $$P(X = a) = 0, \qquad P(a \le X \le b) = \int_a^b f(t)\, \mathrm{d}t,$$ de sorte que les inégalités peuvent être strictes ou larges sans changer la valeur.
Comme \(F_X\) est continue, \(P(X = a) = F_X(a) - \lim_{t \to a^-} F_X(t) = 0\). Puis, avec \(P(a < X \le b) = F_X(b) - F_X(a)\) et la relation de Chasles, $$\begin{aligned} P(a \le X \le b) &= P(a < X \le b) && \text{(car \(P(X = a) = 0\))} \\
&= F_X(b) - F_X(a) \\
&= \int_{-\infty}^{b} f(t)\,\mathrm{d}t - \int_{-\infty}^{a} f(t)\,\mathrm{d}t = \int_a^b f(t)\, \mathrm{d}t. \end{aligned}$$
Exemple
La fonction \(f(t) = e^{-t}\) pour \(t \ge 0\) et \(f(t) = 0\) pour \(t < 0\) est une densité : elle est positive, continue sauf en \(0\), et \(\int_0^{+\infty} e^{-t}\, \mathrm{d}t = 1\). Sa fonction de répartition est \(F(x) = 1 - e^{-x}\) pour \(x \ge 0\) et \(F(x) = 0\) pour \(x < 0\). Exemple
La fonction égale à \(1\) sur \([0, 1]\) et \(0\) ailleurs est une densité (aire d'un carré unité) ; la fonction de répartition associée est la rampe \(F(x) = 0\) pour \(x < 0\), \(F(x) = x\) pour \(0 \le x \le 1\), \(F(x) = 1\) pour \(x > 1\). Compétences à pratiquer
- Reconnaître une densité
I.2
Fonctions d'une variable à densité et indépendance
Pour reconnaître une densité à partir d'une fonction de répartition, ou pour trouver la loi d'une variable transformée \(u(X)\), on passe par la fonction de répartition puis on dérive. Il n'y a pas de formule à retenir : la méthode fiable est de calculer \(F_{u(X)}(y) = P(u(X) \le y)\) en fonction de \(F_X\), puis de dériver.
Proposition — La densité est la dérivée de la fonction de répartition
Si \(X\) admet la densité \(f\), alors en tout point \(x\) où \(f\) est continue, \(F_X\) est dérivable avec \(F_X'(x) = f(x)\) ; en particulier \(F_X\) est \(\mathcal{C}^1\) sur tout intervalle où \(f\) est continue.
Là où \(f\) est continue, \(F_X(x) = \int_{-\infty}^{x} f(t)\,\mathrm{d}t\) est une primitive de \(f\) par le théorème fondamental de l'analyse, donc y est \(\mathcal{C}^1\) de dérivée \(f\).
Proposition — Caractérisation par la fonction de répartition
Si la fonction de répartition \(F_X\) de \(X\) est continue sur \(\mathbb{R}\) et \(\mathcal{C}^1\) sauf en un nombre fini de points, alors \(X\) admet une densité, à savoir \(f = F_X'\) (les valeurs aux points exceptionnels étant choisies arbitrairement \(\ge 0\)). Admis. Méthode — Loi d'une variable transformée par la fonction de répartition
On calcule \(F_{u(X)}(y) = P(u(X) \le y)\), en réécrivant l'événement en fonction de \(X\) pour l'exprimer avec \(F_X\). On vérifie que le résultat est continu sur \(\mathbb{R}\) et \(\mathcal{C}^1\) sauf en un nombre fini de points, puis on dérive pour obtenir une densité de \(u(X)\). Proposition — Densité d'une transformée affine
Si \(X\) admet la densité \(f\) et \(a \ne 0\), \(b \in \mathbb{R}\), alors \(aX + b\) admet la densité $$g(x) = \frac{1}{|a|}\, f\!\left( \frac{x - b}{a} \right).$$
Si \(a > 0\), alors \(aX + b \le x \Leftrightarrow X \le \frac{x - b}{a}\), donc $$F_{aX+b}(x) = F_X\!\left( \tfrac{x-b}{a} \right), \qquad g(x) = \tfrac{1}{a}\, f\!\left( \tfrac{x-b}{a} \right) \text{ (on dérive).}$$ Si \(a < 0\), l'inégalité se renverse : \(aX + b \le x \Leftrightarrow X \ge \frac{x - b}{a}\), donc (avec \(P(X = \cdot) = 0\)) $$\begin{aligned} F_{aX+b}(x) &= 1 - F_X\!\left( \tfrac{x-b}{a} \right) && \text{(complémentaire)} \\
g(x) &= -\tfrac{1}{a}\, f\!\left( \tfrac{x-b}{a} \right) && \text{(on dérive).} \end{aligned}$$ Dans les deux cas le facteur est \(\frac{1}{|a|}\). (On dérive là où \(f\) est continue ; les valeurs de la densité aux points restants, en nombre fini, sont choisies arbitrairement \(\ge 0\).)
Exemple
Si \(X\) admet la densité \(f\), alors \(Y = e^X\) vérifie, pour \(y > 0\), \(F_Y(y) = P(e^X \le y) = P(X \le \ln y) = F_X(\ln y)\), d'où une densité \(g(y) = \frac{1}{y} f(\ln y)\) sur \(]0, +\infty[\) et \(g(y) = 0\) pour \(y \le 0\). Proposition — Indépendance et extrêmes (rappel)
Des variables à densité \(X, Y\) sont indépendantes si les événements \((X \le x)\) et \((Y \le y)\) sont indépendants pour tous \(x, y\) ; les sous-familles et le lemme des coalitions se transposent (cadre admis). Pour des variables mutuellement indépendantes et tout réel \(t\), $$P(\max(X_1, \dots, X_n) \le t) = \prod_i F_{X_i}(t), \qquad P(\min(X_1, \dots, X_n) > t) = \prod_i \big(1 - F_{X_i}(t)\big).$$ Compétences à pratiquer
- Transformations et extrêmes
II
Espérance, variance et concentration
II.1
Espérance, transfert et Markov
L'espérance est désormais une intégrale \(\int x f(x)\, \mathrm{d}x\) à la place de la somme \(\sum_k x_k P(X = x_k)\). Comme avant elle n'existe que si l'intégrale converge absolument ; le théorème de transfert calcule alors la moyenne de toute fonction de \(X\) directement à partir de la densité.
Définition — Espérance
Si \(X\) admet la densité \(f\) et \(\int_{-\infty}^{+\infty} |x|\, f(x)\, \mathrm{d}x\) converge, \(X\) admet une espérance $$\mathbb{E}(X) = \int_{-\infty}^{+\infty} x\, f(x)\, \mathrm{d}x.$$ Théorème — Théorème de transfert
Si \(X\) admet la densité \(f\) et \(\varphi\) est continue (sauf en un nombre fini de points) sur un intervalle \(I\) hors duquel \(f\) est nulle, alors \(\varphi(X)\) admet une espérance si et seulement si \(\int_{-\infty}^{+\infty} |\varphi(x)|\, f(x)\, \mathrm{d}x\) converge, et alors $$\mathbb{E}(\varphi(X)) = \int_{-\infty}^{+\infty} \varphi(x)\, f(x)\, \mathrm{d}x.$$ Admis. Proposition — Propriétés de l'espérance
Pour des variables admettant une espérance : linéarité \(\mathbb{E}(aX + bY) = a\mathbb{E}(X) + b\mathbb{E}(Y)\) (admise) ; positivité \(X \ge 0 \Rightarrow \mathbb{E}(X) \ge 0\) ; croissance \(X \le Y \Rightarrow \mathbb{E}(X) \le \mathbb{E}(Y)\) ; et \(|\mathbb{E}(X)| \le \mathbb{E}(|X|)\).
Positivité : si \(X \ge 0\), l'intégrale de sa densité sur \(]-\infty, 0[\) est nulle, donc \(\mathbb{E}(X) = \int_0^{+\infty} x f(x)\, \mathrm{d}x \ge 0\) comme intégrale d'une fonction positive. La croissance suit alors de la positivité et de la linéarité admise (on applique la positivité à \(Y - X \ge 0\)) ; et \(-|X| \le X \le |X|\) donne, de nouveau par linéarité, \(-\mathbb{E}(|X|) \le \mathbb{E}(X) \le \mathbb{E}(|X|)\), i.e. \(|\mathbb{E}(X)| \le \mathbb{E}(|X|)\).
Théorème — Inégalité de Markov
Pour \(X \ge 0\) admettant une espérance et tout \(a > 0\), \(\;P(X \ge a) \le \dfrac{\mathbb{E}(X)}{a}\).
Soit \(f\) une densité de \(X\), nulle sur \(]-\infty, 0[\). Pour \(x \ge a\) on a \(1 \le x/a\), donc $$P(X \ge a) = \int_a^{+\infty} f(x)\, \mathrm{d}x \le \int_a^{+\infty} \frac{x}{a}\, f(x)\, \mathrm{d}x \le \frac{1}{a}\int_0^{+\infty} x\, f(x)\, \mathrm{d}x = \frac{\mathbb{E}(X)}{a}.$$
Méthode — Calculer une espérance
On utilise le théorème de transfert \(\int \varphi(x) f(x)\, \mathrm{d}x\) pour \(\mathbb{E}(\varphi(X))\), ou on décompose \(X\) et on utilise la linéarité. On vérifie toujours d'abord la convergence absolue de l'intégrale. Exemple
Une variable à support borné admet des moments de tout ordre : si une densité \(f\) est nulle hors de \([-M, M]\), alors \(\int |x|^n f(x)\, \mathrm{d}x = \int_{-M}^{M} |x|^n f(x)\, \mathrm{d}x \le M^n \int_{-M}^{M} f(t)\,\mathrm{d}t = M^n\) converge pour tout \(n\). Compétences à pratiquer
- Calculer des espérances
II.2
Variance, moments et Bienaymé-Tchebychev
La variance mesure la dispersion de \(X\) autour de sa moyenne, exactement comme pour les variables discrètes. König-Huygens en donne un calcul rapide, et Bienaymé-Tchebychev la transforme en une borne sur les écarts — les énoncés sont identiques au cas discret.
Définition — Moments, variance et écart-type
Pour \(r \in \mathbb{N}^*\) le moment d'ordre \(r\) est \(\mathbb{E}(X^r)\) (quand il existe). Si \(\mathbb{E}(X^2)\) existe (ce qui force aussi \(\mathbb{E}(X)\) à exister, un moment d'ordre \(2\) entraînant le moment d'ordre \(1\)), la variance est \(\mathrm{Var}(X) = \mathbb{E}\big((X - \mathbb{E}(X))^2\big)\) et l'écart-type est \(\sigma(X) = \sqrt{\mathrm{Var}(X)}\). Proposition — König-Huygens et transformation affine
Si \(\mathbb{E}(X^2)\) existe alors \(\mathrm{Var}(X) = \mathbb{E}(X^2) - \mathbb{E}(X)^2\), et pour \(a, b \in \mathbb{R}\), \(\mathrm{Var}(aX + b) = a^2\, \mathrm{Var}(X)\).
On développe et on utilise la linéarité, \(\mathbb{E}(X)\) étant constante : $$\begin{aligned} \mathrm{Var}(X) &= \mathbb{E}\big( X^2 - 2X\,\mathbb{E}(X) + \mathbb{E}(X)^2 \big) && \text{(on développe)} \\
&= \mathbb{E}(X^2) - 2\mathbb{E}(X)^2 + \mathbb{E}(X)^2 = \mathbb{E}(X^2) - \mathbb{E}(X)^2. \end{aligned}$$ Pour la transformation affine, \(aX + b - \mathbb{E}(aX + b) = a(X - \mathbb{E}(X))\), donc \(\mathrm{Var}(aX + b) = \mathbb{E}(a^2 (X - \mathbb{E}(X))^2) = a^2 \mathrm{Var}(X)\).
Définition — Variable centrée réduite
Si \(\mathbb{E}(X^2)\) existe avec \(\sigma(X) > 0\), la variable centrée réduite est \(X^* = \dfrac{X - \mathbb{E}(X)}{\sigma(X)}\), d'espérance \(0\) et de variance \(1\). Théorème — Inégalité de Bienaymé-Tchebychev
Si \(\mathbb{E}(X^2)\) existe alors pour tout \(\varepsilon > 0\), \(\;P\big(|X - \mathbb{E}(X)| \ge \varepsilon\big) \le \dfrac{\mathrm{Var}(X)}{\varepsilon^2}\).
On applique l'inégalité de Markov à la variable positive \((X - \mathbb{E}(X))^2\) au niveau \(\varepsilon^2\) : \(P((X - \mathbb{E}(X))^2 \ge \varepsilon^2) \le \mathbb{E}((X - \mathbb{E}(X))^2)/\varepsilon^2 = \mathrm{Var}(X)/\varepsilon^2\), et \((X - \mathbb{E}(X))^2 \ge \varepsilon^2 \Leftrightarrow |X - \mathbb{E}(X)| \ge \varepsilon\).
Compétences à pratiquer
- Variance et bornes d'écart
III
Les lois continues usuelles et sommes
III.1
Lois uniforme et exponentielle
Deux modèles continus de base : la loi uniforme d'un nombre tiré au hasard dans un intervalle (densité constante), et la loi exponentielle d'un temps d'attente sans mémoire (densité décroissante). 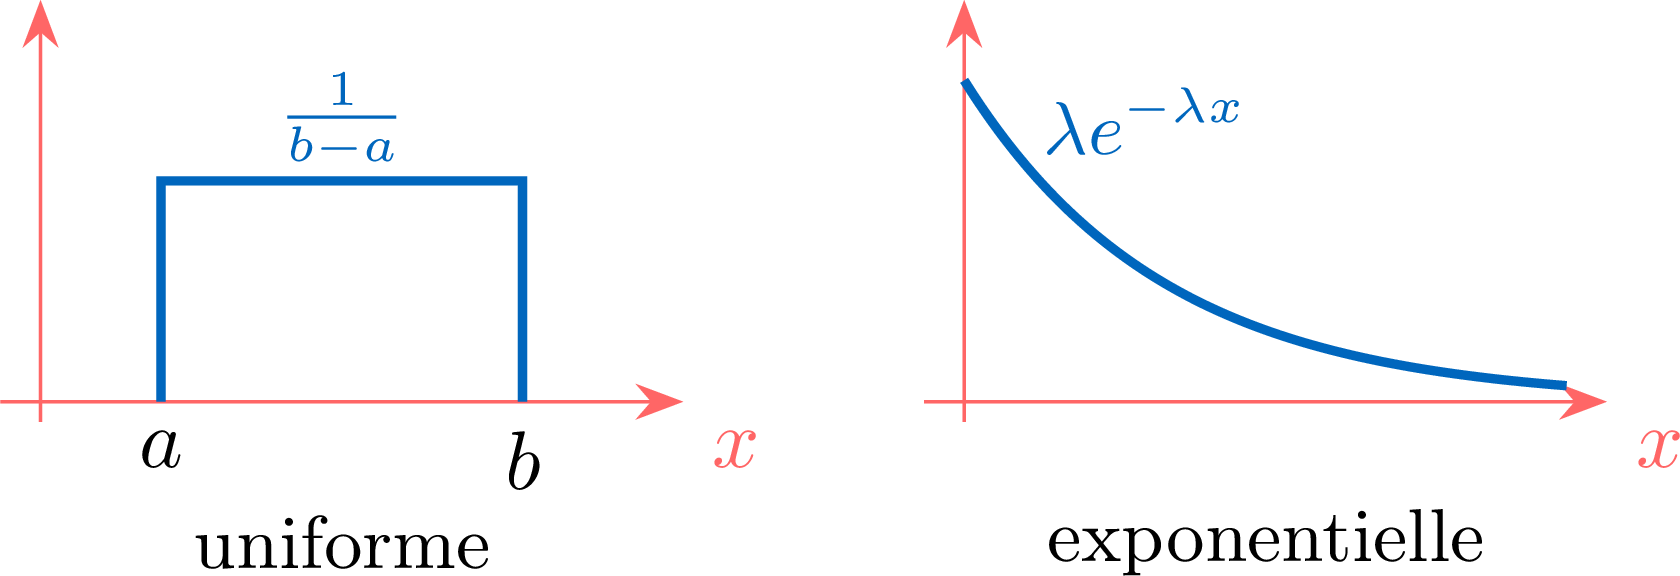
Définition — Loi uniforme
Pour \(a < b\), \(X\) suit la loi uniforme sur \([a, b]\), notée \(X \sim \mathcal{U}([a,b])\), si elle admet la densité \(f(t) = \frac{1}{b - a}\) sur \([a, b]\) et \(0\) ailleurs. Sa fonction de répartition est la rampe \(F(x) = \frac{x - a}{b - a}\) sur \([a, b]\) (avec \(0\) en dessous, \(1\) au-dessus). Proposition — Espérance et variance de la loi uniforme
Si \(X \sim \mathcal{U}([a,b])\) alors \(\mathbb{E}(X) = \dfrac{a + b}{2}\) et \(\mathrm{Var}(X) = \dfrac{(b - a)^2}{12}\).
Le support est borné, donc tous les moments existent. Par intégration, $$\begin{aligned} \mathbb{E}(X) &= \int_a^b \frac{x}{b - a}\, \mathrm{d}x = \frac{1}{b-a}\Big[ \frac{x^2}{2} \Big]_a^b = \frac{b^2 - a^2}{2(b-a)} = \frac{a + b}{2}, \\
\mathbb{E}(X^2) &= \int_a^b \frac{x^2}{b - a}\, \mathrm{d}x = \frac{b^3 - a^3}{3(b-a)} = \frac{a^2 + ab + b^2}{3}. \end{aligned}$$ Puis par König-Huygens, $$\mathrm{Var}(X) = \frac{a^2 + ab + b^2}{3} - \frac{(a + b)^2}{4} = \frac{a^2 - 2ab + b^2}{12} = \frac{(b - a)^2}{12}.$$
Définition — Loi exponentielle
Pour \(\lambda > 0\), \(X\) suit la loi exponentielle de paramètre \(\lambda\), notée \(X \sim \mathcal{E}(\lambda)\), si elle admet la densité \(f(t) = \lambda e^{-\lambda t}\) pour \(t \ge 0\) et \(0\) pour \(t < 0\). Sa fonction de répartition est \(F(x) = 1 - e^{-\lambda x}\) pour \(x \ge 0\) et \(0\) pour \(x < 0\). Proposition — Espérance et variance de la loi exponentielle
Si \(X \sim \mathcal{E}(\lambda)\) alors \(\mathbb{E}(X) = \dfrac{1}{\lambda}\) et \(\mathrm{Var}(X) = \dfrac{1}{\lambda^2}\).
Par intégration par parties (\(u = t\), \(v' = \lambda e^{-\lambda t}\), \(v = -e^{-\lambda t}\)), $$\begin{aligned} \mathbb{E}(X) &= \int_0^{+\infty} t\, \lambda e^{-\lambda t}\, \mathrm{d}t = \Big[ -t e^{-\lambda t} \Big]_0^{+\infty} + \int_0^{+\infty} e^{-\lambda t}\, \mathrm{d}t && \text{(parties)} \\
&= 0 + \Big[ -\tfrac{1}{\lambda} e^{-\lambda t} \Big]_0^{+\infty} = \frac{1}{\lambda}. \end{aligned}$$ De même, avec \(u = t^2\), $$\begin{aligned} \mathbb{E}(X^2) &= \int_0^{+\infty} t^2\, \lambda e^{-\lambda t}\, \mathrm{d}t = \Big[ -t^2 e^{-\lambda t} \Big]_0^{+\infty} + \int_0^{+\infty} 2t\, e^{-\lambda t}\, \mathrm{d}t && \text{(parties)} \\
&= 0 + \frac{2}{\lambda}\int_0^{+\infty} \lambda t\, e^{-\lambda t}\, \mathrm{d}t = \frac{2}{\lambda}\cdot\frac{1}{\lambda} = \frac{2}{\lambda^2}. \end{aligned}$$ D'où \(\mathrm{Var}(X) = \mathbb{E}(X^2) - \mathbb{E}(X)^2 = \frac{2}{\lambda^2} - \frac{1}{\lambda^2} = \frac{1}{\lambda^2}\).
Proposition — Absence de mémoire
Si \(X \sim \mathcal{E}(\lambda)\) alors pour tous \(s, t \ge 0\), \(\;P_{X > s}(X > t + s) = P(X > t)\).
Pour \(x \ge 0\), \(P(X > x) = 1 - F(x) = e^{-\lambda x}\). Comme \(t, s \ge 0\), \((X > t + s) \subset (X > s)\), donc $$P_{X > s}(X > t + s) = \frac{P(X > t + s)}{P(X > s)} = \frac{e^{-\lambda(t + s)}}{e^{-\lambda s}} = e^{-\lambda t} = P(X > t).$$ Un temps d'attente déjà écoulé est oublié : la loi de l'attente restante ne dépend pas de \(s\).
Exemple
La durée de vie d'un composant est modélisée par \(X \sim \mathcal{E}(0{,}5)\) (années). Alors \(\mathbb{E}(X) = 1/0{,}5 = 2\) ans, et \(P(X > 3) = e^{-0{,}5 \cdot 3} = e^{-1{,}5} \approx 0{,}22\). Compétences à pratiquer
- Calculs uniforme et exponentielle
III.2
La loi normale
La loi normale (ou gaussienne) est la courbe en cloche. C'est le modèle central du chapitre suivant, où les sommes de nombreuses variables indépendantes tendent vers elle. Centrer-réduire toute variable normale la ramène à la normale centrée réduite \(\mathcal{N}(0, 1)\), dont la fonction de répartition \(\Phi\) est tabulée. 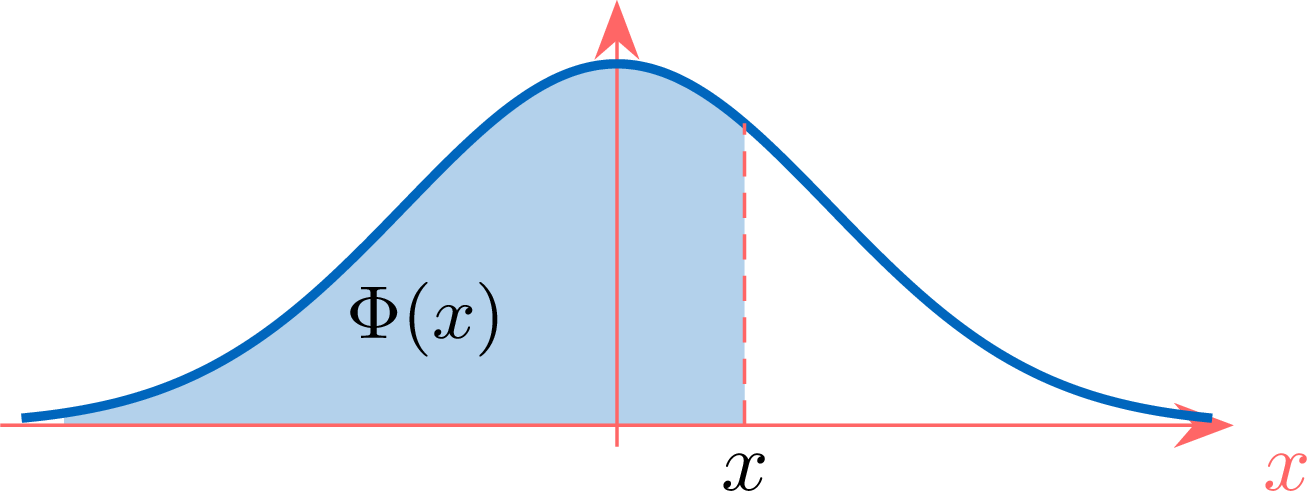
Définition — Loi normale centrée réduite
\(X\) suit la loi normale centrée réduite \(\mathcal{N}(0, 1)\) si elle admet la densité \(f(t) = \frac{1}{\sqrt{2\pi}} e^{-t^2/2}\) (c'est une densité : \(\int_{\mathbb{R}} f = 1\), admis). Sa fonction de répartition est notée \(\Phi\). Proposition — Symétrie et moments de la normale centrée réduite
Si \(X \sim \mathcal{N}(0, 1)\) alors \(\Phi(-x) = 1 - \Phi(x)\), et pour \(x \ge 0\), \(P(|X| \le x) = 2\Phi(x) - 1\). De plus \(\mathbb{E}(X) = 0\) et \(\mathrm{Var}(X) = 1\).
La densité est paire, donc son graphe est symétrique par rapport à \(0\), ce qui donne \(\Phi(-x) = 1 - \Phi(x)\) ; puis pour \(x \ge 0\), \(P(|X| \le x) = \Phi(x) - \Phi(-x) = 2\Phi(x) - 1\). Pour la moyenne, l'intégrale converge d'abord absolument : \(\int_0^{+\infty} t e^{-t^2/2}\, \mathrm{d}t = [-e^{-t^2/2}]_0^{+\infty} = 1\), donc \(\int_{\mathbb{R}} |t| e^{-t^2/2}\, \mathrm{d}t = 2 < \infty\) et \(\mathbb{E}(X)\) existe. L'intégrande \(t e^{-t^2/2}\) est impair, donc \(\mathbb{E}(X) = \frac{1}{\sqrt{2\pi}}\int_{\mathbb{R}} t e^{-t^2/2}\, \mathrm{d}t = 0\). La valeur \(\mathrm{Var}(X) = 1\) est admise (elle vient d'une intégration par parties).
Définition — Loi normale générale
Pour \(\mu \in \mathbb{R}\) et \(\sigma > 0\), \(X\) suit la loi normale \(\mathcal{N}(\mu, \sigma^2)\) si elle admet la densité \(f(t) = \frac{1}{\sigma\sqrt{2\pi}} e^{-\frac12\left(\frac{t - \mu}{\sigma}\right)^2}\) (que ce soit une densité découle de la normale centrée réduite par la formule de changement affine ci-dessous). Proposition — Standardisation, image affine, moments
Si \(X \sim \mathcal{N}(\mu, \sigma^2)\) alors \(Z = \dfrac{X - \mu}{\sigma} \sim \mathcal{N}(0, 1)\) ; par conséquent \(\mathbb{E}(X) = \mu\) et \(\mathrm{Var}(X) = \sigma^2\). Plus généralement, pour \(a \ne 0\), \(aX + b \sim \mathcal{N}(a\mu + b,\, a^2\sigma^2)\).
On applique la densité de \(aX + b\) avec \(a = \frac{1}{\sigma}\), \(b = -\frac{\mu}{\sigma}\) : une densité de \(Z = \frac{X - \mu}{\sigma}\) est \(\sigma f(\sigma z + \mu) = \frac{1}{\sqrt{2\pi}} e^{-z^2/2}\), la densité normale centrée réduite, donc \(Z \sim \mathcal{N}(0, 1)\). Puis \(X = \sigma Z + \mu\) donne \(\mathbb{E}(X) = \sigma \cdot 0 + \mu = \mu\) et \(\mathrm{Var}(X) = \sigma^2 \cdot 1 = \sigma^2\). L'image affine est le même calcul.
Méthode — Calculer une probabilité normale
Pour calculer \(P(a \le X \le b)\) pour \(X \sim \mathcal{N}(\mu, \sigma^2)\), on standardise : \(P\left( \frac{a - \mu}{\sigma} \le Z \le \frac{b - \mu}{\sigma} \right) = \Phi\!\left( \frac{b - \mu}{\sigma} \right) - \Phi\!\left( \frac{a - \mu}{\sigma} \right)\), puis on lit \(\Phi\) dans la table ou à la calculatrice. Exemple
Pour \(X \sim \mathcal{N}(1, 4)\) (donc \(\mu = 1\), \(\sigma = 2\)), \(P(-2 \le X \le 3) = \Phi\!\left( \frac{3 - 1}{2} \right) - \Phi\!\left( \frac{-2 - 1}{2} \right) = \Phi(1) - \Phi(-1{,}5) \approx 0{,}841 - 0{,}067 = 0{,}774\). Compétences à pratiquer
- Standardiser et lire \(\Phi\)
III.3
Sommes de variables à densité indépendantes
La somme de deux variables à densité indépendantes admet encore une densité, donnée par la convolution des deux densités. Démontrer la convergence dépasse ce cours ; ce qui compte est le résultat et, pour les normales, la règle simple sur les paramètres.
Proposition — Indépendance, espérance d'un produit et variance d'une somme
Si \(X, Y\) sont indépendantes et admettent une variance, alors (comme dans le cas discret, admis) $$\mathbb{E}(XY) = \mathbb{E}(X)\,\mathbb{E}(Y), \qquad \mathrm{Var}(X + Y) = \mathrm{Var}(X) + \mathrm{Var}(Y).$$ Proposition — Convolution
Si \(X, Y\) sont indépendantes de densités \(f, g\), alors \(X + Y\) admet une densité donnée par la convolution $$h(x) = \int_{-\infty}^{+\infty} f(t)\, g(x - t)\, \mathrm{d}t,$$ cette intégrale convergeant pour presque tout \(x\). Admis. Proposition — Somme de variables normales indépendantes
Si \(X \sim \mathcal{N}(\mu_1, \sigma_1^2)\) et \(Y \sim \mathcal{N}(\mu_2, \sigma_2^2)\) sont indépendantes, alors \(X + Y \sim \mathcal{N}(\mu_1 + \mu_2,\, \sigma_1^2 + \sigma_2^2)\). Admis. Méthode — Somme de normales indépendantes
Pour des variables normales indépendantes, on ajoute simplement les moyennes et on ajoute les variances — aucune intégrale n'est nécessaire. (De façon cohérente avec la linéarité, \(\mathbb{E}(X + Y) = \mu_1 + \mu_2\) et, par indépendance, \(\mathrm{Var}(X + Y) = \sigma_1^2 + \sigma_2^2\).) Exemple
Si \(X \sim \mathcal{N}(0, 1)\) et \(Y \sim \mathcal{N}(0, 1)\) sont indépendantes, alors \(X + Y \sim \mathcal{N}(0, 2)\). Par symétrie de la cloche autour de sa moyenne \(0\), \(P(X + Y \le 0) = \tfrac12\). Compétences à pratiquer
- Sommes de variables normales
- Synthèse
Aller à la section