Éducation Nationale Française · BCPST 2
Couples de variables aléatoires discrètes
On observe rarement une expérience isolément : on compte deux espèces dans le même relevé, on lance deux dés, on observe un nombre d'œufs puis combien éclosent. Un couple \((X, Y)\) de variables aléatoires discrètes enregistre les deux à la fois. Sa loi conjointe donne les probabilités \(P(X = x, Y = y)\) ; sommer une ligne ou une colonne redonne la loi marginale de \(X\) ou de \(Y\), et fixer une variable donne une loi conditionnelle. À partir du couple on construit un seul nombre \(Z = u(X, Y)\) — une somme, un maximum, un minimum — dont la loi se lit sur la loi conjointe. Enfin la covariance mesure si \(X\) et \(Y\) ont tendance à varier ensemble ; elle contrôle la variance d'une somme, et s'annule dès que \(X\) et \(Y\) sont indépendantes. Tout prolonge la variable discrète unique du chapitre précédent, l'ingrédient nouveau étant la loi conjointe des deux.
I
Lois conjointe, marginales et conditionnelles
I.1
Loi conjointe et lois marginales
Un couple \((X, Y)\) associe à chaque issue deux nombres à la fois. Sa loi conjointe donne les probabilités de toutes les combinaisons de valeurs \((x, y)\). Lorsque les deux variables prennent un nombre fini de valeurs, la loi conjointe se présente le plus clairement dans un tableau à double entrée : une ligne par valeur de \(X\), une colonne par valeur de \(Y\), la case contenant \(P(X = x, Y = y)\). 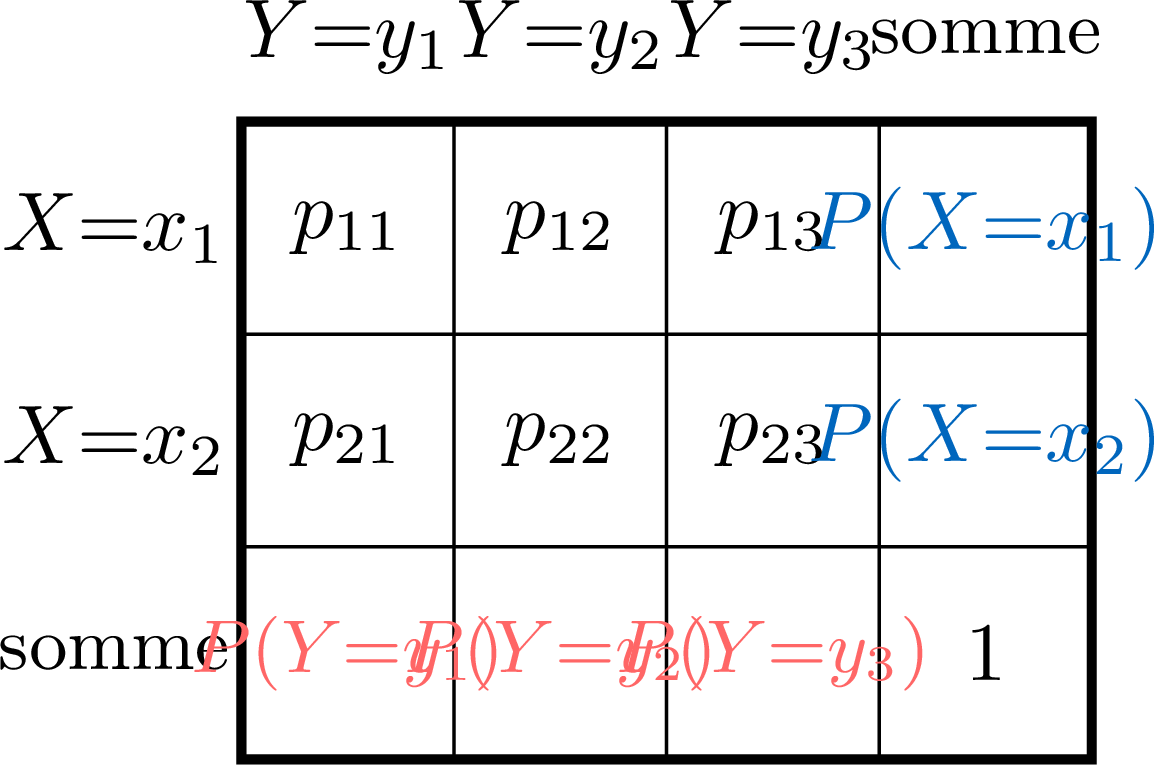
Définition — Couple et loi conjointe
Un couple de variables aléatoires discrètes est un couple \((X, Y)\) de variables discrètes sur le même espace probabilisé. Sa loi conjointe est la donnée des probabilités $$P(X = x, Y = y) = P\big((X = x) \cap (Y = y)\big), \qquad x \in X(\Omega),\ y \in Y(\Omega).$$ Le support du couple est l'ensemble des \((x, y)\) avec \(P(X = x, Y = y) > 0\) ; il est contenu dans \(X(\Omega) \times Y(\Omega)\). Exemple
Une loi conjointe concrète de \((X, Y)\) avec \(X \in \{0, 1\}\) et \(Y \in \{0, 1\}\) est donnée par le tableau \(P(0,0) = 0{,}1\), \(P(0,1) = 0{,}2\), \(P(1,0) = 0{,}3\), \(P(1,1) = 0{,}4\). Les quatre cases sont positives et somment à \(0{,}1 + 0{,}2 + 0{,}3 + 0{,}4 = 1\), donc c'est une loi conjointe valide ; on lit toute probabilité conjointe directement sur le tableau, par exemple \(P(X = 1, Y = 0) = 0{,}3\). Proposition — Système complet associé à un couple
Les événements \(\big((X = x_i) \cap (Y = y_j)\big)\), pour \((i, j)\) parcourant les indices de valeurs (en nombre au plus dénombrable), forment un système complet d'événements : ils sont deux à deux incompatibles et leur réunion est \(\Omega\). En particulier \(\sum_{i, j} P(X = x_i, Y = y_j) = 1\).
Deux cases distinctes \((i, j) \ne (i', j')\) diffèrent en \(X\) ou en \(Y\), donc les événements \((X = x_i) \cap (Y = y_j)\) et \((X = x_{i'}) \cap (Y = y_{j'})\) sont incompatibles. Pour toute issue \(\omega\), \(X(\omega)\) est un certain \(x_i\) et \(Y(\omega)\) un certain \(y_j\), donc \(\omega\) est dans exactement une case : la réunion est \(\Omega\). Les probabilités d'un système complet somment à \(1\).
Définition — Lois marginales
La loi de \(X\) est la première loi marginale du couple, et la loi de \(Y\) la deuxième loi marginale. Proposition — Marginales à partir de la loi conjointe
Les lois marginales se retrouvent à partir de la loi conjointe en sommant sur l'autre variable : $$P(X = x_i) = \sum_j P(X = x_i, Y = y_j), \qquad P(Y = y_j) = \sum_i P(X = x_i, Y = y_j).$$
Les événements \((Y = y_j)\) forment un système complet, donc par la décomposition par probabilités totales de \((X = x_i)\), $$\begin{aligned} P(X = x_i) &= P\Big( (X = x_i) \cap \bigsqcup_j (Y = y_j) \Big) && \text{(\((Y=y_j)\) système complet)} \\
&= \sum_j P\big( (X = x_i) \cap (Y = y_j) \big) && \text{(\(\sigma\)-additivité)} \\
&= \sum_j P(X = x_i, Y = y_j). \end{aligned}$$ La formule pour \(Y\) s'obtient en échangeant les rôles.
Méthode — Lire les marginales sur le tableau
Dans un tableau à double entrée, la loi marginale de \(X\) est la colonne des sommes par ligne, et la loi marginale de \(Y\) la ligne des sommes par colonne. Le total général vaut \(1\). Deux lois conjointes différentes peuvent avoir les mêmes marginales : les marginales ne déterminent pas la loi conjointe. Exemple
Pour le tableau de lignes \(X \in \{0, 1\}\) et colonnes \(Y \in \{0, 1, 2\}\) et de cases toutes égales à \(\tfrac{1}{6}\), la première marginale vaut \(P(X = 0) = P(X = 1) = \tfrac{3}{6} = \tfrac12\) (chaque ligne somme à \(\tfrac12\)), et la seconde \(P(Y = j) = \tfrac{2}{6} = \tfrac13\) pour \(j = 0, 1, 2\) (chaque colonne somme à \(\tfrac13\)). Compétences à pratiquer
- Lire et vérifier un tableau conjoint
- Lois marginales
I.2
Lois conditionnelles
Sachant que \(Y\) a pris la valeur \(y\), les probabilités des valeurs de \(X\) sont renormalisées par \(P(Y = y)\). Cette loi conditionnelle de \(X\) sachant \(Y = y\) réutilise la probabilité conditionnelle du chapitre précédent, valeur par valeur. Croisée avec une marginale, elle reconstruit toute la loi conjointe.
Définition — Loi conditionnelle
Pour \(y\) avec \(P(Y = y) \ne 0\), la loi conditionnelle de \(X\) sachant \(Y = y\) est l'application sur \(X(\Omega)\) $$x \in X(\Omega) \longmapsto P_{Y = y}(X = x) = \frac{P(X = x, Y = y)}{P(Y = y)}.$$ Symétriquement, pour \(x\) avec \(P(X = x) \ne 0\), la loi conditionnelle de \(Y\) sachant \(X = x\) est \(y \mapsto P(X = x, Y = y)/P(X = x)\). Chacune est une vraie loi : ses valeurs sont positives et somment à \(1\). Exemple
Dans le tableau précédent (toutes les cases \(\tfrac16\)), la loi conditionnelle de \(X\) sachant \(Y = 0\) vaut \(P_{Y=0}(X = x) = \tfrac{1/6}{1/3} = \tfrac12\) pour \(x = 0\) et \(x = 1\) : sachant \(Y = 0\), \(X\) est uniforme sur \(\{0, 1\}\). Les deux valeurs somment à \(1\). Proposition — Loi conjointe à partir d'une marginale et d'une conditionnelle
Pour \(y\) avec \(P(Y = y) \ne 0\), $$P(X = x, Y = y) = P(Y = y)\, P_{Y = y}(X = x).$$ Ainsi une loi marginale de \(Y\) et toutes les lois conditionnelles de \(X\) sachant \(Y = y\) déterminent la loi conjointe (et donc, en sommant, la marginale de \(X\)). Méthode — Construire une loi conjointe en deux temps
Lorsqu'une expérience se déroule en deux temps — d'abord \(Y\), puis \(X\) selon le résultat de \(Y\) — on lit la marginale de \(Y\) et la loi conditionnelle de \(X\) sachant chaque valeur de \(Y\), puis on multiplie : \(P(X = x, Y = y) = P(Y = y)\,P_{Y = y}(X = x)\). Sommer la colonne \(y\) redonne \(P(Y = y)\) ; sommer la ligne \(x\) donne la marginale de \(X\). Exemple
Une ponte compte \(Y\) œufs avec \(P(Y = 2) = P(Y = 3) = \tfrac12\), et chaque œuf éclot indépendamment avec probabilité \(\tfrac12\), donc sachant \(Y = n\) le nombre \(X\) d'éclosions suit une loi binomiale \(\mathcal{B}(n, \tfrac12)\). Alors, par exemple, \(P(X = 1, Y = 2) = P(Y = 2)\,P_{Y=2}(X = 1) = \tfrac12 \cdot \binom{2}{1}(\tfrac12)^2 = \tfrac14\). Compétences à pratiquer
- Calculer une loi conditionnelle
II
Fonctions d'un couple et sommes
II.1
Loi d'une fonction, maximum et minimum
Un couple alimente un seul nombre \(Z = u(X, Y)\) : une somme \(X + Y\), un produit \(XY\), un maximum ou un minimum. Sa loi s'obtient en regroupant toutes les cases \((x, y)\) qui produisent la même valeur \(z\). Pour le maximum et le minimum, il est plus rapide de passer par la fonction de répartition, surtout lorsque les variables sont indépendantes. Rappelons d'abord ce que signifie l'indépendance pour un couple.
Définition — Indépendance d'un couple (rappel)
\(X\) et \(Y\) sont indépendantes si \(P(X = x, Y = y) = P(X = x)\,P(Y = y)\) pour toutes valeurs \(x, y\). Des variables \(X_1, \dots, X_n\) sont mutuellement indépendantes si \(P(X_1 = x_1, \dots, X_n = x_n) = \prod_{i} P(X_i = x_i)\) pour tout choix de valeurs. Proposition — Loi d'une fonction d'un couple
Pour une fonction \(u\) définie sur \(X(\Omega) \times Y(\Omega)\), \(Z = u(X, Y)\) est une variable aléatoire discrète (admis), et sa loi s'obtient par regroupement : $$P(Z = z) = \sum_{(x, y)\,:\,u(x, y) = z} P(X = x, Y = y),$$ une seule somme sur le support (au plus dénombrable) du couple — les cases vérifiant \(u(x, y) = z\) partitionnent l'événement \((Z = z)\). Exemple
Pour le tableau tout-\(\tfrac16\) sur \(X \in \{0,1\}\), \(Y \in \{0,1,2\}\), la loi de \(Z = X + Y\) regroupe les cases de chaque diagonale \(x + y = z\) : \(P(Z = 0) = \tfrac16\), \(P(Z = 1) = \tfrac26\), \(P(Z = 2) = \tfrac26\), \(P(Z = 3) = \tfrac16\), de somme \(1\). Proposition — Maximum et minimum de variables indépendantes
Pour des variables mutuellement indépendantes \(X_1, \dots, X_n\) et tout réel \(t\), $$P\big(\max(X_1, \dots, X_n) \le t\big) = \prod_{i=1}^n P(X_i \le t), \qquad P\big(\min(X_1, \dots, X_n) \ge t\big) = \prod_{i=1}^n P(X_i \ge t).$$
Le maximum est \(\le t\) exactement lorsque tous les \(X_i\) sont \(\le t\), donc \((\max \le t) = \bigcap_i (X_i \le t)\). Comme chaque événement \((X_i \le t)\) ne dépend que de \(X_i\), l'indépendance mutuelle des \(X_i\) rend ces événements mutuellement indépendants (lemme des coalitions du chapitre précédent), donc la probabilité se factorise en \(\prod_i P(X_i \le t)\). De même \((\min \ge t) = \bigcap_i (X_i \ge t)\) donne \(\prod_i P(X_i \ge t)\).
Méthode — Loi d'un max ou d'un min
On calcule la fonction de répartition par la formule produit, puis pour des variables à valeurs entières on retrouve la loi de \(M = \max\) par le saut \(P(M = k) = P(M \le k) - P(M \le k - 1)\) (et de même pour le min via \(P(\min \ge k) - P(\min \ge k + 1)\)). Exemple
Pour deux dés équilibrés indépendants \(X, Y\) et \(M = \max(X, Y)\), \(P(M \le k) = (k/6)^2\) pour \(k \in \{1, \dots, 6\}\), donc \(P(M = k) = (k/6)^2 - ((k-1)/6)^2 = (2k - 1)/36\). Les six probabilités \(1, 3, 5, 7, 9, 11\) sur \(36\) somment à \(1\). Compétences à pratiquer
- Loi d'une fonction par regroupement
II.2
Somme de deux variables à valeurs entières et lois stables
La somme \(S = X + Y\) de deux variables à valeurs dans \(\mathbb{N}\) est la fonction d'un couple la plus courante. Sa loi est donnée par la formule de convolution, lue sur les antidiagonales \(x + y = k\) du support. Deux familles sont stables : une somme de binomiales indépendantes de même \(p\) est encore binomiale, et une somme de variables de Poisson indépendantes est encore de Poisson. 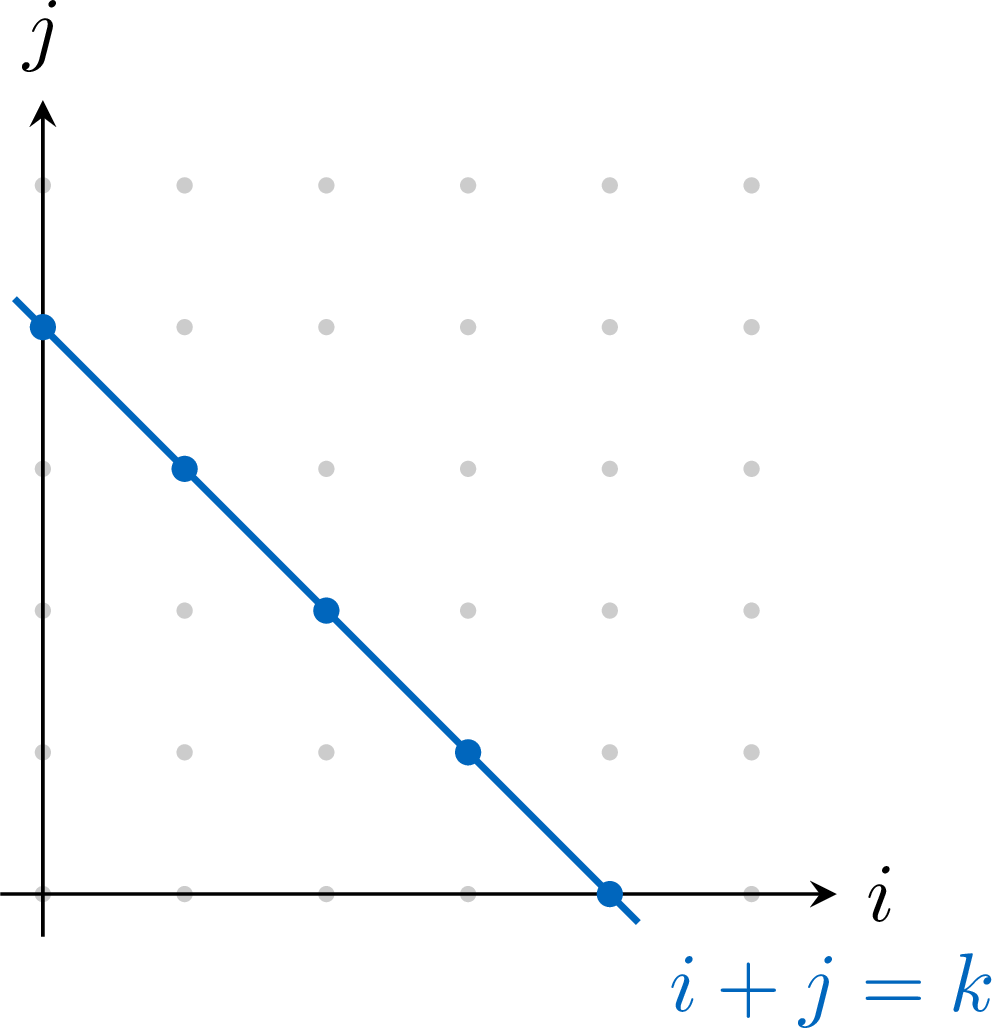
Proposition — Convolution
Si \(X\) et \(Y\) sont indépendantes à valeurs dans \(\mathbb{N}\), alors \(S = X + Y\) est à valeurs dans \(\mathbb{N}\) et, pour tout \(k \in \mathbb{N}\), $$P(X + Y = k) = \sum_{i=0}^{k} P(X = i)\,P(Y = k - i).$$
On partitionne l'événement \((X + Y = k)\) selon la valeur de \(X\) : comme \(Y = k - i \ge 0\) impose \(0 \le i \le k\), $$\begin{aligned} P(X + Y = k) &= P\Big( \bigsqcup_{i=0}^{k} (X = i) \cap (Y = k - i) \Big) && \text{(partition selon \(X = i\))} \\
&= \sum_{i=0}^{k} P(X = i,\, Y = k - i) && \text{(événements incompatibles)} \\
&= \sum_{i=0}^{k} P(X = i)\,P(Y = k - i) && \text{(indépendance).} \end{aligned}$$ C'est une seule somme (finie) — aucune série double n'intervient.
Méthode — Loi d'une somme par convolution
Pour trouver la loi de \(X + Y\) pour des variables indépendantes à valeurs dans \(\mathbb{N}\), on fixe \(k\) et on somme les produits \(P(X = i)P(Y = k - i)\) sur les valeurs \(i\) permises par les deux supports. Pour des variables à valeurs dans \(\mathbb{N}^*\) (par exemple des lois géométriques), la plus petite valeur de la somme est \(2\) et l'indice parcourt \(i = 1, \dots, k - 1\). Proposition — Stabilité de la loi binomiale (rappel)
Si \(X \sim \mathcal{B}(m, p)\) et \(Y \sim \mathcal{B}(n, p)\) sont indépendantes (même \(p\)), alors \(X + Y \sim \mathcal{B}(m + n, p)\). Admis (vu pour le comptage d'épreuves indépendantes en première année). Proposition — Stabilité de la loi de Poisson
Si \(X \sim \mathcal{P}(\lambda)\) et \(Y \sim \mathcal{P}(\mu)\) sont indépendantes, alors \(X + Y \sim \mathcal{P}(\lambda + \mu)\).
Par convolution, puis en factorisant \(e^{-(\lambda+\mu)}/k!\) et en utilisant la formule du binôme, $$\begin{aligned} P(X + Y = k) &= \sum_{i=0}^{k} e^{-\lambda}\frac{\lambda^i}{i!}\, e^{-\mu}\frac{\mu^{k-i}}{(k-i)!} && \text{(convolution de deux lois de Poisson)} \\
&= \frac{e^{-(\lambda+\mu)}}{k!} \sum_{i=0}^{k} \frac{k!}{i!\,(k-i)!}\, \lambda^i \mu^{k-i} && \text{(on insère \(k!/k!\))} \\
&= \frac{e^{-(\lambda+\mu)}}{k!} \sum_{i=0}^{k} \binom{k}{i} \lambda^i \mu^{k-i} \\
&= e^{-(\lambda+\mu)}\,\frac{(\lambda + \mu)^k}{k!} && \text{(formule du binôme).} \end{aligned}$$ C'est la loi de Poisson de paramètre \(\lambda + \mu\).
Exemple
Si \(X \sim \mathcal{P}(2)\) et \(Y \sim \mathcal{P}(3)\) sont indépendantes, alors \(X + Y \sim \mathcal{P}(5)\). Par exemple \(P(X + Y = 1) = e^{-5} \cdot 5 = 5 e^{-5} \approx 0{,}034\). Compétences à pratiquer
- Convolution et stabilité
III
Covariance
III.1
Théorème de transfert et espérance d'un produit
Pour moyenner une fonction \(g(X, Y)\) du couple — en particulier le produit \(XY\) — il n'est pas nécessaire de déterminer d'abord la loi de \(g(X, Y)\) : le théorème de transfert lit la moyenne directement sur la loi conjointe. À ce niveau on l'énonce pour des variables prenant un nombre fini de valeurs.
Théorème — Théorème de transfert (cas fini)
Soient \(X, Y\) des variables prenant un nombre fini de valeurs et \(g\) une fonction définie sur \(X(\Omega) \times Y(\Omega)\). Alors \(Z = g(X, Y)\) admet une espérance, donnée par $$\mathbb{E}\big(g(X, Y)\big) = \sum_i \sum_j g(x_i, y_j)\, P(X = x_i, Y = y_j).$$ Admis. Proposition — Espérance d'un produit (cas fini)
Pour \(X, Y\) prenant un nombre fini de valeurs, \(XY\) admet une espérance et $$\mathbb{E}(XY) = \sum_i \sum_j x_i\, y_j\, P(X = x_i, Y = y_j).$$
On applique le théorème de transfert à \(g(x, y) = xy\).
Méthode — Calculer l'espérance d'un produit sur le tableau
Pour un tableau conjoint fini, on multiplie chaque valeur de case \(x_i y_j\) par sa probabilité \(P(X = x_i, Y = y_j)\) et on somme. (Pour des variables à support infini, \(\mathbb{E}(XY)\) demanderait une série double, hors du cadre de ce cours ; les cas rencontrés ici sont soit finis, soit traités par l'indépendance ci-dessous.) Exemple
Pour le tableau tout-\(\tfrac16\) sur \(X \in \{0,1\}\), \(Y \in \{0,1,2\}\), $$\mathbb{E}(XY) = \sum_{i,j} x_i y_j \cdot \tfrac16 = \tfrac16\big(1\cdot 0 + 1 \cdot 1 + 1 \cdot 2\big) = \tfrac{3}{6} = \tfrac12,$$ les seuls termes non nuls étant ceux avec \(x = 1\). Compétences à pratiquer
- Espérance d'un produit
III.2
Covariance, König-Huygens et variance d'une somme
La covariance mesure si \(X\) et \(Y\) ont tendance à s'écarter de leurs moyennes dans le même sens. Elle généralise la variance — la covariance de \(X\) avec elle-même est sa variance — et la formule de König-Huygens la calcule à partir de \(\mathbb{E}(XY)\). Son usage principal est la variance d'une somme.
Définition — Covariance
Pour \(X, Y\) prenant un nombre fini de valeurs (plus généralement, toutes deux de variance finie pour que le produit ci-dessous ait une espérance), la covariance du couple est $$\mathrm{Cov}(X, Y) = \mathbb{E}\big( (X - \mathbb{E}(X))(Y - \mathbb{E}(Y)) \big).$$ Proposition — König-Huygens pour la covariance (cas fini)
Pour \(X, Y\) prenant un nombre fini de valeurs, $$\mathrm{Cov}(X, Y) = \mathbb{E}(XY) - \mathbb{E}(X)\,\mathbb{E}(Y).$$ La même formule vaut dès que \(\mathbb{E}(X)\), \(\mathbb{E}(Y)\) et \(\mathbb{E}(XY)\) existent tous (par exemple pour les lois infinies usuelles), et est alors admise ; seul le calcul effectif de \(\mathbb{E}(XY)\) dans le cas infini est hors du cadre de ce cours (il demanderait une série double).
On développe le produit et on utilise la linéarité de l'espérance (\(\mathbb{E}(X)\) et \(\mathbb{E}(Y)\) sont des constantes) : $$\begin{aligned} \mathrm{Cov}(X, Y) &= \mathbb{E}\big( XY - X\,\mathbb{E}(Y) - Y\,\mathbb{E}(X) + \mathbb{E}(X)\mathbb{E}(Y) \big) && \text{(on développe)} \\
&= \mathbb{E}(XY) - \mathbb{E}(X)\mathbb{E}(Y) - \mathbb{E}(Y)\mathbb{E}(X) + \mathbb{E}(X)\mathbb{E}(Y) && \text{(linéarité)} \\
&= \mathbb{E}(XY) - \mathbb{E}(X)\mathbb{E}(Y). \end{aligned}$$
Exemple
Pour le tableau tout-\(\tfrac16\), \(\mathbb{E}(XY) = \tfrac12\) (ci-dessus), \(\mathbb{E}(X) = \tfrac12\) et \(\mathbb{E}(Y) = 0\cdot\tfrac13 + 1\cdot\tfrac13 + 2\cdot\tfrac13 = 1\), donc \(\mathrm{Cov}(X, Y) = \tfrac12 - \tfrac12 \cdot 1 = 0\). Proposition — Propriétés de la covariance
Pour des variables \(X, X', Y\) toutes de variance finie : - \(\mathrm{Cov}(X, X) = \mathrm{Var}(X)\) et \(\mathrm{Cov}(X, Y) = \mathrm{Cov}(Y, X)\) (symétrie) ;
- \(\mathrm{Cov}(c, Y) = 0\) pour une constante \(c \in \mathbb{R}\) ;
- bilinéarité : pour tous \(\alpha, \beta \in \mathbb{R}\), \(\mathrm{Cov}(\alpha X + \beta X', Y) = \alpha\,\mathrm{Cov}(X, Y) + \beta\,\mathrm{Cov}(X', Y)\), et de même dans la seconde variable.
La symétrie est claire d'après la définition symétrique, et \(\mathrm{Cov}(X, X) = \mathbb{E}((X - \mathbb{E}(X))^2) = \mathrm{Var}(X)\). Une constante \(c\) vérifie \(c - \mathbb{E}(c) = 0\), donc \(\mathrm{Cov}(c, Y) = \mathbb{E}(0 \cdot (Y - \mathbb{E}(Y))) = 0\). La bilinéarité découle de König-Huygens et de la linéarité de l'espérance ; on l'admet dans le cas général.
Proposition — Variance d'une somme
Pour \(X, Y\) admettant une variance, $$\mathrm{Var}(X + Y) = \mathrm{Var}(X) + \mathrm{Var}(Y) + 2\,\mathrm{Cov}(X, Y).$$
Posons \(\mu_X = \mathbb{E}(X)\), \(\mu_Y = \mathbb{E}(Y)\), de sorte que \(\mathbb{E}(X + Y) = \mu_X + \mu_Y\). En développant le carré et par linéarité, $$\begin{aligned} \mathrm{Var}(X + Y) &= \mathbb{E}\big( ((X - \mu_X) + (Y - \mu_Y))^2 \big) && \text{(définition)} \\
&= \mathbb{E}\big( (X - \mu_X)^2 + (Y - \mu_Y)^2 + 2(X - \mu_X)(Y - \mu_Y) \big) && \text{(on développe)} \\
&= \mathrm{Var}(X) + \mathrm{Var}(Y) + 2\,\mathrm{Cov}(X, Y) && \text{(linéarité).} \end{aligned}$$
Méthode — Covariance par la demi-différence
Lorsque les variances de \(X\), \(Y\) et \(X + Y\) sont faciles à obtenir, la formule précédente donne la covariance comme \(\mathrm{Cov}(X, Y) = \tfrac12\big(\mathrm{Var}(X + Y) - \mathrm{Var}(X) - \mathrm{Var}(Y)\big)\). Compétences à pratiquer
- Covariance et variance d'une somme
III.3
Indépendance et covariance
Lorsque \(X\) et \(Y\) sont indépendantes, la moyenne de leur produit se factorise, donc la covariance s'annule et la variance de la somme est simplement la somme des variances. La réciproque est fausse : une covariance nulle n'impose pas l'indépendance.
Proposition — L'indépendance factorise le produit (cas fini)
Si \(X\) et \(Y\) prennent un nombre fini de valeurs et sont indépendantes, alors $$\mathbb{E}(XY) = \mathbb{E}(X)\,\mathbb{E}(Y).$$
On utilise l'espérance du produit, on factorise la probabilité conjointe par indépendance, puis on sépare la somme double finie : $$\begin{aligned} \mathbb{E}(XY) &= \sum_i \sum_j x_i y_j\, P(X = x_i, Y = y_j) && \text{(espérance du produit)} \\
&= \sum_i \sum_j x_i y_j\, P(X = x_i)\,P(Y = y_j) && \text{(indépendance)} \\
&= \Big( \sum_i x_i P(X = x_i) \Big) \Big( \sum_j y_j P(Y = y_j) \Big) && \text{(on sépare les sommes)} \\
&= \mathbb{E}(X)\,\mathbb{E}(Y). \end{aligned}$$
Proposition — L'indépendance annule la covariance
Si \(X\) et \(Y\) sont indépendantes (et admettent une variance), alors $$\mathrm{Cov}(X, Y) = 0 \qquad \text{et} \qquad \mathrm{Var}(X + Y) = \mathrm{Var}(X) + \mathrm{Var}(Y).$$ Dans le cas fini cela découle de \(\mathbb{E}(XY) = \mathbb{E}(X)\mathbb{E}(Y)\) et de König-Huygens ; pour les lois infinies usuelles (par exemple deux variables de Poisson ou géométriques indépendantes) les identités restent vraies et sont admises. Définition — Variables non corrélées
\(X\) et \(Y\) (toutes deux de variance finie) sont non corrélées si \(\mathrm{Cov}(X, Y) = 0\). Des variables indépendantes de variance finie sont non corrélées. Exemple — non corrélées mais non indépendantes
Soit \(X\) uniforme sur \(\{-1, 0, 1\}\) (chaque valeur de probabilité \(\tfrac13\)) et \(Y = X^2\). Alors \(XY = X^3\), et $$\mathbb{E}(X) = \tfrac{-1 + 0 + 1}{3} = 0, \qquad \mathbb{E}(XY) = \mathbb{E}(X^3) = \tfrac{-1 + 0 + 1}{3} = 0,$$ donc \(\mathrm{Cov}(X, Y) = \mathbb{E}(XY) - \mathbb{E}(X)\mathbb{E}(Y) = 0\) : les variables sont non corrélées. Mais elles ne sont pas indépendantes : \(P(X = 0, Y = 0) = P(X = 0) = \tfrac13\), alors que \(P(X = 0)\,P(Y = 0) = \tfrac13 \cdot \tfrac13 = \tfrac19\) (car \(Y = 0 \Leftrightarrow X = 0\)). Les deux diffèrent, donc \(X\) et \(Y\) sont dépendantes. Méthode — Variance d'une somme de variables indépendantes
Pour des variables mutuellement indépendantes de variance finie la variance de la somme est la somme des variances : \(\mathrm{Var}(X_1 + \dots + X_n) = \mathrm{Var}(X_1) + \dots + \mathrm{Var}(X_n)\). C'est l'outil standard derrière la concentration d'une moyenne de mesures indépendantes. Compétences à pratiquer
- Indépendance, corrélation et sommes
- Synthèse
Aller à la section