Éducation Nationale Française · BCPST 2
Variables aléatoires discrètes
Une variable aléatoire discrète prend ses valeurs dans un ensemble dénombrable — le rang d'un premier succès, le nombre d'arrivées à un guichet. Sa loi donne les probabilités \(P(X = k)\), dont la somme vaut \(1\) ; l'espérance est la valeur moyenne \(\sum_k k\, P(X = k)\) (lorsque la série converge absolument), la variance mesure la dispersion, et le théorème de transfert calcule la moyenne de toute fonction de \(X\) sans en déterminer la loi. Deux inégalités — Markov et Bienaymé-Tchebychev — bornent la probabilité de grands écarts à la moyenne. Deux lois nouvelles apparaissent : la loi géométrique (rang d'un premier succès, sans mémoire) et la loi de Poisson (comptage d'événements rares). Tout prolonge les variables finies de première année, les sommes étant désormais des séries convergentes.
I
Variables aléatoires discrètes et leurs lois
I.1
Loi et fonction de répartition
Une variable discrète est une variable dont les valeurs peuvent se lister (en nombre fini ou en suite). Sa loi est le tableau des probabilités de ces valeurs ; la fonction de répartition du chapitre précédent devient alors un escalier qui saute à chaque valeur.
Définition — Variable aléatoire discrète
Une variable aléatoire \(X\) est discrète si son image \(X(\Omega)\) est indexée par une partie de \(\mathbb{N}\) (valeurs en nombre fini ou dénombrable ; en général \(X(\Omega) \subset \mathbb{N}\) ou \(\mathbb{Z}\), mais des valeurs comme \(1/n\) sont autorisées). Toute variable aléatoire finie est discrète. Définition — Loi d'une variable discrète
La loi de \(X\) est la donnée de ses valeurs \(X(\Omega)\) et des probabilités \(P(X = x)\) pour \(x \in X(\Omega)\), notée \(\mathcal{L}(X)\). Seules les valeurs de probabilité non nulle (le support) comptent ; pour tout ensemble de valeurs \(B\), \(P(X \in B) = \sum_{x \in B} P(X = x)\). Proposition — Fonction de répartition d'une variable discrète
La fonction de répartition du ch. 9, \(F_X(t) = P(X \le t)\), devient ici \(F_X(t) = \sum_{x \le t} P(X = x)\), un escalier (généralisé) avec un saut de \(P(X = x)\) à chaque valeur \(x\) ; lorsque \(X(\Omega) \subset \mathbb{Z}\) (ou sans point d'accumulation fini) c'est un véritable escalier, constant entre deux valeurs consécutives. La loi et \(F_X\) se déterminent mutuellement. Théorème — Existence d'une variable de loi donnée
Pour des valeurs \((x_i)\) deux à deux distinctes et des réels \((p_i)\) avec \(p_i \ge 0\) et \(\sum_i p_i = 1\), il existe une variable aléatoire \(X\) avec \(P(X = x_i) = p_i\) pour tout \(i\). Admis. Méthode — Déterminer une loi
On identifie les valeurs \(X(\Omega)\), on calcule chaque \(P(X = x)\), et on vérifie \(\sum_{x} P(X = x) = 1\) (une série convergente). La loi décrit entièrement \(X\) pour les calculs de probabilité. Exemple
Le rang \(X\) du premier six d'un dé équilibré : \(X(\Omega) = \mathbb{N}^*\), \(P(X = n) = (5/6)^{n-1}(1/6)\), et \(\sum_{n \ge 1} P(X = n) = 1\). La loi \(p_n = \frac{1}{n(n+1)}\) sur \(\mathbb{N}^*\) somme aussi à \(1\) (télescopique), mais n'a pas d'espérance : \(\sum_n n\, p_n = \sum_n \frac{1}{n+1}\) diverge. Compétences à pratiquer
- Déterminer une loi
I.2
Indépendance de variables aléatoires discrètes
Pour des variables discrètes, l'indépendance se lit directement sur les événements élémentaires \((X = x)\), \((Y = y)\) : la probabilité conjointe est le produit des probabilités individuelles. Le lemme des coalitions permet de regrouper plusieurs variables indépendantes en blocs indépendants.
Définition — Indépendance
\(X\) et \(Y\) sont indépendantes si \(P(X = x, Y = y) = P(X = x)\,P(Y = y)\) pour toutes valeurs \(x \in X(\Omega)\), \(y \in Y(\Omega)\). Une famille finie ou une suite est mutuellement indépendante si, pour toute sous-famille finie et tout choix de valeurs dans leurs images respectives, la probabilité conjointe est le produit des probabilités individuelles. Proposition — Lemme des coalitions
Si \(X_1, \dots, X_n\) sont mutuellement indépendantes, alors toute fonction d'un bloc (par exemple \(X_1, \dots, X_k\)) est indépendante de toute fonction d'un bloc disjoint (\(X_{k+1}, \dots, X_n\)). Admis. Méthode — Utiliser l'indépendance
On factorise les probabilités conjointes en produits de probabilités individuelles. Par le lemme des coalitions, une somme (ou une autre fonction) d'un bloc est indépendante d'une fonction d'un bloc disjoint — utile pour les sommes de variables indépendantes. Exemple
Deux dés équilibrés lancés indépendamment : \(P(X = i, Y = j) = \frac16 \cdot \frac16\) pour tous \(i, j\), donc \(X\) et \(Y\) sont indépendantes. Par coalitions, \(X_1 + X_2\) est indépendante de \(X_3\) lorsque \(X_1, X_2, X_3\) sont indépendantes. Compétences à pratiquer
- Tester l'indépendance
II
Espérance, variance et concentration
II.1
Espérance, transfert et Markov
L'espérance est la valeur moyenne de la variable — un barycentre de ses valeurs pondérées par leurs probabilités. Elle n'existe que si la série qui la définit converge absolument ; sinon la « moyenne » dépendrait de l'ordre de sommation et n'aurait aucun sens.
Définition — Espérance
Si la série \(\sum_k |x_k|\,P(X = x_k)\) converge (convergence absolue), \(X\) admet une espérance $$\mathbb{E}(X) = \sum_k x_k\, P(X = x_k),$$ valeur indépendante de l'ordre des \(x_k\). Théorème — Théorème de transfert
Pour une fonction \(g\) définie sur \(X(\Omega)\), \(\mathbb{E}(g(X))\) existe si et seulement si \(\sum_k g(x_k)\,P(X = x_k)\) converge absolument, et alors $$\mathbb{E}(g(X)) = \sum_k g(x_k)\,P(X = x_k).$$ Admis. Proposition — Propriétés de l'espérance
Pour des variables dont les espérances existent : linéarité \(\mathbb{E}(aX + bY) = a\mathbb{E}(X) + b\mathbb{E}(Y)\) (admise) ; positivité \(X \ge 0 \Rightarrow \mathbb{E}(X) \ge 0\) ; croissance \(X \le Y \Rightarrow \mathbb{E}(X) \le \mathbb{E}(Y)\) ; et \(a \le X \le b \Rightarrow a \le \mathbb{E}(X) \le b\).
Positivité : si \(X \ge 0\) alors toutes les valeurs \(x_k \ge 0\), donc \(\mathbb{E}(X) = \sum_k x_k P(X = x_k) \ge 0\) comme somme de termes positifs. La croissance suit en appliquant la positivité à \(Y - X \ge 0\) et la linéarité : \(\mathbb{E}(Y) - \mathbb{E}(X) = \mathbb{E}(Y - X) \ge 0\). L'encadrement \(a \le \mathbb{E}(X) \le b\) vient de la croissance appliquée aux constantes \(a \le X \le b\) (une constante \(c\) vérifie \(\mathbb{E}(c) = c\)).
Théorème — Inégalité de Markov
Pour une variable positive \(X \ge 0\) admettant une espérance et tout \(a > 0\), $$P(X \ge a) \le \frac{\mathbb{E}(X)}{a}.$$
En scindant la somme et en ne gardant que les valeurs \(\ge a\), $$\begin{aligned} \mathbb{E}(X) &= \sum_k x_k\, P(X = x_k) \\
&\ge \sum_{x_k \ge a} x_k\, P(X = x_k) && \text{(on retire des termes positifs)} \\
&\ge a \sum_{x_k \ge a} P(X = x_k) = a\, P(X \ge a). \end{aligned}$$ En divisant par \(a > 0\) on obtient \(P(X \ge a) \le \mathbb{E}(X)/a\).
Méthode — Calculer une espérance
On utilise le théorème de transfert (\(\sum_k g(x_k) P(X = x_k)\)) pour \(\mathbb{E}(g(X))\), ou on décompose \(X\) en morceaux plus simples et on utilise la linéarité. On vérifie toujours d'abord la convergence absolue. Compétences à pratiquer
- Espérance et Markov
II.2
Variance et Bienaymé-Tchebychev
La variance mesure la dispersion de \(X\) autour de sa moyenne. König-Huygens en donne un calcul rapide, et Bienaymé-Tchebychev la transforme en une borne sur la probabilité d'un grand écart.
Définition — Moments, variance et écart-type
Pour \(r \in \mathbb{N}^*\), le moment d'ordre \(r\) est \(\mathbb{E}(X^r)\) (quand il existe). Si \(\mathbb{E}(X^2)\) existe (ce qui force aussi \(\mathbb{E}(X)\) à exister, un moment d'ordre \(2\) entraînant le moment d'ordre \(1\)), la variance est \(\mathrm{Var}(X) = \mathbb{E}\big((X - \mathbb{E}(X))^2\big)\) et l'écart-type est \(\sigma(X) = \sqrt{\mathrm{Var}(X)}\). \(X\) est centrée si \(\mathbb{E}(X) = 0\), réduite si \(\mathrm{Var}(X) = 1\). Proposition — König-Huygens
Si \(\mathbb{E}(X^2)\) existe, \(\mathrm{Var}(X) = \mathbb{E}(X^2) - \mathbb{E}(X)^2\).
En développant le carré et par linéarité (avec \(m = \mathbb{E}(X)\) une constante), $$\begin{aligned} \mathrm{Var}(X) &= \mathbb{E}\big((X - m)^2\big) = \mathbb{E}(X^2 - 2mX + m^2) \\
&= \mathbb{E}(X^2) - 2m\,\mathbb{E}(X) + m^2 = \mathbb{E}(X^2) - m^2. \end{aligned}$$
Proposition — Transformation affine et variable centrée réduite
On suppose que \(X\) admet une variance. Alors \(\mathrm{Var}(aX + b) = a^2\,\mathrm{Var}(X)\) ; et si \(\sigma(X) > 0\), \(X^* = \dfrac{X - \mathbb{E}(X)}{\sigma(X)}\) est centrée réduite.
\(\mathbb{E}(aX + b) = a\mathbb{E}(X) + b\), donc \(aX + b - \mathbb{E}(aX + b) = a(X - \mathbb{E}(X))\) ; en élevant au carré et en prenant l'espérance, \(\mathrm{Var}(aX + b) = a^2 \mathbb{E}\big((X - \mathbb{E}(X))^2\big) = a^2 \mathrm{Var}(X)\). Pour \(X^*\) : c'est \(\frac1{\sigma(X)}(X - \mathbb{E}(X))\), donc \(\mathbb{E}(X^*) = 0\) et \(\mathrm{Var}(X^*) = \frac{1}{\sigma(X)^2}\mathrm{Var}(X) = 1\).
Théorème — Inégalité de Bienaymé-Tchebychev
Pour une variable \(X\) admettant une variance et tout \(\varepsilon > 0\), $$P\big(|X - \mathbb{E}(X)| \ge \varepsilon\big) \le \frac{\mathrm{Var}(X)}{\varepsilon^2}.$$
La variable \(Y = (X - \mathbb{E}(X))^2 \ge 0\) a pour espérance \(\mathrm{Var}(X)\). Comme \(|X - \mathbb{E}(X)| \ge \varepsilon\) est le même événement que \(Y \ge \varepsilon^2\), l'inégalité de Markov appliquée à \(Y\) au seuil \(\varepsilon^2\) donne $$P\big(|X - \mathbb{E}(X)| \ge \varepsilon\big) = P(Y \ge \varepsilon^2) \le \frac{\mathbb{E}(Y)}{\varepsilon^2} = \frac{\mathrm{Var}(X)}{\varepsilon^2}.$$
Proposition — Variables indépendantes
Si \(X\) et \(Y\) sont indépendantes et admettent chacune une espérance, alors \(\mathbb{E}(XY) = \mathbb{E}(X)\,\mathbb{E}(Y)\). Si de plus elles admettent chacune une variance, alors \(\mathrm{Var}(X + Y) = \mathrm{Var}(X) + \mathrm{Var}(Y)\). Admis ici (développé avec la loi conjointe au chapitre suivant). Méthode — Calculer une variance
On utilise König-Huygens : on calcule \(\mathbb{E}(X^2)\) (par transfert), puis \(\mathrm{Var}(X) = \mathbb{E}(X^2) - \mathbb{E}(X)^2\). Pour une somme de variables indépendantes, on additionne les variances. Exemple
Une variable de Bernoulli \(X \hookrightarrow \mathcal{B}(p)\) (valeurs \(0, 1\) avec \(P(X = 1) = p\)) vérifie \(\mathbb{E}(X) = p\), \(\mathbb{E}(X^2) = p\), donc \(\mathrm{Var}(X) = p - p^2 = p(1-p)\). Par Bienaymé-Tchebychev, une variable d'espérance \(m\) et de variance \(v > 0\) vérifie \(P(|X - m| \ge 2\sqrt{v}) \le \dfrac{v}{(2\sqrt v)^2} = \tfrac14\). Compétences à pratiquer
- Variance et concentration
III
Les lois discrètes usuelles
III.1
La loi géométrique
Rappelons les lois finies de première année et leurs moments : la loi uniforme sur \(\llbracket 1, n\rrbracket\) (\(\mathbb{E} = \frac{n+1}{2}\)) ; la loi de Bernoulli \(\mathcal{B}(p)\) (\(\mathbb{E} = p\), \(\mathrm{Var} = p(1-p)\)) ; la loi binomiale \(\mathcal{B}(n,p)\) (\(\mathbb{E} = np\), \(\mathrm{Var} = np(1-p)\)). La première loi infinie nouvelle est la loi géométrique, qui modélise le rang d'un premier succès dans des épreuves indépendantes. 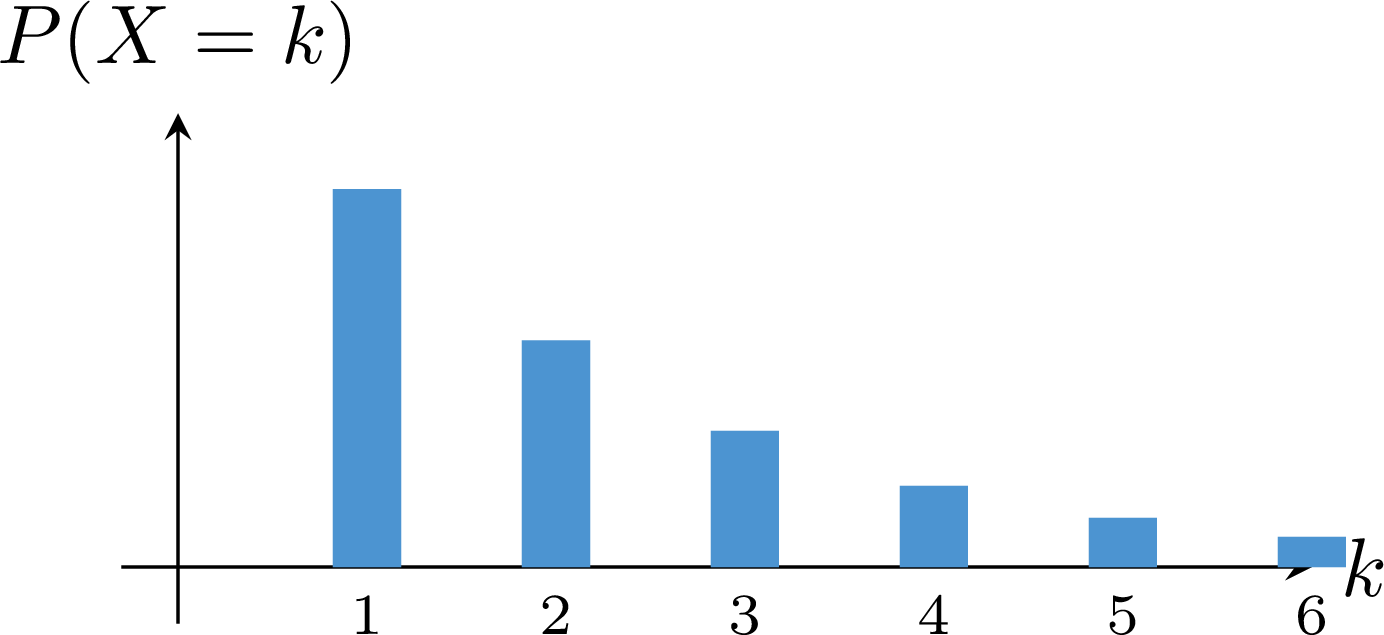
Définition — Loi géométrique
\(X\) suit la loi géométrique \(\mathcal{G}(p)\) (\(p \in {]0,1[}\)) si \(X(\Omega) = \mathbb{N}^*\) et \(P(X = k) = (1-p)^{k-1} p\) pour \(k \ge 1\). (On vérifie \(\sum_{k \ge 1} P(X = k) = 1\) par la série géométrique.) Proposition — Espérance et variance de la loi géométrique
Si \(X \hookrightarrow \mathcal{G}(p)\), alors \(\mathbb{E}(X) = \dfrac1p\) et \(\mathrm{Var}(X) = \dfrac{1-p}{p^2}\).
Posons \(q = 1 - p\). La série \(\sum_k k q^{k-1}\) est la dérivée de la série géométrique, de somme \(\frac{1}{(1-q)^2} = \frac{1}{p^2}\) (rappel des Séries réelles, convergence absolue car \(0 < q < 1\)). Donc $$\mathbb{E}(X) = \sum_{k \ge 1} k q^{k-1} p = p \cdot \frac{1}{p^2} = \frac1p.$$ Avec \(\sum_{k \ge 2} k(k-1) q^{k-2} = \frac{2}{(1-q)^3} = \frac{2}{p^3}\) (les termes \(k = 0, 1\) s'annulent), le théorème de transfert donne \(\mathbb{E}(X(X-1)) = \frac{2q}{p^2}\), donc \(\mathbb{E}(X^2) = \frac{2q}{p^2} + \frac1p = \frac{2-p}{p^2}\) et König-Huygens donne \(\mathrm{Var}(X) = \frac{2-p}{p^2} - \frac1{p^2} = \frac{1-p}{p^2}\).
Proposition — Absence de mémoire
Si \(X \hookrightarrow \mathcal{G}(p)\), alors pour tous entiers \(m, n \ge 0\), \(P_{X > n}(X > n + m) = P(X > m)\).
La queue vaut \(P(X > n) = \sum_{k > n} (1-p)^{k-1} p = (1-p)^n\) (somme géométrique). Donc $$P_{X > n}(X > n + m) = \frac{P(X > n + m)}{P(X > n)} = \frac{(1-p)^{n+m}}{(1-p)^n} = (1-p)^m = P(X > m).$$
Méthode — Reconnaître une loi géométrique
« Rang du premier succès » dans des épreuves indépendantes de probabilité de succès \(p\) donne \(\mathcal{G}(p)\) ; alors \(\mathbb{E}(X) = 1/p\) et \(\mathrm{Var}(X) = (1-p)/p^2\) sont immédiats. Exemple
Le rang du premier un en lançant un dé équilibré suit \(\mathcal{G}(1/6)\), donc \(\mathbb{E}(X) = 6\) (en moyenne, six lancers pour le premier un). Compétences à pratiquer
- Utiliser la loi géométrique
III.2
La loi de Poisson
La loi de Poisson modélise un comptage d'événements rares — arrivées à un guichet, appels sur un intervalle. Son unique paramètre \(\lambda\) est à la fois sa moyenne et sa variance. 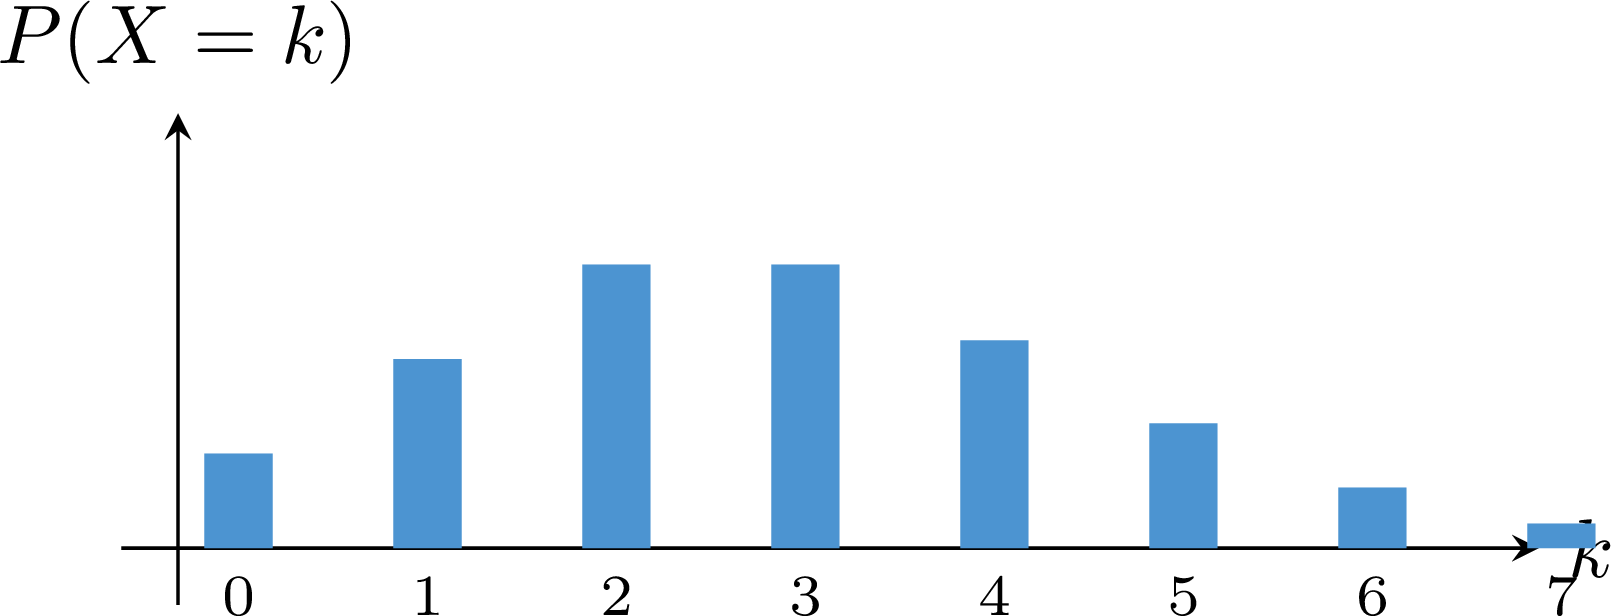
Définition — Loi de Poisson
\(X\) suit la loi de Poisson \(\mathcal{P}(\lambda)\) (\(\lambda > 0\)) si \(X(\Omega) = \mathbb{N}\) et \(P(X = k) = e^{-\lambda}\dfrac{\lambda^k}{k!}\) pour \(k \ge 0\). (On vérifie \(\sum_{k \ge 0} P(X = k) = 1\) via la série exponentielle \(\sum_k \lambda^k/k! = e^\lambda\).) Proposition — Espérance et variance de la loi de Poisson
Si \(X \hookrightarrow \mathcal{P}(\lambda)\), alors \(\mathbb{E}(X) = \lambda\) et \(\mathrm{Var}(X) = \lambda\).
Pour la moyenne, $$\mathbb{E}(X) = \sum_{k \ge 0} k\, e^{-\lambda}\frac{\lambda^k}{k!} = e^{-\lambda} \lambda \sum_{k \ge 1} \frac{\lambda^{k-1}}{(k-1)!} = e^{-\lambda}\lambda\, e^{\lambda} = \lambda.$$ De même \(\mathbb{E}(X(X-1)) = e^{-\lambda}\lambda^2 \sum_{k \ge 2} \frac{\lambda^{k-2}}{(k-2)!} = \lambda^2\), donc \(\mathbb{E}(X^2) = \lambda^2 + \lambda\) et \(\mathrm{Var}(X) = \lambda^2 + \lambda - \lambda^2 = \lambda\).
Méthode — Reconnaître une loi de Poisson
On la reconnaît à sa fonction de masse \(P(X = k) = e^{-\lambda}\lambda^k/k!\) sur \(\mathbb{N}\) ; alors \(\mathbb{E}(X) = \mathrm{Var}(X) = \lambda\). (Le « comptage d'événements rares » est un contexte de modélisation ; l'approximation de la binomiale par une loi de Poisson vient au chapitre des théorèmes limites.) Exemple
Le nombre de clients à un guichet pendant une période fixée est couramment modélisé par \(\mathcal{P}(\lambda)\) lorsque les arrivées sont rares et approximativement indépendantes sur la période ; alors sa moyenne et sa variance valent toutes deux \(\lambda\).
Pour aller plus loin. Le chapitre suivant étudie les couples de variables discrètes — lois conjointe et conditionnelles, somme de deux variables indépendantes (stabilité des lois binomiale et de Poisson) — et démontre \(\mathbb{E}(XY) = \mathbb{E}(X)\mathbb{E}(Y)\) pour des variables indépendantes ; le chapitre sur les densités remplacera la somme par une intégrale.
Compétences à pratiquer
- Utiliser la loi de Poisson
Aller à la section