Éducation Nationale Française · BCPST 2
Produit scalaire dans \(\mathbb{R}^n\)
La première année mesurait longueurs et angles dans le plan avec le produit scalaire. Le même outil fonctionne dans \(\mathbb{R}^n\) : \(\langle u,v\rangle = x_1 y_1 + \dots + x_n y_n\), ou sous forme matricielle \({}^t\!U V\). En découlent la norme euclidienne, les inégalités de Cauchy-Schwarz et triangulaire, et l'orthogonalité. Les bases orthonormées rendent tout calcul aussi simple que dans la base canonique ; la projection orthogonale sur un sous-espace donne le point le plus proche et la distance à ce sous-espace (utilisée dans l'ajustement par moindres carrés) ; et le théorème spectral affirme que toute matrice réelle symétrique est diagonalisable dans une base orthonormée — le cas propre du chapitre précédent. Partout, \(\mathbb{R}^n\) est muni de son produit scalaire usuel.
I
Le produit scalaire et la norme euclidienne
I.1
Le produit scalaire usuel
Le produit scalaire associe à deux vecteurs un nombre en sommant les produits de leurs coordonnées. Écrit avec des matrices, c'est une ligne fois une colonne ; il se comporte comme un développement de parenthèses en chaque variable.
Définition — Produit scalaire
Pour \(u, v \in \mathbb{R}^n\) de coordonnées \((x_1, \dots, x_n)\) et \((y_1, \dots, y_n)\) dans la base canonique, le produit scalaire est $$\langle u, v\rangle = x_1 y_1 + \dots + x_n y_n = {}^t\!U V,$$ où \(U, V\) sont les colonnes de coordonnées de \(u, v\). Proposition — Bilinéaire, symétrique, défini positif
Le produit scalaire est linéaire en chaque variable, symétrique (\(\langle u,v\rangle = \langle v,u\rangle\)), et défini positif : \(\langle u,u\rangle \ge 0\) avec \(\langle u,u\rangle = 0 \iff u = 0\).
La linéarité en la première variable et la symétrie se lisent sur \({}^t\!U V\) (le produit matriciel est linéaire en chaque facteur, et \({}^t\!U V = {}^t\!V U\) car c'est une matrice \(1\times1\)) ; la linéarité en la seconde suit par symétrie. Pour la positivité, \(\langle u,u\rangle = x_1^2 + \dots + x_n^2 \ge 0\), somme de carrés, nulle ssi tous les \(x_i = 0\), soit \(u = 0\).
Exemple
Dans \(\mathbb{R}^4\), pour \(u = (1, 0, -1, 2)\) et \(v = (2, 3, -1, 1)\), \(\langle u,v\rangle = 1\cdot2 + 0\cdot3 + (-1)(-1) + 2\cdot1 = 5\), lu aussi comme \({}^t\!U V = \begin{psmallmatrix} 1 & 0 & -1 & 2 \end{psmallmatrix}\begin{psmallmatrix} 2 \\ 3 \\ -1 \\ 1 \end{psmallmatrix} = 5\). Méthode — Calculer un produit scalaire
On somme les produits des coordonnées correspondantes, ou on calcule \({}^t\!U V\). Si les vecteurs sont donnés dans une base non canonique, on les exprime d'abord dans la base canonique (ou on développe par bilinéarité). (La matrice en base quelconque est la matrice de Gram \({}^t\!P P\) ; on ne la poursuit pas.) Compétences à pratiquer
- Calculer un produit scalaire
I.2
Norme euclidienne et les deux inégalités
La norme est la longueur d'un vecteur, racine carrée de son carré scalaire. Deux inégalités la gouvernent : Cauchy-Schwarz majore un produit scalaire par le produit des normes, et l'inégalité triangulaire majore la norme d'une somme.
Définition — Norme euclidienne
La norme euclidienne de \(u \in \mathbb{R}^n\) est \(\|u\| = \sqrt{\langle u,u\rangle} = \sqrt{x_1^2 + \dots + x_n^2}\). Elle vérifie \(\|u\| = 0 \iff u = 0\) et \(\|\lambda u\| = |\lambda|\,\|u\|\) pour \(\lambda \in \mathbb{R}\). Proposition — Développement de la norme au carré
Pour \(u, v \in \mathbb{R}^n\), \(\|u+v\|^2 = \|u\|^2 + \|v\|^2 + 2\langle u,v\rangle\).
Par bilinéarité et symétrie, $$\begin{aligned} \|u+v\|^2 &= \langle u+v, u+v\rangle \\
&= \langle u,u\rangle + \langle u,v\rangle + \langle v,u\rangle + \langle v,v\rangle && \text{(bilinéarité)} \\
&= \|u\|^2 + \|v\|^2 + 2\langle u,v\rangle && \text{(symétrie)}. \end{aligned}$$
Théorème — Inégalité de Cauchy-Schwarz
Pour \(u, v \in \mathbb{R}^n\), \(|\langle u,v\rangle| \le \|u\|\,\|v\|\), avec égalité si et seulement si \(u\) et \(v\) sont colinéaires (l'un est un multiple scalaire de l'autre, le vecteur nul inclus).
Si \(v = 0\) les deux membres valent \(0\). Sinon on considère, pour \(t \in \mathbb{R}\), $$\|u + tv\|^2 = \|v\|^2 t^2 + 2\langle u,v\rangle\, t + \|u\|^2 \ge 0.$$ Ce trinôme en \(t\) est toujours \(\ge 0\) de coefficient dominant positif, donc son discriminant est \(\le 0\) : \(4\langle u,v\rangle^2 - 4\|v\|^2\|u\|^2 \le 0\), soit \(|\langle u,v\rangle| \le \|u\|\,\|v\|\). L'égalité signifie discriminant nul, donc \(\|u + t_0 v\|^2 = 0\) pour un \(t_0\), soit \(u = -t_0 v\) : \(u\) et \(v\) sont colinéaires. Réciproquement, si \(u = \lambda v\) alors \(|\langle u,v\rangle| = |\lambda|\,\|v\|^2 = \|u\|\,\|v\|\) (et si \(v = 0\) les deux membres valent \(0\)), donc la colinéarité donne l'égalité.
Théorème — Inégalité triangulaire
Pour \(u, v \in \mathbb{R}^n\), \(\|u+v\| \le \|u\| + \|v\|\), avec égalité si et seulement si \(u = 0\) ou \(v = \lambda u\) pour un \(\lambda \ge 0\) (positivement proportionnels).
Les deux membres sont \(\ge 0\), on compare donc les carrés. Avec le développement puis Cauchy-Schwarz, $$\begin{aligned} \|u+v\|^2 &= \|u\|^2 + \|v\|^2 + 2\langle u,v\rangle \\
&\le \|u\|^2 + \|v\|^2 + 2\|u\|\,\|v\| && \text{(Cauchy-Schwarz)} \\
&= (\|u\| + \|v\|)^2. \end{aligned}$$ L'égalité force \(\langle u,v\rangle = \|u\|\,\|v\| \ge 0\), le cas d'égalité de Cauchy-Schwarz avec produit scalaire positif : \(u, v\) sont positivement proportionnels. Réciproquement, si \(u = 0\) ou \(v = \lambda u\) avec \(\lambda \ge 0\), un calcul direct donne \(\|u+v\| = \|u\| + \|v\|\).
Exemple
Pour \(u = (1,2)\), \(v = (3,1)\) : \(\langle u,v\rangle = 5\), \(\|u\| = \sqrt5\), \(\|v\| = \sqrt{10}\), et en effet \(5 \le \sqrt5\cdot\sqrt{10} = \sqrt{50} \approx 7{,}07\). De plus \(\|u+v\| = \|(4,3)\| = 5 \le \sqrt5 + \sqrt{10} \approx 5{,}40\). Méthode — Majorer un produit scalaire ou une norme
Pour majorer un produit scalaire, on applique Cauchy-Schwarz \(|\langle u,v\rangle| \le \|u\|\,\|v\|\) ; pour majorer la norme d'une somme, l'inégalité triangulaire. L'égalité n'a lieu que dans le cas colinéaire (resp. positivement proportionnel). Compétences à pratiquer
- Norme et inégalités
II
Orthogonalité et bases orthonormales
II.1
Orthogonalité, Pythagore et bases orthonormales
Deux vecteurs sont orthogonaux quand leur produit scalaire est nul. L'orthogonalité ramène le théorème de Pythagore, et une base dont les vecteurs sont orthogonaux — mieux, orthonormés — transforme tout calcul de coordonnées en un simple produit scalaire. 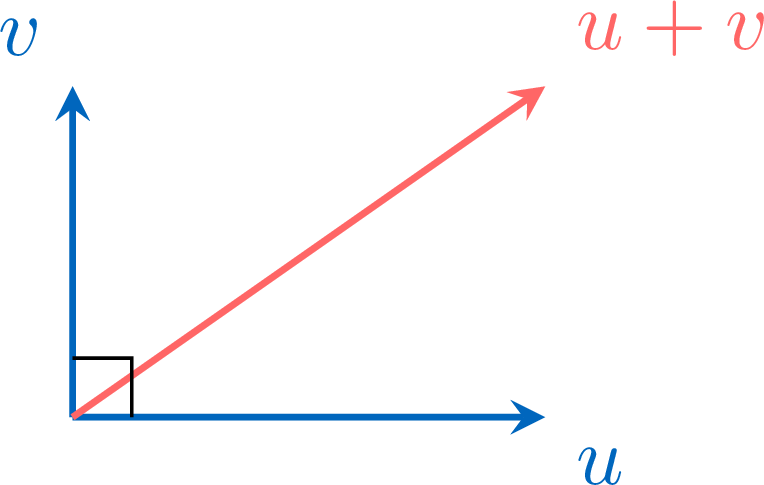
Définition — Vecteurs orthogonaux
Deux vecteurs \(u, v \in \mathbb{R}^n\) sont orthogonaux, noté \(u \perp v\), si \(\langle u,v\rangle = 0\) (rappel de première année). Théorème — Pythagore
Pour \(u, v \in \mathbb{R}^n\), \(u \perp v \iff \|u+v\|^2 = \|u\|^2 + \|v\|^2\).
Par le développement, \(\|u+v\|^2 = \|u\|^2 + \|v\|^2 + 2\langle u,v\rangle\), qui vaut \(\|u\|^2 + \|v\|^2\) exactement quand \(\langle u,v\rangle = 0\), soit \(u \perp v\).
Définition — Base orthogonale et orthonormale
Une famille de \(\mathbb{R}^n\) (ou d'un sous-espace \(F\)) est orthogonale si ses vecteurs sont deux à deux orthogonaux, et orthonormale si de plus chacun est de norme \(1\). Une base orthonormale est une base qui est une famille orthonormale. Proposition — Une famille orthogonale de vecteurs non nuls est libre
Si \(v_1, \dots, v_s\) sont deux à deux orthogonaux et non nuls, la famille est libre. En particulier \(n\) vecteurs non nuls deux à deux orthogonaux de \(\mathbb{R}^n\) forment une base.
Supposons \(\lambda_1 v_1 + \dots + \lambda_s v_s = 0\). En prenant le produit scalaire avec \(v_i\) et en utilisant l'orthogonalité (\(\langle v_j, v_i\rangle = 0\) pour \(j \ne i\)) on obtient \(\lambda_i \|v_i\|^2 = 0\) ; comme \(v_i \ne 0\), \(\|v_i\|^2 \ne 0\), donc \(\lambda_i = 0\). Ceci vaut pour tout \(i\), donc la famille est libre.
Proposition — Coordonnées dans une base orthonormale
Dans une base orthonormale \((u_1, \dots, u_n)\), tout \(u\) s'écrit \(u = \sum_i \langle u, u_i\rangle\, u_i\). Dans une base orthogonale \((v_1, \dots, v_n)\), \(u = \sum_i \frac{\langle u, v_i\rangle}{\|v_i\|^2}\, v_i\).
Écrivons \(u = \sum_j \alpha_j u_j\). En prenant le produit scalaire avec \(u_i\) et en utilisant \(\langle u_j, u_i\rangle = 0\) pour \(j \ne i\) et \(\|u_i\| = 1\) on obtient \(\langle u, u_i\rangle = \alpha_i\). Pour une base orthogonale le même calcul donne \(\langle u, v_i\rangle = \alpha_i \|v_i\|^2\), d'où \(\alpha_i = \langle u, v_i\rangle / \|v_i\|^2\).
Proposition — Produit scalaire et norme en base orthonormale
Si \(u, v\) ont pour coordonnées \((\alpha_i)\), \((\beta_i)\) dans une base orthonormale, alors \(\langle u,v\rangle = \sum_i \alpha_i \beta_i\) et \(\|u\|^2 = \sum_i \alpha_i^2\) — la formule de la base canonique vaut dans toute base orthonormale.
On développe \(\langle \sum_i \alpha_i u_i, \sum_j \beta_j u_j\rangle = \sum_{i,j} \alpha_i \beta_j \langle u_i, u_j\rangle\) par bilinéarité. Comme \(\langle u_i, u_j\rangle = 0\) pour \(i \ne j\) et \(= 1\) pour \(i = j\), seuls les termes diagonaux subsistent : \(\sum_i \alpha_i \beta_i\). Prendre \(v = u\) donne \(\|u\|^2 = \sum_i \alpha_i^2\).
Définition — Matrice orthogonale
Une matrice carrée \(P\) est orthogonale si \({}^t\!P P = I_n\). Proposition — Caractérisation des matrices orthogonales
\(P\) est orthogonale si et seulement si ses colonnes forment une famille orthonormale ; alors \(P\) est inversible avec \(P^{-1} = {}^t\!P\), et un produit ou un inverse de matrices orthogonales est orthogonal.
Le coefficient \((i,j)\) de \({}^t\!P P\) est \({}^t\!C_i C_j = \langle c_i, c_j\rangle\), produit scalaire des colonnes. Donc \({}^t\!P P = I_n\) signifie exactement \(\langle c_i, c_j\rangle = \delta_{ij}\), soit colonnes orthonormales ; et \({}^t\!P P = I_n\) dit que \({}^t\!P = P^{-1}\). Si \(P, Q\) sont orthogonales, \({}^t\!(PQ)(PQ) = {}^t\!Q\,{}^t\!P P\, Q = {}^t\!Q Q = I_n\), et \({}^t\!(P^{-1})P^{-1} = P\,{}^t\!P = I_n\) (l'inverse à gauche d'une matrice carrée est son inverse), donc produits et inverses sont orthogonaux.
Exemple
La base canonique est orthonormale. Les vecteurs \((1,1,1), (1,0,-1), (1,-2,1)\) de \(\mathbb{R}^3\) sont deux à deux orthogonaux ; en divisant chacun par sa norme (\(\sqrt3, \sqrt2, \sqrt6\)) on obtient une base orthonormale. La matrice ayant ces vecteurs unitaires en colonnes est orthogonale. Méthode — Construire et utiliser une base orthonormale
On normalise une famille orthogonale donnée en divisant chaque vecteur par sa norme (construire une famille orthogonale de toutes pièces est hors de ce cours). On lit les coordonnées par produits scalaires : \(u = \sum_i \langle u, u_i\rangle\, u_i\) dans une base orthonormale. Compétences à pratiquer
- Orthogonalité et coordonnées
II.2
Le théorème spectral
Parmi toutes les matrices, les matrices réelles symétriques sont le cas parfaitement diagonalisable du chapitre précédent : non seulement elles sont diagonalisables, mais une base de vecteurs propres peut être choisie orthonormale.
Proposition — Sous-espaces propres orthogonaux d'une matrice symétrique
Soit \(A \in M_n(\mathbb{R})\) symétrique (\({}^t\!A = A\)). Des vecteurs propres de \(A\) pour des valeurs propres distinctes sont orthogonaux.
Pour \(A\) symétrique, \(\langle Au, v\rangle = {}^t\!(Au)\,v = {}^t\!u\,{}^t\!A\,v = {}^t\!u\,(Av) = \langle u, Av\rangle\). Si \(Au = \lambda u\) et \(Av = \mu v\) avec \(\lambda \ne \mu\), alors $$\lambda \langle u,v\rangle = \langle Au, v\rangle = \langle u, Av\rangle = \mu \langle u,v\rangle,$$ donc \((\lambda - \mu)\langle u,v\rangle = 0\), d'où \(\langle u,v\rangle = 0\) : \(u \perp v\).
Théorème — Théorème spectral
Toute matrice réelle symétrique \(A\) est diagonalisable dans une base orthonormale : il existe une matrice diagonale réelle \(D\) et une matrice orthogonale \(P\) (colonnes une base orthonormale de vecteurs propres, \(P^{-1} = {}^t\!P\)) avec \(A = P D P^{-1} = P D\, {}^t\!P\).
Ce théorème est admis ; sa preuve dépasse ce cours. Les hypothèses sont essentielles : une matrice non symétrique, même diagonalisable, n'est pas nécessairement diagonalisable en base orthonormale. (Le résultat est propre aux matrices réelles.)
Méthode — Diagonaliser une matrice symétrique en base orthonormale
Une matrice réelle symétrique est automatiquement diagonalisable, à sous-espaces propres deux à deux orthogonaux. Quand les valeurs propres sont distinctes, chaque sous-espace propre est une droite : on normalise un vecteur propre par valeur propre. Pour une valeur propre multiple, une base orthonormale de son sous-espace propre existe (admis) ; on n'est pas tenu de la construire ici — en exercice une telle base est donnée ou évidente, et on la normalise simplement. On assemble les vecteurs propres unitaires en colonnes d'une matrice orthogonale \(P\), d'où \(A = P D\, {}^t\!P\). Exemple
\(A = \begin{psmallmatrix} 1 & 2 \\ 2 & 1 \end{psmallmatrix}\) est symétrique, de valeurs propres \(3, -1\) et vecteurs propres \((1,1), (1,-1)\) — orthogonaux, comme prévu. En normalisant on obtient la matrice orthogonale \(P = \tfrac{1}{\sqrt2}\begin{psmallmatrix} 1 & 1 \\ 1 & -1 \end{psmallmatrix}\), et \(A = P\begin{psmallmatrix} 3 & 0 \\ 0 & -1 \end{psmallmatrix}{}^t\!P\). Compétences à pratiquer
- Matrices symétriques
III
Projection orthogonale, distance et moindres carrés
III.1
Orthogonal d'un sous-espace et projection orthogonale
Tout sous-espace \(F\) possède son orthogonal \(F^\perp\), les vecteurs perpendiculaires à tout \(F\). Chaque vecteur se décompose de façon unique en une partie dans \(F\) et une partie dans \(F^\perp\) ; ne garder que la partie dans \(F\) est la projection orthogonale. 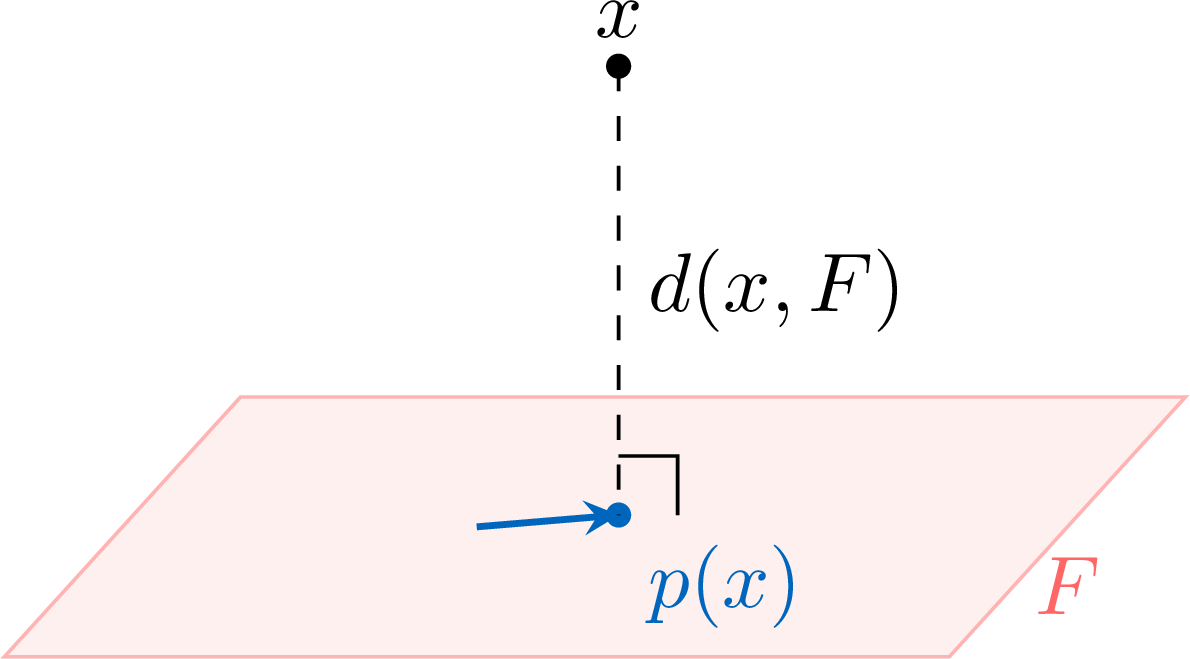
Définition — Orthogonal d'un sous-espace
Pour un sous-espace \(F \subset \mathbb{R}^n\), son orthogonal est \(F^\perp = \{u \in \mathbb{R}^n : \langle u, v\rangle = 0 \ \text{pour tout } v \in F\}\). C'est un sous-espace (défini par les conditions linéaires \(\langle \cdot, v\rangle = 0\)), et \(\dim F + \dim F^\perp = n\) (admis). Proposition — Décomposition orthogonale
Tout \(x \in \mathbb{R}^n\) s'écrit de façon unique \(x = x_F + x_{F^\perp}\) avec \(x_F \in F\) et \(x_{F^\perp} \in F^\perp\). L'application \(x \mapsto x_F\) est la projection orthogonale sur \(F\), notée \(p_F\) (ou \(p\)).
L'existence est admise en général (elle revient à ce que \(F\) possède une base orthogonale ; étant donné une telle base, la formule de projection de la proposition suivante construit explicitement la décomposition). Pour l'unicité, si \(x = a + b = a' + b'\) avec \(a, a' \in F\) et \(b, b' \in F^\perp\), alors \(a - a' = b' - b\) appartient à la fois à \(F\) et à \(F^\perp\), donc à \(F \cap F^\perp\). Un vecteur orthogonal à lui-même vérifie \(\|w\|^2 = \langle w,w\rangle = 0\), donc \(F \cap F^\perp = \{0\}\) ; ainsi \(a = a'\) et \(b = b'\).
Proposition — Propriétés de la projection orthogonale
La projection orthogonale \(p\) sur \(F\) est linéaire, et vérifie \(p \circ p = p\), \(\mathrm{Im}\, p = F\), \(\ker p = F^\perp\), et \(p(u) = u \iff u \in F\).
Linéarité : si \(x = x_F + x_{F^\perp}\) et \(y = y_F + y_{F^\perp}\), alors \(\lambda x + y = (\lambda x_F + y_F) + (\lambda x_{F^\perp} + y_{F^\perp})\) est la décomposition orthogonale de \(\lambda x + y\), donc \(p(\lambda x + y) = \lambda x_F + y_F = \lambda p(x) + p(y)\). Pour \(u \in F\), la décomposition est \(u = u + 0\), donc \(p(u) = u\) ; d'où \(p(p(x)) = p(x)\) (car \(p(x) \in F\)) et \(\mathrm{Im}\, p = F\). Et \(p(x) = 0\) signifie \(x = 0 + x_{F^\perp}\), soit \(x \in F^\perp\), donc \(\ker p = F^\perp\).
Proposition — Formule de projection en base orthogonale
Si \((v_1, \dots, v_s)\) est une base orthogonale de \(F\), alors \(p(u) = \sum_i \frac{\langle u, v_i\rangle}{\|v_i\|^2}\, v_i\). Pour une base orthonormale \((u_1, \dots, u_s)\) de \(F\) : \(p(u) = \sum_i \langle u, u_i\rangle\, u_i\).
Posons \(w = \sum_i \frac{\langle u, v_i\rangle}{\|v_i\|^2}\, v_i \in F\). Pour chaque \(j\), \(\langle u - w, v_j\rangle = \langle u, v_j\rangle - \frac{\langle u, v_j\rangle}{\|v_j\|^2}\|v_j\|^2 = 0\) (l'orthogonalité annule les autres termes), donc \(u - w \perp F\). Ainsi \(u = w + (u-w)\) est la décomposition orthogonale et \(p(u) = w\).
Méthode — Calculer une projection orthogonale
Si une base orthogonale de \(F\) est donnée ou évidente, on applique la formule de projection terme à terme. Sinon, on prend une base \((w_1, \dots, w_s)\) de \(F\) (pour que le système ci-dessous soit non singulier), on écrit \(p(u) = \sum_j a_j w_j\) et on impose \(u - p(u) \perp w_j\) pour chaque \(j\) — les équations normales \(\langle u - p(u), w_j\rangle = 0\), un petit système linéaire en les \(a_j\) (sans orthogonalisation). Exemple
Dans \(\mathbb{R}^3\), on projette \(u = (1, 0, 0)\) sur \(F = \mathrm{Vect}\big((1,1,1), (1,0,-1)\big)\) (base orthogonale : \(\langle (1,1,1),(1,0,-1)\rangle = 0\)). Alors \(p(u) = \frac{\langle u,(1,1,1)\rangle}{3}(1,1,1) + \frac{\langle u,(1,0,-1)\rangle}{2}(1,0,-1) = \frac13(1,1,1) + \frac12(1,0,-1) = \frac16(5, 2, -1)\). Compétences à pratiquer
- Orthogonal et projection
III.2
Distance à un sous-espace et moindres carrés
La projection orthogonale est le point de \(F\) le plus proche d'un vecteur, et la distance est la longueur de la perpendiculaire abaissée. La même idée ajuste une droite à un nuage de données : les moindres carrés.
Définition — Distance à un sous-espace
La distance de \(x \in \mathbb{R}^n\) à un sous-espace \(F\) est \(d(x, F) = \inf_{y \in F} \|x - y\|\). Théorème — Distance par la projection
Pour \(x \in \mathbb{R}^n\) et un sous-espace \(F\), \(d(x, F) = \|x - p(x)\|\), le minimum étant atteint en \(y = p(x)\).
Pour \(y \in F\), écrivons \(x - y = (x - p(x)) + (p(x) - y)\). Le premier terme est dans \(F^\perp\) (car \(x - p(x) = x_{F^\perp}\)), le second dans \(F\), ils sont donc orthogonaux et Pythagore donne $$\|x - y\|^2 = \|x - p(x)\|^2 + \|p(x) - y\|^2 \ge \|x - p(x)\|^2.$$ L'égalité a lieu pour \(y = p(x)\), donc la borne inférieure est \(\|x - p(x)\|\).
Méthode — Calculer une distance à un sous-espace
On projette \(x\) sur \(F\) (formule de projection ou équations normales), puis \(d(x, F) = \|x - p(x)\|\). De façon équivalente, avec une base orthonormale \((u_1, \dots, u_n)\) de \(\mathbb{R}^n\) prolongeant une de \(F\) (dont l'existence est admise), \(d(x,F)^2\) est la somme des carrés des coordonnées de \(x\) le long des vecteurs de base situés dans \(F^\perp\). Exemple
Distance de \(x = (2, 3, -1)\) à \(F = \mathrm{Vect}\big((1,1,1), (1,0,-1)\big)\) : la troisième direction orthogonale est \((1,-2,1)\) (orthogonale aux deux, norme \(\sqrt6\)), et \(d(x,F) = \frac{|\langle x, (1,-2,1)\rangle|}{\sqrt6} = \frac{|2 - 6 - 1|}{\sqrt6} = \frac{5}{\sqrt6}\).
Moindres carrés. Ajuster une loi affine \(y = ax + b\) à un nuage \((x_i, y_i)_{1 \le i \le n}\) revient à minimiser \(\sum_i (y_i - a x_i - b)^2\). Avec \(X = (x_1, \dots, x_n)\), \(Y = (y_1, \dots, y_n)\) et \(U = (1, \dots, 1)\), c'est \(\|Y - (aX + bU)\|^2\), donc le meilleur \(aX + bU\) est la projection orthogonale de \(Y\) sur \(\mathrm{Vect}(X, U)\). Attention : \((X, U)\) n'est en général pas orthogonale, donc on ne lit pas les coefficients sur la formule de projection ; les \((a, b)\) optimaux résolvent les équations normales \(\langle Y - aX - bU, X\rangle = 0\) et \(\langle Y - aX - bU, U\rangle = 0\), soit les formules de régression rappelées \(a = \mathrm{Cov}(x, y)/\mathrm{Var}(x)\) et \(b = \bar y - a\bar x\) (en supposant les \(x_i\) non tous égaux). La démonstration n'est pas exigible à ce niveau.
Pour aller plus loin. Le produit scalaire sous-tend la statistique (la droite de régression, la corrélation comme un cosinus) et la géométrie des variables aléatoires des chapitres de probabilités à venir ; le théorème spectral est le socle de l'analyse en composantes principales.
Compétences à pratiquer
- Distance et ajustement de droite
Aller à la section