Éducation Nationale Française · BCPST 2
Théorèmes limites
Ce chapitre étudie ce qui se passe lorsqu'une expérience est répétée un très grand nombre de fois. À partir d'un \(n\)-échantillon on forme la moyenne empirique, la proportion empirique et la variance empirique — des quantités calculées sur les données, elles-mêmes aléatoires. La loi faible des grands nombres dit que la moyenne empirique se rapproche de la moyenne théorique quand \(n\) grandit ; elle découle aussitôt de l'inégalité de Bienaymé-Tchebychev. La convergence en loi précise l'idée qu'une loi en approche une autre : une binomiale de petit \(p\) est proche d'une loi de Poisson, et — par le théorème central limite — la moyenne empirique standardisée de n'importe quelle loi de variance finie non nulle est proche de la normale \(\mathcal{N}(0,1)\). Ces approximations permettent de remplacer une loi compliquée par une loi normale. Enfin, une introduction aux tests de conformité utilise le théorème central limite pour décider si un échantillon est conforme à une population de référence.
I
La loi faible des grands nombres
I.1
Moyenne, proportion et variance empiriques
Répéter une expérience \(n\) fois donne un \(n\)-échantillon : \(n\) variables indépendantes de même loi. On en calcule la moyenne empirique, la proportion empirique d'un événement, et la variance empirique — chacune une variable aléatoire, variant d'une série d'essais à l'autre. La figure montre la proportion empirique de piles se rapprochant de la probabilité théorique quand \(n\) grandit. 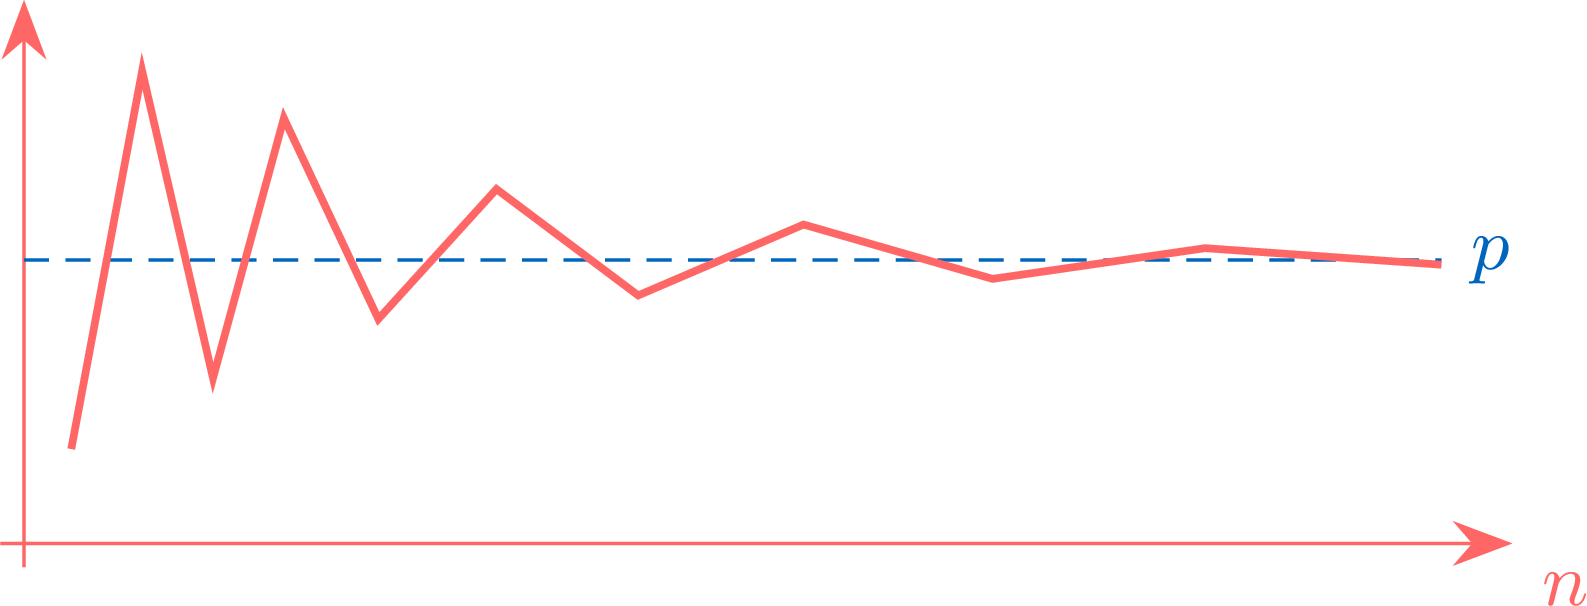
Définition — \(n\)-échantillon
Un \(n\)-échantillon d'une variable aléatoire \(X\) est un \(n\)-uplet \((X_1, \dots, X_n)\) de variables aléatoires mutuellement indépendantes, chacune de même loi que \(X\). Définition — Moyenne, proportion et variance empiriques
Pour un \(n\)-échantillon \((X_1, \dots, X_n)\), la moyenne empirique est \(M_n = \dfrac{X_1 + \dots + X_n}{n}\). La proportion empirique d'un événement \(E\) est \(P_n = \dfrac{B_1 + \dots + B_n}{n}\), où \(B_i = 1\) si \(E\) se produit à l'essai \(i\) et \(0\) sinon (chaque \(B_i\) une variable de Bernoulli, donc \(P_n\) est la moyenne empirique des indicatrices). La variance empirique est \(S_n^2 = \dfrac1n \sum_{i=1}^n (X_i - M_n)^2\). Proposition — Espérance et variance de la moyenne empirique
Si \(X\) a pour espérance \(\mu\) et variance \(\sigma^2\), alors \(\mathbb{E}(M_n) = \mu\) et \(\mathrm{Var}(M_n) = \dfrac{\sigma^2}{n}\).
Par linéarité, \(\mathbb{E}(M_n) = \frac1n \sum_i \mathbb{E}(X_i) = \frac1n \cdot n\mu = \mu\). Les \(X_i\) sont mutuellement indépendantes, donc la variance de leur somme est la somme des variances (variance d'une somme de variables indépendantes, vue précédemment) : $$\mathrm{Var}(M_n) = \frac{1}{n^2} \mathrm{Var}\Big( \sum_i X_i \Big) = \frac{1}{n^2} \sum_i \mathrm{Var}(X_i) = \frac{1}{n^2}\cdot n\sigma^2 = \frac{\sigma^2}{n}.$$
Proposition — Variance empirique et variance corrigée
Si \(X\) a pour variance \(\sigma^2\), alors \(\mathbb{E}(S_n^2) = \dfrac{n - 1}{n}\,\sigma^2\). Pour \(n \ge 2\), la variance empirique corrigée \(\widehat{S_n^2} = \dfrac{n}{n - 1}\, S_n^2\) vérifie alors \(\mathbb{E}(\widehat{S_n^2}) = \sigma^2\).
On développe \(\sum_i (X_i - M_n)^2 = \sum_i X_i^2 - n M_n^2\). Avec \(\mathbb{E}(X_i^2) = \sigma^2 + \mu^2\) et \(\mathbb{E}(M_n^2) = \mathrm{Var}(M_n) + \mu^2 = \frac{\sigma^2}{n} + \mu^2\), $$\begin{aligned} \mathbb{E}\Big( \sum_i (X_i - M_n)^2 \Big) &= n(\sigma^2 + \mu^2) - n\Big( \tfrac{\sigma^2}{n} + \mu^2 \Big) && \text{(linéarité)} \\
&= n\sigma^2 - \sigma^2 = (n - 1)\sigma^2. \end{aligned}$$ En divisant par \(n\) on obtient \(\mathbb{E}(S_n^2) = \frac{n-1}{n}\sigma^2\) ; d'où \(\mathbb{E}(\widehat{S_n^2}) = \frac{n}{n-1}\cdot\frac{n-1}{n}\sigma^2 = \sigma^2\) (c'est pourquoi on corrige par \(\frac{n}{n-1}\)).
Exemple
Un dé équilibré est lancé \(5\) fois, donnant \((1, 6, 3, 6, 2)\). La moyenne empirique est \(M_5 = \frac{1+6+3+6+2}{5} = 3{,}6\), proche mais différente de la moyenne théorique \(3{,}5\). (Bien estimer la variance nécessite un grand échantillon, donc un \(5\)-échantillon n'illustre que les définitions.) Compétences à pratiquer
- Quantités empiriques
I.2
Markov, Bienaymé-Tchebychev et la loi faible
Deux inégalités, rappelées du chapitre discret, bornent la probabilité d'un grand écart. Appliquée à la moyenne empirique, Bienaymé-Tchebychev donne la loi faible des grands nombres : la moyenne empirique se rapproche de la moyenne théorique quand l'échantillon grandit.
Théorème — Inégalité de Markov (rappel)
Pour une variable positive \(X \ge 0\) admettant une espérance et tout \(a > 0\), \(\;P(X \ge a) \le \dfrac{\mathbb{E}(X)}{a}\). Théorème — Inégalité de Bienaymé-Tchebychev (rappel)
Pour une variable \(X\) admettant une variance et tout \(\varepsilon > 0\), \(\;P\big(|X - \mathbb{E}(X)| \ge \varepsilon\big) \le \dfrac{\mathrm{Var}(X)}{\varepsilon^2}\).
On applique Markov à la variable positive \((X - \mathbb{E}(X))^2\) au niveau \(\varepsilon^2\) : comme \(|X - \mathbb{E}(X)| \ge \varepsilon \Leftrightarrow (X - \mathbb{E}(X))^2 \ge \varepsilon^2\), $$P\big(|X - \mathbb{E}(X)| \ge \varepsilon\big) = P\big((X - \mathbb{E}(X))^2 \ge \varepsilon^2\big) \le \frac{\mathbb{E}\big((X - \mathbb{E}(X))^2\big)}{\varepsilon^2} = \frac{\mathrm{Var}(X)}{\varepsilon^2}.$$
Théorème — Loi faible des grands nombres
Soit \((X_i)_{i \ge 1}\) une suite de variables mutuellement indépendantes, toutes de la loi d'une variable \(X\) de moyenne \(\mu\) et variance \(\sigma^2\), et notons \(M_n = \frac1n(X_1 + \dots + X_n)\). Alors, pour tout \(\varepsilon > 0\), $$\lim_{n \to +\infty} P\big(|M_n - \mu| \ge \varepsilon\big) = 0.$$
On a \(\mathbb{E}(M_n) = \mu\) et \(\mathrm{Var}(M_n) = \sigma^2/n\). Bienaymé-Tchebychev appliquée à \(M_n\) donne, pour tout \(\varepsilon > 0\), $$0 \le P\big(|M_n - \mu| \ge \varepsilon\big) \le \frac{\mathrm{Var}(M_n)}{\varepsilon^2} = \frac{\sigma^2}{n\varepsilon^2} \xrightarrow[n \to +\infty]{} 0,$$ donc la limite est \(0\) par encadrement.
Méthode — Estimer des quantités théoriques
Pour un grand échantillon, la moyenne empirique estime la moyenne théorique (\(M_n \approx \mu\)), la proportion empirique d'un événement estime sa probabilité (\(P_n \approx p\)), et la variance empirique corrigée estime la variance (\(\widehat{S_n^2} \approx \sigma^2\)). Les estimations de la moyenne et de la proportion sont justifiées par la loi faible ; l'estimation de la variance repose sur le caractère sans biais (\(\mathbb{E}(\widehat{S_n^2}) = \sigma^2\)). Exemple
En lançant une pièce \(n\) fois et en notant \(P_n\) la proportion de piles, le théorème de Bernoulli (la loi faible pour un échantillon de Bernoulli, \(\mu = p = \frac12\)) donne \(P\big(|P_n - \tfrac12| \ge \varepsilon\big) \to 0\) pour tout \(\varepsilon > 0\) : la fréquence de piles se rapproche de \(\frac12\). Compétences à pratiquer
- Inégalités et loi faible
II
Convergence en loi et approximations
II.1
Convergence en loi et approximation binomiale-Poisson
Deux lois sont « approximativement égales » lorsque leurs fonctions de répartition sont proches. C'est la convergence en loi ; pour des variables à valeurs dans \(\mathbb{N}\) elle se lit directement sur les probabilités \(P(Y_n = k)\). Premier exemple : une loi binomiale avec beaucoup d'épreuves et une petite probabilité de succès est proche d'une loi de Poisson.
Définition — Convergence en loi
Une suite \((Y_n)\) converge en loi vers \(Y\), noté \(Y_n \xrightarrow{\mathcal{L}} Y\), si \(F_{Y_n}(u) \to F_Y(u)\) en tout point \(u\) où \(F_Y\) est continue. Alors, pour \(a, b\) points de continuité de \(F_Y\) (en particulier pour tous \(a, b\) lorsque \(F_Y\) est continue, comme pour une limite normale), \(P(a < Y_n \le b) \to P(a < Y \le b)\). Proposition — Cas des valeurs entières
Si tous les \(Y_n\) et \(Y\) prennent leurs valeurs dans \(\mathbb{N}\), alors \(Y_n \xrightarrow{\mathcal{L}} Y\) si et seulement si \(P(Y_n = k) \to P(Y = k)\) pour tout \(k \in \mathbb{N}\). Admis. C'est le critère pratique pour les limites discrètes. Théorème — Approximation de la binomiale par la Poisson
Soit \(\lambda > 0\). Pour \(n > \lambda\) (de sorte que \(\lambda/n \in\, ]0, 1[\)), si \(X_n \sim \mathcal{B}(n, \lambda/n)\), alors \(X_n \xrightarrow{\mathcal{L}} \mathcal{P}(\lambda)\).
Fixons \(k \in \mathbb{N}\). Pour \(n \ge k\), $$\begin{aligned} P(X_n = k) &= \binom{n}{k}\Big( \tfrac{\lambda}{n} \Big)^k \Big( 1 - \tfrac{\lambda}{n} \Big)^{n-k} \\
&= \frac{\lambda^k}{k!} \cdot \underbrace{\frac{n(n-1)\cdots(n-k+1)}{n^k}}_{\to\, 1} \cdot \underbrace{\Big( 1 - \tfrac{\lambda}{n} \Big)^{n-k}}_{\to\, e^{-\lambda}} && \text{(on regroupe les facteurs)} \\
&\xrightarrow[n \to +\infty]{} \frac{\lambda^k}{k!}\, e^{-\lambda}, \end{aligned}$$ car \((n-k)\ln\big(1 - \tfrac{\lambda}{n}\big) \sim -\lambda\). Par le critère des valeurs entières, \(X_n \xrightarrow{\mathcal{L}} \mathcal{P}(\lambda)\).
Méthode — Approximation binomiale-Poisson
En pratique on approche \(\mathcal{B}(n, p)\) par \(\mathcal{P}(np)\) lorsque \(n \ge 30\) et \(p \le 0{,}1\) (et \(np \le 15\)). Ceci remplace une loi dépendant de \(n\) et \(p\) par une loi ne dépendant que de \(\lambda = np\), évitant de grandes factorielles et puissances. Exemple
Pour \(X \sim \mathcal{B}(50, 0{,}05)\) (\(n = 50 \ge 30\), \(p = 0{,}05 \le 0{,}1\)), on approche par \(\mathcal{P}(2{,}5)\) : \(P(X = 3) \approx e^{-2{,}5}\frac{2{,}5^3}{3!} \approx 0{,}214\), contre la valeur exacte \(0{,}220\). Compétences à pratiquer
- Approximation binomiale-Poisson
II.2
Le théorème central limite et les approximations normales
Le théorème central limite est le résultat le plus profond du chapitre : pour des variables indépendantes et de même loi, de moyenne finie et de variance finie non nulle, la moyenne empirique standardisée tend en loi vers la normale centrée réduite — quelle que soit la loi de \(X\). C'est pourquoi la loi normale est centrale, et il fournit les approximations normales de la binomiale, de la proportion et de la loi de Poisson. 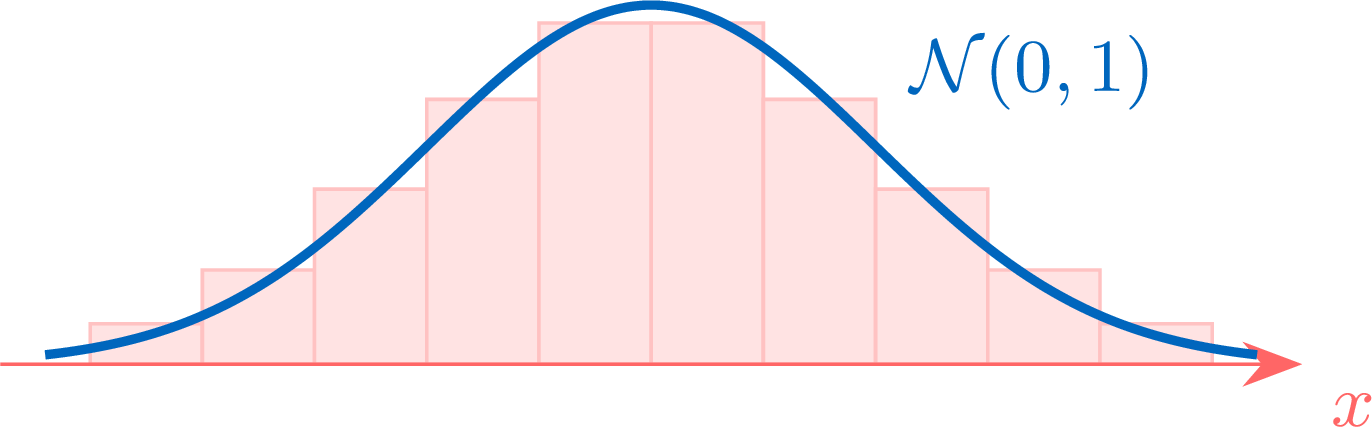
Théorème — Théorème central limite, première forme
Soit \((X_i)_{i \ge 1}\) une suite de variables mutuellement indépendantes, toutes de la loi d'une variable \(X\) de moyenne \(\mu\) et variance \(\sigma^2 \ne 0\), et \(M_n = \frac1n(X_1 + \dots + X_n)\). Alors la moyenne empirique standardisée $$M_n^* = \frac{M_n - \mu}{\sigma/\sqrt{n}} \xrightarrow{\mathcal{L}} \mathcal{N}(0, 1).$$ Admis. Théorème — de Moivre-Laplace
Soit \(0 < p < 1\) et soit \((X_i)_{i \ge 1}\) des variables de Bernoulli \(\mathcal{B}(p)\) indépendantes ; la somme binomiale \(T_n = X_1 + \dots + X_n \sim \mathcal{B}(n, p)\) vérifie $$\frac{T_n - np}{\sqrt{np(1 - p)}} \xrightarrow{\mathcal{L}} \mathcal{N}(0, 1).$$
On prend un \(n\)-échantillon d'une variable de Bernoulli \(X \sim \mathcal{B}(p)\), donc \(\mu = p\), \(\sigma^2 = p(1 - p)\), et \(T_n = \sum_i X_i \sim \mathcal{B}(n, p)\) avec \(M_n = T_n/n\). Le théorème central limite donne \(M_n^* \xrightarrow{\mathcal{L}} \mathcal{N}(0, 1)\), et $$M_n^* = \frac{M_n - p}{\sqrt{p(1-p)}/\sqrt{n}} = \frac{\sqrt{n}\,(T_n/n - p)}{\sqrt{p(1-p)}} = \frac{T_n - np}{\sqrt{np(1 - p)}},$$ qui est donc la limite annoncée.
Proposition — Approximations normales
En pratique : - \(\mathcal{B}(n, p) \approx \mathcal{N}(np,\, np(1 - p))\) lorsque \(n \ge 30\), \(np \ge 5\), \(n(1 - p) \ge 5\) ;
- la proportion empirique \(P_n \approx \mathcal{N}\big( p,\, \tfrac{p(1 - p)}{n} \big)\) (mêmes conditions) ;
- \(\mathcal{P}(\lambda) \approx \mathcal{N}(\lambda,\, \lambda)\) lorsque \(\lambda \ge 18\).
Théorème — Théorème central limite, deuxième forme
Lorsque la variance est inconnue, la même convergence vaut avec \(\sigma\) remplacé par l'écart-type empirique \(S_n = \sqrt{S_n^2}\) : $$\frac{M_n - \mu}{S_n/\sqrt{n}} \xrightarrow{\mathcal{L}} \mathcal{N}(0, 1).$$ Admis. (On lit ceci lorsque \(S_n > 0\), ce qui a lieu avec une probabilité tendant vers \(1\) ; on peut tout aussi bien utiliser la variante corrigée \(\widehat{S_n} = \sqrt{\widehat{S_n^2}}\) à la place de \(S_n\).) Méthode — Calculer une probabilité approchée
Pour approcher une probabilité binomiale, de proportion ou de Poisson, on vérifie les conditions, on remplace la loi par la normale correspondante, on standardise vers \(\mathcal{N}(0, 1)\) et on lit \(\Phi\) dans la table. Exemple
Un dé équilibré est lancé \(n = 100\) fois ; soit \(T_n\) le nombre de six, donc \(T_n \sim \mathcal{B}(100, \tfrac16)\) avec \(np = \tfrac{100}{6} \approx 16{,}7 \ge 5\) et \(n(1-p) \approx 83 \ge 5\). En approchant par \(\mathcal{N}(16{,}7,\, 13{,}9)\) (\(\sigma \approx 3{,}73\)), \(P(T_n \le 20) \approx \Phi\big( \tfrac{20 - 16{,}7}{3{,}73} \big) = \Phi(0{,}88) \approx 0{,}81\). Compétences à pratiquer
- Approximations normales
III
Introduction aux tests de conformité
III.1
Le principe d'un test de conformité
Un test de conformité compare un échantillon à une population de référence pour décider si l'échantillon lui est conforme. On pose une hypothèse nulle \(H_0\) (l'hypothèse précise sur laquelle on calcule) contre une alternative \(H_1\) ; on construit un intervalle \(I\) dans lequel la moyenne empirique se trouve avec une grande probabilité sous \(H_0\) ; une valeur observée hors de \(I\) — très improbable sous \(H_0\) — conduit à rejeter \(H_0\). 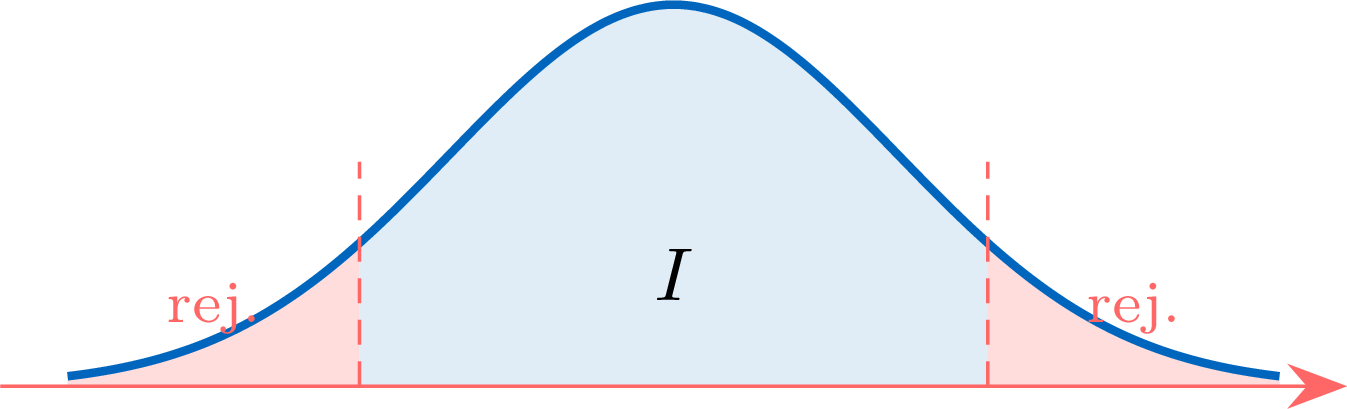
Définition — Hypothèses nulle et alternative
L'hypothèse nulle \(H_0\) est l'hypothèse précise sur laquelle on effectue les calculs (par exemple \(\mu = \mu_0\)) ; l'hypothèse alternative \(H_1\) est l'hypothèse contraire (pour le test bilatéral ici, \(\mu \ne \mu_0\)). Définition — Intervalle d'acceptation et zone de rejet
Pour un niveau de confiance \(c\) proche de \(1\) (par exemple \(c = 0{,}95\)), un intervalle d'acceptation est un intervalle \(I\) avec \(P(M_n \in I) \approx c\) sous \(H_0\) (approché, via le théorème central limite ; exact seulement dans le cas véritablement normal). Son complémentaire \(\mathbb{R} \setminus I\) est la zone de rejet. Méthode — Mener un test de conformité
Sous \(H_0\), on construit l'intervalle d'acceptation \(I\) au niveau de confiance choisi. On calcule la moyenne empirique observée (ou la proportion). Si elle tombe dans la zone de rejet \(\mathbb{R} \setminus I\) — un événement de petite probabilité sous \(H_0\) — on rejette \(H_0\) au profit de \(H_1\). Si elle tombe dans \(I\), on ne peut pas conclure. Exemple
Deux lots de baies ont des poids moyens connus ; on soupçonne qu'un échantillon provient du lot le plus lourd. En posant \(H_0\) = « l'échantillon provient du lot \(1\) (moyenne \(\mu_0\)) », on construit \(I\) autour de \(\mu_0\) ; une moyenne d'échantillon observée loin hors de \(I\) conduit à rejeter \(H_0\). Compétences à pratiquer
- Construire et lire un intervalle d'acceptation
III.2
Test de conformité d'une moyenne et d'une proportion
L'intervalle d'acceptation se construit à partir du théorème central limite — avec \(\sigma\) connu (première forme) ou inconnu (deuxième forme, \(\sigma\) remplacé par \(S_n\)). Le cas nommé par le programme est le test d'une proportion, construit à partir de l'approximation normale d'une proportion.
Proposition — Intervalle d'acceptation pour une moyenne
Sous \(H_0 : \mu = \mu_0\), avec \(\sigma\) connu, \(P\big( |M_n - \mu_0| < a\,\tfrac{\sigma}{\sqrt{n}} \big) \to 2\Phi(a) - 1\), donc l'intervalle d'acceptation approché au niveau de confiance \(2\Phi(a) - 1\), pour \(n\) grand, est $$I = \Big[ \mu_0 - a\,\tfrac{\sigma}{\sqrt{n}},\; \mu_0 + a\,\tfrac{\sigma}{\sqrt{n}} \Big].$$ Lorsque \(\sigma\) est inconnu, on remplace \(\sigma\) par \(S_n\) (deuxième forme), le test se lisant sur la statistique \(|M_n - \mu_0|/(S_n/\sqrt{n})\).
Par le théorème central limite, \(\frac{M_n - \mu_0}{\sigma/\sqrt{n}} \xrightarrow{\mathcal{L}} Z \sim \mathcal{N}(0, 1)\), donc pour \(a > 0\), $$P\Big( \big| \tfrac{M_n - \mu_0}{\sigma/\sqrt{n}} \big| < a \Big) \to P(|Z| < a) = 2\Phi(a) - 1.$$ L'événement \(|\frac{M_n - \mu_0}{\sigma/\sqrt{n}}| < a\) est exactement \(M_n \in I\), ce qui donne l'intervalle.
Proposition — Intervalle d'acceptation pour une proportion
Sous \(H_0 : p = p_0\) (un événement de probabilité théorique \(p_0\)), la proportion empirique \(P_n\) vérifie \(P\big( |P_n - p_0| < a\sqrt{\tfrac{p_0(1 - p_0)}{n}} \big) \to 2\Phi(a) - 1\). En pratique, sous les conditions \(n \ge 30\), \(np_0 \ge 5\), \(n(1 - p_0) \ge 5\), ceci donne l'intervalle d'acceptation approché $$I = \Big[ p_0 - a\sqrt{\tfrac{p_0(1 - p_0)}{n}},\; p_0 + a\sqrt{\tfrac{p_0(1 - p_0)}{n}} \Big].$$ Méthode — Test de conformité d'une moyenne ou d'une proportion
On choisit un niveau de confiance proche de \(1\) ; on cherche \(a\) vérifiant \(2\Phi(a) - 1 = \text{niveau}\) (par exemple \(a \approx 1{,}96\) pour \(0{,}95\)). On construit \(I\) autour de la valeur théorique \(\mu_0\) (ou \(p_0\)). On rejette \(H_0\) si la moyenne empirique (ou proportion) observée tombe hors de \(I\) ; sinon on ne conclut pas. Exemple
Un fournisseur annonce des baies de poids moyen \(\mu_0 = 16\) g, avec \(\sigma = 2\) g. Sur \(n = 100\) baies on observe \(M_n = 16{,}5\) g. Au niveau de confiance \(0{,}95\) (\(a \approx 1{,}96\)), \(I = [16 - 1{,}96\cdot\tfrac{2}{10},\, 16 + 1{,}96\cdot\tfrac{2}{10}] = [15{,}61,\, 16{,}39]\). Comme \(16{,}5 \notin I\), on rejette \(H_0\) au niveau de confiance \(0{,}95\) : la moyenne observée n'est pas compatible avec la moyenne annoncée (on ne prouve évidemment pas la non-conformité avec certitude). Compétences à pratiquer
- Tests de moyenne et de proportion
- Synthèse
Aller à la section