Mathématiques en ECG approfondies 2
13 chapitres, dans l'ordre du programme : cours, vidéos et exercices corrigés, gratuits au départ.
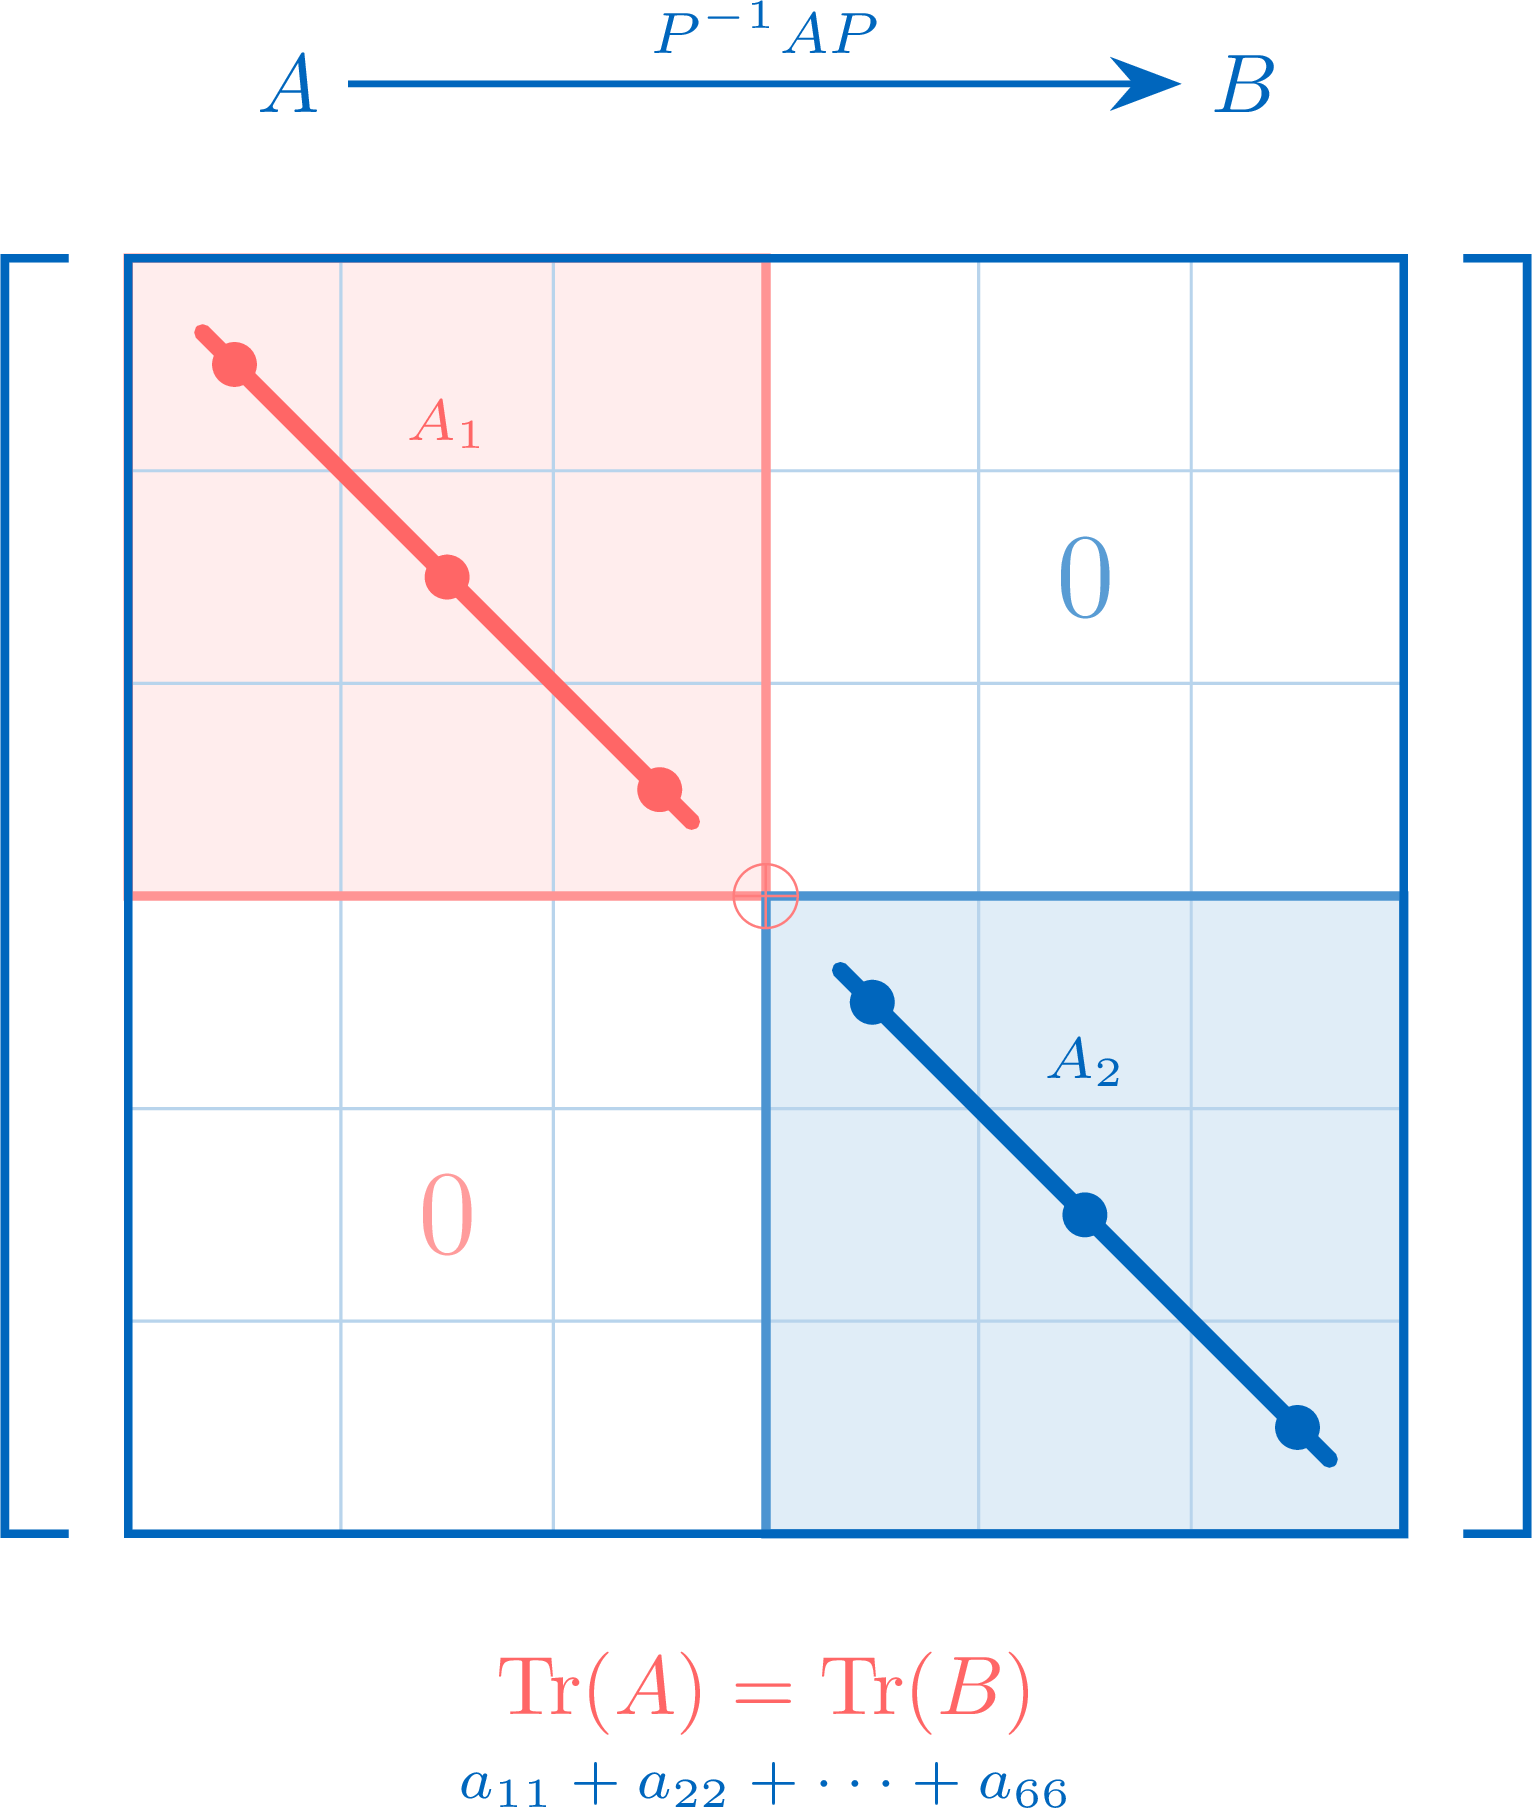
Compléments d'algèbre linéaire
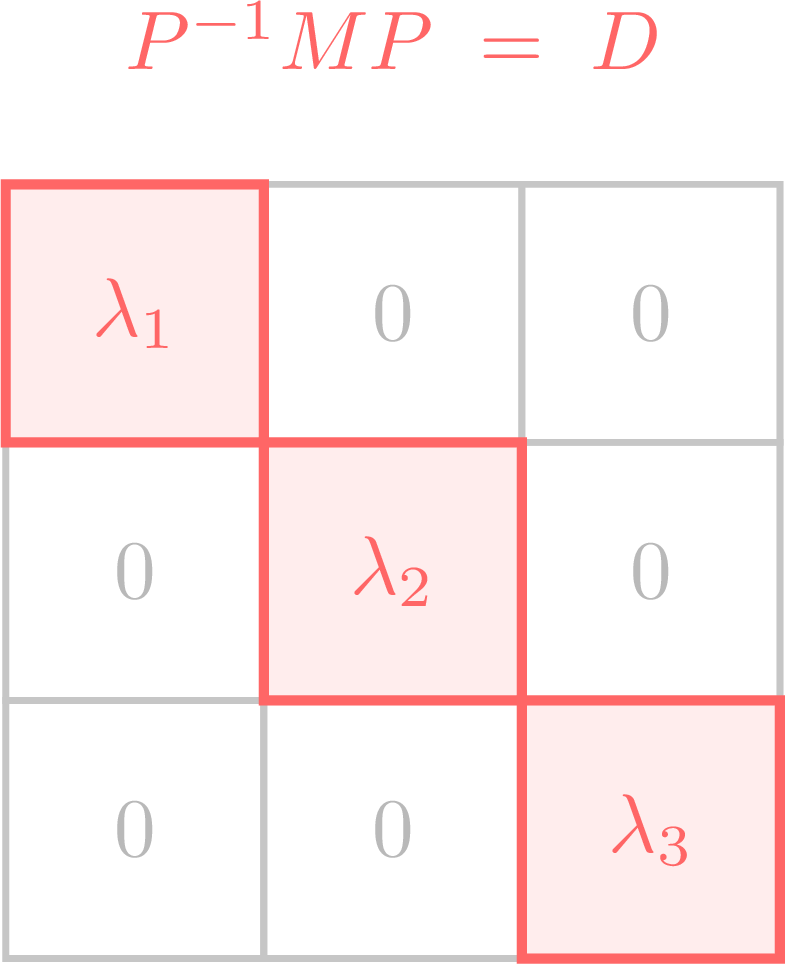
Éléments propres et réduction
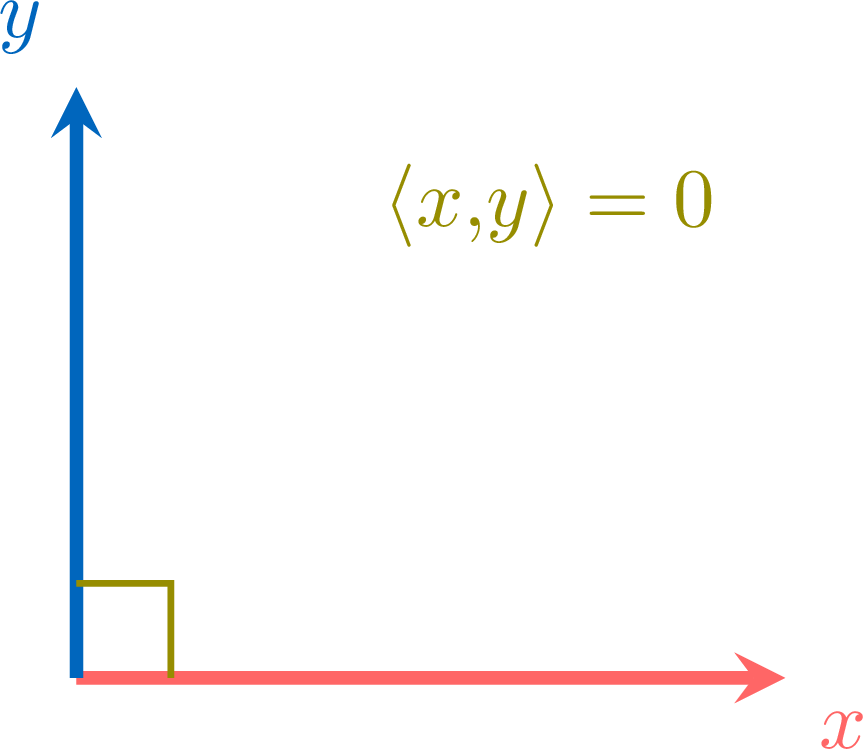
Produit scalaire et espaces euclidiens
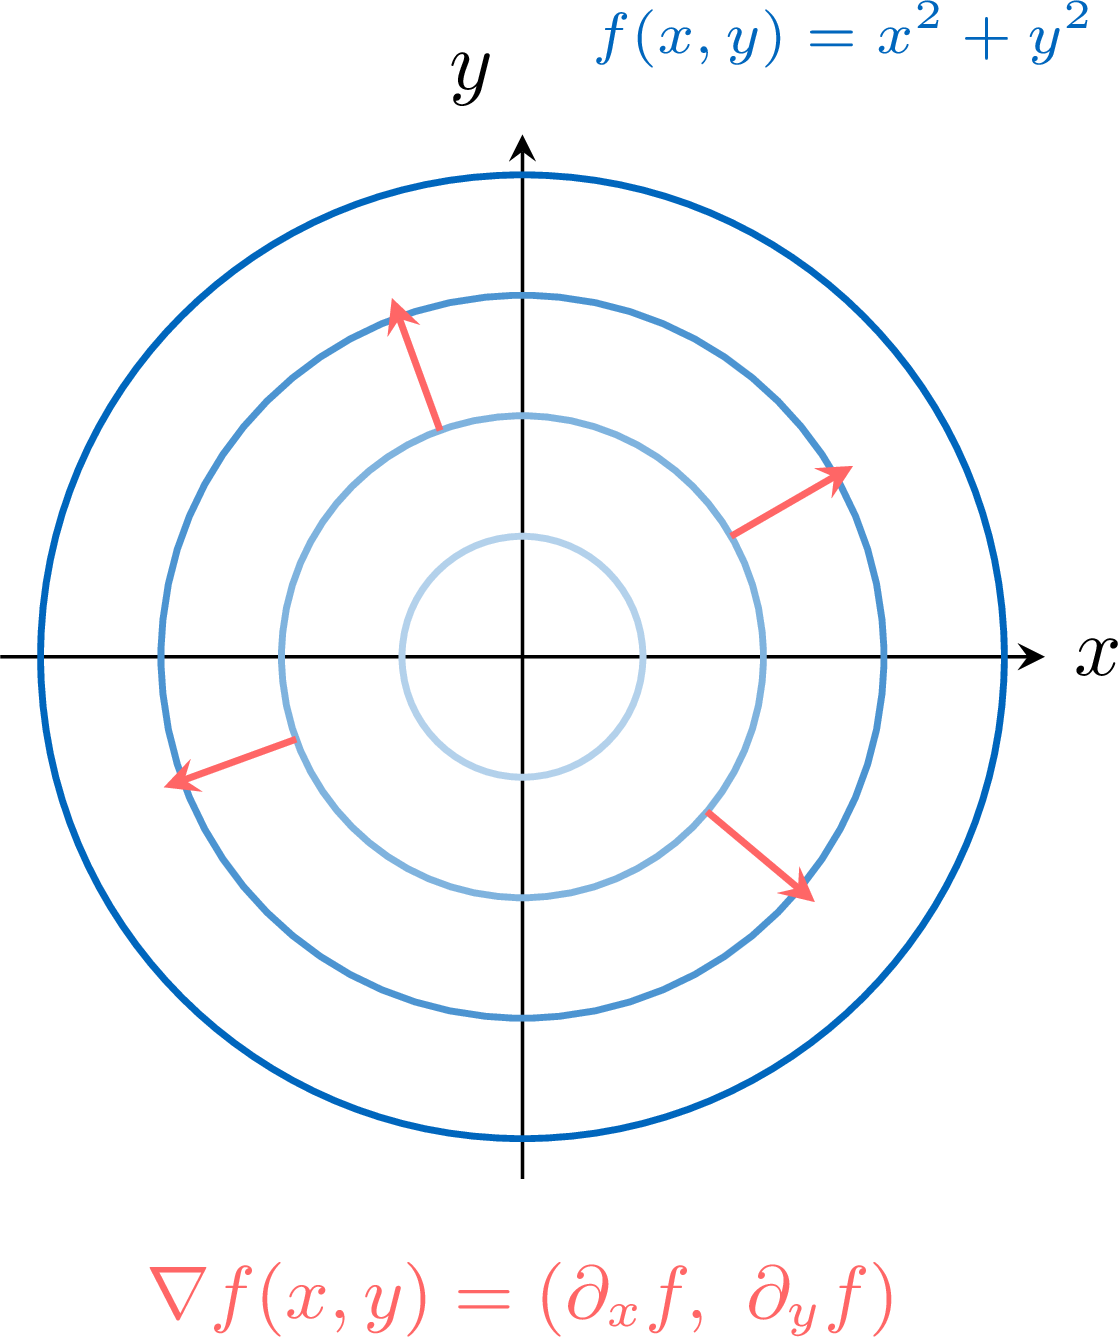
Fonctions de plusieurs variables
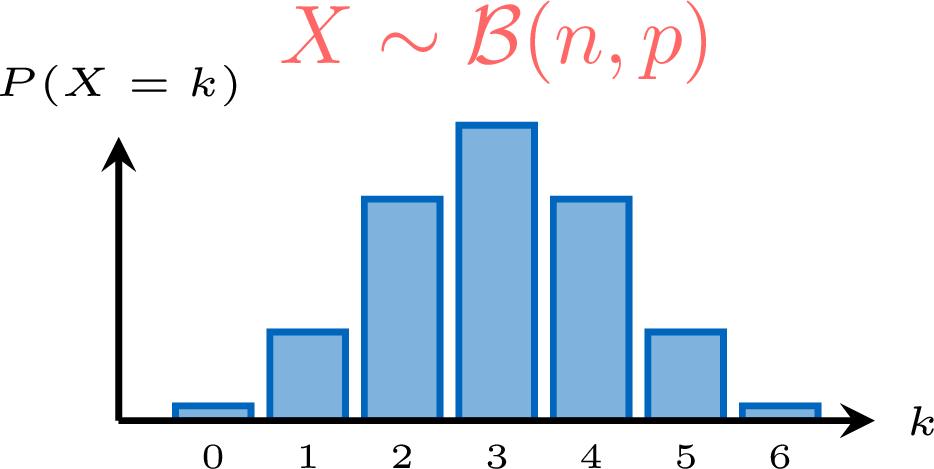
Compléments sur les variables aléatoires
Variables aléatoires à densité
Vecteurs aléatoires
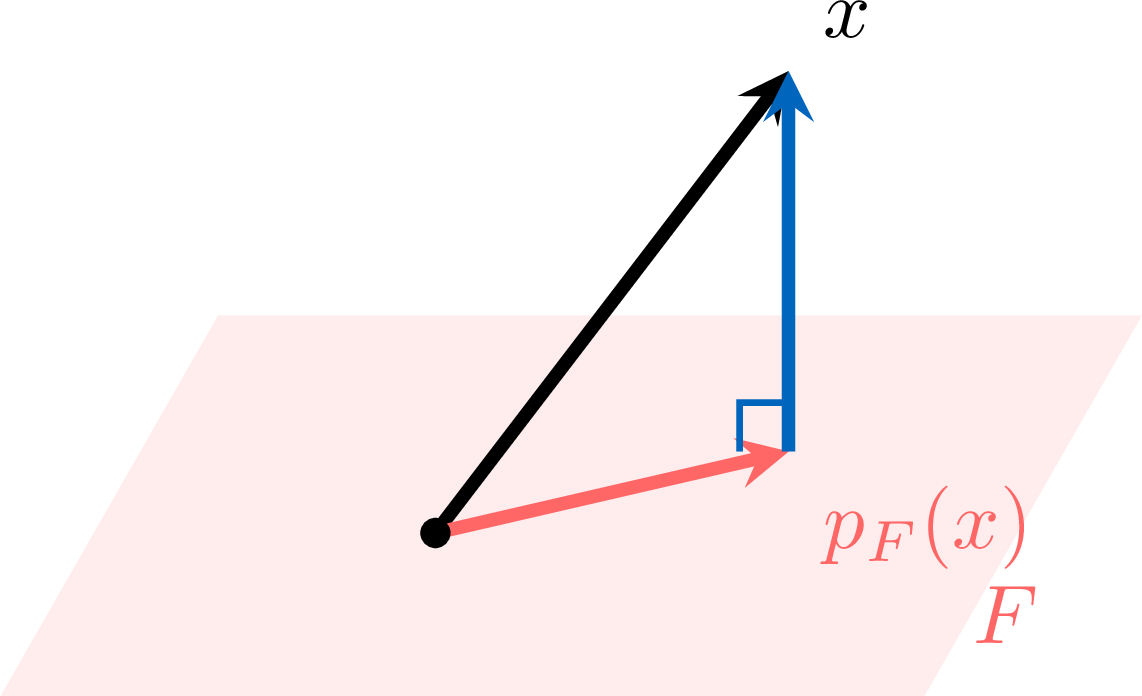
Projection orthogonale
Endomorphismes symétriques (théorème spectral)
Optimisation dans \(\mathbb{R}^n\)
Convergences de variables aléatoires et approximations
Estimation ponctuelle et qualité des estimateurs
Intervalles de confiance
Au programme
- Compléments d'algèbre linéaire — Trois compléments d'algèbre linéaire de première année. Sommes directes de k sous-espaces : définition, critère de décomposition nulle (et le piège de l'intersection deux à deux pour k >= 3), bases adaptées, caractérisation par concaténation de bases, et dimension d'une somme directe. Changement de base : matrice de passage P_{B,B'} et son inverse, formule de changement de base Mat_{B'}(f) = P^{-1} Mat_B(f) P, et relation de similitude des matrices (relation d'équivalence, théorème du même endomorphisme dans deux bases, invariance du rang). Trace : définition comme somme des coefficients diagonaux, linéarité, identité Tr(AB) = Tr(BA), invariance par changement de base, deux matrices semblables ont la même trace, et trace d'un endomorphisme (bien définie). Le rang et la trace apparaissent comme les deux invariants pratiques pour les questions de similitude.
- Éléments propres et réduction — Éléments propres et diagonalisation d'un endomorphisme ou d'une matrice carrée sur R. Valeurs propres, vecteurs propres et sous-espaces propres E_lambda = ker(f - lambda Id) ; spectre Sp(f), Sp(A) ; la caractérisation lambda dans Sp(f) ssi f - lambda Id n'est pas injective (non bijective en dimension finie), et l'analogue matriciel par la non-inversibilité ; la valeur propre 0 ; l'identité Q(f)(x) = Q(lambda)x et l'inclusion à sens unique Q(lambda) dans Sp(Q(f)). Recherche des valeurs propres : matrices triangulaires (coefficients diagonaux), équation du déterminant 2x2 det(A - lambda I) = 0, et polynômes annulateurs (projecteur, symétrie, A^2 = 3A - 2I), les valeurs propres étant parmi les racines, plus l'existence d'un polynôme annulateur non nul. Propriétés générales : des vecteurs propres pour des valeurs propres distinctes sont libres, les sous-espaces propres sont en somme directe, l'inégalité des dimensions somme dim E_lambda <= dim E, au plus n valeurs propres. Diagonalisabilité : f diagonalisable ssi il existe une base de vecteurs propres ssi somme dim E_lambda = dim E ssi E est la somme directe des sous-espaces propres ; n valeurs propres distinctes est suffisant ; diagonalisation matricielle A = P D P^{-1} avec les colonnes de P vecteurs propres ; puissances A^k = P D^k P^{-1} ; et la trace d'une matrice diagonalisable comme somme des valeurs propres avec multiplicité. Pas de théorie du polynôme caractéristique (seulement le raccourci du déterminant 2x2), pas de valeurs propres complexes, pas de trigonalisation.
- Produit scalaire et espaces euclidiens — Algèbre bilinéaire : produits scalaires et espaces euclidiens sur R. Un produit scalaire est une forme bilinéaire symétrique définie positive ; produit scalaire canonique sur R^n, produit scalaire intégral sur les polynômes. Norme euclidienne, identité de polarisation, inégalité de Cauchy-Schwarz (égalité ssi colinéaires, cas du vecteur nul isolé) et inégalité triangulaire. Orthogonalité des vecteurs et des sous-espaces (testée sur des familles génératrices), théorème de Pythagore et sa généralisation à sens unique à une famille deux à deux orthogonale. Familles orthogonales et orthonormales finies, le fait qu'une famille orthogonale de vecteurs non nuls est libre. Espaces euclidiens et bases orthonormées : existence (admise, le procédé constructif de Gram-Schmidt étant non exigible), coordonnées et norme dans une base orthonormée (x = somme <x,e_i> e_i, ||x||^2 = somme <x,e_i>^2, <x,y> = tXY). Supplémentaire orthogonal F-perp et la décomposition E = F (+) F-perp avec dim F-perp = dim E - dim F (preuve non circulaire), complétion d'une famille orthonormale, changement de base orthonormée avec une matrice de passage orthogonale P^{-1} = tP. Pas de projection orthogonale (chapitre du quatrième semestre), pas de théorie du groupe orthogonal au-delà de P^{-1}=tP, familles finies seulement.
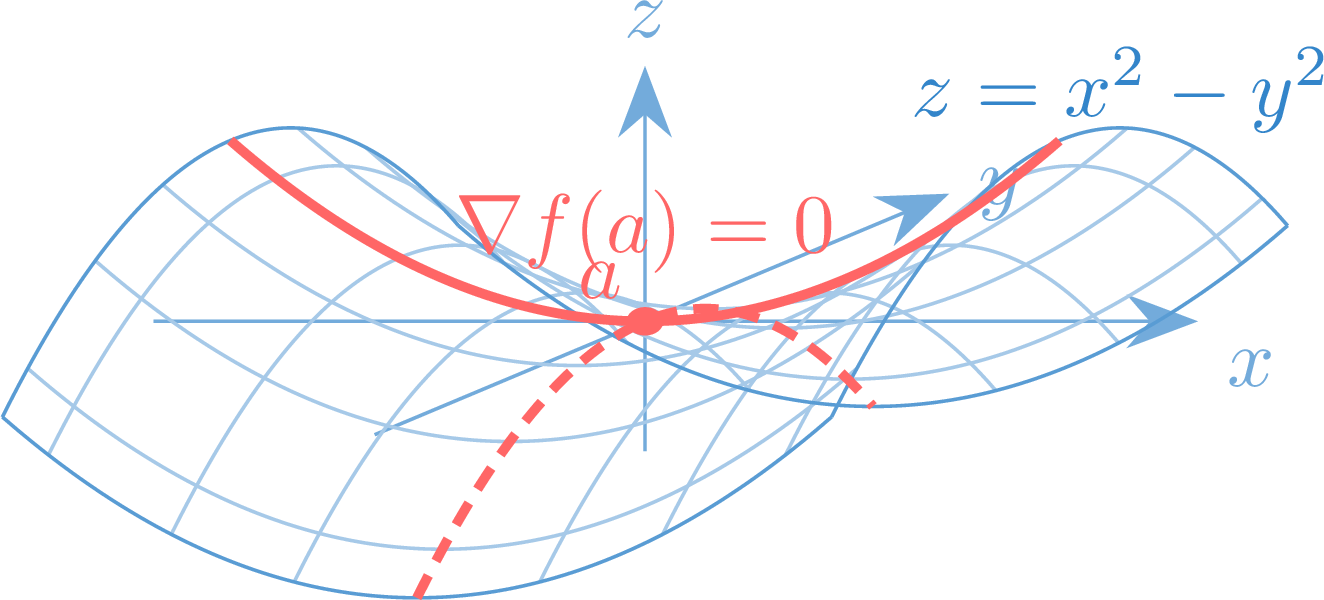
- Fonctions de plusieurs variables — Fonctions de plusieurs variables sur R^n a valeurs dans R. Fonctions polynomiales et affines ; graphe (une surface pour n = 2), lignes de niveau (cercles, droites, paraboles, hyperboles) et leur lecture economique (droites d'iso-cout). Continuite via la norme euclidienne canonique (definition epsilon-alpha) : les applications coordonnees sont continues, les fonctions polynomiales sont continues (admis), et les operations (somme, produit, quotient a denominateur non nul, composition avec une fonction d'une variable) preservent la continuite (admis). Calcul differentiel : fonctions partielles, derivees partielles d_i f, gradient grad f(a) dans R^n, derivees d'ordre deux d^2_{i,j} f et classes C^1 et C^2 (les polynomes sont C^2 et les operations preservent la classe, admis). Developpement limite d'ordre un f(a+h) = f(a) + <grad f(a), h> + ||h|| eps(h) (admis), d'ou : une fonction C^1 est continue (preuve par Cauchy-Schwarz), la derivee selon une direction g'(t) = <grad f(a+tu), u>, et l'interpretation du gradient comme direction de plus grande pente (cas d'egalite de Cauchy-Schwarz). Extrema : minima/maxima globaux et locaux ; condition necessaire du premier ordre grad f(c) = 0 (demontree par reduction aux fonctions partielles d'une variable) ; points critiques ; la reciproque est fausse (point selle x^2 - y^2). La nature d'un point critique se decide a ce niveau par le signe de f(x) - f(c) (sommes de carres) ou en ecartant un extremum le long d'une direction. Pas de matrice hessienne, pas de theoreme de Schwarz, pas de test du second ordre, pas d'optimisation sous contrainte, pas de topologie (tout cela renvoye au chapitre d'optimisation).
- Compléments sur les variables aléatoires — Compléments sur les variables aléatoires réelles sur un espace probabilisé (Omega, A, P). Une variable aléatoire réelle est une application X : Omega -> R avec [X <= x] un événement pour tout x (de façon équivalente [X dans I] un événement pour tout intervalle I) ; les opérations X+Y, XY, lambda X, min, max sont des variables aléatoires (admis), et l'indicatrice 1_A est une variable de Bernoulli B(P(A)). La fonction de répartition F_X(x) = P(X <= x) encode toute la loi : P(X > a) = 1 - F_X(a), P(a < X <= b) = F_X(b) - F_X(a), et deux variables de même F_X ont la même loi. Une fonction de répartition est croissante, continue à droite, de limites 0 en -infini et 1 en +infini ; P(X = x) = F_X(x) - lim_{t->x-} F_X(t) est le saut en x, et les sauts sont exactement les atomes. Pour une variable discrète, F_X(x) = somme_{z <= x} P(X = z), un escalier. Espérance conditionnelle sachant un événement A (P(A) != 0) : E(X | A) = somme_x x P_A(X = x) (définie sous convergence absolue) ; si X admet une espérance alors elle en admet une sachant A (domination), et E(. | A) est linéaire. Formule de l'espérance totale : pour un système complet d'événements (A_n), fini ou dénombrable, avec P(A_n) != 0, une variable discrète X admet une espérance (avec le critère de convergence somme_n P(A_n) E(|X| | A_n) dans le cas dénombrable) et E(X) = somme_n P(A_n) E(X | A_n) – l'analogue, pour l'espérance, de la formule des probabilités totales, démontrée dans le cas fini. Pas de développement à densité / variables continues (chapitre suivant), pas de vecteurs aléatoires, pas de preuves de mesurabilité, pas de théorie des familles sommables.
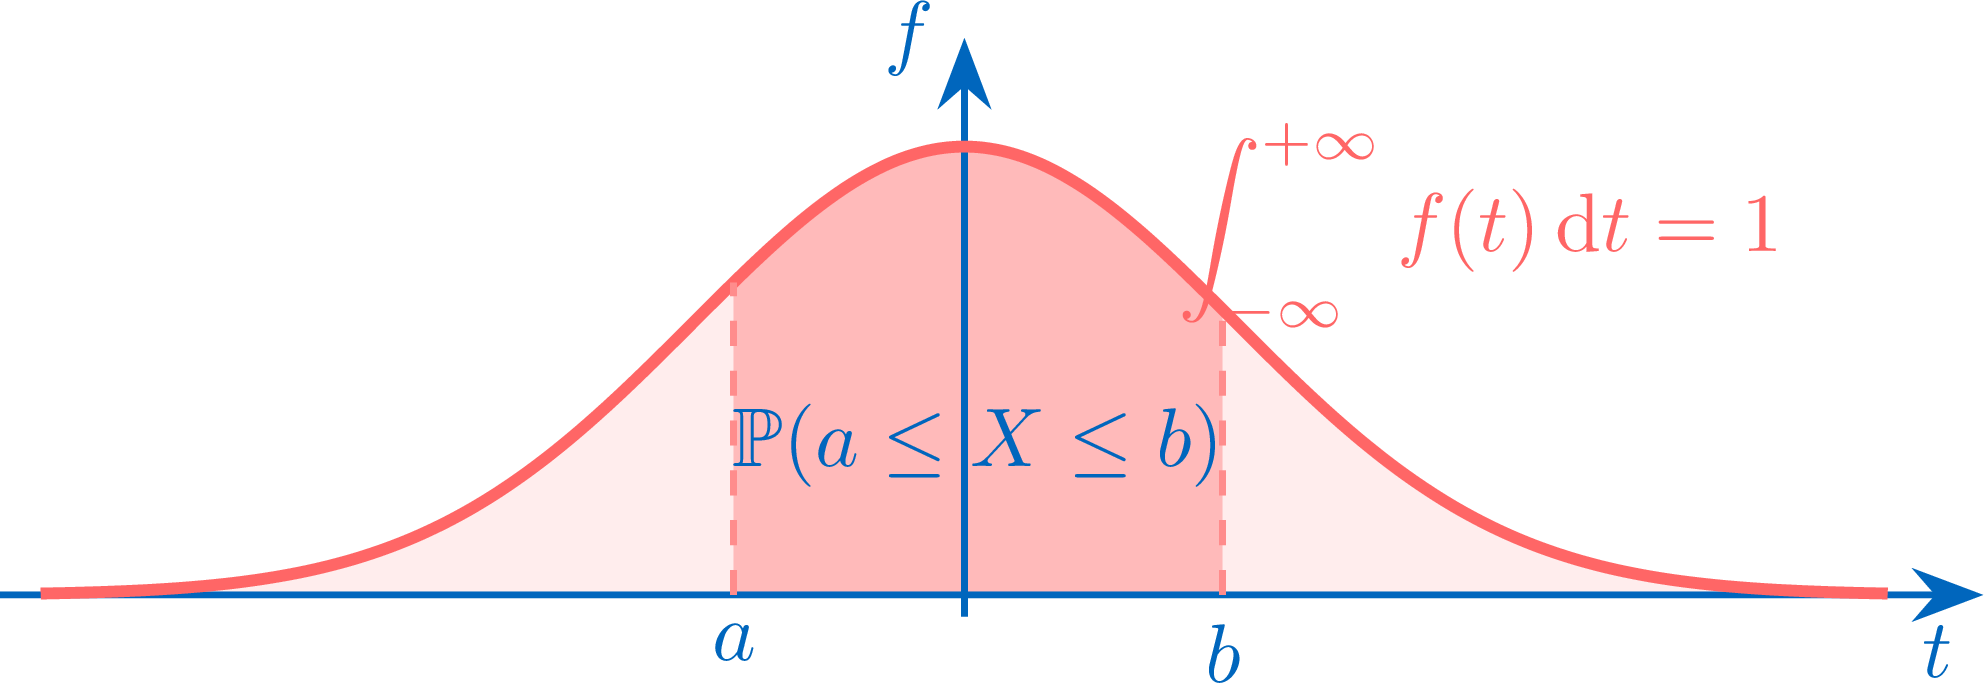
- Variables aléatoires à densité — Variables aleatoires continues (a densite). Une variable a densite X a une fonction de repartition F_X continue, C1 par morceaux, et une densite f_X (positive ou nulle, continue sauf en un nombre fini de points, d'integrale totale 1) avec F_X(x) = integrale_{-inf}^x f_X ; P(X=a)=0 et P(a<=X<=b) = integrale_a^b f_X (toutes les formes d'intervalle coincident) ; la densite n'est pas unique. Fonctions d'une variable a densite : la transformee affine aX+b (a != 0) a pour densite (1/|a|) f_X((t-b)/a) (demontre), et la methode en quatre etapes (via F_{g(X)}) donne la densite de X^2, e^X, et de phi(X) pour phi C1 strictement monotone. Esperance E(X) = integrale t f_X(t) dt (convergence absolue ; la loi de Cauchy n'en a pas), avec linearite/croissance/domination et le theoreme de transfert E(phi(X)) = integrale phi(t) f_X(t) dt admis ; E(aX+b) = aE(X)+b demontre. Moments et variance : V(X) = E((X-E(X))^2) = E(X^2) - E(X)^2 (Koenig-Huygens, demontre), V(aX+b) = a^2 V(X), ecart-type et variable centree reduite. Les quatre lois usuelles a densite avec densite, fonction de repartition, esperance et variance : uniforme U([a,b]) (E=(a+b)/2, V=(b-a)^2/12) ; exponentielle E(lambda) (E=1/lambda, V=1/lambda^2, sans memoire) ; normale N(mu,sigma^2) (E=mu, V=sigma^2, normale centree reduite Phi avec Phi(-x)=1-Phi(x), transformee affine et centrage-reduction, table de Laplace-Gauss) ; loi gamma a un parametre gamma(nu) construite sur la fonction Gamma d'Euler (Gamma(nu+1)=nu Gamma(nu), Gamma(n+1)=n!, Gamma(1/2)=racine(pi)), avec E=V=nu et gamma(1)=E(1). Les outils d'integrales generalisees (dont int e^{-x^2/2} = racine(2 pi), admise) sont rappeles et utilises ; la simulation Python des lois (numpy.random, methode d'inversion) clot le chapitre. Pas de densites conjointes ni de vecteurs aleatoires (chapitre suivant), pas de theoreme central limite (ulterieur).
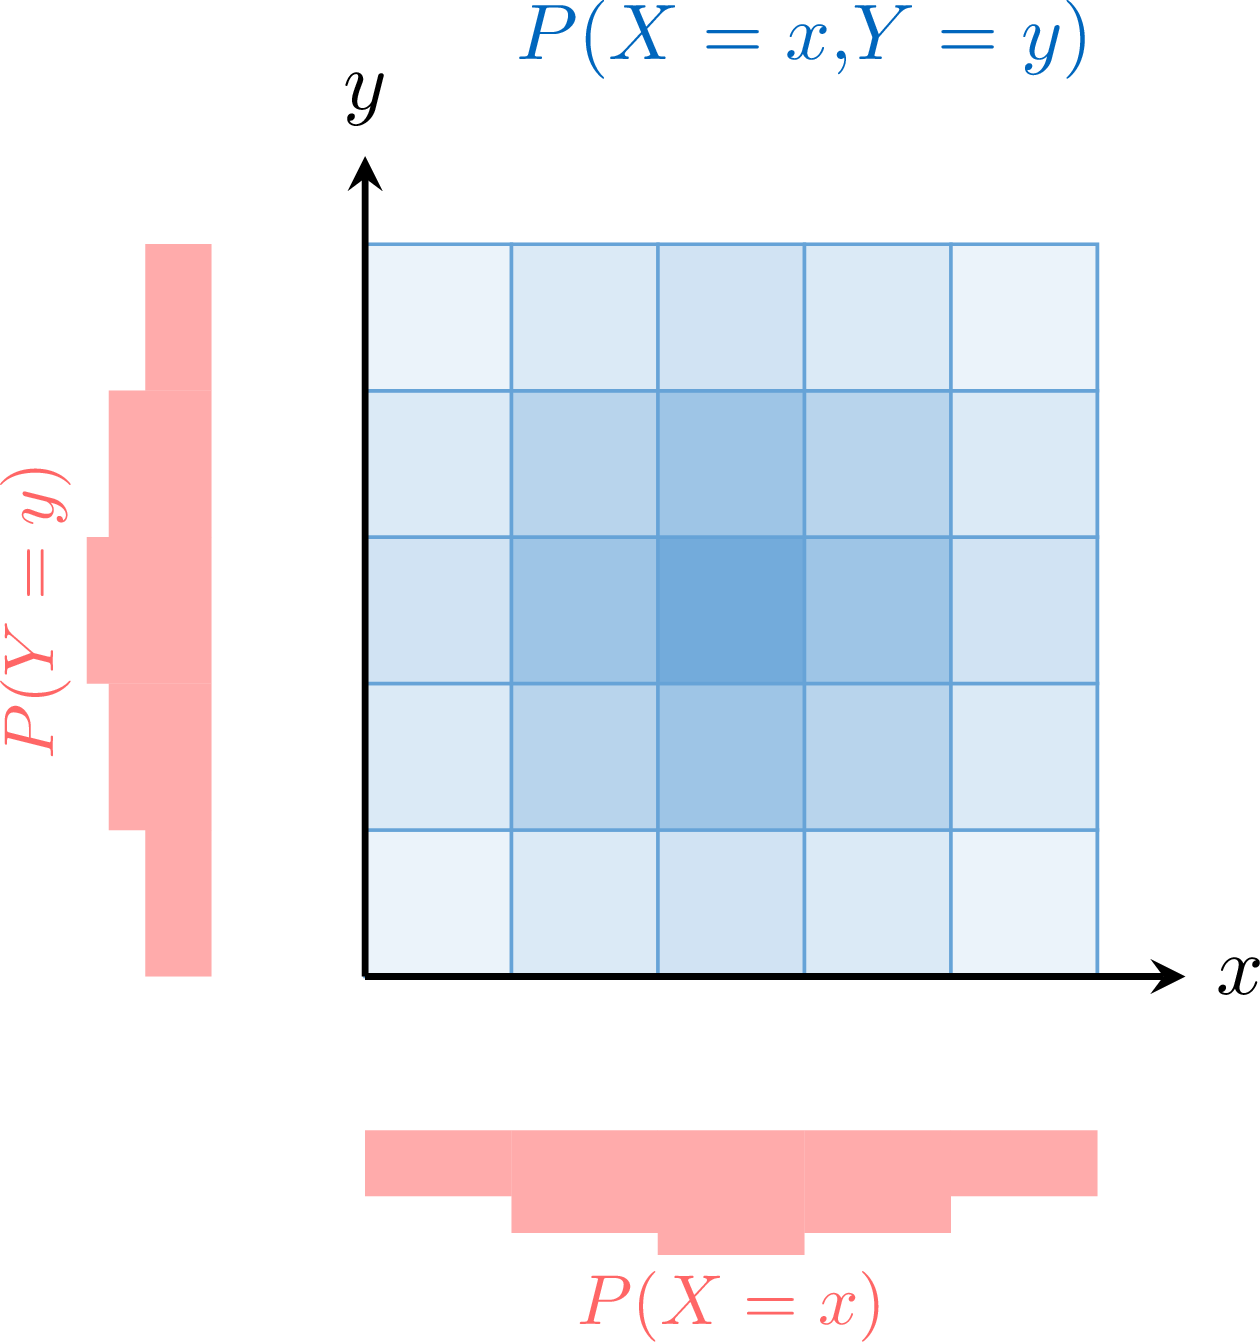
- Vecteurs aléatoires — Vecteurs aléatoires (X_1, ..., X_n) et addition de variables indépendantes. La loi d'un vecteur est déterminée par sa fonction de répartition multivariée ; les lois marginales s'en lisent (pour un vecteur discret en sommant sur les autres coordonnées), mais les marginales ne déterminent pas la loi conjointe. Indépendance mutuelle : la loi conjointe se factorise en produit des marginales (caractérisations admises par fonction de répartition, intervalles, valeurs discrètes) ; le lemme des coalitions (des fonctions de blocs disjoints sont indépendantes) ; mutuelle implique deux à deux, pas l'inverse ; pour n > 2 seul le cas mutuellement indépendant est traité. Pour un couple admettant un moment d'ordre 2, la covariance Cov(X,Y) = E(XY) - E(X)E(Y) est symétrique, bilinéaire, avec Cov(X,X) = V(X) et l'inégalité Cov(X,Y)^2 <= V(X)V(Y) (démontrée par le discriminant de t -> E((U+tV)^2) >= 0 sur les variables centrées) ; V(X+Y) = V(X) + V(Y) + 2Cov(X,Y) ; indépendance implique Cov = 0 (la réciproque est fausse, X uniforme sur {-1,0,1}, Y = X^2) ; le coefficient de corrélation linéaire rho = Cov/(sigma_X sigma_Y) avec |rho| <= 1, égalité ssi lien affine presque sûr de signe correspondant. La covariance est travaillée de façon discrète (la covariance d'un couple à densité dépasse ce cours). Sommes de variables indépendantes : les espérances s'ajoutent (toujours), les espérances des produits se factorisent, les variances s'ajoutent si indépendantes ; stabilité des lois usuelles – binomiale (même p), Poisson, gamma à un paramètre gamma(nu), et normale – par somme indépendante ; une somme de n exponentielles i.i.d. se ramène à gamma(n) par dilatation. Pour les densités, la densité de la somme est le produit de convolution h = f*g (légitimité admise, une densité bornée) ; le maximum et le minimum de variables indépendantes par F_max = prod F_i et 1 - F_min = prod (1 - F_i) (le min de n E(lambda) i.i.d. est E(n lambda)). TP Python thèmes I et III (covariance/corrélation empiriques, échantillons indépendants). Pas de densités conjointes 2D ni d'intégrales doubles ; pas de théorème central limite (chapitre ultérieur).
- Projection orthogonale — Projection orthogonale sur un sous-espace d'un espace euclidien. Construite sur la décomposition E = F (+) F-perp rappelée du chapitre sur le produit scalaire, la projection orthogonale p_F est la projection sur F parallèlement à F-perp ; la caractérisation v = p_F(x) ssi (v dans F et x - v dans F-perp) ; la formule de projection sur une droite p_F(x) = <x,a>/||a||^2 a ; le système linéaire <x - p_F(x), u_j> = 0 pour calculer p_F(x) à partir d'une base quelconque (la matrice de Gram d'une base est inversible). p_F est un projecteur linéaire avec Im p_F = F, Ker p_F = F-perp, p_{F-perp} = id - p_F ; projection sur un hyperplan H = {n}-perp par sa normale, p_H(x) = x - <x,n>/||n||^2 n. Expression en base orthonormée : p_F(x) = somme <x,e_i> e_i (démontrée en appariant x - somme <x,e_i> e_i avec chaque e_j) ; la variante en base orthogonale somme <x,e_i>/||e_i||^2 e_i ; un projecteur orthogonal est un endomorphisme symétrique (renvoi au chapitre du théorème spectral, seulement énoncé). Distance à un sous-espace et meilleure approximation : d(x,F) = min sur y dans F de ||x - y||, atteint en l'unique point p_F(x), avec d(x,F)^2 = ||x||^2 - ||p_F(x)||^2 (Pythagore) ; minimisation de ||x - u||^2 sur u dans F par projection orthogonale, avec l'exemple des moindres carrés intégraux inf de integrale (t^2 - at - b)^2. Moindres carrés et pseudo-solutions (enrichissement non exigible) : le produit scalaire canonique <Y,Z> = tYZ sur les matrices colonnes ; pour A de rang plein en colonnes p, l'unique pseudo-solution X_0 minimisant ||AX - B|| via le théorème de distance et l'injectivité de X -> AX ; les équations normales tA A X_0 = tA B (tA A inversible), X_0 = (tA A)^{-1} tA B ; l'interprétation par projection (Im A)-perp = Ker tA ; TP Python thème I – la droite de régression aux moindres carrés via numpy.linalg.solve(A.T @ A, A.T @ B). Pas de projection sur un sous-espace de dimension infinie ; la dérivation par projection des équations normales et la forme close sont non exigibles.
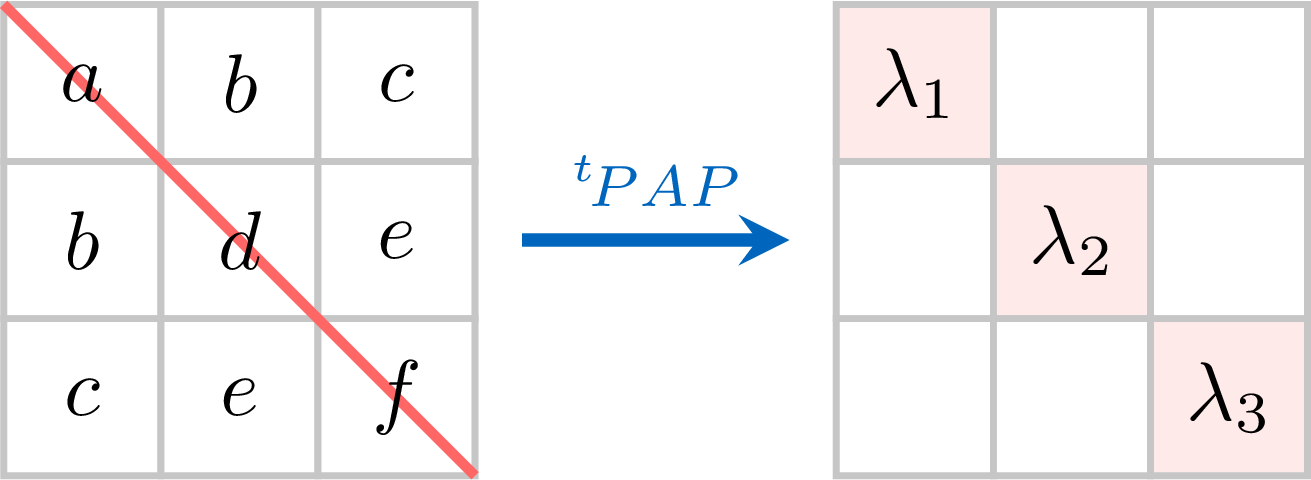
- Endomorphismes symétriques (théorème spectral) — Endomorphismes symétriques d'un espace euclidien et théorème spectral. Un endomorphisme symétrique f vérifie <f(x),y> = <x,f(y)> ; en base orthonormée, c'est exactement une matrice symétrique (tA = A), l'hypothèse b.o.n. étant essentielle (la matrice dans une base non orthonormée n'est pas nécessairement symétrique). Un projecteur est orthogonal si et seulement si c'est un endomorphisme symétrique (fermant le renvoi du chapitre de projection orthogonale). Si un sous-espace F est stable par un f symétrique, alors son orthogonal F-perp l'est aussi ; des vecteurs propres d'un endomorphisme symétrique associés à des valeurs propres distinctes sont orthogonaux (les sous-espaces propres sont deux à deux orthogonaux). Théorème spectral (endomorphismes) : tout endomorphisme symétrique est diagonalisable à valeurs propres réelles et admet une base orthonormée de vecteurs propres – la diagonalisabilité et la réalité du spectre sont admises (sans complexification), l'assemblage de la base orthonormée de vecteurs propres est démontré à partir de l'orthogonalité des sous-espaces propres. Théorème spectral (matrices) : toute matrice symétrique réelle A est orthogonalement diagonalisable, D = P^{-1} A P = tP A P avec P orthogonale (P^{-1} = tP), D diagonale réelle. Méthode de diagonalisation d'une matrice symétrique réelle en base orthonormée (une base orthonormée de chaque sous-espace propre, Gram-Schmidt dans un sous-espace propre multiple, concaténation). Forme quadratique q_A(X) = tX A X associée à une matrice symétrique (représentant symétrique unique ; hors-diagonale = moitié du coefficient croisé) ; réduction q_A = somme lambda_k alpha_k^2 en base orthonormée de vecteurs propres. Signe d'une forme quadratique par le spectre : positive/définie positive ssi toutes les valeurs propres >= 0 / > 0, négative/définie négative symétriquement, de signe non constant (indéfinie) ssi valeurs propres des deux signes. Le test du second ordre par la hessienne pour les extrema est l'application, traitée au chapitre d'optimisation. Pas de matrices symétriques complexes ; pas de théorie des matrices orthogonales au-delà de P^{-1} = tP ; le coeur de diagonalisabilité du théorème spectral est admis.
- Optimisation dans \(\mathbb{R}^n\) — Optimisation de fonctions de plusieurs variables sur Rn, libre et sous contrainte. Le domaine : ouverts (un point a une petite boule incluse ; de façon équivalente une réunion d'ouverts élémentaires {phi < a}), fermés (complémentaire d'un ouvert ; {phi <= a}, {phi >= a}, {phi = a} avec phi continue), bornés (inclus dans une boule fermée) ; le théorème des bornes atteintes – une fonction continue sur un fermé borné non vide atteint un maximum global et un minimum global (admis). Fonctions de classe C2 : dérivées partielles d'ordre deux, théorème de Schwarz (la hessienne nabla^2 f est symétrique, admis) donc orthogonalement diagonalisable avec la forme quadratique q_a(h) = th nabla^2 f(a) h = somme lambda_k h_k^2 ; le développement de Taylor d'ordre deux f(a+h) = f(a) + <grad f(a), h> + 1/2 q_a(h) + ||h||^2 eps(h) (admis). Extrema libres : rappel (du chapitre des fonctions de plusieurs variables) de la condition nécessaire du premier ordre grad f(a) = 0 sur un ouvert et des points critiques ; la condition d'ordre deux (admise) par le spectre de la hessienne – toutes les valeurs propres > 0 minimum local, toutes < 0 maximum local, des deux signes point selle (point col), non concluant seulement lorsque 0 est valeur propre et que les autres sont de même signe ; la méthode (résoudre grad f = 0, valeurs propres de la hessienne en chaque point critique) ; la condition suffisante d'extremum global sur un ouvert convexe lorsque la hessienne garde son signe partout (admise). Optimisation sous contrainte : extrema globaux sur un fermé borné (points critiques intérieurs et bord étudié à la main) ; contraintes d'égalités linéaires C = {g_i(x) = b_i} avec g_i linéaires, C = x_0 + H (H le sous-espace des solutions homogènes) ; la technique de substitution / paramétrage (par défaut) ; le théorème de Lagrange (admis) – en un extremum sous contrainte grad f(a) dans H-perp = Vect(grad g_i), soit grad f(a) = somme lambda_i grad g_i(a) avec les multiplicateurs de Lagrange lambda_i, condition nécessaire non suffisante ; le lagrangien L(x, lambda) = f(x) - somme lambda_i (g_i(x) - b_i). TP Python thème 2 (visualiser les extrema et les lignes de niveau avec matplotlib). Aucune démonstration n'est exigible (tous les résultats admis) ; pas de classification topologique des ensembles ; les contraintes sont des égalités linéaires uniquement – pas de KKT, pas de contraintes d'inégalités, pas de conditions du second ordre sous contrainte.
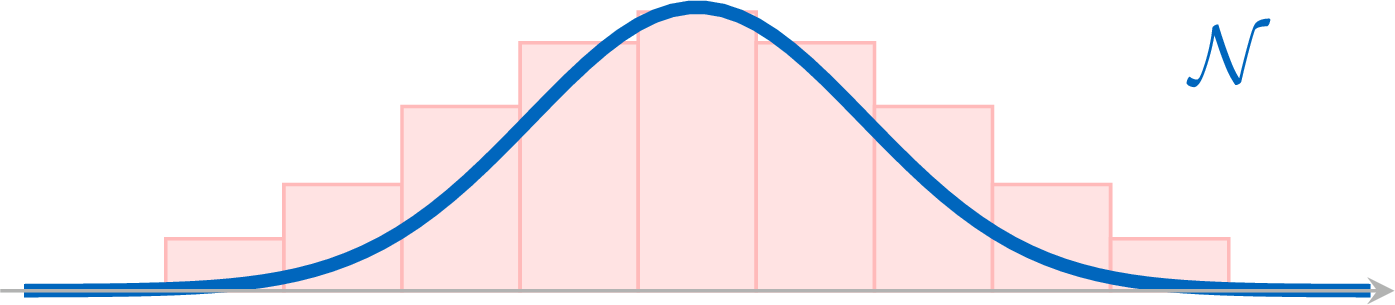
- Convergences de variables aléatoires et approximations — Convergences de variables aléatoires et approximations. Inégalités de concentration rappelées de la première année : Markov P(X>=a) <= E(X)/a pour X>=0, et Bienaymé-Tchebychev P(|X-E(X)|>=eps) <= V(X)/eps^2. Convergence en probabilité X_n -> X : pour tout eps>0, P(|X_n-X|>=eps) -> 0 ; opérations (somme, produit, et composition par une fonction continue – cette dernière admise). La loi faible des grands nombres (rappel, dans le langage de la convergence en probabilité) : pour des variables i.i.d. de même espérance m et de même variance, la moyenne empirique Xbar_n -> m (démontrée par Bienaymé-Tchebychev car E(Xbar_n)=m, V(Xbar_n)=sigma^2/n -> 0) ; théorème de Bernoulli (fréquence empirique -> probabilité). Convergence en loi X_n -> X : F_{X_n}(x) -> F_X(x) en tout point de continuité de F_X (tout x si X a une densité) ; la convergence en probabilité implique la convergence en loi (admis) ; P(a<X_n<=b) -> P(a<X<=b) aux points de continuité. Le cas des variables à valeurs entières : pour des variables à valeurs dans N, la convergence en loi équivaut à P(X_n=k) -> P(X=k) pour tout k. Le théorème central limite (admis) : pour des variables i.i.d. d'espérance m et de variance sigma^2 != 0, Xbar_n* = sqrt(n)(Xbar_n-m)/sigma -> N(0,1) en loi, de façon équivalente S_n* = (S_n-nm)/(sigma sqrt(n)) -> N(0,1) ; interprétation Xbar_n approx N(m, sigma^2/n), S_n approx N(nm, n sigma^2). Approximations par la loi normale : la binomiale (S_n-np)/sqrt(np(1-p)) -> N(0,1) et la Poisson (Y_lambda-lambda)/sqrt(lambda) -> N(0,1), avec une correction de continuité lorsqu'une loi à valeurs entières est approchée par une loi continue (tous les seuils pratiques fournis dans les énoncés). TP Python thème 4 (visualiser le théorème central limite). Le chapitre est le pont vers l'estimation. Pas de convergence presque sûre ni L^p ; l'approximation binomiale vers Poisson relève de la première année (seulement citée) ; pas de seuils d'approximation mémorisés ; les seules démonstrations admises sont la composition par une fonction continue et le théorème central limite.
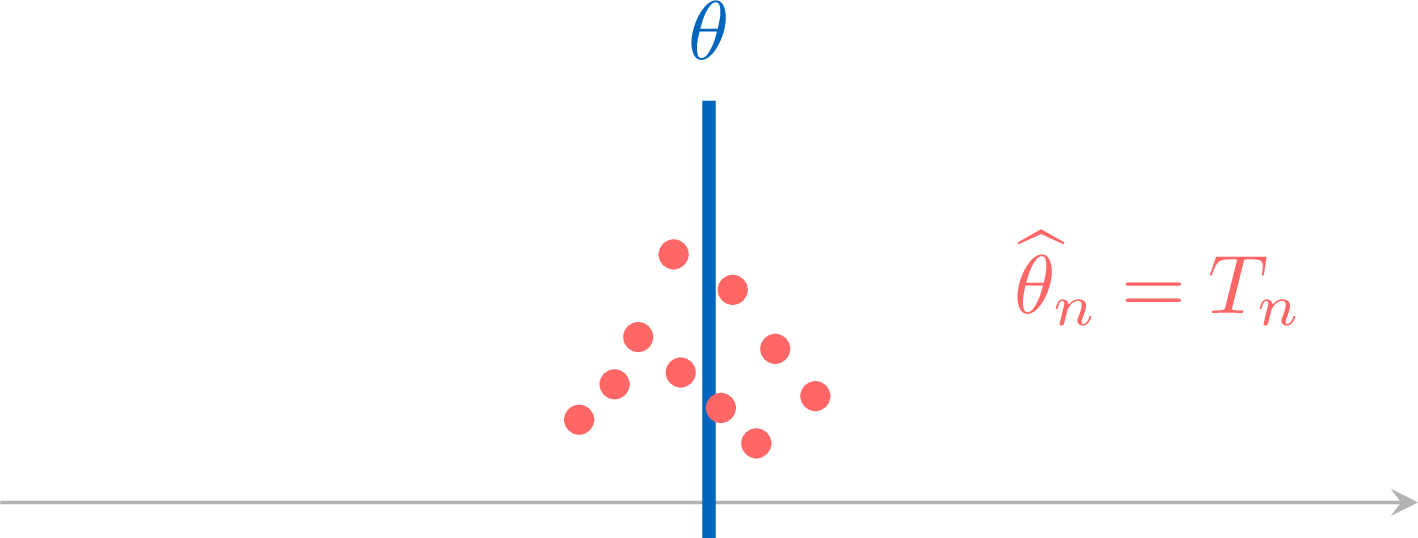
- Estimation ponctuelle et qualité des estimateurs — Estimation ponctuelle et qualité des estimateurs. Cadre inférentiel : une famille de lois (mu_theta) indexée par un paramètre inconnu theta dans Theta (partie de R ou R^2) dont la valeur caractérise la loi ; un n-échantillon (X_1, ..., X_n) de variables i.i.d. de loi mère mu_theta ; espérance et variance E_theta, V_theta sous P_theta ; l'objectif est d'estimer theta ou une fonction g(theta). Un estimateur est une statistique T_n = phi(X_1, ..., X_n) avec phi n'utilisant pas theta ; une estimation est une réalisation t_n ; la moyenne empirique Xbar_n est l'exemple central (proportion de Bernoulli, exponentielle 1/theta, uniforme 2 Xbar_n). Estimateur sans biais : E_theta(T_n) = g(theta) pour tout theta ; Xbar_n est sans biais pour l'espérance m de la loi mère ; la variance empirique S'^2_n = (1/(n-1)) somme (X_k - Xbar_n)^2 est un estimateur sans biais de la variance sigma^2 (convention inférentielle 1/(n-1) ; la version 1/n est biaisée d'espérance (n-1)/n sigma^2). Asymptotiquement sans biais : E_theta(T_n) -> g(theta). Comparaison d'estimateurs sans biais par la variance : celui de plus petite variance est le meilleur (pas de risque quadratique – hors programme). Suites d'estimateurs ; estimateur convergent : T_n -> g(theta) en probabilité pour tout theta ; Xbar_n est convergent (loi faible des grands nombres) ; composition par une fonction continue (rappel) ; condition suffisante de convergence : si E_theta(T_n) -> g(theta) et V_theta(T_n) -> 0 alors (T_n) est convergent (démontrée par Markov / Bienaymé-Tchebychev). TP Python thème 4 (comparer des estimateurs par simulation). Le chapitre est la première moitié de l'estimation rigoureuse, alimentant le chapitre des intervalles de confiance. Pas de risque quadratique / erreur quadratique moyenne / décomposition biais-variance ; pas de maximum de vraisemblance ni de méthode des moments comme cadre systématique ; les estimateurs sont des exemples simples donnés ; comparaison par la variance seulement.
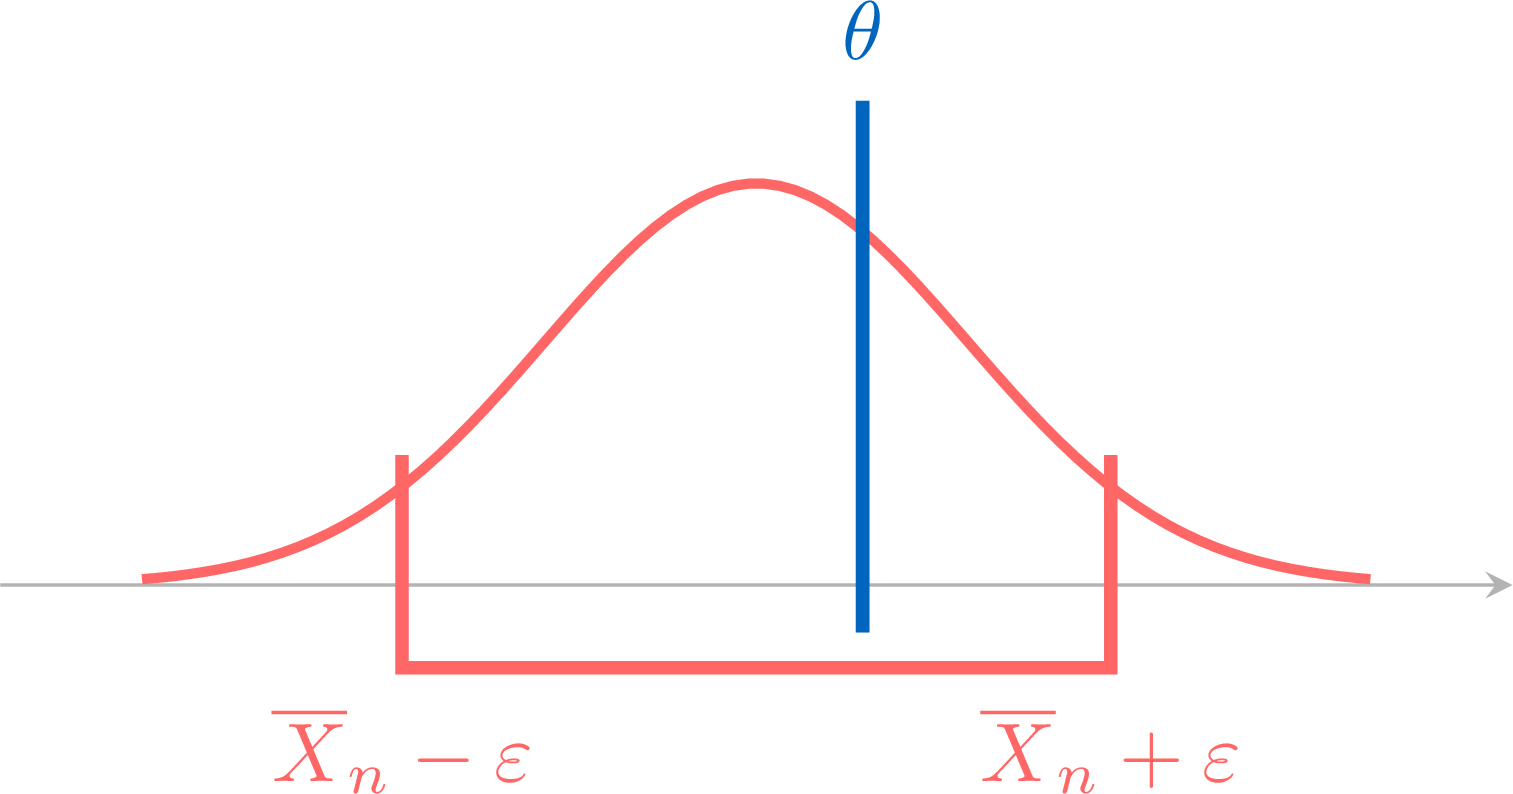
- Intervalles de confiance — Intervalles de confiance : estimation par intervalle d'un paramètre inconnu. Cadre : (X_n) i.i.d. de loi mère mu_theta, theta dans Theta inconnu ; deux suites d'estimateurs (U_n) et (V_n) de g(theta) avec P_theta(U_n <= V_n) = 1. Intervalle de confiance au niveau de confiance 1 - alpha : [U_n, V_n] avec P_theta(U_n <= g(theta) <= V_n) >= 1 - alpha pour tout theta ; alpha est le risque ; une réalisation est un intervalle de confiance observé ; le niveau porte sur l'intervalle aléatoire, non sur l'inconnue fixe. Trois constructions. (1) Intervalle de confiance par Bienayme-Tchebychev : pour un estimateur sans biais de variance majorée indépendamment de g(theta), un intervalle garanti (non asymptotique) valable pour tout n ; traité pour un paramètre de Bernoulli, [Xbar_n - 1/(2 sqrt(n alpha)), Xbar_n + 1/(2 sqrt(n alpha))], avec p(1-p) <= 1/4 ; grossier (large). (2) Intervalle de confiance exact pour la moyenne d'une loi normale d'écart-type connu : la moyenne empirique est exactement normale, donnant [Xbar_n - t_alpha sigma/sqrt(n), Xbar_n + t_alpha sigma/sqrt(n)] au niveau exact 1 - alpha, t_alpha = Phi^{-1}(1 - alpha/2) ; occasion de rappeler la variance empirique S'^2_n estimant sigma^2 (l'intervalle de Student à sigma inconnu est hors de ce cours). (3) Intervalle de confiance asymptotique au niveau 1 - alpha : une suite ([U_n, V_n]) telle qu'il existe (alpha_n) -> alpha avec P_theta(U_n <= g(theta) <= V_n) >= 1 - alpha_n pour tout n ; construit via le théorème central limite ; traité pour un paramètre de Bernoulli, [Xbar_n - t_alpha/(2 sqrt(n)), Xbar_n + t_alpha/(2 sqrt(n))] ; comparaison Bienayme-Tchebychev vs théorème central limite (l'intervalle du TLC est bien plus précis : n >= 9604 contre n >= 50000 pour la même précision). TP Python thème 4 (estimation par Monte-Carlo du niveau de couverture réel). Referme le parcours de l'estimation commencé au chapitre précédent ; démonstrations à refaire à chaque utilisation. Pas de tests d'hypothèses (pas de risques alpha/beta, pas de p-value), pas de méthode du pivot comme technique systématique, pas d'intervalle de Student pour sigma inconnu.