Éducation Nationale Française · ECGapprofondies 2
Compléments d'algèbre linéaire
Ce cours prolonge trois piliers d'algèbre linéaire établis dans le cours précédent. D'abord, la notion de somme directe, rencontrée pour deux sous-espaces, est généralisée à une famille finie quelconque de sous-espaces, accompagnée du langage des bases adaptées. Ensuite, le calcul du changement de base pour les vecteurs est étendu aux endomorphismes : la matrice d'un même endomorphisme dans deux bases différentes est régie par la formule \(\mathrm{Mat}_{B'}(f) = P_{B, B'}^{-1}\, \mathrm{Mat}_B(f)\, P_{B, B'}\), qui mène à la relation des matrices semblables. Enfin, la trace d'une matrice carrée est introduite comme l'invariant le plus simple associé à une matrice ; jointe au rang, elle constitue la boîte à outils pratique pour distinguer les classes de matrices semblables. Ces trois piliers forment le bagage algébrique utilisé dans le cours suivant pour étudier les valeurs propres et la réduction des endomorphismes. Convention : dans tout ce cours, \(E\) désigne un espace vectoriel réel de dimension finie, sauf mention contraire ; toutes les matrices sont à coefficients réels, et \(K = \mathbb{R}\) est implicite.
I
Sommes directes de sous-espaces vectoriels
On a déjà étudié, pour deux sous-espaces \(F\) et \(G\) de \(E\), la somme \(F + G\) et la somme directe \(F \oplus G\), accompagnées du critère \(F \cap G = \{0_E\}\) et de la formule de dimension \(\dim(F + G) = \dim F + \dim G - \dim(F \cap G)\). On étend à présent ces notions à une famille de \(k\) sous-espaces \(F_1, \dots, F_k\), avec \(k \ge 2\). La généralisation est en grande partie formelle, mais elle apporte deux idées nouvelles : la base adaptée, qui enregistre la décomposition \(E = F_1 \oplus \dots \oplus F_k\) au niveau des vecteurs, et une mise en garde subtile pour \(k \ge 3\), selon laquelle le critère deux à deux \(F_i \cap F_j = \{0_E\}\) ne suffit pas à garantir que la somme est directe.
I.1
Somme et somme directe de \(k\) sous-espaces
La somme de \(k\) sous-espaces rassemble tous les vecteurs qui peuvent s'écrire \(x_1 + \dots + x_k\) avec \(x_i \in F_i\). La somme est dite directe lorsque cette décomposition est unique. Le contenu nouveau de cette sous-section est le critère portant sur le vecteur nul, qui remplace le test à deux sous-espaces \(F \cap G = \{0_E\}\).
Définition — Somme de \(k\) sous-espaces
Soient \(F_1, \dots, F_k\) des sous-espaces de \(E\). La somme de \(F_1, \dots, F_k\), notée \(F_1 + \dots + F_k\) ou \(\sum_{i = 1}^k F_i\), est l'ensemble $$ F_1 + \dots + F_k = \bigl\{ x_1 + \dots + x_k \,:\, x_i \in F_i \text{ pour tout } i \in \{1, \dots, k\} \bigr\}. $$ Exemple
Dans \(\mathbb{R}^3\) muni de la base canonique \((e_1, e_2, e_3)\), on pose \(F_i = \mathrm{Vect}(e_i)\) pour \(i \in \{1, 2, 3\}\). Alors \(F_1 + F_2 + F_3 = \mathbb{R}^3\) : tout vecteur \((x_1, x_2, x_3)\) s'écrit \(x_1 e_1 + x_2 e_2 + x_3 e_3\) avec \(x_i e_i \in F_i\). Exemple
Dans \(\mathbb{R}_3[X]\), on pose \(F_0 = \mathrm{Vect}(1)\), \(F_1 = \mathrm{Vect}(X)\), \(F_2 = \mathrm{Vect}(X^2)\), \(F_3 = \mathrm{Vect}(X^3)\). Alors \(F_0 + F_1 + F_2 + F_3 = \mathbb{R}_3[X]\) : tout polynôme de degré inférieur ou égal à \(3\) s'écrit \(a_0 \cdot 1 + a_1 X + a_2 X^2 + a_3 X^3\) avec chaque \(a_i \cdot X^i \in F_i\). Proposition — La somme est un sous-espace
Soient \(F_1, \dots, F_k\) des sous-espaces de \(E\). Alors \(F_1 + \dots + F_k\) est un sous-espace de \(E\).
Le vecteur nul \(0_E = 0_E + \dots + 0_E\) appartient à la somme car chaque \(0_E \in F_i\). Soient \(x = \sum_{i = 1}^k x_i\) et \(y = \sum_{i = 1}^k y_i\) avec \(x_i, y_i \in F_i\), et soient \(\lambda, \mu \in \mathbb{R}\). Alors $$ \begin{aligned} \lambda x + \mu y &= \lambda \sum_{i = 1}^k x_i + \mu \sum_{i = 1}^k y_i && \text{(définition de \(x\) et \(y\))} \\
&= \sum_{i = 1}^k (\lambda x_i + \mu y_i) && \text{(linéarité de la somme)}, \end{aligned} $$ et chaque \(\lambda x_i + \mu y_i\) appartient à \(F_i\) puisque \(F_i\) est un sous-espace. Donc \(\lambda x + \mu y \in F_1 + \dots + F_k\), qui est ainsi un sous-espace de \(E\).
Définition — Somme directe de \(k\) sous-espaces
La somme \(F_1 + \dots + F_k\) est dite directe lorsque, pour tout \(x \in F_1 + \dots + F_k\), il existe un unique \(k\)-uplet \((x_1, \dots, x_k) \in F_1 \times \dots \times F_k\) tel que \(x = x_1 + \dots + x_k\). Dans ce cas, la somme se note $$ F_1 \oplus \dots \oplus F_k \quad \text{ou} \quad \bigoplus_{i = 1}^k F_i. $$ Exemple
Dans \(\mathbb{R}^3\), la somme \(\mathrm{Vect}(e_1) + \mathrm{Vect}(e_2) + \mathrm{Vect}(e_3)\) est directe : tout \((x_1, x_2, x_3)\) s'écrit de manière unique \(x_1 e_1 + x_2 e_2 + x_3 e_3\). Donc \(\mathbb{R}^3 = \mathrm{Vect}(e_1) \oplus \mathrm{Vect}(e_2) \oplus \mathrm{Vect}(e_3)\). Exemple — Matrices symétriques et antisymétriques
Rappelons les sous-espaces symétriques et antisymétriques de \(\mathcal{M}_n(\mathbb{R})\) : $$ \mathcal{S}_n(\mathbb{R}) = \{ A \in \mathcal{M}_n(\mathbb{R}) \,:\, {}^t A = A \}, \qquad \mathcal{A}_n(\mathbb{R}) = \{ A \in \mathcal{M}_n(\mathbb{R}) \,:\, {}^t A = -A \}. $$ Toute matrice \(A \in \mathcal{M}_n(\mathbb{R})\) se décompose en $$ A = \underbrace{\frac{1}{2}\bigl(A + {}^t A\bigr)}_{\in\, \mathcal{S}_n(\mathbb{R})} \;+\; \underbrace{\frac{1}{2}\bigl(A - {}^t A\bigr)}_{\in\, \mathcal{A}_n(\mathbb{R})}, $$ et les deux composantes sont uniques : si \(A = S + T\) avec \(S\) symétrique et \(T\) antisymétrique, alors la transposition donne \({}^t A = S - T\), d'où \(S = \frac{1}{2}(A + {}^t A)\) et \(T = \frac{1}{2}(A - {}^t A)\). Par conséquent \(\mathcal{M}_n(\mathbb{R}) = \mathcal{S}_n(\mathbb{R}) \oplus \mathcal{A}_n(\mathbb{R})\). Proposition — Caractérisation d'une somme directe
La somme \(F_1 + \dots + F_k\) est directe si et seulement si la seule décomposition du vecteur nul est la décomposition triviale : $$ \bigl( \forall (x_1, \dots, x_k) \in F_1 \times \dots \times F_k, \quad x_1 + \dots + x_k = 0_E \;\Rightarrow\; \forall i, \ x_i = 0_E \bigr). $$
On démontre les deux implications.
- Directe \(\Rightarrow\) décomposition nulle triviale. Supposons la somme directe. Prenons \((x_1, \dots, x_k)\) avec \(x_1 + \dots + x_k = 0_E\). Comme \(0_E\) s'écrit aussi \(0_E + \dots + 0_E\) avec \(0_E \in F_i\), l'unicité de la décomposition de \(0_E\) impose \(x_i = 0_E\) pour tout \(i\).
- Décomposition nulle triviale \(\Rightarrow\) directe. Supposons que la décomposition nulle soit triviale. Soit \(x \in F_1 + \dots + F_k\) admettant deux décompositions \(x = x_1 + \dots + x_k = y_1 + \dots + y_k\) avec \(x_i, y_i \in F_i\). Alors $$ \begin{aligned} (x_1 - y_1) + \dots + (x_k - y_k) &= x - x = 0_E && \text{(soustraction des deux décompositions)}, \end{aligned} $$ et chaque \(x_i - y_i \in F_i\). L'hypothèse de décomposition nulle triviale donne \(x_i - y_i = 0_E\), c'est-à-dire \(x_i = y_i\), pour tout \(i\). La décomposition de \(x\) est donc unique, et la somme est directe.
Piège du critère deux à deux pour \(k \ge 3\)
Pour deux sous-espaces, le critère \(F \cap G = \{0_E\}\) équivaut au caractère direct de \(F + G\). Cette équivalence tombe en défaut pour \(k \ge 3\) : la condition \(F_i \cap F_j = \{0_E\}\) pour tout \(i \ne j\) ne suffit pas à garantir que \(F_1 + \dots + F_k\) est directe. Le bon critère est la condition de décomposition nulle ci-dessus ; il doit être vérifié sur tous les indices simultanément, et non deux à deux.
Exemple — Contre-exemple au critère deux à deux
Dans \(\mathbb{R}^2\) muni de la base canonique \((e_1, e_2)\), on pose $$ F = \mathrm{Vect}(e_1), \qquad G = \mathrm{Vect}(e_2), \qquad H = \mathrm{Vect}(e_1 + e_2). $$ Chaque paire de sous-espaces ne s'intersecte qu'en zéro : \(F \cap G = \{0\}\), \(F \cap H = \{0\}\), \(G \cap H = \{0\}\) (tout vecteur non nul de \(F\) a sa seconde coordonnée nulle, tandis que tout vecteur non nul de \(H\) a ses deux coordonnées égales, le seul vecteur commun est donc \(0\) ; symétriquement pour les autres paires). Pourtant, la somme \(F + G + H\) n'est pas directe : le vecteur \(e_1 + e_2\) admet deux décompositions distinctes, $$ \begin{aligned} e_1 + e_2 &= e_1 + e_2 + 0 && \text{(décomposition dans \(F + G + H\) via \(F\) et \(G\))}, \\
e_1 + e_2 &= 0 + 0 + (e_1 + e_2) && \text{(décomposition via \(H\))}. \end{aligned} $$ L'hypothèse \(F_i \cap F_j = \{0\}\) n'est donc pas assez forte pour \(k \ge 3\). Méthode — Démontrer qu'une somme est directe
Pour démontrer que la somme \(F_1 + \dots + F_k\) est directe : - Prendre un \(k\)-uplet quelconque \((x_1, \dots, x_k) \in F_1 \times \dots \times F_k\) tel que \(x_1 + \dots + x_k = 0_E\).
- Montrer que cela impose \(x_i = 0_E\) pour tout \(i \in \{1, \dots, k\}\) (en utilisant la description explicite de chaque \(F_i\)).
- Conclure par la caractérisation ci-dessus.
Compétences à pratiquer
- Démontrer qu'une somme est directe
- Identifier une somme directe à partir d'une base
I.2
Base adaptée et concaténation de bases
Lorsque \(E = F_1 \oplus \dots \oplus F_k\), la structure de somme directe peut être remontée des vecteurs aux bases : en choisissant une base \(\mathcal{B}_i\) dans chaque \(F_i\) et en les concaténant, on obtient une base de \(E\) qui respecte la décomposition. Une telle base est dite adaptée, et l'opération nous donne du même coup une méthode explicite pour calculer la dimension d'une somme directe.
Définition — Base adaptée à une somme directe
On suppose \(E = F_1 \oplus \dots \oplus F_k\). Soit \(\mathcal{B}_i\) une base de \(F_i\) pour chaque \(i\). La famille de \(E\) obtenue en concaténant \(\mathcal{B}_1, \dots, \mathcal{B}_k\) dans l'ordre, $$ \mathcal{B} = \mathcal{B}_1 \sqcup \mathcal{B}_2 \sqcup \dots \sqcup \mathcal{B}_k, $$ est appelée famille adaptée à la décomposition en somme directe \(E = F_1 \oplus \dots \oplus F_k\). (Le théorème ci-dessous montre que cette concaténation est en fait une base de \(E\), d'où la dénomination usuelle base adaptée.) Exemple
La base canonique \((e_1, \dots, e_n)\) de \(\mathbb{R}^n\) est adaptée à la décomposition en somme directe $$ \mathbb{R}^n = \mathrm{Vect}(e_1) \oplus \mathrm{Vect}(e_2) \oplus \dots \oplus \mathrm{Vect}(e_n). $$ Chaque \(\mathcal{B}_i = (e_i)\) est une base de la droite \(\mathrm{Vect}(e_i)\), et leur concaténation est exactement la base canonique. Exemple
Dans \(\mathbb{R}^3\), on pose \(F = \mathrm{Vect}(e_1, e_2)\) (le plan horizontal) et \(G = \mathrm{Vect}(e_3)\) (la droite verticale). La somme directe se décompose en \(\mathbb{R}^3 = F \oplus G\) (tout vecteur \((x, y, z)\) s'écrit de manière unique \((x, y, 0) + (0, 0, z)\)). Une base de \(F\) est \((e_1, e_2)\), une base de \(G\) est \((e_3)\), et la concaténation est la base canonique \((e_1, e_2, e_3)\) : une base adaptée. En remplaçant \(G\) par \(G' = \mathrm{Vect}(e_1 + e_2 + e_3)\), on obtient encore une décomposition en somme directe \(\mathbb{R}^3 = F \oplus G'\), et la base adaptée correspondante est \((e_1, e_2, e_1 + e_2 + e_3)\). Proposition — La concaténation engendre la somme
Soient \(F_1, \dots, F_k\) des sous-espaces de \(E\), et soit \(\mathcal{B}_i\) une base de \(F_i\) pour chaque \(i\). Alors la concaténation \(\mathcal{B}_1 \sqcup \dots \sqcup \mathcal{B}_k\) est une famille génératrice de \(F_1 + \dots + F_k\). Ce résultat est valable indépendamment du fait que la somme soit directe ou non.
Soit \(x \in F_1 + \dots + F_k\). Par définition, il existe \(x_i \in F_i\) tels que \(x = x_1 + \dots + x_k\). Comme \(\mathcal{B}_i\) engendre \(F_i\), chaque \(x_i\) est une combinaison linéaire des vecteurs de \(\mathcal{B}_i\). En sommant ces combinaisons linéaires sur \(i\), \(x\) est lui-même une combinaison linéaire des vecteurs de la concaténation \(\mathcal{B}_1 \sqcup \dots \sqcup \mathcal{B}_k\), qui engendre donc \(F_1 + \dots + F_k\).
Théorème — Caractérisation d'une somme directe par concaténation de bases
Soient \(F_1, \dots, F_k\) des sous-espaces de \(E\), et soit \(\mathcal{B}_i\) une base de \(F_i\) pour chaque \(i\). Les énoncés suivants sont équivalents : - la somme \(F_1 + \dots + F_k\) est directe ;
- la concaténation \(\mathcal{B}_1 \sqcup \dots \sqcup \mathcal{B}_k\) est une famille libre de \(E\) ;
- la concaténation \(\mathcal{B}_1 \sqcup \dots \sqcup \mathcal{B}_k\) est une base de \(F_1 + \dots + F_k\).
Écrivons \(\mathcal{B}_i = (b_{i, 1}, \dots, b_{i, p_i})\), où \(p_i = \dim F_i\).
- (1) \(\Rightarrow\) (2). Supposons la somme directe. Une combinaison linéaire \(\sum_{i = 1}^k \sum_{j = 1}^{p_i} \lambda_{i, j}\, b_{i, j} = 0_E\) se réécrit \(\sum_{i = 1}^k x_i = 0_E\) avec \(x_i = \sum_{j = 1}^{p_i} \lambda_{i, j}\, b_{i, j} \in F_i\). La caractérisation précédente des sommes directes impose \(x_i = 0_E\) pour tout \(i\). Comme \(\mathcal{B}_i\) est une base, donc libre, tous les \(\lambda_{i, j} = 0\). La concaténation est donc libre.
- (2) \(\Rightarrow\) (3). Supposons la concaténation libre. La Proposition précédente montre qu'elle engendre aussi \(F_1 + \dots + F_k\). Une famille à la fois libre et génératrice est une base.
- (3) \(\Rightarrow\) (1). Supposons la concaténation base de \(F_1 + \dots + F_k\). Prenons une décomposition nulle \(\sum_{i = 1}^k x_i = 0_E\) avec \(x_i \in F_i\). Écrire chaque \(x_i\) dans la base \(\mathcal{B}_i\) fournit une combinaison linéaire de la concaténation égale à \(0_E\), donc tous les coefficients sont nuls. Par conséquent chaque \(x_i = 0_E\), et la somme est directe.
Proposition — Dimension d'une somme directe
Si \(F_1, \dots, F_k\) sont des sous-espaces de \(E\) de dimension finie et la somme est directe, alors $$ \dim\Bigl( \bigoplus_{i = 1}^k F_i \Bigr) = \sum_{i = 1}^k \dim F_i. $$
D'après le théorème ci-dessus, une base de \(\bigoplus_{i = 1}^k F_i\) s'obtient en concaténant une base de chaque \(F_i\). Le cardinal de la concaténation est la somme des cardinaux : \(\sum_{i = 1}^k \dim F_i\).
Méthode — Construire une base adaptée et lire la dimension
Étant donné \(E = F_1 \oplus \dots \oplus F_k\) : - Calculer (ou choisir) une base \(\mathcal{B}_i\) de chaque \(F_i\).
- Les concaténer dans l'ordre : \(\mathcal{B} = \mathcal{B}_1 \sqcup \dots \sqcup \mathcal{B}_k\) est une base adaptée de \(E\).
- Lire \(\dim E = \dim F_1 + \dots + \dim F_k\) sur le cardinal de \(\mathcal{B}\).
La figure ci-dessous illustre la décomposition en base adaptée dans \(\mathbb{R}^3\). 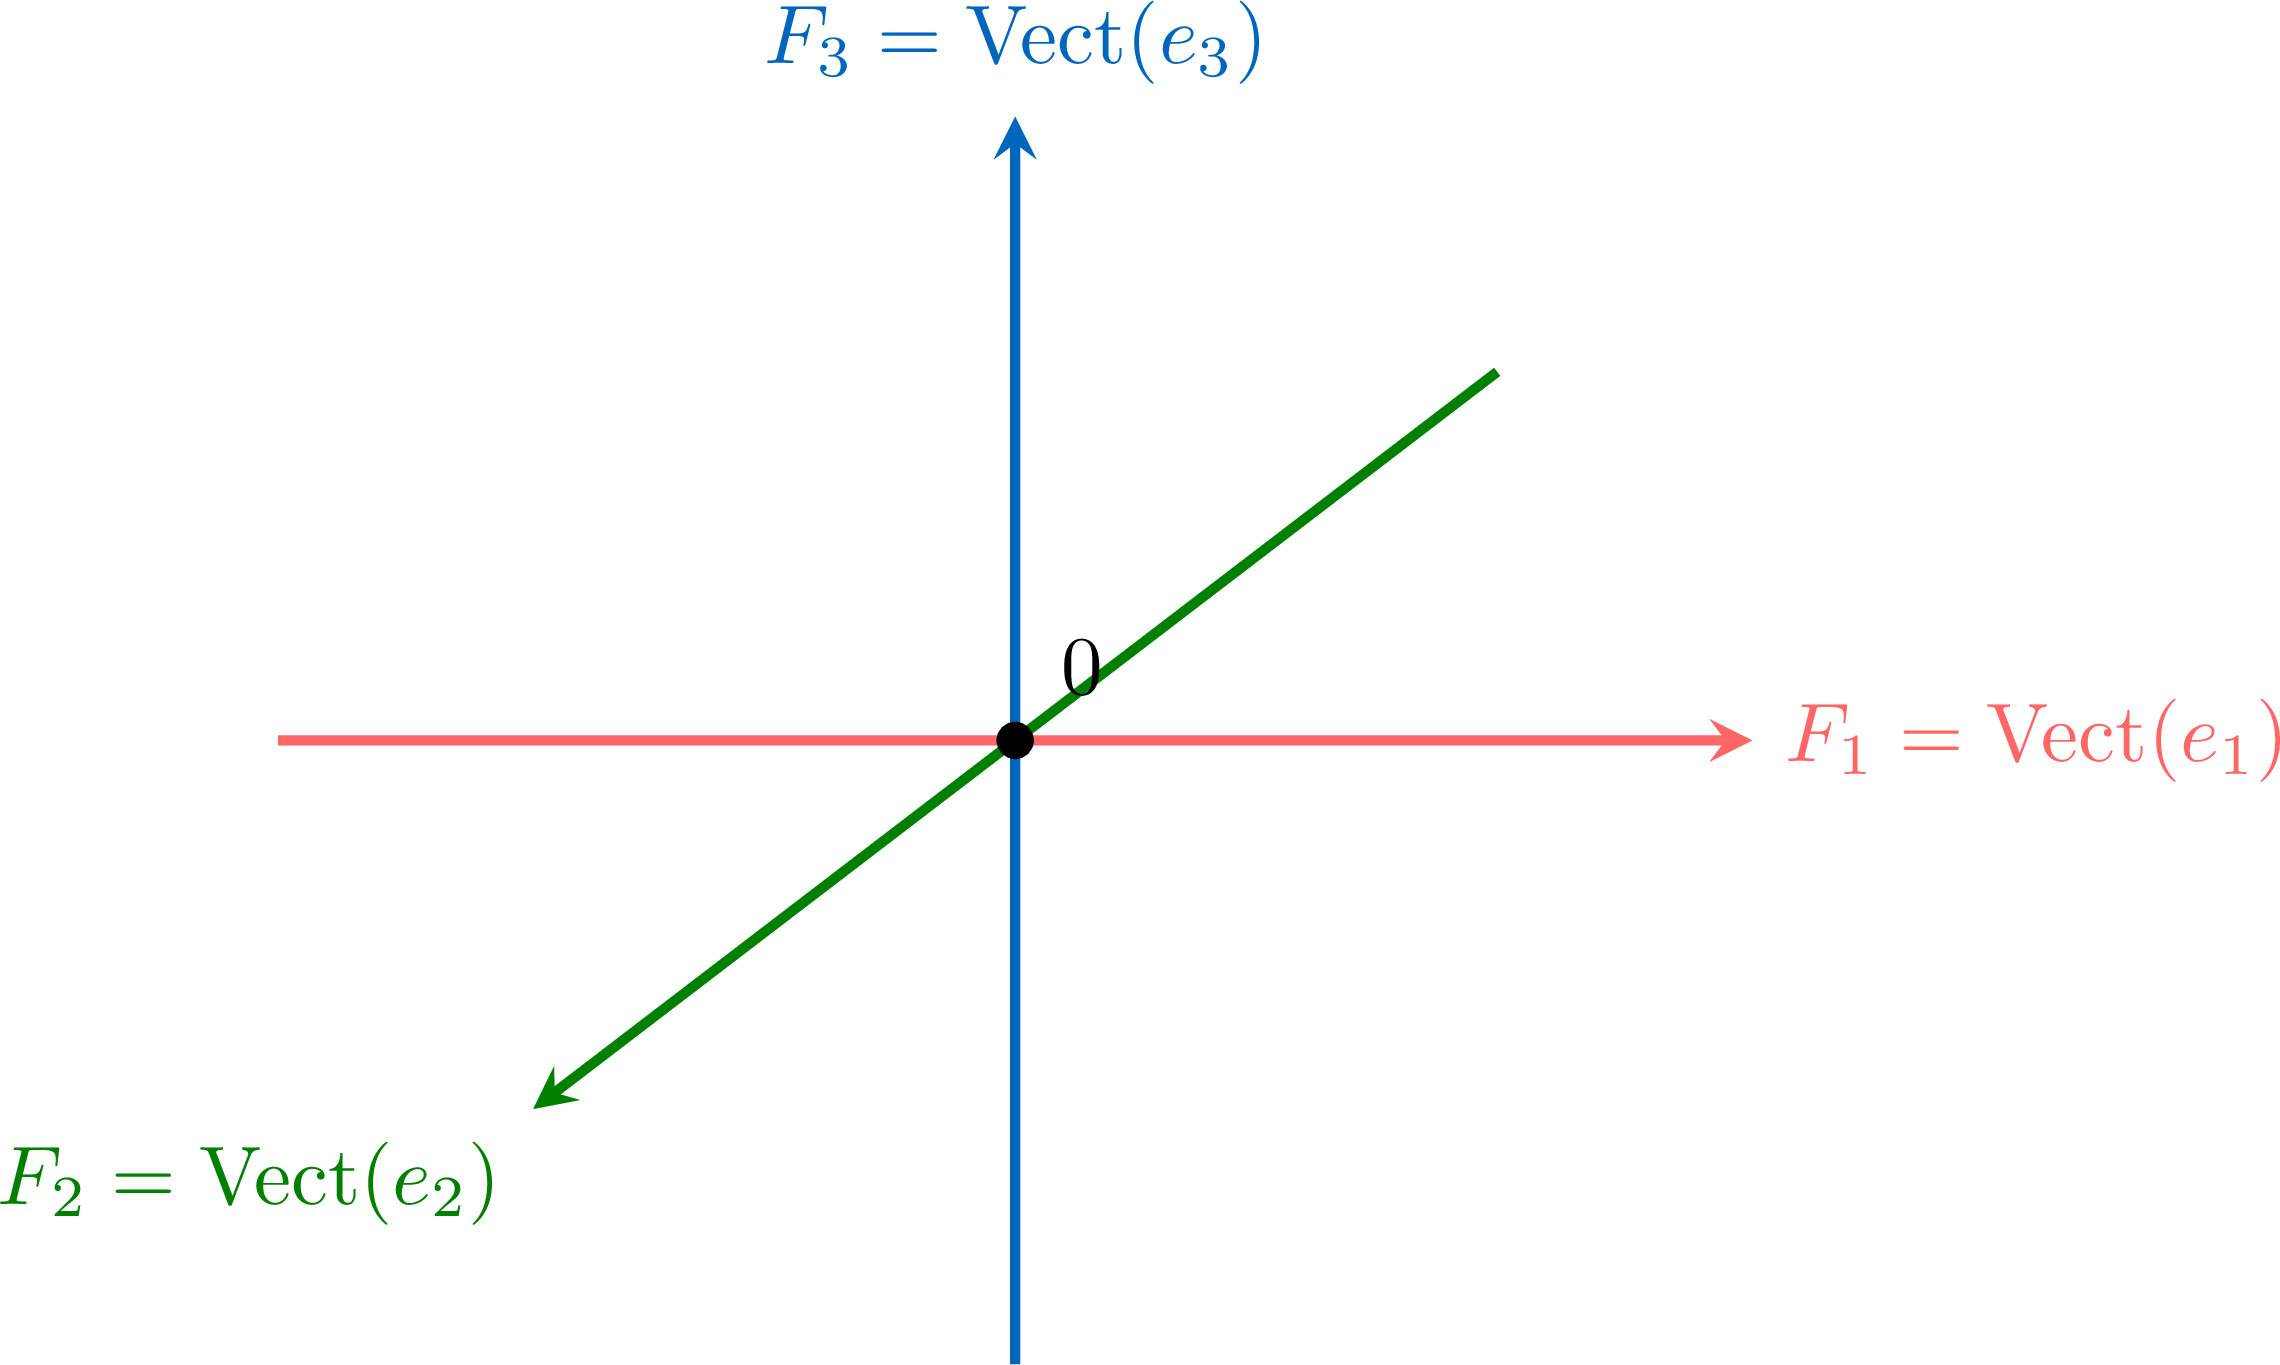
L'image est un schéma plan de la décomposition tridimensionnelle \(\mathbb{R}^3 = F_1 \oplus F_2 \oplus F_3\) : les trois droites passant par l'origine sont à lire comme trois axes géométriquement indépendants (un par dimension), et non comme des droites coplanaires. Chaque vecteur de \(\mathbb{R}^3\) se décompose de manière unique comme somme de trois composantes, une dans chaque droite. La base adaptée est \((e_1, e_2, e_3)\).
Compétences à pratiquer
- Construire une base adaptée
- Calculer la dimension d'une somme directe
II
Changement de base
La matrice d'un endomorphisme dépend du choix de la base. L'objectif de cette section est d'exprimer cette dépendance quantitativement : étant données deux bases \(B\) et \(B'\) de \(E\), quel est le lien entre \(\mathrm{Mat}_B(f)\) et \(\mathrm{Mat}_{B'}(f)\) ? Le lien est fourni par la matrice de passage \(P_{B, B'}\), et la formule centrale est \(\mathrm{Mat}_{B'}(f) = P_{B, B'}^{-1}\, \mathrm{Mat}_B(f)\, P_{B, B'}\). Cette relation entre deux matrices représentant le même endomorphisme dans deux bases différentes est consignée sous le nom de similitude.
II.1
Rappels : matrice d'un endomorphisme, matrice de passage
On rappelle, sans démonstration, les constructions du cours précédent : la matrice d'un endomorphisme dans une base donnée, et la matrice de passage entre deux bases. La notation \(P_{B, B'}\) est figée ici pour l'usage des formules de la sous-section suivante.
Définition — Matrice de passage
Il s'agit de la même définition que dans le cours précédent, redite ici pour fixer la notation \(P_{B, B'}\) en vue des formules de la sous-section suivante. Soient \(B = (e_1, \dots, e_n)\) et \(B' = (e'_1, \dots, e'_n)\) deux bases de \(E\). La matrice de passage de \(B\) vers \(B'\), notée \(P_{B, B'}\), est la matrice de \(\mathcal{M}_n(\mathbb{R})\) dont la \(j\)-ème colonne contient les coordonnées de \(e'_j\) dans la base \(B\) : $$ P_{B, B'} \;=\; \mathrm{Mat}_B(e'_1, \dots, e'_n) \;=\; \bigl(\, \mathrm{coord}_B(e'_1) \mid \dots \mid \mathrm{coord}_B(e'_n)\, \bigr). $$ Exemple
Dans \(\mathbb{R}^2\), on prend \(B = (e_1, e_2)\) la base canonique et \(B' = (e'_1, e'_2)\) obtenue par une rotation d'angle \(\pi/4\) : $$ e'_1 = \tfrac{\sqrt{2}}{2}\, e_1 + \tfrac{\sqrt{2}}{2}\, e_2, \qquad e'_2 = -\tfrac{\sqrt{2}}{2}\, e_1 + \tfrac{\sqrt{2}}{2}\, e_2. $$ En lisant les coordonnées comme colonnes : $$ P_{B, B'} \;=\; \begin{pmatrix} \tfrac{\sqrt{2}}{2} & -\tfrac{\sqrt{2}}{2} \\
\tfrac{\sqrt{2}}{2} & \tfrac{\sqrt{2}}{2} \end{pmatrix}. $$ Proposition — Inverse de la matrice de passage
Pour deux bases quelconques \(B\) et \(B'\) de \(E\), la matrice \(P_{B, B'}\) est inversible, et $$ \bigl(P_{B, B'}\bigr)^{-1} \;=\; P_{B', B}. $$
Par construction, \(P_{B, B'}\) est la matrice de l'endomorphisme identité \(\mathrm{Id}_E\) lue de \(B'\) vers \(B\) : la \(j\)-ème colonne de \(P_{B, B'}\) est \(\mathrm{coord}_B(\mathrm{Id}_E(e'_j)) = \mathrm{coord}_B(e'_j)\). Symétriquement, \(P_{B', B}\) lit \(\mathrm{Id}_E\) de \(B\) vers \(B'\). La composition des deux lectures donne la matrice de \(\mathrm{Id}_E\) de \(B\) vers \(B\), c'est-à-dire la matrice identité : $$ \begin{aligned} P_{B, B'} \cdot P_{B', B} &= \mathrm{Mat}_B(\mathrm{Id}_E) && \text{(produit = composition)} \\
&= I_n && \text{(matrice de l'identité dans toute base)}. \end{aligned} $$ Pour les matrices carrées, cette identité d'un seul côté entraîne l'autre : toute matrice carrée \(M\) satisfaisant \(M\, N = I_n\) satisfait aussi \(N\, M = I_n\) (résultat admis du cours précédent). Donc \(P_{B, B'}\) est inversible, d'inverse \(P_{B', B}\).
Exemple
On poursuit l'exemple de la rotation : un calcul direct d'inverse \(2 \times 2\) donne $$ \bigl(P_{B, B'}\bigr)^{-1} \;=\; \begin{pmatrix} \tfrac{\sqrt{2}}{2} & \tfrac{\sqrt{2}}{2} \\
-\tfrac{\sqrt{2}}{2} & \tfrac{\sqrt{2}}{2} \end{pmatrix} \;=\; P_{B', B}, $$ que l'on peut lire directement à partir de la rotation d'angle \(-\pi/4\) qui ramène \(B'\) sur \(B\). Compétences à pratiquer
- Calculer une matrice de passage
II.2
Formules de changement de base
Cette sous-section contient les formules centrales de la section. La première est rappelée du cours précédent ; la seconde est nouvelle et sera utilisée tout au long du reste du chapitre.
Proposition — Changement de coordonnées d'un vecteur
Soient \(B, B'\) deux bases de \(E\), et soit \(x \in E\) de colonnes de coordonnées \(X_B\) dans la base \(B\) et \(X_{B'}\) dans la base \(B'\). Alors $$ X_B = P_{B, B'} \cdot X_{B'}. $$ Rappel du cours précédent ; pas de nouvelle démonstration. Théorème — Changement de base pour un endomorphisme
Soit \(f \in \mathcal{L}(E)\) et soient \(B, B'\) deux bases de \(E\). Posons \(A = \mathrm{Mat}_B(f)\), \(A' = \mathrm{Mat}_{B'}(f)\), et \(P = P_{B, B'}\). Alors $$ A' \;=\; P^{-1}\, A\, P, \qquad \text{c'est-à-dire} \qquad \mathrm{Mat}_{B'}(f) \;=\; P_{B, B'}^{-1}\, \mathrm{Mat}_B(f)\, P_{B, B'}. $$
Prenons un \(x \in E\) quelconque et écrivons \(y = f(x)\). Soient \(X_B, Y_B\) les colonnes de coordonnées de \(x\) et \(y\) dans la base \(B\), et soient \(X_{B'}, Y_{B'}\) les colonnes de coordonnées de \(x\) et \(y\) dans la base \(B'\). La matrice de l'endomorphisme lit l'image colonne par colonne : $$ \begin{aligned} Y_B &= A\, X_B && \text{(définition de \(A = \mathrm{Mat}_B(f)\))}, \\
Y_{B'} &= A'\, X_{B'} && \text{(définition de \(A' = \mathrm{Mat}_{B'}(f)\))}. \end{aligned} $$ La Proposition de changement de coordonnées relie les colonnes de coordonnées : $$ \begin{aligned} X_B &= P\, X_{B'}, \\
Y_B &= P\, Y_{B'}. \end{aligned} $$ On substitue dans \(Y_B = A\, X_B\) : $$ \begin{aligned} P\, Y_{B'} &= A\, P\, X_{B'} && \text{(substitution des identités de changement de coordonnées)}, \\
Y_{B'} &= P^{-1}\, A\, P\, X_{B'} && \text{(multiplication à gauche par \(P^{-1}\), qui existe par la Proposition précédente)}. \end{aligned} $$ Cette identité est valable pour tout \(X_{B'} \in \mathcal{M}_{n, 1}(\mathbb{R})\). La comparaison avec \(Y_{B'} = A'\, X_{B'}\) et la spécialisation de \(X_{B'}\) aux vecteurs colonnes canoniques \(E_1, \dots, E_n\) redonnent tour à tour les colonnes de \(A'\) et de \(P^{-1}\, A\, P\), d'où \(A' = P^{-1}\, A\, P\).
Exemple
Dans \(\mathbb{R}^2\), soit \(f\) l'endomorphisme dont la matrice dans la base canonique \(B = (e_1, e_2)\) est $$ A = \mathrm{Mat}_B(f) = \begin{pmatrix} 2 & 1 \\
0 & 3 \end{pmatrix}. $$ On considère la base \(B' = (e'_1, e'_2)\) avec \(e'_1 = e_1\) et \(e'_2 = e_1 + e_2\). Calculer \(\mathrm{Mat}_{B'}(f)\).
Les colonnes de \(P = P_{B, B'}\) sont les coordonnées de \(e'_1, e'_2\) dans \(B\) : \(P = \begin{pmatrix} 1 & 1 \\ 0 & 1 \end{pmatrix}\). L'inverse est \(P^{-1} = \begin{pmatrix} 1 & -1 \\ 0 & 1 \end{pmatrix}\). La formule de changement de base donne : $$ \begin{aligned} \mathrm{Mat}_{B'}(f) &= P^{-1}\, A\, P && \text{(changement de base pour un endomorphisme)} \\
&= \begin{pmatrix} 1 & -1 \\
0 & 1 \end{pmatrix} \begin{pmatrix} 2 & 1 \\
0 & 3 \end{pmatrix} \begin{pmatrix} 1 & 1 \\
0 & 1 \end{pmatrix} \\
&= \begin{pmatrix} 1 & -1 \\
0 & 1 \end{pmatrix} \begin{pmatrix} 2 & 3 \\
0 & 3 \end{pmatrix} && \text{(produit de droite)} \\
&= \begin{pmatrix} 2 & 0 \\
0 & 3 \end{pmatrix} && \text{(produit de gauche)}. \end{aligned} $$ Vérification directe en calculant \(f(e'_1)\) et \(f(e'_2)\) : \(f(e'_1) = f(e_1) = 2 e_1 = 2 e'_1\) et \(f(e'_2) = f(e_1 + e_2) = (2 e_1) + (e_1 + 3 e_2) = 3 e_1 + 3 e_2 = 3 e'_2\). Les colonnes sont \(\begin{pmatrix} 2 \\ 0 \end{pmatrix}\) et \(\begin{pmatrix} 0 \\ 3 \end{pmatrix}\), ce qui confirme \(\mathrm{Mat}_{B'}(f) = \mathrm{diag}(2, 3)\).
Méthode — Calculer la matrice de \(f\) dans une nouvelle base
Étant donné \(A = \mathrm{Mat}_B(f)\) et une nouvelle base \(B'\) : - Écrire \(P = P_{B, B'}\) en lisant les coordonnées des vecteurs de \(B'\) dans \(B\) comme colonnes.
- Calculer \(P^{-1}\) (par les méthodes du cours précédent — formule \(2 \times 2\), pivot de Gauss, ou polynôme annulateur, rappelé du cours précédent).
- Calculer le produit \(P^{-1}\, A\, P\).
- Vérifier une colonne en calculant \(f\) sur un seul vecteur de base \(e'_j\) directement.
Compétences à pratiquer
- Changer la matrice d'un endomorphisme
II.3
Matrices semblables
La formule de changement de base motive la notion de similitude : deux matrices liées par la formule \(B = P^{-1}\, A\, P\) pour un certain \(P\) inversible sont dites semblables. Cette sous-section met en place la définition, les propriétés de relation d'équivalence, et l'interprétation centrale : deux matrices semblables sont exactement deux matrices d'un même endomorphisme, exprimé dans deux bases.
Définition — Matrices semblables
Deux matrices \(A, B \in \mathcal{M}_n(\mathbb{R})\) sont dites semblables, et l'on note \(A \sim B\), lorsqu'il existe \(P \in \mathrm{GL}_n(\mathbb{R})\) telle que $$ B = P^{-1}\, A\, P. $$ Exemple
La matrice \(I_n\) est semblable seulement à elle-même : \(P^{-1}\, I_n\, P = P^{-1}\, P = I_n\) pour toute \(P \in \mathrm{GL}_n(\mathbb{R})\). Plus généralement, pour tout \(\lambda \in \mathbb{R}\), la matrice scalaire \(\lambda I_n\) est semblable seulement à elle-même, puisque \(P^{-1}\, (\lambda I_n)\, P = \lambda\, P^{-1}\, P = \lambda I_n\). Proposition — La similitude est une relation d'équivalence
Sur l'ensemble \(\mathcal{M}_n(\mathbb{R})\), la relation \(\sim\) est une relation d'équivalence : elle est réflexive, symétrique et transitive. - Réflexivité. Pour \(A \in \mathcal{M}_n(\mathbb{R})\), \(A = I_n^{-1}\, A\, I_n\), donc \(A \sim A\).
- Symétrie. Supposons \(A \sim B\) via \(P\) : \(B = P^{-1}\, A\, P\). Alors \(A = P\, B\, P^{-1} = (P^{-1})^{-1}\, B\, (P^{-1})\), ce qui donne \(B \sim A\) via \(P^{-1}\).
- Transitivité. Supposons \(A \sim B\) via \(P\) et \(B \sim C\) via \(Q\) : \(B = P^{-1}\, A\, P\) et \(C = Q^{-1}\, B\, Q\). Alors $$ \begin{aligned} C &= Q^{-1}\, B\, Q && \text{(hypothèse sur \(B \sim C\))} \\ &= Q^{-1}\, (P^{-1}\, A\, P)\, Q && \text{(substitution de \(B = P^{-1}\, A\, P\))} \\ &= (P\, Q)^{-1}\, A\, (P\, Q) && \text{(regroupement et inverse d'un produit)}, \end{aligned} $$ et \(P\, Q\) est inversible comme produit d'inversibles. Donc \(A \sim C\) via \(P\, Q\).
Théorème — La similitude équivaut à même endomorphisme, deux bases
Deux matrices \(A, B \in \mathcal{M}_n(\mathbb{R})\) sont semblables si et seulement s'il existe un endomorphisme \(f \in \mathcal{L}(E)\) d'un certain espace \(E\) de dimension \(n\), et deux bases \(\mathcal{B}_1, \mathcal{B}_2\) de \(E\) (éventuellement égales — auquel cas \(P = I_n\)), telles que \(A = \mathrm{Mat}_{\mathcal{B}_1}(f)\) et \(B = \mathrm{Mat}_{\mathcal{B}_2}(f)\). - Même endomorphisme \(\Rightarrow\) semblables. Si \(A = \mathrm{Mat}_{\mathcal{B}_1}(f)\) et \(B = \mathrm{Mat}_{\mathcal{B}_2}(f)\), posons \(P = P_{\mathcal{B}_1, \mathcal{B}_2}\). Le Théorème de changement de base de la sous-section précédente donne \(B = P^{-1}\, A\, P\), donc \(A \sim B\).
- Semblables \(\Rightarrow\) même endomorphisme. Réciproquement, supposons \(B = P^{-1}\, A\, P\) pour un certain \(P \in \mathrm{GL}_n(\mathbb{R})\). Prenons \(E = \mathbb{R}^n\) muni de la base canonique \(\mathcal{B}_1\), et soit \(f\) l'endomorphisme de matrice \(A\) dans \(\mathcal{B}_1\). Soit \(\mathcal{B}_2\) la base de \(\mathbb{R}^n\) dont les vecteurs sont les colonnes de \(P\) (libres puisque \(P\) est inversible). Alors \(P_{\mathcal{B}_1, \mathcal{B}_2} = P\), et le Théorème de changement de base donne \(\mathrm{Mat}_{\mathcal{B}_2}(f) = P^{-1}\, A\, P = B\). Donc \(A\) et \(B\) sont les deux matrices d'un même endomorphisme \(f\) dans deux bases.
Proposition — Deux matrices semblables ont même rang
Si \(A, B \in \mathcal{M}_n(\mathbb{R})\) sont semblables, alors \(\mathrm{rg}(A) = \mathrm{rg}(B)\).
Par le Théorème ci-dessus, \(A\) et \(B\) sont les matrices d'un même endomorphisme \(f\) dans deux bases. Rappel du cours précédent : le rang d'une matrice est égal au rang de l'application linéaire qu'elle représente : $$ \mathrm{rg}(A) \;=\; \mathrm{rg}(f) \;=\; \mathrm{rg}(B). $$
Exemple
Montrer que \(A = \begin{pmatrix} 2 & 1 \\ 0 & 3 \end{pmatrix}\) et \(B = \begin{pmatrix} 2 & 0 \\ 0 & 3 \end{pmatrix}\) sont semblables.
Par l'exemple traité de la sous-section précédente, avec \(P = \begin{pmatrix} 1 & 1 \\ 0 & 1 \end{pmatrix}\), on a calculé \(P^{-1}\, A\, P = B\). Donc \(A \sim B\) via \(P\). (Le Théorème ci-dessus précise que \(A\) et \(B\) sont les deux matrices d'un même endomorphisme dans deux bases de \(\mathbb{R}^2\).)
Exemple — Distinguer deux matrices par le rang
Montrer que \(A = \begin{pmatrix} 1 & 0 \\ 0 & 0 \end{pmatrix}\) et \(B = \begin{pmatrix} 1 & 0 \\ 0 & 1 \end{pmatrix}\) ne sont pas semblables.
En lisant directement les rangs, \(\mathrm{rg}(A) = 1\) et \(\mathrm{rg}(B) = 2\). Par la Proposition ci-dessus, deux matrices semblables ont même rang ; ici les rangs diffèrent, donc \(A\) et \(B\) ne peuvent pas être semblables.
Méthode — Démontrer que deux matrices sont semblables ou non
Pour montrer \(A \sim B\) : soit - exhiber une matrice inversible \(P\) telle que \(B = P^{-1}\, A\, P\) (souvent en devinant \(P\) à partir d'un changement de base), soit
- exhiber un endomorphisme \(f\) et deux bases telles que \(A = \mathrm{Mat}_{\mathcal{B}_1}(f)\) et \(B = \mathrm{Mat}_{\mathcal{B}_2}(f)\).
Le diagramme ci-dessous résume le cadre de la similitude. 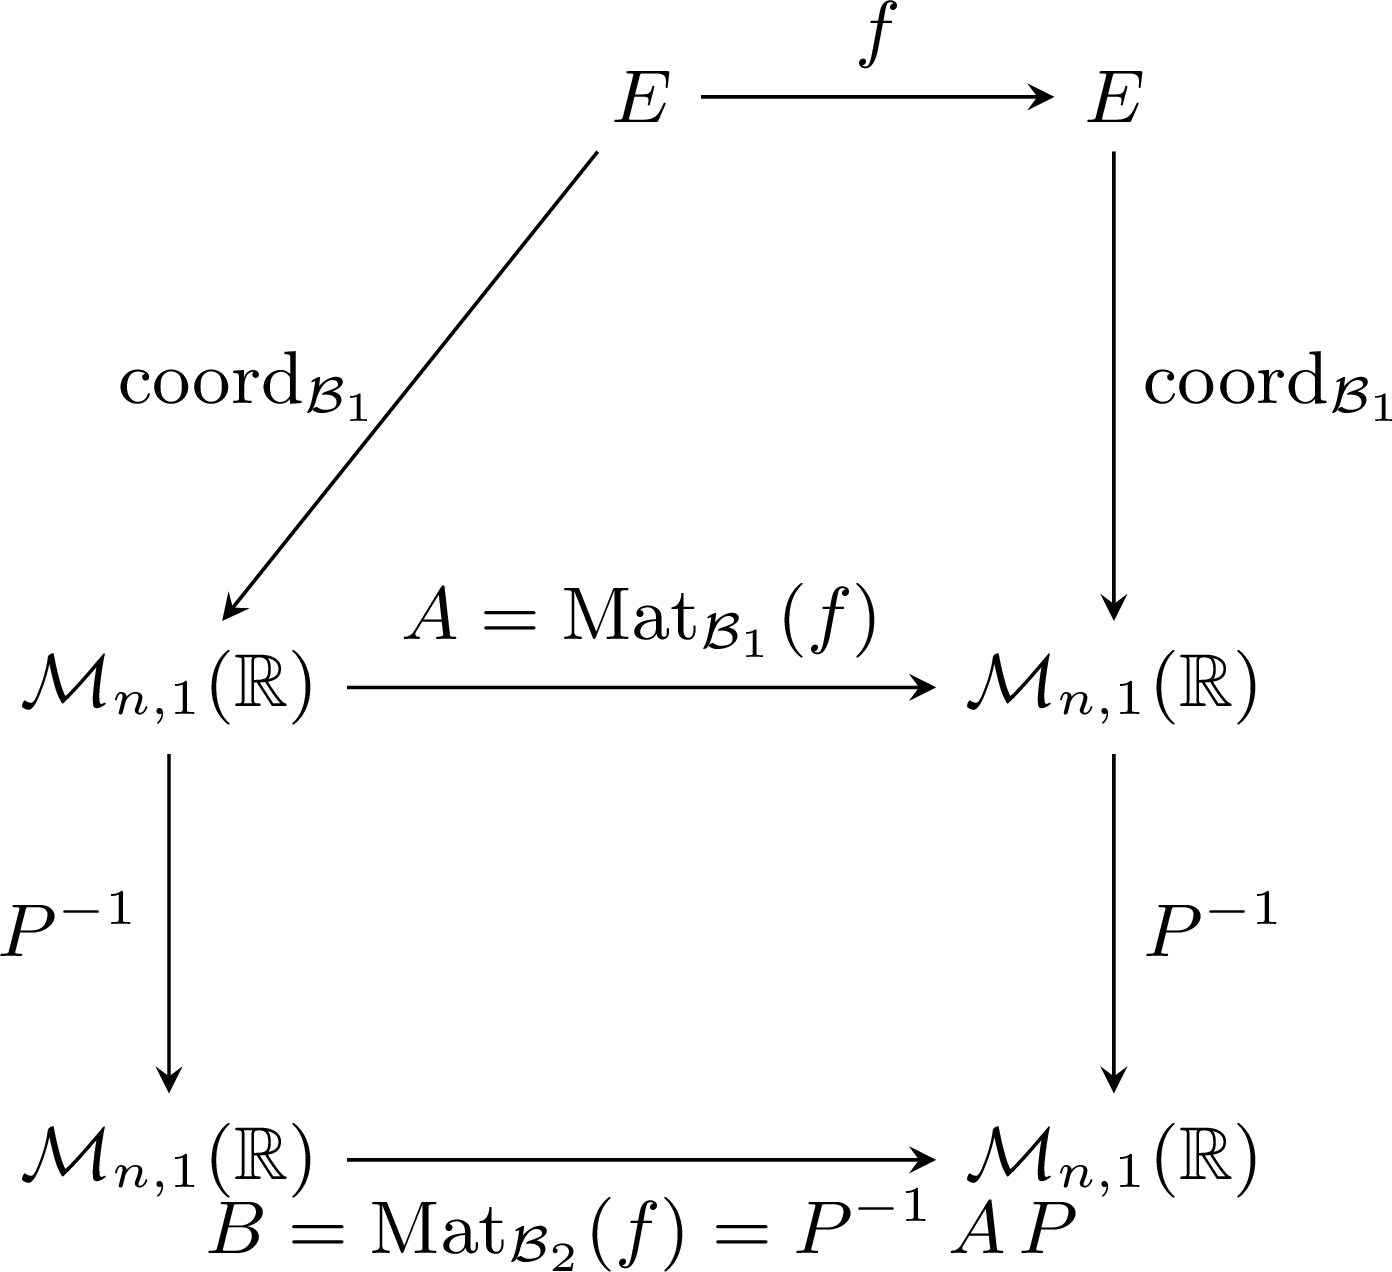
Les deux matrices \(A\) et \(B\) lisent le même endomorphisme \(f\) dans deux bases différentes ; le changement de coordonnées \(P\) relie les deux lectures.
Compétences à pratiquer
- Démontrer que deux matrices sont semblables
- Démontrer que deux matrices ne sont pas semblables
III
Trace
La trace d'une matrice carrée est l'invariant le plus simple qui soit : c'est simplement la somme des coefficients diagonaux. Malgré sa simplicité, la trace possède une propriété remarquable — elle est invariante par similitude, donc par changement de base — ce qui en fait un outil puissant pour distinguer des matrices non semblables, et pour définir la trace d'un endomorphisme (une grandeur attachée à \(f\), et non à une matrice particulière de \(f\)).
III.1
Définition et linéarité
On définit d'abord la trace et l'on observe qu'elle est une forme linéaire sur \(\mathcal{M}_n(\mathbb{R})\). La démonstration est une conséquence en une ligne de la linéarité de la somme.
Définition — Trace d'une matrice carrée
Soit \(A = (a_{i, j})_{1 \le i, j \le n} \in \mathcal{M}_n(\mathbb{R})\). La trace de \(A\), notée \(\mathrm{Tr}(A)\), est la somme de ses coefficients diagonaux : $$ \mathrm{Tr}(A) \;=\; \sum_{i = 1}^n a_{i, i} \;=\; a_{1, 1} + a_{2, 2} + \dots + a_{n, n}. $$ Exemple
Pour $$ A = \begin{pmatrix} 1 & 2 & 3 \\
4 & 5 & 6 \\
7 & 8 & 9 \end{pmatrix}, $$ la trace vaut \(\mathrm{Tr}(A) = 1 + 5 + 9 = 15\). Deux cas particuliers immédiats : \(\mathrm{Tr}(I_n) = n\) (les \(n\) coefficients diagonaux valent tous \(1\)) et \(\mathrm{Tr}(0_n) = 0\) (tous les coefficients sont nuls). Exemple
Pour une matrice diagonale \(D = \mathrm{diag}(d_1, \dots, d_n)\), la trace est la somme des coefficients diagonaux : $$ \mathrm{Tr}(D) \;=\; d_1 + d_2 + \dots + d_n. $$ La même formule vaut pour une matrice triangulaire (supérieure ou inférieure) : les coefficients hors diagonale ne contribuent pas. Proposition — Linéarité de la trace
L'application \(\mathrm{Tr}: \mathcal{M}_n(\mathbb{R}) \to \mathbb{R}\) est linéaire. Concrètement, pour tous \(A, B \in \mathcal{M}_n(\mathbb{R})\) et \(\lambda, \mu \in \mathbb{R}\) : $$ \mathrm{Tr}(\lambda A + \mu B) \;=\; \lambda\, \mathrm{Tr}(A) + \mu\, \mathrm{Tr}(B). $$
Écrivons \(A = (a_{i, j})\) et \(B = (b_{i, j})\). Le coefficient \((i, i)\) de \(\lambda A + \mu B\) est \(\lambda a_{i, i} + \mu b_{i, i}\), donc $$ \begin{aligned} \mathrm{Tr}(\lambda A + \mu B) &= \sum_{i = 1}^n (\lambda a_{i, i} + \mu b_{i, i}) && \text{(définition de la trace)} \\
&= \lambda \sum_{i = 1}^n a_{i, i} + \mu \sum_{i = 1}^n b_{i, i} && \text{(linéarité de la somme)} \\
&= \lambda\, \mathrm{Tr}(A) + \mu\, \mathrm{Tr}(B). \end{aligned} $$
Compétences à pratiquer
- Calculer une trace
III.2
L'identité fondamentale \(\mathrm{Tr}(AB)\equal\mathrm{Tr}(BA)\) et invariance par changement de base
L'identité centrale de cette section est \(\mathrm{Tr}(AB) = \mathrm{Tr}(BA)\) : la trace est invariante par échange des deux facteurs d'un produit. (Attention : cela ne s'étend pas à des réarrangements quelconques de trois facteurs ou plus — pour \(A, B, C\), la trace est invariante par permutation circulaire, \(\mathrm{Tr}(ABC) = \mathrm{Tr}(BCA) = \mathrm{Tr}(CAB)\), mais pas sous \(\mathrm{Tr}(ABC) = \mathrm{Tr}(ACB)\) en général.) Deux conséquences de l'identité à deux facteurs sont immédiates. D'abord, la trace est invariante par le changement de base \(A \mapsto P^{-1}\, A\, P\) — de manière équivalente, deux matrices semblables ont la même trace. Ensuite, la trace d'un endomorphisme est bien définie : elle ne dépend pas du choix de la base utilisée pour lire sa matrice.
Proposition — \(\mathrm{Tr}(AB)\equal\mathrm{Tr}(BA)\)
Pour tous \(A, B \in \mathcal{M}_n(\mathbb{R})\), $$ \mathrm{Tr}(A\, B) \;=\; \mathrm{Tr}(B\, A). $$
Écrivons \(A = (a_{i, j})\) et \(B = (b_{i, j})\). Le coefficient \((i, i)\) du produit \(A\, B\) vaut \(\sum_{k = 1}^n a_{i, k}\, b_{k, i}\), donc $$ \begin{aligned} \mathrm{Tr}(A\, B) &= \sum_{i = 1}^n \sum_{k = 1}^n a_{i, k}\, b_{k, i} && \text{(définition de la trace et du produit matriciel)} \\
&= \sum_{k = 1}^n \sum_{i = 1}^n b_{k, i}\, a_{i, k} && \text{(échange de l'ordre dans la double somme finie)} \\
&= \sum_{k = 1}^n (B\, A)_{k, k} && \text{(la somme interne est le coefficient \((k, k)\) de \(B\, A\))} \\
&= \mathrm{Tr}(B\, A). \end{aligned} $$
Théorème — Invariance de la trace par changement de base
Pour tous \(A \in \mathcal{M}_n(\mathbb{R})\) et \(P \in \mathrm{GL}_n(\mathbb{R})\), $$ \mathrm{Tr}(P^{-1}\, A\, P) \;=\; \mathrm{Tr}(A). $$
On applique la Proposition \(\mathrm{Tr}(X\, Y) = \mathrm{Tr}(Y\, X)\) avec le regroupement \(X = P^{-1}\, A\) et \(Y = P\) : $$ \begin{aligned} \mathrm{Tr}(P^{-1}\, A\, P) &= \mathrm{Tr}\bigl( (P^{-1}\, A)\, P\bigr) && \text{(regroupement des facteurs)} \\
&= \mathrm{Tr}\bigl( P\, (P^{-1}\, A)\bigr) && \text{(par la Proposition \(\mathrm{Tr}(XY) = \mathrm{Tr}(YX)\))} \\
&= \mathrm{Tr}\bigl( (P\, P^{-1})\, A\bigr) && \text{(associativité)} \\
&= \mathrm{Tr}(I_n\, A) && \text{(car \(P\, P^{-1} = I_n\))} \\
&= \mathrm{Tr}(A) && \text{(\(I_n\, A = A\))}. \end{aligned} $$
Proposition — Deux matrices semblables ont même trace
Si \(A, B \in \mathcal{M}_n(\mathbb{R})\) sont semblables, alors \(\mathrm{Tr}(A) = \mathrm{Tr}(B)\).
Par définition de la similitude, \(B = P^{-1}\, A\, P\) pour un certain \(P \in \mathrm{GL}_n(\mathbb{R})\). Le Théorème précédent donne \(\mathrm{Tr}(B) = \mathrm{Tr}(P^{-1}\, A\, P) = \mathrm{Tr}(A)\).
Avoir la même trace n'implique pas semblable
La réciproque de la Proposition ci-dessus est fausse. Par exemple, $$ I_2 = \begin{pmatrix} 1 & 0 \\
0 & 1 \end{pmatrix} \qquad \text{et} \qquad C = \begin{pmatrix} 2 & 0 \\
0 & 0 \end{pmatrix} $$ ont toutes deux une trace égale à \(2\), et pourtant elles ne sont pas semblables : \(I_2\) est de rang \(2\) tandis que \(C\) est de rang \(1\), et le rang est un invariant de similitude. La trace est une condition nécessaire, et non suffisante, pour la similitude.
Définition — Trace d'un endomorphisme
Soit \(f \in \mathcal{L}(E)\). La trace de \(f\), notée \(\mathrm{Tr}(f)\), est la trace de la matrice de \(f\) dans n'importe quelle base de \(E\) : $$ \mathrm{Tr}(f) \;=\; \mathrm{Tr}\bigl( \mathrm{Mat}_B(f)\bigr) \qquad \text{pour toute base } B \text{ de } E. $$ Cette définition ne dépend pas de la base \(B\) choisie, puisque deux matrices de \(f\) dans des bases différentes sont semblables (par le Théorème de la section précédente), et ont donc la même trace. Exemple
\(\mathrm{Tr}(\mathrm{Id}_E) = \mathrm{Tr}(I_n) = n = \dim E\) (l'identité a pour matrice \(I_n\) dans toute base). Exemple — Trace d'un projecteur particulier
Dans \(E = \mathbb{R}^3\), on pose \(F = \mathrm{Vect}(e_1, e_2)\) et \(G = \mathrm{Vect}(e_3)\), et soit \(p\) le projecteur sur \(F\) parallèlement à \(G\) (l'application qui envoie \((x, y, z)\) sur \((x, y, 0)\)). Dans la base adaptée \(\mathcal{B} = (e_1, e_2, e_3)\), la matrice s'écrit $$ \mathrm{Mat}_{\mathcal{B}}(p) \;=\; \mathrm{diag}(1, 1, 0), $$ donc \(\mathrm{Tr}(p) = 1 + 1 + 0 = 2\). Par le Théorème d'invariance, cette valeur de trace ne dépend pas de la base choisie ; c'est une grandeur intrinsèque attachée à \(p\). Méthode — Calculer la trace via une base adaptée
Lorsqu'un endomorphisme \(f\) a une structure connue par blocs dans une base adaptée \(\mathcal{B}\) (par exemple, \(\mathcal{B}\) adaptée à une décomposition en somme directe que \(f\) respecte — un projecteur, une symétrie, ou tout opérateur construit à partir de la décomposition), la stratégie est : - Choisir la base adaptée \(\mathcal{B}\).
- Écrire la matrice \(\mathrm{Mat}_{\mathcal{B}}(f)\) bloc par bloc.
- Lire \(\mathrm{Tr}(f)\) comme la somme des coefficients diagonaux.
Méthode — Utiliser la trace comme invariant de non-similitude
Pour montrer \(A \not\sim B\) : - Calculer \(\mathrm{Tr}(A)\) et \(\mathrm{Tr}(B)\).
- Si \(\mathrm{Tr}(A) \ne \mathrm{Tr}(B)\), conclure \(A \not\sim B\) (puisque deux matrices semblables partagent leur trace).
Pour aller plus loin
Les trois piliers de ce cours — sommes directes, changement de base, et trace — nourrissent directement le cours suivant, qui étudie la réduction des endomorphismes. La question centrale y est : étant donné un endomorphisme \(f\), peut-on trouver une base \(B'\) dans laquelle \(\mathrm{Mat}_{B'}(f)\) soit le plus simple possible — idéalement, diagonale ? La réponse conduit aux notions de valeur propre, vecteur propre et diagonalisabilité, et la trace devient l'outil le plus simple pour repérer la somme des valeurs propres. La machinerie des sommes directes est le cadre dans lequel la décomposition diagonale s'exprime naturellement, et la formule de changement de base est l'outil opératoire qui transforme la décomposition abstraite en un calcul matriciel concret.
Compétences à pratiquer
- Utiliser la trace comme invariant
IV
Pour aller plus loin
Compétences à pratiquer
- Combiner sommes directes et trace
Aller à la section