Éducation Nationale Française · ECGapprofondies 2
Compléments sur les variables aléatoires
En première année, les variables aléatoires étaient essentiellement discrètes — la valeur d'un dé, un nombre de succès. On élargit ici le cadre dans deux directions. D'abord, on définit une variable aléatoire réelle en toute généralité, comme une application \(X : \Omega \to \mathbb{R}\) pour laquelle les événements \([X \le x]\) ont un sens, et on la décrit par sa fonction de répartition \(F_X(x) = P(X \le x)\) — une seule fonction qui encode toute la loi et se prolongera telle quelle aux variables continues du chapitre suivant. Ensuite, on affine le conditionnement : l'espérance conditionnelle \(E(X \mid A)\) d'une variable sachant un événement, et la formule de l'espérance totale qui reconstitue \(E(X)\) en découpant l'univers selon un système complet d'événements — l'analogue, pour l'espérance, de la formule des probabilités totales. Conventions : \((\Omega, \mathcal{A}, P)\) désigne un espace probabilisé ; toutes les variables sont réelles, et à partir de la deuxième section elles sont discrètes. On rappelle librement de la première année l'espérance \(E(X) = \sum_x x\, P(X = x)\) d'une variable discrète (définie lorsque la série converge absolument) et sa linéarité.
I
Variables aléatoires réelles et fonction de répartition
I.1
Variables aléatoires réelles et opérations
Une variable aléatoire attache un nombre à chaque issue d'une expérience. Pour que des probabilités comme \(P(X \le x)\) ou \(P(a < X \le b)\) aient un sens, les ensembles d'issues correspondants doivent être des événements. Cette seule exigence est la définition d'une variable aléatoire réelle ; elle couvre aussi bien les variables discrètes de la première année que les variables continues du chapitre suivant.
Définition — Variable aléatoire réelle
Une variable aléatoire réelle est une application \(X : \Omega \to \mathbb{R}\) telle que $$ \forall x \in \mathbb{R}, \quad [X \le x] = \{\omega \in \Omega : X(\omega) \le x\} \in \mathcal{A}. $$ Proposition — Événements associés à une variable aléatoire
Soit \(X\) une variable aléatoire réelle. Pour tout intervalle \(I\) de \(\mathbb{R}\), $$ [X \in I] = \{\omega \in \Omega : X(\omega) \in I\} \in \mathcal{A}. $$ C'est la caractérisation équivalente d'une variable aléatoire réelle au moyen des intervalles.
Énoncé admis. Cela découle de la définition et de la stabilité de la famille d'événements \(\mathcal{A}\) par les opérations ensemblistes usuelles ; vérifier qu'une application donnée est une variable aléatoire n'est pas un objectif à ce niveau, on l'admet donc.
Proposition — Opérations sur les variables aléatoires
Soient \(X, Y\) deux variables aléatoires réelles et \(\lambda \in \mathbb{R}\). Alors \(X + Y\), \(XY\), \(\lambda X\), \(\min(X, Y)\) et \(\max(X, Y)\) sont des variables aléatoires réelles.
Énoncé admis par le programme ; on ne vérifie jamais la mesurabilité à la main.
Exemple
La somme \(X\) des deux faces lors du lancer de deux dés est une variable aléatoire réelle, avec \(X(\Omega) = \{2, \dots, 12\}\). Le nombre \(N\) de piles en \(n\) lancers d'une pièce est une variable aléatoire réelle, avec \(N(\Omega) = \{0, \dots, n\}\) (elle suit une loi binomiale). Dans les deux cas les événements \([X \le x]\) sont des réunions d'événements élémentaires, donc appartiennent à \(\mathcal{A}\). Définition — Variable indicatrice
Soit \(A \in \mathcal{A}\). L'indicatrice de \(A\) est l'application $$ \mathbf{1}_A : \omega \in \Omega \longmapsto \begin{cases} 1 & \text{si } \omega \in A, \\
0 & \text{si } \omega \notin A. \end{cases} $$ Proposition — L'indicatrice est une variable de Bernoulli
Pour \(A \in \mathcal{A}\), l'indicatrice \(\mathbf{1}_A\) est une variable aléatoire réelle et suit la loi de Bernoulli \(\mathcal{B}(P(A))\).
On vérifie la définition : \([\mathbf{1}_A \le x]\) dépend de \(x\) comme suit, $$ [\mathbf{1}_A \le x] = \begin{cases} \emptyset & \text{si } x < 0, \\
A^c & \text{si } 0 \le x < 1, \\
\Omega & \text{si } x \ge 1, \end{cases} $$ et \(\emptyset\), \(A^c\) (car \(A \in \mathcal{A}\)) et \(\Omega\) appartiennent tous à \(\mathcal{A}\). Donc \(\mathbf{1}_A\) est une variable aléatoire réelle. Ses valeurs sont \(0\) et \(1\), avec \(P(\mathbf{1}_A = 1) = P(A)\) et \(P(\mathbf{1}_A = 0) = P(A^c) = 1 - P(A)\) : c'est la loi de Bernoulli \(\mathcal{B}(P(A))\).
Exemple
La valeur \(X\) obtenue en lançant un dé est une variable aléatoire réelle discrète, avec \(X(\Omega) = \{1, \dots, 6\}\). L'indicatrice \(\mathbf{1}_A\) d'un événement \(A\) est une variable aléatoire réelle (de Bernoulli). Une grandeur continue comme la durée de vie d'un composant est aussi une variable aléatoire réelle ; ces variables, dont la fonction de répartition n'a aucun saut, font l'objet du chapitre suivant. Exemple
L'indicatrice \(\mathbf{1}_{[X = 6]}\) de l'événement « le dé montre \(6\) » vaut \(1\) si le dé montre \(6\) et \(0\) sinon ; elle suit la loi de Bernoulli \(\mathcal{B}\!\left(\tfrac16\right)\), d'espérance \(E(\mathbf{1}_{[X=6]}) = P(X = 6) = \tfrac16\). Méthode — Modéliser une grandeur par une variable aléatoire
Pour modéliser une grandeur numérique par une variable aléatoire : on identifie l'univers \(\Omega\) des issues, on définit l'application \(X : \Omega \to \mathbb{R}\), et on exprime les grandeurs d'intérêt comme des événements \([X \le x]\), \([X = k]\) ou \([a < X \le b]\) sur lesquels on calculera des probabilités. Compétences à pratiquer
- Reconnaître et modéliser des variables aléatoires
I.2
La fonction de répartition
Plutôt que de lister toutes les probabilités \(P(X \in I)\), on enregistre une seule fonction d'une variable réelle — la fonction de répartition — d'où toutes les autres se déduisent. Elle est définie pour toute variable aléatoire réelle, discrète ou non.
Définition — Fonction de répartition
Soit \(X\) une variable aléatoire réelle. La fonction de répartition de \(X\) est la fonction \(F_X : \mathbb{R} \to \mathbb{R}\) définie par $$ \forall x \in \mathbb{R}, \quad F_X(x) = P(X \le x). $$ Proposition — Probabilités à partir de la fonction de répartition
Soit \(X\) une variable aléatoire réelle et \(a, b \in \mathbb{R}\) avec \(a \le b\). Alors $$ P(X > a) = 1 - F_X(a), \qquad P(a < X \le b) = F_X(b) - F_X(a). $$
L'événement \([X > a]\) est le complémentaire de \([X \le a]\), donc \(P(X > a) = 1 - P(X \le a) = 1 - F_X(a)\). Pour la seconde, comme \(a \le b\), les événements \([X \le a]\) et \([a < X \le b]\) sont disjoints de réunion \([X \le b]\) : $$ \begin{aligned} P(X \le b) &= P(X \le a) + P(a < X \le b) && \text{(réunion disjointe, additivité)} \\
\text{d'où } P(a < X \le b) &= F_X(b) - F_X(a). && \end{aligned} $$
Définition — Loi d'une variable aléatoire
La loi (ou distribution) d'une variable aléatoire réelle \(X\) est la donnée des probabilités \(P(X \in I)\) pour tout intervalle \(I\) de \(\mathbb{R}\). Proposition — La loi est caractérisée par la fonction de répartition
Deux variables aléatoires réelles ayant la même fonction de répartition ont la même loi.
En effet deux variables de même \(F_X\) donnent la même valeur \(F_X(b) - F_X(a) = P(a < X \le b)\) pour tous \(a \le b\) ; la probabilité d'un intervalle quelconque se construit à partir de celles-là, donc les deux variables ont la même loi.
Exemple
Déterminer la fonction de répartition de la valeur \(X\) d'un dé équilibré.
Ici \(X(\Omega) = \{1, \dots, 6\}\) avec \(P(X = k) = \tfrac{1}{6}\). Pour \(x \in \mathbb{R}\), \(F_X(x) = P(X \le x)\) compte les valeurs \(k \le x\) : elle vaut \(0\) pour \(x < 1\), saute de \(\tfrac16\) à chaque entier \(1, \dots, 6\), et vaut \(1\) pour \(x \ge 6\). Le graphe est un escalier, continu à droite, avec un saut de hauteur \(\tfrac16\) à chaque valeur de \(X\). 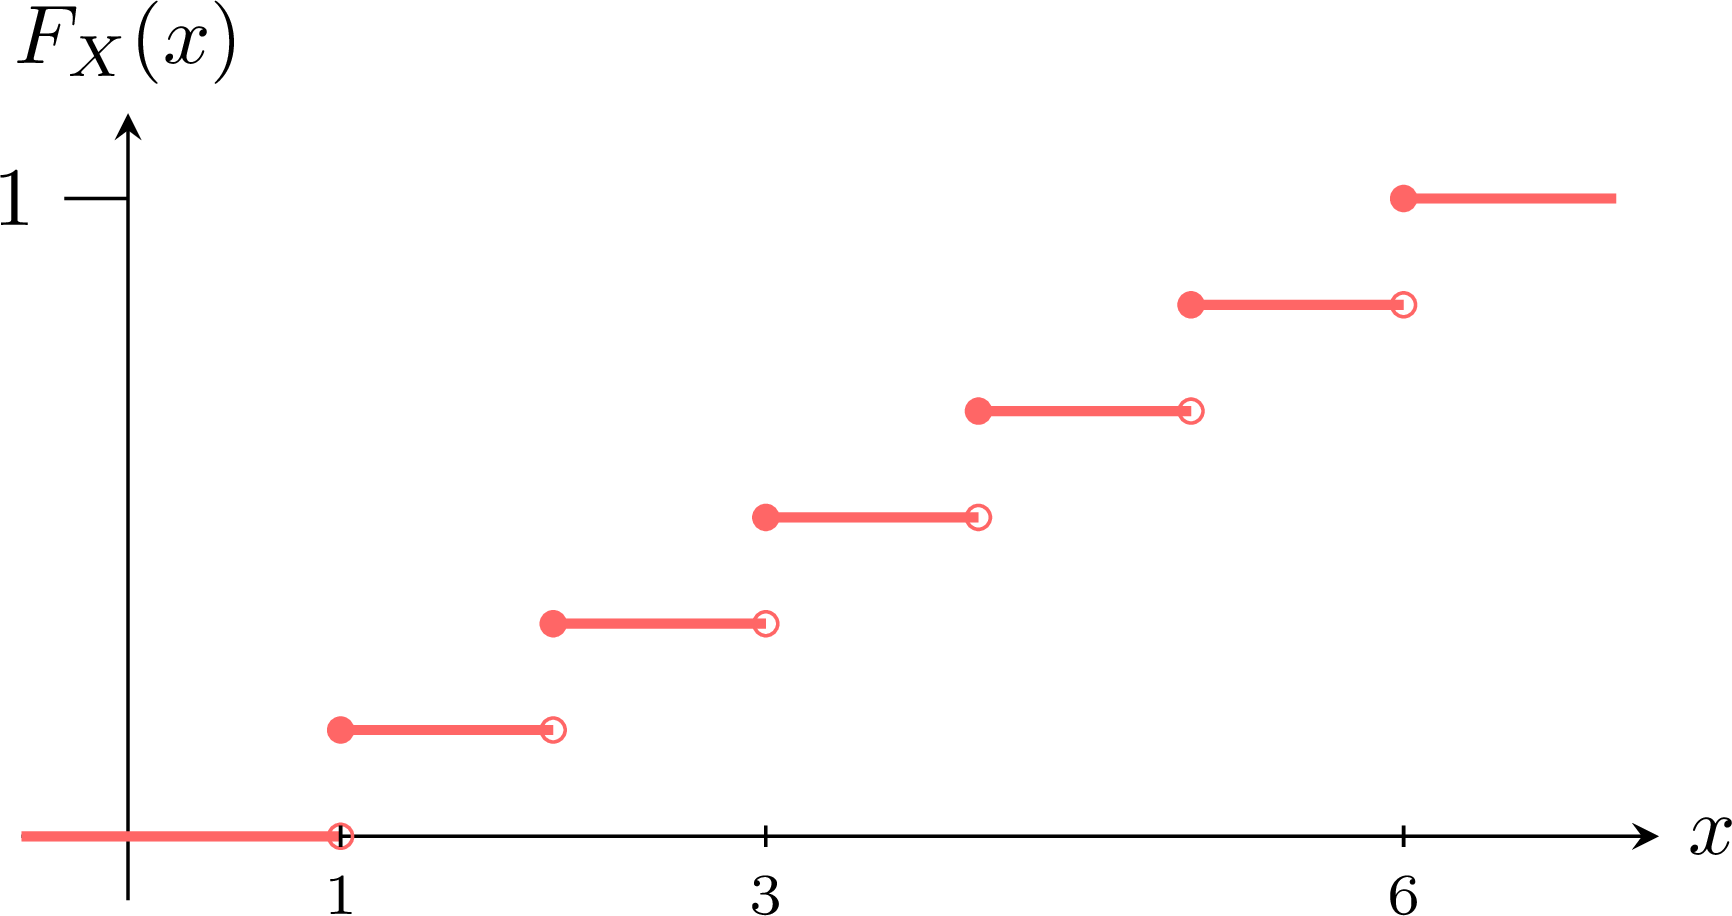
Exemple
Pour une variable de Bernoulli \(X \sim \mathcal{B}(p)\) (\(0 < p < 1\)), \(F_X(x) = 0\) pour \(x < 0\), \(F_X(x) = 1 - p\) pour \(0 \le x < 1\), et \(F_X(x) = 1\) pour \(x \ge 1\) : un escalier à deux marches, avec un saut de hauteur \(1 - p = P(X = 0)\) en \(0\) et un saut de hauteur \(p = P(X = 1)\) en \(1\). Méthode — Lire la loi sur la fonction de répartition
Les points où \(F_X\) saute sont exactement les valeurs \(x\) telles que \(P(X = x) > 0\) (les atomes), et \(P(X = x)\) est la hauteur du saut en \(x\). Pour une variable discrète ces atomes sont les points de \(X(\Omega)\) portant une probabilité strictement positive. Compétences à pratiquer
- Calculer avec la fonction de répartition
I.3
Caractériser une fonction de répartition
Une fonction de répartition n'est pas une fonction quelconque : elle monte toujours de \(0\) à \(1\) sans jamais redescendre. On établit d'abord ces propriétés structurelles, puis on énonce exactement quelles fonctions s'obtiennent ainsi et comment lire la probabilité d'une valeur isolée sur les sauts.
Proposition — Propriétés d'une fonction de répartition
Soit \(X\) une variable aléatoire réelle et \(F_X\) sa fonction de répartition. Alors \(F_X\) est croissante sur \(\mathbb{R}\), continue à droite en tout point, et $$ \lim_{x \to -\infty} F_X(x) = 0, \qquad \lim_{x \to +\infty} F_X(x) = 1. $$ - Croissance. Si \(x \le x'\) alors \([X \le x] \subset [X \le x']\), donc par croissance de \(P\), \(F_X(x) = P(X \le x) \le P(X \le x') = F_X(x')\).
- Limite en \(-\infty\). Les événements \([X \le -n]\) décroissent (quand \(n \to +\infty\)) vers \(\bigcap_n [X \le -n] = \emptyset\), donc par la continuité de \(P\) rappelée de la première année, \(F_X(-n) = P(X \le -n) \to P(\emptyset) = 0\).
- Limite en \(+\infty\). Les événements \([X \le n]\) croissent vers \(\bigcup_n [X \le n] = \Omega\), donc \(F_X(n) = P(X \le n) \to P(\Omega) = 1\).
Théorème — Caractérisation d'une fonction de répartition
Une fonction \(F : \mathbb{R} \to \mathbb{R}\) est la fonction de répartition d'une variable aléatoire réelle si et seulement si elle est croissante sur \(\mathbb{R}\), continue à droite en tout point, et vérifie \(\lim_{-\infty} F = 0\) et \(\lim_{+\infty} F = 1\). De plus, pour toute variable aléatoire réelle \(X\), $$ P(X = x) = F_X(x) - \lim_{t \to x^-} F_X(t), $$ la hauteur du saut de \(F_X\) en \(x\).
L'implication directe (une fonction de répartition a les trois propriétés) est la Proposition précédente. La réciproque — toute telle \(F\) est la fonction de répartition d'une variable aléatoire — nécessite la construction d'un espace probabilisé adapté et est admise ici. Pour la formule du saut : \([X < x] = \bigcup_n [X \le x - \tfrac1n]\) est une réunion croissante, donc \(P(X < x) = \lim_n F_X(x - \tfrac1n)\), et par monotonie de \(F_X\) cette limite séquentielle est la limite à gauche \(\lim_{t \to x^-} F_X(t)\) ; comme \([X = x] = [X \le x] \setminus [X < x]\) avec \([X < x] \subset [X \le x]\), $$ P(X = x) = P(X \le x) - P(X < x) = F_X(x) - \lim_{t \to x^-} F_X(t). $$
Exemple
Considérons la fonction \(F(x) = 0\) pour \(x < 0\) et \(F(x) = 1 - e^{-x}\) pour \(x \ge 0\). Elle est croissante, continue (en particulier continue à droite), de limites \(0\) en \(-\infty\) et \(1\) en \(+\infty\), donc c'est une fonction de répartition. Elle n'a aucun saut, donc \(P(X = x) = 0\) pour tout \(x\) : c'est une variable continue — possédant une densité, le type étudié au chapitre suivant (ici, une durée de vie exponentielle). Par contraste, la figure ci-dessous montre une autre fonction de répartition, mixte, \(G\), qui possède un atome en \(0\) : la hauteur de son saut y est \(P(X = 0) > 0\). 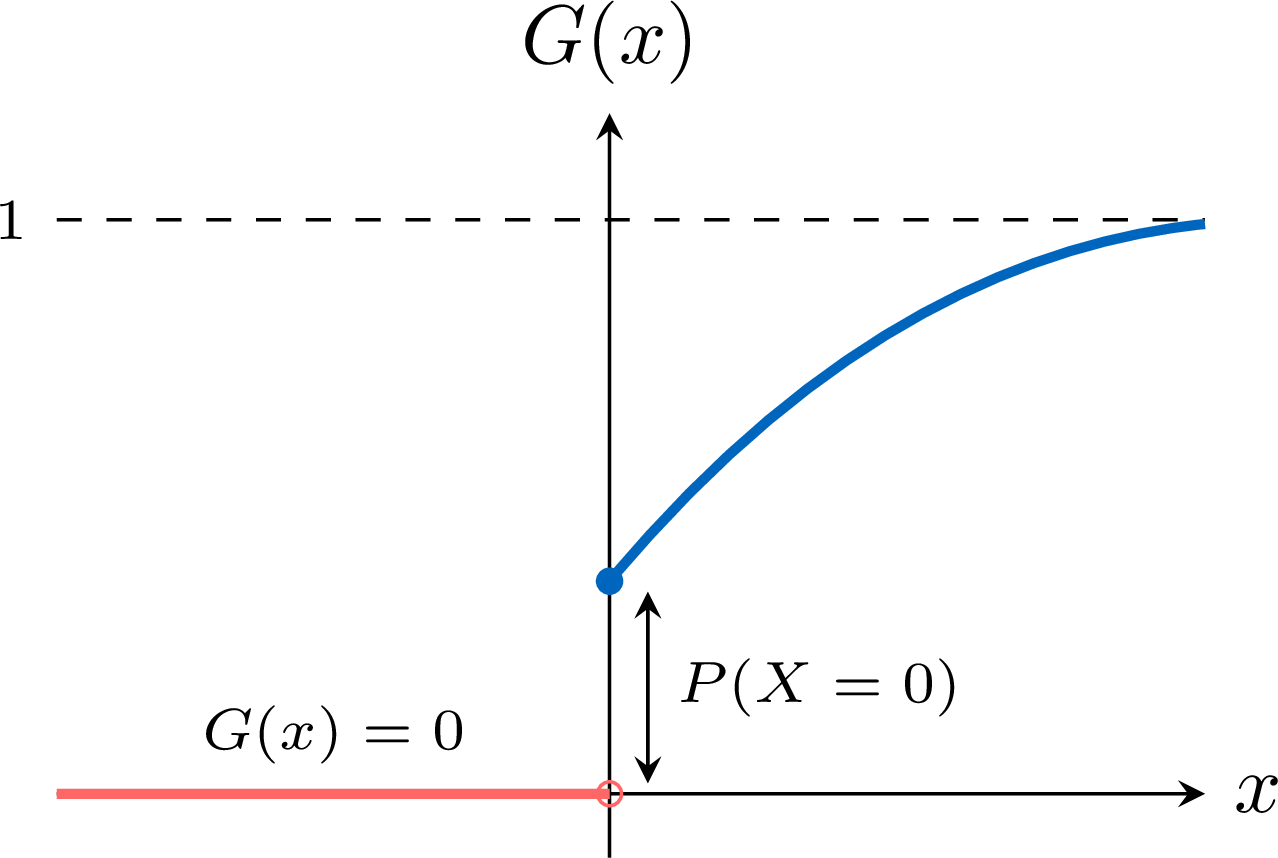
Proposition — Fonction de répartition d'une variable discrète
Soit \(X\) une variable aléatoire réelle discrète. Alors $$ \forall x \in \mathbb{R}, \quad F_X(x) = \sum_{\substack{z \in X(\Omega) \\
z \le x}} P(X = z), $$ \(F_X\) est continue à droite, donnée par cette série, et présente un saut de hauteur \(P(X = x)\) en chaque atome (les \(x\) avec \(P(X = x) > 0\)). Pour les variables discrètes usuelles de ce cours (binomiale, géométrique, Poisson), dont les valeurs sont isolées, \(F_X\) est un escalier obtenu en accumulant les masses \(P(X = z)\).
L'événement \([X \le x]\) est la réunion disjointe des \([X = z]\) pour \(z \in X(\Omega)\) avec \(z \le x\), donc par additivité \(F_X(x) = \sum_{z \le x} P(X = z)\). Lorsque \(x\) franchit un atome \(z\), le terme \(P(X = z)\) s'ajoute, donc \(F_X\) y saute exactement de \(P(X = z)\) ; c'est l'escalier, avec des sauts précisément aux atomes.
Méthode — Vérifier qu'une fonction est une fonction de répartition
Pour vérifier qu'une fonction \(F\) est une fonction de répartition : on vérifie qu'elle est croissante, continue à droite, et de limites \(0\) en \(-\infty\) et \(1\) en \(+\infty\). Ses sauts donnent alors les atomes \(\{x : P(X = x) > 0\}\) et leurs masses ; une partie sans saut ne porte aucun atome (le cas continu du chapitre suivant). Les sauts redonnent les atomes, pas nécessairement toute l'image d'une variable représentante. Compétences à pratiquer
- Vérifier une fonction de répartition
II
Espérance conditionnelle et formule de l'espérance totale
II.1
Espérance conditionnelle sachant un événement
Rappelons de la première année qu'une variable discrète \(X\) admet une espérance lorsque \(\sum_x x\, P(X = x)\) converge absolument, et alors \(E(X) = \sum_x x\, P(X = x)\) ; l'espérance est linéaire. Lorsqu'on apprend qu'un événement \(A\) est réalisé, on remplace la probabilité \(P\) par la probabilité conditionnelle \(P_A(B) = P(A \cap B)/P(A)\) (une probabilité à part entière) et on obtient l'espérance conditionnelle. À partir d'ici toutes les variables sont discrètes.
Définition — Loi et espérance conditionnelles sachant un événement
Soit \(A \in \mathcal{A}\) avec \(P(A) \ne 0\) et \(X\) une variable aléatoire discrète. La loi de \(X\) sachant \(A\) est la donnée des \(P_A(X = x)\) pour \(x \in X(\Omega)\). On dit que \(X\) admet une espérance sachant \(A\) lorsque \(\sum_x x\, P_A(X = x)\) converge absolument, et alors $$ E(X \mid A) = \sum_{x \in X(\Omega)} x\, P_A(X = x). $$ Exemple
Soit \(X\) la valeur d'un dé équilibré et \(A = [X \text{ est pair}]\). Déterminer \(E(X \mid A)\).
Sachant \(A\), la variable prend les valeurs \(2, 4, 6\) chacune avec probabilité conditionnelle \(P_A(X = 2k) = \tfrac{1/6}{1/2} = \tfrac13\). Donc $$ E(X \mid A) = 2 \cdot \tfrac13 + 4 \cdot \tfrac13 + 6 \cdot \tfrac13 = 4. $$
Exemple
Soit \(X\) la valeur d'un dé équilibré et \(B = [X \ge 4]\). Sachant \(B\), la variable prend les valeurs \(4, 5, 6\) chacune avec probabilité conditionnelle \(\tfrac13\), donc \(E(X \mid B) = \tfrac{4 + 5 + 6}{3} = 5\). Le conditionnement a déplacé la moyenne de \(E(X) = 3{,}5\) à \(5\). Proposition — Existence de l'espérance conditionnelle
Soit \(A \in \mathcal{A}\) avec \(P(A) \ne 0\). Si \(X\) admet une espérance (sous \(P\)), alors \(X\) admet une espérance sachant \(A\).
Pour tout \(x\), \(P_A(X = x) = \dfrac{P(A \cap [X = x])}{P(A)} \le \dfrac{P(X = x)}{P(A)}\). Donc $$ \sum_x |x|\, P_A(X = x) \le \frac{1}{P(A)} \sum_x |x|\, P(X = x) < +\infty, $$ la série de droite convergeant car \(X\) admet une espérance. Donc \(\sum_x x\, P_A(X = x)\) converge absolument, c'est-à-dire \(X\) admet une espérance sachant \(A\).
Proposition — Linéarité de l'espérance conditionnelle
Soit \(A \in \mathcal{A}\) avec \(P(A) \ne 0\), et \(X, Y\) deux variables discrètes admettant une espérance sachant \(A\). Pour tous \(\lambda, \mu \in \mathbb{R}\), la variable \(\lambda X + \mu Y\) admet une espérance sachant \(A\), et $$ E(\lambda X + \mu Y \mid A) = \lambda\, E(X \mid A) + \mu\, E(Y \mid A). $$
Comme \(P_A\) est elle-même une probabilité, \(E(\cdot \mid A)\) est l'espérance ordinaire calculée pour la probabilité \(P_A\). Le résultat est donc la linéarité de l'espérance rappelée de la première année, appliquée à \(P_A\).
Méthode — Calculer une espérance conditionnelle
Pour calculer \(E(X \mid A)\) : on détermine la loi conditionnelle \((x, P_A(X = x))\) — qui est souvent une loi usuelle (Bernoulli, binomiale, géométrique, …) — puis on somme \(E(X \mid A) = \sum_x x\, P_A(X = x)\). Lorsque la loi conditionnelle est usuelle, on lit directement son espérance connue. Compétences à pratiquer
- Calculer une espérance conditionnelle
II.2
La formule de l'espérance totale
La formule des probabilités totales calcule \(P(B)\) en découpant l'univers selon un système complet d'événements. Le même découpage calcule une espérance : chaque espérance conditionnelle \(E(X \mid A_n)\) est pondérée par \(P(A_n)\) puis sommée. C'est la formule de l'espérance totale.
Théorème — Formule de l'espérance totale
Soit \((A_n)_{n \in I}\) un système complet d'événements, avec \(I\) fini ou dénombrable et \(P(A_n) \ne 0\) pour tout \(n\), et \(X\) une variable aléatoire discrète. - Si \(I\) est fini et \(X\) admet une espérance, alors \(E(X) = \displaystyle\sum_{n \in I} P(A_n)\, E(X \mid A_n)\).
- Si \(I\) est dénombrable infini, alors \(X\) admet une espérance si et seulement si chaque \(E(X \mid A_n)\) existe et \(\sum_n P(A_n)\, E(|X| \mid A_n)\) converge ; dans ce cas \(E(X) = \displaystyle\sum_{n \in I} P(A_n)\, E(X \mid A_n)\).
On démontre le cas fini \(I = \{1, \dots, N\}\) (le cas dénombrable infini, avec son critère de convergence absolue, est admis). Comme \(X\) admet une espérance, chaque \(E(X \mid A_n)\) existe par la Proposition d'existence. Alors $$ \begin{aligned} \sum_{n=1}^N P(A_n)\, E(X \mid A_n) &= \sum_{n=1}^N P(A_n) \sum_x x\, P_{A_n}(X = x) && \text{(définition de } E(X \mid A_n)\text{)} \\
&= \sum_x x \sum_{n=1}^N P(A_n)\, P_{A_n}(X = x) && \text{(la somme finie commute avec la série, par linéarité)} \\
&= \sum_x x\, P(X = x) && \text{(formule des probabilités totales sur } [X = x]\text{)} \\
&= E(X). && \end{aligned} $$
Chaque fois qu'on utilise la formule de l'espérance totale, le système complet d'événements \((A_n)\) doit d'abord être précisé explicitement. La formule reste valable pour un système presque complet (couvrant l'univers à un événement négligeable près).
Méthode — Utiliser la formule de l'espérance totale
Trois étapes : (1) préciser explicitement le système complet d'événements \((A_n)\) utilisé ; (2) calculer chaque espérance conditionnelle \(E(X \mid A_n)\) (souvent une loi conditionnelle usuelle) ; (3) sommer \(E(X) = \sum_n P(A_n)\, E(X \mid A_n)\) — pour un système dénombrable infini, justifier d'abord la convergence de \(\sum_n P(A_n)\, E(|X| \mid A_n)\). Exemple
Le nombre \(X\) de clients entrant dans un restaurant un soir suit une loi de Poisson \(\mathcal{P}(\lambda)\) avec \(\lambda > 0\). Chaque client choisit indépendamment de la viande avec probabilité \(p \in [0, 1]\). Soit \(Y\) le nombre de ceux qui choisissent de la viande. Calculer \(E(Y)\). 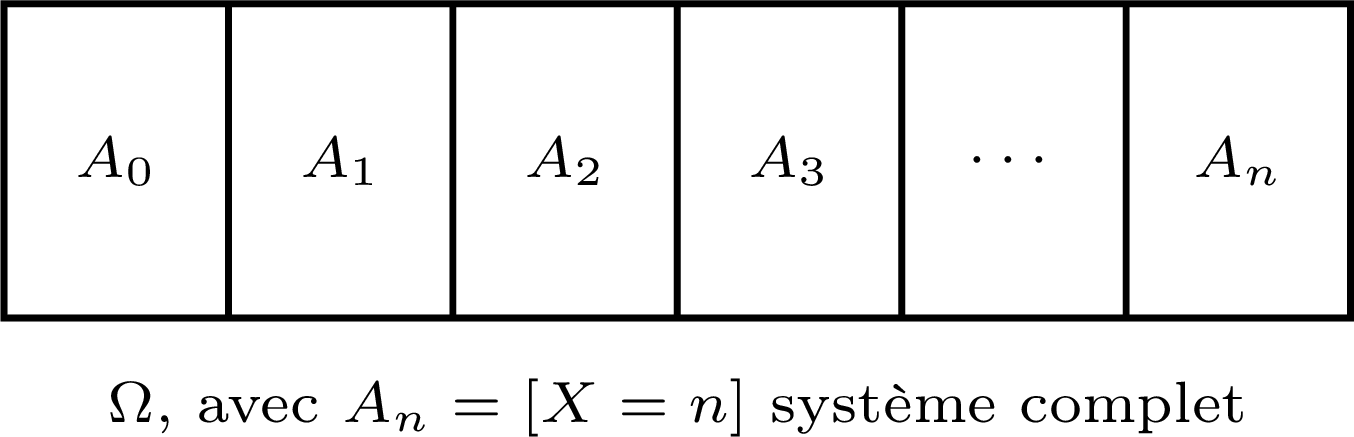
- Système complet. On prend \(A_n = [X = n]\) pour \(n \in \mathbb{N}\) : un système complet d'événements, avec \(P(A_n) = e^{-\lambda}\tfrac{\lambda^n}{n!} \ne 0\).
- Loi conditionnelle. Sachant \([X = n]\), chacun des \(n\) clients choisit de la viande indépendamment avec probabilité \(p\), donc \(Y\) sachant \([X = n]\) suit la loi binomiale \(\mathcal{B}(n, p)\), d'espérance \(E(Y \mid X = n) = np\).
- Espérance totale. Comme \(Y \ge 0\), \(E(|Y| \mid X = n) = E(Y \mid X = n) = np\), et \(\sum_n P(X = n)\, np = \lambda p < +\infty\) converge, donc la formule de l'espérance totale s'applique. La série à termes positifs donne $$ \begin{aligned} E(Y) &= \sum_{n=0}^{+\infty} P(X = n)\, E(Y \mid X = n) && \text{(formule de l'espérance totale)} \\ &= \sum_{n=0}^{+\infty} e^{-\lambda}\frac{\lambda^n}{n!}\, np && \text{(\(E(Y\mid X=n) = np\) ; \(P(X=n)\) Poisson)} \\ &= p\lambda \sum_{n=1}^{+\infty} e^{-\lambda}\frac{\lambda^{n-1}}{(n-1)!} && \text{(on retire \(n=0\) ; \(\tfrac{n}{n!} = \tfrac{1}{(n-1)!}\))} \\ &= p\lambda \sum_{m=0}^{+\infty} e^{-\lambda}\frac{\lambda^{m}}{m!} && \text{(\(m = n-1\))} \\ &= \lambda p. && \text{(la série de Poisson vaut \(1\))} \end{aligned} $$
Pour aller plus loin
La fonction de répartition introduite ici décrit toute variable aléatoire réelle. Le chapitre suivant l'utilise pour définir les variables aléatoires à densité — celles dont la fonction de répartition est continue et obtenue à partir d'une intégrale — généralisant les moments discrets rappelés ici. Les chapitres ultérieurs traitent les vecteurs aléatoires (plusieurs variables ensemble) et la convergence de suites de variables aléatoires, où la formule de l'espérance totale et la fonction de répartition réapparaissent toutes deux.
Compétences à pratiquer
- Appliquer la formule de l'espérance totale
III
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section