Éducation Nationale Française · ECGapprofondies 2
Estimation ponctuelle et qualité des estimateurs
La statistique transforme des données en connaissance sur une loi inconnue. On observe un \(n\)-échantillon \((X_1, \dots, X_n)\) de copies indépendantes d'une variable \(X\) dont la loi est connue à un paramètre \(\theta\) près, et l'on veut estimer \(\theta\) — ou une quantité \(g(\theta)\) telle que son espérance. Un estimateur est une fonction de l'échantillon, \(T_n = \varphi(X_1, \dots, X_n)\) ; l'exemple central est la moyenne empirique \(\overline{X_n}\). Deux qualités rendent un estimateur fiable : il doit être sans biais (juste en moyenne, \(E_\theta(T_n) = g(\theta)\)) et convergent (il se fixe sur la vraie valeur quand l'échantillon grandit, \(T_n \xrightarrow{P} g(\theta)\) — la loi des grands nombres à l'œuvre). Entre deux estimateurs sans biais, celui de plus petite variance est le meilleur. Ce chapitre construit le vocabulaire rigoureux de l'estimation ; le prochain transforme les fluctuations d'un estimateur convergent en intervalles de confiance. Conventions : \((\mu_\theta)_{\theta \in \Theta}\) est la famille des lois candidates, \(\Theta \subset \mathbb{R}\) (éventuellement \(\mathbb{R}^2\)) l'ensemble des paramètres ; \(E_\theta\) et \(V_\theta\) sont l'espérance et la variance calculées sous \(P_\theta\) ; \(\overline{X_n} = \frac1n \sum_{k=1}^n X_k\) est la moyenne empirique.
I
Le problème de l'estimation et le vocabulaire
I.1
Modèle statistique et échantillonnage
On étudie un phénomène dont la loi est connue par son type (Bernoulli, Poisson, exponentielle, normale…) mais non par son paramètre. Pour apprendre le paramètre, on répète l'expérience de façon indépendante et l'on recueille un échantillon.
Définition — Modèle statistique et \(n\)-échantillon
Un modèle statistique est une famille de lois \((\mu_\theta)_{\theta \in \Theta}\) indexée par un paramètre \(\theta\) dans un ensemble \(\Theta \subset \mathbb{R}\) (ou \(\mathbb{R}^2\)), dont la vraie valeur est inconnue et caractérise la loi. Un \(n\)-échantillon de loi mère \(\mu_\theta\) est un \(n\)-uplet \((X_1, \dots, X_n)\) de variables i.i.d. de loi \(\mu_\theta\) ; un échantillon observé \((x_1, \dots, x_n)\) est une réalisation de \((X_1, \dots, X_n)\). Exemple
Trois modèles typiques. Sondage : à la veille d'une élection, \(X = 1\) si un électeur interrogé au hasard choisit le candidat \(A\), sinon \(0\) ; \(X \hookrightarrow \mathcal{B}(\theta)\) avec \(\Theta = [0, 1]\), \(\theta\) la proportion votant \(A\). Durée de vie : la durée \(X\) d'un appareil sans mémoire, \(X \hookrightarrow \mathcal{E}(\theta)\), \(\Theta = ]0, +\infty[\). Comptage : le nombre \(X\) d'arrivées à un péage en une heure, \(X \hookrightarrow \mathcal{P}(\theta)\).
Les notations \(E_\theta\) et \(V_\theta\)
La vraie valeur de \(\theta\) étant inconnue, tous les calculs sont menés sous chaque probabilité \(P_\theta\) — la probabilité pour laquelle l'échantillon \((X_1, \dots, X_n)\) est i.i.d. de loi mère \(\mu_\theta\) — de sorte que les conclusions valent quelle que soit la vraie valeur. On note \(E_\theta(X)\), \(V_\theta(X)\) l'espérance et la variance sous \(P_\theta\) — elles dépendent de \(\theta\) (par exemple \(E_\theta(X_i) = \theta\), \(V_\theta(X_i) = \theta(1 - \theta)\) pour un échantillon de Bernoulli).
Compétences à pratiquer
- Mettre en place un modèle statistique
I.2
Estimateurs et moyenne empirique
Un estimateur est toute quantité calculée à partir de l'échantillon et servant à deviner \(g(\theta)\). Surtout, il ne doit pas utiliser \(\theta\) — précisément ce que l'on cherche.
Définition — Estimateur et estimation
Soit \(g : \Theta \to \mathbb{R}\). Un estimateur de \(g(\theta)\) est une variable aléatoire \(T_n = \varphi(X_1, \dots, X_n)\), où \((X_1, \dots, X_n)\) est un \(n\)-échantillon et \(\varphi\) ne dépend pas de \(\theta\). Une estimation est une réalisation \(t_n = \varphi(x_1, \dots, x_n)\) sur un échantillon observé. (Un estimateur est une variable aléatoire ; une estimation est un nombre.) Définition — Moyenne empirique
La moyenne empirique est l'estimateur \(\overline{X_n} = \dfrac{X_1 + \dots + X_n}{n}\), l'estimateur le plus naturel de l'espérance de la loi mère. Exemple
Pour un échantillon de Bernoulli \(\mathcal{B}(\theta)\), \(\overline{X_n}\) estime \(\theta\) (l'espérance de la loi mère). Sur l'échantillon observé \(1, 0, 0, 1, 0\) (\(n = 5\)), l'estimation est \(\overline{x_5} = \tfrac15(1 + 0 + 0 + 1 + 0) = \tfrac25\). Exemple
Pour un échantillon exponentiel \(\mathcal{E}(\theta)\), \(E(X) = \tfrac1\theta\), donc \(\overline{X_n}\) estime \(g(\theta) = \tfrac1\theta\) (il est plus facile d'estimer \(\tfrac1\theta\) que \(\theta\) directement). Pour un échantillon uniforme \(\mathcal{U}([0, \theta])\), \(E(X) = \tfrac\theta2\), donc \(T_n = 2\overline{X_n}\) estime \(\theta\) ; \(\max(X_1, \dots, X_n)\) est un autre estimateur de \(\theta\). Méthode — Construire un estimateur à partir d'un échantillon
Pour estimer \(g(\theta)\), le relier à une quantité de l'échantillon d'espérance \(g(\theta)\) : le plus souvent, exprimer \(g(\theta)\) à l'aide de l'espérance \(E_\theta(X)\) et utiliser la moyenne empirique (ou un multiple), formant \(T_n = \varphi(X_1, \dots, X_n)\) sans utiliser \(\theta\). Compétences à pratiquer
- Construire des estimateurs et calculer des estimations
II
Estimateurs sans biais et leur comparaison
II.1
Estimateurs sans biais
Un estimateur est sans biais lorsqu'il est juste en moyenne : aucune erreur systématique. Le biais est l'écart entre l'estimation moyenne et la cible.
Définition — Estimateur sans biais
Un estimateur \(T_n\) de \(g(\theta)\) (admettant une espérance sous chaque \(P_\theta\)) est sans biais lorsque $$ \forall \theta \in \Theta, \qquad E_\theta(T_n) = g(\theta). $$ Sinon il est biaisé. Une suite \((T_n)\) d'estimateurs est asymptotiquement sans biais lorsque \(E_\theta(T_n) \to g(\theta)\) quand \(n \to +\infty\), pour tout \(\theta\). Exemple
L'estimateur constant \(B_n = 0\) a \(E_\theta(B_n) = 0\) pour tout \(\theta\) : il est sans biais pour \(g(\theta) = 0\), mais biaisé pour tout \(g\) avec \(g(\theta) \ne 0\) (par exemple pour l'espérance \(m \ne 0\), son biais est \(-m\)). Être sans biais est donc relatif à la cible \(g(\theta)\). Proposition — La moyenne empirique est sans biais
Pour un échantillon dont la loi mère admet une espérance finie \(m\), \(E(\overline{X_n}) = m\) : la moyenne empirique est un estimateur sans biais de \(m\).
Par linéarité de l'espérance, \(E(\overline{X_n}) = \dfrac1n \sum_{k=1}^n E(X_k) = \dfrac1n \cdot n m = m\) (chaque \(X_k\) a l'espérance \(m\) de la loi mère).
Exemple
\(A_n = \dfrac{2}{n(n+1)} \sum_{k=1}^n k X_k\) est-il un estimateur sans biais de \(m\) ?
Par linéarité, $$ \begin{aligned} E(A_n) &= \frac{2}{n(n+1)} \sum_{k=1}^n k\, E(X_k) && \text{(linéarité)} \\
&= \frac{2}{n(n+1)}\, m \sum_{k=1}^n k && \text{(}E(X_k) = m\text{)} \\
&= \frac{2}{n(n+1)}\, m \cdot \frac{n(n+1)}{2} = m && \text{(}\textstyle\sum_{k=1}^n k = \tfrac{n(n+1)}{2}\text{)}. \end{aligned} $$ Donc \(A_n\) est sans biais pour \(m\).
Proposition — La variance empirique est sans biais
Pour une loi mère admettant une variance finie \(\sigma^2\) et \(n \ge 2\), la variance empirique $$ S_n'^2 = \frac{1}{n - 1} \sum_{k=1}^n (X_k - \overline{X_n})^2 $$ est un estimateur sans biais de \(\sigma^2\).
Comme \(\sum_k X_k = n\overline{X_n}\), le développement donne \(\sum_{k=1}^n (X_k - \overline{X_n})^2 = \sum_{k=1}^n X_k^2 - n\,\overline{X_n}^2\). En prenant les espérances avec \(E(X_k^2) = \sigma^2 + m^2\) et \(E(\overline{X_n}^2) = V(\overline{X_n}) + m^2 = \dfrac{\sigma^2}{n} + m^2\) : $$ \begin{aligned} E\Bigl( \sum_{k=1}^n (X_k - \overline{X_n})^2 \Bigr) &= \sum_{k=1}^n E(X_k^2) - n\, E(\overline{X_n}^2) = n(\sigma^2 + m^2) - n\Bigl( \tfrac{\sigma^2}{n} + m^2 \Bigr) \\
&= n\sigma^2 + nm^2 - \sigma^2 - nm^2 = (n - 1)\sigma^2. \end{aligned} $$ En divisant par \(n - 1\), \(E(S_n'^2) = \sigma^2\).
La convention \(\tfrac1n\) contre \(\tfrac{1}{n-1}\)
La preuve montre que \(\frac1n \sum_k (X_k - \overline{X_n})^2\) a pour espérance \(\frac{n-1}{n}\sigma^2 \ne \sigma^2\) : elle est biaisée. Le facteur \(\frac{1}{n-1}\) corrige exactement ce biais, c'est pourquoi la variance empirique inférentielle utilise \(\frac{1}{n-1}\) (la version \(\frac1n\) est la variance descriptive usuelle d'une série de données, biaisée ici comme estimateur de \(\sigma^2\)).
Compétences à pratiquer
- Montrer qu'un estimateur est sans biais
II.2
Comparer des estimateurs sans biais
Lorsque plusieurs estimateurs sans biais d'un même \(g(\theta)\) sont disponibles, le plus fiable est le moins dispersé : celui dont les estimations se regroupent le plus autour de \(g(\theta)\) — c'est-à-dire celui de plus petite variance.
Définition — Un meilleur estimateur sans biais
Soient \(T_n\) et \(U_n\) deux estimateurs sans biais de \(g(\theta)\) (admettant des variances). On dit que \(T_n\) est un meilleur estimateur de \(g(\theta)\) que \(U_n\) lorsque $$ \forall \theta \in \Theta, \qquad V_\theta(T_n) \le V_\theta(U_n) $$ (strictement meilleur si de plus l'inégalité est stricte pour au moins un \(\theta\)). Méthode — Comparer deux estimateurs sans biais
Vérifier que les deux sont sans biais (\(E_\theta = g(\theta)\)), puis calculer et comparer leurs variances \(V_\theta(T_n)\) et \(V_\theta(U_n)\) ; celui de plus petite variance pour tout \(\theta\) est le meilleur estimateur. Exemple
Pour un échantillon de Bernoulli \(\mathcal{B}(\theta)\), comparer les estimateurs sans biais \(\overline{X_n}\) et \(A_n = \dfrac{2}{n(n+1)} \sum_{k=1}^n k X_k\) de \(\theta\).
Les deux sont sans biais (ci-dessus). Par indépendance, \(V_\theta(\overline{X_n}) = \dfrac{\theta(1 - \theta)}{n}\), tandis que $$ \begin{aligned} V_\theta(A_n) &= \frac{4}{n^2(n+1)^2} \sum_{k=1}^n k^2\, V_\theta(X_k) && \text{(indépendance ; mise à l'échelle)} \\
&= \frac{4\,\theta(1-\theta)}{n^2(n+1)^2} \sum_{k=1}^n k^2 && \text{(}V_\theta(X_k) = \theta(1-\theta)\text{)} \\
&= \frac{4\,\theta(1-\theta)}{n^2(n+1)^2} \cdot \frac{n(n+1)(2n+1)}{6} && \text{(}\textstyle\sum k^2 = \tfrac{n(n+1)(2n+1)}{6}\text{)} \\
&= \frac{2(2n+1)}{3n(n+1)}\,\theta(1-\theta). \end{aligned} $$ Pour \(0 < \theta < 1\) le rapport \(\dfrac{V_\theta(A_n)}{V_\theta(\overline{X_n})} = \dfrac{2(2n+1)}{3(n+1)} \ge 1\) (égal en \(n = 1\), strictement plus grand pour \(n \ge 2\)) ; en \(\theta \in \{0, 1\}\) les deux variances s'annulent. Donc \(\overline{X_n}\) a une variance au plus égale à celle de \(A_n\) (strictement plus petite pour \(n \ge 2\) et \(0 < \theta < 1\)) : c'est un meilleur estimateur de \(\theta\) que \(A_n\).
La variance d'un estimateur sans biais mesure la dispersion de ses estimations autour de \(g(\theta)\). Comparer deux estimateurs sans biais par leur variance est le seul critère de comparaison utilisé ici ; le risque quadratique — qui serait nécessaire pour comparer des estimateurs biaisés — dépasse ce cours.
Compétences à pratiquer
- Comparer des estimateurs sans biais
III
Suites d'estimateurs et convergence
III.1
Estimateurs convergents
Un seul estimateur ne suffit pas : on veut une suite \((T_n)\) qui se fixe sur \(g(\theta)\) lorsque la taille de l'échantillon grandit. C'est la convergence en probabilité, appliquée à l'estimation.
Définition — Estimateur convergent
Une suite \((T_n)\) d'estimateurs de \(g(\theta)\) est convergente lorsque \(T_n \xrightarrow{P} g(\theta)\) pour tout \(\theta \in \Theta\), c'est-à-dire $$ \forall \theta \in \Theta,\ \forall \varepsilon > 0, \qquad P_\theta\bigl( |T_n - g(\theta)| \ge \varepsilon \bigr) \xrightarrow[n \to +\infty]{} 0. $$ Exemple
Un estimateur constant \(T_n = c\) ignore l'échantillon : il converge en probabilité vers \(c\), donc c'est un estimateur convergent de \(g(\theta)\) seulement lorsque \(g(\theta) = c\) pour tout \(\theta\) — pratiquement jamais. La convergence exige que l'estimateur s'adapte aux données quand \(n\) grandit. Proposition — La moyenne empirique est convergente
Pour un échantillon dont la loi mère admet une espérance \(m\) et une variance, \((\overline{X_n})\) est un estimateur convergent de \(m\).
C'est exactement la loi faible des grands nombres (chapitre des convergences) : \(\overline{X_n} \xrightarrow{P} m\).
Proposition — Composition
Rappel (chapitre des convergences). Si \((T_n)\) est un estimateur convergent de \(g(\theta)\) et \(f\) est continue en \(g(\theta)\), alors \((f(T_n))\) est un estimateur convergent de \(f(g(\theta))\). Exemple
Pour un échantillon exponentiel \(\mathcal{E}(\theta)\), \(\overline{X_n} \xrightarrow{P} \tfrac1\theta\), donc \((\overline{X_n})\) est un estimateur convergent de \(\tfrac1\theta\). Ici \(\overline{X_n} > 0\) presque sûrement, donc \(\tfrac{1}{\overline{X_n}}\) est bien défini ; l'application \(t \mapsto \tfrac1t\) est continue en \(\tfrac1\theta > 0\), donc par composition \(\dfrac{1}{\overline{X_n}} \xrightarrow{P} \theta\) : \(\bigl( \tfrac{1}{\overline{X_n}} \bigr)\) est un estimateur convergent de \(\theta\). Compétences à pratiquer
- Montrer qu'un estimateur est convergent
III.2
La condition suffisante de convergence
Un unique critère, très commode, tranche la convergence sans calculer de probabilités : si un estimateur est asymptotiquement sans biais et que sa variance s'annule, il est convergent.
Théorème — Condition suffisante de convergence
Soit \((T_n)\) une suite d'estimateurs de \(g(\theta)\), chacun admettant une variance finie sous \(P_\theta\) (pour \(n\) grand). Si, pour tout \(\theta \in \Theta\), $$ E_\theta(T_n) \xrightarrow[n \to +\infty]{} g(\theta) \qquad \text{et} \qquad V_\theta(T_n) \xrightarrow[n \to +\infty]{} 0, $$ alors \((T_n)\) est un estimateur convergent de \(g(\theta)\).
Fixons \(\theta\) et \(\varepsilon > 0\). Pour \(n\) assez grand, \(|E_\theta(T_n) - g(\theta)| < \tfrac\varepsilon2\), donc \(\{|T_n - g(\theta)| \ge \varepsilon\} \subseteq \{|T_n - E_\theta(T_n)| \ge \tfrac\varepsilon2\}\). Par Bienaymé-Tchebychev sous \(P_\theta\), $$ P_\theta\bigl( |T_n - g(\theta)| \ge \varepsilon \bigr) \le P_\theta\bigl( |T_n - E_\theta(T_n)| \ge \tfrac\varepsilon2 \bigr) \le \frac{4\, V_\theta(T_n)}{\varepsilon^2} \xrightarrow[n \to +\infty]{} 0, $$ donc \(T_n \xrightarrow{P} g(\theta)\).
Méthode — Montrer qu'un estimateur est convergent
Calculer \(E_\theta(T_n)\) et \(V_\theta(T_n)\) ; si \(E_\theta(T_n) \to g(\theta)\) et \(V_\theta(T_n) \to 0\), conclure la convergence. En particulier, un estimateur sans biais dont la variance tend vers \(0\) est automatiquement convergent. Exemple
La moyenne empirique vérifie \(E(\overline{X_n}) = m\) (sans biais) et \(V(\overline{X_n}) = \tfrac{\sigma^2}{n} \to 0\), donc le critère donne directement que \((\overline{X_n})\) est convergente — on retrouve la conclusion de la loi des grands nombres. L'estimateur \(T_n = \overline{X_n} + \tfrac1n\) est biaisé (\(E = m + \tfrac1n\)) mais asymptotiquement sans biais, avec \(V_\theta(T_n) = \tfrac{\sigma^2}{n} \to 0\) : il est convergent lui aussi. Méthode — Python — TP Thème 4 — comparer des estimateurs
Pour comparer deux estimateurs d'un même paramètre, simuler de nombreux échantillons, calculer chaque estimateur sur chaque échantillon, et superposer les histogrammes des estimations : parmi des estimateurs sans biais (histogrammes centrés sur \(g(\theta)\)), le moins dispersé est le meilleur estimateur. \begin{verbatim} import numpy as np import matplotlib.pyplot as plt theta, n, N = 0.4, 60, 1000 # vrai parametre, taille, repetitions E = np.random.binomial(1, theta, size=(N, n)) # N echantillons de Bernoulli mean_est = E.mean(axis=1) # moyenne empirique k = np.arange(1, n + 1) A_est = (2 / (n * (n + 1))) * (E * k).sum(axis=1) # l'estimateur A_n plt.hist(mean_est, bins=30, density=True, alpha=0.5) plt.hist(A_est, bins=30, density=True, alpha=0.5) plt.axvline(theta) # la vraie valeur plt.show() \end{verbatim}
La figure superpose les histogrammes d'estimations de deux estimateurs sans biais centrés sur la vraie valeur \(g(\theta)\) : les deux sont centrés (sans biais), mais le plus étroit (plus petite variance) est le meilleur estimateur. 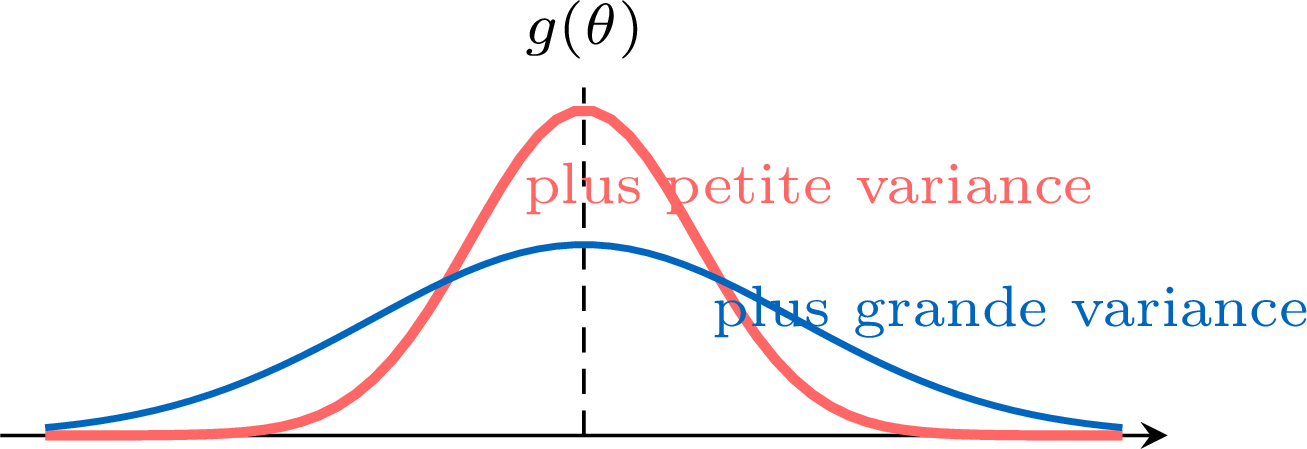
Pour aller plus loin
Un estimateur convergent et de plus asymptotiquement normal — comme la moyenne empirique, par le théorème central limite — est exactement ce que le prochain chapitre transforme en intervalle de confiance : un intervalle aléatoire, calculé sur l'échantillon, qui contient le \(g(\theta)\) inconnu avec une probabilité prescrite. Les notions de qualité construites ici (absence de biais, convergence, petite variance) sont ce qui rend un tel intervalle fiable.
Compétences à pratiquer
- Utiliser la condition suffisante de convergence
IV
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section