Éducation Nationale Française · ECGapprofondies 2
Vecteurs aléatoires
Plusieurs grandeurs aléatoires observées ensemble — la taille et le poids d'une personne, les rendements de plusieurs actifs — forment un vecteur aléatoire \((X_1, \dots, X_n)\). Sa loi (la fonction de répartition multivariée) précise les lois marginales individuelles ; la notion simplificatrice clé est l'indépendance mutuelle, sous laquelle tout se factorise. Pour un couple on mesure comment deux variables varient ensemble par la covariance et le coefficient de corrélation linéaire, obtenant la variance d'une somme. Enfin on additionne des variables indépendantes : leurs espérances et variances s'ajoutent, les lois usuelles sont stables par de telles sommes (une somme de normales indépendantes est normale, de gamma à un paramètre est gamma, de Poisson est Poisson, de binomiales de même probabilité de succès est binomiale), et pour les densités la densité de la somme est le produit de convolution des deux. Conventions : \((\Omega, \mathcal{A}, P)\) est un espace probabilisé ; toutes les variables sont réelles ; covariance et corrélation s'emploient pour des variables admettant un moment d'ordre \(2\) (nos exemples sont discrets, la covariance d'un couple de variables à densité dépassant ce cours).
I
Vecteurs aléatoires et indépendance
I.1
Vecteurs aléatoires et lois marginales
Un vecteur aléatoire regroupe plusieurs variables en un seul objet. Sa loi enregistre toutes les probabilités conjointes ; on en lit la loi de chaque variable — les marginales — mais, fait essentiel, les marginales seules ne reconstituent pas la loi conjointe.
Définition — Vecteur aléatoire et sa loi
Un vecteur aléatoire sur \((\Omega, \mathcal{A}, P)\) est un \(n\)-uplet \((X_1, \dots, X_n)\) de variables aléatoires réelles. Sa loi est déterminée par la fonction de répartition multivariée $$ F_{(X_1,\dots,X_n)}(x_1,\dots,x_n) = P\!\left(\bigcap_{i=1}^n [X_i \le x_i]\right). $$ Définition — Loi marginale
Soit \((X_1, \dots, X_n)\) un vecteur aléatoire. Sa \(i\)-ème loi marginale est la loi de la seule variable \(X_i\). Proposition — Marginales d'un vecteur discret
Soit \((X_1, \dots, X_n)\) un vecteur aléatoire discret (tous les \(X_i\) discrets). Sa loi est donnée par les valeurs de \(X_1(\Omega) \times \cdots \times X_n(\Omega)\) (certains \(n\)-uplets peuvent être de probabilité \(0\)) et les probabilités \(P\!\left(\bigcap_j [X_j = x_j]\right)\). La \(i\)-ème marginale se retrouve par $$ P(X_i = x_i) = \sum_{(x_j)_{j \ne i}} P\!\left(\bigcap_{j=1}^n [X_j = x_j]\right). $$
Les événements \(\bigcap_{j \ne i} [X_j = x_j]\), lorsque \((x_j)_{j \ne i}\) parcourt \(\prod_{j \ne i} X_j(\Omega)\), forment un système complet d'événements. Par la formule des probabilités totales (rappelée des chapitres précédents) appliquée à \([X_i = x_i]\), $$ P(X_i = x_i) = \sum_{(x_j)_{j \ne i}} P\!\left([X_i = x_i] \cap \bigcap_{j \ne i} [X_j = x_j]\right) = \sum_{(x_j)_{j \ne i}} P\!\left(\bigcap_{j=1}^n [X_j = x_j]\right). $$
Exemple
Un couple \((X, Y)\) a le tableau conjoint ci-dessous (\(X \in \{0,1\}\), \(Y \in \{0,1\}\)). Déterminer les deux lois marginales. 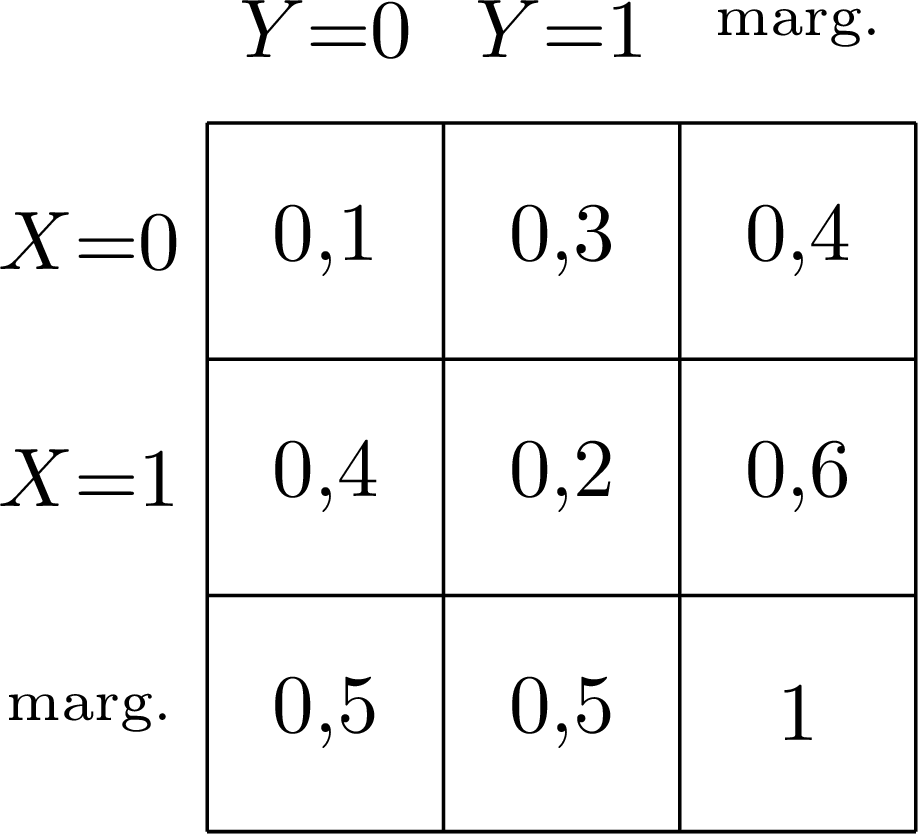
La somme de chaque ligne donne la loi de \(X\) : \(P(X = 0) = 0{,}1 + 0{,}3 = 0{,}4\), \(P(X = 1) = 0{,}6\). La somme de chaque colonne donne la loi de \(Y\) : \(P(Y = 0) = 0{,}1 + 0{,}4 = 0{,}5\), \(P(Y = 1) = 0{,}5\).
Les marginales ne déterminent pas la loi conjointe
La loi du vecteur donne les marginales, mais pas l'inverse : deux vecteurs aléatoires peuvent avoir les mêmes marginales et des lois conjointes différentes (la loi conjointe encode aussi la façon dont les variables sont liées).
Proposition — Même loi et fonction continue
Si les vecteurs \((X_1, \dots, X_n)\) et \((Y_1, \dots, Y_n)\) ont la même loi et \(g : \mathbb{R}^n \to \mathbb{R}\) est continue, alors \(g(X_1, \dots, X_n)\) et \(g(Y_1, \dots, Y_n)\) ont la même loi.
Énoncé admis par le programme.
Méthode — Lire les marginales sur un tableau conjoint
Pour un couple discret donné par un tableau conjoint, la loi de \(X\) s'obtient en sommant chaque ligne, la loi de \(Y\) en sommant chaque colonne (les totaux de lignes et de colonnes sont les marginales). Compétences à pratiquer
- Lire la loi d'un vecteur aléatoire
I.2
Indépendance mutuelle
L'indépendance est l'hypothèse sous laquelle un vecteur aléatoire n'est pas plus difficile que ses variables séparées : toute probabilité conjointe se factorise en produit des marginales. On étend la notion des événements aux variables.
Définition — Indépendance mutuelle
Les variables \(X_1, \dots, X_n\) sont mutuellement indépendantes lorsque $$ \forall (x_1, \dots, x_n) \in \mathbb{R}^n, \quad P\!\left(\bigcap_{i=1}^n [X_i \le x_i]\right) = \prod_{i=1}^n P(X_i \le x_i). $$ Proposition — Caractérisations de l'indépendance mutuelle
\(X_1, \dots, X_n\) sont mutuellement indépendantes si et seulement si, pour tous intervalles \(I_1, \dots, I_n\) de \(\mathbb{R}\), $$ P\!\left(\bigcap_{i=1}^n [X_i \in I_i]\right) = \prod_{i=1}^n P(X_i \in I_i). $$ Si les variables sont discrètes, ceci équivaut à : pour tout \((x_1, \dots, x_n) \in X_1(\Omega) \times \cdots \times X_n(\Omega)\), \(P\!\left(\bigcap_i [X_i = x_i]\right) = \prod_i P(X_i = x_i)\).
Énoncé admis par le programme.
Proposition — Lemme des coalitions
Soient \(X_1, \dots, X_n\) mutuellement indépendantes et \(p \in \{1, \dots, n-1\}\). Alors toute fonction de \(X_1, \dots, X_p\) est indépendante de toute fonction de \(X_{p+1}, \dots, X_n\). Plus généralement, pour des fonctions \(f_1, \dots, f_n\) (telles que les \(f_i(X_i)\) soient des variables aléatoires — aucune difficulté de mesurabilité n'est soulevée à ce niveau), les variables \(f_1(X_1), \dots, f_n(X_n)\) sont mutuellement indépendantes (en particulier des indicatrices, servant à déduire l'indépendance d'événements).
Énoncé admis par le programme.
Mutuelle contre deux à deux
L'indépendance mutuelle implique l'indépendance deux à deux, mais la réciproque est fausse. Pour \(n > 2\) on n'étudie que le cas mutuellement indépendant (les vecteurs à composantes non indépendantes au-delà d'un couple dépassent ce cours).
Exemple
Les deux faces de deux dés lancés sont des variables indépendantes : \(P(X = i, Y = j) = \tfrac{1}{36} = \tfrac16 \cdot \tfrac16 = P(X = i)P(Y = j)\). Pour deux événements \(A, B\), les indicatrices \(\mathbf{1}_A\) et \(\mathbf{1}_B\) sont indépendantes si et seulement si \(A\) et \(B\) le sont. Méthode — Utiliser l'indépendance mutuelle
Pour exploiter l'indépendance : factoriser une probabilité conjointe \(P(\bigcap [X_i \in I_i])\) en \(\prod P(X_i \in I_i)\) ; factoriser une espérance d'un produit (section suivante) ; ou, pour construire de nouvelles variables indépendantes, appliquer le lemme des coalitions à des fonctions de blocs disjoints des \(X_i\). Compétences à pratiquer
- Utiliser l'indépendance mutuelle
II
Le couple : covariance et corrélation
II.1
Covariance et variance d'une somme
Pour un couple de variables admettant un moment d'ordre \(2\), la covariance mesure si elles tendent à varier dans le même sens. C'est la compagne hors-diagonale de la variance, et elle donne la variance d'une somme. On la travaille de façon discrète ; la covariance d'un couple de variables à densité dépasse ce cours.
Définition — Covariance
Soient \(X, Y\) admettant un moment d'ordre \(2\). Leur covariance est $$ \operatorname{Cov}(X, Y) = E\bigl((X - E(X))(Y - E(Y))\bigr). $$ Proposition — Forme de Koenig de la covariance
\(\operatorname{Cov}(X, Y) = E(XY) - E(X)E(Y)\).
En développant le produit et par linéarité de l'espérance, $$ \begin{aligned} \operatorname{Cov}(X, Y) &= E\bigl(XY - E(X)Y - E(Y)X + E(X)E(Y)\bigr) && \text{(développement)} \\
&= E(XY) - E(X)E(Y) - E(Y)E(X) + E(X)E(Y) && \text{(linéarité)} \\
&= E(XY) - E(X)E(Y). && \end{aligned} $$
Proposition — Propriétés de la covariance
La covariance est symétrique et bilinéaire, \(\operatorname{Cov}(X, X) = V(X) \ge 0\), et $$ \operatorname{Cov}(X, Y)^2 \le V(X)\, V(Y). $$
La symétrie et la bilinéarité découlent de la forme de Koenig et de la linéarité de l'espérance ; \(\operatorname{Cov}(X, X) = E((X - E(X))^2) = V(X) \ge 0\). Pour l'inégalité, on pose \(U = X - E(X)\), \(V_0 = Y - E(Y)\), donc \(\operatorname{Cov}(X, Y) = E(U V_0)\), \(V(X) = E(U^2)\), \(V(Y) = E(V_0^2)\). Si \(E(V_0^2) = 0\) les deux membres sont nuls ; sinon, pour tout \(t \in \mathbb{R}\), $$ E\bigl((U + t V_0)^2\bigr) = E(V_0^2)\, t^2 + 2 E(U V_0)\, t + E(U^2) \ge 0 $$ (espérance d'un carré). Ce trinôme en \(t\) étant positif ou nul pour tout \(t\), son discriminant est \(\le 0\) : $$ 4\,E(U V_0)^2 - 4\,E(U^2)E(V_0^2) \le 0, \quad\text{soit}\quad \operatorname{Cov}(X, Y)^2 \le V(X)\, V(Y). $$
Théorème — Variance d'une somme
Pour \(X, Y\) admettant un moment d'ordre \(2\), $$ V(X + Y) = V(X) + V(Y) + 2\operatorname{Cov}(X, Y). $$
En utilisant \(V(Z) = \operatorname{Cov}(Z, Z)\) et la bilinéarité de la covariance, $$ \begin{aligned} V(X + Y) &= \operatorname{Cov}(X + Y, X + Y) && \\
&= \operatorname{Cov}(X, X) + 2\operatorname{Cov}(X, Y) + \operatorname{Cov}(Y, Y) && \text{(bilinéarité, symétrie)} \\
&= V(X) + V(Y) + 2\operatorname{Cov}(X, Y). && \end{aligned} $$
Proposition — Indépendantes implique covariance nulle
Si \(X\) et \(Y\) sont indépendantes et admettent un moment d'ordre \(2\), alors \(E(XY) = E(X)E(Y)\), donc \(\operatorname{Cov}(X, Y) = 0\) et \(V(X + Y) = V(X) + V(Y)\).
Pour \(X, Y\) indépendantes, \(E(XY) = E(X)E(Y)\) (admis par le programme). Donc \(\operatorname{Cov}(X, Y) = E(XY) - E(X)E(Y) = 0\), et le théorème de la variance d'une somme donne \(V(X + Y) = V(X) + V(Y)\).
La réciproque est fausse
Une covariance nulle n'implique PAS l'indépendance. Prenons \(X\) uniforme sur \(\{-1, 0, 1\}\) et \(Y = X^2\). Alors \(E(X) = 0\) et \(\operatorname{Cov}(X, Y) = E(X^3) - E(X)E(X^2) = 0 - 0 = 0\), pourtant \(X\) et \(Y\) sont dépendantes (en effet \(Y = 0\) si et seulement si \(X = 0\)). La covariance ne détecte que l'association linéaire.
Exemple
Pour le couple \((X, Y)\) du tableau conjoint de la §1 (rappel \(P(X{=}1, Y{=}1) = 0{,}2\), de marginales \(P(X{=}1) = 0{,}6\), \(P(Y{=}1) = 0{,}5\)), calculer \(\operatorname{Cov}(X, Y)\) et \(V(X + Y)\).
D'après les marginales, \(E(X) = 0{,}6\), \(E(Y) = 0{,}5\), \(E(X^2) = 0{,}6\), \(E(Y^2) = 0{,}5\), donc \(V(X) = 0{,}6 - 0{,}36 = 0{,}24\), \(V(Y) = 0{,}5 - 0{,}25 = 0{,}25\). Or \(E(XY) = 1\cdot1\cdot P(X{=}1, Y{=}1) = 0{,}2\), donc \(\operatorname{Cov}(X, Y) = 0{,}2 - 0{,}6\cdot0{,}5 = -0{,}1\). Ainsi $$ V(X + Y) = V(X) + V(Y) + 2\operatorname{Cov}(X, Y) = 0{,}24 + 0{,}25 - 0{,}2 = 0{,}29. $$
Exemple
Si \(X, Y\) sont indépendantes avec \(V(X) = 4\) et \(V(Y) = 9\), alors \(\operatorname{Cov}(X, Y) = 0\), donc \(V(X + Y) = 4 + 9 = 13\) et de même \(V(X - Y) = V(X) + V(-Y) = 4 + 9 = 13\) (le signe de \(Y\) ne change pas sa variance). Méthode — Calculer une covariance
On utilise la forme de Koenig \(\operatorname{Cov}(X, Y) = E(XY) - E(X)E(Y)\), avec (pour un couple discret) \(E(XY) = \sum_{i, j} x_i y_j\, P(X = x_i, Y = y_j)\). Puis \(V(X+Y) = V(X) + V(Y) + 2\operatorname{Cov}(X, Y)\). Compétences à pratiquer
- Calculer une covariance et une variance de somme
II.2
Le coefficient de corrélation linéaire
La covariance porte les unités de \(X\) fois celles de \(Y\) ; en divisant par les écarts-types on obtient un nombre sans dimension dans \([-1, 1]\) — le coefficient de corrélation — mesurant la force de l'association linéaire.
Définition — Coefficient de corrélation linéaire
Soient \(X, Y\) admettant un moment d'ordre \(2\) avec \(V(X), V(Y) > 0\). Leur coefficient de corrélation linéaire est $$ \rho(X, Y) = \frac{\operatorname{Cov}(X, Y)}{\sigma(X)\, \sigma(Y)}. $$ Proposition — Borne et cas d'égalité
Avec \(V(X), V(Y) > 0\), \(|\rho(X, Y)| \le 1\). De plus \(|\rho(X, Y)| = 1\) si et seulement s'il existe \(a \ne 0\) et \(b\) tels que \(Y = aX + b\) presque sûrement ; alors \(a > 0\) lorsque \(\rho = 1\) et \(a < 0\) lorsque \(\rho = -1\).
L'inégalité de covariance \(\operatorname{Cov}(X, Y)^2 \le V(X)V(Y)\) donne, en divisant par \(\sigma(X)^2\sigma(Y)^2 > 0\), \(\rho(X, Y)^2 \le 1\), soit \(|\rho| \le 1\). L'égalité a lieu exactement dans le cas d'égalité de Cauchy–Schwarz pour les variables centrées \(U = X - E(X)\) et \(V_0 = Y - E(Y)\), c'est-à-dire lorsque \(V_0 = a U\) presque sûrement pour un scalaire \(a \ne 0\), soit \(Y - E(Y) = a(X - E(X))\), donc \(Y = aX + b\) presque sûrement avec \(b = E(Y) - aE(X)\). Le signe de \(\rho\) est celui de \(a\) car \(\operatorname{Cov}(X, Y) = a\, V(X)\).
Lire la corrélation
\(\rho > 0\) signale une association linéaire positive, \(\rho < 0\) une association linéaire négative, \(\rho = 0\) que \(X, Y\) sont non corrélées (mais PAS nécessairement indépendantes). \(\rho\) ne mesure que la part linéaire de la dépendance.
Exemple
Pour le couple du tableau conjoint de la §1, \(\operatorname{Cov}(X, Y) = -0{,}1\), \(\sigma(X) = \sqrt{0{,}24}\), \(\sigma(Y) = \sqrt{0{,}25} = 0{,}5\), donc $$ \rho(X, Y) = \frac{-0{,}1}{\sqrt{0{,}24}\cdot 0{,}5} = \frac{-0{,}1}{0{,}5\sqrt{0{,}24}} \approx -0{,}41. $$ Une association linéaire négative modérée. Méthode — Calculer le coefficient de corrélation
On calcule \(\operatorname{Cov}(X, Y)\), \(\sigma(X)\), \(\sigma(Y)\), puis \(\rho(X, Y) = \dfrac{\operatorname{Cov}(X, Y)}{\sigma(X)\sigma(Y)}\) ; on vérifie \(|\rho| \le 1\), et on lit son signe comme le sens de l'association linéaire. Compétences à pratiquer
- Calculer le coefficient de corrélation
III
Sommes de variables indépendantes
III.1
Espérance, variance et stabilité des lois usuelles discrètes
Additionner des variables indépendantes est l'opération centrale des probabilités. Les espérances s'ajoutent (dès qu'elles existent), les variances s'ajoutent (si les variables sont indépendantes), et les lois usuelles conservent leur type : une somme de variables indépendantes d'une famille usuelle suit la même famille. On commence par les lois discrètes.
Proposition — Linéarité de l'espérance ; espérance d'un produit
Soient \(X_1, \dots, X_n\) admettant une espérance. Alors \(\sum_i \lambda_i X_i\) admet une espérance et \(E\!\left(\sum_i \lambda_i X_i\right) = \sum_i \lambda_i E(X_i)\). Si de plus \(X_1, \dots, X_n\) sont mutuellement indépendantes, alors \(\prod_i X_i\) admet une espérance et \(E\!\left(\prod_i X_i\right) = \prod_i E(X_i)\).
Les deux sont des récurrences sur \(n\) à partir du cas \(n = 2\) (rappelé de la première année). Pour le produit, au rang \(n+1\) : \(X_1 \cdots X_n\) est indépendante de \(X_{n+1}\) par le lemme des coalitions, donc \(E(X_1 \cdots X_{n+1}) = E(X_1 \cdots X_n)E(X_{n+1}) = E(X_1)\cdots E(X_n) E(X_{n+1})\) par hypothèse de récurrence.
Proposition — Variance d'une somme indépendante
Soient \(X_1, \dots, X_n\) admettant un moment d'ordre \(2\). Si elles sont mutuellement indépendantes, alors \(V\!\left(\sum_i X_i\right) = \sum_i V(X_i)\). En général, $$ V\!\left(\sum_{i=1}^n X_i\right) = \sum_{i=1}^n V(X_i) + 2\sum_{1 \le i < j \le n} \operatorname{Cov}(X_i, X_j). $$
En développant \(V\!\left(\sum_i X_i\right) = \operatorname{Cov}\!\left(\sum_i X_i, \sum_j X_j\right)\) par bilinéarité on obtient \(\sum_i \operatorname{Cov}(X_i, X_i) + \sum_{i \ne j}\operatorname{Cov}(X_i, X_j) = \sum_i V(X_i) + 2\sum_{i < j}\operatorname{Cov}(X_i, X_j)\). Lorsque les \(X_i\) sont mutuellement indépendantes, tous les \(\operatorname{Cov}(X_i, X_j) = 0\) pour \(i \ne j\), laissant \(\sum_i V(X_i)\).
Théorème — Stabilité des lois binomiale et de Poisson
Soient \(X_1, \dots, X_n\) mutuellement indépendantes. - Si \(X_i \sim \mathcal{B}(m_i, p)\) pour tout \(i\), alors \(\sum_i X_i \sim \mathcal{B}\!\left(\sum_i m_i, p\right)\). En particulier \(\mathcal{B}(n, p)\) est la loi d'une somme de \(n\) variables indépendantes \(\mathcal{B}(p)\).
- Si \(X_i \sim \mathcal{P}(\lambda_i)\) pour tout \(i\), alors \(\sum_i X_i \sim \mathcal{P}\!\left(\sum_i \lambda_i\right)\).
Les deux par récurrence sur \(n\) ; on donne le cas Poisson \(n = 2\). Pour \(X \sim \mathcal{P}(\lambda)\), \(Y \sim \mathcal{P}(\mu)\) indépendantes, et \(k \in \mathbb{N}\), la convolution discrète donne $$ \begin{aligned} P(X + Y = k) &= \sum_{j=0}^k P(X = j)P(Y = k - j) && \text{(indépendance)} \\
&= \sum_{j=0}^k e^{-\lambda}\frac{\lambda^j}{j!}\, e^{-\mu}\frac{\mu^{k-j}}{(k-j)!} && \\
&= \frac{e^{-(\lambda+\mu)}}{k!}\sum_{j=0}^k \binom{k}{j}\lambda^j \mu^{k-j} && \text{(}\tfrac{1}{j!(k-j)!} = \tfrac{1}{k!}\binom kj\text{)} \\
&= e^{-(\lambda+\mu)}\frac{(\lambda + \mu)^k}{k!}, && \text{(formule du binôme)} \end{aligned} $$ qui est la loi \(\mathcal{P}(\lambda + \mu)\). Le pas de récurrence utilise le lemme des coalitions. Pour la binomiale, l'argument le plus net est la décomposition en Bernoulli : \(\mathcal{B}(m_i, p)\) est la loi d'une somme de \(m_i\) variables \(\mathcal{B}(p)\) indépendantes (nombre de succès en \(m_i\) épreuves indépendantes de probabilité \(p\)), donc une somme de \(\mathcal{B}(m_i, p)\) indépendantes est une somme de \(\sum_i m_i\) variables \(\mathcal{B}(p)\) indépendantes, soit \(\mathcal{B}(\sum_i m_i, p)\). En particulier \(\mathcal{B}(n, p)\) redonne \(E = np\) et \(V = np(1-p)\).
Méthode — Reconnaître une somme comme une loi usuelle
Pour trouver la loi d'une somme : vérifier que les termes sont indépendants et suivent chacun une loi usuelle de la même famille ; appliquer le théorème de stabilité correspondant pour nommer la loi de la somme et lire son espérance et sa variance. Exemple
Soient \(X \sim \mathcal{P}(2)\) et \(Y \sim \mathcal{P}(3)\) indépendantes. Donner la loi de \(X + Y\) et \(E(X+Y)\), \(V(X+Y)\).
Par stabilité de Poisson, \(X + Y \sim \mathcal{P}(2 + 3) = \mathcal{P}(5)\). Donc \(E(X+Y) = 5\) et \(V(X+Y) = 5\) (espérance et variance de \(\mathcal{P}(5)\)) ; cela coïncide avec \(E(X)+E(Y) = 2+3\) et, par indépendance, \(V(X)+V(Y) = 2+3\).
Exemple
Soient \(X \sim \mathcal{B}(3, p)\) et \(Y \sim \mathcal{B}(2, p)\) indépendantes (même \(p\)). Donner la loi de \(X + Y\).
Par stabilité binomiale (même \(p\)), \(X + Y \sim \mathcal{B}(3 + 2, p) = \mathcal{B}(5, p)\), avec \(E(X+Y) = 5p\) et \(V(X+Y) = 5p(1-p)\).
Compétences à pratiquer
- Reconnaître une somme de lois usuelles
III.2
Sommes à densité, maximum et minimum
Pour les variables à densité la densité de la somme est le produit de convolution des deux densités. Les lois continues usuelles sont stables aussi (une somme de normales indépendantes est normale, de gamma est gamma), et le maximum et le minimum de variables indépendantes se lisent directement sur les fonctions de répartition.
Théorème — Produit de convolution
Soient \(X, Y\) des variables à densité indépendantes de densités \(f, g\). Si l'une de \(f, g\) est bornée, alors \(X + Y\) est à densité, de densité le produit de convolution $$ h(x) = \int_{-\infty}^{+\infty} f(t)\, g(x - t)\,\mathrm{d}t = (f * g)(x). $$
Énoncé admis. Le programme déclare la légitimité du produit de convolution non exigible ; on l'admet et on l'utilise. Toutes les densités continues usuelles sont bornées sauf \(\gamma(\nu)\) avec \(\nu < 1\).
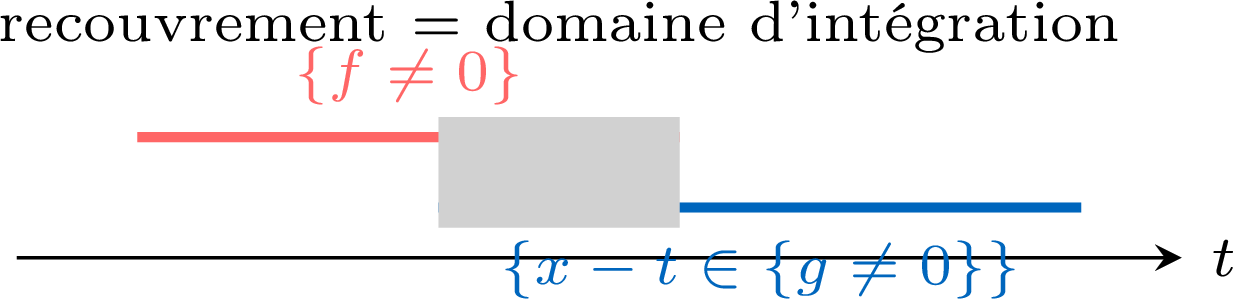
Méthode — Calculer la densité d'une somme : les quatre étapes
- Vérifier \(X, Y\) indépendantes (et une densité bornée) ; écrire \(h(x) = \int_{-\infty}^{+\infty} f(t)g(x-t)\,\mathrm{d}t\).
- Réduire le domaine à l'ensemble où \(f\) est non nulle.
- Imposer que \(x - t\) soit dans l'ensemble où \(g\) est non nulle ; combiné à l'étape 2, cela donne un domaine de \(t\) dont les bornes dépendent de \(x\).
- Calculer \(h(x)\) cas par cas selon \(x\).
Exemple
Soient \(X, Y \sim \mathcal{E}(\lambda)\) indépendantes. Déterminer la densité de \(X + Y\).
La densité \(f(t) = \lambda e^{-\lambda t}\mathbf{1}_{t > 0}\) est bornée. Pour \(x > 0\), l'intégrande est non nul lorsque \(t > 0\) et \(x - t > 0\), soit \(0 < t < x\) : $$ \begin{aligned} h(x) &= \int_0^x \lambda e^{-\lambda t}\, \lambda e^{-\lambda(x - t)}\,\mathrm{d}t && \\
&= \lambda^2 e^{-\lambda x}\int_0^x \mathrm{d}t = \lambda^2 x\, e^{-\lambda x}. && \end{aligned} $$ Pour \(x \le 0\), \(h(x) = 0\). (C'est la loi \(\gamma(2)\) dilatée par \(\lambda\) : \(\lambda(X+Y) \sim \gamma(2)\).)
Théorème — Stabilité des lois gamma et normale
Soient \(X_1, \dots, X_n\) mutuellement indépendantes. - Si \(X_i \sim \gamma(\nu_i)\) pour tout \(i\), alors \(\sum_i X_i \sim \gamma\!\left(\sum_i \nu_i\right)\).
- Si \(X_i \sim \mathcal{N}(m_i, \sigma_i^2)\) pour tout \(i\), alors \(\sum_i X_i \sim \mathcal{N}\!\left(\sum_i m_i, \sum_i \sigma_i^2\right)\).
Gamma, \(n = 2\), \(X \sim \gamma(\nu)\), \(Y \sim \gamma(\nu')\) indépendantes. Par convolution (le théorème de convolution s'applique directement lorsque \(\nu \ge 1\) ou \(\nu' \ge 1\), une densité étant alors bornée ; lorsque \(\nu < 1\) et \(\nu' < 1\) les deux densités sont non bornées et la légitimité est admise), pour \(x > 0\), avec le changement de variable \(t = xv\), $$ \begin{aligned} h(x) &= \int_0^x \frac{t^{\nu-1}e^{-t}}{\Gamma(\nu)}\frac{(x-t)^{\nu'-1}e^{-(x-t)}}{\Gamma(\nu')}\,\mathrm{d}t && \\
&= \frac{x^{\nu+\nu'-1}e^{-x}}{\Gamma(\nu)\Gamma(\nu')}\int_0^1 v^{\nu-1}(1-v)^{\nu'-1}\,\mathrm{d}v. && \end{aligned} $$ C'est \(C\, x^{\nu+\nu'-1}e^{-x}\mathbf{1}_{x>0}\), la forme de la densité \(\gamma(\nu+\nu')\) ; comme \(h\) est d'intégrale \(1\), \(C = 1/\Gamma(\nu+\nu')\), donc \(X + Y \sim \gamma(\nu + \nu')\). Puis récurrence sur \(n\) via le lemme des coalitions. La stabilité normale est admise en général : le cas \(\mathcal{N}(0,1)\) découle d'un calcul de convolution analogue à celui de la loi gamma, et on admet l'extension à des espérances et variances quelconques (la convolution générale étant plus lourde).
Exemple
Soient \(X \sim \mathcal{N}(1, 4)\) et \(Y \sim \mathcal{N}(2, 9)\) indépendantes. Donner la loi de \(X + Y\).
Par stabilité normale, \(X + Y \sim \mathcal{N}(1 + 2, 4 + 9) = \mathcal{N}(3, 13)\) (les espérances et les variances s'ajoutent).
Méthode — Somme de \(n\) exponentielles i.i.d.
Pour \(Y = X_1 + \dots + X_n\) avec \(X_i \sim \mathcal{E}(\lambda)\) i.i.d. : on écrit \(\lambda Y = \sum_i \lambda X_i\) ; chaque \(\lambda X_i \sim \mathcal{E}(1) = \gamma(1)\), et elles sont indépendantes (lemme des coalitions) ; par stabilité gamma \(\lambda Y \sim \gamma(n)\) ; enfin on lit une densité de \(Y\) par la transformée affine \(Y = \tfrac1\lambda(\lambda Y)\). Théorème — Maximum et minimum
Soient \(X_1, \dots, X_n\) mutuellement indépendantes. Alors pour tout \(x \in \mathbb{R}\), $$ F_{\max}(x) = \prod_{i=1}^n F_{X_i}(x), \qquad 1 - F_{\min}(x) = \prod_{i=1}^n \bigl(1 - F_{X_i}(x)\bigr), $$ où \(\max = \max(X_1, \dots, X_n)\) et \(\min = \min(X_1, \dots, X_n)\).
\([\max \le x] = \bigcap_i [X_i \le x]\) (le plus grand est \(\le x\) ssi tous le sont), donc par indépendance \(F_{\max}(x) = \prod_i P(X_i \le x) = \prod_i F_{X_i}(x)\). De même \([\min > x] = \bigcap_i [X_i > x]\), donc \(1 - F_{\min}(x) = P(\min > x) = \prod_i P(X_i > x) = \prod_i(1 - F_{X_i}(x))\).
Exemple
Soient \(X_1, \dots, X_n \sim \mathcal{E}(\lambda)\) i.i.d. Déterminer la loi de \(\min(X_1, \dots, X_n)\).
Pour \(x \ge 0\), \(1 - F_{X_i}(x) = e^{-\lambda x}\), donc \(1 - F_{\min}(x) = \prod_{i=1}^n e^{-\lambda x} = e^{-n\lambda x}\), soit \(F_{\min}(x) = 1 - e^{-n\lambda x}\) pour \(x \ge 0\) (et \(F_{\min}(x) = 0\) pour \(x < 0\)). Donc \(\min(X_1, \dots, X_n) \sim \mathcal{E}(n\lambda)\) (le minimum de \(n\) exponentielles i.i.d. est exponentiel de taux multiplié par \(n\)).
Méthode — Python — TP Thèmes I et III
La covariance et la corrélation empiriques d'un échantillon bivarié se calculent avec numpy.cov et numpy.corrcoef ; les deux renvoient une matrice \(2\times2\), donc la valeur bivariée est le terme hors-diagonale [0,1]. Les échantillons indépendants se simulent avec les générateurs numpy.random du chapitre précédent. \begin{verbatim} import numpy as np import numpy.random as rd n = 10000 X = rd.normal(0, 1, n) Y = X + rd.normal(0, 1, n) # correle avec X print(np.cov(X, Y)[0, 1]) # covariance empirique print(np.corrcoef(X, Y)[0, 1]) # correlation empirique (dans [-1,1]) S = rd.exponential(1, n) + rd.exponential(1, n) # somme de deux E(1) indep \end{verbatim}
Pour aller plus loin
L'addition de variables indépendantes et la stabilité des lois usuelles sont au fondement du chapitre suivant : la loi des grands nombres (la moyenne empirique \(\bar X_n\) se concentre en \(E(X)\)) et le théorème central limite (la somme centrée réduite tend vers \(\mathcal{N}(0,1)\)), et des chapitres d'estimation qui suivent, où des échantillons indépendants sont sommés et moyennés.
Compétences à pratiquer
- Calculer la densité d'une somme et la loi d'un max ou min
IV
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section