Éducation Nationale Française · ECGapprofondies 2
Convergences de variables aléatoires et approximations
Qu'advient-il d'une variable aléatoire \(X_n\) lorsque \(n\) grandit ? Deux notions de convergence y répondent. La convergence en probabilité dit que \(X_n\) est, avec une probabilité écrasante, arbitrairement proche d'une limite \(X\) — le langage dans lequel s'énonce la loi des grands nombres (la moyenne empirique converge vers l'espérance). La convergence en loi compare les lois : la fonction de répartition de \(X_n\) tend vers celle de \(X\). Son grand théorème est le théorème central limite — une somme de nombreuses variables indépendantes de même loi, une fois centrée et réduite, est approximativement normale, quelle que soit la loi commune (pourvu qu'elle ait une variance finie). C'est pourquoi la loi normale est partout, et cela fonde les approximations normales des lois binomiale et de Poisson. Ce chapitre est le pont des probabilités vers les statistiques. Conventions : toutes les variables sont définies sur un même espace probabilisé ; \(X_n \xrightarrow{P} X\) et \(X_n \xrightarrow{\mathcal{L}} X\) désignent la convergence en probabilité et en loi ; \(\overline{X_n} = \frac1n \sum_{k=1}^n X_k\) est la moyenne empirique ; \(\Phi\) est la fonction de répartition de \(\mathcal{N}(0,1)\).
I
Convergence en probabilité
I.1
Inégalités de concentration et convergence en probabilité
Quelle est la probabilité qu'une variable aléatoire s'écarte fortement de sa moyenne ? Deux inégalités, rappelées de la première année, majorent cette probabilité à l'aide de la seule espérance et de la seule variance — et elles sont le moteur des résultats de convergence qui suivent.
Proposition — Inégalité de Markov
Rappel. Soit \(X\) une variable aléatoire positive admettant une espérance. Alors $$ \forall a > 0, \qquad P(X \ge a) \le \frac{E(X)}{a}. $$
Fixons \(a > 0\). La variable \(a\,\mathbf{1}_{X \ge a}\) vérifie \(a\,\mathbf{1}_{X \ge a} \le X\) (sur \(\{X \ge a\}\) elle vaut \(a \le X\) ; ailleurs elle vaut \(0 \le X\), car \(X \ge 0\)). En prenant les espérances et par croissance, $$ a\, P(X \ge a) = E\bigl( a\,\mathbf{1}_{X \ge a} \bigr) \le E(X), $$ et en divisant par \(a > 0\) on obtient l'inégalité.
Proposition — Inégalité de Bienaymé-Tchebychev
Rappel. Soit \(X\) admettant une variance. Alors $$ \forall \varepsilon > 0, \qquad P\bigl( |X - E(X)| \ge \varepsilon \bigr) \le \frac{V(X)}{\varepsilon^2}. $$
On applique l'inégalité de Markov à la variable positive \((X - E(X))^2\), avec le seuil \(\varepsilon^2\) : $$ P\bigl( |X - E(X)| \ge \varepsilon \bigr) = P\bigl( (X - E(X))^2 \ge \varepsilon^2 \bigr) \le \frac{E\bigl( (X - E(X))^2 \bigr)}{\varepsilon^2} = \frac{V(X)}{\varepsilon^2}. $$
Exemple
Pour tout \(X\) admettant une variance et \(\sigma = \sqrt{V(X)} > 0\), \(P\bigl( |X - E(X)| \ge 3\sigma \bigr) \le \dfrac{\sigma^2}{(3\sigma)^2} = \dfrac19\) : au moins \(\tfrac89\) de la masse est à moins de \(3\) écarts-types de la moyenne — une majoration grossière mais indépendante de la loi. Définition — Convergence en probabilité
Une suite \((X_n)\) de variables aléatoires converge en probabilité vers une variable aléatoire \(X\), ce que l'on note \(X_n \xrightarrow{P} X\), lorsque $$ \forall \varepsilon > 0, \qquad \lim_{n \to +\infty} P\bigl( |X_n - X| \ge \varepsilon \bigr) = 0, $$ de façon équivalente \(P\bigl( |X_n - X| < \varepsilon \bigr) \to 1\) pour tout \(\varepsilon > 0\). Exemple
Si \(E(X_n) \to m\) et \(V(X_n) \to 0\), alors \(X_n \xrightarrow{P} m\) (la constante \(m\)). En effet, fixons \(\varepsilon > 0\) ; pour \(n\) assez grand \(|E(X_n) - m| < \varepsilon/2\), et alors \(|X_n - m| \ge \varepsilon\) force \(|X_n - E(X_n)| \ge \varepsilon/2\), donc \(\{|X_n - m| \ge \varepsilon\} \subseteq \{|X_n - E(X_n)| \ge \varepsilon/2\}\) et, par Bienaymé-Tchebychev, \(P(|X_n - m| \ge \varepsilon) \le P(|X_n - E(X_n)| \ge \varepsilon/2) \le \dfrac{4 V(X_n)}{\varepsilon^2} \to 0\). Méthode — Démontrer une convergence en probabilité
Pour montrer \(X_n \xrightarrow{P} X\) : - reconnaître la loi des grands nombres si \(X_n\) est une moyenne empirique ;
- si \(E(X_n) \to m\) et \(V(X_n) \to 0\), conclure \(X_n \xrightarrow{P} m\) par Bienaymé-Tchebychev ;
- sinon, calculer directement \(P(|X_n - X| \ge \varepsilon)\) et passer à la limite.
Compétences à pratiquer
- Majorer des probabilités et prouver une convergence en probabilité
I.2
La loi faible des grands nombres et les opérations
La conséquence phare des inégalités de concentration est la loi des grands nombres : la moyenne empirique de variables indépendantes de même loi converge en probabilité vers leur espérance commune. C'est la forme précise de l'intuition qu'une moyenne « se stabilise ».
Théorème — Loi faible des grands nombres
Rappel (cours de première année), énoncé dans le langage de la convergence en probabilité. Soit \((X_n)\) mutuellement indépendantes, de même espérance \(m\) et de même variance finie \(\sigma^2\). Avec \(\overline{X_n} = \frac1n \sum_{k=1}^n X_k\), $$ \overline{X_n} \xrightarrow{P} m. $$
Par linéarité, \(E(\overline{X_n}) = \frac1n \sum_{k=1}^n E(X_k) = m\). Par l'additivité de la variance sous indépendance (chapitre des vecteurs aléatoires), \(V(\overline{X_n}) = \frac{1}{n^2} \sum_{k=1}^n V(X_k) = \frac{\sigma^2}{n}\) où \(\sigma^2\) est la variance commune. Comme \(V(\overline{X_n}) = \sigma^2/n \to 0\) et \(E(\overline{X_n}) = m\), Bienaymé-Tchebychev donne, pour \(\varepsilon > 0\), $$ P\bigl( |\overline{X_n} - m| \ge \varepsilon \bigr) \le \frac{\sigma^2/n}{\varepsilon^2} = \frac{\sigma^2}{n\varepsilon^2} \xrightarrow[n \to +\infty]{} 0, $$ donc \(\overline{X_n} \xrightarrow{P} m\).
Exemple
Théorème de Bernoulli. Si \((X_n)\) sont i.i.d. \(\mathcal{B}(p)\) (donc \(X_k = 1\) si un événement \(A\) se réalise à l'épreuve \(k\), sinon \(0\)), alors \(m = p\) et la fréquence empirique \(\overline{X_n} = \frac1n \sum_{k=1}^n X_k\) vérifie \(\overline{X_n} \xrightarrow{P} p\) : la fréquence statistique d'un événement converge en probabilité vers sa probabilité — la justification formelle de l'intuition fréquentiste. Proposition — Opérations sur la convergence en probabilité
Soient \(X_n \xrightarrow{P} X\) et \(Y_n \xrightarrow{P} Y\). - Somme : \(X_n + Y_n \xrightarrow{P} X + Y\).
- Produit : \(X_n Y_n \xrightarrow{P} XY\).
- Composée continue (admis) : pour \(f : \mathbb{R} \to \mathbb{R}\) continue, \(f(X_n) \xrightarrow{P} f(X)\).
Somme. Si \(|X_n - X| < \varepsilon/2\) et \(|Y_n - Y| < \varepsilon/2\), alors \(|(X_n + Y_n) - (X + Y)| < \varepsilon\) par l'inégalité triangulaire ; donc l'événement \(\{|(X_n + Y_n) - (X + Y)| \ge \varepsilon\}\) est contenu dans \(\{|X_n - X| \ge \varepsilon/2\} \cup \{|Y_n - Y| \ge \varepsilon/2\}\), de probabilité \(\le P(|X_n - X| \ge \varepsilon/2) + P(|Y_n - Y| \ge \varepsilon/2) \to 0\). L'énoncé sur la composée continue est admis ; le produit en découle alors avec la somme (via \(XY = \tfrac14[(X+Y)^2 - (X-Y)^2]\) et la composée continue \(t \mapsto t^2\)).
Exemple
Si \(\overline{X_n} \xrightarrow{P} m\), alors par la composée continue \(f(t) = t^2\), \(\overline{X_n}^2 \xrightarrow{P} m^2\) ; de même \(e^{\overline{X_n}} \xrightarrow{P} e^m\). Compétences à pratiquer
- Appliquer la loi des grands nombres
II
Convergence en loi
II.1
Définition et critère par la fonction de répartition
La convergence en loi compare les lois de \(X_n\) et \(X\), non les variables elles-mêmes ; elle se lit sur les fonctions de répartition. C'est la bonne notion lorsque la limite est une autre nature de variable (une somme qui devient normale, une loi discrète qui devient continue).
Définition — Convergence en loi
Soient \((X_n)\) de fonctions de répartition \(F_{X_n}\) et \(X\) de fonction de répartition \(F_X\). La suite converge en loi vers \(X\), ce que l'on note \(X_n \xrightarrow{\mathcal{L}} X\), lorsque $$ F_{X_n}(x) \xrightarrow[n \to +\infty]{} F_X(x) \quad \text{en tout point } x \text{ où } F_X \text{ est continue.} $$ (Lorsque \(X\) a une densité, \(F_X\) est continue sur \(\mathbb{R}\), donc la convergence est requise en tout \(x\).)
La loi limite est unique ; la variable limite ne l'est pas
La convergence en loi ne dépend que des lois en jeu. La loi limite est unique, mais la variable limite ne l'est pas : si \(X_n \xrightarrow{\mathcal{L}} X\) et que \(Y\) a la même loi que \(X\), alors aussi \(X_n \xrightarrow{\mathcal{L}} Y\).
Proposition — La convergence en probabilité implique la convergence en loi
Admis. Si \(X_n \xrightarrow{P} X\), alors \(X_n \xrightarrow{\mathcal{L}} X\). La réciproque est fausse : par exemple, si \((X_n)\) sont i.i.d.\ de loi \(\mathcal{N}(0,1)\) et \(X \hookrightarrow \mathcal{N}(0,1)\) indépendante d'elles, alors \(X_n \xrightarrow{\mathcal{L}} X\) (même loi à tout \(n\)) sans que \(X_n\) converge en probabilité vers \(X\) (la différence \(X_n - X\) garde une variance strictement positive fixe). (On utilise souvent l'implication à rebours, de façon heuristique : pour deviner la loi limite d'une suite que l'on sait converger en probabilité.)
La figure montre des fonctions de répartition \(F_{X_n}\) convergeant vers une fonction de répartition limite \(F_X\) : la convergence en loi est exactement la convergence ponctuelle de ces courbes aux points de continuité de la limite. 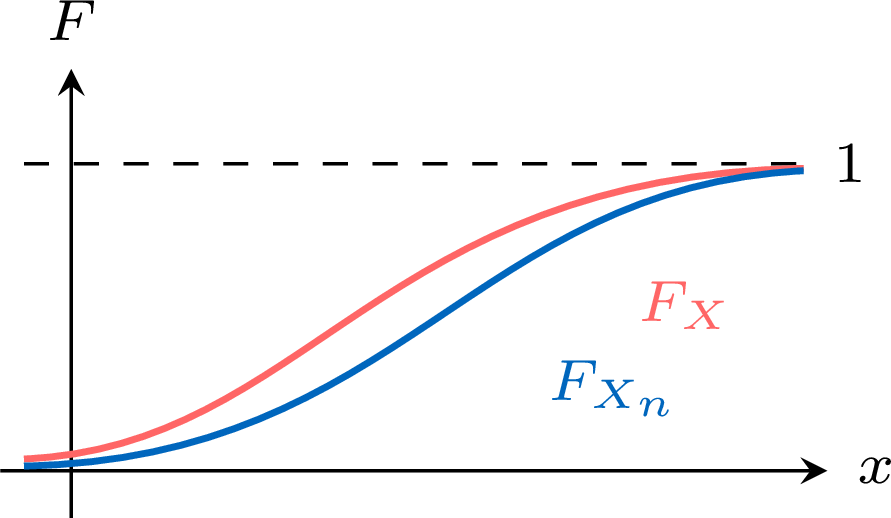
Proposition — Probabilité d'un intervalle
Si \(X_n \xrightarrow{\mathcal{L}} X\), alors pour \(a < b\) points de continuité de \(F_X\), $$ P(a < X_n \le b) \xrightarrow[n \to +\infty]{} P(a < X \le b). $$
\(P(a < X_n \le b) = F_{X_n}(b) - F_{X_n}(a) \to F_X(b) - F_X(a) = P(a < X \le b)\), en utilisant la convergence de \(F_{X_n}\) aux points de continuité \(a\) et \(b\).
Méthode — Montrer une convergence en loi dans le cas général
Pour identifier la loi limite à partir des fonctions de répartition : - calculer la fonction de répartition \(F_{X_n}(x)\) ;
- pour chaque \(x\) fixé, étudier la limite de \(F_{X_n}(x)\) quand \(n \to +\infty\), notée \(F(x)\) ;
- vérifier que \(F\) est une fonction de répartition (limites \(0\) en \(-\infty\) et \(1\) en \(+\infty\), croissante, continue à droite), puis identifier une variable \(X\) telle que \(F_X = F\).
Exemple
Soit \(X_n \hookrightarrow \mathcal{E}(n)\). Alors \(F_{X_n}(x) = 1 - e^{-nx}\) pour \(x \ge 0\) et \(0\) pour \(x < 0\). Pour \(x > 0\), \(F_{X_n}(x) \to 1\) ; pour \(x < 0\), \(F_{X_n}(x) = 0\). Donc \(F_{X_n}(x) \to F(x)\) où \(F(x) = 0\) pour \(x < 0\) et \(1\) pour \(x > 0\) — la fonction de répartition de la constante \(0\) en tout point sauf son saut en \(0\). Comme \(x = 0\) est l'unique discontinuité de la limite, le critère est vérifié : \(X_n \xrightarrow{\mathcal{L}} 0\). Une suite de densités peut donc converger en loi vers une variable discrète (ici constante). Compétences à pratiquer
- Étudier une convergence en loi par la fonction de répartition
II.2
Le cas des variables à valeurs entières
Pour des variables à valeurs dans \(\mathbb{N}\), la convergence en loi prend une forme plus simple : c'est la convergence ponctuelle des probabilités individuelles \(P(X_n = k)\).
Théorème — Convergence en loi de variables à valeurs entières
Supposons que \((X_n)\) et \(X\) sont toutes à valeurs dans \(\mathbb{N}\). Alors $$ X_n \xrightarrow{\mathcal{L}} X \iff \forall k \in \mathbb{N}, \quad P(X_n = k) \xrightarrow[n \to +\infty]{} P(X = k). $$
Pour une variable à valeurs dans \(\mathbb{N}\), la fonction de répartition est en escalier, son saut en \(k\) valant exactement \(P(X = k) = F_X(k) - F_X(k^-)\), et les points de continuité de \(F_X\) sont tous les non-entiers. Si \(P(X_n = k) \to P(X = k)\) pour tout \(k\), alors en un non-entier \(x\), \(F_{X_n}(x) = \sum_{k \le x} P(X_n = k) \to \sum_{k \le x} P(X = k) = F_X(x)\) (somme finie sous \(x\)), d'où la convergence en loi. Réciproquement, \(P(X_n = k) = F_{X_n}(k + \tfrac12) - F_{X_n}(k - \tfrac12) \to F_X(k + \tfrac12) - F_X(k - \tfrac12) = P(X = k)\), car \(k \pm \tfrac12\) sont des points de continuité.
Méthode — Convergence en loi de variables à valeurs entières
- calculer \(P(X_n = k)\) ;
- pour chaque \(k\) fixé, déterminer sa limite \(p_k\) en \(n\) ;
- vérifier que \((p_k)\) est une loi de probabilité (\(p_k \ge 0\), \(\sum_{k \ge 0} p_k = 1\)), puis identifier \(X\) telle que \(P(X = k) = p_k\).
Exemple
Soit \(X_n\) (pour \(n \ge 2\)) prenant la valeur \(1\) avec probabilité \(1 - \tfrac1n\) et la valeur \(n\) avec probabilité \(\tfrac1n\). Pour chaque \(k\) fixé : \(P(X_n = 1) = 1 - \tfrac1n \to 1\), et \(P(X_n = k) \to 0\) pour \(k \ne 1\) (la masse \(\tfrac1n\) s'échappe à l'infini). La limite \((p_k)\) a \(p_1 = 1\) et \(p_k = 0\) sinon — la loi de la constante \(1\). Donc \(X_n \xrightarrow{\mathcal{L}} 1\). (Le cours de première année étudie la convergence binomiale vers Poisson comme autre exemple à valeurs entières.) Compétences à pratiquer
- Étudier la convergence en loi de variables à valeurs entières
II.3
Le théorème central limite
La loi des grands nombres dit que la moyenne empirique \(\overline{X_n}\) converge vers \(m\). Le théorème central limite décrit comment \(\overline{X_n}\) fluctue autour de \(m\) : une fois remise à l'échelle par \(\sqrt n\), les fluctuations sont normales — quelle que soit la loi commune des variables (de variance finie non nulle). C'est le théorème le plus profond du chapitre, et il est admis.
Théorème — Théorème central limite
Admis. Soit \((X_n)\) i.i.d. d'espérance \(m\) et de variance \(\sigma^2 \ne 0\), et \(\overline{X_n} = \frac1n \sum_{k=1}^n X_k\). Alors la moyenne centrée réduite $$ \overline{X_n}^* = \sqrt{n}\,\frac{\overline{X_n} - m}{\sigma} \xrightarrow{\mathcal{L}} \mathcal{N}(0, 1). $$ De façon équivalente, pour la somme \(S_n = \sum_{k=1}^n X_k\), \(\ S_n^* = \dfrac{S_n - nm}{\sigma\sqrt n} \xrightarrow{\mathcal{L}} \mathcal{N}(0, 1)\).
Interprétation
Pour \(n\) grand, le théorème se lit \(\overline{X_n} \approx \mathcal{N}\bigl( m, \tfrac{\sigma^2}{n} \bigr)\) et \(S_n \approx \mathcal{N}(nm, n\sigma^2)\). Une somme de nombreuses variables indépendantes de même loi est approximativement normale — d'où le fait que la loi normale modélise tant de quantités naturelles (une mesure est la somme de nombreuses petites erreurs indépendantes).
La figure montre la fonction de répartition de \(\overline{X_n}^*\) s'approchant de celle de \(\mathcal{N}(0,1)\) à mesure que \(n\) grandit — le contenu visuel du théorème central limite, indépendant de la loi de départ. 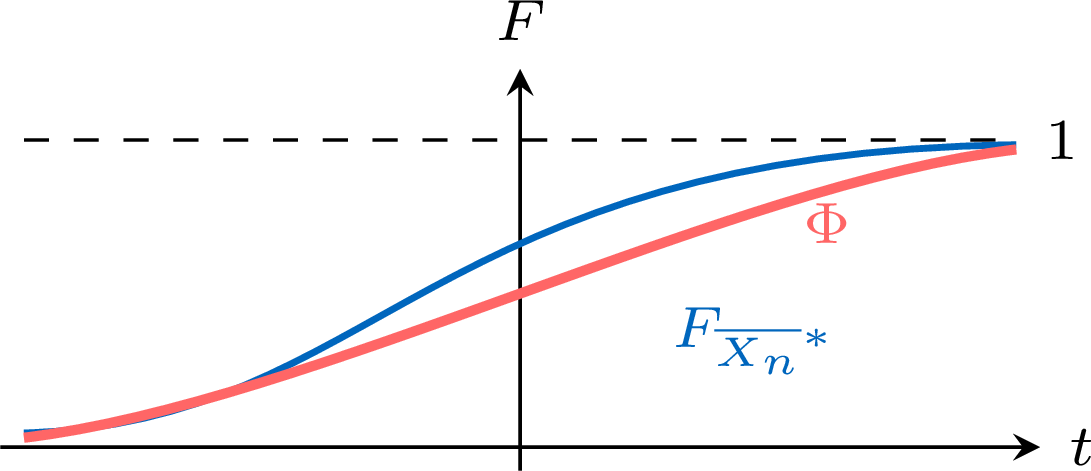
Méthode — Utiliser le théorème central limite
Pour approcher une probabilité portant sur une grande somme i.i.d. \(S_n\) (ou la moyenne \(\overline{X_n}\)) : centrer et réduire, \(S_n^* = \dfrac{S_n - nm}{\sigma\sqrt n}\), puis \(P(S_n \le c) = P\bigl( S_n^* \le \tfrac{c - nm}{\sigma\sqrt n} \bigr) \approx \Phi\bigl( \tfrac{c - nm}{\sigma\sqrt n} \bigr)\), en lisant \(\Phi\) dans la table de la loi normale. Exemple
Soit \(S_{100} = \sum_{k=1}^{100} X_k\) avec les \(X_k\) i.i.d. \(\mathcal{E}(1)\) (donc \(m = 1\), \(\sigma = 1\)). Approcher \(P(S_{100} \le 110)\). Ici \(E(S_{100}) = 100\), \(V(S_{100}) = 100\), \(\sigma\sqrt{n} = 10\), donc $$ P(S_{100} \le 110) = P\Bigl( S_{100}^* \le \tfrac{110 - 100}{10} \Bigr) = P(S_{100}^* \le 1) \approx \Phi(1) \approx 0.84. $$ Compétences à pratiquer
- Appliquer le théorème central limite
III
Approximation par la loi normale
III.1
Approximation des lois binomiale et de Poisson par la loi normale
La loi binomiale est une somme de variables de Bernoulli indépendantes, donc le théorème central limite s'applique directement ; la loi de Poisson, pour un grand paramètre, est de même proche d'une loi normale. En pratique, on remplace la loi par une loi normale de même espérance et même variance. Chaque fois qu'une loi à valeurs entières est approchée par une loi continue, une correction de continuité affine l'estimation. Tous les seuils pratiques sont fournis dans l'énoncé.
Proposition — Approximation normale de la loi binomiale
Si \(S_n \hookrightarrow \mathcal{B}(n, p)\) (avec \(0 < p < 1\)), alors $$ \frac{S_n - np}{\sqrt{np(1 - p)}} \xrightarrow[n \to +\infty]{\mathcal{L}} \mathcal{N}(0, 1). $$
\(S_n\) est la somme de \(n\) variables de Bernoulli i.i.d. \(\mathcal{B}(p)\), chacune d'espérance \(p\) et de variance \(p(1-p)\). Le théorème central limite pour \(S_n\) donne \(\dfrac{S_n - np}{\sqrt{n\,p(1-p)}} \xrightarrow{\mathcal{L}} \mathcal{N}(0,1)\).
Proposition — Approximation normale de la loi de Poisson
Si \(Y_\lambda \hookrightarrow \mathcal{P}(\lambda)\), alors \(\dfrac{Y_\lambda - \lambda}{\sqrt{\lambda}} \xrightarrow[\lambda \to +\infty]{\mathcal{L}} \mathcal{N}(0, 1)\). En pratique, pour \(\lambda\) grand, \(\mathcal{P}(\lambda) \approx \mathcal{N}(\lambda, \lambda)\). (Admis. Pour un paramètre entier, cela découle du théorème central limite en écrivant \(Y_n \hookrightarrow \mathcal{P}(n)\) comme somme de \(n\) variables indépendantes \(\mathcal{P}(1)\), chacune d'espérance et de variance \(1\) ; le cas général d'un paramètre réel \(\lambda \to +\infty\) est de même admis.) Méthode — Correction de continuité
Pour approcher une variable à valeurs entières \(X\) par une variable continue (normale) \(Y\), élargir chaque entier à l'intervalle de demi-unité autour de lui : remplacer \(P(X = k)\) par \(P\bigl( k - \tfrac12 \le Y \le k + \tfrac12 \bigr)\), \(P(X \le k)\) par \(P\bigl( Y \le k + \tfrac12 \bigr)\), et \(P(X \ge k)\) par \(P\bigl( Y \ge k - \tfrac12 \bigr)\). L'énoncé indique quand la correction est attendue. Exemple
Soit \(S \hookrightarrow \mathcal{B}(100, \tfrac12)\) (\(np = 50\), \(np(1-p) = 25\), \(\sigma = 5\)). Approcher \(P(S \le 60)\) avec correction de continuité. En remplaçant \(S \le 60\) par \(Y \le 60.5\) pour \(Y \hookrightarrow \mathcal{N}(50, 25)\), $$ P(S \le 60) \approx P\Bigl( \frac{Y - 50}{5} \le \frac{60.5 - 50}{5} \Bigr) = \Phi(2.1) \approx 0.982. $$
La figure superpose un histogramme binomial à la courbe normale approchante de même moyenne et même variance : pour un grand paramètre, les barres épousent la cloche. 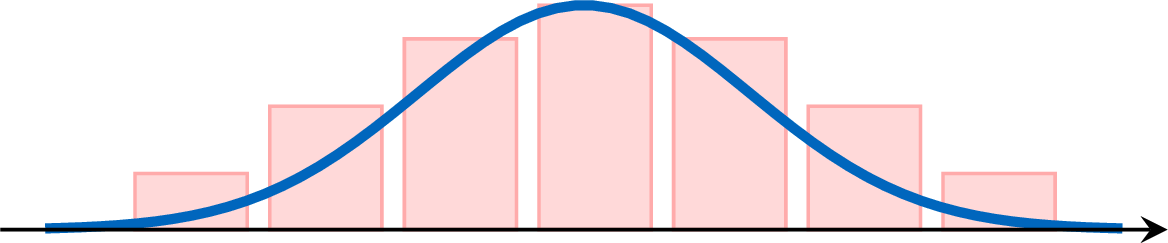
Méthode — Python — TP Thème 4 : visualiser la convergence
Pour voir le théorème central limite à l'œuvre, simuler de nombreux échantillons i.i.d., former la moyenne centrée réduite de chacun, et comparer l'histogramme empirique à la densité \(\mathcal{N}(0,1)\) : \begin{verbatim} import numpy as np import matplotlib.pyplot as plt n, N = 100, 10000 # taille d'echantillon, nombre de repetitions # n exponentielles i.i.d. E(1): moyenne m = 1, sigma = 1 data = np.random.exponential(1.0, size=(N, n)) means = data.mean(axis=1) reduced = np.sqrt(n) * (means - 1.0) / 1.0 # moyenne centree reduite plt.hist(reduced, bins=40, density=True) t = np.linspace(-4, 4, 200) plt.plot(t, np.exp(-t**2 / 2) / np.sqrt(2 * np.pi)) # densite N(0,1) plt.show() \end{verbatim}
Pour aller plus loin
La convergence en probabilité et le théorème central limite sont le moteur de l'estimation statistique. Le prochain chapitre utilise la loi des grands nombres pour justifier des estimateurs convergents (un estimateur dont la valeur se fixe sur le vrai paramètre quand l'échantillon grandit) et le théorème central limite pour décrire les fluctuations d'un estimateur ; le chapitre des intervalles de confiance transforme alors ces fluctuations en intervalles de confiance asymptotiques construits à partir de la loi normale.
Compétences à pratiquer
- Approcher une loi par la loi normale
IV
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section