Éducation Nationale Française · PT
Espaces préhilbertiens et euclidiens
Au lycée, le produit scalaire de deux vecteurs du plan a été introduit par les longueurs et les angles : \(\vec{u} \cdot \vec{v} = \|\vec{u}\| \, \|\vec{v}\| \cos(\widehat{\vec{u}, \vec{v}})\). Ce chapitre retourne la théorie. On définit d'abord le produit scalaire comme un objet algébrique abstrait sur un espace vectoriel réel ; on en dérive ensuite la norme, la distance, l'orthogonalité et l'angle. L'intérêt est que la même géométrie s'applique bien au-delà de \(\mathbb{R}^2\) et \(\mathbb{R}^3\) — aux espaces de fonctions, de polynômes, de matrices.
Le chapitre s'organise en cinq étapes, chacune appuyée sur des figures en dimension \(2\) et \(3\) comme le demande le programme. (1) Le produit scalaire lui-même, ses quatre propriétés définissantes et ses exemples principaux. (2) La norme et la distance qu'il induit, et les deux grandes inégalités — Cauchy-Schwarz et l'inégalité triangulaire — avec leurs cas d'égalité. (3) L'orthogonalité et le théorème de Pythagore. (4) Les bases orthonormées en dimension finie, construites par l'algorithme de Gram-Schmidt, et le confort qu'elles apportent à tout calcul. (5) La projection orthogonale sur un sous-espace de dimension finie, la distance à ce sous-espace, et le problème des moindres carrés qu'elle résout.
Notations permanentes. \(E\) désigne un espace vectoriel réel (un \(\mathbb{R}\)-espace vectoriel), de dimension finie ou infinie sauf mention contraire. Un produit scalaire est noté \(\langle x, y \rangle\) tout au long du chapitre (les notations \((x \mid y)\) et \(x \cdot y\) sont équivalentes et mentionnées une fois). La norme induite vaut \(\|x\| = \sqrt{\langle x, x \rangle}\), la distance est \(d(x, y) = \|x - y\|\). L'orthogonalité est \(x \perp y \iff \langle x, y \rangle = 0\), et pour une partie \(X\) de \(E\), \(X^{\perp} = \{\, t \in E \mid \forall x \in X,\ \langle t, x \rangle = 0 \,\}\). Le symbole de Kronecker vaut \(\delta_{i, j} = 1\) si \(i = j\) et \(0\) sinon. Tous les espaces vectoriels ici sont sur \(\mathbb{R}\) ; le cas complexe n'est pas traité à ce niveau.
I
Produit scalaire
I.1
Définition et premiers exemples
Un produit scalaire est une application \(E \times E \to \mathbb{R}\) qui capture quatre propriétés algébriques : bilinéarité (linéarité par rapport à chaque variable), symétrie, positivité et caractère défini (aussi appelé séparation). Ces quatre propriétés sont les os de toute la théorie ; tout ce qui suit — norme, distance, orthogonalité, projection — en est construit. On isole les quatre propriétés, on donne un raccourci pratique et une Méthode de vérification, puis on teste la définition sur un exemple canonique et deux contre-exemples.
Définition — Produit scalaire
Un produit scalaire sur un espace vectoriel réel \(E\) est une application \(\langle \cdot, \cdot \rangle : E \times E \to \mathbb{R}\) vérifiant les quatre propriétés ci-dessous. - Bilinéaire : pour tous \(x, x', y, y' \in E\) et tous \(\lambda, \mu \in \mathbb{R}\), $$ \langle \lambda x + \mu x', y \rangle = \lambda \langle x, y \rangle + \mu \langle x', y \rangle, \qquad \langle x, \lambda y + \mu y' \rangle = \lambda \langle x, y \rangle + \mu \langle x, y' \rangle. $$
- Symétrique : pour tous \(x, y \in E\), \(\langle y, x \rangle = \langle x, y \rangle\).
- Positive : pour tout \(x \in E\), \(\langle x, x \rangle \ge 0\).
- Définie (ou séparée) : pour tout \(x \in E\), \(\langle x, x \rangle = 0\) implique \(x = 0_E\).
Définition — Espace préhilbertien réel, espace euclidien
Un espace préhilbertien réel est un espace vectoriel réel \(E\) muni d'un produit scalaire \(\langle \cdot, \cdot \rangle\). Un espace euclidien est un espace préhilbertien réel de dimension finie.
Raccourci pratique. Les quatre propriétés ressemblent à quatre vérifications indépendantes, mais dès que la symétrie est acquise, la linéarité par rapport à la première variable implique la linéarité par rapport à la seconde. On prouve donc la symétrie d'abord, puis la linéarité par rapport à une variable, et la bilinéarité s'en déduit gratuitement. La positivité est alors une vérification de signe sur \(\langle x, x \rangle\), et le caractère défini est l'implication « \(\langle x, x \rangle = 0 \Rightarrow x = 0_E\) » — en général la seule étape délicate.
Méthode — Vérifier qu'une application est un produit scalaire
Étant donné un candidat \(\varphi : E \times E \to \mathbb{R}\), vérifier les quatre propriétés dans cet ordre. - Étape 1 — Symétrie. Montrer \(\varphi(y, x) = \varphi(x, y)\) pour tous \(x, y\).
- Étape 2 — Linéarité par rapport à la première variable seulement. Montrer \(\varphi(\lambda x + \mu x', y) = \lambda \varphi(x, y) + \mu \varphi(x', y)\). Par l'étape 1, la linéarité par rapport à la seconde variable s'en déduit, d'où la bilinéarité.
- Étape 3 — Positivité. Montrer \(\varphi(x, x) \ge 0\) pour tout \(x\).
- Étape 4 — Caractère défini. Montrer \(\varphi(x, x) = 0 \Rightarrow x = 0_E\).
Exemple — Aperçu canonique sur \(\mathbb{R}^2\)
L'application \(\varphi\big((x_1 \,;\, x_2), (y_1 \,;\, y_2)\big) = x_1 y_1 + x_2 y_2\) est un produit scalaire sur \(\mathbb{R}^2\). Symétrie et bilinéarité se lisent sur la formule ; la positivité est \(\varphi(x, x) = x_1^2 + x_2^2 \ge 0\) ; le caractère défini : \(x_1^2 + x_2^2 = 0\) force \(x_1 = x_2 = 0\). C'est le produit scalaire du lycée, retrouvé comme cas particulier du produit canonique sur \(\mathbb{R}^n\) ci-dessous. Exemple — Deux contre-exemples
Sur \(\mathbb{R}^2\) : - \(\varphi(x, y) = x_1 y_1\) est bilinéaire, symétrique et positive, mais pas définie : \(\varphi\big((0 \,;\, 1), (0 \,;\, 1)\big) = 0\) tandis que \((0 \,;\, 1) \ne 0_E\). Le caractère défini échoue.
- \(\psi(x, y) = x_1 y_1 - x_2 y_2\) est bilinéaire et symétrique, mais pas positive : \(\psi\big((0 \,;\, 1), (0 \,;\, 1)\big) = -1 < 0\). La positivité échoue.
Exemple — Un produit scalaire non canonique valide sur \(\mathbb{R}^2\)
L'application \(\varphi(X, Y) = X^{\top} \begin{pmatrix} 2 & 1 \\ 1 & 2 \end{pmatrix} Y\) est un produit scalaire sur \(\mathbb{R}^2\). Symétrie et bilinéarité sont immédiates (la matrice est symétrique). Pour la positivité et le caractère défini, avec \(X = (x_1 \,;\, x_2)^{\top}\), $$ X^{\top} \begin{pmatrix} 2 & 1 \\
1 & 2 \end{pmatrix} X = 2 x_1^2 + 2 x_1 x_2 + 2 x_2^2 = x_1^2 + x_2^2 + (x_1 + x_2)^2 \ge 0, $$ une somme de trois carrés ; elle s'annule seulement quand \(x_1 = x_2 = 0\). Ainsi un même espace vectoriel peut porter plusieurs produits scalaires : celui-ci réapparaîtra pour montrer que la base canonique de \(\mathbb{R}^2\) n'est pas orthonormée pour \(\varphi\). Compétences à pratiquer
- Est-ce un produit scalaire ?
I.2
Produits scalaires canoniques sur \(\mathbb{R}^n\) et sur les matrices
On généralise l'aperçu sur \(\mathbb{R}^2\) à \(\mathbb{R}^n\) et à l'espace de matrices \(\mathcal{M}_n(\mathbb{R})\), avec un produit scalaire canonique sur chacun. Ce sont les produits de travail de la section projection-et-distance plus bas.
Proposition — Produit scalaire canonique sur \(\mathbb{R}^n\)
L'application $$ \textcolor{colorprop}{(X, Y) \longmapsto X^{\top} Y = \sum_{i = 1}^n x_i y_i} $$ est un produit scalaire sur \(\mathbb{R}^n\), appelé le produit scalaire canonique. Ici \(X = (x_1 \,;\, \dots \,;\, x_n)^{\top}\) et \(Y = (y_1 \,;\, \dots \,;\, y_n)^{\top}\) sont des vecteurs colonnes, et \(X^{\top} Y\) est la matrice \(1 \times 1\) identifiée à son unique coefficient.
On suit la Méthode en quatre étapes.
- Symétrie. \(X^{\top} Y\) est une matrice \(1 \times 1\), donc égale à sa transposée : \(X^{\top} Y = (X^{\top} Y)^{\top} = Y^{\top} X\).
- Linéarité par rapport à la première variable. \((\lambda X + \mu X')^{\top} Y = \lambda X^{\top} Y + \mu (X')^{\top} Y\) par linéarité du produit matriciel par rapport à son premier facteur.
- Positivité. \(X^{\top} X = \sum_{i = 1}^n x_i^2 \ge 0\).
- Caractère défini. Si \(\sum x_i^2 = 0\), chaque \(x_i^2 = 0\), donc \(X = 0_{\mathbb{R}^n}\).
Exemple — Illustration numérique sur \(\mathbb{R}^3\)
Sur \(\mathbb{R}^3\) avec le produit scalaire canonique, \(\langle (1 \,;\, 2 \,;\, 3), (4 \,;\, 5 \,;\, 6) \rangle = 1 \cdot 4 + 2 \cdot 5 + 3 \cdot 6 = 32\). Proposition — Produit scalaire canonique sur \(\mathcal{M}_n(\mathbb{R})\)
L'application $$ \textcolor{colorprop}{(A, B) \longmapsto \operatorname{tr}(A^{\top} B) = \sum_{1 \le i, j \le n} a_{i, j}\, b_{i, j}} $$ est un produit scalaire sur \(\mathcal{M}_n(\mathbb{R})\), appelé le produit scalaire canonique (de Frobenius).
D'abord la formule : par définition du produit matriciel, \((A^{\top} B)_{j, j} = \sum_{i = 1}^n a_{i, j}\, b_{i, j}\), et la somme sur \(j\) donne \(\operatorname{tr}(A^{\top} B) = \sum_{i, j} a_{i, j}\, b_{i, j}\). Puis les quatre étapes.
- Symétrie. \(\operatorname{tr}(A^{\top} B) = \operatorname{tr}\big((A^{\top} B)^{\top}\big) = \operatorname{tr}(B^{\top} A)\), en utilisant \(\operatorname{tr}(M^{\top}) = \operatorname{tr}(M)\).
- Linéarité par rapport à la première variable. \((\lambda A + \mu A')^{\top} = \lambda A^{\top} + \mu (A')^{\top}\), puis par linéarité de la trace et du produit, \(\operatorname{tr}\big((\lambda A + \mu A')^{\top} B\big) = \lambda \operatorname{tr}(A^{\top} B) + \mu \operatorname{tr}\big((A')^{\top} B\big)\).
- Positivité. \(\operatorname{tr}(A^{\top} A) = \sum_{i, j} a_{i, j}^2 \ge 0\).
- Caractère défini. Si \(\sum_{i, j} a_{i, j}^2 = 0\), chaque \(a_{i, j} = 0\), donc \(A = 0\).
Compétences à pratiquer
- Calculer un produit scalaire canonique
I.3
Produit scalaire intégral sur les fonctions et les polynômes
Le modèle mental du lycée (\(\mathbb{R}^2\), \(\mathbb{R}^3\)) est brisé par un exemple en dimension infinie : le produit scalaire intégral sur l'espace \(C^0([a \,;\, b], \mathbb{R})\) des fonctions continues sur un segment. L'étape-clé (le caractère défini) utilise le lemme « une fonction continue positive sur un segment d'intégrale nulle est identiquement nulle », vu dans le cours d'intégration.
Proposition — Produit scalaire intégral
Soient \(a, b \in \mathbb{R}\) avec \(a < b\). L'application $$ \textcolor{colorprop}{(f, g) \longmapsto \langle f, g \rangle = \int_a^b f(t)\, g(t)\, \mathrm{d}t} $$ est un produit scalaire sur \(C^0([a \,;\, b], \mathbb{R})\). La même formule définit un produit scalaire sur \(\mathbb{R}[X]\), tout polynôme étant continu sur \([a \,;\, b]\).
Quatre étapes.
- Symétrie. \(\int_a^b f(t) g(t)\,\mathrm{d}t = \int_a^b g(t) f(t)\,\mathrm{d}t\).
- Linéarité par rapport à la première variable. Par linéarité de l'intégrale par rapport à son intégrande.
- Positivité. \(\int_a^b f(t)^2\, \mathrm{d}t \ge 0\) car \(f(t)^2 \ge 0\).
- Caractère défini. Si \(\int_a^b f(t)^2\, \mathrm{d}t = 0\), comme \(f^2\) est continue et positive sur \([a \,;\, b]\), le lemme donne \(f^2 = 0\), donc \(f = 0\). Pour un polynôme \(P\), \(\int_a^b P(t)^2\, \mathrm{d}t = 0\) force \(P\) à s'annuler sur \([a \,;\, b]\), donc à avoir une infinité de racines, donc \(P = 0\).
Attention. L'espace \(C^0([a \,;\, b], \mathbb{R})\) est préhilbertien réel mais pas euclidien : il est de dimension infinie (la famille \((t \mapsto t^n)_{n \in \mathbb{N}}\) est libre). Les notions de produit scalaire, norme et orthogonalité s'appliquent partout ; seuls les théorèmes de dimension finie sur les bases orthonormées et la projection orthogonale (les deux dernières sections) requièrent un sous-espace de dimension finie — ce qui est exactement la façon dont on les utilisera.
Exemple — Un produit scalaire sur les polynômes par points d'évaluation
Soient \(x_0, \dots, x_n\) des réels deux à deux distincts au nombre de \(n + 1\). L'application \((P, Q) \mapsto \sum_{k = 0}^n P(x_k)\, Q(x_k)\) est un produit scalaire sur \(\mathbb{R}_n[X]\). Symétrie, bilinéarité, positivité sont immédiates ; caractère défini : si \(\sum P(x_k)^2 = 0\), alors \(P\) a les \(n + 1\) racines distinctes \(x_0, \dots, x_n\), et comme \(\deg P \le n\) cela force \(P = 0\). Compétences à pratiquer
- Travailler avec un produit scalaire intégral
II
Norme, distance et les deux grandes inégalités
II.1
Norme et distance associées
Le produit scalaire induit une longueur et une distance. On les définit et on prouve trois des quatre axiomes de norme maintenant (positivité, séparation, homogénéité) ; le quatrième (l'inégalité triangulaire) attend Cauchy-Schwarz plus bas. Aucune théorie abstraite des espaces normés n'est requise : la norme est ici simplement l'objet \(\|x\| = \sqrt{\langle x, x \rangle}\).
Définition — Norme associée, vecteur unitaire, distance
Soit \((E, \langle \cdot, \cdot \rangle)\) un espace préhilbertien réel. Pour \(x, y \in E\) : - la norme associée de \(x\) est \(\|x\| = \sqrt{\langle x, x \rangle}\) (bien définie car \(\langle x, x \rangle \ge 0\)) ;
- \(x\) est un vecteur unitaire (ou normalisé) si \(\|x\| = 1\) ;
- la distance entre \(x\) et \(y\) est \(d(x, y) = \|x - y\|\).
Proposition — Propriétés de base de la norme
Pour tout \(x \in E\) et tout \(\lambda \in \mathbb{R}\) : - \(\|x\| \ge 0\) (positivité) ;
- \(\|x\| = 0 \iff x = 0_E\) (séparation) ;
- \(\|\lambda x\| = |\lambda|\, \|x\|\) (homogénéité positive).
- (i) \(\|x\| = \sqrt{\langle x, x \rangle}\) est une racine carrée, donc \(\ge 0\).
- (ii) \(\|x\| = 0 \iff \langle x, x \rangle = 0 \iff x = 0_E\) par le caractère défini du produit scalaire.
- (iii) \(\|\lambda x\|^2 = \langle \lambda x, \lambda x \rangle = \lambda^2 \langle x, x \rangle = \lambda^2 \|x\|^2\) par bilinéarité ; la racine carrée donne \(\|\lambda x\| = |\lambda|\, \|x\|\).
La norme dépend du produit scalaire. Pour le produit non canonique \(\varphi(X, Y) = X^{\top} \begin{pmatrix} 2 & 1 \\ 1 & 2 \end{pmatrix} Y\) vu plus haut, \(\|(1 \,;\, 0)\|^2 = 2\), donc \(\|(1 \,;\, 0)\| = \sqrt{2} \ne 1\) : le même vecteur a des longueurs différentes selon le produit scalaire. Toute normalisation \(x \mapsto x / \|x\|\) (pour \(x \ne 0_E\)) produit un vecteur unitaire.
Compétences à pratiquer
- Calculer une norme et une distance
II.2
Identités remarquables et polarisation
La bilinéarité relie la norme d'une somme au produit scalaire. L'identité remarquable est un développement direct ; la formule de polarisation l'inverse, récupérant le produit scalaire à partir de la norme seule ; et l'identité du parallélogramme en découle en une ligne.
Proposition — Identités remarquables et polarisation
Pour tous \(x, y \in E\) : $$ \textcolor{colorprop}{\|x + y\|^2 = \|x\|^2 + 2 \langle x, y \rangle + \|y\|^2}, \qquad \textcolor{colorprop}{\|x - y\|^2 = \|x\|^2 - 2 \langle x, y \rangle + \|y\|^2}, $$ d'où la formule de polarisation et l'identité du parallélogramme : $$ \textcolor{colorprop}{\langle x, y \rangle = \tfrac{1}{4}\big(\|x + y\|^2 - \|x - y\|^2\big)}, \qquad \textcolor{colorprop}{\|x + y\|^2 + \|x - y\|^2 = 2\big(\|x\|^2 + \|y\|^2\big)}. $$
Pour la première identité, par bilinéarité et symétrie : $$ \begin{aligned} \|x + y\|^2 &= \langle x + y, x + y \rangle && \text{(définition de \(\|\cdot\|\))} \\
&= \langle x, x \rangle + 2 \langle x, y \rangle + \langle y, y \rangle && \text{(bilinéarité, symétrie)} \\
&= \|x\|^2 + 2 \langle x, y \rangle + \|y\|^2. \end{aligned} $$ En remplaçant \(y\) par \(-y\) on obtient la seconde identité. La soustraction donne \(\|x + y\|^2 - \|x - y\|^2 = 4 \langle x, y \rangle\), d'où la polarisation ; l'addition donne l'identité du parallélogramme.
Lecture géométrique. Dans un parallélogramme construit sur \(x\) et \(y\), les deux diagonales sont \(x + y\) et \(x - y\) ; l'identité du parallélogramme dit que la somme des carrés des diagonales vaut deux fois la somme des carrés des côtés — la forme abstraite d'un fait classique de géométrie plane. 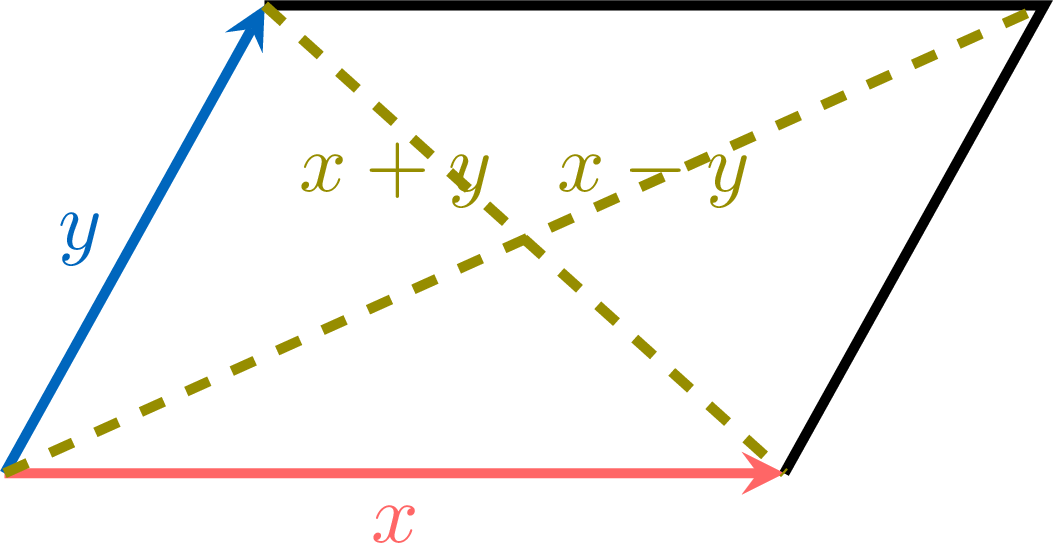
Compétences à pratiquer
- Utiliser polarisation et identité du parallélogramme
II.3
Inégalité de Cauchy-Schwarz et angle
On établit l'inégalité centrale du chapitre : \(|\langle x, y \rangle| \le \|x\|\, \|y\|\). La démonstration étudie le polynôme réel \(\varphi(t) = \|x + t y\|^2 \ge 0\) de degré \(\le 2\) en \(t\) et lit son discriminant ; le cas dégénéré \(y = 0_E\) est traité à part. Le cas d'égalité caractérise la colinéarité. Cauchy-Schwarz permet ensuite de définir l'angle géométrique dans \(\mathbb{R}^2\) et \(\mathbb{R}^3\) et le coefficient de corrélation linéaire.
Théorème — Inégalité de Cauchy-Schwarz
Pour tous \(x, y \in E\) : $$ \textcolor{colorprop}{|\langle x, y \rangle| \le \|x\| \cdot \|y\|}, $$ avec égalité si et seulement si \(x\) et \(y\) sont colinéaires. (Convention : \(0_E\) est colinéaire à tout vecteur, le cas d'égalité a donc lieu sans exception quand \(x = 0_E\) ou \(y = 0_E\).)
On définit \(\varphi : \mathbb{R} \to \mathbb{R}\) par \(\varphi(t) = \|x + t y\|^2 = \|x\|^2 + 2 t \langle x, y \rangle + t^2 \|y\|^2\) (identité remarquable). Par positivité, \(\varphi(t) \ge 0\) pour tout \(t\).
- Cas \(y = 0_E\). Alors \(\langle x, y \rangle = 0\) et \(\|y\| = 0\) : les deux membres sont nuls, l'égalité a lieu, et \(x, 0_E\) sont colinéaires par convention.
- Cas \(y \ne 0_E\). Alors \(\|y\|^2 > 0\), donc \(\varphi\) est de degré exactement \(2\) à coefficient dominant positif et \(\varphi \ge 0\) sur \(\mathbb{R}\), donc son discriminant est \(\le 0\) : $$ \Delta = 4 \langle x, y \rangle^2 - 4 \|x\|^2 \|y\|^2 \le 0, \quad\text{soit}\quad \langle x, y \rangle^2 \le \|x\|^2 \|y\|^2, $$ soit \(|\langle x, y \rangle| \le \|x\|\, \|y\|\). L'égalité signifie \(\Delta = 0\), soit \(\varphi\) a une racine double \(t_0\), soit \(\|x + t_0 y\|^2 = 0\), soit \(x = -t_0 y\) (séparation) : \(x, y\) colinéaires. Réciproquement, si \(x = \lambda y\) alors \(\varphi(-\lambda) = 0\), forçant \(\Delta = 0\), soit l'égalité.
Méthode — Appliquer Cauchy-Schwarz pour majorer une somme ou une intégrale
- Étape 1. Identifier l'espace préhilbertien et son produit scalaire (typiquement \(\mathbb{R}^n\) canonique, ou \(C^0([a \,;\, b], \mathbb{R})\) intégral).
- Étape 2. Choisir \(x, y\) dont le produit scalaire \(\langle x, y \rangle\) vaut l'expression à majorer et dont les normes sont calculables.
- Étape 3. Écrire \(|\langle x, y \rangle| \le \|x\|\, \|y\|\), élever au carré ou simplifier, et lire le cas d'égalité par la colinéarité.
Exemple — Cauchy-Schwarz avec des un
Pour tous \(x_1, \dots, x_n \in \mathbb{R}\), \(\big(\sum_{k = 1}^n x_k\big)^2 \le n \sum_{k = 1}^n x_k^2\), avec égalité si et seulement si \(x_1 = \dots = x_n\). On applique Cauchy-Schwarz sur \(\mathbb{R}^n\) canonique à \(X = (x_1 \,;\, \dots \,;\, x_n)\) et \(Y = (1 \,;\, \dots \,;\, 1)\) : \(\langle X, Y \rangle = \sum x_k\), \(\|X\|^2 = \sum x_k^2\), \(\|Y\|^2 = n\). En élevant au carré \(|\langle X, Y \rangle| \le \|X\|\, \|Y\|\) on obtient la majoration ; égalité si et seulement si \(X\) est colinéaire à \(Y\), soit tous les \(x_k\) égaux. Définition — Angle et coefficient de corrélation linéaire
Soient \(x, y \in E\) non nuls. Par Cauchy-Schwarz, \(-1 \le \dfrac{\langle x, y \rangle}{\|x\|\, \|y\|} \le 1\), donc il existe un unique angle \(\theta \in [0 \,;\, \pi]\) tel que $$ \textcolor{colordef}{\cos \theta = \frac{\langle x, y \rangle}{\|x\| \cdot \|y\|}}. $$ Dans \(\mathbb{R}^2\) et \(\mathbb{R}^3\) (produit canonique) cet \(\theta\) est l'angle géométrique usuel entre \(x\) et \(y\). En statistiques, lorsque \(x, y\) sont des vecteurs de données centrées de \(\mathbb{R}^n\), le même quotient est le coefficient de corrélation linéaire \(r = \dfrac{\langle x, y \rangle}{\|x\|\, \|y\|} \in [-1 \,;\, 1]\), et \(|r| = 1\) exactement quand les données sont colinéaires. Compétences à pratiquer
- Appliquer Cauchy-Schwarz
II.4
Inégalité triangulaire
Cauchy-Schwarz donne maintenant le dernier axiome de norme, l'inégalité triangulaire, ainsi que sa forme inverse. On décrit les deux cas d'égalité : colinéaires de même sens pour la borne supérieure, de sens contraire pour la borne inférieure. Une fois ceci prouvé, \(\|\cdot\|\) est une vraie norme et \(d\) une vraie distance.
Théorème — Inégalité triangulaire
Pour tous \(x, y \in E\) : $$ \textcolor{colorprop}{\big|\, \|x\| - \|y\| \,\big| \le \|x + y\| \le \|x\| + \|y\|}. $$ L'égalité de droite \(\|x + y\| = \|x\| + \|y\|\) a lieu si et seulement si \(x, y\) sont positivement colinéaires, soit \(\langle x, y \rangle = \|x\|\, \|y\|\) — de manière équivalente, l'un est un multiple positif ou nul de l'autre (elle a donc lieu automatiquement si \(x = 0_E\) ou \(y = 0_E\)) ; l'égalité de gauche a lieu si et seulement si \(\langle x, y \rangle = -\|x\|\, \|y\|\), soit l'un est un multiple négatif ou nul de l'autre.
Pour l'inégalité de droite, on élève au carré et on utilise Cauchy-Schwarz : $$ \begin{aligned} \|x + y\|^2 &= \|x\|^2 + 2 \langle x, y \rangle + \|y\|^2 && \text{(identité remarquable)} \\
&\le \|x\|^2 + 2 \|x\|\, \|y\| + \|y\|^2 && \text{(\(\langle x, y \rangle \le |\langle x, y \rangle| \le \|x\|\, \|y\|\))} \\
&= (\|x\| + \|y\|)^2, \end{aligned} $$ puis on prend la racine carrée positive. L'égalité force \(\langle x, y \rangle = \|x\|\, \|y\|\), soit l'égalité de Cauchy-Schwarz avec produit scalaire positif : \(x, y\) colinéaires de même sens. L'inégalité de gauche s'obtient en appliquant celle de droite à \(x + y\) et \(-y\) : \(\|x\| \le \|x + y\| + \|y\|\), et symétriquement ; son cas d'égalité se ramène à celui de droite appliqué à \(x = (x + y) + (-y)\), donnant la colinéarité de sens contraire.
Corollaire — une vraie norme et une vraie distance. En combinant les propriétés de base (positivité, séparation, homogénéité) avec l'inégalité triangulaire, \(\|\cdot\|\) vérifie tous les axiomes de norme. Alors \(d(x, y) = \|x - y\|\) hérite des axiomes de distance : \(d \ge 0\) ; \(d(x, y) = 0 \iff x = y\) (séparation) ; \(d(y, x) = \|y - x\| = \|x - y\| = d(x, y)\) (symétrie) ; et en écrivant \(x - z = (x - y) + (y - z)\), l'inégalité triangulaire pour \(\|\cdot\|\) donne \(d(x, z) \le d(x, y) + d(y, z)\). Désormais on les appelle « la norme » et « la distance » sans réserve.
Compétences à pratiquer
- Vérifier l'inégalité triangulaire
III
Orthogonalité et théorème de Pythagore
III.1
Vecteurs et parties orthogonaux
On renverse encore l'ordre du lycée. Là, les angles droits venaient d'abord et le produit scalaire était une conséquence ; ici, l'orthogonalité est définie par l'annulation du produit scalaire, \(x \perp y \iff \langle x, y \rangle = 0\). Chaque produit scalaire apporte sa propre orthogonalité.
Définition — Vecteurs et parties orthogonaux
Soit \((E, \langle \cdot, \cdot \rangle)\) un espace préhilbertien réel, \(x, y \in E\), et \(X, Y\) des parties de \(E\). - \(x\) et \(y\) sont orthogonaux, on note \(x \perp y\), si \(\langle x, y \rangle = 0\).
- \(X\) et \(Y\) sont orthogonales, on note \(X \perp Y\), si \(\langle x, y \rangle = 0\) pour tous \(x \in X\), \(y \in Y\).
Exemple — Vecteurs orthogonaux dans \(\mathbb{R}^3\)
Sur \(\mathbb{R}^3\) canonique, \((1 \,;\, 2 \,;\, 3) \perp (2 \,;\, -1 \,;\, 0)\) car \(1 \cdot 2 + 2 \cdot (-1) + 3 \cdot 0 = 0\) ; mais \((1 \,;\, 2 \,;\, 3)\) et \((1 \,;\, 1 \,;\, 1)\) ne sont pas orthogonaux car leur produit scalaire vaut \(6 \ne 0\). 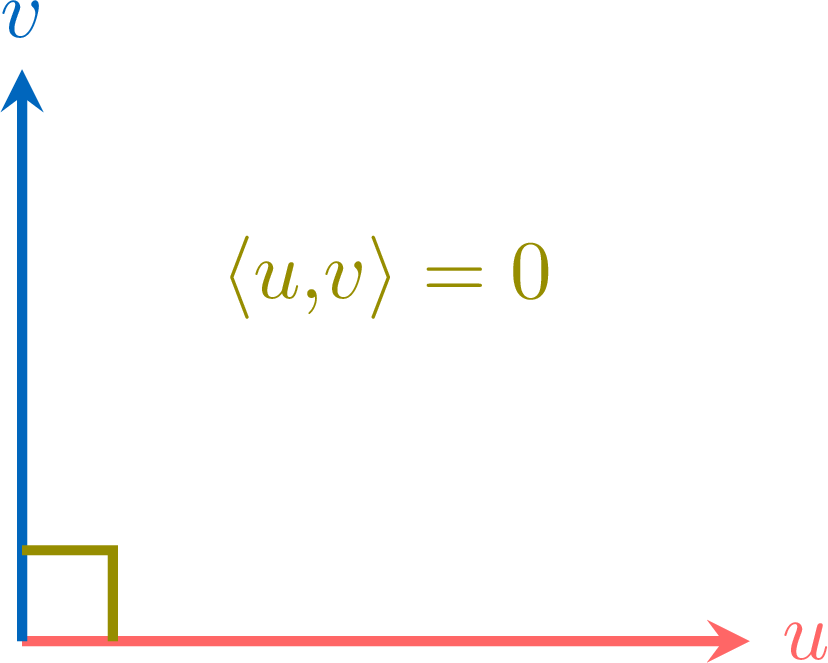
Exemple — Matrices symétriques et antisymétriques orthogonales
Sur \(\mathcal{M}_n(\mathbb{R})\) muni du produit de Frobenius, les sous-espaces \(\mathcal{S}_n(\mathbb{R})\) (symétriques) et \(\mathcal{A}_n(\mathbb{R})\) (antisymétriques) sont orthogonaux. En effet, pour \(A\) symétrique (\(A^{\top} = A\)) et \(B\) antisymétrique (\(B^{\top} = -B\)), \(\langle A, B \rangle = \operatorname{tr}(A^{\top} B) = \operatorname{tr}(A B)\), et aussi \(\langle A, B \rangle = \langle B, A \rangle = \operatorname{tr}(B^{\top} A) = -\operatorname{tr}(B A) = -\operatorname{tr}(A B)\), donc \(\langle A, B \rangle = 0\).
Le rôle du vecteur nul. Seul \(0_E\) est orthogonal à lui-même, et seul \(0_E\) est orthogonal à tout vecteur de \(E\). En effet \(x \perp x\) signifie \(\langle x, x \rangle = 0\), donc \(x = 0_E\) ; et si \(x \perp y\) pour tout \(y\), prendre \(y = x\). En bref \(E^{\perp} = \{0_E\}\) et \(\{0_E\}^{\perp} = E\).
Compétences à pratiquer
- Tester l'orthogonalité
III.2
Familles orthonormées et théorème de Pythagore
L'orthogonalité s'étend aux familles indexées. Deux conséquences feront tourner toute la suite : le théorème de Pythagore dans sa forme \(n\)-aire, et le fait qu'une famille orthogonale finie de vecteurs non nuls est automatiquement libre.
Définition — Familles orthogonales et orthonormées
Une famille finie \((x_1, \dots, x_p)\) de vecteurs de \(E\) est : - orthogonale si \(\langle x_i, x_j \rangle = 0\) pour tous \(i \ne j\) ;
- orthonormée si elle est orthogonale et chaque \(x_i\) est unitaire, soit \(\langle x_i, x_j \rangle = \delta_{i, j}\) pour tous \(i, j\).
Exemple — La base canonique est orthonormée
Pour le produit canonique sur \(\mathbb{R}^n\), la base canonique \((e_1, \dots, e_n)\) vérifie \(e_i^{\top} e_j = \delta_{i, j}\) : elle est orthonormée. Mais pour le produit non canonique \(\varphi(X, Y) = X^{\top} \begin{pmatrix} 2 & 1 \\ 1 & 2 \end{pmatrix} Y\), la base canonique de \(\mathbb{R}^2\) n'est pas orthonormée : \(\varphi(e_1, e_1) = 2 \ne 1\) et \(\varphi(e_1, e_2) = 1 \ne 0\). Théorème — Théorème de Pythagore
Soit \((x_1, \dots, x_p)\) une famille orthogonale finie de \(E\). Alors $$ \textcolor{colorprop}{\Big\| \sum_{k = 1}^p x_k \Big\|^2 = \sum_{k = 1}^p \|x_k\|^2}. $$ En particulier, pour deux vecteurs : \(x \perp y \iff \|x + y\|^2 = \|x\|^2 + \|y\|^2\).
On développe par bilinéarité et on sépare les termes diagonaux des termes croisés : $$ \Big\| \sum_{k = 1}^p x_k \Big\|^2 = \Big\langle \sum_{i} x_i, \sum_{j} x_j \Big\rangle = \sum_{i = 1}^p \langle x_i, x_i \rangle + \sum_{i \ne j} \langle x_i, x_j \rangle = \sum_{k = 1}^p \|x_k\|^2, $$ la somme croisée étant nulle par orthogonalité. Pour deux vecteurs, \(\|x + y\|^2 = \|x\|^2 + \|y\|^2\) équivaut (identité remarquable) à \(2 \langle x, y \rangle = 0\), soit \(x \perp y\).
Proposition — Une famille orthogonale de vecteurs non nuls est libre
Une famille orthogonale finie \((x_1, \dots, x_p)\) de vecteurs non nuls de \(E\) est libre. En particulier, une famille orthonormée est libre.
Supposons \(\sum_{k = 1}^p \lambda_k x_k = 0_E\). On prend le produit scalaire avec \(x_i\) : par orthogonalité, \(\sum_k \lambda_k \langle x_k, x_i \rangle = \lambda_i \langle x_i, x_i \rangle = \lambda_i \|x_i\|^2 = 0\). Comme \(x_i \ne 0_E\), \(\|x_i\|^2 \ne 0\), donc \(\lambda_i = 0\). Ceci vaut pour tout \(i\), donc la famille est libre.
Compétences à pratiquer
- Pythagore et familles orthogonales libres
III.3
Orthogonal d'une partie
L'ensemble des vecteurs orthogonaux à toute une partie \(X\) est lui-même un sous-espace, \(X^{\perp}\). C'est l'ossature géométrique de la théorie de la projection de la dernière section.
Proposition — L'orthogonal d'une partie
Soit \(X\) une partie de \(E\). L'ensemble $$ \textcolor{colorprop}{X^{\perp} = \{\, t \in E \mid \forall x \in X,\ \langle t, x \rangle = 0 \,\}} $$ est un sous-espace de \(E\). De plus, \(X \subseteq (X^{\perp})^{\perp}\), et si \(F = \operatorname{Vect}(x_1, \dots, x_p)\), alors \(t \in F^{\perp} \iff t \perp x_k\) pour tout \(k\) (il suffit de tester l'orthogonalité sur une famille génératrice).
\(0_E \in X^{\perp}\). Si \(s, t \in X^{\perp}\) et \(\lambda \in \mathbb{R}\), alors pour tout \(x \in X\), \(\langle \lambda s + t, x \rangle = \lambda \langle s, x \rangle + \langle t, x \rangle = 0\), donc \(\lambda s + t \in X^{\perp}\) : c'est un sous-espace. Pour \(x \in X\), \(x\) est orthogonal à tout \(t \in X^{\perp}\) par définition, donc \(x \in (X^{\perp})^{\perp}\) ; d'où \(X \subseteq (X^{\perp})^{\perp}\). Enfin, si \(t \perp x_k\) pour tout \(k\) alors pour tout \(x = \sum a_k x_k \in F\), \(\langle t, x \rangle = \sum a_k \langle t, x_k \rangle = 0\) par bilinéarité ; la réciproque est immédiate.
Exemple — Orthogonal d'une droite dans \(\mathbb{R}^3\)
Sur \(\mathbb{R}^3\) canonique, pour \(D = \operatorname{Vect}(1 \,;\, 1 \,;\, 1)\), un vecteur \((x \,;\, y \,;\, z)\) est dans \(D^{\perp}\) ssi \(x + y + z = 0\). Donc \(D^{\perp}\) est le plan d'équation \(x + y + z = 0\), de dimension \(2\) — le « plan orthogonal à la droite \(D\) » géométrique. Compétences à pratiquer
- Calculer un orthogonal
IV
Bases orthonormées en dimension finie
IV.1
L'algorithme d'orthonormalisation de Gram-Schmidt
Dans un espace euclidien la base naturelle de travail est orthonormée, car le produit scalaire, la norme et les coordonnées y prennent leur forme la plus simple (sous-section suivante). L'algorithme de Gram-Schmidt construit une telle base : partant d'une base quelconque \((v_1, \dots, v_n)\), il produit une famille orthogonale ayant les mêmes drapeaux \(\operatorname{Vect}(v_1, \dots, v_k)\), puis une normalisation finale la rend orthonormée. L'idée est géométrique : à chaque étape on retranche de \(v_k\) sa projection sur l'espace déjà construit, ne gardant que la part orthogonale.
Théorème — Orthonormalisation de Gram-Schmidt
Soit \((v_1, \dots, v_n)\) une famille libre d'un espace préhilbertien réel \(E\). Il existe une famille orthonormée \((e_1, \dots, e_n)\) telle que, pour tout \(k \in \{1, \dots, n\}\), $$ \textcolor{colorprop}{\operatorname{Vect}(e_1, \dots, e_k) = \operatorname{Vect}(v_1, \dots, v_k)}. $$ On la construit pas à pas : on pose \(w_1 = v_1\), puis pour \(k \ge 2\) $$ w_k = v_k - \sum_{i = 1}^{k - 1} \frac{\langle v_k, w_i \rangle}{\|w_i\|^2}\, w_i, \qquad\text{et enfin}\qquad e_k = \frac{w_k}{\|w_k\|}. $$
On montre par récurrence sur \(k\) que \((w_1, \dots, w_k)\) est orthogonale avec chaque \(w_i \ne 0_E\) et \(\operatorname{Vect}(w_1, \dots, w_k) = \operatorname{Vect}(v_1, \dots, v_k)\). Pour \(k = 1\), \(w_1 = v_1 \ne 0_E\) (famille libre). Supposons la propriété acquise jusqu'au rang \(k - 1\). Pour \(j < k\), en utilisant l'orthogonalité des \(w_i\), $$ \langle w_k, w_j \rangle = \langle v_k, w_j \rangle - \sum_{i = 1}^{k - 1} \frac{\langle v_k, w_i \rangle}{\|w_i\|^2} \langle w_i, w_j \rangle = \langle v_k, w_j \rangle - \frac{\langle v_k, w_j \rangle}{\|w_j\|^2} \|w_j\|^2 = 0, $$ donc \((w_1, \dots, w_k)\) est orthogonale. Ensuite \(w_k \ne 0_E\) : sinon \(v_k\) serait combinaison de \(w_1, \dots, w_{k-1}\), donc de \(v_1, \dots, v_{k-1}\) (récurrence), contredisant la liberté. L'égalité des drapeaux vient de ce que \(w_k\) diffère de \(v_k\) d'un vecteur de \(\operatorname{Vect}(v_1, \dots, v_{k-1})\), et les dimensions coïncident. En divisant chaque \(w_k\) par sa norme (non nulle) on obtient la famille orthonormée \((e_1, \dots, e_n)\) ayant les mêmes drapeaux.
Lecture géométrique d'une étape. À l'étape \(k\), \(w_k = v_k - p_{k-1}(v_k)\) où \(p_{k-1}(v_k) = \sum_{i < k} \frac{\langle v_k, w_i \rangle}{\|w_i\|^2} w_i\) est la projection orthogonale de \(v_k\) sur \(\operatorname{Vect}(w_1, \dots, w_{k-1})\) (section suivante). On retire l'« ombre » de \(v_k\) sur l'espace déjà construit et on garde la part perpendiculaire. 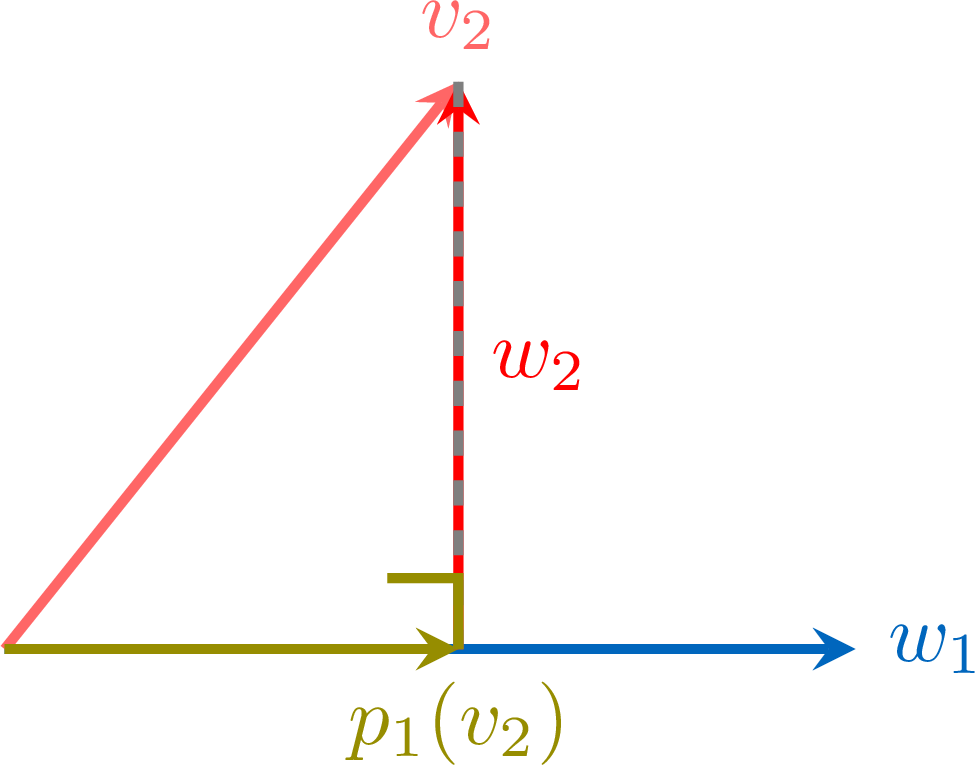
Méthode — Exécuter Gram-Schmidt sur une petite famille
- Étape 1. Garder le premier vecteur : \(w_1 = v_1\).
- Étape 2. Au rang \(k\), poser \(w_k = v_k - \sum_{i < k} \frac{\langle v_k, w_i \rangle}{\|w_i\|^2} w_i\) ; vérifier au fur et à mesure \(w_k \perp w_i\) pour \(i < k\) (bon test de cohérence).
- Étape 3. Normaliser tout à la fin : \(e_k = w_k / \|w_k\|\). Ne pas normaliser en cours de route sauf demande — cela n'ajoute que des racines carrées.
Exemple — Gram-Schmidt sur \((1\virgule X\virgule X^2)\) pour un produit intégral
On munit \(\mathbb{R}_2[X]\) de \(\langle P, Q \rangle = \int_{-1}^{1} P(t)\, Q(t)\, \mathrm{d}t\) et on orthonormalise la famille \((v_1, v_2, v_3) = (1, X, X^2)\). On pose \(w_1 = v_1 = 1\). Alors \(w_2 = X - \frac{\langle X, w_1 \rangle}{\|w_1\|^2}\, w_1 = X\) car \(\int_{-1}^{1} t\, \mathrm{d}t = 0\). Ensuite \(w_3 = X^2 - \frac{\langle X^2, w_1 \rangle}{\|w_1\|^2}\, w_1 - \frac{\langle X^2, w_2 \rangle}{\|w_2\|^2}\, w_2\) ; avec \(\int_{-1}^{1} t^2\, \mathrm{d}t = \tfrac{2}{3}\), \(\|w_1\|^2 = 2\), \(\int_{-1}^{1} t^3\, \mathrm{d}t = 0\), on obtient \(w_3 = X^2 - \tfrac{1}{3}\). En normalisant (\(\|w_1\|^2 = 2\), \(\|w_2\|^2 = \tfrac{2}{3}\), \(\|w_3\|^2 = \tfrac{8}{45}\)) on obtient la famille orthonormée $$ \Big( \tfrac{1}{\sqrt{2}},\ \sqrt{\tfrac{3}{2}}\, X,\ \tfrac{3\sqrt{5}}{2\sqrt{2}}\big(X^2 - \tfrac{1}{3}\big) \Big). $$ Exemple — Gram-Schmidt dans le plan \(\mathbb{R}^2\)
Sur \(\mathbb{R}^2\) canonique, orthonormaliser \(v_1 = (1 \,;\, 1)\), \(v_2 = (1 \,;\, 0)\). Alors \(w_1 = (1 \,;\, 1)\), \(\|w_1\|^2 = 2\) ; \(w_2 = (1 \,;\, 0) - \frac{\langle (1 \,;\, 0), (1 \,;\, 1) \rangle}{2}(1 \,;\, 1) = (1 \,;\, 0) - \tfrac{1}{2}(1 \,;\, 1) = \big(\tfrac{1}{2} \,;\, -\tfrac{1}{2}\big)\). En normalisant : \(e_1 = \tfrac{1}{\sqrt{2}}(1 \,;\, 1)\), \(e_2 = \tfrac{1}{\sqrt{2}}(1 \,;\, -1)\) — une base orthonormée dirigée selon les deux directions diagonales du carré unité. Compétences à pratiquer
- Exécuter Gram-Schmidt
IV.2
Existence d'une base orthonormée
Gram-Schmidt a une récolte immédiate : tout espace euclidien possède une base orthonormée, et toute famille orthonormée peut être complétée en une base orthonormée. Ces deux faits sont utilisés librement désormais.
Théorème — Existence et complétion d'une base orthonormée
Soit \(E\) un espace euclidien (dimension finie \(n \ge 1\)). - \(E\) possède une base orthonormée.
- Toute famille orthonormée de \(E\) peut être complétée en une base orthonormée (théorème de la base incomplète, version orthonormée).
(1) On prend une base quelconque de \(E\) et on lui applique Gram-Schmidt : le résultat est une famille orthonormée de \(n = \dim E\) vecteurs, donc (étant libre) une base orthonormée. (2) Soit \((e_1, \dots, e_r)\) orthonormée, donc libre. On la complète en une base \((e_1, \dots, e_r, v_{r+1}, \dots, v_n)\) par le théorème de la base incomplète ordinaire, puis on applique Gram-Schmidt à toute la famille : comme \((e_1, \dots, e_r)\) est déjà orthonormée, l'algorithme la laisse inchangée (chaque étape retranche la projection, ici nulle) et n'orthonormalise que les vecteurs ajoutés.
Exemple — Une base orthonormée d'un plan de \(\mathbb{R}^3\)
Sur \(\mathbb{R}^3\) canonique, le plan \(P : x + y + z = 0\) est engendré par \(a = (1 \,;\, -1 \,;\, 0)\) et \(b = (1 \,;\, 0 \,;\, -1)\). Gram-Schmidt : \(w_1 = a\), \(\|a\|^2 = 2\) ; \(w_2 = b - \frac{\langle b, a \rangle}{2} a = (1 \,;\, 0 \,;\, -1) - \tfrac{1}{2}(1 \,;\, -1 \,;\, 0) = \big(\tfrac{1}{2} \,;\, \tfrac{1}{2} \,;\, -1\big)\). En normalisant on obtient \(e_1 = \tfrac{1}{\sqrt{2}}(1 \,;\, -1 \,;\, 0)\) et \(e_2 = \tfrac{1}{\sqrt{6}}(1 \,;\, 1 \,;\, -2)\) : une base orthonormée de \(P\). Compétences à pratiquer
- Reconnaître une base orthonormée
IV.3
Coordonnées, produit scalaire et norme dans une base orthonormée
Tout l'intérêt d'une base orthonormée est que le produit scalaire devient le produit scalaire canonique des vecteurs de coordonnées. Les coordonnées se lisent par produits scalaires, et la norme est la racine de la somme des carrés des coordonnées — Pythagore à l'œuvre.
Théorème — Calculs dans une base orthonormée
Soit \(E\) un espace euclidien et \(\mathcal{B} = (e_1, \dots, e_n)\) une base orthonormée. Pour tous \(x, y \in E\) de colonnes de coordonnées \(X = (x_1 \,;\, \dots \,;\, x_n)^{\top}\) et \(Y = (y_1 \,;\, \dots \,;\, y_n)^{\top}\) dans \(\mathcal{B}\) : $$ \textcolor{colorprop}{x = \sum_{i = 1}^n \langle x, e_i \rangle\, e_i}, \qquad \textcolor{colorprop}{\langle x, y \rangle = X^{\top} Y = \sum_{i = 1}^n x_i\, y_i}, \qquad \textcolor{colorprop}{\|x\|^2 = \sum_{i = 1}^n \langle x, e_i \rangle^2}. $$ La \(i\)-ème coordonnée de \(x\) vaut exactement \(x_i = \langle x, e_i \rangle\).
On écrit \(x = \sum_j x_j e_j\) dans la base \(\mathcal{B}\). En prenant le produit scalaire avec \(e_i\) et en utilisant \(\langle e_j, e_i \rangle = \delta_{i, j}\), \(\langle x, e_i \rangle = \sum_j x_j \langle e_j, e_i \rangle = x_i\) ; cela prouve la formule des coordonnées et \(x = \sum_i \langle x, e_i \rangle e_i\). Puis, par bilinéarité, $$ \langle x, y \rangle = \Big\langle \sum_i x_i e_i, \sum_j y_j e_j \Big\rangle = \sum_{i, j} x_i y_j \langle e_i, e_j \rangle = \sum_i x_i y_i = X^{\top} Y, $$ et \(\|x\|^2 = \langle x, x \rangle = \sum_i x_i^2 = \sum_i \langle x, e_i \rangle^2\).
Exemple — Lire les coordonnées par produits scalaires
Sur \(\mathbb{R}^2\) avec la base orthonormée \(e_1 = \tfrac{1}{\sqrt{2}}(1 \,;\, 1)\), \(e_2 = \tfrac{1}{\sqrt{2}}(1 \,;\, -1)\), les coordonnées de \(x = (3 \,;\, 1)\) sont \(\langle x, e_1 \rangle = \tfrac{1}{\sqrt{2}}(3 + 1) = 2\sqrt{2}\) et \(\langle x, e_2 \rangle = \tfrac{1}{\sqrt{2}}(3 - 1) = \sqrt{2}\). Vérification : \(\langle x, e_1 \rangle^2 + \langle x, e_2 \rangle^2 = 8 + 2 = 10 = 3^2 + 1^2 = \|x\|^2\). Compétences à pratiquer
- Lire des coordonnées en base orthonormée
V
Projection orthogonale sur un sous-espace de dimension finie
V.1
Supplémentaire orthogonal d'un sous-espace de dimension finie
L'ossature géométrique de la section est : un sous-espace \(F\) de dimension finie et son orthogonal \(F^{\perp}\) remplissent ensemble tout l'espace, \(E = F \oplus F^{\perp}\). C'est ce qui permet de décomposer tout vecteur en « sa part dans \(F\) » plus « sa part orthogonale à \(F\) ». La dimension finie de \(F\) est l'hypothèse utilisée — la preuve construit une base orthonormée de \(F\) par Gram-Schmidt ; \(E\) lui-même peut être de dimension infinie.
Théorème — Supplémentaire orthogonal
Soit \(E\) un espace préhilbertien réel et \(F\) un sous-espace de \(E\) de dimension finie. Alors \(F\) et \(F^{\perp}\) sont supplémentaires : $$ \textcolor{colorprop}{E = F \oplus F^{\perp}}. $$ \(F^{\perp}\) est appelé le supplémentaire orthogonal de \(F\). Lorsque \(E\) lui-même est de dimension finie, \(\dim F^{\perp} = \dim E - \dim F\) et \((F^{\perp})^{\perp} = F\).
Si \(F = \{0_E\}\) alors \(F^{\perp} = E\) et \(E = F \oplus F^{\perp}\) est immédiat, donc on suppose \(\dim F = r \ge 1\). D'abord \(F \cap F^{\perp} = \{0_E\}\) : un vecteur orthogonal à lui-même est \(0_E\). On choisit ensuite une base orthonormée \((e_1, \dots, e_r)\) de \(F\) (Gram-Schmidt, \(F\) de dimension finie). Pour \(x \in E\) on pose \(x_1 = \sum_{k = 1}^r \langle x, e_k \rangle\, e_k \in F\) et \(x_2 = x - x_1\). Pour chaque \(i\), $$ \langle x_2, e_i \rangle = \langle x, e_i \rangle - \sum_{k = 1}^r \langle x, e_k \rangle \langle e_k, e_i \rangle = \langle x, e_i \rangle - \langle x, e_i \rangle = 0, $$ donc \(x_2 \perp e_i\) pour tout \(i\), d'où \(x_2 \in F^{\perp}\). Ainsi \(x = x_1 + x_2\) avec \(x_1 \in F\), \(x_2 \in F^{\perp}\) : \(E = F + F^{\perp}\), et la somme est directe. Les énoncés sur la dimension et le bi-orthogonal découlent en dimension finie de \(\dim F + \dim F^{\perp} = \dim E\) et de \(F \subseteq (F^{\perp})^{\perp}\) avec des dimensions égales.
Compétences à pratiquer
- Dimension du supplémentaire orthogonal
V.2
Projection orthogonale
La décomposition \(E = F \oplus F^{\perp}\) fournit un projecteur : la projection orthogonale \(p_F\) sur \(F\), parallèlement à \(F^{\perp}\). Elle a une formule close dans toute base orthonormée de \(F\) et une caractérisation géométrique qui est l'outil de travail de tout calcul : \(p_F(x)\) est le point de \(F\) dont l'erreur \(x - p_F(x)\) est orthogonale à \(F\).
Définition — Projection orthogonale
Soit \(F\) un sous-espace de dimension finie de \(E\). La projection orthogonale sur \(F\) est la projection \(p_F\) sur \(F\) parallèlement à \(F^{\perp}\), associée à la décomposition \(E = F \oplus F^{\perp}\) : pour \(x = x_1 + x_2\) avec \(x_1 \in F\) et \(x_2 \in F^{\perp}\), \(p_F(x) = x_1\). Théorème — Formule et caractérisation de la projection orthogonale
Soit \(F\) de dimension finie de base orthonormée \((u_1, \dots, u_r)\). Pour tout \(x \in E\) : $$ \textcolor{colorprop}{p_F(x) = \sum_{i = 1}^r \langle x, u_i \rangle\, u_i}. $$ De plus \(p_F(x)\) est caractérisé géométriquement par $$ \textcolor{colorprop}{p_F(x) \in F \qquad\text{et}\qquad x - p_F(x) \in F^{\perp}}. $$ En particulier, sur une droite \(F = \operatorname{Vect}(u)\) avec \(\|u\| = 1\), \(p_F(x) = \langle x, u \rangle\, u\).
La preuve du théorème du supplémentaire orthogonal a construit \(x = x_1 + x_2\) avec \(x_1 = \sum_i \langle x, u_i \rangle u_i \in F\) et \(x_2 = x - x_1 \in F^{\perp}\). Par définition \(p_F(x) = x_1\), ce qui est la formule annoncée et vérifie \(p_F(x) \in F\), \(x - p_F(x) = x_2 \in F^{\perp}\). Réciproquement, si \(z \in F\) et \(x - z \in F^{\perp}\), alors \(z - p_F(x) \in F\) et vaut \((x - p_F(x)) - (x - z) \in F^{\perp}\), donc appartient à \(F \cap F^{\perp} = \{0_E\}\) : \(z = p_F(x)\). La caractérisation est donc exacte.
Méthode — Calculer une projection orthogonale
- Si une base orthonormée \((u_1, \dots, u_r)\) de \(F\) est connue : appliquer directement \(p_F(x) = \sum_i \langle x, u_i \rangle u_i\) (exécuter d'abord Gram-Schmidt si la base donnée n'est pas orthonormée).
- Sinon : écrire \(p_F(x) \in F\) avec des coordonnées inconnues, imposer \(x - p_F(x) \perp f\) pour chaque \(f\) d'une base de \(F\), et résoudre le système linéaire obtenu.
Exemple — Projection sur une droite de \(\mathbb{R}^3\)
Sur \(\mathbb{R}^3\) canonique, projeter \(x = (1 \,;\, 2 \,;\, 3)\) sur \(D = \operatorname{Vect}(1 \,;\, 1 \,;\, 1)\). Un vecteur unitaire de \(D\) est \(u = \tfrac{1}{\sqrt{3}}(1 \,;\, 1 \,;\, 1)\), donc \(\langle x, u \rangle = \tfrac{1}{\sqrt{3}}(1 + 2 + 3) = 2\sqrt{3}\) et \(p_D(x) = \langle x, u \rangle\, u = 2\sqrt{3} \cdot \tfrac{1}{\sqrt{3}}(1 \,;\, 1 \,;\, 1) = (2 \,;\, 2 \,;\, 2)\). Vérification : \(x - p_D(x) = (-1 \,;\, 0 \,;\, 1) \perp (1 \,;\, 1 \,;\, 1)\). 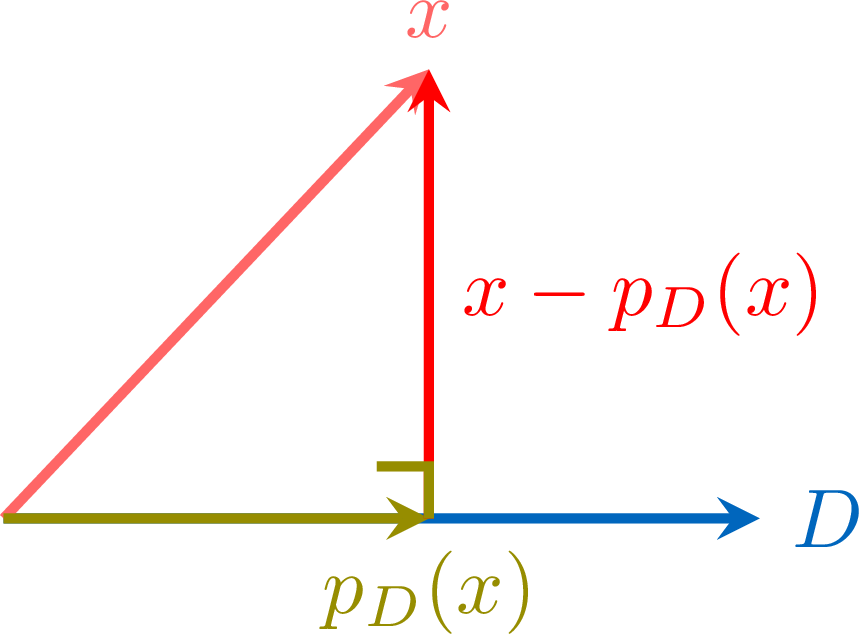
Exemple — Projection d'une matrice sur le sous-espace symétrique
Sur \(\mathcal{M}_n(\mathbb{R})\) muni du produit de Frobenius, \(\mathcal{S}_n(\mathbb{R})\) et \(\mathcal{A}_n(\mathbb{R})\) sont supplémentaires (toute matrice s'écrit \(\tfrac{1}{2}(A + A^{\top}) + \tfrac{1}{2}(A - A^{\top})\), symétrique plus antisymétrique) et orthogonaux (vu plus haut), donc \(\mathcal{A}_n(\mathbb{R}) = \mathcal{S}_n(\mathbb{R})^{\perp}\). La projection orthogonale de \(A\) sur \(\mathcal{S}_n(\mathbb{R})\) est la partie symétrique \(p(A) = \tfrac{1}{2}(A + A^{\top})\) : en effet \(\tfrac{1}{2}(A + A^{\top}) \in \mathcal{S}_n(\mathbb{R})\) et \(A - \tfrac{1}{2}(A + A^{\top}) = \tfrac{1}{2}(A - A^{\top}) \in \mathcal{A}_n(\mathbb{R}) = \mathcal{S}_n(\mathbb{R})^{\perp}\), ce qui est la caractérisation géométrique. Compétences à pratiquer
- Calculer une projection orthogonale
V.3
Distance à un sous-espace et moindres carrés
La projection orthogonale résout un problème de minimisation : parmi tous les points de \(F\), le plus proche de \(x\) est exactement \(p_F(x)\). C'est le théorème des moindres carrés, le moteur de l'ajustement de données. Le théorème de Pythagore donne alors la distance sous forme close et l'inégalité de Bessel.
Théorème — Distance à un sous-espace et moindres carrés
Soit \(F\) un sous-espace de dimension finie de \(E\) et \(x \in E\). La distance de \(x\) à \(F\) est \(d(x, F) = \inf_{y \in F} \|x - y\|\). Alors : - la borne inférieure est un minimum, atteint en l'unique point \(p_F(x)\) : $$ \textcolor{colorprop}{d(x, F) = \|x - p_F(x)\|}; $$
- (Pythagore) \(\textcolor{colorprop}{\|x\|^2 = \|p_F(x)\|^2 + d(x, F)^2}\);
- (inégalité de Bessel) \(\textcolor{colorprop}{\|p_F(x)\| \le \|x\|}\), avec égalité ssi \(x \in F\).
Soit \(y \in F\). On écrit \(x - y = \big(x - p_F(x)\big) + \big(p_F(x) - y\big)\). Le premier terme est dans \(F^{\perp}\), le second dans \(F\), donc ils sont orthogonaux et Pythagore donne $$ \|x - y\|^2 = \|x - p_F(x)\|^2 + \|p_F(x) - y\|^2 \ge \|x - p_F(x)\|^2, $$ avec égalité ssi \(p_F(x) - y = 0_E\), soit \(y = p_F(x)\). La borne inférieure est donc atteinte seulement en \(p_F(x)\) et vaut \(\|x - p_F(x)\|\) : assertion (1). En appliquant la même décomposition orthogonale à \(x = p_F(x) + (x - p_F(x))\) on obtient \(\|x\|^2 = \|p_F(x)\|^2 + \|x - p_F(x)\|^2\) : assertion (2) ; en supprimant le terme positif \(d(x, F)^2\) on obtient \(\|p_F(x)\|^2 \le \|x\|^2\), avec égalité ssi \(d(x, F) = 0\), soit \(x = p_F(x) \in F\) : assertion (3).
Lecture géométrique. \(p_F(x)\) est le « pied de la perpendiculaire » abaissée de \(x\) sur \(F\), et \(d(x, F)\) est la longueur de cette perpendiculaire — le plus court chemin de \(x\) à \(F\). 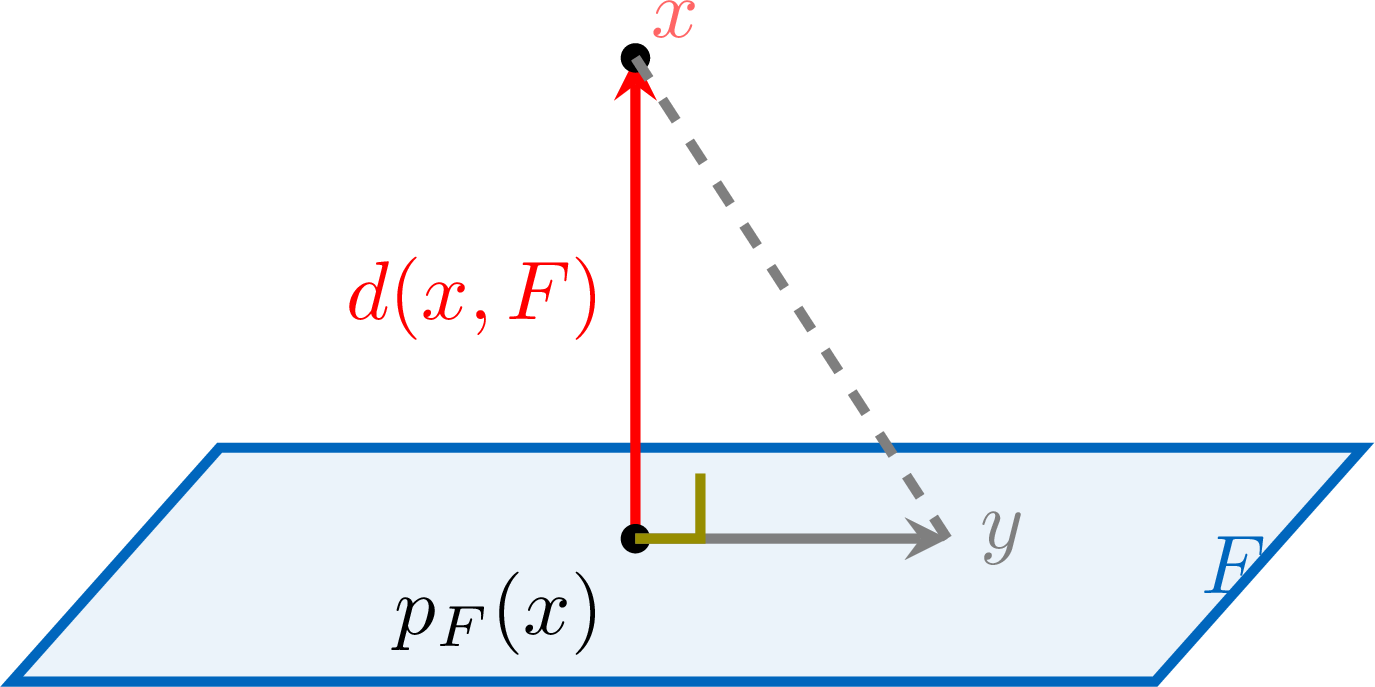
Méthode — Calculer une distance à un sous-espace
- Étape 1. Trouver une base orthonormée de \(F\) (Gram-Schmidt si nécessaire).
- Étape 2. Calculer \(p_F(x) = \sum_i \langle x, u_i \rangle u_i\).
- Étape 3. Alors \(d(x, F) = \|x - p_F(x)\|\), ou utiliser \(d(x, F)^2 = \|x\|^2 - \|p_F(x)\|^2 = \|x\|^2 - \sum_i \langle x, u_i \rangle^2\).
Exemple — Une minimisation moindres carrés sur les polynômes
On munit \(C^0([0 \,;\, 1], \mathbb{R})\) de \(\langle f, g \rangle = \int_0^1 f(t) g(t)\,\mathrm{d}t\) et on minimise \(\int_0^1 (t^2 - a t - b)^2\, \mathrm{d}t\) sur \((a, b) \in \mathbb{R}^2\). C'est \(d(x, F)^2\) pour \(x : t \mapsto t^2\) et \(F = \mathbb{R}_1[X] = \operatorname{Vect}(1, X)\) : le minimum est atteint en la projection orthogonale \(p_F(x) = a X + b\). Les conditions d'orthogonalité \(\langle x - p_F(x), 1 \rangle = 0\) et \(\langle x - p_F(x), X \rangle = 0\) donnent le système \(a/2 + b = 1/3\), \(a/3 + b/2 = 1/4\), d'où \(a = 1\), \(b = -1/6\), et la valeur minimale vaut \(\int_0^1 (t^2 - t + \tfrac{1}{6})^2\, \mathrm{d}t = \tfrac{1}{180}\). Compétences à pratiquer
- Mesurer une distance à un sous-espace
VI
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section