Éducation Nationale Française · PT
Compléments d'algèbre linéaire
Le cours de première année a construit le langage de travail de l'algèbre linéaire : dimension, bases, somme \(F + G\) et somme directe \(F \oplus G\) de deux sous-espaces, sous-espaces supplémentaires, matrice d'une application linéaire. Ce chapitre en est la continuation directe, en quatre étapes, chacune ajoutant un outil et — comme le demande le programme — appuyée sur des figures en dimension \(2\) et \(3\).
(1) La somme et la somme directe d'une famille finie \(F_1, \dots, F_p\) de sous-espaces, avec les bases adaptées à une décomposition \(E = F_1 \oplus \dots \oplus F_p\). (2) Les sous-espaces stables d'un endomorphisme et l'endomorphisme induit : lorsqu'on choisit une base commençant par une base d'un sous-espace stable, la stabilité devient un bloc nul de la matrice, et une décomposition de \(E\) en sous-espaces stables rend la matrice diagonale par blocs. (3) La trace, l'invariant scalaire attaché à une matrice carrée et à un endomorphisme, avec les formules \(\mathrm{tr}(AB) = \mathrm{tr}(BA)\) et l'invariance par similitude. (4) Les hyperplans d'un espace de dimension finie — les sous-espaces auxquels il ne manque qu'une dimension — leurs équations, et la lecture d'un système d'équations linéaires comme intersection d'hyperplans.
Les deux premières étapes relient le point de vue géométrique (un sous-espace, une décomposition) et le point de vue matriciel (un bloc nul, une matrice diagonale par blocs) — passer de l'un à l'autre, dans les deux sens, est la compétence centrale du chapitre.
Notations permanentes. \(\mathbb{K}\) désigne \(\mathbb{R}\) ou \(\mathbb{C}\). \(E\) est un \(\mathbb{K}\)-espace vectoriel, de dimension finie sauf mention contraire. Les sous-espaces sont notés \(F, G, F_1, \dots, F_p\) avec \(p \geq 1\). On note \(\dim E\) la dimension, \(\operatorname{Vect}(\cdot)\) le sous-espace engendré, \(\mathcal{L}(E)\) les endomorphismes de \(E\), et \(\operatorname{Mat}_{\mathcal{B}}(u)\) la matrice de \(u \in \mathcal{L}(E)\) dans une base \(\mathcal{B}\). La somme et la somme directe de deux sous-espaces, les sous-espaces supplémentaires, la formule de Grassmann, la matrice d'une application linéaire et la formule de changement de base, le déterminant et sa multiplicativité, sont ceux du cours de première année et sont utilisés ici sans redémonstration.
I
Produit d'espaces vectoriels, somme et somme directe de sous-espaces
I.1
Produit d'une famille finie d'espaces vectoriels
Définition — Produit d'une famille finie d'espaces vectoriels
Soient \(E_1, \dots, E_p\) des \(\mathbb{K}\)-espaces vectoriels, \(p \geq 1\). Leur produit cartésien \(E_1 \times \dots \times E_p\) est l'ensemble des \(p\)-uplets $$ E_1 \times \dots \times E_p = \bigl\{\, (x_1, \dots, x_p) \ :\ x_i \in E_i \text{ pour tout } i \,\bigr\}. $$ Il devient un \(\mathbb{K}\)-espace vectoriel pour les opérations coordonnées par coordonnées : $$ (x_1, \dots, x_p) + (y_1, \dots, y_p) = (x_1 + y_1, \dots, x_p + y_p), \qquad \lambda \cdot (x_1, \dots, x_p) = (\lambda x_1, \dots, \lambda x_p). $$ Exemple — Le produit familier de trois copies de \(\mathbb{R}\)
L'espace \(\mathbb{R}^3\) est le produit de trois copies de \(\mathbb{R}\), avec la structure coordonnées par coordonnées déjà utilisée en première année. Plus généralement, \(\mathbb{K}^p = \mathbb{K} \times \dots \times \mathbb{K}\) (\(p\) facteurs). On peut aussi mélanger : \(\mathbb{R}^2 \times \mathbb{R}[X]\) associe un couple \((a, b) \in \mathbb{R}^2\) à un polynôme \(P \in \mathbb{R}[X]\), avec \(\bigl((a,b), P\bigr) + \bigl((a',b'), P'\bigr) = \bigl((a+a', b+b'), P+P'\bigr)\). Proposition — Dimension d'un produit fini
Si \(E_1, \dots, E_p\) sont de dimension finie, alors \(E_1 \times \dots \times E_p\) est de dimension finie, avec $$ \textcolor{colorprop}{\dim(E_1 \times \dots \times E_p) = \dim E_1 + \dots + \dim E_p.} $$ Une base s'obtient en concaténant, pour chaque \(i\), la famille \(\bigl((0_{E_1}, \dots, 0_{E_{i-1}}, e_{i,j}, 0_{E_{i+1}}, \dots, 0_{E_p})\bigr)_j\) où \((e_{i,j})_j\) est une base de \(E_i\) ; soit le \(p\)-uplet dont la seule composante non nulle est la \(i\)-ème, égale à un vecteur de base de \(E_i\). Compétences à pratiquer
- Calculer dans un espace produit
I.2
Somme d'une famille finie de sous-espaces
Dans Espaces vectoriels de dimension finie, la somme \(F + G\) de deux sous-espaces a été définie comme l'ensemble des \(x + y\) avec \(x \in F\) et \(y \in G\), et reconnue comme le plus petit sous-espace contenant les deux. Rien dans cette idée n'est propre à deux sous-espaces. Cette sous-section la généralise à une famille finie \(F_1, \dots, F_p\) : la somme est encore un sous-espace, encore le plus petit contenant chaque \(F_i\).
Définition — Somme d'une famille finie de sous-espaces
Soient \(F_1, \dots, F_p\) des sous-espaces de \(E\). Leur somme, notée \(\sum_{i=1}^p F_i\) ou \(F_1 + \dots + F_p\), est l'ensemble des sommes d'un vecteur pris dans chaque \(F_i\) : $$ \sum_{i=1}^p F_i = \left\{\, x_1 + x_2 + \dots + x_p \ :\ x_i \in F_i \text{ pour tout } i \,\right\}. $$ Exemple — Trois droites de coordonnées de \(\mathbb{R}^3\)
Soit \((e_1, e_2, e_3)\) la base canonique de \(\mathbb{R}^3\) et \(D_i = \operatorname{Vect}(e_i)\). Une somme \(x_1 e_1 + x_2 e_2 + x_3 e_3\) avec \(x_i \in \mathbb{R}\) est le vecteur général de \(\mathbb{R}^3\), donc \(D_1 + D_2 + D_3 = \mathbb{R}^3\) : trois droites passant par l'origine, non contenues dans un plan commun, remplissent déjà l'espace tout entier. Exemple — Deux plans de \(\mathbb{R}^3\)
Prenons \(P_1 = \operatorname{Vect}(e_1, e_2)\) et \(P_2 = \operatorname{Vect}(e_2, e_3)\), deux plans distincts de \(\mathbb{R}^3\). Tout \(x = (a, b, c)\) vaut \((a, b - c, 0) + (0, c, c)\) avec le premier terme dans \(P_1\) et le second dans \(P_2\), donc \(P_1 + P_2 = \mathbb{R}^3\). Deux plans dont l'intersection se réduit à la droite \(\operatorname{Vect}(e_2)\) engendrent déjà l'espace. Proposition — La somme est le plus petit sous-espace contenant chaque terme
Soient \(F_1, \dots, F_p\) des sous-espaces de \(E\). Alors \(\sum_{i=1}^p F_i\) est un sous-espace de \(E\), il contient chaque \(F_i\), et il est contenu dans tout sous-espace de \(E\) contenant chaque \(F_i\) — c'est leur plus petit majorant commun.
Notons \(S = \sum_{i=1}^p F_i\). Le vecteur nul vaut \(0 = 0 + \dots + 0\) avec chaque terme dans \(F_i\), donc \(0 \in S\). Si \(x = \sum x_i\) et \(y = \sum y_i\) sont dans \(S\) (avec \(x_i, y_i \in F_i\)) et \(\lambda \in \mathbb{K}\), alors \(\lambda x + y = \sum (\lambda x_i + y_i)\), et chaque \(\lambda x_i + y_i \in F_i\) puisque \(F_i\) est un sous-espace ; donc \(\lambda x + y \in S\). Ainsi \(S\) est un sous-espace. Chaque \(F_j\) est contenu dans \(S\) : un vecteur \(x_j \in F_j\) vaut \(0 + \dots + x_j + \dots + 0 \in S\). Enfin, soit \(H\) un sous-espace contenant chaque \(F_i\) ; pour \(x = \sum x_i \in S\), chaque \(x_i \in F_i \subset H\), et \(H\) est stable par somme, donc \(x \in H\). Ainsi \(S \subset H\).
Un vecteur de la somme est, par définition, exprimable comme somme de morceaux pris dans les \(F_i\). La figure montre une telle décomposition, les morceaux disposés bout à bout. 
Ici \(x = x_1 + x_2 + x_3\) avec \(x_i \in F_i\).
Méthode — Montrer qu'un vecteur appartient à une somme, ou calculer une somme
Pour démontrer \(x \in F_1 + \dots + F_p\), exhiber une décomposition \(x = x_1 + \dots + x_p\) avec chaque \(x_i \in F_i\). Pour démontrer une égalité \(F_1 + \dots + F_p = H\), démontrer les deux inclusions : \(\subset\) a lieu, une fois \(H\) reconnu comme un sous-espace contenant chaque \(F_i\), par la propriété du « plus petit sous-espace » ; \(\supset\) revient à décomposer tout vecteur de \(H\). Compétences à pratiquer
- Calculer une somme de sous-espaces
I.3
Somme directe et ses caractérisations
Pour deux sous-espaces, \(F \oplus G\) signifiait que tout vecteur de \(F + G\) se décompose d'exactement une façon. La même exigence — l'unicité de la décomposition — définit la somme directe d'une famille finie. L'intérêt est pratique : un seul critère rend « la somme est directe » vérifiable. C'est le critère du vecteur nul : la seule façon d'écrire \(0\) comme somme de morceaux pris dans les \(F_i\) est la triviale. En dimension finie, les dimensions d'une somme directe s'ajoutent, ce qui donne une seconde voie commode pour deux sous-espaces et pour une famille remplissant un espace connu.
Définition — Somme directe d'une famille finie
Les sous-espaces \(F_1, \dots, F_p\) sont dits en somme directe lorsque tout vecteur \(x\) de \(\sum_{i=1}^p F_i\) admet une décomposition unique \(x = x_1 + \dots + x_p\) avec \(x_i \in F_i\). La somme se note alors \(\bigoplus_{i=1}^p F_i\) ou \(F_1 \oplus \dots \oplus F_p\). Exemple — Une somme directe et une somme non directe
Dans \(\mathbb{R}^3\) muni de la base canonique, \(\operatorname{Vect}(e_1) \oplus \operatorname{Vect}(e_2) \oplus \operatorname{Vect}(e_3) = \mathbb{R}^3\) : un vecteur \((a, b, c)\) ne s'écrit que \(a e_1 + b e_2 + c e_3\), les coordonnées étant uniques. Au contraire, avec \(F_1 = \operatorname{Vect}(e_1)\), \(F_2 = \operatorname{Vect}(e_2)\) et \(F_3 = \operatorname{Vect}(e_1 + e_2)\), le vecteur \(e_1 + e_2\) de \(F_1 + F_2 + F_3\) s'écrit à la fois \(e_1 + e_2 + 0\) et \(0 + 0 + (e_1 + e_2)\) : la somme \(F_1 + F_2 + F_3\) n'est pas directe. Proposition — Caractérisation par le vecteur nul
La somme \(\sum_{i=1}^p F_i\) est directe si et seulement si $$ \textcolor{colorprop}{x_1 + \dots + x_p = 0 \ \text{ avec } x_i \in F_i \quad \Longrightarrow \quad x_1 = \dots = x_p = 0.} $$ Autrement dit : la seule décomposition du vecteur nul est la décomposition triviale.
Si la somme est directe, le vecteur nul a une décomposition unique ; comme \(0 = 0 + \dots + 0\) en est une, c'est la seule, ce qui est l'implication annoncée. Réciproquement, supposons l'implication vraie, et soit \(x \in \sum F_i\) admettant deux décompositions \(x = \sum x_i = \sum x_i'\) avec \(x_i, x_i' \in F_i\). Par différence, \(\sum (x_i - x_i') = 0\) avec \(x_i - x_i' \in F_i\) ; l'implication force \(x_i - x_i' = 0\), soit \(x_i = x_i'\) pour tout \(i\). La décomposition de \(x\) est donc unique, et la somme est directe.
Un piège. « Les \(F_i\) ne se rencontrent qu'en \(0\) deux à deux » ne suffit pas à rendre la somme directe. Trois droites peuvent être deux à deux indépendantes sans vérifier le critère du vecteur nul. 
Prenons \(D_1 = \operatorname{Vect}(e_1)\), \(D_2 = \operatorname{Vect}(e_2)\), \(D_3 = \operatorname{Vect}(e_1 + e_2)\), trois droites distinctes de \(\mathbb{R}^2\). Deux à deux, deux droites distinctes ne se rencontrent qu'en \(0\). Pourtant \(e_1 + e_2 + \bigl(-(e_1 + e_2)\bigr) = 0\) est une décomposition non triviale de \(0\) sur \(D_1, D_2, D_3\) (chaque terme non nul dans sa droite), donc par le critère du vecteur nul, \(D_1 + D_2 + D_3\) n'est pas directe. La morale : toujours tester la directe par le critère du vecteur nul, jamais par les intersections deux à deux.
Proposition — Dimension d'une somme directe
Soient \(F_1, \dots, F_p\) des sous-espaces de dimension finie de \(E\). Alors $$ \dim\left(\sum_{i=1}^p F_i\right) \leq \dim F_1 + \dots + \dim F_p . $$ Lorsque la somme est directe, c'est une égalité : $$ \textcolor{colorprop}{\dim\left(\bigoplus_{i=1}^p F_i\right) = \dim F_1 + \dots + \dim F_p .} $$ Pour deux sous-espaces \(F\) et \(G\), la formule de Grassmann plus précise \(\dim(F + G) = \dim F + \dim G - \dim(F \cap G)\) donne : la somme \(F + G\) est directe si et seulement si \(\dim(F + G) = \dim F + \dim G\), soit \(F \cap G = \{0\}\).
Pour deux sous-espaces, la formule de Grassmann \(\dim(F + G) = \dim F + \dim G - \dim(F \cap G)\) est rappelée de la première année ; comme \(F \cap G = \{0\}\) exactement lorsque \(\dim(F \cap G) = 0\), l'équivalence annoncée en découle aussitôt, et \(F \cap G = \{0\}\) est le critère du vecteur nul pour deux sous-espaces.
Pour l'inégalité générale, choisissons une base \(\mathcal{B}_i\) de chaque \(F_i\) ; leur concaténation est une famille génératrice de \(\sum_i F_i\) comptant \(\dim F_1 + \dots + \dim F_p\) vecteurs, donc \(\dim(\sum_i F_i)\), taille d'une base extraite, est au plus ce nombre. Lorsque la somme est directe, cette concaténation est de plus libre : une combinaison nulle se regroupe, selon les \(F_i\), en \(y_1 + \dots + y_p = 0\) avec \(y_i \in F_i\), la directe force chaque \(y_i = 0\), et la liberté de \(\mathcal{B}_i\) force alors chaque coefficient à l'intérieur de \(\mathcal{B}_i\) à s'annuler. Libre et génératrice, la concaténation est une base de \(\bigoplus_i F_i\), d'où \(\dim(\bigoplus_i F_i) = \dim F_1 + \dots + \dim F_p\).
Pour l'inégalité générale, choisissons une base \(\mathcal{B}_i\) de chaque \(F_i\) ; leur concaténation est une famille génératrice de \(\sum_i F_i\) comptant \(\dim F_1 + \dots + \dim F_p\) vecteurs, donc \(\dim(\sum_i F_i)\), taille d'une base extraite, est au plus ce nombre. Lorsque la somme est directe, cette concaténation est de plus libre : une combinaison nulle se regroupe, selon les \(F_i\), en \(y_1 + \dots + y_p = 0\) avec \(y_i \in F_i\), la directe force chaque \(y_i = 0\), et la liberté de \(\mathcal{B}_i\) force alors chaque coefficient à l'intérieur de \(\mathcal{B}_i\) à s'annuler. Libre et génératrice, la concaténation est une base de \(\bigoplus_i F_i\), d'où \(\dim(\bigoplus_i F_i) = \dim F_1 + \dots + \dim F_p\).
Méthode — Démontrer qu'une somme est directe
Trois voies à ce niveau, à choisir selon les données : - Vecteur nul (la méthode de référence, toujours disponible). Supposer \(x_1 + \dots + x_p = 0\) avec \(x_i \in F_i\), et en déduire que chaque \(x_i = 0\). Pour deux sous-espaces, c'est exactement « montrer \(F \cap G = \{0\}\) ».
- Dimension (deux sous-espaces). Pour deux sous-espaces, vérifier \(\dim(F + G) = \dim F + \dim G\), soit \(F \cap G = \{0\}\).
- Base adaptée (une famille finie remplissant un espace connu). Lorsque \(\sum_i F_i = E\) avec \(E\) de dimension finie, concaténer une base de chaque \(F_i\) : par le critère de la base adaptée de la sous-section suivante, \(E = \bigoplus_i F_i\) exactement lorsque cette concaténation est une base de \(E\), ce qui — comme elle engendre déjà \(E\) — a lieu dès que son cardinal \(\dim F_1 + \dots + \dim F_p\) égale \(\dim E\).
Compétences à pratiquer
- Démontrer qu'une somme est directe
I.4
Décomposition d'un espace et bases adaptées
Lorsque la somme directe des \(F_i\) remplit l'espace entier, on dit que \(E\) est décomposé. Le cours de première année a construit, pour \(E = F \oplus G\), une base « adaptée » au découpage, en concaténant une base de \(F\) et une base de \(G\). La même construction fonctionne pour un nombre quelconque de termes, et donne le critère qui relie une décomposition à une base.
Définition — Décomposition et base adaptée
On dit que \(E\) est décomposé en la somme directe de \(F_1, \dots, F_p\) lorsque \(E = \bigoplus_{i=1}^p F_i\). Une base \(\mathcal{B}\) de \(E\) est adaptée à cette décomposition lorsqu'elle est la concaténation, dans l'ordre \(1, \dots, p\), d'une base \(\mathcal{B}_1\) de \(F_1\), puis d'une base \(\mathcal{B}_2\) de \(F_2\), …, puis d'une base \(\mathcal{B}_p\) de \(F_p\). Exemple — La base canonique de \(\mathbb{K}^n\)
Soit \(D_i = \operatorname{Vect}(e_i)\) la \(i\)-ième droite de coordonnées de \(\mathbb{K}^n\). Alors \(\mathbb{K}^n = D_1 \oplus \dots \oplus D_n\), et la base canonique \((e_1, \dots, e_n)\) — concaténation des bases à un vecteur \((e_i)\) des \(D_i\) — est adaptée à cette décomposition. Exemple — Les polynômes par degré
Dans \(\mathbb{K}_n[X]\), posons \(L_k = \operatorname{Vect}(X^k)\) pour \(k = 0, \dots, n\). Un polynôme de degré au plus \(n\) s'écrit de manière unique \(a_0 X^0 + a_1 X^1 + \dots + a_n X^n\), donc \(\mathbb{K}_n[X] = L_0 \oplus L_1 \oplus \dots \oplus L_n\), et la base monomiale \((1, X, \dots, X^n)\) est adaptée à cette décomposition. Proposition — Critère de la base adaptée
Soient \(F_1, \dots, F_p\) des sous-espaces de dimension finie de \(E\). Alors \(E = \bigoplus_{i=1}^p F_i\) si et seulement si, pour un — de façon équivalente, pour tout — choix d'une base \(\mathcal{B}_i\) de chaque \(F_i\), la concaténation \(\mathcal{B}_1, \dots, \mathcal{B}_p\) (dans cet ordre) est une base de \(E\).
Fixons une base \(\mathcal{B}_i\) de chaque \(F_i\) et soit \(\mathcal{C}\) leur concaténation.
- Si \(E = \bigoplus F_i\). La famille \(\mathcal{C}\) engendre \(E\), puisque \(E = \sum F_i\) et que chaque vecteur de \(F_i\) est combinaison de \(\mathcal{B}_i\). Elle est libre : une combinaison nulle de \(\mathcal{C}\) se regroupe, selon les \(F_i\), en \(y_1 + \dots + y_p = 0\) avec \(y_i \in F_i\) (la part dans \(F_i\) de la combinaison) ; la directe force chaque \(y_i = 0\), et la liberté de \(\mathcal{B}_i\) force alors chaque coefficient à l'intérieur de \(\mathcal{B}_i\) à s'annuler. Donc \(\mathcal{C}\) est une base de \(E\).
- Si \(\mathcal{C}\) est une base de \(E\). Alors \(E\) est engendré par \(\mathcal{C}\), donc \(E = \sum F_i\). Pour voir que la somme est directe, soit \(y_1 + \dots + y_p = 0\) avec \(y_i \in F_i\) ; en développant chaque \(y_i\) sur \(\mathcal{B}_i\), on en fait une combinaison nulle de \(\mathcal{C}\), donc tous les coefficients sont nuls par liberté, d'où chaque \(y_i = 0\). La caractérisation par le vecteur nul donne \(E = \bigoplus F_i\).
Remarque (lecture facultative). Lorsque \(E = \bigoplus_{i=1}^p F_i\), le regroupement \(E = F_i \oplus \bigl(\bigoplus_{j \neq i} F_j\bigr)\) vaut pour chaque \(i\), donc la projection \(p_i\) sur \(F_i\) parallèlement à \(\bigoplus_{j \neq i} F_j\) est bien définie. Ces projecteurs vérifient \(p_i^2 = p_i\) et \(p_1 + \dots + p_p = \operatorname{id}_E\). C'est une note annexe ; le chapitre ne la développe pas davantage.
Méthode — Construire une base adaptée à une décomposition
Étant donné \(E = \bigoplus_{i=1}^p F_i\) : choisir une base de chaque \(F_i\) séparément — les termes sont indépendants, aucune compatibilité à respecter — puis les écrire l'une après l'autre dans l'ordre \(1, \dots, p\). Le résultat est une base adaptée, et par le critère — \(E\) étant de dimension finie — son cardinal vaut \(\dim F_1 + \dots + \dim F_p = \dim E\).
La figure montre le plus petit cas non trivial : \(\mathbb{R}^3\) découpé en une droite plus un plan, avec une base adaptée — un vecteur engendrant la droite, deux engendrant le plan. 
\(\mathbb{R}^3 = D \oplus P\) : \((e_1, e_2)\) est une base du plan \(P\), \((e_3)\) une base de la droite \(D\), et \((e_1, e_2, e_3)\) est une base de \(\mathbb{R}^3\) adaptée à la décomposition.
Compétences à pratiquer
- Former une base adaptée
II
Sous-espaces stables et endomorphisme induit
II.1
Sous-espaces stables
Soit \(u\) un endomorphisme de \(E\). Un sous-espace sur lequel \(u\) « reste à l'intérieur » — renvoie tout vecteur du sous-espace dans le sous-espace — peut être étudié pour lui-même, sans le reste de \(E\). Un tel sous-espace est dit stable. Cette section définit la stabilité, donne des façons de la reconnaître, et la lit sur la matrice de \(u\).
Lire une matrice par blocs. L'outil matriciel ici est élémentaire : une matrice carrée est découpée par une ligne horizontale et une ligne verticale, tracées au même endroit, en quatre blocs \(\begin{pmatrix} A & C \\ B & D \end{pmatrix}\), avec \(A\) et \(D\) carrés. Une telle matrice est triangulaire supérieure par blocs lorsque le bloc en bas à gauche est nul (\(B = 0\)), et diagonale par blocs lorsque les deux blocs hors diagonale sont nuls (\(B = C = 0\)) ; une matrice diagonale par blocs de blocs diagonaux \(A_1, \dots, A_r\) se note \(\operatorname{Diag}(A_1, \dots, A_r)\). Le produit de deux telles matrices partitionnées se calcule bloc par bloc, en traitant les blocs comme des scalaires tout en conservant leur ordre de gauche à droite — la même règle que pour les matrices \(2 \times 2\), rappelée de la première année. Ces quelques mots sont toute la notation par blocs dont ce chapitre a besoin.
Lire une matrice par blocs. L'outil matriciel ici est élémentaire : une matrice carrée est découpée par une ligne horizontale et une ligne verticale, tracées au même endroit, en quatre blocs \(\begin{pmatrix} A & C \\ B & D \end{pmatrix}\), avec \(A\) et \(D\) carrés. Une telle matrice est triangulaire supérieure par blocs lorsque le bloc en bas à gauche est nul (\(B = 0\)), et diagonale par blocs lorsque les deux blocs hors diagonale sont nuls (\(B = C = 0\)) ; une matrice diagonale par blocs de blocs diagonaux \(A_1, \dots, A_r\) se note \(\operatorname{Diag}(A_1, \dots, A_r)\). Le produit de deux telles matrices partitionnées se calcule bloc par bloc, en traitant les blocs comme des scalaires tout en conservant leur ordre de gauche à droite — la même règle que pour les matrices \(2 \times 2\), rappelée de la première année. Ces quelques mots sont toute la notation par blocs dont ce chapitre a besoin.
Définition — Sous-espace stable
Soit \(u \in \mathcal{L}(E)\) et \(F\) un sous-espace de \(E\). On dit que \(F\) est stable par \(u\) — ou que \(u\) stabilise \(F\) — lorsque \(u(F) \subset F\), c'est-à-dire lorsque \(u(x) \in F\) pour tout \(x \in F\). Exemple — Sous-espaces toujours stables
Pour tout \(u \in \mathcal{L}(E)\), les sous-espaces \(\{0\}\) et \(E\) sont stables, puisque \(u(\{0\}) = \{0\}\) et \(u(E) \subset E\). Il en va de même de \(\operatorname{Ker} u\) — si \(u(x) = 0\) alors \(u(u(x)) = u(0) = 0\), donc \(u(x) \in \operatorname{Ker} u\) — et de \(\operatorname{Im} u\) — \(u(\operatorname{Im} u) \subset \operatorname{Im} u\) par définition de l'image. Exemple — Droites stables et une rotation
Pour \(x \neq 0\), la droite \(\mathbb{K}x\) est stable par \(u\) si et seulement si \(u(x) \in \mathbb{K}x\), soit \(u(x) = \lambda x\) pour un scalaire \(\lambda\) : une droite stable est une direction que \(u\) se contente de redimensionner. En conséquence la rotation de \(\mathbb{R}^2\) d'angle \(\theta \not\equiv 0 \ [\pi]\) ne stabilise aucune droite : une rotation d'un tel angle n'envoie aucun vecteur non nul sur un multiple de lui-même, donc ses seuls sous-espaces stables sont \(\{0\}\) et \(\mathbb{R}^2\). Proposition — Stabilité par une famille génératrice
Soit \(u \in \mathcal{L}(E)\) et \(F = \operatorname{Vect}(e_1, \dots, e_d)\) un sous-espace engendré par la famille \((e_1, \dots, e_d)\). Alors $$ \textcolor{colorprop}{F \text{ est stable par } u \iff u(e_k) \in F \text{ pour tout } k.} $$
Si \(F\) est stable, alors chaque \(e_k \in F\) donne \(u(e_k) \in F\). Réciproquement, supposons \(u(e_k) \in F\) pour tout \(k\). Un vecteur \(x \in F\) s'écrit \(x = \sum_k \lambda_k e_k\), donc par linéarité \(u(x) = \sum_k \lambda_k u(e_k)\), combinaison linéaire des vecteurs \(u(e_k)\), tous dans \(F\) ; comme \(F\) est un sous-espace, \(u(x) \in F\). D'où \(u(F) \subset F\).
Proposition — Des endomorphismes qui commutent préservent noyaux et images
Soient \(u, v \in \mathcal{L}(E)\) avec \(u \circ v = v \circ u\). Alors \(\operatorname{Ker} v\) et \(\operatorname{Im} v\) sont stables par \(u\). - Noyau. Soit \(x \in \operatorname{Ker} v\), donc \(v(x) = 0\). Alors \(v(u(x)) = u(v(x)) = u(0) = 0\), donc \(u(x) \in \operatorname{Ker} v\). D'où \(u(\operatorname{Ker} v) \subset \operatorname{Ker} v\).
- Image. \(u(\operatorname{Im} v) = \operatorname{Im}(u \circ v) = \operatorname{Im}(v \circ u) \subset \operatorname{Im} v\), l'égalité centrale étant la commutation \(u \circ v = v \circ u\) et la dernière inclusion ayant lieu car \(\operatorname{Im}(v \circ u) = v(u(E)) \subset v(E) = \operatorname{Im} v\).
Exemple — Un noyau stabilisé par un endomorphisme qui commute
Fixons \(u \in \mathcal{L}(E)\) et un scalaire \(\lambda\), et posons \(v = u - \lambda \operatorname{id}_E\). Comme \(u\) commute avec \(v\) (tous deux sont des polynômes en \(u\)), la Proposition précédente s'applique : \(\operatorname{Ker}(u - \lambda \operatorname{id}_E)\) est stable par \(u\). Plus généralement il est stable par tout endomorphisme commutant avec \(u\). Ce noyau réapparaîtra, nommé, au chapitre suivant. Méthode — Démontrer la stabilité d'un sous-espace
Pour démontrer \(F\) stable par \(u\) : si \(F\) est donné par une famille génératrice, vérifier que l'image de chaque générateur appartient à \(F\) — par la Proposition cela suffit. Si \(F\) est un noyau ou une image, chercher un endomorphisme qui commute avec l'application concernée. Pour démontrer \(F\) non stable, exhiber un vecteur \(x \in F\) avec \(u(x) \notin F\).
La figure montre la stabilité géométriquement : un plan \(F\) stable par \(u\) garde chacun de ses vecteurs à l'intérieur de \(F\) après application de \(u\). 
À la fois \(x\) et \(u(x)\) sont dans le plan \(F\) : appliquer \(u\) ne sort jamais de \(F\).
Compétences à pratiquer
- Démontrer la stabilité d'un sous-espace
II.2
Endomorphisme induit et forme triangulaire par blocs
Lorsque \(F\) est stable par \(u\), restreindre \(u\) à \(F\) produit une application de \(F\) dans \(F\) — un endomorphisme de \(F\) à part entière, l'endomorphisme induit. Choisir une base de \(E\) commençant par une base de \(F\) rend alors la stabilité visible dans la matrice : elle devient un bloc nul.
Définition — Endomorphisme induit
Soit \(u \in \mathcal{L}(E)\) et \(F\) un sous-espace stable par \(u\). L'endomorphisme induit par \(u\) sur \(F\), noté \(u_F\), est l'application \(u_F : F \to F\), \(x \mapsto u(x)\). Il est bien défini — car \(u(F) \subset F\), la valeur \(u(x)\) appartient à \(F\) — et c'est un endomorphisme de \(F\). Exemple — Deux endomorphismes induits
Prenons \(u \in \mathcal{L}(E)\). Sur le sous-espace stable \(\operatorname{Ker} u\), l'endomorphisme induit \(u_{\operatorname{Ker} u}\) est l'application nulle de \(\operatorname{Ker} u\), puisque \(u\) y est nul. Sur une droite stable \(\mathbb{K}x\) avec \(u(x) = \lambda x\), l'endomorphisme induit est l'homothétie de rapport \(\lambda\) de cette droite. Exemple — Endomorphisme induit et restriction
L'endomorphisme induit \(u_F\) et la restriction \(u_{|F}\) effectuent la même affectation \(x \mapsto u(x)\) sur \(F\) ; ce qui les distingue est l'ensemble d'arrivée déclaré. La restriction \(u_{|F} : F \to E\) a \(E\) pour ensemble d'arrivée ; c'est une application linéaire de \(F\) dans \(E\). L'endomorphisme induit \(u_F : F \to F\) est cette même application corestreinte à \(F\) comme ensemble d'arrivée — ce qui n'est légitime que parce que \(F\) est stable — et c'est un endomorphisme, donc il peut être composé avec lui-même, possède une matrice dans une base de \(F\), et ainsi de suite. Les deux applications prennent les mêmes valeurs ; elles diffèrent par leur ensemble d'arrivée déclaré, et seul \(u_F\) est un endomorphisme. Théorème — Traduction matricielle de la stabilité
Soit \(u \in \mathcal{L}(E)\), soit \(\mathcal{B} = (e_1, \dots, e_n)\) une base de \(E\), et soit \(F = \operatorname{Vect}(e_1, \dots, e_r)\) avec \(1 \le r \le n-1\). Écrivons la matrice en blocs pour le découpage \(r + (n-r)\) : $$ \operatorname{Mat}_{\mathcal{B}}(u) = \begin{pmatrix} A & C \\
B & D \end{pmatrix}. $$ Alors \(F\) est stable par \(u\) si et seulement si \(B = 0\), et dans ce cas \(A = \operatorname{Mat}_{(e_1, \dots, e_r)}(u_F)\) — le bloc en haut à gauche est la matrice de l'endomorphisme induit.
Un vecteur \(x \in F\) a pour colonne de coordonnées \(\begin{pmatrix} X \\ 0 \end{pmatrix}\) (les \(n-r\) dernières coordonnées sont nulles, car \(x\) est combinaison de \(e_1, \dots, e_r\)). Le produit par blocs donne la colonne de coordonnées de \(u(x)\) : $$ \operatorname{Mat}_{\mathcal{B}}(u(x)) = \begin{pmatrix} A & C \\
B & D \end{pmatrix}\begin{pmatrix} X \\
0 \end{pmatrix} = \begin{pmatrix} AX \\
BX \end{pmatrix}. $$ Or \(u(x) \in F\) signifie que ses \(n-r\) dernières coordonnées sont nulles, soit \(BX = 0\). Donc \(F\) est stable — \(u(x) \in F\) pour tout \(x \in F\) — si et seulement si \(BX = 0\) pour tout \(X \in \mathbb{K}^r\), ce qui a lieu si et seulement si \(B = 0\). Lorsque \(B = 0\), la colonne de \(u(x)\) est \(\begin{pmatrix} AX \\ 0 \end{pmatrix}\), donc les coordonnées de \(u_F(x)\) dans \((e_1, \dots, e_r)\) sont \(AX\) ; quand \(X\) parcourt les colonnes de coordonnées de \(F\), cela dit que \(A = \operatorname{Mat}_{(e_1, \dots, e_r)}(u_F)\).
Exemple — Lire la stabilité sur une matrice
Soit \(u \in \mathcal{L}(\mathbb{R}^3)\) de matrice \(\begin{pmatrix} 2 & 1 & 5 \\ 0 & 3 & 4 \\ 0 & 0 & 7 \end{pmatrix}\) dans la base canonique. Pour \(F = \operatorname{Vect}(e_1, e_2)\) le bloc en bas à gauche est \(\begin{pmatrix} 0 & 0 \end{pmatrix}\), nul, donc \(F\) est stable, et l'endomorphisme induit a pour matrice \(\begin{pmatrix} 2 & 1 \\ 0 & 3 \end{pmatrix}\) dans \((e_1, e_2)\). Pour \(G = \operatorname{Vect}(e_1)\) la colonne de \(u(e_1)\) est \((2, 0, 0)\), encore dans \(G\), donc \(G\) est aussi stable. Méthode — Utiliser un sous-espace stable pour triangulariser par blocs
Étant donné un sous-espace \(F\) stable par \(u\) : compléter une base de \(F\) en une base \(\mathcal{B}\) de \(E\). Dans \(\mathcal{B}\), la matrice de \(u\) est automatiquement triangulaire supérieure par blocs, \(\begin{pmatrix} A & C \\ 0 & D \end{pmatrix}\), avec \(A\) la matrice de l'endomorphisme induit \(u_F\). C'est l'étape standard pour commencer à simplifier la matrice d'un endomorphisme.
La figure consigne la forme : un \(F\) stable engendré par les premiers vecteurs de base force le bloc en bas à gauche à s'annuler, laissant \(\operatorname{Mat}(u_F)\) en haut. 
\(F = \operatorname{Vect}(e_1, \dots, e_r)\) stable : le bloc en bas à gauche est nul.
Compétences à pratiquer
- Identifier un endomorphisme induit
II.3
Décomposition en sous-espaces stables
Le chapitre boucle maintenant. Un seul sous-espace stable rendait la matrice triangulaire par blocs ; toute une décomposition de \(E\) en sous-espaces stables la rend diagonale par blocs. Chaque bloc diagonal est la matrice d'un endomorphisme induit, et l'endomorphisme \(u\) a été découpé en pièces indépendantes, une par terme.
Théorème — Forme diagonale par blocs sur une décomposition stable
Soit \(u \in \mathcal{L}(E)\), supposons \(E = \bigoplus_{i=1}^p F_i\) avec chaque \(F_i \neq \{0\}\), et fixons une base \(\mathcal{B}\) adaptée à cette décomposition. Alors chaque \(F_i\) est stable par \(u\) si et seulement si \(\operatorname{Mat}_{\mathcal{B}}(u)\) est diagonale par blocs, \(\operatorname{Mat}_{\mathcal{B}}(u) = \operatorname{Diag}(A_1, \dots, A_p)\) pour le découpage \(\dim F_1, \dots, \dim F_p\). Dans ce cas chaque bloc diagonal \(A_i\) est la matrice de l'endomorphisme induit par \(u\) sur \(F_i\), dans la base de \(F_i\) extraite de \(\mathcal{B}\).
La base adaptée \(\mathcal{B}\) groupe ses vecteurs en \(p\) tranches consécutives, la \(i\)-ième tranche étant une base de \(F_i\) ; partitionnons \(\operatorname{Mat}_{\mathcal{B}}(u)\) en \(p \times p\) blocs en conséquence, le bloc \((i, j)\) ayant pour taille \(\dim F_i \times \dim F_j\). Le bloc-colonne \(j\) contient les colonnes de coordonnées des vecteurs \(u(e)\) pour \(e\) dans la base de \(F_j\). Par le critère de la famille génératrice, \(F_j\) est stable par \(u\) exactement lorsque chacun de ces \(u(e)\) appartient à \(F_j\), soit exactement lorsque les colonnes de coordonnées n'ont de coefficients non nuls que dans le bloc-ligne \(j\) — c'est-à-dire que tout bloc hors diagonale du bloc-colonne \(j\) s'annule. Donc tous les \(F_j\) sont stables si et seulement si tout bloc hors diagonale s'annule, soit la matrice est diagonale par blocs. Lorsque c'est le cas, le bloc diagonal \(A_i\) rassemble les coordonnées, dans la base de \(F_i\), des images \(u(e) = u_{F_i}(e)\) des vecteurs de base de \(F_i\) ; donc \(A_i\) est la matrice de \(u_{F_i}\) dans cette base. Cela redémontre, en coordonnées par blocs, la même correspondance stabilité / bloc nul que la sous-section précédente.
Exemple — Deux plans stables dans \(\mathbb{R}^4\)
Soit \(u \in \mathcal{L}(\mathbb{R}^4)\) de matrice \(\begin{pmatrix} 1 & 2 & 0 & 0 \\ 3 & 4 & 0 & 0 \\ 0 & 0 & 5 & 6 \\ 0 & 0 & 7 & 8 \end{pmatrix}\) dans la base canonique. Les plans \(F_1 = \operatorname{Vect}(e_1, e_2)\) et \(F_2 = \operatorname{Vect}(e_3, e_4)\) vérifient \(\mathbb{R}^4 = F_1 \oplus F_2\), et la matrice est diagonale par blocs pour le découpage \(2 + 2\) : les deux plans sont stables, l'endomorphisme induit sur \(F_1\) a pour matrice \(\begin{pmatrix} 1 & 2 \\ 3 & 4 \end{pmatrix}\), et celui sur \(F_2\) a pour matrice \(\begin{pmatrix} 5 & 6 \\ 7 & 8 \end{pmatrix}\). Exemple — Une droite stable et un plan stable
Supposons que \(u \in \mathcal{L}(\mathbb{R}^3)\) vérifie \(u(e_1) = 2 e_1\) et stabilise le plan \(P = \operatorname{Vect}(e_2, e_3)\). Alors \(\mathbb{R}^3 = \operatorname{Vect}(e_1) \oplus P\) est une décomposition en sous-espaces stables, et dans la base adaptée \((e_1, e_2, e_3)\) la matrice de \(u\) est diagonale par blocs \(\begin{pmatrix} 2 & 0 & 0 \\ 0 & \ast & \ast \\ 0 & \ast & \ast \end{pmatrix}\) : un bloc \(1 \times 1\) valant \((2)\) pour la droite, un bloc \(2 \times 2\) pour le plan. Méthode — Diagonaliser par blocs un endomorphisme
Pour mettre la matrice de \(u\) sous forme diagonale par blocs : trouver une décomposition \(E = \bigoplus F_i\) en sous-espaces chacun stable par \(u\), construire une base adaptée, et lire les blocs diagonaux comme les matrices des endomorphismes induits \(u_{F_i}\). Tout l'effort réside dans la recherche de la décomposition stable — l'objet de la théorie de la réduction qui suit.
La figure montre l'état final : \(E\) découpé en \(p\) pièces stables, la matrice de \(u\) une diagonale de blocs avec des zéros partout ailleurs. 
\(\operatorname{Mat}_{\mathcal{B}}(u) = \operatorname{Diag}(A_1, A_2, A_3)\) avec \(A_i = \operatorname{Mat}(u_{F_i})\) : tout bloc hors diagonale s'annule.
Compétences à pratiquer
- Décomposer en sous-espaces stables
III
Trace
Une matrice carrée \(A \in \mathcal{M}_n(\mathbb{K})\) porte de nombreux invariants : son déterminant, son rang, les dimensions de son noyau et de son image. Cette section en introduit un autre, le plus simple de tous : la trace, la somme des coefficients diagonaux. Trois formules en font le bon invariant : elle est linéaire, elle est égale à la trace de la transposée, et surtout le produit est commutatif modulo elle, \(\mathrm{tr}(AB) = \mathrm{tr}(BA)\). De cette dernière identité, la trace hérite d'une propriété qui la promeut d'invariant de matrice à invariant d'endomorphisme : deux matrices semblables ont même trace, donc la trace d'un endomorphisme est bien définie, indépendamment de la base.
Définition — Trace d'une matrice carrée
Soit \(A = (a_{ij})_{1 \leq i, j \leq n} \in \mathcal{M}_n(\mathbb{K})\). La trace de \(A\) est la somme de ses coefficients diagonaux : $$ \textcolor{colordef}{\mathrm{tr}(A) = \sum_{i=1}^n a_{ii} = a_{11} + a_{22} + \dots + a_{nn}.} $$ Exemple — Calculer une trace
\(\mathrm{tr}\begin{pmatrix} 1 & 2 & 3 \\ 4 & 5 & 6 \\ 7 & 8 & 9 \end{pmatrix} = 1 + 5 + 9 = 15\). \(\mathrm{tr}(I_n) = n\), car chaque coefficient diagonal de \(I_n\) vaut \(1\). Pour une matrice diagonale \(\operatorname{Diag}(\lambda_1, \dots, \lambda_n)\), \(\mathrm{tr} = \lambda_1 + \dots + \lambda_n\). La trace d'une matrice triangulaire supérieure reste la somme des coefficients diagonaux — les coefficients hors diagonale n'apparaissent pas dans la formule. Proposition — Linéarité et trace de la transposée
L'application \(\mathrm{tr} \colon \mathcal{M}_n(\mathbb{K}) \to \mathbb{K}\) est linéaire : $$ \mathrm{tr}(\lambda A + \mu B) = \lambda\, \mathrm{tr}(A) + \mu\, \mathrm{tr}(B), $$ pour tous \(A, B \in \mathcal{M}_n(\mathbb{K})\) et \(\lambda, \mu \in \mathbb{K}\). De plus $$ \textcolor{colorprop}{\mathrm{tr}(A^\top) = \mathrm{tr}(A),} $$ car la transposition laisse les coefficients diagonaux inchangés. Proposition — Trace d'un produit
Pour toutes \(A \in \mathcal{M}_{n,p}(\mathbb{K})\) et \(B \in \mathcal{M}_{p,n}(\mathbb{K})\), les produits \(AB \in \mathcal{M}_n(\mathbb{K})\) et \(BA \in \mathcal{M}_p(\mathbb{K})\) sont carrés (de tailles distinctes en général), et $$ \textcolor{colorprop}{\mathrm{tr}(AB) = \mathrm{tr}(BA).} $$
Écrivons \(A = (a_{ik})\) et \(B = (b_{kj})\). Le coefficient diagonal \((AB)_{ii}\) vaut \(\sum_{k=1}^p a_{ik} b_{ki}\), donc $$ \mathrm{tr}(AB) = \sum_{i=1}^n (AB)_{ii} = \sum_{i=1}^n \sum_{k=1}^p a_{ik} b_{ki}. $$ On intervertit l'ordre de sommation : \(\mathrm{tr}(AB) = \sum_{k=1}^p \sum_{i=1}^n b_{ki} a_{ik} = \sum_{k=1}^p (BA)_{kk} = \mathrm{tr}(BA)\), car \((BA)_{kk} = \sum_{i=1}^n b_{ki} a_{ik}\) par définition du produit matriciel.
Proposition — Invariance de la trace par similitude
Si \(A, A' \in \mathcal{M}_n(\mathbb{K})\) sont semblables — \(A' = P^{-1} A P\) pour une certaine matrice inversible \(P\) — alors $$ \textcolor{colorprop}{\mathrm{tr}(A') = \mathrm{tr}(A).} $$
On applique la proposition précédente aux deux facteurs \(P^{-1}\) et \(AP\) : \(\mathrm{tr}(A') = \mathrm{tr}\bigl(P^{-1} (AP)\bigr) = \mathrm{tr}\bigl((AP) P^{-1}\bigr) = \mathrm{tr}\bigl(A (PP^{-1})\bigr) = \mathrm{tr}(A I_n) = \mathrm{tr}(A)\).
Définition — Trace d'un endomorphisme
Soit \(E\) un \(\mathbb{K}\)-espace vectoriel de dimension finie et \(u \in \mathcal{L}(E)\). La trace de \(u\) est la valeur commune de \(\mathrm{tr}\bigl(\operatorname{Mat}_{\mathcal{B}}(u)\bigr)\) sur toutes les bases \(\mathcal{B}\) de \(E\) ; on la note \(\mathrm{tr}(u)\).
La définition est cohérente : les matrices \(\operatorname{Mat}_{\mathcal{B}}(u)\) dans deux bases sont semblables (la formule de changement de base donne \(\operatorname{Mat}_{\mathcal{B}'}(u) = P^{-1} \operatorname{Mat}_{\mathcal{B}}(u) P\) avec \(P\) la matrice de passage), et la proposition précédente montre qu'elles ont même trace. La linéarité se transporte : \(\mathrm{tr}(\lambda u + \mu v) = \lambda\, \mathrm{tr}(u) + \mu\, \mathrm{tr}(v)\) pour \(u, v \in \mathcal{L}(E)\). Et l'identité du produit se transporte : \(\mathrm{tr}(u \circ v) = \mathrm{tr}(v \circ u)\) pour \(u, v \in \mathcal{L}(E)\) (fixer une base \(\mathcal{B}\), appliquer \(\mathrm{tr}(AB) = \mathrm{tr}(BA)\) aux matrices).
Pour un projecteur \(p \in \mathcal{L}(E)\) d'un espace de dimension \(n\), la décomposition canonique \(E = \ker p \oplus \mathrm{Im}\, p\) rappelée de la première année est stable par \(p\) (les deux termes : \(p\) s'annule sur \(\ker p\), et \(p(x) = x\) sur \(\mathrm{Im}\, p\)). Choisissons une base adaptée à cette décomposition — une base de \(\ker p\) suivie d'une base de \(\mathrm{Im}\, p\). Dans cette base, la matrice de \(p\) est la matrice diagonale par blocs \(\operatorname{Diag}(0_{\dim \ker p}, I_{\mathrm{rk}(p)})\), dont la trace est la somme des coefficients diagonaux, soit le nombre de \(1\) : $$ \mathrm{tr}(p) = \mathrm{rk}(p). $$
Pour un projecteur \(p \in \mathcal{L}(E)\) d'un espace de dimension \(n\), la décomposition canonique \(E = \ker p \oplus \mathrm{Im}\, p\) rappelée de la première année est stable par \(p\) (les deux termes : \(p\) s'annule sur \(\ker p\), et \(p(x) = x\) sur \(\mathrm{Im}\, p\)). Choisissons une base adaptée à cette décomposition — une base de \(\ker p\) suivie d'une base de \(\mathrm{Im}\, p\). Dans cette base, la matrice de \(p\) est la matrice diagonale par blocs \(\operatorname{Diag}(0_{\dim \ker p}, I_{\mathrm{rk}(p)})\), dont la trace est la somme des coefficients diagonaux, soit le nombre de \(1\) : $$ \mathrm{tr}(p) = \mathrm{rk}(p). $$
Méthode — Calculer la trace d'un endomorphisme
Pour calculer \(\mathrm{tr}(u)\), choisir n'importe quelle base \(\mathcal{B}\) commode — le résultat ne dépend pas de ce choix. En pratique : la base canonique si \(u\) agit sur \(\mathbb{K}^n\) ; une base adaptée à une décomposition stable \(E = F_1 \oplus \dots \oplus F_p\) pour lire \(\mathrm{tr}(u) = \sum_i \mathrm{tr}(u_{F_i})\) sur la forme diagonale par blocs. Pour vérifier des identités de traces, exploiter la linéarité (\(\mathrm{tr}\) est une forme linéaire sur \(\mathcal{L}(E)\)) et \(\mathrm{tr}(uv) = \mathrm{tr}(vu)\). Compétences à pratiquer
- Calculer la trace
IV
Hyperplans et équations
IV.1
Hyperplans en dimension finie
Une droite de \(\mathbb{R}^2\) et un plan de \(\mathbb{R}^3\) partagent un trait : à chacun il manque exactement une dimension pour remplir l'espace, et chacun est l'ensemble des solutions d'une seule équation linéaire, \(ax + by = 0\) dans le plan, \(ax + by + cz = 0\) dans l'espace. Les sous-espaces « auxquels il manque une dimension » sont les hyperplans ; cette section les définit, donne leur équation, et lit tout un système d'équations comme une intersection d'hyperplans.
Définition — Hyperplan
Soit \(E\) un \(\mathbb{K}\)-espace vectoriel de dimension finie. Un hyperplan de \(E\) est un sous-espace \(H\) de \(E\) qui admet une droite pour supplémentaire : il existe un vecteur \(a \neq 0\) tel que $$ E = H \oplus \mathbb{K}a . $$ Exemple — Hyperplans en petite dimension
Dans \(\mathbb{R}^2\), les hyperplans sont les droites passant par l'origine : une droite \(D\) admet toute autre droite pour supplémentaire, donc \(\mathbb{R}^2 = D \oplus \mathbb{K}a\). Dans \(\mathbb{R}^3\), les hyperplans sont les plans passant par l'origine : un plan \(P\) admet toute droite non contenue dans lui pour supplémentaire. Dans \(\mathbb{K}^n\), un hyperplan est de dimension \(n - 1\). Proposition — Hyperplan et dimension
Soit \(E\) de dimension \(n \geq 1\) et \(H\) un sous-espace de \(E\). Alors $$ \textcolor{colorprop}{H \text{ est un hyperplan de } E \iff \dim H = n - 1 .} $$
Si \(H\) est un hyperplan, alors \(E = H \oplus \mathbb{K}a\) avec \(a \neq 0\), donc par la dimension d'une somme directe \(n = \dim H + \dim(\mathbb{K}a) = \dim H + 1\), d'où \(\dim H = n - 1\). Réciproquement, si \(\dim H = n - 1\), choisissons un vecteur \(a \in E \setminus H\) (il existe car \(H \neq E\)) ; alors \(\mathbb{K}a\) est une droite et \(H \cap \mathbb{K}a = \{0\}\) (un vecteur non nul de \(\mathbb{K}a\) est un multiple non nul de \(a\), donc hors de \(H\)), donc \(H + \mathbb{K}a\) est directe de dimension \((n-1) + 1 = n = \dim E\), ce qui donne \(E = H \oplus \mathbb{K}a\).
Proposition — Les hyperplans sont les noyaux des formes linéaires non nulles
Soit \(E\) de dimension \(n \geq 1\). Un sous-espace \(H\) est un hyperplan de \(E\) si et seulement s'il existe une forme linéaire non nulle \(\varphi : E \to \mathbb{K}\) avec \(H = \ker \varphi\). Concrètement, en fixant une base \(\mathcal{B} = (e_1, \dots, e_n)\) et en écrivant un vecteur \(x\) par ses coordonnées \((x_1, \dots, x_n)\), un hyperplan est l'ensemble des solutions d'une seule équation $$ \textcolor{colorprop}{a_1 x_1 + a_2 x_2 + \dots + a_n x_n = 0,} $$ avec \((a_1, \dots, a_n) \neq (0, \dots, 0)\). Deux formes linéaires non nulles ont le même noyau si et seulement si elles sont proportionnelles, donc l'équation d'un hyperplan est unique à un scalaire non nul près.
Une forme linéaire \(\varphi : E \to \mathbb{K}\) est une application linéaire vers l'espace \(\mathbb{K}\) de dimension \(1\). Si \(\varphi \neq 0\), son image est un sous-espace non nul de \(\mathbb{K}\), donc \(\mathbb{K}\) tout entier, d'où \(\operatorname{rk} \varphi = 1\) ; le théorème du rang donne \(\dim \ker \varphi = n - 1\), donc \(\ker \varphi\) est un hyperplan par la Proposition précédente. Réciproquement, soit \(H\) un hyperplan, \(E = H \oplus \mathbb{K}a\) ; tout \(x\) s'écrit de manière unique \(x = h + \lambda a\) avec \(h \in H\), et \(\varphi(x) = \lambda\) définit une forme linéaire (la coordonnée sur \(\mathbb{K}a\)) avec \(\ker \varphi = H\) et \(\varphi(a) = 1 \neq 0\).
En coordonnées, \(\varphi(x) = \varphi(x_1 e_1 + \dots + x_n e_n) = a_1 x_1 + \dots + a_n x_n\) avec \(a_i = \varphi(e_i)\), et \(\varphi \neq 0\) signifie que les \(a_i\) ne sont pas tous nuls ; l'équation \(\varphi(x) = 0\) est celle annoncée. Enfin, si \(\psi = \mu \varphi\) avec \(\mu \neq 0\) alors clairement \(\ker \psi = \ker \varphi\) ; réciproquement, si \(\ker \psi = \ker \varphi = H\), fixons \(a\) avec \(\varphi(a) = 1\) et posons \(\mu = \psi(a)\) (avec \(\mu \neq 0\), car \(a \notin H = \ker \psi\)) : pour tout \(x = h + \lambda a\), \(\psi(x) = \lambda \mu = \mu \varphi(x)\), donc \(\psi = \mu \varphi\) avec \(\mu \neq 0\).
En coordonnées, \(\varphi(x) = \varphi(x_1 e_1 + \dots + x_n e_n) = a_1 x_1 + \dots + a_n x_n\) avec \(a_i = \varphi(e_i)\), et \(\varphi \neq 0\) signifie que les \(a_i\) ne sont pas tous nuls ; l'équation \(\varphi(x) = 0\) est celle annoncée. Enfin, si \(\psi = \mu \varphi\) avec \(\mu \neq 0\) alors clairement \(\ker \psi = \ker \varphi\) ; réciproquement, si \(\ker \psi = \ker \varphi = H\), fixons \(a\) avec \(\varphi(a) = 1\) et posons \(\mu = \psi(a)\) (avec \(\mu \neq 0\), car \(a \notin H = \ker \psi\)) : pour tout \(x = h + \lambda a\), \(\psi(x) = \lambda \mu = \mu \varphi(x)\), donc \(\psi = \mu \varphi\) avec \(\mu \neq 0\).
La figure montre le plus petit cas visible : un plan passant par l'origine dans \(\mathbb{R}^3\) est un hyperplan, l'ensemble des solutions d'une équation \(a_1 x_1 + a_2 x_2 + a_3 x_3 = 0\), complété par toute droite passant par l'origine non contenue dans lui. 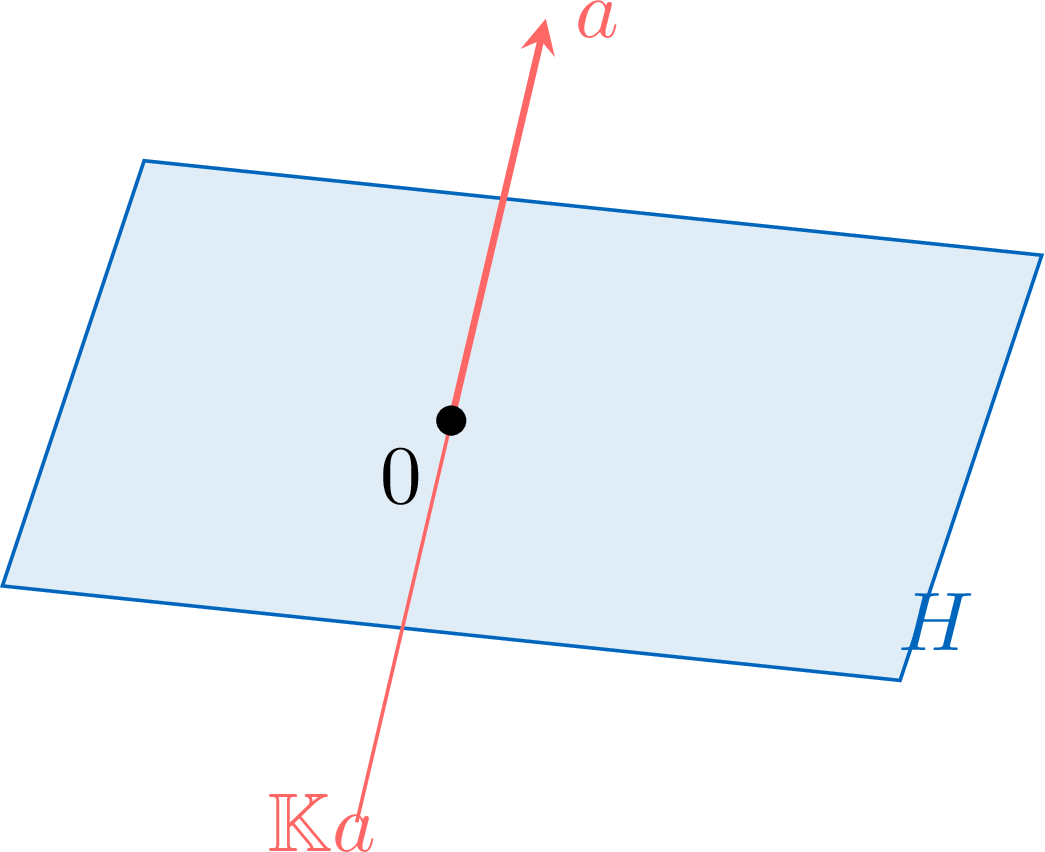
\(\mathbb{R}^3 = H \oplus \mathbb{K}a\) : le plan \(H\) est un hyperplan, \(\mathbb{K}a\) une droite supplémentaire.
Méthode — Trouver l'équation d'un hyperplan
Pour produire une équation d'un hyperplan \(H\) donné par une base \((u_1, \dots, u_{n-1})\) : chercher \((a_1, \dots, a_n) \neq 0\) tel que la forme linéaire \(\varphi(x) = a_1 x_1 + \dots + a_n x_n\) s'annule sur chaque \(u_j\). C'est un système linéaire homogène de \(n-1\) équations aux \(n\) inconnues \(a_i\) ; son espace de solutions est une droite (les \(a_i\) sont uniques à un scalaire près), et toute solution non nulle donne l'équation \(\varphi(x) = 0\) de \(H\). Compétences à pratiquer
- Reconnaître et utiliser un hyperplan
IV.2
Équations d'un sous-espace
Une seule équation découpe un hyperplan. Imposer plusieurs équations à la fois intersecte les hyperplans correspondants, et la dimension chute d'au plus un par équation. C'est ainsi qu'un sous-espace quelconque se décrit par un système d'équations linéaires, et que l'ensemble des solutions d'un système linéaire se lit géométriquement.
Proposition — Intersection d'hyperplans
Soit \(E\) de dimension \(n\) et \(H_1, \dots, H_p\) des hyperplans de \(E\). Alors $$ \textcolor{colorprop}{\dim(H_1 \cap \dots \cap H_p) \geq n - p .} $$ Réciproquement, pour \(0 \leq p \leq n\), tout sous-espace \(F\) de \(E\) de dimension \(n - p\) est l'intersection de \(p\) hyperplans (avec la convention qu'une intersection de \(p = 0\) hyperplans est \(E\) lui-même).
Minoration. Intersecter avec un hyperplan abaisse la dimension d'au plus \(1\) : si \(V\) est un sous-espace et \(H = \ker \varphi\) un hyperplan, alors \(V \cap H\) est le noyau de la forme \(\varphi\) restreinte à \(V\), donc \(\dim(V \cap H) \geq \dim V - 1\) (le rang de \(\varphi_{|V}\) est au plus \(1\)). En appliquant ceci \(p\) fois, depuis \(V = E\) de dimension \(n\), on obtient \(\dim(H_1 \cap \dots \cap H_p) \geq n - p\).
Réciproque. Soit \(F\) de dimension \(n - p\). Complétons une base \((e_1, \dots, e_{n-p})\) de \(F\) en une base \((e_1, \dots, e_n)\) de \(E\), et soient \(\varphi_1, \dots, \varphi_n\) les formes coordonnées dans cette base (\(\varphi_i(x) = x_i\)). Pour \(k = 1, \dots, p\) posons \(H_k = \ker \varphi_{n-p+k}\), un hyperplan. Un vecteur \(x\) appartient à \(H_1 \cap \dots \cap H_p\) exactement lorsque \(x_{n-p+1} = \dots = x_n = 0\), soit \(x \in \operatorname{Vect}(e_1, \dots, e_{n-p}) = F\). D'où \(F = H_1 \cap \dots \cap H_p\).
Réciproque. Soit \(F\) de dimension \(n - p\). Complétons une base \((e_1, \dots, e_{n-p})\) de \(F\) en une base \((e_1, \dots, e_n)\) de \(E\), et soient \(\varphi_1, \dots, \varphi_n\) les formes coordonnées dans cette base (\(\varphi_i(x) = x_i\)). Pour \(k = 1, \dots, p\) posons \(H_k = \ker \varphi_{n-p+k}\), un hyperplan. Un vecteur \(x\) appartient à \(H_1 \cap \dots \cap H_p\) exactement lorsque \(x_{n-p+1} = \dots = x_n = 0\), soit \(x \in \operatorname{Vect}(e_1, \dots, e_{n-p}) = F\). D'où \(F = H_1 \cap \dots \cap H_p\).
Exemple — Deux plans de \(\mathbb{R}^3\) se coupant le long d'une droite
Dans \(\mathbb{R}^3\) (\(n = 3\)), prenons les deux plans vectoriels passant par l'origine \(H_1 : x_1 = 0\) et \(H_2 : x_2 = 0\), deux hyperplans. Leur intersection \(H_1 \cap H_2\) est \(\{x : x_1 = x_2 = 0\} = \operatorname{Vect}(e_3)\), une droite : dimension \(3 - 2 = 1\), atteignant la borne \(n - p\). Deux plans vectoriels distincts se coupent toujours le long d'une droite vectorielle passant par l'origine — jamais en un seul point, puisque tous deux contiennent \(0\). Méthode — Décrire un sous-espace par un système d'équations
Pour transformer un sous-espace \(F\) de \(\mathbb{K}^n\), donné par une base \((u_1, \dots, u_r)\) (donc \(r = \dim F\)), en un système d'équations : un vecteur \(x\) appartient à \(F\) exactement lorsque les formes linéaires s'annulant sur chaque \(u_j\) s'annulent sur \(x\). Résoudre le système homogène « \(\varphi\) s'annule sur chaque \(u_j\) » pour les coefficients de \(\varphi\) ; une base de son espace de solutions donne \(n - r\) formes indépendantes \(\varphi_1, \dots, \varphi_{n-r}\), et \(F\) vaut exactement \(\{x : \varphi_1(x) = \dots = \varphi_{n-r}(x) = 0\}\) — un système de \(n - r\) équations, un hyperplan chacune. (Si l'on ne dispose que d'une famille génératrice, en extraire d'abord une base pour avoir \(r = \dim F\).)
Lecture géométrique d'un système linéaire. L'ensemble des solutions d'un système homogène \(a_{11} x_1 + \dots + a_{1n} x_n = 0, \dots, a_{p1} x_1 + \dots + a_{pn} x_n = 0\) est l'intersection des hyperplans portés par ses lignes non nulles (une ligne nulle n'impose rien, son équation étant vérifiée par \(E\) tout entier) — un sous-espace passant par l'origine, de dimension \(n - r\) où \(r\) est le rang du système. Pour un système non homogène \(AX = b\) (avec \(b \neq 0\)), l'ensemble des solutions, lorsqu'il est non vide, n'est plus un sous-espace : c'est un translaté de l'espace des solutions du système homogène \(AX = 0\), à savoir \(x_0 + \ker A\) pour une solution particulière \(x_0\). Géométriquement c'est un sous-espace affine — l'intersection des hyperplans affines \(a_{i1}x_1 + \dots + a_{in}x_n = b_i\) portés par les lignes non nulles (une ligne entièrement nulle ne donne soit aucune contrainte, si son \(b_i = 0\), soit aucune solution, si son \(b_i \neq 0\)) — parallèle à l'espace des solutions homogènes mais ne passant plus par l'origine.
Compétences à pratiquer
- Équations d'un sous-espace et systèmes linéaires
V
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section