Éducation Nationale Française · Première Spécialité
Algorithmique : listes et coût
I
Une liste comme donnée
La programmation a déjà écrit les parcours d'une liste : chercher une valeur, garder la plus grande, les additionner toutes. Ce qu'elle n'a pas demandé, c'est ce que valent ces parcours. Deux questions se posent à leur sujet. Qu'est-ce qui est vrai à chaque tour d'un parcours, pour que sa dernière ligne se lise comme une réponse valant pour toute liste et non pour la seule qui a été tracée ? Et que coûte ce parcours, compté sur l'algorithme, sous la forme d'un nombre écrit avec la longueur de la liste ? La première question s'appelle l'invariant ; la seconde est un compte de comparaisons, et elle séparera des algorithmes qui donnent tous la bonne réponse.
Définition — Une liste
Une liste est une suite finie de valeurs, données dans un ordre. Sa longueur est le nombre de valeurs qu'elle porte, et ses positions sont numérotées à partir de 0, si bien que la dernière est la longueur moins un. La valeur à la position k d'une liste lst s'écrit lst[k]. Un algorithme reçoit une liste comme il reçoit un nombre : il n'en connaît pas la longueur à l'avance, donc tout ce qu'il en dit doit valoir pour une liste de toute longueur qu'autorise son énoncé. Certains algorithmes exigent une liste non vide, ou d'au moins deux valeurs, et l'énoncé le dit alors : une précondition fait partie de l'algorithme, elle n'est pas un oubli. Définition — Les deux parcours
Une liste se parcourt de deux façons. Le parcours par élément prend les valeurs l'une après l'autre, sans jamais nommer de position : Pour chaque x dans lst. Le parcours par position prend les positions de 0 à la longueur moins un et lit la valeur à chacune : Pour k allant de 0 à longueur de lst - 1. Les deux font le même nombre de tours et voient les mêmes valeurs ; ils diffèrent par ce qu'ils peuvent dire. Le premier ne donne pas où il est, et un compteur à côté ne fait que reconstruire ce que le second a gratuitement ; le second est celui qu'il faut employer quand la position fait partie de la réponse ou quand deux listes se lisent ensemble. Méthode — Parcourir une liste
- Choisir le parcours : par élément quand seules les valeurs comptent, par position sinon.
- Créer l'accumulateur avant la boucle, à la valeur qui répond pour zéro tour quand il y en a une.
- Écrire le corps pour une valeur, sans penser aux autres.
- Lire l'accumulateur après la boucle, et dire ce qu'il retient.
- Essayer la liste vide : un parcours sur rien ne fait aucun tour, et l'accumulateur se lit tel qu'il a été créé.
| Pseudo-code | Python |
longueur de lst | len(lst) |
lst[k] | lst[k] |
Pour chaque x dans lst | for x in lst: |
Pour k allant de 0 à longueur de lst - 1 | for k in range(len(lst)): |
Ajouter x à lst | lst.append(x) |
la liste vide, [2, 5] | [], [2, 5] |
lst[k] \(\leftarrow\) v | lst[k] = v |
Sortir de la boucle | break |
vrai, faux | True, False |
Exemple
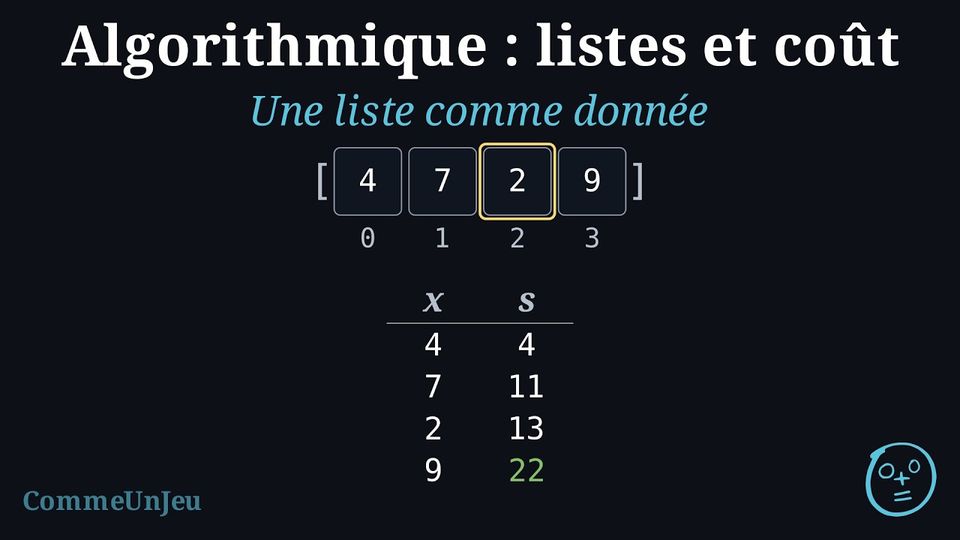
Exécuter à la main l'algorithme ci-dessous. La liste lst est la liste \([4 ; 7 ; 2 ; 9]\). s ← 0
Pour chaque x dans lst
s ← s + x
Fin Pour
Afficher s| Instruction | \(x\) | \(s\) | Affichage |
| départ | \(0\) | ||
| tour 1 | \(4\) | \(4\) | |
| tour 2 | \(7\) | \(11\) | |
| tour 3 | \(2\) | \(13\) | |
| tour 4 | \(9\) | \(22\) | |
| Afficher \(s\) | \(9\) | \(22\) | \(22\) |
22. Quatre tours, un par valeur : le nombre de tours d'un parcours est la longueur de la liste, et rien d'autre. L'accumulateur part de 0 parce que c'est la somme d'aucune valeur, ce qui est aussi ce que l'algorithme répond pour la liste vide — cas qui mérite d'être écrit, puisque la boucle ne fait alors aucun tour et que la dernière ligne est la première.
La dernière position est la longueur moins un
Une liste de quatre valeurs a les positions
0, 1, 2 et 3 : il n'y a pas de lst[4], et le demander arrête le programme. Un parcours par position va donc de 0 à la longueur moins un, ce que le pseudo-code écrit comme il le dit et que Python écrit range(len(lst)), puisque range s'arrête juste avant sa borne. Compter à partir de 0 est ce qui fait s'accorder les deux écritures, et c'est là qu'un parcours par position se trompe quand il se trompe.
Un parcours par élément ne sait pas où il est
Pour chaque x dans lst donne les valeurs et rien de plus : un algorithme qui doit répondre à quelle position ne peut pas l'employer, et lui adjoindre un compteur n'est que le parcours par position écrit en deux lignes au lieu d'une. Le choix entre les deux parcours n'est donc pas affaire de goût ; il est tranché par ce que la réponse doit contenir.
Compétences à pratiquer
- Prédire
- Traduire
- Parcourir une liste
II
Chercher et l'invariant
Une trace montre qu'un algorithme est juste sur la liste qui a été tracée, et ne dit rien des autres. Il faut autre chose, et c'est une phrase : une phrase vraie avant le premier tour et que chaque tour garde vraie. Une telle phrase s'appelle un invariant, et c'est ce qui manque à une trace seule. Avec elle, la dernière ligne d'une trace cesse d'être un résultat et devient une réponse, pour toutes les listes à la fois.
Définition — La recherche séquentielle
La recherche séquentielle parcourt la liste depuis sa première valeur et regarde chacune à son tour. Quand la question est réglée par une valeur — une valeur égale à celle qui est cherchée, une valeur au-dessus d'un seuil — elle s'arrête à la première qui y répond. Quand la question porte sur toutes — la plus grande, combien — elle doit toutes les voir. Sur une liste dont on ne sait rien, aucune recherche ne peut promettre moins que voir toutes les valeurs au pire, et sa réponse est une valeur, une position, ou le fait qu'il n'y en a pas. Définition — L'invariant d'une boucle
Un invariant d'une boucle est une phrase sur ses variables, vraie avant le premier tour et que chaque tour laisse vraie. Elle est donc vraie quand la boucle s'arrête, si elle s'arrête — un invariant ne dit rien de la terminaison, à laquelle répond séparément un variant. Jointe à la raison pour laquelle la boucle s'est arrêtée, elle dit ce que retiennent les variables à la fin, pour toute entrée et non pour la seule qui a été tracée. Un invariant n'est pas ce que fait la boucle ; c'est ce qui ne change pas pendant qu'elle le fait. Méthode — Trouver l'invariant d'une boucle
- Écrire d'abord la trace et regarder la colonne de l'accumulateur, ligne à ligne.
- Dire en une phrase ce que retient cette colonne à la fin du tour
k, en employantket les valeurs déjà vues. Dans un invariant,kcompte toujours les tours déjà faits et se numérote depuis \(1\), quel que soit le nom de la variable de boucle et l'endroit où elle part. - La vérifier avant le premier tour : la phrase doit être vraie de la valeur de départ, sur la part de liste déjà vue, qui est alors vide.
- Vérifier qu'un tour la garde vraie : en la supposant vraie après le tour
k, est-elle vraie après le tourk + 1? - Lire la fin : écrire la phrase pour le dernier tour, et elle dit ce que rend l'algorithme.
- Quand il n'y a pas d'accumulateur, l'invariant nomme une zone : la part de liste qui peut encore contenir la réponse. Elle se vérifie aux mêmes trois endroits — avant le premier tour, où la zone est toute la liste ; à un tour, qui la garde vraie puisque la part jetée ne peut pas contenir la réponse ; et à la fin, où la zone s'est réduite à un candidat.
Exemple
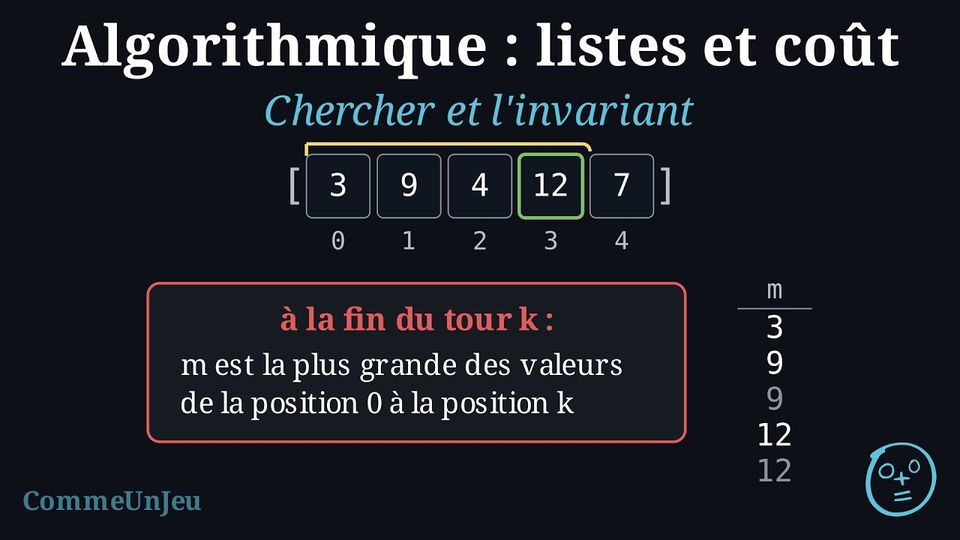
Exécuter à la main l'algorithme ci-dessous et donner ce qu'il affiche, puis dire ce que retient m à la fin du tour k. La liste lst est la liste \([3 ; 9 ; 4 ; 12 ; 7]\). m ← lst[0]
Pour k allant de 1 à longueur de lst - 1
Si lst[k] > m alors
m ← lst[k]
Fin Si
Fin Pour
Afficher m| Instruction | \(k\) | lst[k] | \(m\) | Affichage |
| départ | \(3\) | |||
| tour \(k = 1\) | \(1\) | \(9\) | \(9\) | |
| tour \(k = 2\) | \(2\) | \(4\) | \(9\) | |
| tour \(k = 3\) | \(3\) | \(12\) | \(12\) | |
| tour \(k = 4\) | \(4\) | \(7\) | \(12\) | |
| Afficher \(m\) | \(4\) | \(7\) | \(12\) | \(12\) |
12. La colonne \(m\) vaut \(3\), puis \(9\), \(9\), \(12\), \(12\) : à la fin du tour k, m est la plus grande des valeurs de la position 0 à la position k. Cette phrase est l'invariant. Elle est vraie avant le premier tour, où seule lst[0] a été vue et où m vaut cette valeur ; et un tour la garde vraie, puisque le nouveau m est le plus grand de l'ancien et de lst[k], c'est-à-dire le plus grand d'une valeur de plus. Au dernier tour k vaut la longueur moins un, donc la phrase dit que m est la plus grande de toute la liste — et cela vaut pour toute liste qu'accepte l'algorithme, là où la trace ne valait que pour une. Quelles listes accepte-t-il ? Pas la liste vide, puisqu'il lit lst[0] ; et sur une liste d'une seule valeur la boucle ne fait aucun tour, donc la phrase se lit avant le premier tour, où elle est déjà vraie. Exemple
L'algorithme ci-dessous rend la position de la plus grande valeur. L'exécuter à la main et donner ce qu'il affiche. La liste lst est la liste \([3 ; 9 ; 4 ; 12 ; 7]\). m ← lst[0]
p ← 0
Pour k allant de 1 à longueur de lst - 1
Si lst[k] > m alors
m ← lst[k]
p ← k
Fin Si
Fin Pour
Afficher p| Instruction | \(k\) | lst[k] | \(m\) | \(p\) | Affichage |
| départ | \(3\) | \(0\) | |||
| tour \(k = 1\) | \(1\) | \(9\) | \(9\) | \(1\) | |
| tour \(k = 2\) | \(2\) | \(4\) | \(9\) | \(1\) | |
| tour \(k = 3\) | \(3\) | \(12\) | \(12\) | \(3\) | |
| tour \(k = 4\) | \(4\) | \(7\) | \(12\) | \(3\) | |
| Afficher \(p\) | \(4\) | \(7\) | \(12\) | \(3\) | \(3\) |
3, la position de la valeur \(12\). Les deux variables bougent ensemble, et c'est là l'invariant : à la fin du tour k, m est la plus grande des valeurs jusqu'à la position k et p est une position où se trouve cette plus grande valeur. C'est l'algorithme qu'un parcours par élément ne peut pas écrire, puisqu'il doit nommer une position. Et une comparaison stricte garde la première de deux plus grandes valeurs égales ; écrire \(\geqslant\) garderait la dernière, ce qui est un autre algorithme répondant à une autre question. Exemple
Qu'affiche le programme suivant ? lst = [4, 7, 4, 2, 4]
c = 0
for x in lst:
if x == 4:
c = c + 1
print(c)3k, c est le nombre de valeurs égales à \(4\) parmi celles déjà vues. Et le parcours est par élément, puisque la réponse ne porte aucune position.
L'invariant est ce qui ne change pas
La valeur de
m change à presque chaque tour ; la phrase m est la plus grande des valeurs déjà vues ne change pas. C'est là toute la difficulté à trouver un invariant : ce qui est cherché n'est pas le mouvement, que la trace montre, mais la phrase qui lui survit. Une phrase qui ne décrit que le dernier tour n'est pas un invariant, et une phrase vraie à la fin et fausse au départ non plus.
La liste vide
L'algorithme du maximum lit
lst[0] avant sa boucle, donc il arrête le programme sur une liste vide : il n'y a pas de position 0. Ce n'est pas une faute de l'écriture mais de la question, puisque la plus grande d'aucune valeur n'est pas un nombre. Un algorithme qui doit accepter la liste vide répond donc autre chose sur elle — un message, ou le fait qu'il n'y a pas de réponse — et l'énoncé doit dire lequel.
Compétences à pratiquer
- Prédire
- Traduire
- Chercher
- L'invariant
III
Sommer et les suites
Une liste se parcourt pour être sommée, et d'une somme viennent la moyenne et la dispersion — des questions que règle le même parcours, ou deux parcours quand le second attend la fin du premier. Il arrive qu'aucune liste ne soit donnée : les valeurs sont produites l'une après l'autre par une règle, chacune à partir de la précédente, et l'algorithme les parcourt sans jamais les tenir toutes. C'est une suite. Le parcours a la même forme dans les deux cas — un accumulateur avant, un corps, une lecture après — et son invariant se lit de la même façon. Ce qui change avec une suite est que le nombre de tours n'est plus la longueur de quoi que ce soit : il est demandé, ou il est la réponse.
Définition — Accumuler sur une liste
La somme d'une liste s'obtient par un accumulateur parti de 0 ; sa moyenne est cette somme divisée par la longueur, ce qui suppose la liste non vide. Les sommes cumulées d'une liste sont la liste des sommes de ses premières valeurs : la première, puis les deux premières, et ainsi de suite, construites en ajoutant l'accumulateur courant à chaque tour au lieu de le lire une fois à la fin. Exemple
Exécuter à la main l'algorithme ci-dessous et donner ce qu'il affiche. La liste lst est la liste \([2 ; 5 ; 1 ; 4]\). s ← 0
cum ← liste vide
Pour chaque x dans lst
s ← s + x
Ajouter s à cum
Fin Pour
Afficher cum| Instruction | \(x\) | \(s\) | cum | Affichage |
| départ | \(0\) | \([\,]\) | ||
| tour 1 | \(2\) | \(2\) | \([2]\) | |
| tour 2 | \(5\) | \(7\) | \([2 ; 7]\) | |
| tour 3 | \(1\) | \(8\) | \([2 ; 7 ; 8]\) | |
| tour 4 | \(4\) | \(12\) | \([2 ; 7 ; 8 ; 12]\) | |
Afficher cum | \(4\) | \(12\) | \([2 ; 7 ; 8 ; 12]\) | \([2 ; 7 ; 8 ; 12]\) |
k, s est la somme des k premières valeurs et cum porte les k sommes de la première, des deux premières, et ainsi de suite. Toute la différence avec la somme simple tient en une ligne : ajouter dans la boucle au lieu de lire une fois après. La dernière valeur de cum est la somme, donc cet algorithme répond aux deux questions à la fois — et coûte le même parcours. Sur la liste vide il affiche la liste vide, qui n'a pas de dernière valeur : la somme vaut alors \(0\) et se lit dans s, non dans cum. Définition — Moyenne et dispersion
La moyenne d'une liste en donne une valeur centrale ; elle ne dit rien de l'éloignement des valeurs entre elles. La variance répond à cette seconde question : c'est la moyenne des carrés des écarts entre chaque valeur et la moyenne, et elle vaut \(0\) exactement quand toutes les valeurs égalent la moyenne. L'écart-type en est la racine carrée, qui ramène la dispersion à l'unité des valeurs. Un algorithme qui veut la variance doit donc parcourir la liste deux fois : une pour la moyenne, qui doit être connue avant le second parcours, et une pour les écarts. Exemple
Les deux fonctions ci-dessous rendent la moyenne et la variance d'une liste non vide. Exécuter à la main les deux dernières instructions et donner ce qu'elles affichent. La liste lst est la liste \([2 ; 4 ; 4 ; 6]\). Fonction mean(t)
s ← 0
Pour chaque x dans t
s ← s + x
Fin Pour
Renvoyer s ÷ longueur de t
Fin Fonction
Fonction spread(t)
m ← mean(t)
s ← 0
Pour chaque x dans t
s ← s + (x - m) × (x - m)
Fin Pour
Renvoyer s ÷ longueur de t
Fin Fonction
Afficher mean(lst)
Afficher spread(lst)| Instruction | \(x\) | \(s\) | Rendu | Affichage |
début de mean | \(0\) | |||
| tour 1 | \(2\) | \(2\) | ||
| tour 2 | \(4\) | \(6\) | ||
| tour 3 | \(4\) | \(10\) | ||
| tour 4 | \(6\) | \(16\) | ||
| Renvoyer \(s \div 4\) | \(6\) | \(16\) | \(4\) | |
| Afficher | \(4\) | |||
début de spread, \(m = 4\) | \(0\) | |||
| tour 1 | \(2\) | \(4\) | ||
| tour 2 | \(4\) | \(4\) | ||
| tour 3 | \(4\) | \(4\) | ||
| tour 4 | \(6\) | \(8\) | ||
| Renvoyer \(s \div 4\) | \(6\) | \(8\) | \(2\) | |
| Afficher | \(2\) |
4 puis 2. Lire une fonction, c'est lire trois choses : ce qu'elle reçoit, ce qu'elle parcourt, et ce qu'elle rend. Ici mean reçoit une liste, la parcourt une fois avec un accumulateur, et rend un nombre ; spread reçoit une liste et appelle mean dessus avant son propre parcours, ce pourquoi les deux parcours se suivent au lieu d'être emboîtés — deux parcours qui se suivent coûtent n plus n, non n fois n. La valeur rendue a une colonne à elle, puisqu'aucune variable de l'appelant ne la retient. L'écart-type serait la racine carrée de \(2\), entre \(1{,}4\) et \(1{,}5\) par l'encadrement que donne le balayage : l'algorithme n'a pas besoin de le calculer pour avoir fait son travail, et s'arrêter à la variance garde toutes les valeurs entières. Définition — Une suite calculée par une boucle
Une suite est donnée par ses premières valeurs et une règle qui produit chaque valeur à partir de celles qui la précèdent — le plus souvent de celle qui la précède immédiatement, parfois des deux. Un algorithme en calcule le terme de rang n avec une variable, ou deux quand la règle emploie deux termes précédents, et n tours ; les valeurs précédentes sont oubliées à mesure qu'elles servent, et les tenir toutes n'est nécessaire que si la réponse les demande toutes. Le nombre de tours est ici ce que demande l'énoncé, et non la longueur d'une liste. Exemple
La règle de Syracuse divise par deux un nombre pair et transforme un nombre impair en son triple augmenté de un. La valeur de départ est un entier strictement positif. Exécuter à la main l'algorithme ci-dessous pour u égal à \(6\) et donner le nombre de tours qu'il affiche. u ← 6
n ← 0
Tant que u ≠ 1
Si reste de u par 2 = 0 alors
u ← quotient de u par 2
Sinon
u ← 3 × u + 1
Fin Si
n ← n + 1
Fin Tant que
Afficher n| Instruction | \(u\) | \(n\) | \(u \neq 1\) | Affichage |
| départ | \(6\) | \(0\) | ||
| tour 1 | \(3\) | \(1\) | vrai | |
| tour 2 | \(10\) | \(2\) | vrai | |
| tour 3 | \(5\) | \(3\) | vrai | |
| tour 4 | \(16\) | \(4\) | vrai | |
| tour 5 | \(8\) | \(5\) | vrai | |
| tour 6 | \(4\) | \(6\) | vrai | |
| tour 7 | \(2\) | \(7\) | vrai | |
| tour 8 | \(1\) | \(8\) | vrai | |
| fin | \(1\) | \(8\) | faux | |
| Afficher \(n\) | \(1\) | \(8\) | \(8\) |
8 : les valeurs sont \(6\), \(3\), \(10\), \(5\), \(16\), \(8\), \(4\), \(2\), \(1\), soit huit tours. Cette boucle est un algorithme dont personne ne sait justifier la terminaison : aucune quantité n'est connue pour décroître à chaque tour, puisqu'une valeur impaire croît. Pour une valeur de départ donnée, la tracer tranche la question : la trace ci-dessus prouve qu'elle s'arrête pour \(6\), et des machines l'ont vérifié bien au-delà de ce qu'on saurait écrire ici. Ce qui est ouvert est l'énoncé général — qu'elle s'arrête pour tout entier strictement positif — qu'aucune démonstration n'a établi. Et le domaine compte : partie de \(0\), la boucle tournerait indéfiniment, puisque \(0\) est pair et que le diviser par deux redonne \(0\). On peut tracer cet algorithme et compter ses tours sur une entrée, et on doit dire que sa terminaison en général est une question ouverte, ce qui vaut d'être su. Exemple
Qu'affiche le programme suivant ? a = 0
b = 1
for k in range(8):
c = a + b
a = b
b = c
print(a)21a retient \(21\). Deux variables suffisent parce que chaque valeur n'a besoin que des deux précédentes, et le troisième nom c est là pour la même raison que dans l'échange de deux variables : sans lui, a serait écrasée avant que b ne puisse la lire. L'invariant — ce qui reste vrai à chaque tour (a et b sont deux termes consécutifs) — se lit sur le nombre de tours déjà faits : après r tours, a et b retiennent les termes de rangs r et r + 1, la suite étant numérotée depuis le rang \(0\) où elle vaut \(0\). Avant le premier tour cela fait \((0 ; 1)\), ce qui est juste, et après le huitième \((21 ; 34)\). Compter avec la variable de boucle k, qui part de \(0\), décalerait les deux rangs de un — le genre de décalage qu'un invariant vérifié avant le premier tour attrape aussitôt. Exemple
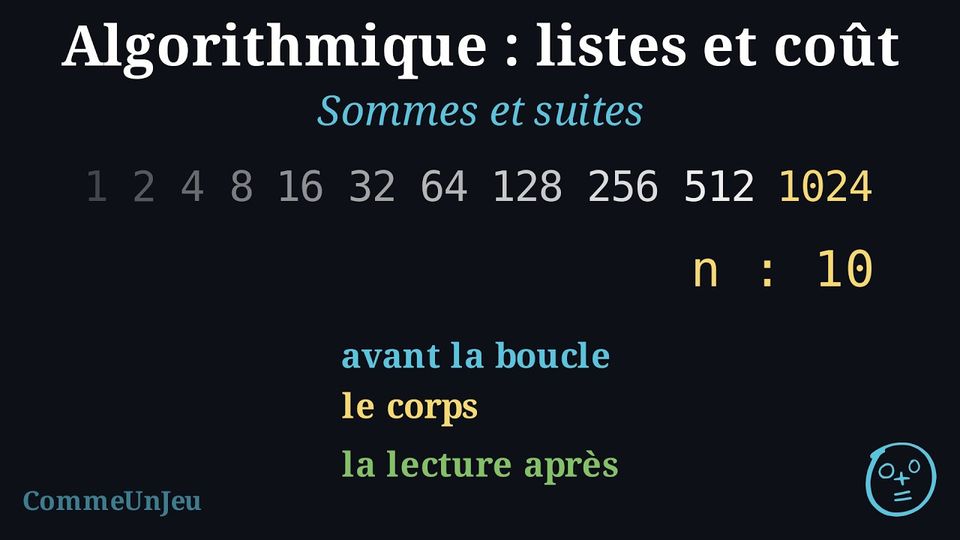
Une suite part de \(1\) et double à chaque étape. L'algorithme ci-dessous donne le premier rang auquel elle dépasse \(1000\). L'exécuter à la main et donner ce qu'il affiche. u ← 1
n ← 0
Tant que u ≤ 1000
u ← 2 × u
n ← n + 1
Fin Tant que
Afficher n| Instruction | \(u\) | \(n\) | \(u \leqslant 1000\) | Affichage |
| départ | \(1\) | \(0\) | ||
| tour 1 | \(2\) | \(1\) | vrai | |
| tour 2 | \(4\) | \(2\) | vrai | |
| tour 3 | \(8\) | \(3\) | vrai | |
| tour 4 | \(16\) | \(4\) | vrai | |
| tour 5 | \(32\) | \(5\) | vrai | |
| tour 6 | \(64\) | \(6\) | vrai | |
| tour 7 | \(128\) | \(7\) | vrai | |
| tour 8 | \(256\) | \(8\) | vrai | |
| tour 9 | \(512\) | \(9\) | vrai | |
| tour 10 | \(1024\) | \(10\) | vrai | |
| fin | \(1024\) | \(10\) | faux | |
| Afficher \(n\) | \(1024\) | \(10\) | \(10\) |
10, et le terme de rang \(10\) vaut \(1024\). C'est l'autre usage des tours d'une boucle : ils ne sont pas ici un coût, ils sont la réponse, et le compteur n n'est là que pour la porter hors de la boucle. La boucle se termine pour la raison que toute boucle doit nommer : le variant est le nombre entier \(1000 - u\), qui reste au moins \(0\) tant que la boucle tourne et décroît strictement à chaque tour, puisque u au moins double depuis une valeur au moins égale à \(1\) ; un entier ne peut pas décroître indéfiniment en restant au moins \(0\). Un seuil lu ainsi est exact et non approché : l'algorithme donne le premier rang qui dépasse \(1000\), parce qu'il s'arrête au premier tour dont la condition échoue. Exemple
La factorielle d'un entier naturel \(n\), notée \(n!\), est le produit \(1 \times 2 \times \cdots \times n\) des entiers de \(1\) à \(n\) ; par convention, \(0! = 1\). Exécuter à la main l'algorithme ci-dessous pour n égal à \(5\) et donner ce qu'il affiche. f ← 1
Pour k allant de 1 à n
f ← f × k
Fin Pour
Afficher f| Instruction | \(k\) | \(f\) | Affichage |
| départ | \(1\) | ||
| tour 1 | \(1\) | \(1\) | |
| tour 2 | \(2\) | \(2\) | |
| tour 3 | \(3\) | \(6\) | |
| tour 4 | \(4\) | \(24\) | |
| tour 5 | \(5\) | \(120\) | |
| Afficher \(f\) | \(5\) | \(120\) | \(120\) |
120 : \(5! = 120\). C'est l'accumulateur d'un produit, et il part de \(1\), le produit d'aucun facteur — partir de \(0\) rendrait tout produit nul. Pour n égal à \(0\), la boucle ne fait aucun tour et l'algorithme affiche \(1\), qui est exactement \(0!\). À la fin de chaque tour, \(f\) contient \(k!\), et la factorielle croît très vite : \(10!\) vaut déjà \(3\,628\,800\).
Retenir les termes ou les oublier
Calculer le terme de rang
n depuis le terme de rang \(0\) demande une variable, ou deux pour Fibonacci, et n tours ; construire la liste des n premiers termes demande une liste, et n tours également. Les deux parcours coûtent donc la même chose, et ils diffèrent par ce qu'ils gardent. Choisir entre eux, c'est choisir ce qu'est la réponse : un nombre, ou une liste de nombres.
Compétences à pratiquer
- Prédire
- Traduire
- Vérifier
- Sommes et moyennes
- Les suites
IV
Compter ce que ça coûte
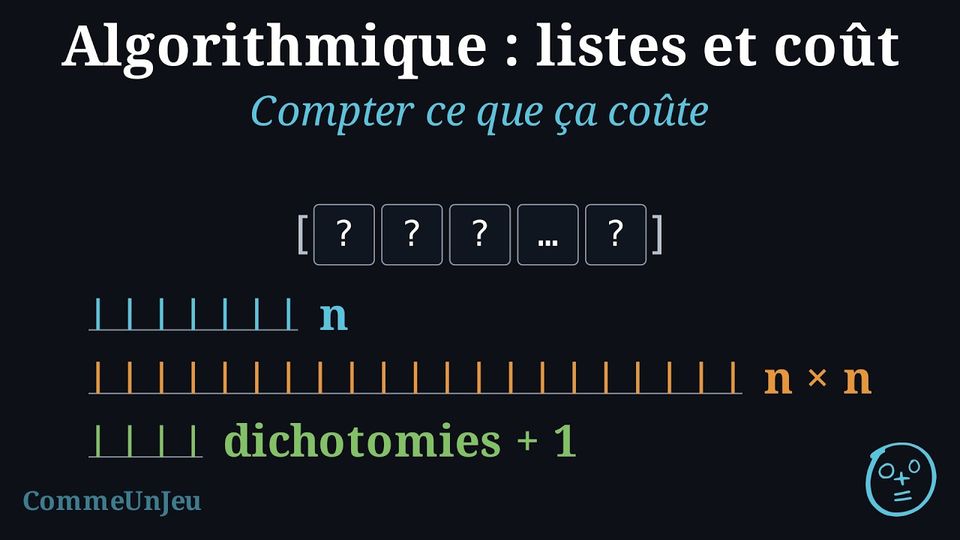
Plusieurs algorithmes sur une liste peuvent être tous justes. Ce qui les sépare est ce qu'ils coûtent, et sur une liste le coût se compte avec un seul nombre : la longueur. Un parcours coûte cette longueur. Deux parcours emboîtés coûtent bien davantage. Et une recherche sur une liste déjà triée ne coûte presque rien — pourvu que cette hypothèse soit payée ailleurs. Ces croissances se comptent sur quatre classiques — la recherche dichotomique, le tri par sélection, le crible d'Ératosthène et le rendu de monnaie glouton — et elles se comptent sur les algorithmes, sans rien exécuter.
Définition — Compter ce que coûte un algorithme
Sur une liste, le coût d'un algorithme se compte en opérations : les opérations arithmétiques et les tests qu'il fait, une par unité, nommer une valeur ne coûtant rien. Quand le travail de l'algorithme est une comparaison répétée — une recherche, un tri — compter les seules comparaisons suffit à comparer deux algorithmes, et c'est ce qu'on compte. Le test qu'une boucle fait pour décider de tourner encore est laissé de côté : ce qui se compte est le travail fait sur les valeurs examinées. Compter les tests propres des boucles ajouterait un par tour et ne changerait rien à la comparaison de deux algorithmes. Le compte s'écrit avec la longueur n de la liste, et il se donne au mieux, quand l'algorithme a de la chance, et au pire, quand il n'en a pas. Le pire cas est celui qui compte, puisque c'est la seule promesse qui vaille pour toute liste. Méthode — Compter les comparaisons d'un algorithme
- Nommer la comparaison qui se répète : celle que l'algorithme fait sur les valeurs qu'il examine, à l'intérieur de la boucle.
- Dire combien il en fait par tour, en lisant le corps une fois.
- Compter les tours en lisant les bornes de chaque boucle, et multiplier.
- Donner le meilleur et le pire cas, et nommer pour chacun une entrée qui l'atteint : une valeur trouvée aussitôt, une valeur absente.
- Retenir le pire cas comme la promesse, et dire comment il croît quand la longueur double.
Exemple
L'algorithme ci-dessous cherche une valeur dans une liste non vide dont on ne sait rien d'autre. Combien fait-il de comparaisons au mieux et au pire, sur une liste de longueur n ? p ← -1
Pour k allant de 0 à longueur de lst - 1
Si lst[k] = v alors
p ← k
Sortir de la boucle
Fin Si
Fin Pour
Afficher p
Une au mieux,
n au pire. Au mieux la valeur cherchée est à la position 0 et la boucle sort à son premier test. Au pire elle est à la dernière position, ou elle n'est pas dans la liste du tout, et toutes les valeurs doivent être comparées : les deux pires cas coûtent la même chose, ce pourquoi une recherche qui échoue est aussi coûteuse que la plus coûteuse de celles qui réussissent. Le coût croît donc comme la longueur, et doubler la liste double le travail. Ce qui autorise la réponse \(-1\) est un invariant, et il vaut d'être écrit ici : à la fin du tour k, ou bien p retient une position où se trouve la valeur cherchée, ou bien cette valeur n'est pas dans les k premières positions. Avant le premier tour rien n'a été vu et p retient \(-1\), donc la phrase est vraie d'une part de liste vide ; un tour la garde vraie, puisqu'il trouve la valeur et remplit p, ou ajoute une position où la valeur n'est pas. La boucle s'arrête alors de deux façons : en étant quittée, et p est une position de la valeur ; ou en atteignant la fin, et la phrase couvre toute la liste, donc \(-1\) est la réponse et non un oubli. Définition — Deux parcours emboîtés
Un parcours placé à l'intérieur d'un autre fait ses propres tours à chaque tour du premier : sur une liste de longueur n, les deux ensemble font environ \(n \times n\) tours. Quand le parcours intérieur commence après la position de l'extérieur, si bien que chaque paire de positions est vue une fois et non deux, le compte est \(\frac{n \times (n-1)}{2}\), le nombre de paires d'une liste de longueur n. Dans les deux cas le coût croît comme le carré de la longueur : doubler la liste multiplie le travail par quatre. Exemple
L'algorithme ci-dessous donne le plus petit écart entre deux valeurs d'une liste d'au moins deux valeurs. L'exécuter à la main et donner ce qu'il affiche, puis dire combien de paires il regarde. La liste lst est la liste \([1 ; 8 ; 3 ; 14]\). d ← lst[1] - lst[0]
Si d < 0 alors
d ← 0 - d
Fin Si
Pour i allant de 0 à longueur de lst - 1
Pour j allant de i + 1 à longueur de lst - 1
e ← lst[j] - lst[i]
Si e < 0 alors
e ← 0 - e
Fin Si
Si e < d alors
d ← e
Fin Si
Fin Pour
Fin Pour
Afficher d| Paire | lst[i] | lst[j] | \(e\) | \(d\) | Affichage |
| avant les boucles | \(7\) | ||||
| \((0 ; 1)\) | \(1\) | \(8\) | \(7\) | \(7\) | |
| \((0 ; 2)\) | \(1\) | \(3\) | \(2\) | \(2\) | |
| \((0 ; 3)\) | \(1\) | \(14\) | \(13\) | \(2\) | |
| \((1 ; 2)\) | \(8\) | \(3\) | \(5\) | \(2\) | |
| \((1 ; 3)\) | \(8\) | \(14\) | \(6\) | \(2\) | |
| \((2 ; 3)\) | \(3\) | \(14\) | \(11\) | \(2\) | |
| Afficher \(d\) | \(2\) | \(2\) |
2, l'écart entre \(1\) et \(3\). Six paires pour une liste de quatre valeurs, soit \(\frac{4 \times 3}{2}\) : le parcours intérieur part de i + 1, donc aucune paire n'est vue deux fois et aucune valeur n'est comparée à elle-même. Le parcours extérieur fait quatre tours, un par position, et le dernier ouvre un parcours intérieur sur rien : ce sont les tours du parcours intérieur qui comptent les paires, non ceux de l'extérieur. La paire \((0 ; 1)\) est en fait calculée deux fois, une avant les boucles pour donner à d une valeur de départ et une à l'intérieur, ce qui coûte un écart de plus qu'il n'y a de paires — le prix d'un accumulateur parti d'une valeur qui soit vraiment un écart, et la raison pour laquelle l'algorithme exige au moins deux valeurs. Sur une liste de cent valeurs cela fait \(4950\) paires, et sur mille environ un demi-million : le coût croît comme le carré. Définition — La recherche dichotomique dans une liste triée
Quand la liste est triée, la dichotomie s'y applique : la position du milieu est regardée, et la moitié où la valeur cherchée ne peut pas être est jetée. La recherche dichotomique divise donc par deux, à chaque tour, la part de liste qui reste à considérer, et son invariant est celui de toute dichotomie : si la valeur est dans la liste, elle est entre les positions a et b. Son coût est le nombre de dichotomies nécessaires pour ramener une longueur n à \(1\), plus l'unique comparaison qui dit si le candidat restant est la valeur cherchée. La liste doit être non vide, puisque cette dernière comparaison lit une position. Méthode — Chercher dans une liste triée par dichotomie
- Vérifier les hypothèses : la liste est triée, et elle n'est pas vide. Sans la première l'algorithme répond n'importe quoi, et vite ; sans la seconde il n'y a pas de dernière comparaison à faire.
- Tenir deux positions,
aetb, entre lesquelles la valeur doit être si elle y est. - Regarder la position du milieu et comparer sa valeur à celle qui est cherchée.
- Jeter la moitié où la valeur ne peut pas être, et répéter tant que les deux positions diffèrent.
- Lire la réponse : les deux positions se rejoignent sur le seul candidat ; une dernière comparaison dit si la valeur y est.
Exemple
Exécuter à la main l'algorithme ci-dessous et donner ce qu'il affiche. Il rend la position de v dans la liste, ou \(-1\) quand v n'y est pas. La liste lst est triée et vaut \([2 ; 5 ; 8 ; 11 ; 14 ; 17 ; 20]\), et la valeur v est égale à \(14\). a ← 0
b ← longueur de lst - 1
Tant que a < b
m ← quotient de a + b par 2
Si lst[m] < v alors
a ← m + 1
Sinon
b ← m
Fin Si
Fin Tant que
Si lst[a] = v alors
Afficher a
Sinon
Afficher -1
Fin Si| Instruction | \(a\) | \(b\) | \(m\) | lst[m] | \(a < b\) | Affichage |
| départ | \(0\) | \(6\) | ||||
| tour 1 | \(4\) | \(6\) | \(3\) | \(11\) | vrai | |
| tour 2 | \(4\) | \(5\) | \(5\) | \(17\) | vrai | |
| tour 3 | \(4\) | \(4\) | \(4\) | \(14\) | vrai | |
| fin | \(4\) | \(4\) | \(4\) | \(14\) | faux | |
Si lst[a] \(= v\) : vrai | \(4\) | \(4\) | \(4\) | \(14\) | ||
| Afficher \(a\) | \(4\) | \(4\) | \(4\) | \(14\) | \(4\) |
4, et lst[4] vaut bien \(14\). Trois tours de boucle et une comparaison après elle, quatre en tout, là où une recherche séquentielle en aurait fait cinq sur cette liste — et l'écart croît avec la liste : sept valeurs demandent trois dichotomies, mille en demandent dix, un million en demandent vingt. La boucle se termine parce que b - a est un entier qui décroît strictement à chaque tour et ne peut pas descendre sous zéro, ce qui est le critère du variant appliqué à une distance entre deux positions. Exemple
Trier une liste par sélection, c'est : chercher la plus petite valeur, la mettre en première position, puis recommencer sur ce qui reste. Qu'affiche le programme suivant ? lst = [5, 2, 9, 1]
n = len(lst)
c = 0
for i in range(n - 1):
p = i
for j in range(i + 1, n):
c = c + 1
if lst[j] < lst[p]:
p = j
t = lst[i]
lst[i] = lst[p]
lst[p] = t
print(lst)
print(c)[1, 2, 5, 9]
6k, les positions 0 à k - 1 portent les k plus petites valeurs de la liste, dans l'ordre — avec k le nombre de tours déjà faits, qui vaut un de plus que la variable de boucle i puisque celle-ci part de \(0\). L'échange en trois lignes est celui de deux variables, et il est nécessaire pour la même raison. Cent valeurs coûteraient \(4950\) comparaisons, et mille environ un demi-million : le tri par sélection est un algorithme quadratique, et le tri fusion montre qu'on peut faire mieux.
Trié est une hypothèse et non une propriété
La recherche dichotomique est rapide parce que la liste est triée, et elle ne vérifie pas qu'elle l'est : sur une liste qui ne l'est pas, elle jette la moitié où la valeur se trouvait, et répond que la valeur est absente — vite et faux. Rien dans l'algorithme ne peut le détecter, puisque vérifier coûterait à soi seul un parcours. L'hypothèse se paie donc ailleurs : ou bien la liste arrive triée, ou bien quelqu'un l'a triée, et trier coûte bien davantage qu'une recherche. Chercher une fois dans une liste non triée coûte moins que la trier d'abord. Y chercher beaucoup de fois peut valoir la peine, et combien fait beaucoup est lui-même un compte : avec le tri par sélection, trier une liste de
n valeurs coûte environ \(\frac{n \times n}{2}\), ce qui ne s'amortit qu'après environ \(\frac{n}{2}\) recherches — cinq cents recherches sur une liste de mille, cinq cent mille sur une liste d'un million.
Définition — Le crible d'Ératosthène
Pour trouver tous les nombres premiers jusqu'à n, le crible ne teste pas les nombres un à un : il les marque. Une liste de marques est tenue, une case par nombre de \(0\) à n, et les nombres de \(2\) à n sont examinés dans l'ordre croissant : un nombre encore non marqué quand on l'atteint est premier, et tous ses multiples sont alors marqués d'un seul balayage ; l'examen terminé, les nombres non marqués de \(2\) à n sont exactement les nombres premiers. Le marquage des multiples de k peut commencer à \(k \times k\), puisque tout multiple plus petit de k a un facteur inférieur à k et a déjà été marqué. Les marquages s'arrêtent donc dès que \(k \times k\) dépasse n, et les tours suivants ne marquent plus rien — l'arrêt à la racine carrée du test des diviseurs, appliqué ici à un marquage et non à un test. Exemple
Exécuter à la main le crible ci-dessous pour n égal à \(12\) et donner ce qu'il affiche. n ← 12
mark ← liste vide
Pour k allant de 0 à n
Ajouter 0 à mark
Fin Pour
Pour k allant de 2 à n
Si mark[k] = 0 alors
m ← k × k
Tant que m ≤ n
mark[m] ← 1
m ← m + k
Fin Tant que
Fin Si
Fin Pour
p ← liste vide
Pour k allant de 2 à n
Si mark[k] = 0 alors
Ajouter k à p
Fin Si
Fin Pour
Afficher p| Instruction | mark[k] | Marqués à ce tour | Affichage |
| départ : treize marques à \(0\) | |||
| tour \(k = 2\) | \(0\) | \(4\), \(6\), \(8\), \(10\), \(12\) | |
| tour \(k = 3\) | \(0\) | \(9\), \(12\) | |
| tour \(k = 4\) | \(1\) | — | |
| tour \(k = 5\) | \(0\) | rien | |
| tour \(k = 6\) | \(1\) | — | |
| tour \(k = 7\) | \(0\) | rien | |
| tour \(k = 8\) | \(1\) | — | |
| tour \(k = 9\) | \(1\) | — | |
| tour \(k = 10\) | \(1\) | — | |
| tour \(k = 11\) | \(0\) | rien | |
| tour \(k = 12\) | \(1\) | — | |
| Afficher \(p\) | \([2 ; 3 ; 5 ; 7 ; 11]\) |
n. Le prix est une liste de n + 1 cases tenue en mémoire dès le début, là où le test ne tient rien : le crible achète sa vitesse avec de la place. Définition — Un algorithme glouton
Un algorithme est glouton quand il construit sa réponse pas à pas, en prenant à chaque pas la plus grande pièce qui tienne encore, et qu'il ne revient jamais sur un choix déjà fait. Payer un montant avec le moins de pièces possible en est le classique : les pièces sont parcourues depuis la plus grande, et chacune est prise tant qu'elle ne dépasse pas ce qui reste à payer. Un algorithme glouton coûte peu, puisqu'il n'explore jamais ce qu'il n'a pas choisi ; il n'est juste que si la collection des pièces le rend tel, et c'est une hypothèse à vérifier et non une propriété de la méthode. Exemple
L'algorithme ci-dessous paie un montant avec les pièces \(50\), \(20\), \(10\), \(5\), \(2\) et \(1\), et affiche le nombre de pièces employées. Le montant lu est \(87\). L'exécuter à la main et donner ce qu'il affiche. Lire r
coins ← [50, 20, 10, 5, 2, 1]
n ← 0
Pour chaque c dans coins
Tant que c ≤ r
r ← r - c
n ← n + 1
Fin Tant que
Fin Pour
Afficher n| Instruction | \(c\) | Tours du Tant que | \(r\) | \(n\) | Affichage |
| départ | \(87\) | \(0\) | |||
| tour 1 | \(50\) | \(1\) | \(37\) | \(1\) | |
| tour 2 | \(20\) | \(1\) | \(17\) | \(2\) | |
| tour 3 | \(10\) | \(1\) | \(7\) | \(3\) | |
| tour 4 | \(5\) | \(1\) | \(2\) | \(4\) | |
| tour 5 | \(2\) | \(1\) | \(0\) | \(5\) | |
| tour 6 | \(1\) | \(0\) | \(0\) | \(5\) | |
| Afficher \(n\) | \(0\) | \(5\) | \(5\) |
5 : les pièces rendues sont \(50\), \(20\), \(10\), \(5\) et \(2\), qui font bien \(87\). Chaque ligne est un tour du parcours des pièces, et la colonne voisine dit combien de tours a faits le Tant que intérieur — jamais plus d'un sur ce montant, ce pourquoi une ligne par pièce dit tout. Le Tant que intérieur est ce qui permet de prendre plusieurs fois la même pièce, ce dont ce montant n'a pas besoin : sur \(40\) il tourne deux fois sur la pièce de \(20\), et sur \(4\) deux fois sur la pièce de \(2\). L'invariant est ce qui dit que l'algorithme fait ce qu'il annonce : à la fin de chaque tour, n est le nombre de pièces déjà rendues et r est ce qui reste à payer, et leur somme avec les pièces rendues fait le montant lu. La boucle se termine parce que r est un entier qui ne descend jamais sous \(0\) et décroît strictement à chaque tour du Tant que. Le coût ne se compte pas ici dans la longueur d'une liste mais dans le nombre de pièces rendues, plus un test par pièce de la collection.
Le glouton ne donne pas toujours le moins
Avec les pièces \(50\), \(20\), \(10\), \(5\), \(2\) et \(1\), l'algorithme glouton rend toujours le moins de pièces possible, et c'est une propriété de ces pièces, non de la méthode. Prendre les pièces \(4\), \(3\) et \(1\) et le montant \(6\) : le glouton prend \(4\), puis \(1\) et \(1\), soit trois pièces, là où \(3\) et \(3\) en font deux. Rien dans l'algorithme ne peut s'en apercevoir, puisqu'il ne revient jamais sur le \(4\) qu'il a pris d'abord. Trouver le moins de pièces pour une collection quelconque demande une autre méthode, qui explore ce que le glouton écarte, et coûte bien davantage — le choix entre un algorithme peu coûteux et juste sous une hypothèse et un algorithme coûteux et toujours juste est une décision à part entière.
Trois croissances
Trois coûts ont été comptés sur une liste de longueur
n. Un parcours, et toute recherche qui doit voir toutes les valeurs, coûte n. Deux parcours emboîtés coûtent environ \(n \times n\) — la moitié quand le parcours intérieur part après l'extérieur, ce qui change le compte et non la croissance. Une recherche dichotomique coûte le nombre de dichotomies qui ramènent n à un, plus une comparaison. Pour une liste d'un million de valeurs, cela fait un million, mille milliards, et vingt et un. Compter ces croissances, sur l'algorithme et avant d'écrire une ligne de programme, précède le fait de les nommer.
Compétences à pratiquer
- Prédire
- Traduire
- Compter les comparaisons
- La recherche dichotomique
V
Pour aller plus loin
Compétences à pratiquer
- Problèmes
- Quiz
Aller à la section