Éducation Nationale Française · Première Spécialité
Variables aléatoires
I
Variables aléatoires
I.1
Définitions
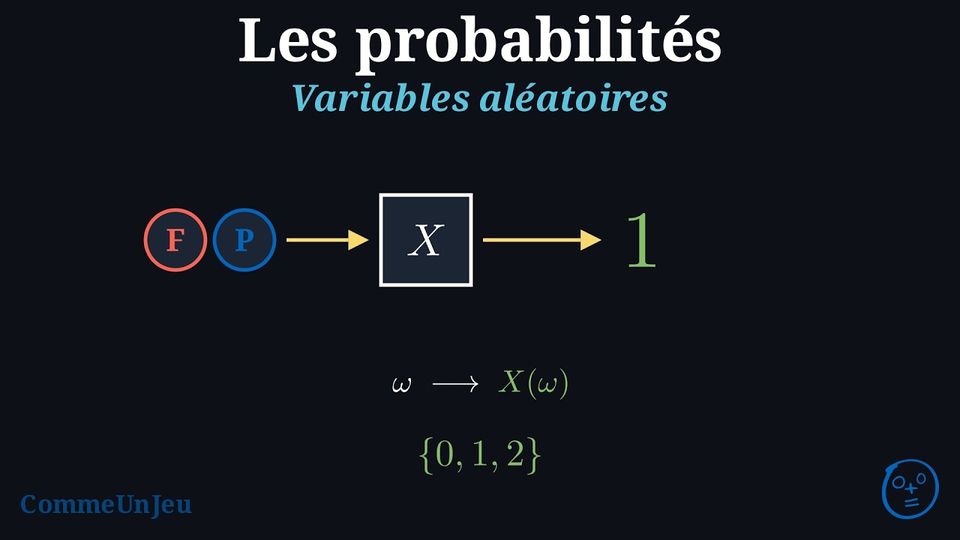
Des événements aux nombres
Un événement est un ensemble d'issues et sa probabilité un nombre. Beaucoup de questions sur une expérience aléatoire portent sur un nombre attaché à chaque issue plutôt que sur un événement : le gain d'un jeu, le nombre de « face » en trois lancers, la somme de deux dés. Ce nombre n'est pas fixé d'avance, il dépend de l'issue que le hasard produit ; c'est ce que la définition suivante fixe sous le nom de variable aléatoire.
Définition — Variable aléatoire
Une variable aléatoire, notée \(X\), est une fonction qui associe une valeur numérique à chaque issue \(\omega\) de l'univers \(\Omega\). On note cette valeur \(X(\omega)\). 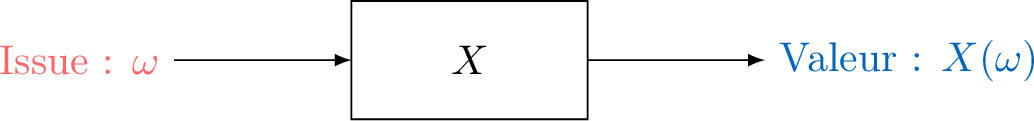
Exemple
Soit \(X\) le nombre de « face » obtenu en lançant 2 pièces équilibrées : 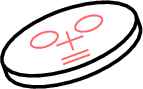 (pièce rouge) et
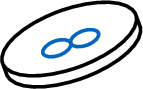 (pièce bleue). Déterminer \(X(\textcolor{colordef}{F},\textcolor{colorprop}{P})\).
L'issue \((\textcolor{colordef}{F},\textcolor{colorprop}{P})\) signifie que la pièce rouge donne « face » (F) et la pièce bleue donne « pile » (P). Puisque \(X\) compte les « face », il y a 1 « face ». Donc, \(X(\textcolor{colordef}{F},\textcolor{colorprop}{P}) = 1\).
Définition — Variable aléatoire discrète
Une variable aléatoire est discrète si l'ensemble de ses valeurs possibles est fini ou infini dénombrable. Cela signifie que l'on peut énumérer toutes les valeurs possibles. Sauf mention contraire, les variables aléatoires considérées prennent un nombre fini de valeurs ; le rang d'un premier succès, rencontré plus loin, est l'exception. Définition — Événements liés à une variable aléatoire
Pour une variable aléatoire \(X\) : - \((X = x)\) : l’ensemble des issues où \(X\) prend la valeur \(x\).
- \((X \leq x)\) : l’ensemble des issues où \(X\) est inférieur ou égal à \(x\).
- \((X \geq x)\) : l’ensemble des issues où \(X\) est supérieur ou égal à \(x\).
Exemple
Soit \(X\) le nombre de « face » obtenu en lançant 2 pièces : et . Lister les issues pour \((X = 0)\), \((X = 1)\), \((X = 2)\), \((X \leq 1)\), et \((X \geq 1)\). - \((X = 0) = \{(\textcolor{colordef}{P},\textcolor{colorprop}{P})\}\) (aucune « face »).
- \((X = 1) = \{(\textcolor{colordef}{P},\textcolor{colorprop}{F}), (\textcolor{colordef}{F},\textcolor{colorprop}{P})\}\) (une « face »).
- \((X = 2) = \{(\textcolor{colordef}{F},\textcolor{colorprop}{F})\}\) (deux « face »).
- \((X \leq 1) = (X = 0) \cup (X = 1) = \{(\textcolor{colordef}{P},\textcolor{colorprop}{P}), (\textcolor{colordef}{P},\textcolor{colorprop}{F}), (\textcolor{colordef}{F},\textcolor{colorprop}{P})\}\) (au plus une « face »).
- \((X \geq 1) = (X = 1) \cup (X = 2) = \{(\textcolor{colordef}{P},\textcolor{colorprop}{F}), (\textcolor{colordef}{F},\textcolor{colorprop}{P}), (\textcolor{colordef}{F},\textcolor{colorprop}{F})\}\) (au moins une « face »).
Exemple
Un questionnaire comporte trois questions, chacune avec quatre propositions dont une seule est juste. Un élève répond au hasard à chaque question, indépendamment des autres. Définir une variable aléatoire qui modélise la situation, donner ses valeurs possibles et calculer la probabilité que l'élève se trompe à toutes les questions. - La variable : soit \(X\) le nombre de réponses justes parmi les trois. À chaque issue, une suite de trois propositions choisies, \(X\) attache le nombre de réponses justes.
- Ses valeurs possibles : \(0\), \(1\), \(2\) et \(3\).
- L'événement \((X = 0)\) est « les trois réponses sont fausses », et chaque réponse est fausse avec la probabilité \(\frac{3}{4}\) : $$\begin{aligned}[t] P(X = 0) &= \frac{3}{4} \times \frac{3}{4} \times \frac{3}{4} && \scriptscriptstyle\text{(réponses indépendantes)} \\ &= \frac{27}{64} \approx 0{,}42. \end{aligned}$$
Compétences à pratiquer
- Trouver la valeur d’une variable aléatoire
- Identifier les valeurs possibles
- Définir une variable aléatoire
- Trouver des événements liés à une variable aléatoire
- Définir une variable aléatoire pour modéliser une situation
I.2
Loi de probabilité
Oublier les issues et garder les valeurs
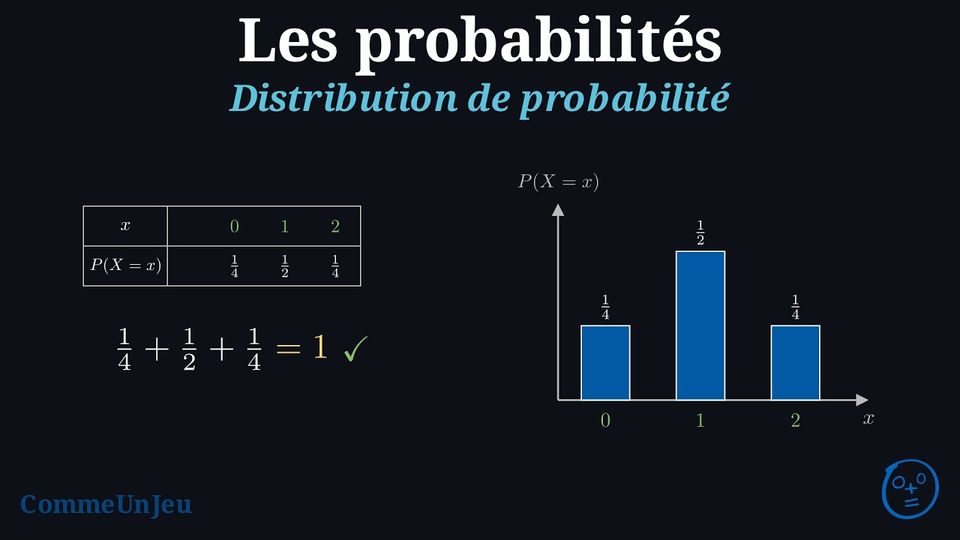
Une fois la variable définie, on met souvent les issues de côté pour ne garder que ce que \(X\) produit : ses valeurs, chacune avec la probabilité de l'événement « \(X\) prend cette valeur ». Consigner ces probabilités, dans un tableau ou par une formule, c'est ce que la définition suivante appelle la loi de probabilité de \(X\). Les issues reviennent chaque fois qu'une telle probabilité doit être calculée.
Définition — Loi de probabilité
La loi de probabilité d’une variable aléatoire \(X\) donne la probabilité \(P(X = x_i)\) pour chaque valeur possible \(x_1,x_2,\dots,x_n\). Ici, chaque \(x_i\) est une valeur possible de \(X\) — un nombre réel — pas une issue. Elle peut être représentée par un tableau ou une formule. Proposition — Caractéristique d'une loi de probabilité
Pour une variable aléatoire \(X\) prenant les valeurs \(x_1,x_2,\dots,x_n\), on a : - \(0 \leq P(X=x_i) \leq 1\) pour tout \(i=1,\dots,n\),
- \(\displaystyle\sum_{i=1}^n P(X=x_i) =P(X=x_1)+P(X=x_2)+\dots+P(X=x_n)= 1 \).
Exemple
Soit \(X\) le nombre de « face » obtenu en lançant, de façon indépendante, 2 pièces équilibrées : et . - Lister les valeurs possibles de \(X\).
- Déterminer la loi de probabilité.
- Construire le tableau de probabilité.
- Dessiner le graphique de la loi.
- Valeurs possibles : \(0\) (aucune « face »), \(1\) (une « face »), \(2\) (deux « face »).
- Loi de probabilité :
- \(P(X = 0) = P(\{(\textcolor{colordef}{P},\textcolor{colorprop}{P})\}) =\frac{1}{4}\),
- \(P(X = 1) = P(\{(\textcolor{colordef}{P},\textcolor{colorprop}{F}), (\textcolor{colordef}{F},\textcolor{colorprop}{P})\}) = \frac{2}{4} = \frac{1}{2}\),
- \(P(X = 2) = P(\{(\textcolor{colordef}{F},\textcolor{colorprop}{F})\}) = \frac{1}{4}\).
- Tableau de probabilité :
\(x\) 0 1 2 \(P(X = x)\) \(\frac{1}{4}\) \(\frac{1}{2}\) \(\frac{1}{4}\) - Graphique :
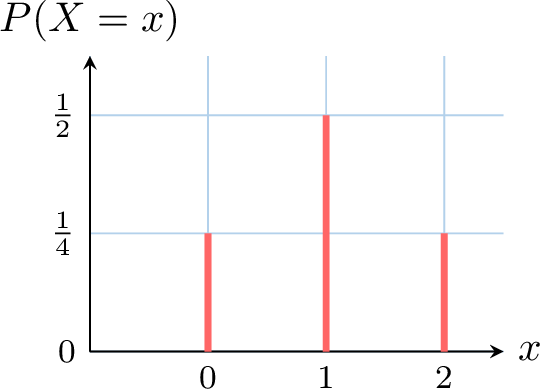
Compétences à pratiquer
- Déterminer la loi de probabilité
- Lire les lois de probabilité à partir de graphiques
- Construire une loi de probabilité
I.3
Existence d’une variable aléatoire avec une loi de probabilité donnée
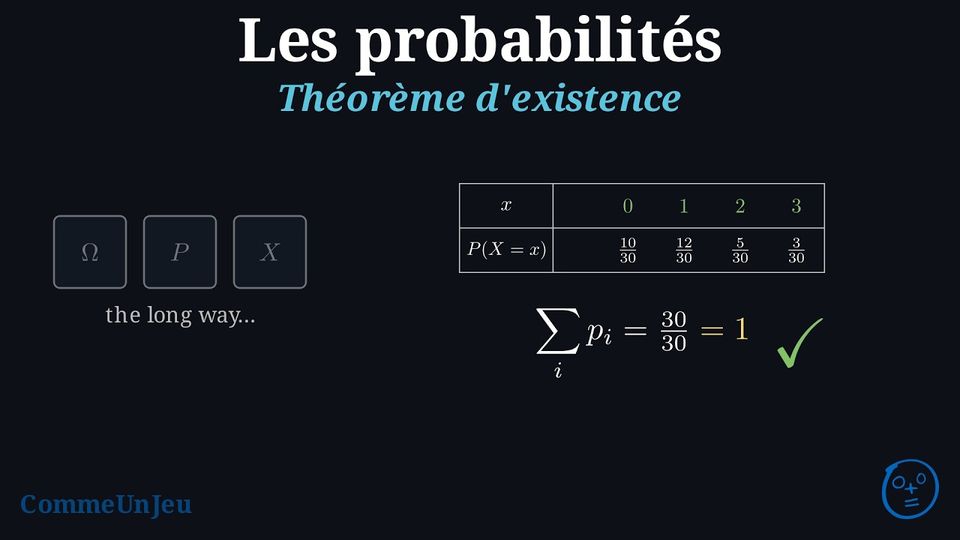
Habituellement, définir une variable aléatoire commence par établir :
Le théorème ci-dessous montre qu’il est toujours possible de construire un univers, une probabilité et une fonction \(X\) pour obtenir une variable aléatoire ayant cette loi de probabilité.
- un univers, c’est-à-dire l’ensemble de toutes les issues possibles,
- une probabilité associée à cet univers,
- une fonction \(X\) qui attribue un nombre à chaque issue de l’univers.
| \(x\) | 0 | 1 | 2 | 3 |
| \(P(X = x)\) | \(\frac{10}{30}\) | \(\frac{12}{30}\) | \(\frac{5}{30}\) | \(\frac{3}{30}\) |
Théorème — Existence d’une variable aléatoire avec une loi de probabilité donnée
Soient des valeurs possibles \(x_1, x_2, \ldots, x_n\), deux à deux distinctes, et des probabilités \(p_1, p_2, \ldots, p_n\).Si :
- \(0 \leq p_i \leq 1\) pour chaque \(i = 1, 2, \ldots, n\),
- \(\sum_{i=1}^n p_i = p_1 + p_2 + \cdots + p_n = 1\),
Méthode — Définir une variable aléatoire \(X\) avec une loi de probabilité valide
En pratique, on définit souvent une variable aléatoire \(X\) directement en précisant sa loi de probabilité. L’essentiel est de s’assurer que cette loi est valide, c’est-à-dire qu’elle respecte les conditions d’une loi de probabilité : toutes les probabilités doivent être non négatives et leur somme doit égaler 1. Exemple
On interroge une classe de 30 élèves sur leurs frères et sœurs et on obtient ces résultats : 10 élèves ont 0 frère ou sœur, 12 en ont 1, 5 en ont 2, et 3 en ont 3. On définit une variable aléatoire \(X\) comme le nombre de frères et sœurs d’un élève choisi au hasard, avec cette loi de probabilité : | \(x\) | 0 | 1 | 2 | 3 |
| \(P(X = x)\) | \(\frac{10}{30}\) | \(\frac{12}{30}\) | \(\frac{5}{30}\) | \(\frac{3}{30}\) |
- \(P(X = x) \geq 0\) pour tout \(x = 0, 1, 2, 3\) (vrai : \(\frac{10}{30}\), \(\frac{12}{30}\), \(\frac{5}{30}\), et \(\frac{3}{30}\) sont tous non négatifs),
- \(P(X = 0) + P(X = 1) + P(X = 2) + P(X = 3) = \frac{10}{30} + \frac{12}{30} + \frac{5}{30} + \frac{3}{30} = \frac{30}{30} = 1\) (vrai : la somme est égale à 1).
Compétences à pratiquer
- Vérifier la validité des lois de probabilité
- Définir une variable aléatoire et sa loi de probabilité
- Calculer des probabilités dans des scénarios de la vie quotidienne
II
Espérance, variance et écart-type
II.1
Espérance
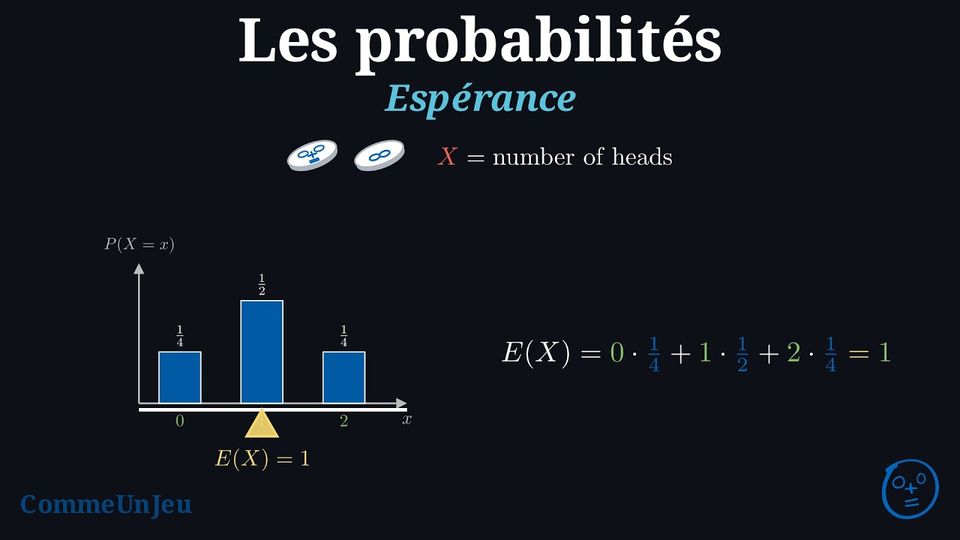
L'espérance d’une variable aléatoire \(X\) est la « moyenne des valeurs si l’on répète l’expérience de nombreuses fois ». Elle est calculée en prenant toutes les valeurs possibles, en multipliant chacune par sa probabilité, et en les additionnant — c'est-à-dire une moyenne pondérée où les probabilités servent de poids.
Définition — Espérance
Soit \(X\) une variable aléatoire prenant les valeurs \(x_1, x_2, \ldots, x_n\). L'espérance de \(X\), notée \(E(X)\) et aussi appelée moyenne, est :$$\begin{aligned}E(X) &= \sum_{i=1}^{n} x_i P(X = x_i)\\
&= x_1 P(X = x_1) + x_2 P(X = x_2) + \cdots + x_n P(X = x_n)\\
\end{aligned}$$ Exemple
On lance 2 pièces équilibrées, et \(X\) est le nombre de « face ». La loi de probabilité est : | \(x\) | 0 | 1 | 2 |
| \(P(X = x)\) | \(\frac{1}{4}\) | \(\frac{1}{2}\) | \(\frac{1}{4}\) |
On calcule \(E(X)\) avec la formule :$$\begin{aligned}E(X) &= 0 \times \frac{1}{4} + 1 \times \frac{1}{2} + 2 \times \frac{1}{4} \\
&= \frac{1}{2} + \frac{2}{4} \\
&= 1\end{aligned}$$ Donc, en moyenne, on s'attend à obtenir 1 « face » en lançant 2 pièces.
Proposition — Espérance de \(aX + b\)
Pour toute variable aléatoire \(X\) et tous réels \(a\) et \(b\) :$$ E(aX + b) = aE(X) + b $$ Cette propriété découle de deux règles plus simples : - \(E(aX) = aE(X)\) (multiplier la variable par \(a\) multiplie son espérance par \(a\)).
- \(E(X+b) = E(X) + b\) (ajouter \(b\) à la variable ajoute \(b\) à son espérance).
Soient \(x_1, \ldots, x_n\) les valeurs de \(X\).
- Cas \(a = 0\). La variable \(aX + b\) est la constante \(b\) : elle prend la seule valeur \(b\), avec la probabilité \(1\), donc \(E(aX + b) = b \times 1 = b\). Et \(aE(X) + b = 0 \times E(X) + b = b\) : les deux membres sont égaux.
- Cas \(a \neq 0\). Deux valeurs différentes de \(X\) donnent deux valeurs différentes de \(aX + b\) : si \(x_i \neq x_j\), alors \(ax_i \neq ax_j\) puisque \(a \neq 0\), donc \(ax_i + b \neq ax_j + b\). Les valeurs \(ax_1 + b, \ldots, ax_n + b\) sont donc deux à deux distinctes, et \(aX + b\) prend la valeur \(ax_i + b\) exactement quand \(X\) prend la valeur \(x_i\) : \(P(aX + b = ax_i + b) = P(X = x_i)\). Donc $$\begin{aligned}E(aX+b) &= \sum_{i} (ax_i + b) P(X=x_i) && \text{(définition de l'espérance)} \\ &= \sum_{i} \left(ax_i P(X=x_i) + b P(X=x_i)\right) && \text{(distributivité)} \\ &= \sum_{i} ax_i P(X=x_i) + \sum_{i} b P(X=x_i) && \text{(somme scindée en deux)} \\ &= a \sum_{i} x_i P(X=x_i) + b \sum_{i} P(X=x_i) && \text{(mise en facteur des constantes } a \text{ et } b\text{)} \\ &= a E(X) + b \times 1 && \text{(définition de } E(X) \text{ ; la somme des probabilités vaut } 1\text{)} \\ &= aE(X) + b.\end{aligned}$$
Jeu équitable
Quand \(X\) est le gain net d'un joueur, mise déduite, \(E(X)\) est le gain moyen par partie sur un grand nombre de parties. Un jeu est équitable quand \(E(X) = 0\) : en moyenne, le joueur ne gagne ni ne perd. Si \(E(X) > 0\), le jeu favorise le joueur ; si \(E(X) < 0\), il favorise l'organisateur. Avec \(G\) le gain brut et \(m\) la mise, \(X = G - m\) : \(G - m\) prend chaque valeur de \(G\) diminuée de \(m\), donc sa moyenne pondérée diminue de \(m\), et \(E(X) = E(G) - m\). Le jeu est équitable quand la mise est égale à l'espérance du gain brut.
Exemple
On lance un dé équilibré. Le joueur reçoit \(6\) euros pour un \(6\), \(3\) euros pour un \(5\) et rien sinon. Déterminer la mise \(m\) qui rend le jeu équitable.
Le gain brut \(G\) prend les valeurs \(6\), \(3\) et \(0\) avec les probabilités \(\frac{1}{6}\), \(\frac{1}{6}\) et \(\frac{4}{6}\). $$\begin{aligned}[t] E(G) &= 6 \times \frac{1}{6} + 3 \times \frac{1}{6} + 0 \times \frac{4}{6} = 1{,}5 && \scriptscriptstyle\text{(définition de l'espérance)} \\
E(X) &= E(G - m) = E(G) - m = 1{,}5 - m && \scriptscriptstyle\text{(chaque valeur de } G \text{ diminuée de } m\text{)} \end{aligned}$$ Le jeu est équitable quand \(E(X) = 0\), c'est-à-dire \(m = 1{,}5\) : une mise de \(1{,}50\) euro. Avec une mise de \(2\) euros, \(E(X) = -0{,}5\) : le joueur perd \(0{,}50\) euro par partie en moyenne.
Compétences à pratiquer
- Calculer des espérances
- Utiliser la linéarité de l'espérance
- Explorer les espérances
- Déterminer la mise d'un jeu équitable
II.2
Variance et écart-type
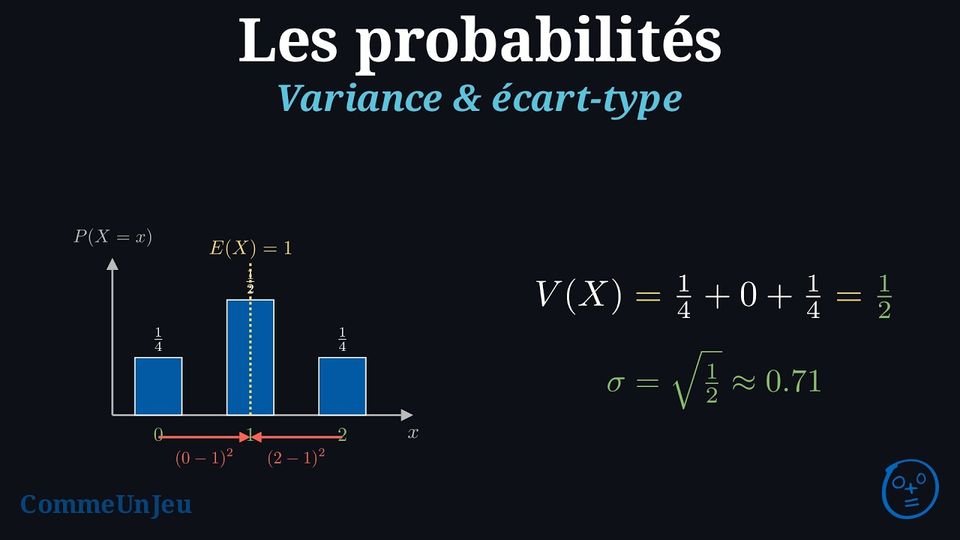
La variance mesure à quel point les valeurs d’une variable aléatoire sont dispersées par rapport à sa valeur attendue. L’écart-type est la racine carrée de la variance, donnant une idée de la déviation typique dans les mêmes unités que \(X\).
Définition — Variance et écart-type
La variance, notée \(V(X)\), est :$$\begin{aligned}V(X) &= \sum_{i=1}^{n} (x_i - E(X))^2 P(X = x_i)\\
&= \left(x_1-E(X)\right)^2 P(X = x_1) + \left(x_2-E(X)\right)^2 P(X = x_2) + \cdots + \left(x_n-E(X)\right)^2 P(X = x_n)\\
\end{aligned}$$ L’écart-type, noté \(\sigma(X)\), est \(\sigma(X) = \sqrt{V(X)}\). Exemple
On lance 2 pièces équilibrées, et \(X\) est le nombre de « face ». Le tableau de probabilité est : | \(x\) | 0 | 1 | 2 |
| \(P(X = x)\) | \(\frac{1}{4}\) | \(\frac{1}{2}\) | \(\frac{1}{4}\) |
On calcule \(V(X)\) :$$\begin{aligned}V(X) &= (0 - 1)^2 \times \frac{1}{4} + (1 - 1)^2 \times \frac{1}{2} + (2 - 1)^2 \times \frac{1}{4} \\
&= 1 \times \frac{1}{4} + 0 \times \frac{1}{2} + 1 \times \frac{1}{4} \\
&= \frac{1}{4} + 0 + \frac{1}{4} \\
&= \frac{1}{2} \\
\end{aligned}$$ La variance est \(\frac{1}{2}\).
Proposition — Formule de König-Huygens
Soit \(X\) prenant les valeurs \(x_1, \dots, x_n\) avec les probabilités \(p_1, \dots, p_n\). En notant \(E(X^2) = p_1 x_1^2 + \dots + p_n x_n^2\) l'espérance des carrés, $$V(X) = E(X^2) - [E(X)]^2.$$ La variance est la moyenne des carrés moins le carré de la moyenne : une formule plus pratique que la définition, puisqu'elle épargne les écarts \(x_i - E(X)\).
On note \(\mu = E(X)\). Pour chaque valeur, \((x_i - \mu)^2 = x_i^2 - 2\mu x_i + \mu^2\). En multipliant par \(p_i\) et en sommant sur \(i\) : $$\begin{aligned}[t] V(X) &= \sum_{i=1}^{n} p_i (x_i - \mu)^2 && \scriptscriptstyle\text{(définition de la variance)} \\
&= \sum_{i=1}^{n} p_i x_i^2 - 2\mu \sum_{i=1}^{n} p_i x_i + \mu^2 \sum_{i=1}^{n} p_i && \scriptscriptstyle\text{(développement et séparation de la somme)} \\
&= E(X^2) - 2\mu \cdot \mu + \mu^2 \cdot 1 && \scriptscriptstyle\text{(}\sum p_i x_i^2 = E(X^2)\text{, }\sum p_i x_i = \mu\text{, }\sum p_i = 1\text{)} \\
&= E(X^2) - \mu^2 = E(X^2) - [E(X)]^2. \end{aligned}$$
Exemple
La loi de \(X\) est donnée par le tableau ci-dessous. Calculer \(V(X)\) avec la formule de König-Huygens, puis contrôler avec la définition. | \(x_i\) | \(-2\) | \(0\) | \(3\) | \(10\) |
| \(P(X = x_i)\) | \(0{,}4\) | \(0{,}3\) | \(0{,}2\) | \(0{,}1\) |
$$\begin{aligned}[t] E(X) &= 0{,}4 \times (-2) + 0{,}3 \times 0 + 0{,}2 \times 3 + 0{,}1 \times 10 = 0{,}8 \\
E(X^2) &= 0{,}4 \times 4 + 0{,}3 \times 0 + 0{,}2 \times 9 + 0{,}1 \times 100 = 13{,}4 \\
V(X) &= E(X^2) - [E(X)]^2 = 13{,}4 - 0{,}64 = 12{,}76 && \scriptscriptstyle\text{(König-Huygens)} \end{aligned}$$ Contrôle avec la définition : \(0{,}4 \times (-2{,}8)^2 + 0{,}3 \times (-0{,}8)^2 + 0{,}2 \times 2{,}2^2 + 0{,}1 \times 9{,}2^2 = 3{,}136 + 0{,}192 + 0{,}968 + 8{,}464 = 12{,}76\). D'où \(\sigma(X) = \sqrt{12{,}76} \approx 3{,}57\).
Méthode — Calculer l'espérance puis la variance et l'écart-type
- Ranger la loi dans deux listes de même longueur : les valeurs dans
x, leurs probabilités dansp, aux mêmes positions. Vérifier que les probabilités ont pour somme \(1\) — ou \(100\) quand elles sont écrites en pourcentage, chaque somme étant alors divisée par \(100\). - Accumuler l'espérance dans une première boucle : \(E = p_1 x_1 + p_2 x_2 + \cdots + p_n x_n\), un produit par position.
- Accumuler la variance dans une seconde boucle, une fois \(E\) connue : \(V = p_1 (x_1 - E)^2 + \cdots + p_n (x_n - E)^2\). Écrite avec les écarts \(x_k - E\), la variance demande cette seconde boucle : chaque terme a besoin de \(E\) tout entière.
- Prendre la racine carrée de \(V\) pour obtenir l'écart-type \(\sigma\).
Exemple
La loi de la variable aléatoire \(X\) est rangée dans deux listes : x est la liste \([-2, 1, 4]\) de ses valeurs et p est la liste \([30, 50, 20]\) de leurs probabilités en pourcentage. Exécuter l'algorithme ci-dessous à la main, donner les deux valeurs qu'il affiche, et en déduire l'écart-type de \(X\). e ← 0
Pour k allant de 0 à longueur de x - 1
e ← e + p[k] × x[k]
Fin Pour
e ← e ÷ 100
Afficher e
v ← 0
Pour k allant de 0 à longueur de x - 1
v ← v + p[k] × (x[k] - e) × (x[k] - e)
Fin Pour
v ← v ÷ 100
Afficher v| Instruction | \(k\) | \(e\) | \(v\) | Affichage |
| départ | \(0\) | |||
| première boucle, tour 1 | \(0\) | \(-60\) | ||
| première boucle, tour 2 | \(1\) | \(-10\) | ||
| première boucle, tour 3 | \(2\) | \(70\) | ||
| \(e \leftarrow e \div 100\), Afficher \(e\) | \(2\) | \(0{,}7\) | \(0{,}7\) | |
| \(v \leftarrow 0\) | \(2\) | \(0{,}7\) | \(0\) | |
| seconde boucle, tour 1 | \(0\) | \(0{,}7\) | \(218{,}7\) | |
| seconde boucle, tour 2 | \(1\) | \(0{,}7\) | \(223{,}2\) | |
| seconde boucle, tour 3 | \(2\) | \(0{,}7\) | \(441\) | |
| \(v \leftarrow v \div 100\), Afficher \(v\) | \(2\) | \(0{,}7\) | \(4{,}41\) | \(4{,}41\) |
0{,}7 puis 4{,}41 : \(E(X) = 0{,}7\) et \(V(X) = 4{,}41\). La première boucle ajoute \(30 \times (-2) = -60\), puis \(50 \times 1 = 50\), puis \(20 \times 4 = 80\). La seconde boucle ajoute les carrés des écarts à \(0{,}7\), chacun pondéré par sa probabilité : \(30 \times 2{,}7^2 = 218{,}7\), puis \(50 \times 0{,}3^2 = 4{,}5\), puis \(20 \times 3{,}3^2 = 217{,}8\). L'écart-type est la racine carrée de la variance, \(\sigma(X) = \sqrt{4{,}41} = 2{,}1\), puisque \(2{,}1^2 = 4{,}41\). La division par \(100\) intervient une fois, après chaque boucle, parce que les probabilités étaient écrites en pourcentage. Compétences à pratiquer
- Calculer des écarts-types
- Décider en fonction des espérances et du risque
- Calculer une variance avec la formule de König-Huygens
- Calculer avec un algorithme
III
Estimer l'espérance par un échantillon
III.1
La loi des grands nombres
Proposition — Loi des grands nombres
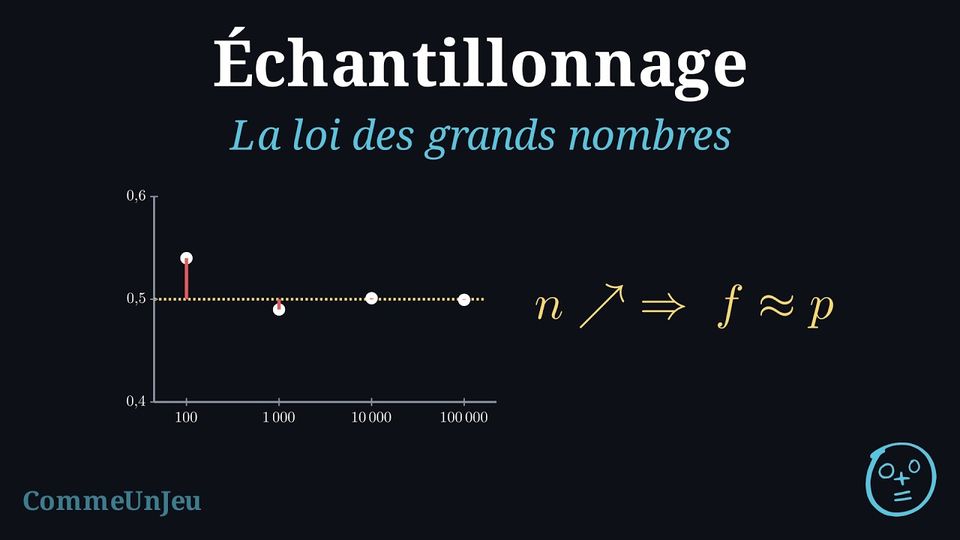
Pour des répétitions indépendantes dans les mêmes conditions, lorsque la taille \(n\) de l'échantillon devient grande, la fréquence observée \(f\) d'un caractère a tendance à se stabiliser autour de la probabilité réelle \(p\) (des fluctuations restent possibles, mais elles diminuent généralement). Lorsqu'un individu est tiré au hasard dans une population, la proportion d'un caractère dans la population est égale à la probabilité de le tirer — estimer l'une, c'est estimer l'autre. Exemple
Lors du lancer d'une pièce équilibrée, la probabilité d'obtenir « pile » est \(p = 0{,}5\). Une simulation informatique de différentes tailles d'échantillon donne : | Taille \(n\) | 100 | 1 000 | 10 000 | 100 000 |
| Nombre de « pile » | 54 | 490 | 5 010 | 49 942 |
| Fréquence \(f\) | 0,54 | 0,49 | 0,501 | 0,49942 |
Compétences à pratiquer
- Comprendre la loi des grands nombres
III.2
Moyenne d'un échantillon et espérance
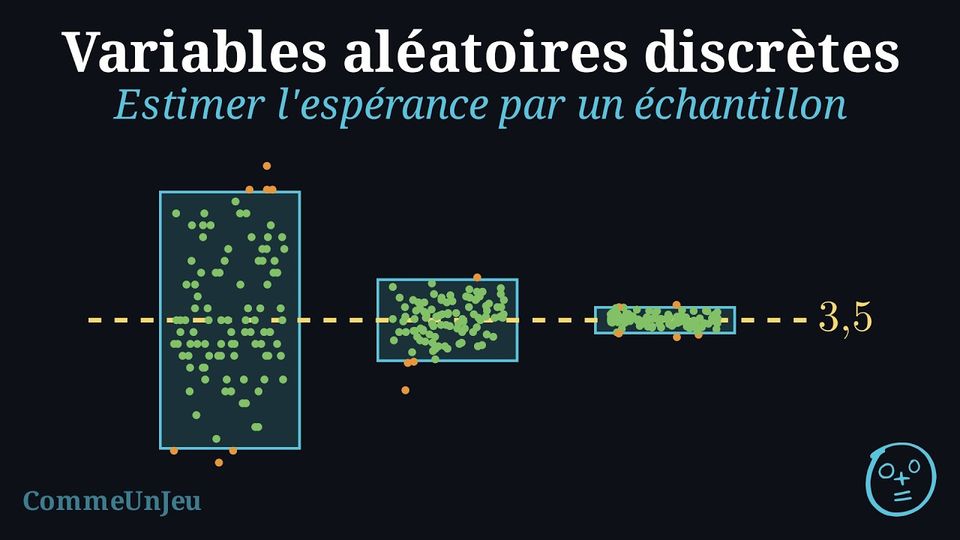
L'espérance est un nombre calculé à partir de la loi de probabilité de \(X\). On peut aussi l'approcher sans la loi, par l'observation : répéter l'expérience \(n\) fois de façon indépendante et dans les mêmes conditions, relever les \(n\) valeurs de \(X\) et calculer leur moyenne \(m\). C'est la loi des grands nombres, qui disait qu'une fréquence approche une probabilité ; ici la moyenne d'un échantillon approche l'espérance. La moyenne \(m\) fluctue d'un échantillon à l'autre, et la fluctuation se resserre quand \(n\) grandit. Les simulations montrent, sans le démontrer, que le plus souvent l'écart entre \(m\) et \(E(X)\) est au plus \(\dfrac{2\sigma(X)}{\sqrt{n}}\) ; un échantillon isolé peut encore tomber au-delà. Une simulation, par exemple avec Python, permettrait de le voir : une fonction qui tire \(n\) valeurs de \(X\) et renvoie leur moyenne.
Définition — Simuler une variable aléatoire
Une variable aléatoire \(X\) qui prend un nombre fini de valeurs est donnée par sa loi : ses valeurs et leurs probabilités, dont la somme vaut \(1\). Simuler \(X\), c'est produire l'une de ses valeurs, chacune avec sa probabilité. Quand les probabilités sont des dixièmes entiers, un seul entier \(r\) tiré entre \(1\) et \(10\), chacun aussi probable que les autres, suffit : la première valeur prend autant de ces entiers que sa probabilité compte de dixièmes, la deuxième valeur prend les suivants, et ainsi de suite. En Python, le tirage est random.randint(1, 10). Répéter la simulation \(n\) fois, de façon indépendante, donne un échantillon de taille \(n\) de \(X\), et la moyenne de ses valeurs est la moyenne de l'échantillon. Exemple
La variable aléatoire \(X\) prend la valeur \(-2\) avec la probabilité \(0{,}3\), la valeur \(1\) avec la probabilité \(0{,}5\) et la valeur \(4\) avec la probabilité \(0{,}2\). L'algorithme ci-dessous simule un échantillon de taille \(10\) de \(X\) : à chaque tour, il lit un entier tiré entre \(1\) et \(10\). Les nombres lus sont, dans l'ordre, \(7\), \(2\), \(9\), \(5\), \(10\), \(1\), \(6\), \(4\), \(8\), \(6\). L'exécuter à la main et donner les deux valeurs qu'il affiche. s ← 0
Pour k allant de 1 à 10
Lire r
Si r ≤ 3 alors
x ← -2
Sinon Si r ≤ 8 alors
x ← 1
Sinon
x ← 4
Fin Si
s ← s + x
Fin Pour
Afficher s
m ← s ÷ 10
Afficher m| Instruction | \(k\) | \(r\) | \(x\) | \(s\) | Affichage |
| départ | \(0\) | ||||
| tour 1 | \(1\) | \(7\) | \(1\) | \(1\) | |
| tour 2 | \(2\) | \(2\) | \(-2\) | \(-1\) | |
| tour 3 | \(3\) | \(9\) | \(4\) | \(3\) | |
| tour 4 | \(4\) | \(5\) | \(1\) | \(4\) | |
| tour 5 | \(5\) | \(10\) | \(4\) | \(8\) | |
| tour 6 | \(6\) | \(1\) | \(-2\) | \(6\) | |
| tour 7 | \(7\) | \(6\) | \(1\) | \(7\) | |
| tour 8 | \(8\) | \(4\) | \(1\) | \(8\) | |
| tour 9 | \(9\) | \(8\) | \(1\) | \(9\) | |
| tour 10 | \(10\) | \(6\) | \(1\) | \(10\) | |
| Afficher \(s\) | \(10\) | \(6\) | \(1\) | \(10\) | \(10\) |
| \(m \leftarrow s \div 10\), Afficher \(m\) | \(10\) | \(6\) | \(1\) | \(10\) | \(1{,}0\) |
10 puis 1{,}0. Les trois tranches d'entiers suivent la loi : de \(1\) à \(3\), on obtient \(-2\), trois entiers sur dix pour une probabilité de \(0{,}3\) ; de \(4\) à \(8\), on obtient \(1\), cinq entiers pour \(0{,}5\) ; \(9\) et \(10\) donnent \(4\), deux entiers pour \(0{,}2\). Dans cet échantillon, \(-2\) est sorti deux fois, \(1\) six fois et \(4\) deux fois : des fréquences de \(0{,}2\), \(0{,}6\) et \(0{,}2\), proches de la loi sans lui être égales. La moyenne de l'échantillon vaut \(1{,}0\). Ce n'est pas l'espérance de \(X\) — un autre échantillon pourrait donner une autre moyenne. Compétences à pratiquer
- Comparer la moyenne d'un échantillon à l'espérance
- Écrire la simulation en Python
III.3
Simuler de nombreux échantillons
Définition — Simuler de nombreux échantillons
Un algorithme simule \(N\) échantillons de taille \(n\) de \(X\), l'un après l'autre, chaque valeur tirée indépendamment selon la loi de \(X\) ; il calcule la moyenne \(m\) de chaque échantillon et compte les échantillons dont la moyenne est à une distance d'au plus \(d\) donnée de l'espérance \(\mu = E(X)\), c'est-à-dire \(|m - \mu| \leqslant d\). La proportion d'échantillons dans la bande est ce compte divisé par \(N\). Deux boucles sont imbriquées : la boucle intérieure tire les \(n\) valeurs d'un échantillon et les additionne, la somme étant remise à \(0\) au début de chaque échantillon, et la boucle extérieure répète cela \(N\) fois. La distance souvent choisie est \(d = \dfrac{2\sigma}{\sqrt{n}}\) avec \(\sigma = \sigma(X)\) ; pourquoi cette distance, et quelle proportion attendre, relèvent des probabilités. L'algorithme ne démontre rien : la proportion qu'il donne est une observation faite sur des simulations, et elle peut changer d'une exécution à l'autre. Exemple
\(X\) est le résultat d'un dé équilibré. Une simulation informatique d'échantillons de tailles différentes a donné les moyennes ci-dessous. Calculer \(E(X)\) et \(\sigma(X)\), puis comparer chaque écart \(|m - E(X)|\) à \(\dfrac{2\sigma(X)}{\sqrt{n}}\). | \(n\) | \(10\) | \(100\) | \(1000\) |
| \(m\) | \(3{,}9\) | \(3{,}42\) | \(3{,}512\) |
Chaque face a la probabilité \(\frac{1}{6}\). $$\begin{aligned}[t] E(X) &= \frac{1 + 2 + 3 + 4 + 5 + 6}{6} = 3{,}5 \\
V(X) &= \frac{(-2{,}5)^2 + (-1{,}5)^2 + (-0{,}5)^2 + 0{,}5^2 + 1{,}5^2 + 2{,}5^2}{6} = \frac{17{,}5}{6} = \frac{35}{12} && \scriptscriptstyle\text{(définition de la variance)} \\
\sigma(X) &= \sqrt{\tfrac{35}{12}} \approx 1{,}71 \end{aligned}$$
Dans cette simulation, chaque écart est sous la borne, et les deux se resserrent quand \(n\) grandit : avec \(1000\) lancers la borne vaut un dixième environ et l'écart observé un centième environ. La borne est divisée par \(\sqrt{10} \approx 3{,}2\) chaque fois que \(n\) est multiplié par \(10\) : la précision typique gagne une décimale quand l'échantillon est cent fois plus grand. Une autre simulation donnerait d'autres moyennes, parfois au-delà de la borne : la même simulation répétée \(100\) fois avec \(n = 100\) a donné \(96\) moyennes dans la borne et \(4\) au-delà. C'est la tendance que la borne décrit.
| \(n\) | \(10\) | \(100\) | \(1000\) |
| \(|m - 3{,}5|\) | \(0{,}4\) | \(0{,}08\) | \(0{,}012\) |
| \(2\sigma(X)/\sqrt{n}\) | \(\approx 1{,}08\) | \(\approx 0{,}34\) | \(\approx 0{,}11\) |
Exemple
La variable aléatoire \(X\) prend les valeurs \(-2\), \(1\) et \(4\) avec les probabilités \(0{,}3\), \(0{,}5\) et \(0{,}2\) ; son espérance vaut \(E(X) = 0{,}7\) et son écart-type \(\sigma(X) = 2{,}1\). Cinq échantillons de taille \(100\) de \(X\) ont été simulés, et l'algorithme ci-dessous lit la somme de chaque échantillon. La bande autour de \(E(X)\) a pour demi-largeur \(\dfrac{2 \times 2{,}1}{\sqrt{100}} = 0{,}42\). Les nombres lus sont, dans l'ordre, \(61\), \(118\), \(34\), \(91\), \(73\). L'exécuter à la main et donner les deux valeurs qu'il affiche. c ← 0
Pour k allant de 1 à 5
Lire s
m ← s ÷ 100
Si m - 0.7 ≤ 0.42 et 0.7 - m ≤ 0.42 alors
c ← c + 1
Fin Si
Fin Pour
Afficher c
f ← c ÷ 5
Afficher f| Instruction | \(k\) | \(s\) | \(m\) | dans la bande | \(c\) | Affichage |
| départ | \(0\) | |||||
| tour 1 | \(1\) | \(61\) | \(0{,}61\) | vrai | \(1\) | |
| tour 2 | \(2\) | \(118\) | \(1{,}18\) | faux | \(1\) | |
| tour 3 | \(3\) | \(34\) | \(0{,}34\) | vrai | \(2\) | |
| tour 4 | \(4\) | \(91\) | \(0{,}91\) | vrai | \(3\) | |
| tour 5 | \(5\) | \(73\) | \(0{,}73\) | vrai | \(4\) | |
| Afficher \(c\) | \(5\) | \(73\) | \(0{,}73\) | \(4\) | \(4\) | |
| \(f \leftarrow c \div 5\), Afficher \(f\) | \(5\) | \(73\) | \(0{,}73\) | \(4\) | \(0{,}8\) |
4 puis 0{,}8. Les deux comparaisons reliées par et disent que \(m\) dépasse \(0{,}7\) d'au plus \(0{,}42\) et lui est inférieure d'au plus \(0{,}42\), ce qui est \(|m - 0{,}7| \leqslant 0{,}42\) écrit sans valeur absolue. Les écarts valent \(0{,}09\), \(0{,}48\), \(0{,}36\), \(0{,}21\) et \(0{,}03\) : seul le deuxième échantillon, de moyenne \(1{,}18\), sort de la bande. Quatre échantillons sur cinq, c'est bien trop peu pour dire quoi que ce soit de la proportion ; l'expérience n'a de sens qu'avec de nombreux échantillons, que seule une machine peut simuler. L'expérience complète, en Python, tire elle-même les \(N\) échantillons : import random
def value():
r = random.randint(1, 10)
if r <= 3:
return -2
elif r <= 8:
return 1
else:
return 4
def proportion_in_band(N, n):
c = 0
for j in range(N):
s = 0
for k in range(n):
s = s + value()
m = s / n
if abs(m - 0.7) <= 2 * 2.1 / n ** 0.5:
c = c + 1
return c / Nproportion_in_band(1000, 100) peut donner un nombre différent d'une exécution à l'autre, le plus souvent entre \(0{,}93\) et \(0{,}97\). Une moyenne située exactement sur un bord de la bande, comme \(1{,}12\), peut être mal classée à cause de l'arrondi des nombres décimaux dans la machine ; cela déplace la proportion d'un échantillon sur \(N\) au plus. Compétences à pratiquer
- Étudier la bande et la taille de l'échantillon
IV
Pour aller plus loin
Compétences à pratiquer
- Problèmes de variables aléatoires
- Quiz
Aller à la section