Éducation Nationale Française · Terminale Technologie
Deux variables : changement de variable
I
Nuage de points et corrélation
I.1
Deux caractères quantitatifs
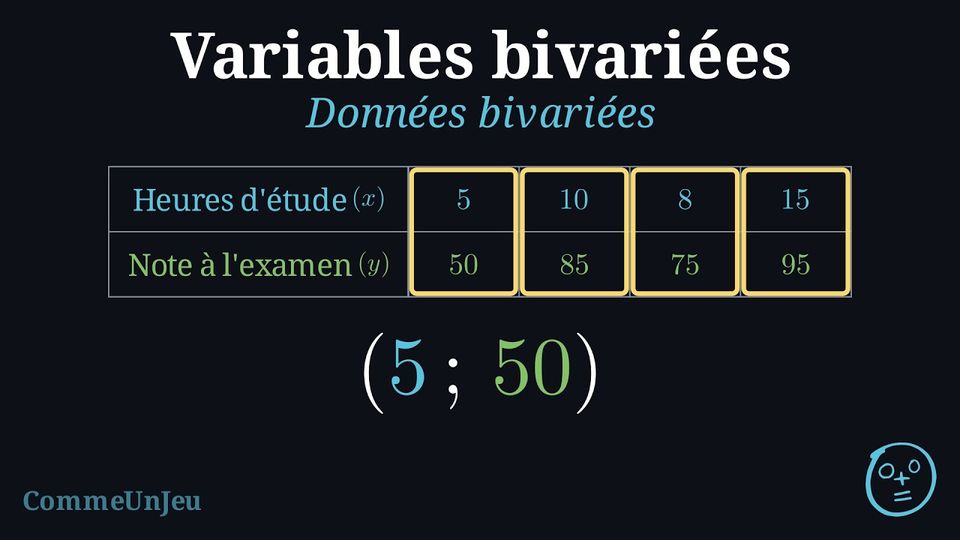
En statistique univariée, on analyse une seule variable à la fois. La statistique bivariée étend cette analyse pour explorer la relation entre deux variables. En examinant des paires de données, on peut rechercher des motifs, déterminer la nature et la force de leur relation, et utiliser cette relation pour faire des prédictions. La statistique à deux variables étudie la relation entre deux variables quantitatives.
Définition — Données bivariées
Les données bivariées sont formées de couples de valeurs de deux variables quantitatives, relevées pour chaque individu d'une population. Lorsqu'une variable est étudiée comme explication possible de l'autre, on écrit les couples \((x ; y)\), où : - \(x\) est la variable indépendante (ou variable explicative).
- \(y\) est la variable dépendante (ou variable expliquée).
Exemple
Un enseignant enregistre les heures d'étude de chaque élève (\(x\)) et leur note à l'examen final (\(y\)). | Heures d'étude (\(x\)) | 5 | 10 | 8 | 15 |
| Note à l'examen (\(y\)) | 50 | 85 | 75 | 95 |
Compétences à pratiquer
- Identifier la variable explicative et la variable expliquée
I.2
Le nuage de points
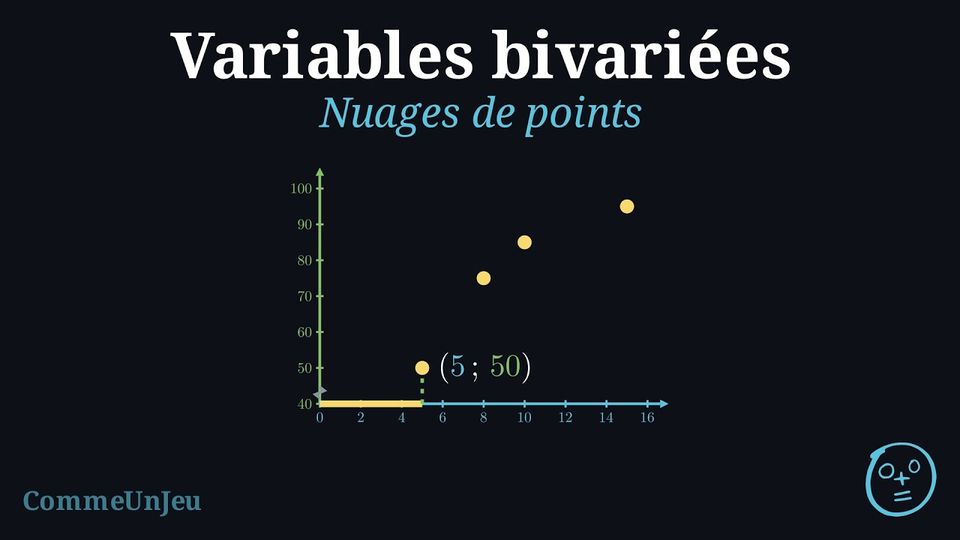
Définition — Nuage de points
Un nuage de points est un graphique qui représente des données bivariées par un ensemble de points dans un repère. La variable indépendante (explicative) est placée sur l'axe horizontal (axe des \(x\)), et la variable dépendante (expliquée) est placée sur l'axe vertical (axe des \(y\)).
Un nuage de points est le principal outil pour repérer, à l'œil, une relation éventuelle, ou corrélation, entre deux variables quantitatives.
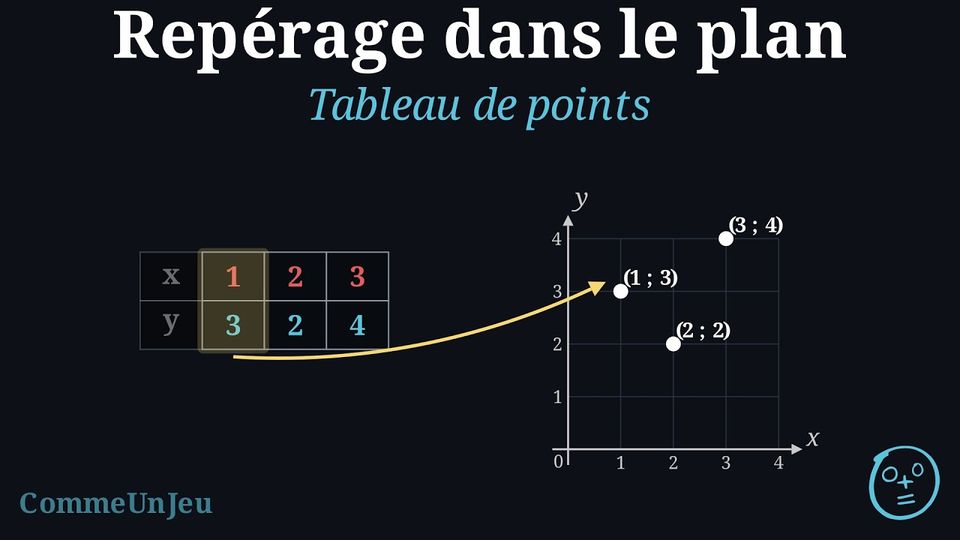
Méthode — Construire un nuage de points
- Identifier les variables : déterminer quelle variable est indépendante (\(x\)) et laquelle est dépendante (\(y\)).
- Préparer les axes : tracer et légender l'axe horizontal pour la variable \(x\) et l'axe vertical pour la variable \(y\), et choisir sur chaque axe une échelle adaptée à l'étendue des données.
- Placer les points : pour chaque couple \((x ; y)\) de la série, placer le point de coordonnées \((x ; y)\).
Exemple
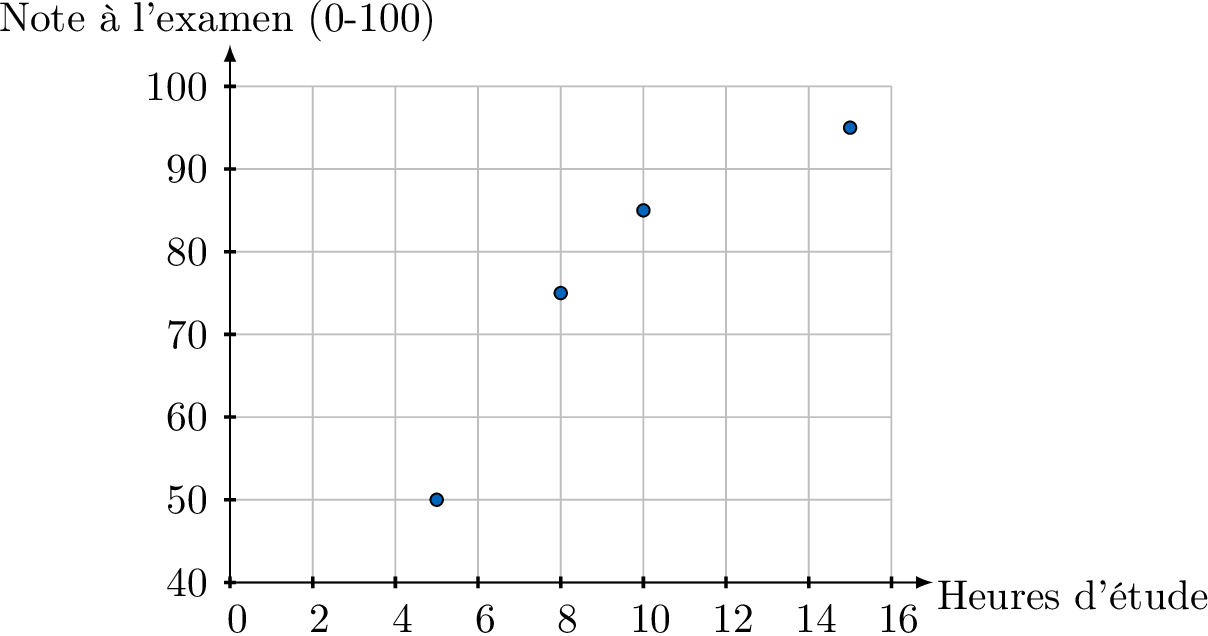
Un enseignant a relevé le nombre d’heures d’étude de ses élèves et leur note à l’examen : | Heures d’étude (\(x\)) | 5 | 10 | 8 | 15 |
| Note à l’examen (\(y\)) | 50 | 85 | 75 | 95 |
- Variables : « Heures d’étude » est la variable indépendante (\(x\)) et « Note à l’examen » est la variable dépendante (\(y\)).
- Axes : l’axe des abscisses porte « Heures d’étude » et l’axe des ordonnées « Note à l’examen » ; les échelles couvrent l’étendue des données.
- Placer les points : on place les quatre couples de coordonnées : \((5 ; 50)\), \((10 ; 85)\), \((8 ; 75)\) et \((15 ; 95)\).
Compétences à pratiquer
- Associer des tableaux de données à des nuages de points
- Tracer des nuages de points
I.3
Lire un nuage de points
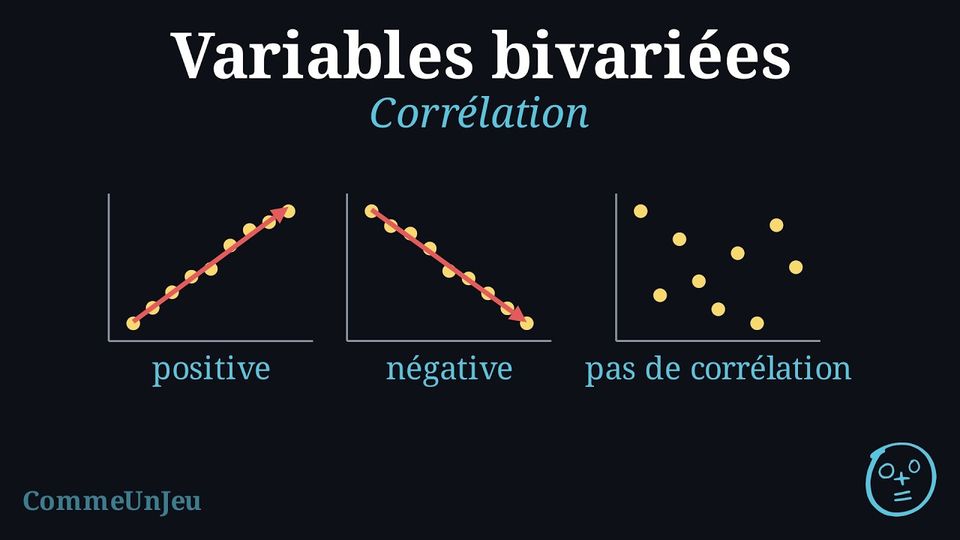
Définition — Corrélation
La corrélation décrit la nature de la relation entre deux variables quantitatives. Définition — Sens : corrélation positive ou négative
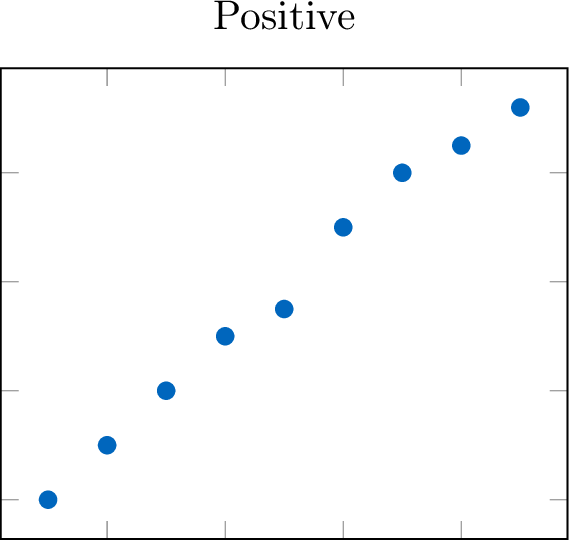
Le sens d'une corrélation décrit la tendance générale des données. - Positive : lorsque la variable indépendante (\(x\)) augmente, la variable dépendante (\(y\)) a tendance à augmenter. Les points suivent une tendance à la hausse.
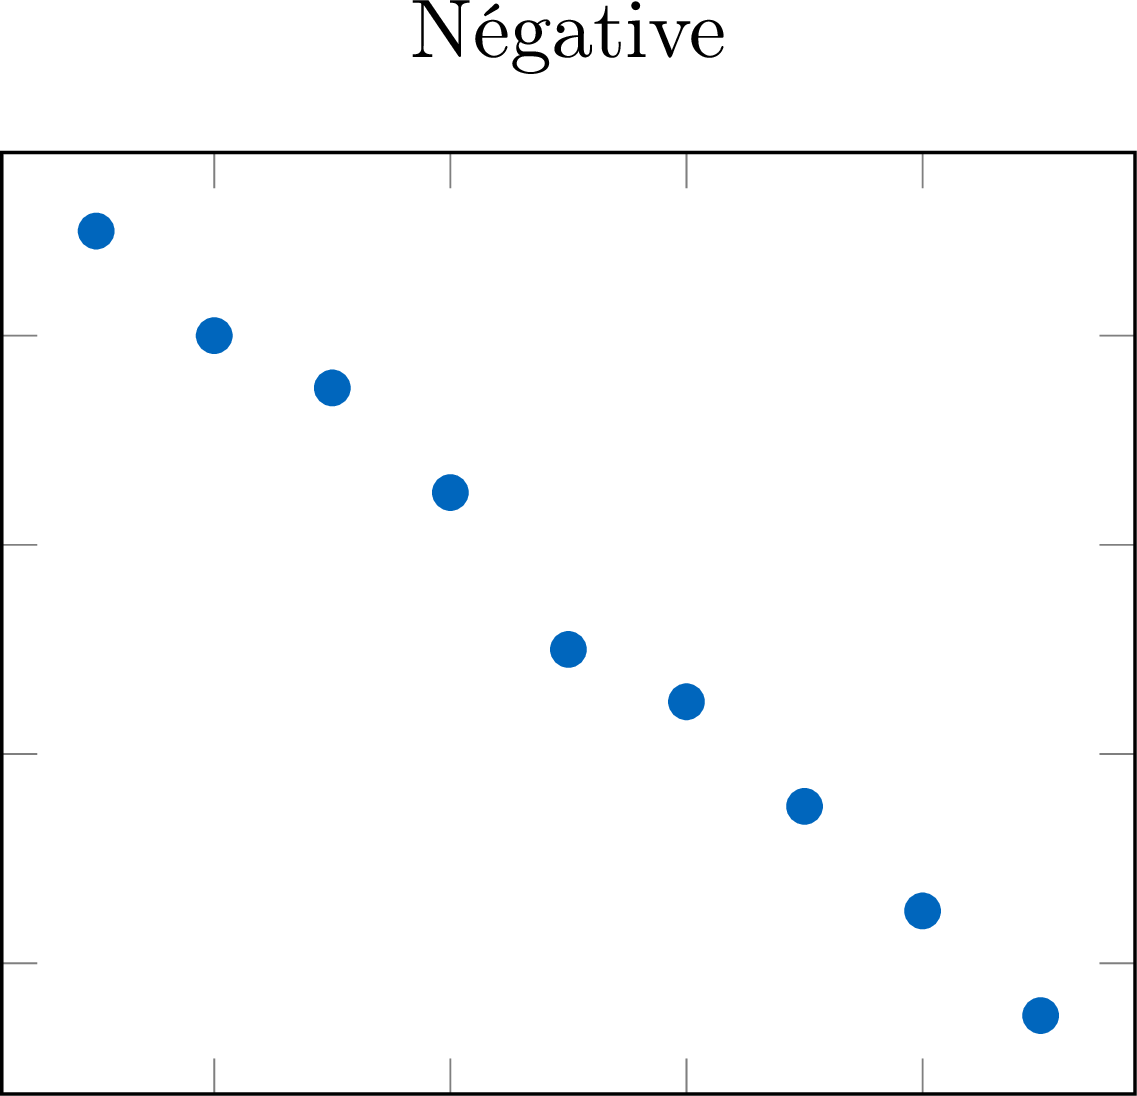
- Négative : lorsque la variable indépendante (\(x\)) augmente, la variable dépendante (\(y\)) a tendance à diminuer. Les points suivent une tendance à la baisse.
Définition — Forme : linéaire ou non linéaire
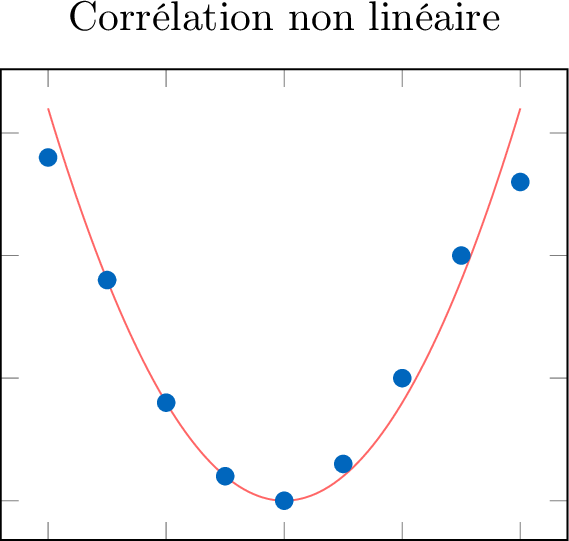
La forme de la relation est linéaire si les points semblent alignés le long d'une droite. S'ils suivent une courbe qui n'est pas une droite, la forme est non linéaire. 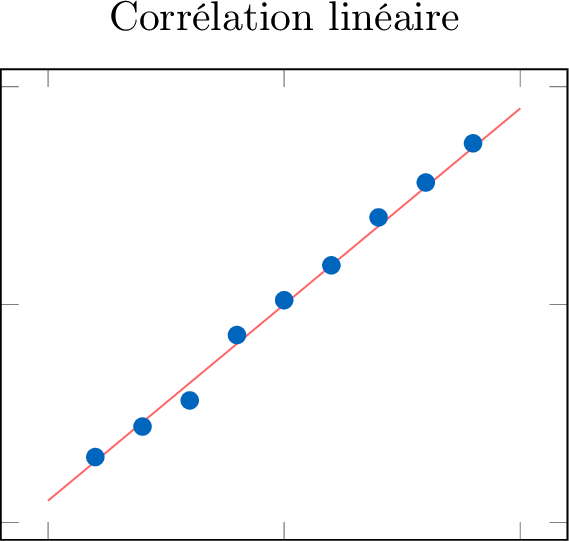
Définition — Force
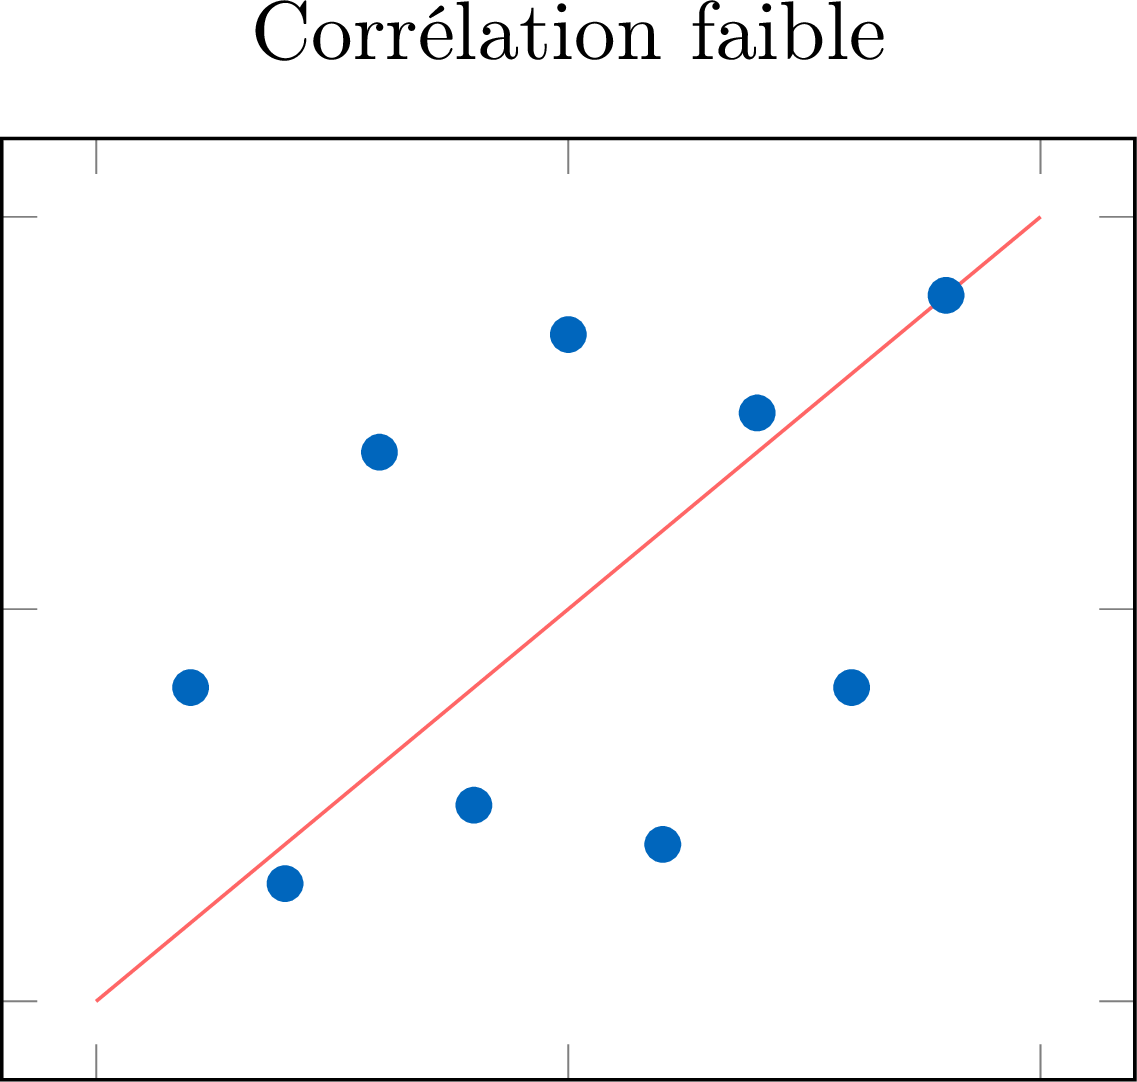
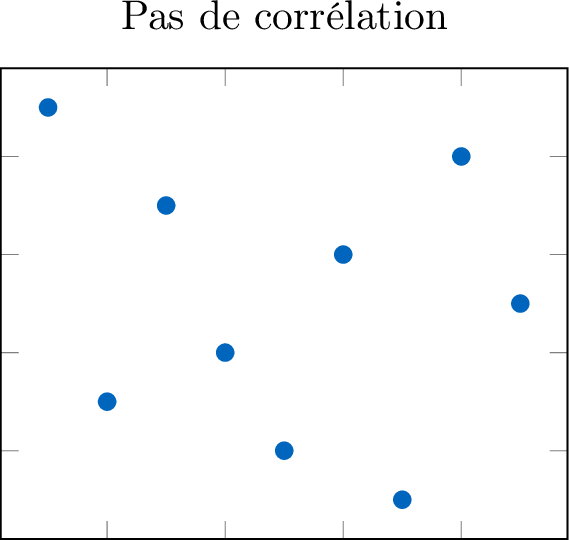
La force d'une corrélation décrit à quel point les points sont proches de la forme repérée. 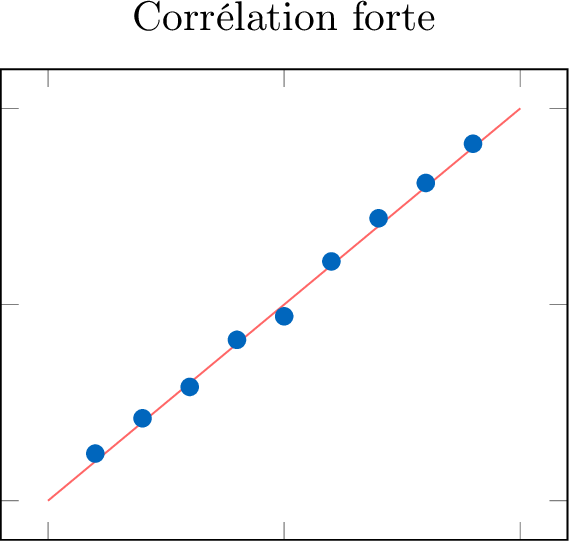
Définition — Données aberrantes
Une donnée aberrante est un point qui s'écarte nettement de la tendance générale du nuage. 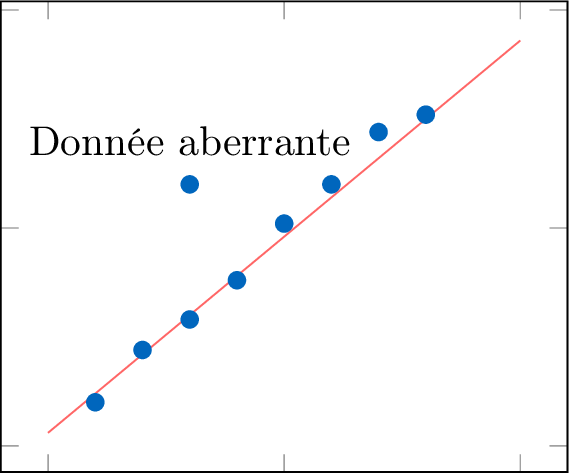
Méthode — Décrire une corrélation
Pour décrire la relation que montre un nuage de points, on commente toujours les quatre caractéristiques suivantes, en une phrase concise. - Sens : la tendance est-elle croissante (corrélation positive), décroissante (corrélation négative), ou ni l'une ni l'autre ?
- Forme : est-elle linéaire, non linéaire, ou sans forme nette ?
- Force : est-elle forte, modérée ou faible ?
- Données aberrantes : y a-t-il des données aberrantes ?
Exemple
Décrire la corrélation entre les heures d'étude et les notes à l'examen que montre ce nuage de points. 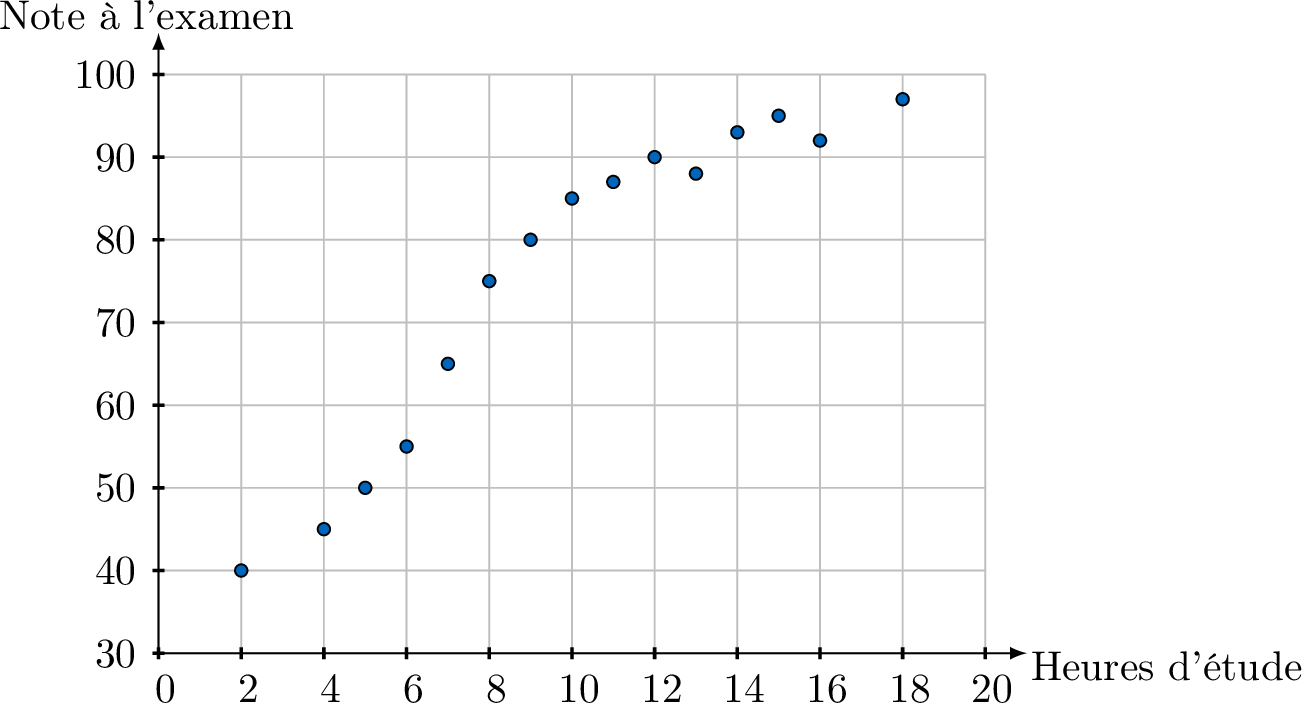
Il y a une corrélation positive et forte entre les heures d'étude et les notes à l'examen : à mesure que le nombre d'heures d'étude augmente, la note à l'examen a tendance à augmenter. Sa forme n'est pas tout à fait linéaire : les notes montent vite jusqu'à environ \(10\) heures, puis plafonnent, et le nuage se courbe. Il n'y a pas de données aberrantes évidentes.
Compétences à pratiquer
- Déterminer le sens de la corrélation
- Déterminer la force de la corrélation
- Identifier la forme d'une corrélation
- Interpréter les tendances dans les nuages de points
I.4
Corrélation n'est pas causalité
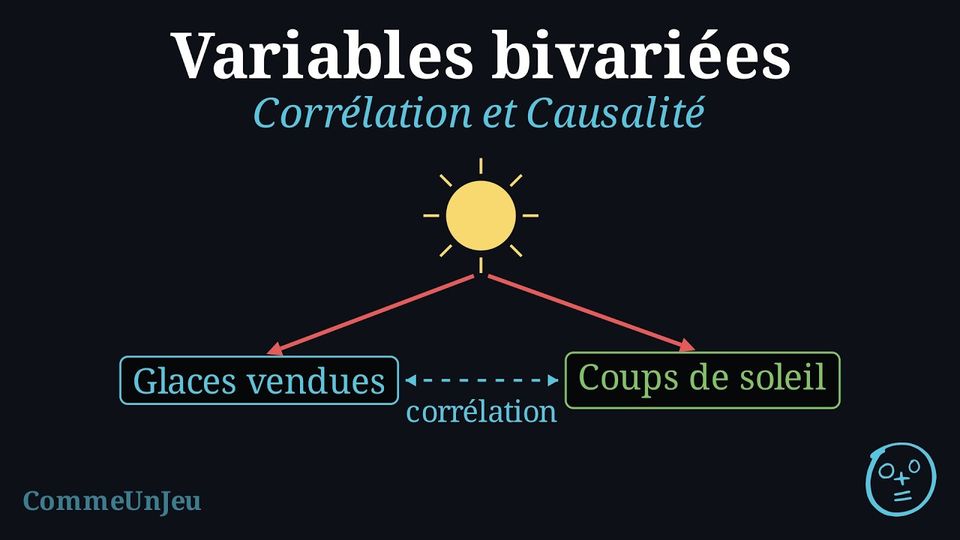
La corrélation n'implique pas la causalité
L'observation d'une relation statistique (corrélation) entre deux variables, \(x\) et \(y\), n'est pas une preuve suffisante pour conclure qu'un changement de \(x\) provoque un changement de \(y\).
Définition — Causalité
Il y a causalité lorsqu'une variation de la variable indépendante produit, directement ou par étapes intermédiaires, une variation de la variable dépendante. La preuve la plus solide d'une causalité est une expérience contrôlée bien conçue ; des observations seules suffisent rarement. Définition — Variable de confusion
Souvent, une corrélation entre deux variables (\(x\) et \(y\)) est créée ou déformée par un tiers facteur — observé ou non — appelé variable de confusion. Cette variable influence à la fois \(x\) et \(y\), si bien qu'une partie ou la totalité de leur corrélation vient d'elle et non d'un lien direct entre \(x\) et \(y\). Exemple
Les données montrent une forte corrélation positive entre les ventes de glaces et le nombre de personnes qui attrapent un coup de soleil.Cela signifie-t-il que manger des glaces provoque des coups de soleil ? Sinon, décrire la relation et indiquer la variable de confusion probable.
Non, manger des glaces ne provoque pas de coups de soleil. 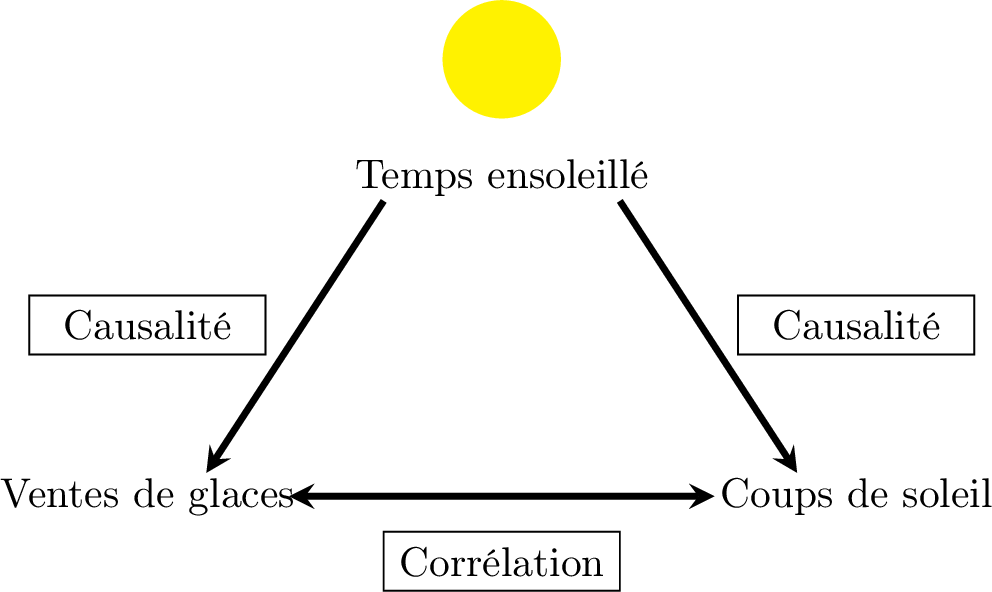
- La relation entre les ventes de glaces et les cas de coups de soleil est une corrélation, et non une causalité.
- La variable de confusion probable est le temps ensoleillé : les journées chaudes et ensoleillées provoquent à la fois une hausse des ventes de glaces et une hausse du nombre de personnes qui attrapent un coup de soleil.
Compétences à pratiquer
- Distinguer corrélation et causalité
- Expliquer une corrélation
II
Ajuster un nuage de points
II.1
Le point moyen et la droite ajustée
Définition — Point moyen
Le point moyen d'un nuage de points \((x_1\,;\,y_1), (x_2\,;\,y_2), \ldots, (x_n\,;\,y_n)\) est le point \(G(\bar{x}\,;\,\bar{y})\) dont les coordonnées sont les moyennes des deux variables : $$\bar{x} = \frac{x_1 + x_2 + \cdots + x_n}{n} \qquad \text{et} \qquad \bar{y} = \frac{y_1 + y_2 + \cdots + y_n}{n}.$$ Le point moyen est le « centre de gravité » du nuage : ce n'est en général pas l'un des points tracés. Méthode — Ajuster une droite au jugé
Lorsque les points d'un nuage sont à peu près alignés, on peut ajuster une droite au nuage, c'est-à-dire tracer une droite qui suit la tendance des points : - Placer le point moyen \(G\) et faire passer la droite par \(G\).
- Suivre le nuage : faire tourner la droite autour de \(G\) pour qu'elle suive la direction des points, tous aussi proches d'elle que possible — pour contrôler grossièrement, les points doivent se répartir des deux côtés de la droite.
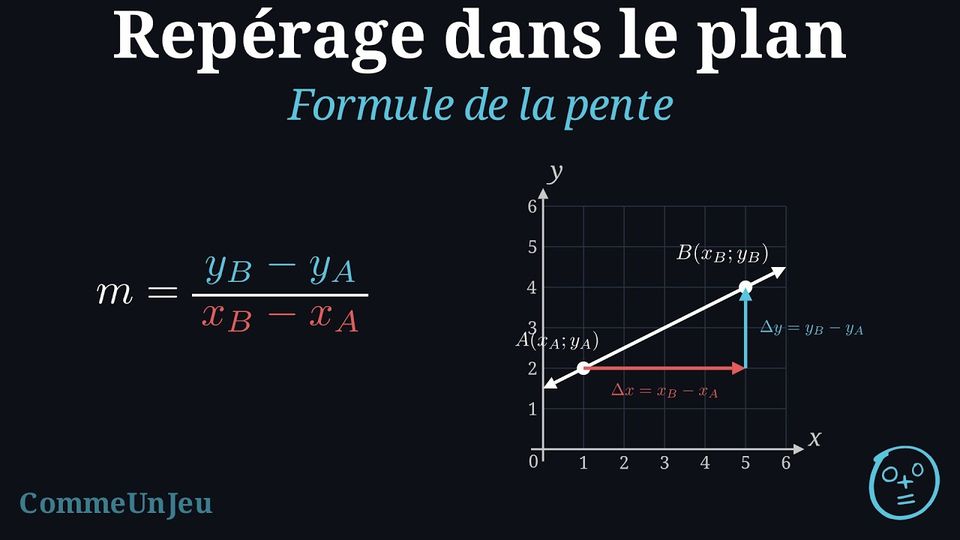
- Lire son équation \(y = ax + b\) sur le graphique (deux points de la droite donnent \(a\), puis \(b\)).
Définition — Droite de Mayer
Pour ajuster une droite sans jugement, on peut utiliser la droite de Mayer : on range les points par \(x\) croissant et on partage le nuage en deux moitiés (la moitié des plus petites abscisses et la moitié des plus grandes ; si le nombre de points est impair, une moitié prend un point de plus) ; \(G_1\) et \(G_2\) sont les points moyens des deux moitiés, et la droite de Mayer est la droite \((G_1 G_2)\). Dès que les abscisses ne sont pas toutes égales, \(G_1\) et \(G_2\) ont des abscisses différentes et la droite n'est pas verticale. Elle passe toujours par le point moyen \(G\) du nuage entier (quand les moitiés ont la même taille, \(G\) est le milieu de \([G_1 G_2]\)). Exemple
La population d'une ville (en milliers d'habitants) a été relevée tous les quatre ans. La variable \(x\) est le nombre d'années écoulées depuis le premier relevé. | \(x\) (années) | \(0\) | \(4\) | \(8\) | \(12\) | \(16\) | \(20\) |
| \(y\) (milliers) | \(12{,}0\) | \(12{,}7\) | \(14{,}0\) | \(14{,}5\) | \(15{,}9\) | \(16{,}4\) |
- Tracer le nuage de points et calculer les coordonnées du point moyen \(G\).
- Calculer les points moyens \(G_1\) et \(G_2\) des deux moitiés, puis une équation de la droite de Mayer. Vérifier qu'elle passe par \(G\).
- Utiliser la droite pour estimer la population deux ans après le premier relevé, puis trente ans après. Laquelle des deux estimations est la moins digne de confiance ?
- \(\bar{x} = \dfrac{0 + 4 + 8 + 12 + 16 + 20}{6} = \dfrac{60}{6} = 10\) et \(\bar{y} = \dfrac{12{,}0 + 12{,}7 + 14{,}0 + 14{,}5 + 15{,}9 + 16{,}4}{6} = \dfrac{85{,}5}{6} = 14{,}25\) : \(G(10\,;\,14{,}25)\).
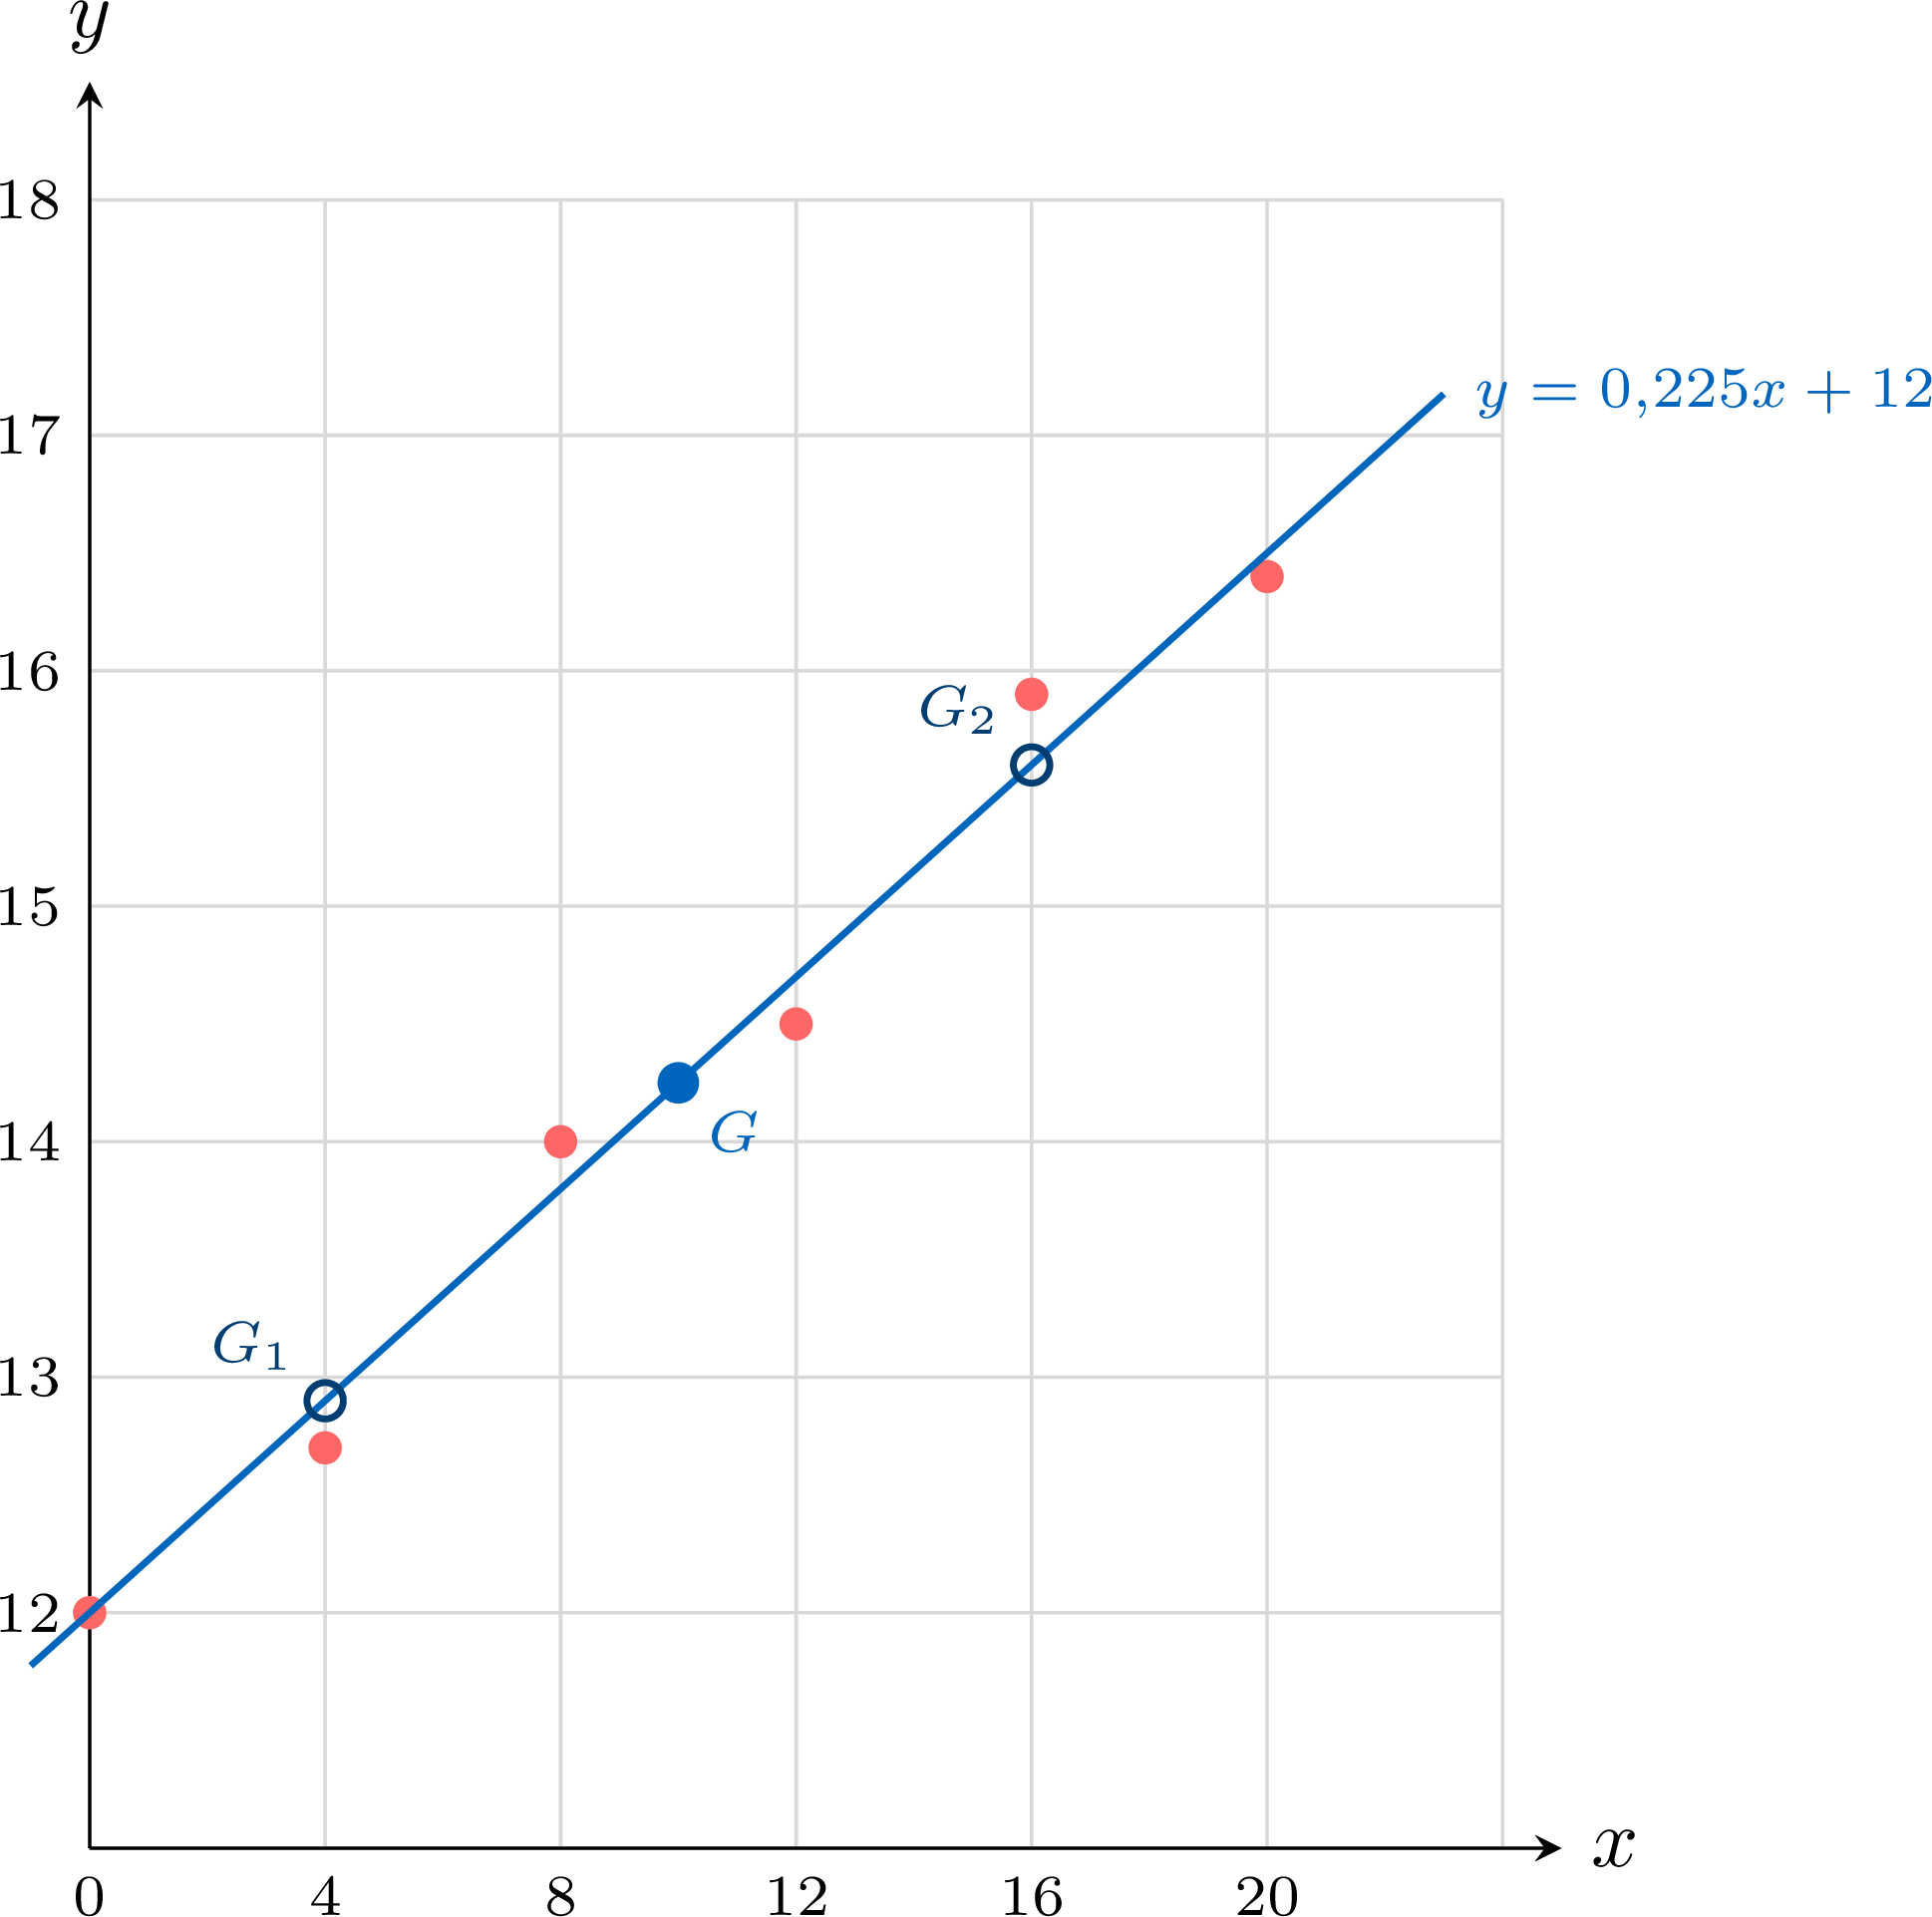
- Trois premiers points (\(x = 0\,;\,4\,;\,8\)) : \(G_1\left(\dfrac{0 + 4 + 8}{3}\,;\,\dfrac{12{,}0 + 12{,}7 + 14{,}0}{3}\right) = G_1(4\,;\,12{,}9)\). Trois derniers points (\(x = 12\,;\,16\,;\,20\)) : \(G_2(16\,;\,15{,}6)\). Le coefficient directeur de \((G_1 G_2)\) est \(a = \dfrac{15{,}6 - 12{,}9}{16 - 4} = \dfrac{2{,}7}{12} = 0{,}225\), et \(b = 12{,}9 - 0{,}225 \times 4 = 12\) : la droite de Mayer a pour équation \(y = 0{,}225x + 12\). Contrôle : \(0{,}225 \times 10 + 12 = 14{,}25 = \bar{y}\), donc \(G\) est sur la droite. Les points ne sont pas sur la droite — deux au-dessus, trois au-dessous et un sur elle — et c'est tout l'intérêt : la droite résume le nuage, elle ne passe pas par lui.
- Deux ans après le premier relevé, \(x = 2\) : \(y = 0{,}225 \times 2 + 12 = 12{,}45\), environ \(12\,450\) habitants — une estimation entre deux relevés. Trente ans après, \(x = 30\) : \(y = 0{,}225 \times 30 + 12 = 18{,}75\), environ \(18\,750\) habitants. La seconde estimation va dix ans au-delà du dernier relevé et suppose que la croissance garde le même rythme, ce que rien dans les données ne garantit : c'est la moins digne de confiance.
Compétences à pratiquer
- Évaluer la pertinence d'un modèle linéaire
- Calculer le point moyen
- Estimer la droite d'ajustement au jugé
- Déterminer la droite de Mayer
II.2
La droite des moindres carrés
Choisir une droite
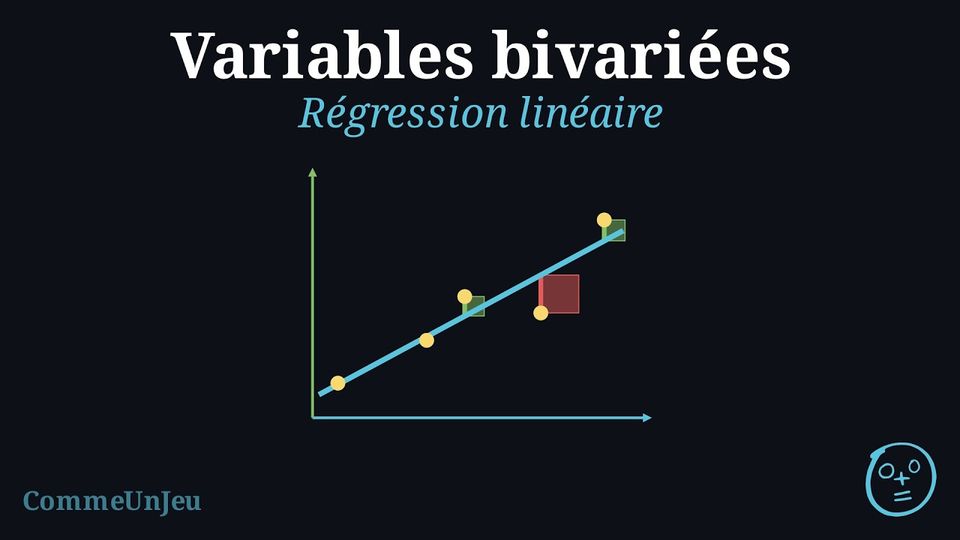
Une règle posée « au jugé » sur un nuage de points donne une droite, mais une autre personne en poserait une autre : même par le point moyen, une infinité de droites passent près des points. Il faut un critère. Pour une droite \(y = ax + b\), le point \(P_i(x_i ; ax_i + b)\) de la droite a la même abscisse que le point \(M_i(x_i ; y_i)\) du nuage, et l'écart vertical entre eux vaut \(y_i - (ax_i + b)\). Dans une somme, les écarts au-dessus et au-dessous de la droite pourraient se compenser et masquer de grands écarts : on additionne donc leurs carrés : $$S(a ; b) = \sum_{i=1}^{n} \big(y_i - (ax_i + b)\big)^2 .$$ La droite des moindres carrés est la droite pour laquelle cette somme est la plus petite possible. 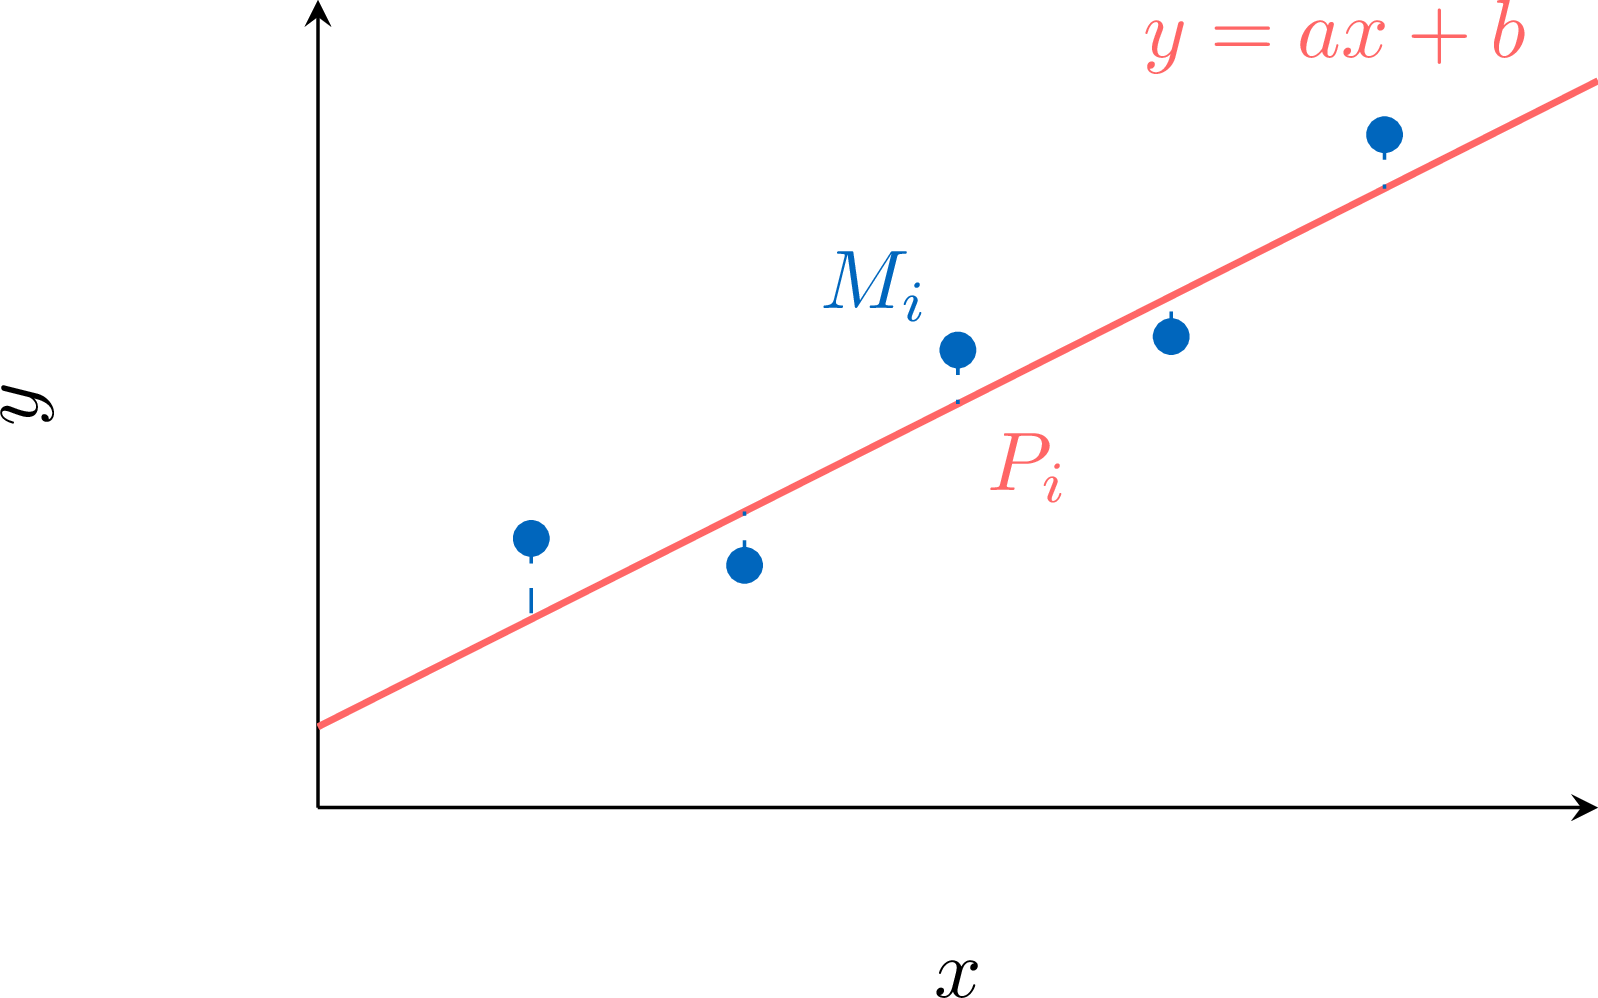
Définition — Droite de régression des moindres carrés
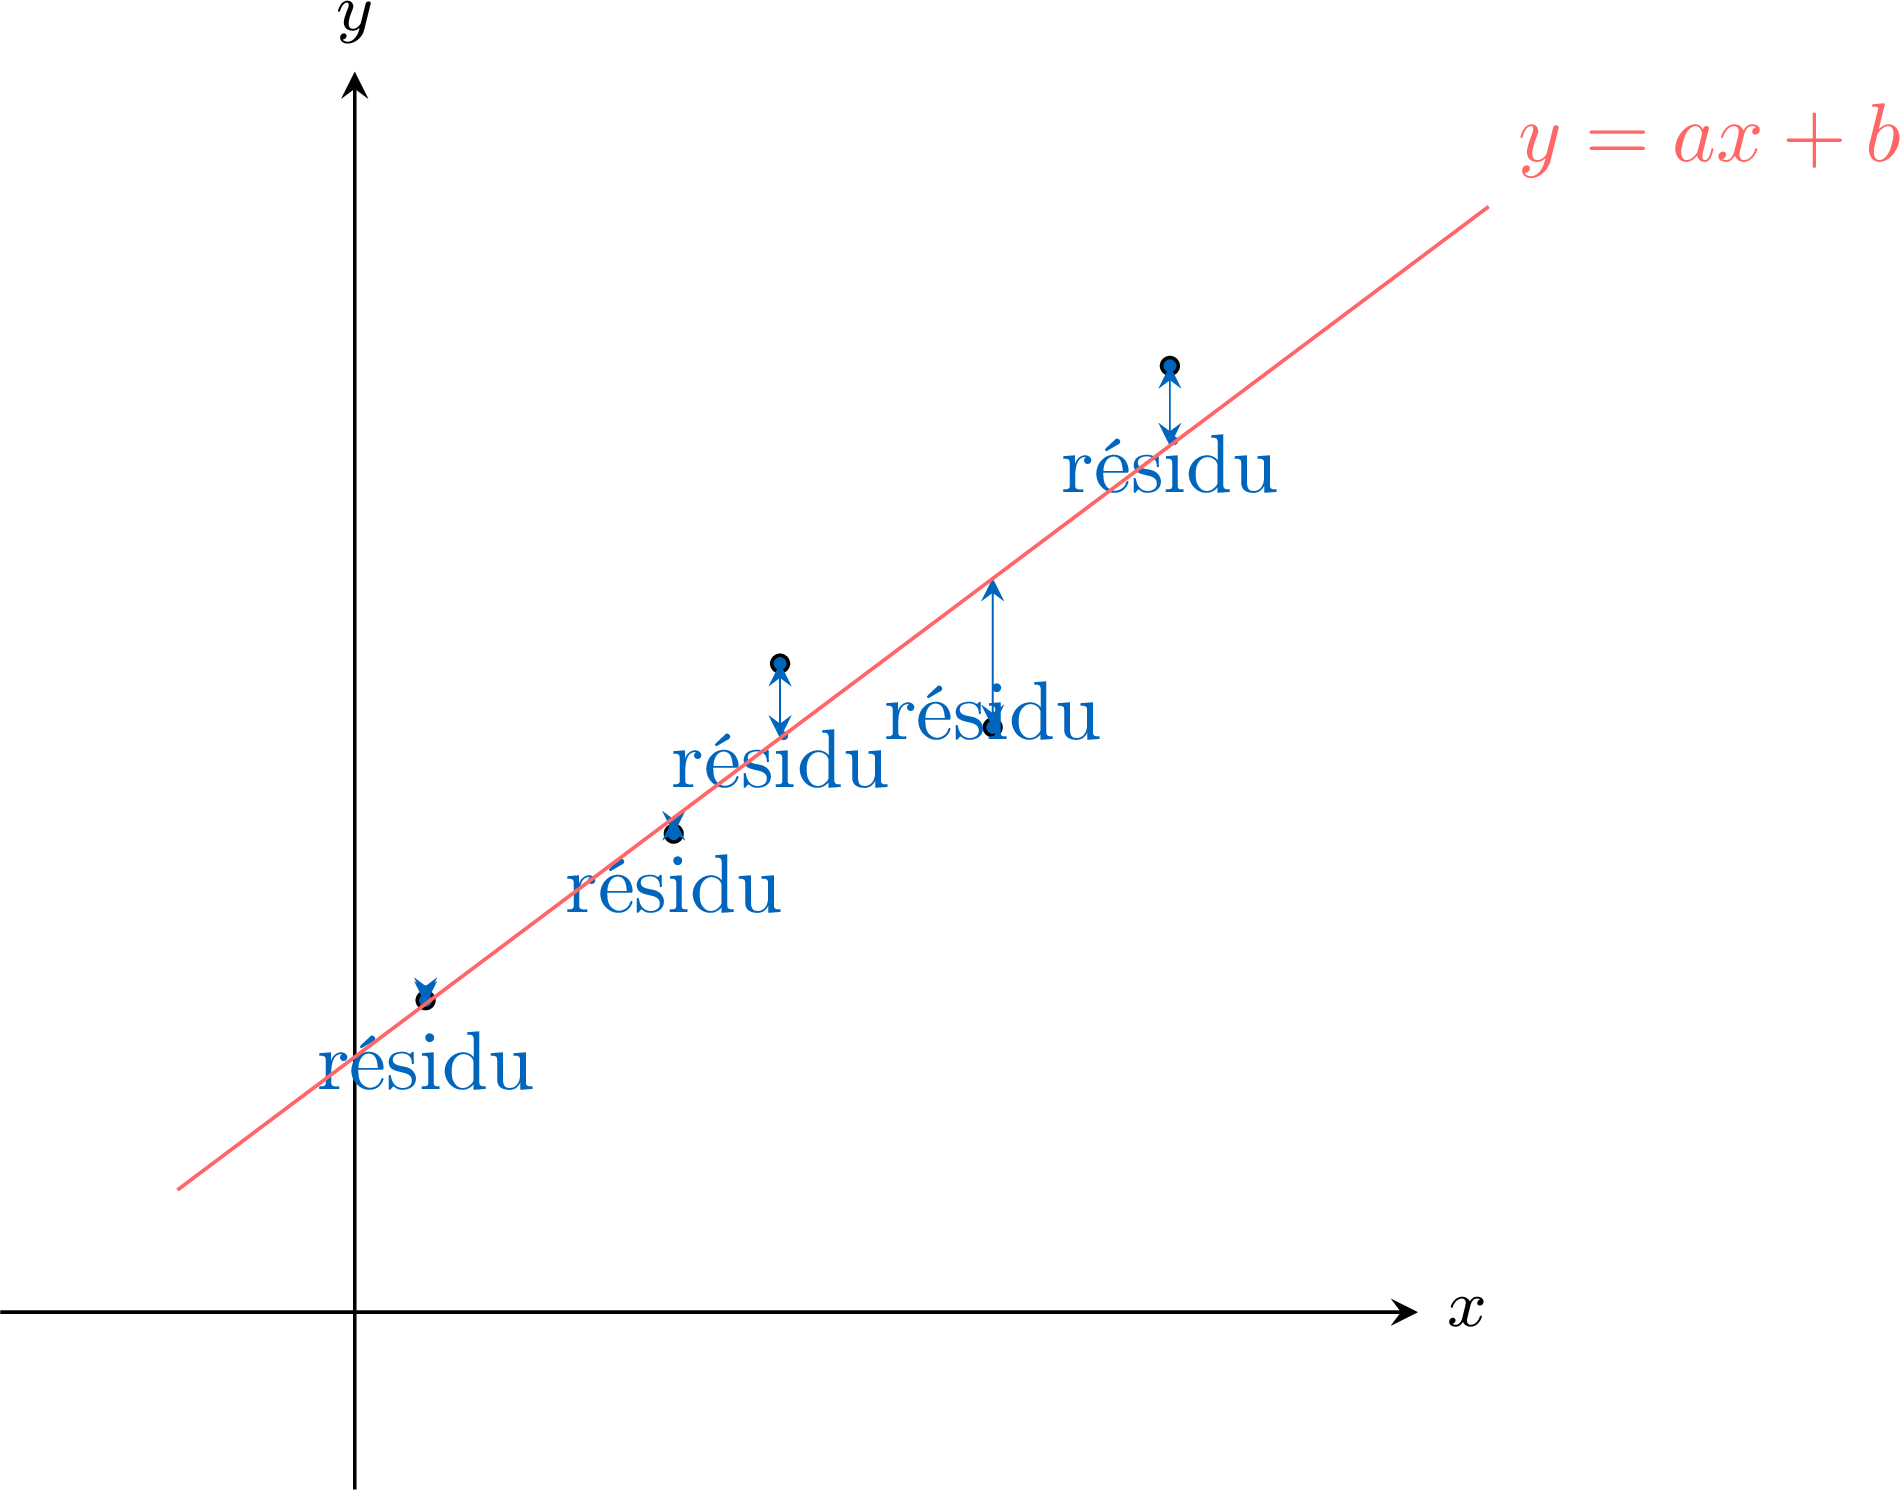
La droite de régression des moindres carrés, écrite sous la forme \(y = ax + b\), est l'unique droite du meilleur ajustement (pourvu que les valeurs de \(x\) ne soient pas toutes égales) qui modélise la relation linéaire entre \(x\) et \(y\). Elle est calculée en minimisant la somme des carrés des résidus.Un résidu est la différence verticale signée (positive au-dessus de la droite, négative au-dessous) entre un point de donnée observé \((x_i, y_i)\) et le point prédit sur la droite de régression \((x_i, \hat{y}_i)\).$$ \text{Résidu} = y_{\text{observé}} - y_{\text{prédit}} = y_i - \hat{y}_i $$ Une propriété clé est que la droite de régression des moindres carrés passe toujours par le point moyen, \((\bar{x}, \bar{y})\).
Méthode — Obtenir la droite des moindres carrés à la calculatrice ou au tableur
Les coefficients \(a\) et \(b\) de la droite des moindres carrés \(y = ax + b\) ne se calculent pas à la main : une calculatrice ou un tableur les donne. - Saisir les données : les valeurs de \(x\) dans une liste (ou une colonne), celles de \(y\) dans une autre, dans le même ordre.
- Demander la droite : à la calculatrice, le menu des statistiques à deux variables, régression linéaire \(y = ax + b\) ; au tableur, avec \(x\) dans
A2:A6et \(y\) dansB2:B6, les formules=PENTE(B2:B6;A2:A6)et=ORDONNEE.ORIGINE(B2:B6;A2:A6), ou une courbe de tendance linéaire ajoutée au nuage de points, avec son équation affichée. - Arrondir avec mesure : garder à peu près autant de chiffres significatifs que les mesures en ont, et écrire l'équation avec les lettres de la situation.
- Contrôler avec le point moyen : la droite des moindres carrés passe par \(G(\bar{x}\,;\,\bar{y})\) ; en remplaçant \(x\) par \(\bar{x}\) dans l'équation, on doit retrouver \(\bar{y}\), aux arrondis près.
Exemple
Un laboratoire prépare cinq solutions de concentration connue \(x\), en milligrammes par litre, et mesure l'absorbance \(y\) de chacune. | \(x\) | \(2\) | \(4\) | \(6\) | \(8\) | \(10\) |
| \(y\) | \(0{,}11\) | \(0{,}19\) | \(0{,}31\) | \(0{,}40\) | \(0{,}49\) |
- Donner, à la calculatrice, l'équation de la droite des moindres carrés, avec \(a\) arrondi à quatre décimales et \(b\) à trois.
- Contrôler que cette droite passe par le point moyen.
- Prévoir l'absorbance d'une solution de concentration \(7\) mg/L.
- Un échantillon de concentration inconnue a une absorbance de \(0{,}35\). Ici la valeur mesurée est \(y\) : utiliser la même équation en sens inverse pour estimer sa concentration.
- La calculatrice donne \(a = 0{,}0485\) et \(b = 0{,}009\) : la droite d'étalonnage est \(y = 0{,}0485x + 0{,}009\) (le coefficient directeur est gardé avec trois chiffres significatifs).
- \(\bar{x} = 6\) et \(\bar{y} = 0{,}30\). Pour \(x = 6\), l'équation donne \(0{,}0485 \times 6 + 0{,}009 = 0{,}300\) : la droite passe par \(G(6\,;\,0{,}30)\).
- \(0{,}0485 \times 7 + 0{,}009 = 0{,}3485\) : l'absorbance attendue est d'environ \(0{,}35\).
- On résout \(0{,}0485x + 0{,}009 = 0{,}35\) : \(x = \dfrac{0{,}35 - 0{,}009}{0{,}0485} \approx 7{,}0\). La concentration est d'environ \(7{,}0\) mg/L. Cette valeur est comprise entre \(2\) et \(10\) mg/L, la plus petite et la plus grande des concentrations mesurées : la droite est utilisée dans l'étendue où elle a été ajustée.
Méthode — Calculer S(a ; b) et chercher la meilleure droite en Python
La somme \(S(a ; b)\) des carrés des écarts est longue à calculer à la main dès qu'il y a plus de quelques points : un programme la calcule, et peut essayer beaucoup de droites l'une après l'autre. - Ranger les données dans deux listes de même longueur,
xspour les valeurs de \(x\) etyspour les valeurs de \(y\), dans le même ordre :xs[i]etys[i]sont les deux coordonnées d'un même point. - Calculer \(S(a ; b)\) avec un accumulateur : initialiser
totalà \(0\) ; pour chaque indicei, calculer l'écartys[i] - (a * xs[i] + b)et ajouter son carré àtotal; rendretotalaprès la boucle. - Balayer une grille de couples : donner à \(a\) les valeurs de \(a_{\min}\) à \(a_{\max}\) avec un pas fixe et, pour chacune, donner à \(b\) les valeurs de \(b_{\min}\) à \(b_{\max}\) avec le même pas — une boucle dans l'autre ; calculer \(S\) à chaque fois et garder le couple dont le \(S\) est le plus petit rencontré jusque-là.
- Lire le résultat : le couple gardé est le meilleur de la grille, proche de la droite des moindres carrés quand le pas est petit ; un pas plus petit peut donner un couple plus proche — pourvu que la droite des moindres carrés soit dans les bornes de la grille — au prix de beaucoup plus de calculs. Tirer les couples au hasard (avec
random.uniform) au lieu de les balayer fonctionne de la même façon.
def S(a, b, xs, ys):
    total = 0
    for i in range(len(xs)):
        gap = ys[i] - (a * xs[i] + b)
        total = total + gap * gap
    return total

def best_line(xs, ys, a_min, a_max, b_min, b_max, step):
    best_a = a_min
    best_b = b_min
    best_s = S(a_min, b_min, xs, ys)
    na = round((a_max - a_min) / step)
    nb = round((b_max - b_min) / step)
    for i in range(na + 1):
        a = a_min + i * step
        for j in range(nb + 1):
            b = b_min + j * step
            s = S(a, b, xs, ys)
            if s < best_s:
                best_a = a
                best_b = b
                best_s = s
    return [best_a, best_b]
Exemple
Les données d'un nuage de points sont rangées dans les listes xs = [1, 2, 3, 4, 5] et ys = [2.1, 3.9, 6.2, 7.8, 10.1]. - Exécuter à la main l'appel
S(2, 0, xs, ys), une ligne d'un tableau d'états par tour de boucle. - La droite \(y = 1{,}9x + 0{,}3\) donne \(S(1{,}9 ; 0{,}3) \approx 0{,}19\). Laquelle des deux droites \(y = 2x\) et \(y = 1{,}9x + 0{,}3\) ajuste le mieux les points ?
- L'appel
best_line(xs, ys, 1, 3, -1, 1, 0.1)rend[2.0, 0.0]. Combien de couples a-t-il essayés ? La calculatrice donne la droite des moindres carrés \(y = 1{,}99x + 0{,}05\) : pourquoi n'est-ce pas le couple trouvé ?
- Avec \(a = 2\) et \(b = 0\), la droite donne \(2 \times \texttt{xs[i]}\) :
ivaleur de la droite gaptotal\(0\) \(2\) \(0{,}1\) \(0{,}01\) \(1\) \(4\) \(-0{,}1\) \(0{,}02\) \(2\) \(6\) \(0{,}2\) \(0{,}06\) \(3\) \(8\) \(-0{,}2\) \(0{,}10\) \(4\) \(10\) \(0{,}1\) \(0{,}11\) - \(0{,}11 \lt 0{,}19\) : la droite \(y = 2x\) ajuste mieux les points au sens du critère des moindres carrés.
- \(a\) prend les \(21\) valeurs \(1\) ; \(1{,}1\) ; …; \(3\) et, pour chacune, \(b\) prend \(21\) valeurs : \(21 \times 21 = 441\) couples. Le couple des moindres carrés \((1{,}99 ; 0{,}05)\) n'est pas sur la grille de pas \(0{,}1\) ; sa somme \(S \approx 0{,}107\) n'est que légèrement inférieure à \(0{,}11\). Avec un pas de \(0{,}01\), le balayage le trouve, après \(201 \times 201 = 40\,401\) couples.
Compétences à pratiquer
- Comparer des droites par la somme des carrés
- Calculer S(a ; b) en Python (sauf STD2A)
II.3
Interpolation et extrapolation
Définition — Interpolation et Extrapolation
La droite d'ajustement peut être utilisée pour faire des prédictions : - L'interpolation est le processus de prédiction d'une valeur de \(y\) pour une valeur de \(x\) qui se situe à l'intérieur de l'étendue des données originales. Si la corrélation est forte, l'interpolation est généralement considérée comme fiable (pourvu que le modèle linéaire décrive bien les données).
- L'extrapolation est le processus de prédiction d'une valeur de \(y\) pour une valeur de \(x\) qui se situe à l'extérieur de l'étendue des données originales. L'extrapolation est généralement considérée comme non fiable, car on ne peut pas supposer que la tendance linéaire se poursuit indéfiniment.
Exemple
Pour une enquête sur les heures d'étude et les notes d'examen (sur \(100\)), la calculatrice donne la droite d'ajustement \(y = 3{,}5x + 40\). Dans cette enquête, les heures d'étude allaient de 2 à 15 heures. - Estimer la note d'examen d'un élève qui a étudié pendant 11 heures.
- Estimer la note d'examen d'un élève qui a étudié pendant 25 heures.
- Commenter la fiabilité de l'estimation de la question 2.
- Comme \(x=11\) est dans l'intervalle des valeurs observées, il s'agit d'une interpolation. $$ y = 3{,}5(11) + 40 = 38{,}5 + 40 = 78{,}5 $$ La note estimée est \(78{,}5\).
- Comme \(x=25\) est en dehors de l'intervalle des valeurs observées, il s'agit d'une extrapolation. $$ y = 3{,}5(25) + 40 = 87{,}5 + 40 = 127{,}5 $$ La note estimée est \(127{,}5\).
- L'estimation de la question 2 n'est pas fiable : c'est une extrapolation, et rien ne garantit que la tendance linéaire se poursuive jusqu'à 25 heures d'étude. De plus, le modèle donne une note supérieure à 100, ce qui est impossible : c'est le danger de l'extrapolation.
Le domaine d'étude
Un ajustement \(y = f(x)\) fait de la série un modèle qui permet d'estimer \(y\) pour une valeur de \(x\) non observée, ou, lorsque l'équation \(f(x) = y\) a une seule solution, \(x\) pour une valeur donnée de \(y\). Le domaine d'étude est l'intervalle qui va de la plus petite à la plus grande valeur observée de \(x\). À l'intérieur, une estimation est une interpolation : elle s'appuie sur les observations qui l'entourent, et elle est raisonnable lorsque le modèle ajuste bien les données. À l'extérieur, une estimation est une extrapolation : elle repose sur une hypothèse supplémentaire, que la tendance se poursuit au-delà des observations, ce que les données seules ne peuvent jamais garantir. Plus on s'éloigne du domaine d'étude, plus l'estimation est fragile. Lorsque \(x\) est le temps, extrapoler au-delà de la dernière observation, c'est prévoir : la prévision doit être donnée avec son hypothèse et avec des mots comme « environ » ou « si la tendance se poursuit ».
Compétences à pratiquer
- Estimer des valeurs et reconnaître une interpolation
- Estimer des valeurs avec une équation de droite
- Ajuster une droite en contexte à la calculatrice
II.4
Changement de variable
Redresser un nuage courbe
Quand un nuage de points est nettement courbe, une droite l'ajuste mal, et une droite des moindres carrés calculée malgré tout peut donner des prévisions absurdes. Un changement de variable remplace l'une des deux variables par une fonction de celle-ci, choisie pour que les nouveaux points soient presque alignés : un ajustement affine devient alors pertinent pour les nouvelles variables, et l'on en déduit un modèle pour les variables de départ. Deux familles de changements couvrent la plupart des situations rencontrées.
- Une puissance ou un inverse de \(x\) — \(x^2\), \(\dfrac{1}{x}\), \(\dfrac{1}{\sqrt{x}}\) — redresse un nuage dans lequel \(y\) croît comme le carré de \(x\) (une distance parcourue depuis l'arrêt, une aire), ou diminue comme son inverse (une pression, un coût réparti sur de plus en plus d'articles).
- Le logarithme décimal de \(y\) redresse un nuage dans lequel chaque pas de \(x\) multiplie \(y\) par un même facteur, car il transforme les produits en sommes : \(\log\left(k \times q^{x}\right) = \log k + x \log q\), une expression affine de \(x\).
Méthode — Ajuster après un changement de variable
Les changements de variable usuels, et le modèle obtenu après le retour aux variables de départ : | Changement de variable | Condition sur les données | Droite à la calculatrice | Modèle après le retour |
| \(u = x^2\) | aucune | \(y = au + b\) | \(y = ax^2 + b\) |
| \(u = \dfrac{1}{x}\) | \(x \neq 0\) | \(y = au + b\) | \(y = \dfrac{a}{x} + b\) |
| \(u = \dfrac{1}{\sqrt{x}}\) | \(x \gt 0\) | \(y = au + b\) | \(y = \dfrac{a}{\sqrt{x}} + b\) |
| \(z = \log y\) | \(y \gt 0\) | \(z = ax + b\) | \(y = k \times q^{x}\), \(k = 10^{b}\), \(q = 10^{a}\) |
- Choisir le changement de variable d'après la forme du nuage et le contexte, et vérifier qu'il est défini pour toutes les données.
- Transformer : calculer les nouvelles valeurs (\(u_i\) ou \(z_i\)), arrondies comme l'énoncé le demande, et vérifier que les nouveaux points sont presque alignés.
- Ajuster : saisir la série transformée à la calculatrice et demander la droite des moindres carrés, comme pour toute série à deux variables.
- Revenir aux variables de départ. Pour \(z = \log y\) : \(\log y = ax + b\) signifie \(y = 10^{ax + b}\), c'est-à-dire \(y = 10^{b} \times \left(10^{a}\right)^{x}\) ; chaque fois que \(x\) augmente de \(1\), \(y\) est multiplié par \(q = 10^{a}\), et \(\log q = a\).
- Utiliser le modèle avec prudence : à l'intérieur de l'étendue des données, il interpole ; au-dehors, il extrapole, et seul le contexte dit si la variation se poursuit de la même façon.
Exemple
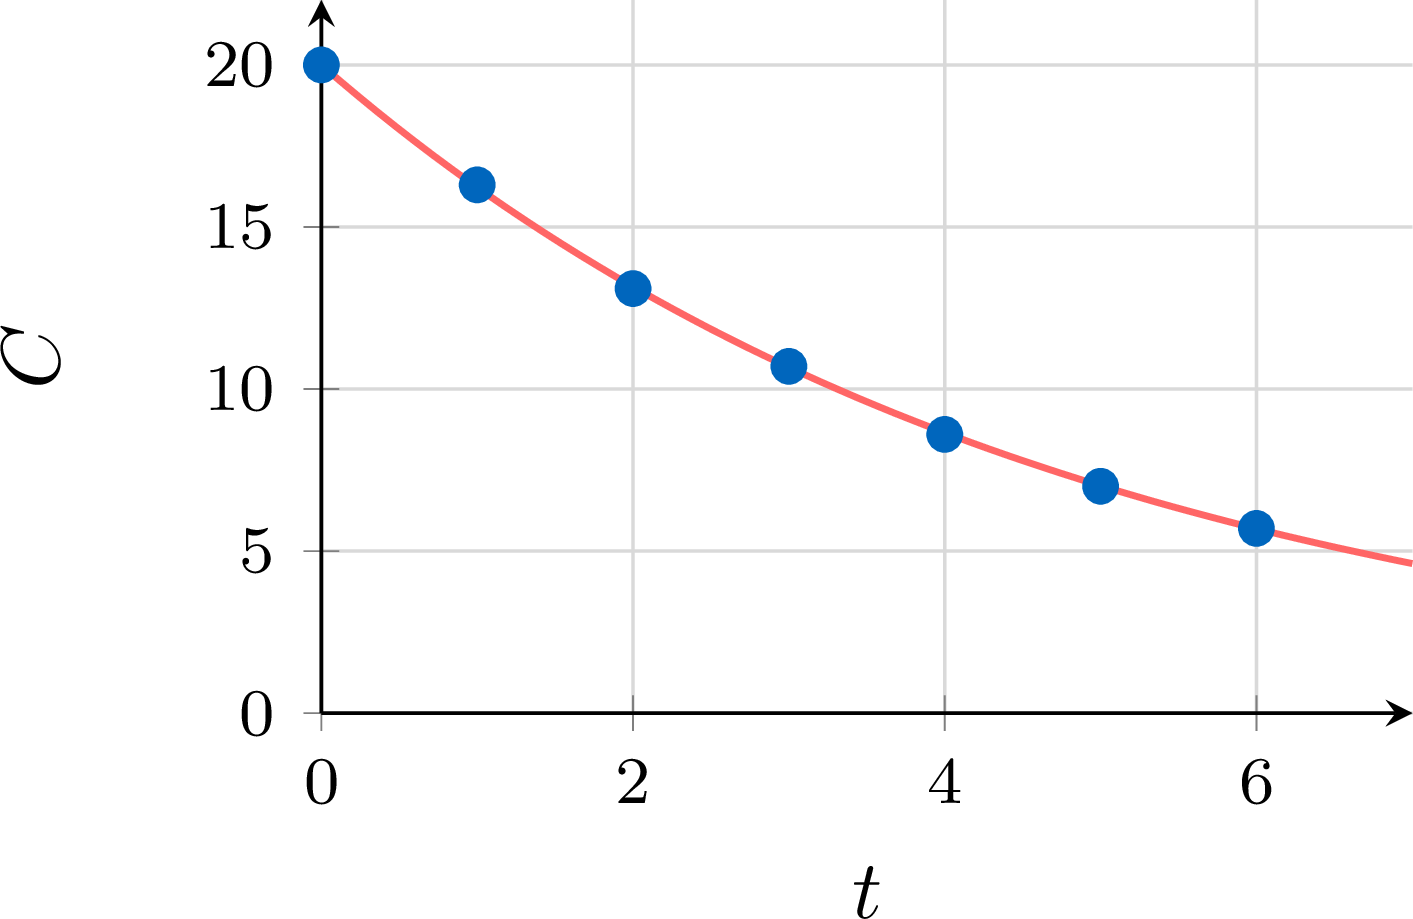
Après une injection, on mesure toutes les heures la concentration \(C\) d'un médicament dans le sang, en milligrammes par litre. | Temps \(t\) (h) | \(0\) | \(1\) | \(2\) | \(3\) | \(4\) | \(5\) | \(6\) |
| \(C\) (mg/L) | \(20{,}0\) | \(16{,}3\) | \(13{,}1\) | \(10{,}7\) | \(8{,}6\) | \(7{,}0\) | \(5{,}7\) |
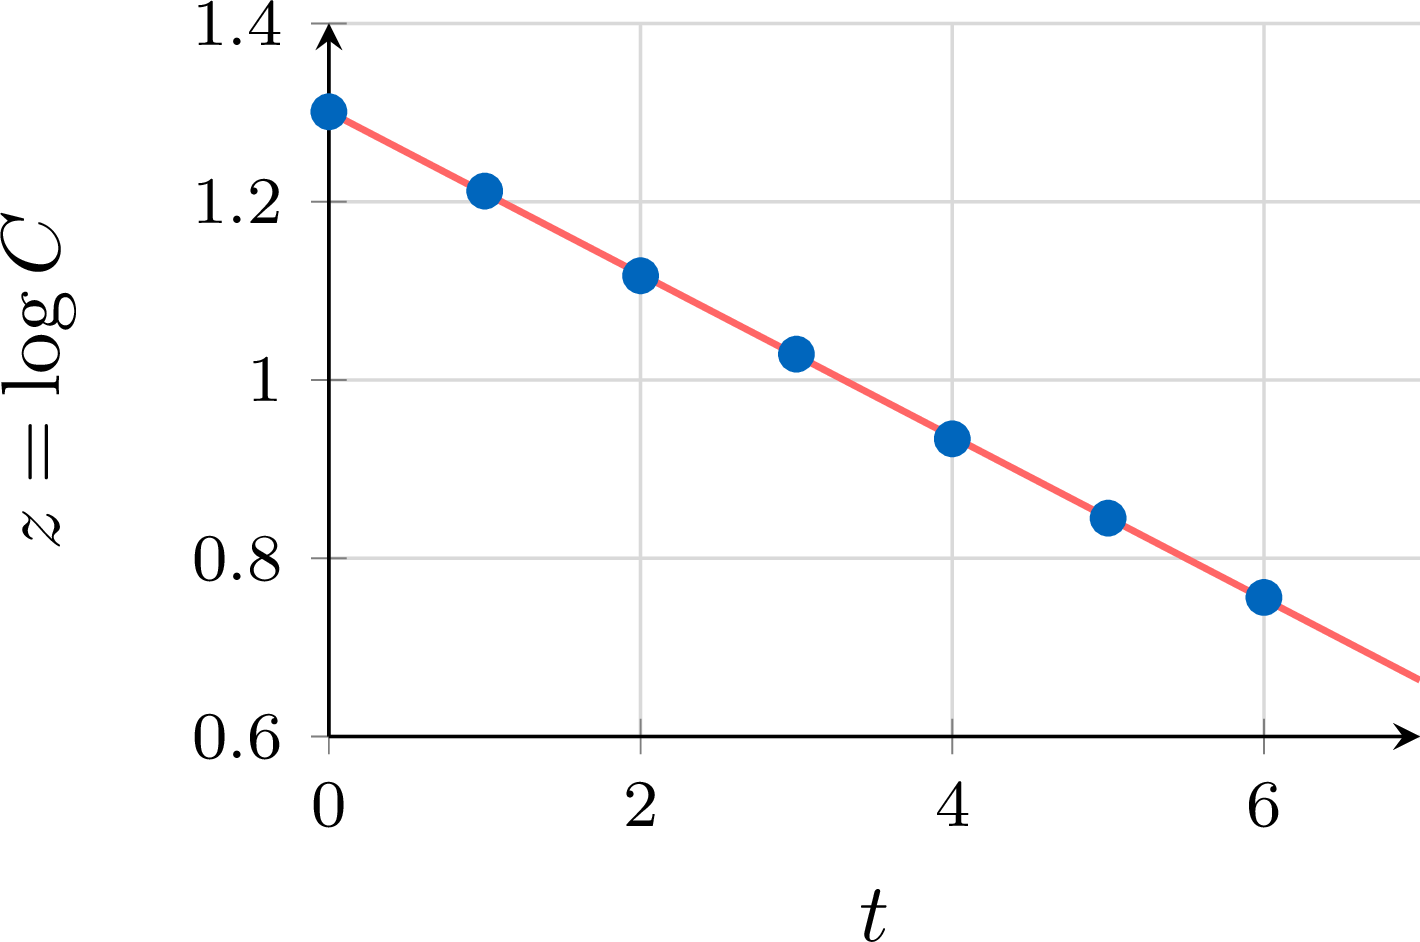
- Calculer les valeurs \(z = \log C\) arrondies à \(10^{-3}\) près, puis déterminer à la calculatrice la droite des moindres carrés de \(z\) en \(t\), la pente arrondie à \(10^{-4}\) et l'ordonnée à l'origine à \(10^{-3}\).
- En déduire une expression de \(C\) en fonction de \(t\), sous la forme \(C = k \times q^{t}\), avec \(k\) arrondi à \(10^{-1}\) et \(q\) à \(10^{-3}\). De quel pourcentage la concentration diminue-t-elle chaque heure ?
- Estimer la concentration au bout de \(2\) h \(30\) min, puis le temps au bout duquel la concentration initiale a diminué de moitié.
- Les valeurs de \(z = \log C\) sont \(1{,}301\) ; \(1{,}212\) ; \(1{,}117\) ; \(1{,}029\) ; \(0{,}934\) ; \(0{,}845\) ; \(0{,}756\) : les points \((t ; z)\) sont presque alignés. La calculatrice donne \(z = -0{,}0911t + 1{,}301\).
- \(\begin{aligned}[t] \log C &= -0{,}0911t + 1{,}301 \\ C &= 10^{-0{,}0911t + 1{,}301} &&\text{(définition du logarithme décimal)}\\ &= 10^{1{,}301} \times \left(10^{-0{,}0911}\right)^{t} &&\text{(propriétés des puissances)}\\ &\approx 20{,}0 \times 0{,}811^{t} \end{aligned}\)
Chaque heure, la concentration est multipliée par \(0{,}811\) : elle diminue de \(1 - 0{,}811 = 0{,}189\), soit d'environ \(18{,}9\pourcent\) par heure. - Au bout de \(2\) h \(30\) min, \(t = 2{,}5\) : \(C \approx 20{,}0 \times 0{,}811^{2{,}5} \approx 11{,}8\) mg/L ; \(2{,}5\) est compris entre \(0\) et \(6\), c'est une interpolation. La concentration a diminué de moitié quand \(q^{t} = \dfrac{1}{2}\) :
\(\begin{aligned}[t] t \log q &= \log 0{,}5 &&\text{(logarithme d'une puissance)}\\ t &= \dfrac{\log 0{,}5}{-0{,}0911} &&\text{(}\log q = a\text{)}\\ &\approx 3{,}3 \end{aligned}\)
La concentration a diminué de moitié au bout d'environ \(3{,}3\) heures, soit environ \(3\) h \(18\) min.
Exemple
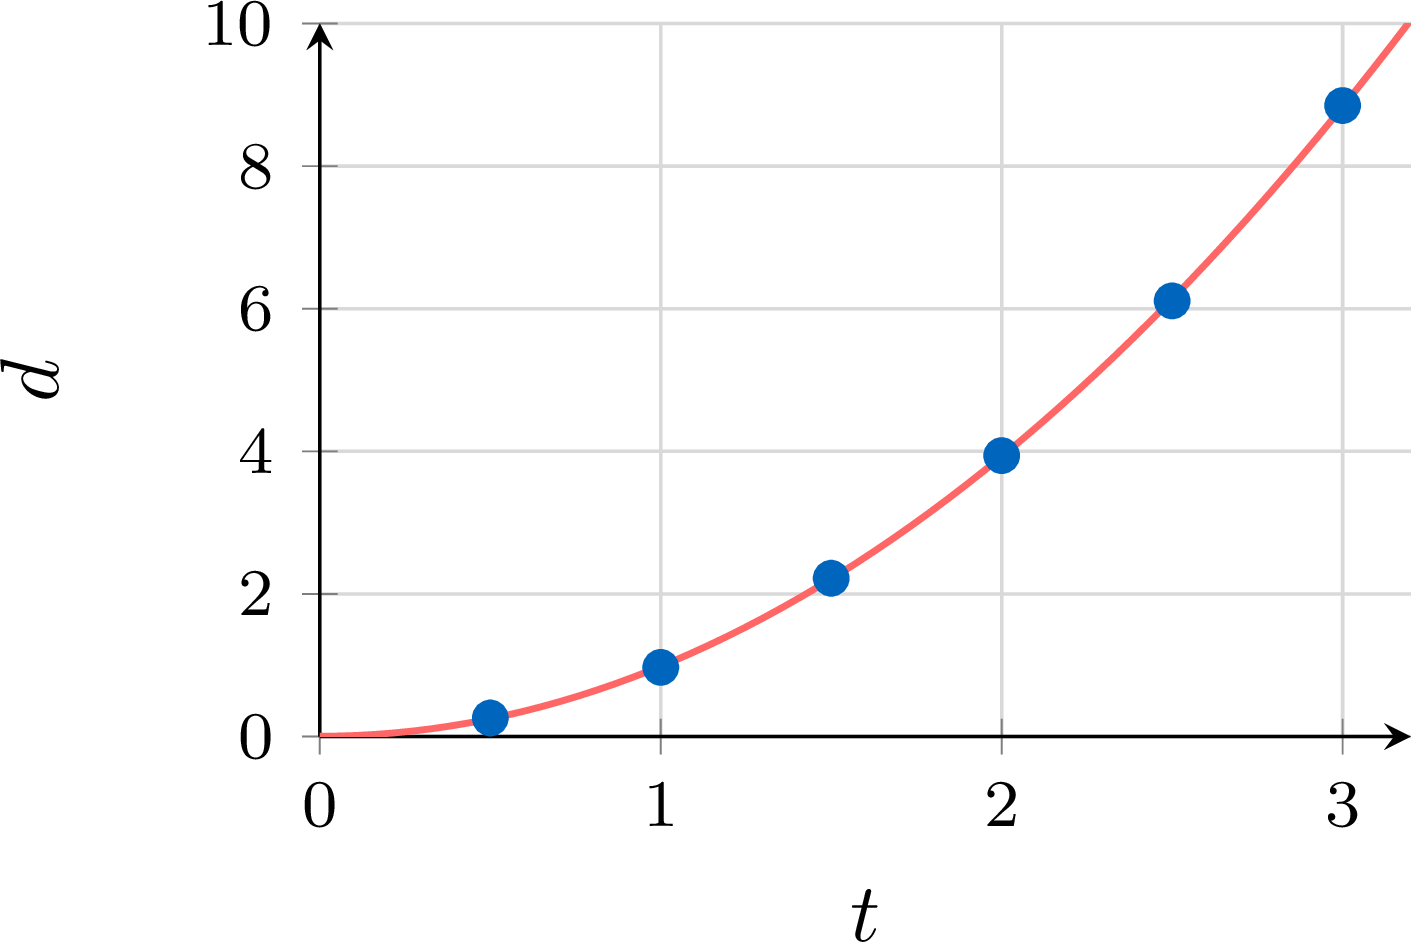
Une bille est lâchée sans vitesse en haut d'un rail légèrement incliné ; on mesure la distance \(d\) qu'elle a parcourue, en mètres, \(t\) secondes après avoir été lâchée. | Temps \(t\) (s) | \(0{,}5\) | \(1{,}0\) | \(1{,}5\) | \(2{,}0\) | \(2{,}5\) | \(3{,}0\) |
| Distance \(d\) (m) | \(0{,}26\) | \(0{,}97\) | \(2{,}22\) | \(3{,}94\) | \(6{,}11\) | \(8{,}85\) |
- La droite des moindres carrés de \(d\) en \(t\) a pour équation \(d = 3{,}434t - 2{,}284\). Quelle distance prévoit-elle pour \(t = 0{,}5\) ? Commenter.
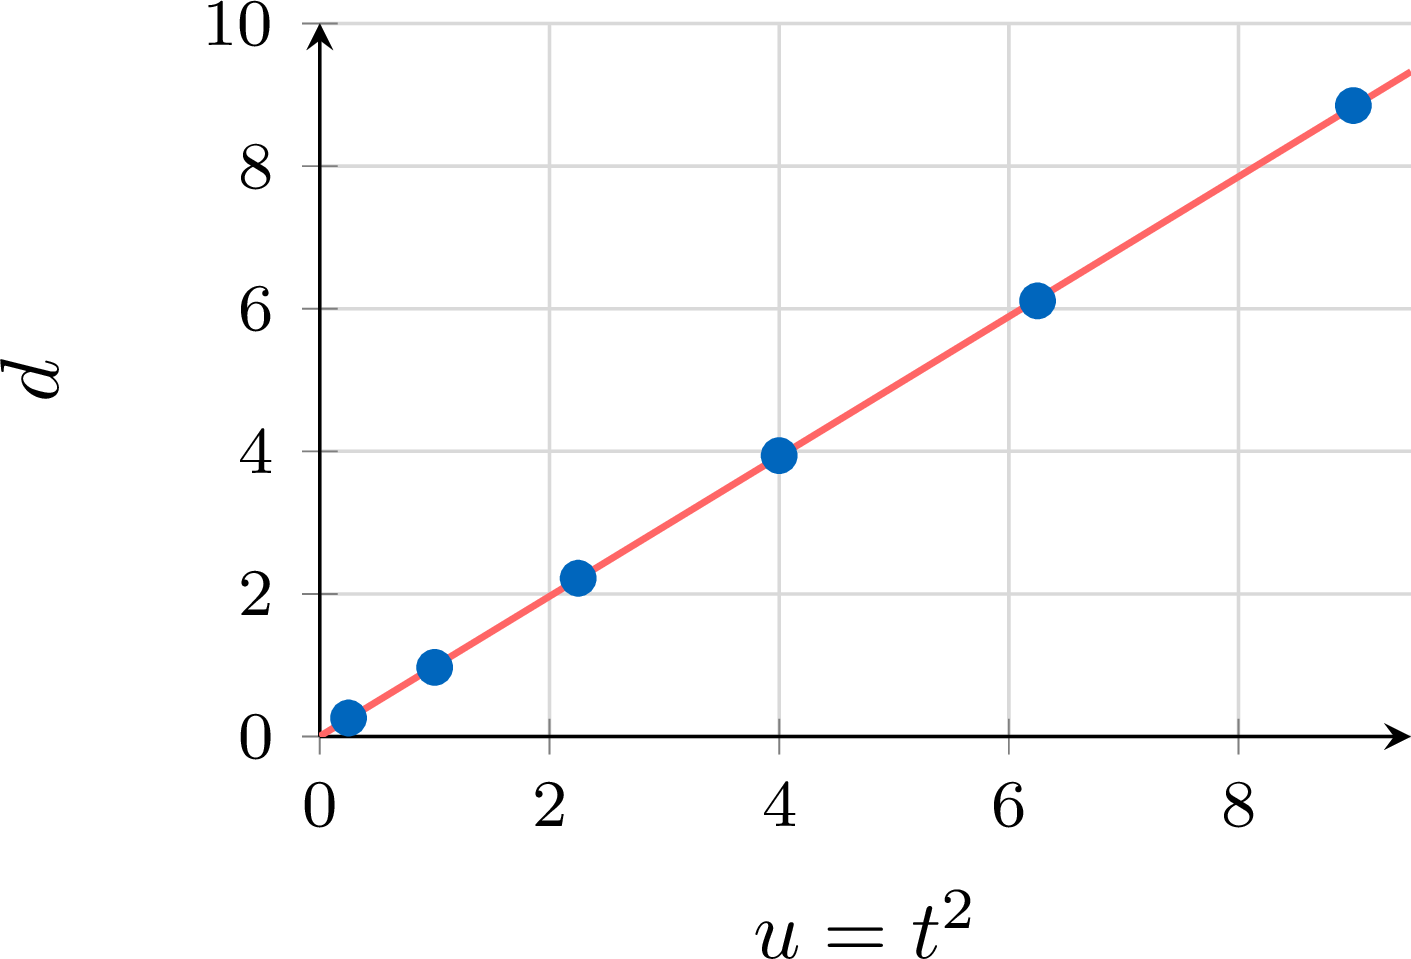
- Calculer les valeurs \(u = t^2\), puis déterminer à la calculatrice la droite des moindres carrés de \(d\) en \(u\), les coefficients arrondis à \(10^{-3}\) près.
- En déduire une expression de \(d\) en fonction de \(t\), puis estimer la distance parcourue au bout de \(2{,}2\) secondes.
- \(3{,}434 \times 0{,}5 - 2{,}284 \approx -0{,}57\) m : une distance négative, ce qui est absurde. Le nuage \((t ; d)\) est courbe — la distance croît de plus en plus vite — et une droite ne le décrit pas.
- Les valeurs de \(u = t^2\) sont \(0{,}25\) ; \(1\) ; \(2{,}25\) ; \(4\) ; \(6{,}25\) ; \(9\) : les points \((u ; d)\) sont presque alignés. La calculatrice donne \(d = 0{,}981u + 0{,}004\).
- \(d \approx 0{,}981t^2 + 0{,}004\) : l'ordonnée à l'origine est presque nulle, la distance est donc à peu près proportionnelle au carré du temps, \(d \approx 0{,}98\,t^2\), comme le prévoit la physique d'un mouvement parti de l'arrêt. Au bout de \(2{,}2\) s : \(d \approx 0{,}981 \times 2{,}2^2 + 0{,}004 \approx 4{,}75\) m, une interpolation puisque \(2{,}2\) est compris entre \(0{,}5\) et \(3\).
Exemple
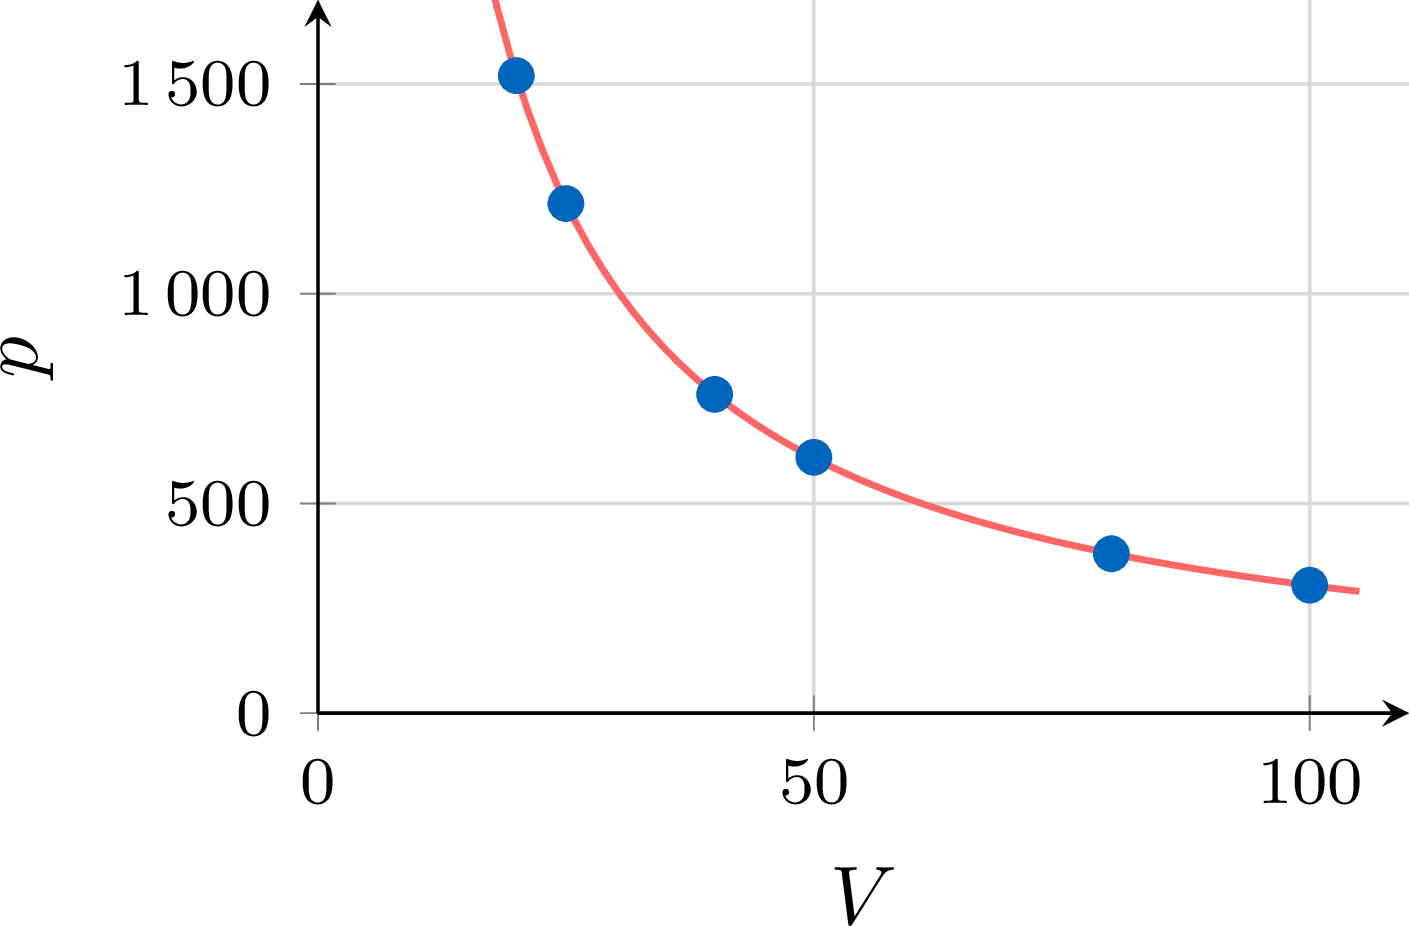
On comprime lentement, à température constante, l'air enfermé dans une seringue ; on lit sa pression \(p\), en hectopascals, pour plusieurs volumes \(V\), en millilitres. | Volume \(V\) (mL) | \(20\) | \(25\) | \(40\) | \(50\) | \(80\) | \(100\) |
| Pression \(p\) (hPa) | \(1520\) | \(1215\) | \(760\) | \(610\) | \(380\) | \(305\) |
- Calculer les valeurs \(u = \dfrac{1}{V}\), puis déterminer à la calculatrice la droite des moindres carrés de \(p\) en \(u\), les coefficients arrondis à l'unité.
- En déduire une expression de \(p\) en fonction de \(V\), et interpréter l'ordonnée à l'origine.
- Estimer la pression pour un volume de \(35\) mL.
- Les valeurs de \(u = \dfrac{1}{V}\) sont \(0{,}05\) ; \(0{,}04\) ; \(0{,}025\) ; \(0{,}02\) ; \(0{,}0125\) ; \(0{,}01\) : les points \((u ; p)\) sont presque alignés. La calculatrice donne \(p = 30\,366u + 1\).
- \(p \approx \dfrac{30\,366}{V} + 1\). L'ordonnée à l'origine, environ \(1\) hPa, est négligeable devant des pressions de plusieurs centaines d'hectopascals : \(p \approx \dfrac{30\,366}{V}\), c'est-à-dire \(pV \approx 30\,366\). Le produit de la pression par le volume reste à peu près constant : c'est la loi de Boyle-Mariotte.
- \(p \approx \dfrac{30\,366}{35} + 1 \approx 867{,}6 + 1 \approx 869\) hPa, une interpolation puisque \(35\) est compris entre \(20\) et \(100\).
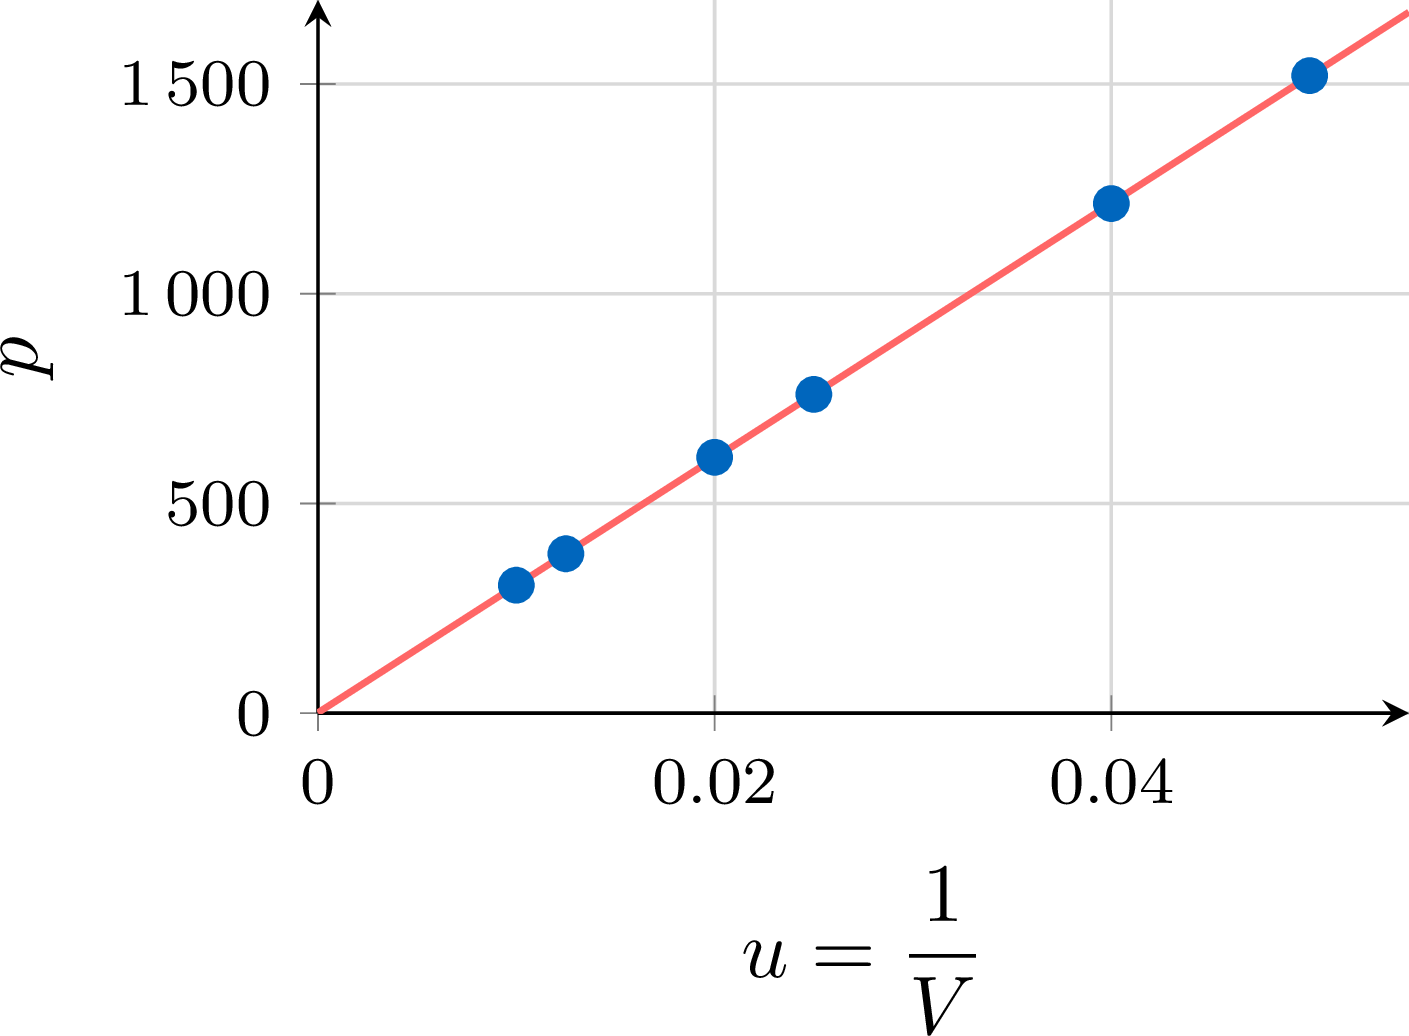
Juger l'ajustement et prévoir
La calculatrice rend la droite aussi proche que possible des points transformés ; pour juger le modèle, on le regarde dans les unités de départ. On compare les valeurs observées \(y_i\) aux valeurs \(\hat{y}_i\) que prévoit le modèle : des écarts petits et sans motif signalent un bon ajustement, alors que des écarts qui changent de signe de façon régulière signalent que le changement de variable n'est pas le bon. Un modèle obtenu à partir de données décrit le phénomène sur l'étendue des données ; employé au-dehors, il suppose que la variation se poursuit de la même façon, et le contexte tranche : un médicament continue d'être éliminé au même rythme pendant un temps, mais une population, une audience ou un nombre de clients ne peut pas être multiplié indéfiniment par le même facteur, car les ressources et les clients potentiels s'épuisent.
Compétences à pratiquer
- Ajuster après un changement de variable
- Rédaction : ajuster à la calculatrice
- Problèmes : changements de variable en contexte
III
Pour aller plus loin
Compétences à pratiquer
- Problèmes
- Quiz
Aller à la section