Éducation Nationale Française · Terminale Technologie
Python : listes et données (sauf STD2A)
I
Les listes
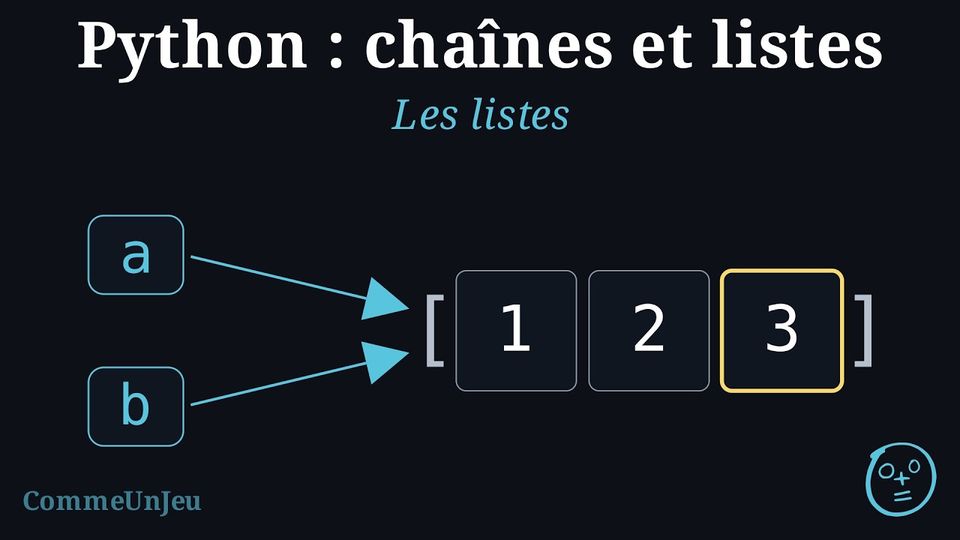
Un programme manipule souvent beaucoup de valeurs de même nature : les notes d'une classe, les articles d'une liste de courses, les lettres déjà essayées dans un jeu. Une variable par valeur est impossible quand leur nombre est inconnu. Une liste est une valeur qui en contient plusieurs, dans l'ordre, numérotées à partir de 0 comme les caractères d'une chaîne. À la différence d'une chaîne, une liste peut changer : des valeurs s'ajoutent, se remplacent, et c'est là qu'apparaît une nouvelle sorte d'erreur, deux noms pour la même liste.
Définition — Les listes
Une liste s'écrit entre crochets, ses éléments séparés par des virgules : [3, 1, 2], ["ada", "leo"], et [] pour la liste vide. Les éléments sont numérotés à partir de 0 : lst[0] est le premier, lst[-1] le dernier quand la liste n'est pas vide, et len(lst) est le nombre d'éléments. Une liste peut contenir des valeurs de tout type, et une liste de chaînes est courante. Les tranches et * fonctionnent comme pour les chaînes : lst[1:3] est une liste de deux éléments, lst[:] la liste entière, et [0] * 3 vaut [0, 0, 0]. Définition — Modifier une liste
Une liste est mutable : l'affectation lst[i] = v remplace l'élément en position i, et la méthode lst.append(v) ajoute v à la fin. Les deux modifient la liste elle-même, sur place : aucune nouvelle liste n'est créée, et append rend None. Une liste construite à partir de [] grandit d'un élément à chaque append. Définition — Parcourir et interroger une liste
La boucle for x in lst: s'exécute une fois par élément, x contenant l'élément courant ; la boucle for i in range(len(lst)): s'exécute une fois par position. Le test v in lst vaut True quand v est un élément de la liste, et v not in lst est le contraire. Sur une liste de nombres, les fonctions sum(lst), min(lst) et max(lst) rendent la somme, le plus petit et le plus grand élément, les deux dernières exigeant au moins un élément ; sorted(lst) rend une nouvelle liste, triée, sans modifier lst. Exemple
Qu'affiche le programme suivant ? items = []
items.append("bread")
items.append("milk")
items.append("eggs")
print(len(items))
print(items)
print(items[1])
for item in items:
print("-", item)
print("milk" in items)3
['bread', 'milk', 'eggs']
milk
- bread
- milk
- eggs
Trueappend. Affichée entière, une liste montre ses crochets et ses chaînes avec des guillemets ; affichée élément par élément dans la boucle, les chaînes apparaissent sans guillemets, comme tout print d'une chaîne. Méthode — Les quatre schémas de liste
- Construire : partir de
[], parcourir quelque chose,appendce qui est produit. - Compter : un compteur à
0, un parcours par élément, unifqui compte. - Le plus grand à la main : sur une liste d'au moins un élément, partir du premier élément, parcourir les autres, remplacer quand plus grand ; parcourir par position quand la position est voulue aussi.
- Filtrer : partir de
[], parcourir la liste,appendles éléments qui passent le test. La liste de départ est intacte.
Exemple
Qu'affiche le programme suivant ? grades = [12, 15, 9, 14]
total = 0
for g in grades:
total = total + g
print(total / len(grades))
print(sum(grades) / len(grades))
print(max(grades), min(grades))
print(sorted(grades))
print(grades)12.5
12.5
15 9
[9, 12, 14, 15]
[12, 15, 9, 14]sum fait de même en un appel. Les deux dernières lignes montrent que sorted a rendu une nouvelle liste triée et a laissé grades dans son ordre de départ. Exemple
Quelle est la valeur de chaque appel ? def position_of_largest(lst):
best = 0
for i in range(1, len(lst)):
if lst[i] > lst[best]:
best = i
return best
def evens(lst):
result = []
for x in lst:
if x % 2 == 0:
result.append(x)
return result>>> position_of_largest([4, 9, 2, 9])
>>> position_of_largest([7])
>>> evens([3, 8, 5, 2, 6])
>>> evens([1, 3])>>> position_of_largest([4, 9, 2, 9])
1
>>> position_of_largest([7])
0
>>> evens([3, 8, 5, 2, 6])
[8, 2, 6]
>>> evens([1, 3])
[]best garde la position du plus grand élément vu jusque-là, et un élément suivant le remplace seulement s'il est strictement plus grand, donc le premier 9 gagne. Avec un seul élément la boucle fait zéro tour et 0 revient ; sans élément il n'y a pas de plus grand, et la fonction n'est pas faite pour être appelée. evens est le schéma du filtre : une nouvelle liste reçoit les éléments qui passent le test, et une liste vide revient si aucun ne passe. Définition — Copies et alias
L'affectation b = a, où a est une liste, ne copie pas la liste : elle donne à la même liste un second nom. Les modifications faites par b se voient par a, et réciproquement ; b est un alias de a. Une vraie copie, une nouvelle liste aux mêmes éléments, s'obtient pour une liste de nombres ou de chaînes avec la tranche a[:], ou en la construisant avec une boucle et append. Il en va de même quand une liste est donnée à une fonction : le paramètre est un alias, et la fonction modifie la liste de l'appelant si elle applique append ou une affectation par index à son paramètre. Exemple
Qu'affiche le programme suivant ? a = [1, 2]
b = a
b.append(3)
print(a)
c = a[:]
c.append(4)
print(a)
print(c)[1, 2, 3]
[1, 2, 3]
[1, 2, 3, 4]| après | noms | listes |
b = a | a, b | une liste [1, 2] |
b.append(3) | a, b | la même liste, maintenant [1, 2, 3] |
c = a[:] | a, b / c | deux listes, toutes deux [1, 2, 3] |
c.append(4) | a, b / c | [1, 2, 3] / [1, 2, 3, 4] |
b a aussi modifié la liste que a nomme : une liste, deux noms. La tranche a fait une seconde liste, et lui ajouter un élément a laissé la première tranquille. La question à se poser avant d'écrire b = a sur une liste : copie, ou alias ?
append rend None
Ranger la valeur de
append remplace la liste par None. lst = [1, 2]
lst = lst.append(3)
lst.append(4)Traceback (most recent call last):
File "main.py", line 3, in <module>
lst.append(4)
^^^^^^^^^^
AttributeError: 'NoneType' object has no attribute 'append'append modifie la liste et rend None, rien d'utilisable : il s'appelle sur sa propre ligne, lst.append(3), jamais à droite d'une affectation.
sorted et sort
Deux façons de trier, aux habitudes opposées :
sorted(lst) rend une nouvelle liste triée, lst.sort() trie la liste sur place et rend None. lst = [3, 1, 2]
print(sorted(lst), lst)
lst.sort()
print(lst)[1, 2, 3] [3, 1, 2]
[1, 2, 3]lst = lst.sort() perd la liste, exactement comme append. sorted est le choix habituel : l'original reste disponible.
Faire grandir la liste que l'on parcourt
Une boucle qui ajoute à la liste qu'elle parcourt n'en atteint jamais la fin : chaque tour ajoute un élément à parcourir.
lst = [1, 2, 3]
for x in lst:
    lst.append(x * 2)
Encore une position de trop
Comme une chaîne, une liste de
n éléments a les positions 0 à n - 1. lst = [10, 20, 30]
print(lst[3])Traceback (most recent call last):
File "main.py", line 2, in <module>
print(lst[3])
~~~^^^
IndexError: list index out of rangelst[len(lst) - 1] ou lst[-1] ; un parcours par position s'arrête à range(len(lst)).
Compétences à pratiquer
- Prédire
- Construire et lire des listes
- Les quatre schémas
- Un carnet de notes
II
Algorithmes sur les listes
Chaînes et listes en main, les mêmes quelques questions reviennent dans chaque programme : cette valeur est-elle dans la liste, et où ; une valeur apparaît-elle deux fois ; comment deux listes sont-elles liées ; comment un tableau de valeurs est-il rangé ; comment une phrase se découpe-t-elle en mots. Chacune a une réponse classique, un court programme qui vaut d'être su par cœur. Ce sont les algorithmes sur les listes ; l'algorithmique les étudie pour eux-mêmes.
Définition — La recherche linéaire
Pour trouver une valeur dans une liste, la recherche linéaire parcourt les positions depuis la première et s'arrête au premier élément égal à la valeur : la fonction rend cette position aussitôt, et rend -1 après la boucle quand aucun élément n'a convenu. La valeur -1 signifie absent, puisque les positions rendues vont de 0 à len(lst) - 1. Le test v in lst ne répond que oui ou non ; lst.index(v) donne la position mais arrête le programme avec une erreur quand v est absent. Méthode — Chercher puis décider
- Parcourir par position avec
for i in range(len(lst)):. - Tester l'élément courant ; quand c'est celui voulu,
return iaussitôt : la recherche est finie. - Après la boucle, écrire ce qui se passe quand rien n'a été trouvé :
return -1. Cette ligne n'est atteinte que si chaque tour a échoué. - Chez l'appelant, tester le résultat avec
!= -1avant de s'en servir comme position.
Exemple
Quelle est la valeur de chaque appel ? def find(lst, v):
for i in range(len(lst)):
if lst[i] == v:
return i
return -1
def has_duplicate(lst):
for i in range(len(lst)):
for j in range(i + 1, len(lst)):
if lst[i] == lst[j]:
return True
return False>>> find([5, 3, 8, 3], 3)
>>> find([5, 3, 8, 3], 7)
>>> find([], 1)
>>> has_duplicate([4, 1, 7, 1])
>>> has_duplicate([4, 1, 7])>>> find([5, 3, 8, 3], 3)
1
>>> find([5, 3, 8, 3], 7)
-1
>>> find([], 1)
-1
>>> has_duplicate([4, 1, 7, 1])
True
>>> has_duplicate([4, 1, 7])
Falsefind rend la première position de 3, et -1 quand la valeur est absente ou la liste vide, puisque la boucle fait alors zéro tour. has_duplicate compare chaque élément avec ceux qui le suivent : deux boucles, l'intérieure commençant à i + 1 pour que chaque paire soit comparée une fois et qu'un élément ne soit jamais comparé à lui-même. Les deux fonctions rendent leur valeur depuis la boucle dès que la réponse est connue. Définition — Les listes parallèles
Deux listes de même longueur sont parallèles quand les éléments de même position vont ensemble : names[i] et scores[i] décrivent le même élève. Un parcours par position lit les deux à la fois ; la position trouvée dans une liste sert dans l'autre. Un même individu, un élève, est ainsi décrit par plusieurs listes, une par propriété. Exemple
Qu'affiche le programme suivant ? names = ["Ada", "Leo", "Zoe"]
scores = [15, 12, 17]
best = 0
for i in range(1, len(names)):
if scores[i] > scores[best]:
best = i
print(names[best], scores[best])
for i in range(len(names)):
if scores[i] >= 15:
print(names[i])Zoe 17
Ada
Zoescores et donne une position, 2, qui sert ensuite dans names. La seconde boucle teste une liste et affiche depuis l'autre. Rien ne lie les deux listes sauf les positions, et c'est pourquoi elles doivent garder la même longueur et le même ordre. Exemple
Qu'affiche le programme suivant ? text = "les lettres les plus frequentes"
counts = [0] * 26
total = 0
for c in text:
if c in "abcdefghijklmnopqrstuvwxyz":
position = ord(c) - ord("a")
counts[position] = counts[position] + 1
total = total + 1
best = 0
for i in range(26):
if counts[i] > counts[best]:
best = i
print(chr(best + ord("a")), counts[best], total)e 7 27counts contient un compteur par lettre : la position 0 pour a, la position 25 pour z, et, les minuscules ayant des codes consécutifs, ord(c) - ord("a") change une lettre en sa position. Un seul parcours du texte suffit à remplir les \(26\) compteurs ; les espaces échouent au test et ne sont pas comptées, donc total est le nombre de lettres, 27. La seconde boucle est le schéma du plus grand à la main sur les \(26\) positions, et chr change la position gagnante en lettre : e, vue 7 fois, soit une fréquence de \(\frac{7}{27}\), environ \(0{,}26\). Les \(26\) fréquences, positives ou nulles et de somme \(1\), forment une loi de probabilité : celle d'une lettre tirée au hasard parmi les lettres du texte. Sur un long texte, les fréquences des \(26\) lettres deviennent caractéristiques de sa langue — en français comme en anglais, e est la lettre la plus fréquente. C'est ainsi qu'on casse un chiffre de César : la lettre la plus fréquente du texte chiffré est très probablement un e décalé. Définition — Les listes de listes
Un élément d'une liste peut être une liste : grid = [[1, 2, 3], [4, 5, 6]] est un tableau de deux lignes et trois colonnes. grid[r] est la ligne numéro r, une liste, et grid[r][c] l'élément de la ligne r et de la colonne c ; pour une grille dont les lignes ont toutes la même longueur, len(grid) est le nombre de lignes et len(grid[0]) le nombre de colonnes. Un tableau se parcourt avec deux boucles, une sur les lignes et une sur les colonnes. Exemple
Qu'affiche le programme suivant ? grid = [["X", "O", "X"], [" ", "X", "O"], ["O", " ", "X"]]
for row in grid:
print(row[0] + "|" + row[1] + "|" + row[2])
count = 0
for r in range(3):
for c in range(3):
if grid[r][c] == "X":
count = count + 1
print("X:", count)
print(grid[1][2])X|O|X
|X|O
O| |X
X: 4
Orange(3), les lignes puis les colonnes. grid[1][2] est le troisième élément de la deuxième ligne : les lignes d'abord, puis les colonnes, les deux à partir de 0. Définition — Découper et recoller
La méthode s.split() coupe la chaîne s à ses espaces, plusieurs espaces de suite comptant pour une, et rend la liste de ses mots ; s.split(",") coupe à chaque virgule à la place. Dans l'autre sens, sep.join(lst) colle les chaînes de la liste lst avec le séparateur sep entre elles, par exemple " ".join(words) reconstruit une phrase. Exemple
Quelle est la valeur de chaque appel ? def longest_word(sentence):
words = sentence.split()
best = words[0]
for w in words:
if len(w) > len(best):
best = w
return best
def word_count(sentence):
return len(sentence.split())>>> "a red fox".split()
>>> longest_word("the quick brown fox")
>>> word_count("the quick brown fox")
>>> "-".join(["a", "b", "c"])>>> "a red fox".split()
['a', 'red', 'fox']
>>> longest_word("the quick brown fox")
'quick'
>>> word_count("the quick brown fox")
4
>>> "-".join(["a", "b", "c"])
'a-b-c'split transforme une phrase en liste de mots, et le schéma du plus grand à la main tourne alors sur les longueurs : quick et brown ont cinq lettres tous deux, et la comparaison stricte garde le premier. Compter les mots, c'est compter les éléments de cette liste. longest_word part de words[0] : la phrase doit contenir au moins un mot. Définition — Liste en compréhension
Une liste peut se construire en une seule expression à partir d'un parcours : [expr for x in lst] est la liste des valeurs de l'expression expr, calculée pour chaque élément x de lst, dans l'ordre. On l'appelle une liste en compréhension. Le parcours peut être un range : [n * n for n in range(5)] vaut [0, 1, 4, 9, 16], les cinq premiers termes de la suite des carrés. Un if écrit à la fin ne garde que les éléments qui passent un test : [x for x in lst if x > 0] est la liste des éléments strictement positifs de lst, dans leur ordre. Une liste en compréhension est le schéma de construction, ou le schéma du filtre, écrit en une ligne : elle rend une nouvelle liste, celle que construirait une boucle partant de [] avec un append à chaque tour, et lst reste intacte. Exemple
Qu'affiche le programme suivant ? u = [3 * n + 2 for n in range(5)]
print(u)
def f(x):
return x * x - 4
xs = [-3, -1, 0, 2, 5]
ys = [f(x) for x in xs]
print(ys)
print([y for y in ys if y > 0])
print([n for n in range(1, 31) if n % 7 == 0])[2, 5, 8, 11, 14]
[5, -3, -4, 0, 21]
[5, 21]
[7, 14, 21, 28]range(5), donc n prend les valeurs de 0 à 4 : elle donne les cinq premiers termes de la suite définie par \(u_n = 3n + 2\), une suite arithmétique de premier terme \(2\) et de raison \(3\). La deuxième parcourt la liste xs et donne les images par \(f\) de ses éléments, dans le même ordre : un tableau de valeurs de \(f\), rangé dans une liste. Le if de la troisième garde les valeurs qui passent le test : 0 n'est pas strictement supérieur à 0, donc l'image de 2 est écartée. La quatrième filtre un range : range(1, 31) va de 1 à 30, et seuls les multiples de 7 sont gardés. La liste ys pourrait aussi se construire avec le schéma de construction, en trois lignes : ys = []
for x in xs:
ys.append(f(x))
-1 n'est pas False
Tester le résultat d'une recherche avec un
if sans comparaison est faux : parmi les entiers, seul 0 compte comme faux, et 0 est une position valable. def find(lst, v):
for i in range(len(lst)):
if lst[i] == v:
return i
return -1
position = find([7, 3], 7)
if position:
print("found at", position)
else:
print("not found")not found0, que le if considère comme faux, alors que -1 serait considéré comme vrai. Écrire la comparaison en entier : if position != -1:.
Des listes parallèles qui se décalent
Des listes parallèles doivent grandir ensemble : un
append sur l'une sans l'autre casse l'appariement, et le parcours échoue sur la liste la plus courte. names = ["Ada", "Leo", "Zoe"]
scores = [15, 12]
for i in range(len(names)):
print(names[i], scores[i])Ada 15
Leo 12
Traceback (most recent call last):
File "main.py", line 4, in <module>
print(names[i], scores[i])
~~~~~~^^^
IndexError: list index out of rangeCompétences à pratiquer
- Prédire
- Chercher
- Les grilles
- Construire des listes en compréhension
III
Les données réelles
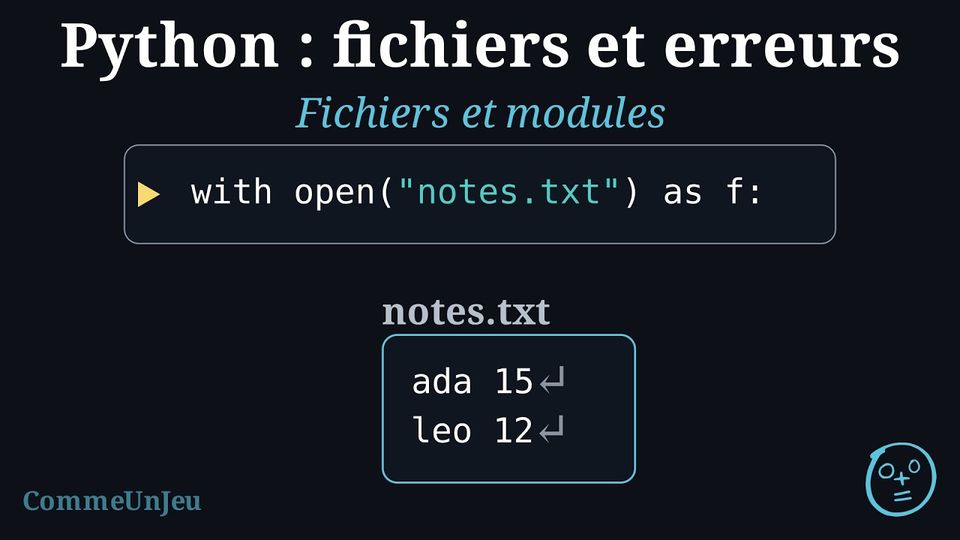
Tout ce qu'un programme a calculé disparaît quand il se termine : les variables vivent dans la mémoire de la machine, et l'exécution suivante repart de rien. Un fichier garde les données sur le disque, où le programme les retrouve le lendemain, et où un autre programme peut les lire. La même idée explique d'où viennent
math et random : un module est un fichier de Python qu'un programme importe.
Définition — Ouvrir un fichier
L'instruction with open(name) as f: ouvre en lecture le fichier appelé name et lui donne le nom f dans son bloc indenté ; le fichier se referme tout seul à la fin du bloc. Un second argument choisit un autre mode : open(name, "w") ouvre en écriture et vide d'abord le fichier, open(name, "a") ouvre pour ajouter à sa fin. Lire un fichier qui n'existe pas lève une FileNotFoundError. Définition — Lire un fichier
Un fichier ouvert se lit de deux façons : f.read() rend tout le texte en une seule chaîne, et la boucle for line in f: donne les lignes une à une. Chaque ligne garde le retour à la ligne qui la termine, que line.strip() retire en même temps que les espaces des deux bouts. Après la boucle, la lecture est à la fin du fichier : pour le lire de nouveau, l'ouvrir de nouveau. Définition — Écrire un fichier
Sur un fichier ouvert en écriture, f.write(text) écrit le texte à la suite de ce qui a déjà été écrit, et n'ajoute aucun retour à la ligne : le texte doit porter le sien, comme dans f.write(line + "\textbackslash n"). Par convention, un print affiche à l'écran et un fichier s'écrit avec write. Méthode — Lire un fichier ligne à ligne
- Ouvrir avec
withpour que le fichier se referme tout seul, quoi qu'il arrive dans le bloc. - Parcourir les lignes avec
for line in f:. - Nettoyer la ligne avec
strip(), puis la découper avecsplit()quand elle porte plusieurs champs. - Traiter la ligne comme un élément d'une collection : compter, accumuler, ranger dans une liste (ou dans un dictionnaire, quand on le connaît). Le résultat sert après le bloc.
Exemple
Qu'affiche le programme suivant ? Il écrit lui-même le fichier pour que l'exemple tienne seul ; dans un cas réel le fichier est déjà là. with open("notes.txt", "w") as f:
f.write("ada 15\n")
f.write("leo 12\n")
with open("notes.txt") as f:
text = f.read()
print(len(text))
count = 0
with open("notes.txt") as f:
for line in f:
print(line.strip())
count = count + 1
print(count, "lines")14
ada 15
leo 12
2 lines"ada 15" et "leo 12" font six caractères chacun, plus les deux retours à la ligne, quatorze en tout. Le troisième parcourt les lignes : strip() retire le retour à la ligne, sans quoi chaque affichage serait suivi d'une ligne vide. Le fichier est ouvert deux fois en lecture, parce que la première lecture a laissé la lecture à sa fin.
Le retour à la ligne reste
Une ligne lue d'un fichier se termine par son retour à la ligne, qui se voit dès qu'elle est comparée ou affichée.
with open("words.txt", "w") as f:
    f.write("cat\ndog\n")

with open("words.txt") as f:
    for line in f:
        print(len(line), line == "cat", len(line.strip()))
4 False 3
4 False 3"cat\textbackslash n" a quatre caractères et n'est pas égale à "cat". Chaque ligne lue est nettoyée par strip() avant d'être comparée, convertie ou rangée.
Définition — Fichier de données
Un fichier de données garde un tableau sous forme de texte : un enregistrement par ligne, ses champs séparés par un séparateur — une virgule, ou un point-virgule dans beaucoup de fichiers écrits avec la virgule décimale — et, sur la première ligne, l'en-tête, qui nomme les champs. Un tel fichier est souvent appelé fichier CSV (valeurs séparées par des virgules, en anglais). Chaque champ est lu comme une chaîne : un nombre doit être converti avec int ou float avant tout calcul. Par exemple, le fichier rain.csv donne la hauteur de pluie, en millimètres, de trois villes pendant trois mois : city;month;rain_mm
Brest;1;133
Brest;2;107
Brest;3;92
Nice;1;82
Nice;2;71
Nice;3;52
Lyon;1;47
Lyon;2;43
Lyon;3;51Méthode — Lire un fichier de données dans une liste d'enregistrements
- Ouvrir le fichier avec
withet parcourir ses lignes avecfor line in f:. - Sauter l'en-tête : une variable
first, qui vautTrueavant la boucle, distingue le premier tour ; elle passe àFalseaprès ce tour. - Découper chaque autre ligne en champs :
line.strip().split(";")donne la liste de ses champs, sans le retour à la ligne. - Convertir les champs numériques avec
intoufloat, puis ajouter l'enregistrement, une petite liste, à la liste des enregistrements.
Exemple
Le dossier du programme contient le fichier rain.csv de la définition. Qu'affiche le programme suivant ? records = []
with open("rain.csv") as f:
first = True
for line in f:
if first:
first = False
else:
fields = line.strip().split(";")
records.append([fields[0], int(fields[1]), int(fields[2])])
print(len(records), "records")
print(records[0])
total = 0
for r in records:
if r[0] == "Brest":
total = total + r[2]
print("Brest:", total, "mm")9 records
['Brest', 1, 133]
Brest: 332 mm"Brest" : \(133 + 107 + 92 = 332\).
La virgule décimale
Beaucoup de fichiers écrits en français emploient la virgule décimale,
7,3, et donc le point-virgule comme séparateur. La fonction float ne lit que le point décimal : la virgule est d'abord remplacée. fields = "Brest;1;7,3".strip().split(";")
temp = float(fields[2].replace(",", "."))
print(temp + 1)8.3replace, float("7,3") arrête le programme sur une erreur ValueError.
Méthode — Sélectionner des enregistrements par une condition
Une sélection garde les enregistrements qui vérifient une condition sur leurs champs ; c'est le schéma du filtre — garder dans une nouvelle liste les éléments qui passent un test — appliqué aux enregistrements. - Écrire la condition sur les champs d'un enregistrement
r, lus par position :r[0] == "Brest",r[2] > 80. - Combiner des conditions avec
and(les deux doivent être vraies),or(l'une au moins est vraie) etnot(inverse une condition) ; chaque côté est une comparaison complète. - Parcourir les enregistrements et compter, additionner, ou ajouter à une nouvelle liste les enregistrements — ou l'un de leurs champs — qui vérifient la condition.
- Résumer la sélection : sa taille, la somme ou la moyenne d'un champ — une moyenne seulement si la sélection contient au moins un enregistrement, puisque sa taille est le diviseur.
Exemple
La liste records est celle lue dans rain.csv à l'exemple précédent. Qu'affiche le programme suivant ? wet = 0
for r in records:
if r[0] != "Brest" and r[2] > 80:
wet = wet + 1
print(wet)
winter = []
for r in records:
if r[1] == 1 or r[1] == 2:
winter.append(r[2])
print(sum(winter) / len(winter))
others = []
for r in records:
if not r[0] == "Lyon":
others.append(r[0])
print(len(others))1
80.5
6and : la ville n'est pas Brest et la hauteur dépasse \(80\) mm ; seul Nice au mois \(1\), \(82\) mm, vérifie les deux. Deuxième sélection, avec or : les mois \(1\) et \(2\) des trois villes, six enregistrements ; leur moyenne est \(\dfrac{133 + 107 + 82 + 71 + 47 + 43}{6} = \dfrac{483}{6} = 80{,}5\) mm (Python écrit 80.5). Troisième sélection, avec not : tous les enregistrements dont la ville n'est pas Lyon, six sur neuf. Méthode — Construire un tableau croisé à partir de données brutes
Des données brutes sont une liste d'enregistrements, chaque enregistrement étant une petite liste [valeur du critère 1, valeur du critère 2]. Un tableau croisé compte les enregistrements pour chaque couple de valeurs. - Lister les catégories de chaque critère, dans l'ordre où le tableau les montrera : deux listes,
cats1etcats2, chaque valeur une seule fois, et toutes les valeurs présentes dans les enregistrements (sinonindexlève une erreur). - Créer le tableau vide : une liste de listes, une ligne par catégorie de
cats1, chaque ligne valant[0] * len(cats2). Ajouter une ligne neuve à chaque fois —[[0] * n] * mcréerait des alias d'une seule et même ligne (voir la remarque « Une ligne partagée » en fin de section). - Parcourir les enregistrements : pour chacun, trouver sa ligne par
cats1.index(record[0])et sa colonne parcats2.index(record[1]), et ajouter \(1\) à cette case. - Lire le tableau :
table[r][c]est l'effectif du couple ;sum(table[r])est le total d'une ligne ; un total de colonne est une boucle sur les lignes. Une fréquence d'une case est son effectif divisé par le total de la ligne, souvent multiplié par \(100\) — la seule façon de comparer des lignes de tailles différentes.
Exemple
Une enquête enregistre, pour chaque élève, un genre et un moyen de venir à l'école. Qu'affiche le programme suivant ? rows = [["girl", "bus"], ["boy", "bike"], ["girl", "walk"], ["girl", "bus"],
["boy", "bus"], ["boy", "walk"], ["girl", "bike"], ["boy", "bus"]]
genders = ["girl", "boy"]
modes = ["bus", "bike", "walk"]
table = []
for g in genders:
table.append([0] * len(modes))
for row in rows:
r = genders.index(row[0])
c = modes.index(row[1])
table[r][c] = table[r][c] + 1
print(" ", modes)
for r in range(len(genders)):
print(genders[r], table[r], "total", sum(table[r])) ['bus', 'bike', 'walk']
girl [2, 1, 1] total 4
boy [2, 1, 1] total 4["girl", "bus"] apparaît deux fois, donc table[0][0] vaut \(2\). Chaque total de ligne est le nombre d'élèves de ce genre ; le nombre d'élèves qui viennent en bus est un total de colonne, table[0][0] + table[1][0] \(= 4\). Exemple
Le fichier trips.csv donne, pour dix élèves, leur classe et leur façon habituelle de venir à l'école : id;class;mode
P01;A;bus
P02;A;bike
P03;B;walk
P04;A;bus
P05;B;bus
P06;B;walk
P07;A;walk
P08;B;bike
P09;A;bus
P10;B;walk[[0] * n] * m, qui répéterait une seule et même ligne —, puis index donne la ligne et la colonne de chaque enregistrement, et on ajoute \(1\) à cette case. Qu'affiche-t-il ? records = []
with open("trips.csv") as f:
first = True
for line in f:
if first:
first = False
else:
fields = line.strip().split(";")
records.append([fields[1], fields[2]])
classes = ["A", "B"]
modes = ["bus", "bike", "walk"]
table = []
for c in classes:
table.append([0] * len(modes))
for r in records:
i = classes.index(r[0])
j = modes.index(r[1])
table[i][j] = table[i][j] + 1
for i in range(len(classes)):
total = sum(table[i])
print(classes[i], table[i], total, round(100 * table[i][0] / total), "% by bus")A [3, 1, 1] 5 60 % by bus
B [1, 1, 3] 5 20 % by bus
Une ligne partagée
Construire une grille en répétant une ligne fait de chaque ligne un alias de la même liste.
grid = [[0] * 3] * 3
grid[0][0] = 1
print(grid)
[[1, 0, 0], [1, 0, 0], [1, 0, 0]]append, pour que chaque ligne soit une nouvelle liste.
Compétences à pratiquer
- Prédire
- Lire un fichier
- Réaliser un tableau croisé
- Traiter un fichier de données
IV
Pour aller plus loin
Compétences à pratiquer
- Aller plus loin avec les listes
- Quiz
Aller à la section