Éducation Nationale Française · Terminale Complémentaire
Lois discrètes
I
Variables aléatoires et loi uniforme
I.1
Variable aléatoire et loi de probabilité
Définition — Variable aléatoire
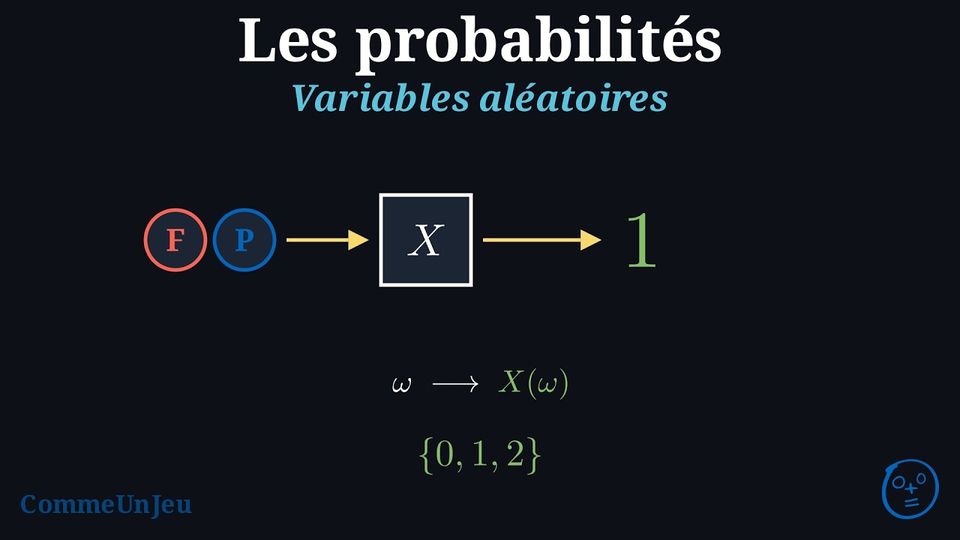
Une variable aléatoire, notée \(X\), est une fonction qui associe une valeur numérique à chaque issue \(\omega\) de l'univers \(\Omega\). On note cette valeur \(X(\omega)\). 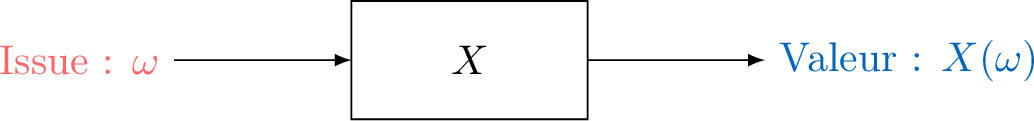
Définition — Variable aléatoire discrète
Une variable aléatoire est discrète si l'ensemble de ses valeurs possibles est fini ou infini dénombrable. Cela signifie que l'on peut énumérer toutes les valeurs possibles. Sauf mention contraire, les variables aléatoires considérées prennent un nombre fini de valeurs ; le rang d'un premier succès, rencontré plus loin, est l'exception. Définition — Événements liés à une variable aléatoire
Pour une variable aléatoire \(X\) : - \((X = x)\) : l’ensemble des issues où \(X\) prend la valeur \(x\).
- \((X \leq x)\) : l’ensemble des issues où \(X\) est inférieur ou égal à \(x\).
- \((X \geq x)\) : l’ensemble des issues où \(X\) est supérieur ou égal à \(x\).
Définition — Loi de probabilité
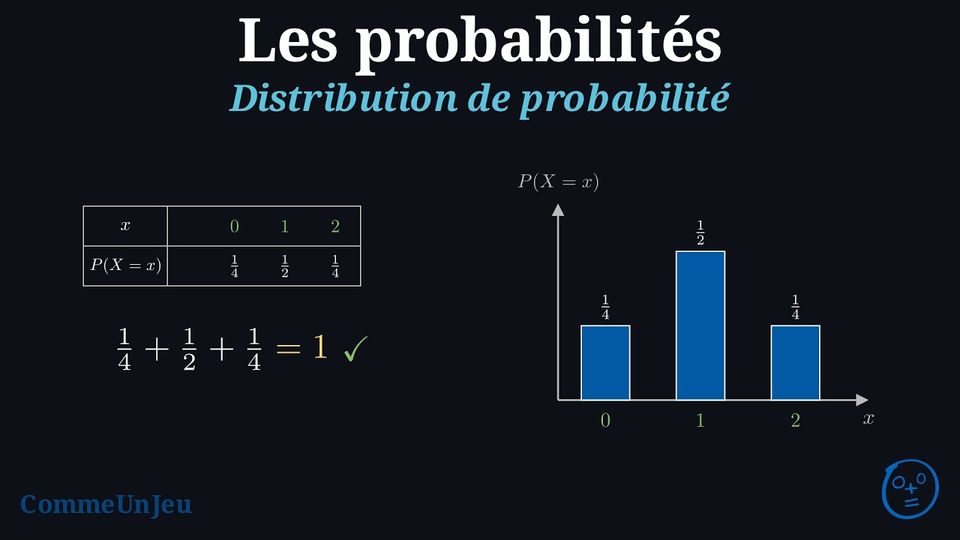
La loi de probabilité d’une variable aléatoire \(X\) donne la probabilité \(P(X = x_i)\) pour chaque valeur possible \(x_1,x_2,\dots,x_n\). Ici, chaque \(x_i\) est une valeur possible de \(X\) — un nombre réel — pas une issue. Elle peut être représentée par un tableau ou une formule. Proposition — Caractéristique d'une loi de probabilité
Pour une variable aléatoire \(X\) prenant les valeurs \(x_1,x_2,\dots,x_n\), on a : - \(0 \leq P(X=x_i) \leq 1\) pour tout \(i=1,\dots,n\),
- \(\displaystyle\sum_{i=1}^n P(X=x_i) =P(X=x_1)+P(X=x_2)+\dots+P(X=x_n)= 1 \).
Compétences à pratiquer
- Vérifier la validité des lois de probabilité
I.2
Espérance et variance
Définition — Espérance
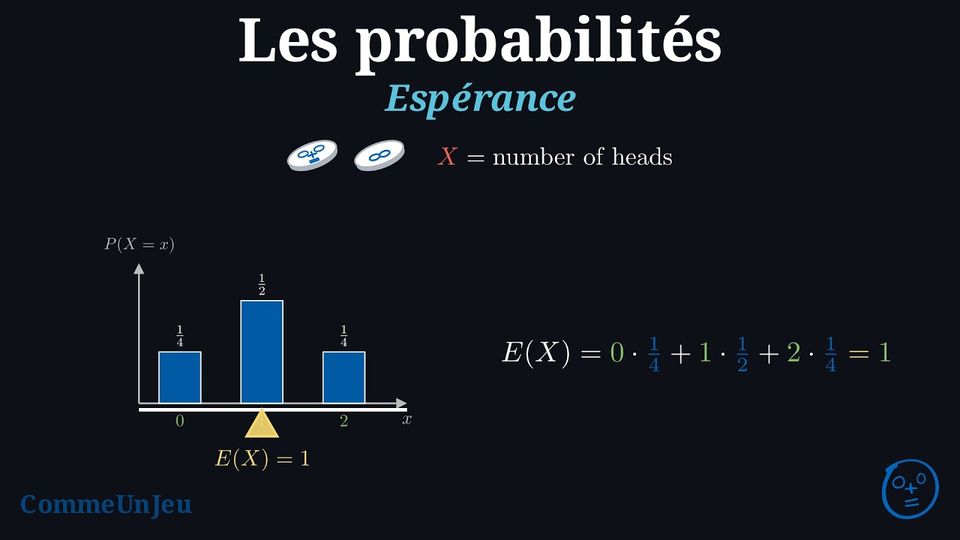
Soit \(X\) une variable aléatoire prenant les valeurs \(x_1, x_2, \ldots, x_n\). L'espérance de \(X\), notée \(E(X)\) et aussi appelée moyenne, est :$$\begin{aligned}E(X) &= \sum_{i=1}^{n} x_i P(X = x_i)\\
&= x_1 P(X = x_1) + x_2 P(X = x_2) + \cdots + x_n P(X = x_n)\\
\end{aligned}$$ Proposition — Espérance de \(aX + b\)
Pour toute variable aléatoire \(X\) et tous réels \(a\) et \(b\) :$$ E(aX + b) = aE(X) + b $$ Cette propriété découle de deux règles plus simples : - \(E(aX) = aE(X)\) (multiplier la variable par \(a\) multiplie son espérance par \(a\)).
- \(E(X+b) = E(X) + b\) (ajouter \(b\) à la variable ajoute \(b\) à son espérance).
Définition — Variance et écart-type
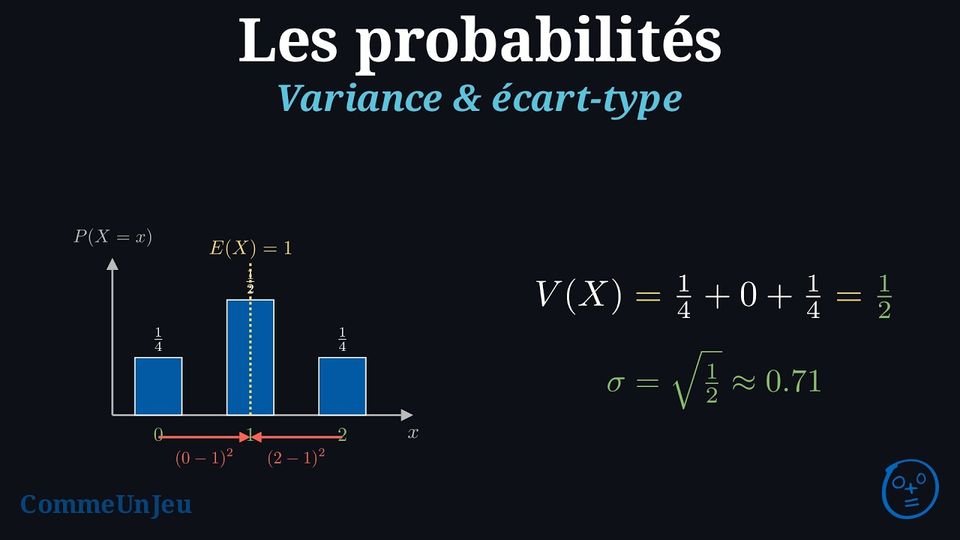
La variance, notée \(V(X)\), est :$$\begin{aligned}V(X) &= \sum_{i=1}^{n} (x_i - E(X))^2 P(X = x_i)\\
&= \left(x_1-E(X)\right)^2 P(X = x_1) + \left(x_2-E(X)\right)^2 P(X = x_2) + \cdots + \left(x_n-E(X)\right)^2 P(X = x_n)\\
\end{aligned}$$ L’écart-type, noté \(\sigma(X)\), est \(\sigma(X) = \sqrt{V(X)}\). Proposition — Formule de König-Huygens
Soit \(X\) prenant les valeurs \(x_1, \dots, x_n\) avec les probabilités \(p_1, \dots, p_n\). En notant \(E(X^2) = p_1 x_1^2 + \dots + p_n x_n^2\) l'espérance des carrés, $$V(X) = E(X^2) - [E(X)]^2.$$ La variance est la moyenne des carrés moins le carré de la moyenne : une formule plus pratique que la définition, puisqu'elle épargne les écarts \(x_i - E(X)\). Proposition — Variance de \(aX + b\)
Pour toute variable aléatoire \(X\) et toutes constantes \(a\) et \(b\) : $$\textcolor{colorprop}{V(aX + b) = a^2\,V(X)} \qquad \text{et} \qquad \textcolor{colorprop}{\sigma(aX + b) = |a|\,\sigma(X)}.$$ Ajouter une constante \(b\) déplace chaque valeur, et l'espérance avec elles, de la même quantité : les écarts à la moyenne ne changent pas, ni la dispersion. Multiplier par \(a\) multiplie chaque écart par \(a\), donc chaque carré d'écart par \(a^2\). Ce sont les règles déjà connues pour la moyenne et l'écart-type d'une transformation affine de données ; avec l'espérance de \(aX + b\), elles disent comment le centre et la dispersion d'une variable aléatoire changent quand on change son unité ou son origine. Compétences à pratiquer
- Calculer des écarts-types
- Calculer l'espérance et la variance de \(aX + b\)
I.3
La loi uniforme sur \(\{1\virgule \dots\virgule n\}\)
Définition — Loi uniforme
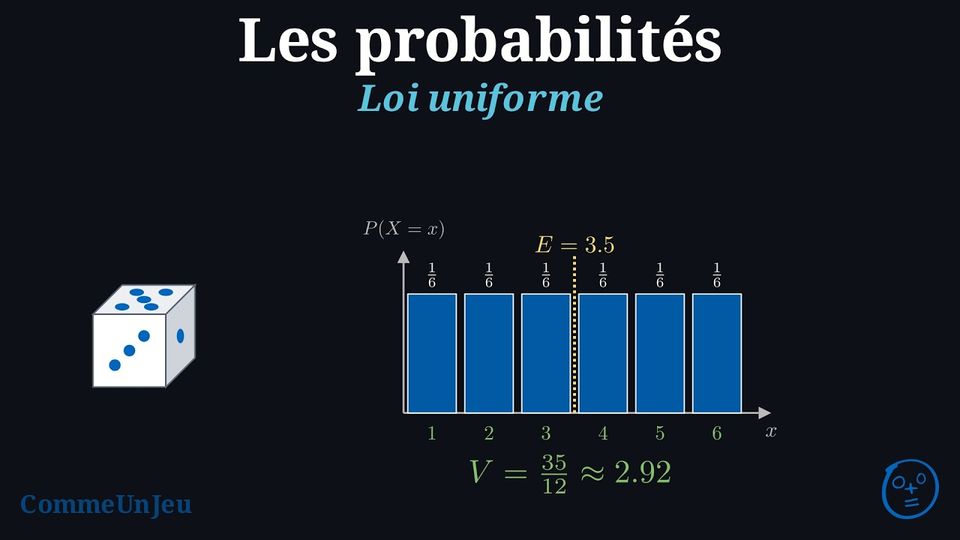
Une variable aléatoire \(X\) suit une loi uniforme si toutes ses valeurs possibles ont la même probabilité :$$P(X = x) = \frac{1}{\text{nombre de valeurs possibles}}, \quad \text{pour toute valeur possible }x$$ Exemple
Soit \(X\) le résultat du lancer d’un dé équilibré :  .
- Lister les valeurs possibles de \(X\).
- Donner la loi de probabilité de \(X\) sous forme de tableau.
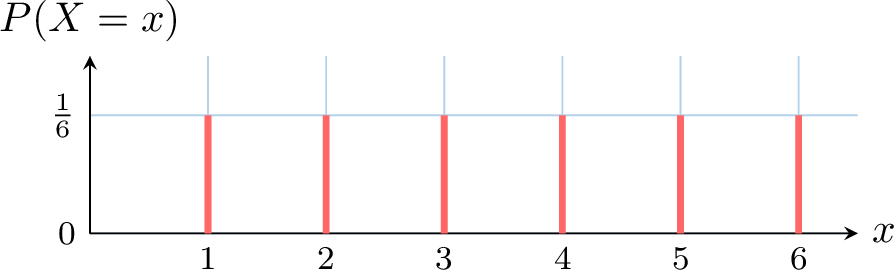
- Représenter cette loi par un diagramme en bâtons.
- Valeurs possibles : \(1, 2, 3, 4, 5, 6\).
- Loi de probabilité :
\(x\) 1 2 3 4 5 6 \(P(X = x)\) \(\frac{1}{6}\) \(\frac{1}{6}\) \(\frac{1}{6}\) \(\frac{1}{6}\) \(\frac{1}{6}\) \(\frac{1}{6}\) - Diagramme en bâtons :
Proposition — Espérance et variance d’une loi uniforme
Pour une variable aléatoire \(X\) qui suit une loi uniforme sur l'ensemble des entiers \(\{1, 2, \ldots, n\}\) : - L'espérance est \(E(X) = \frac{n+1}{2}\).
- La variance est \(V(X) = \frac{n^2-1}{12}\).
Calcul de l'espérance \(E(X)\) : pour une loi uniforme sur \(\{1, 2, \dots, n\}\), la probabilité de chaque issue est \(P(X=i) = \frac{1}{n}\). $$ \begin{aligned} E(X) &= \sum_{i=1}^n i \cdot P(X=i) = \sum_{i=1}^n i \cdot \frac{1}{n} \\
&= \frac{1}{n} \sum_{i=1}^n i \quad \text{(mise en facteur de } 1/n\text{)}\\
&= \frac{1}{n} \left( \frac{n(n+1)}{2} \right) \text{(somme des entiers de } 1 \text{ à } n\text{)} \\
& = \frac{n+1}{2} \end{aligned} $$
Exemple
Soit \(X\) la variable aléatoire correspondant au résultat du lancer d'un dé équilibré à six faces. Déterminer l'espérance et la variance de \(X\).
La variable aléatoire \(X\) suit une loi uniforme sur \(\{1, 2, 3, 4, 5, 6\}\).
- \( E(X) = \frac{6+1}{2} = 3{,}5 \)
- \( V(X) = \frac{6^2-1}{12} = \frac{35}{12} \approx 2{,}92 \)
Compétences à pratiquer
- Reconnaître une loi uniforme
- Calculer l'espérance et la variance d'une loi uniforme
II
Arbres et épreuves indépendantes
II.1
Arbres pondérés
Définition — Arbre pondéré
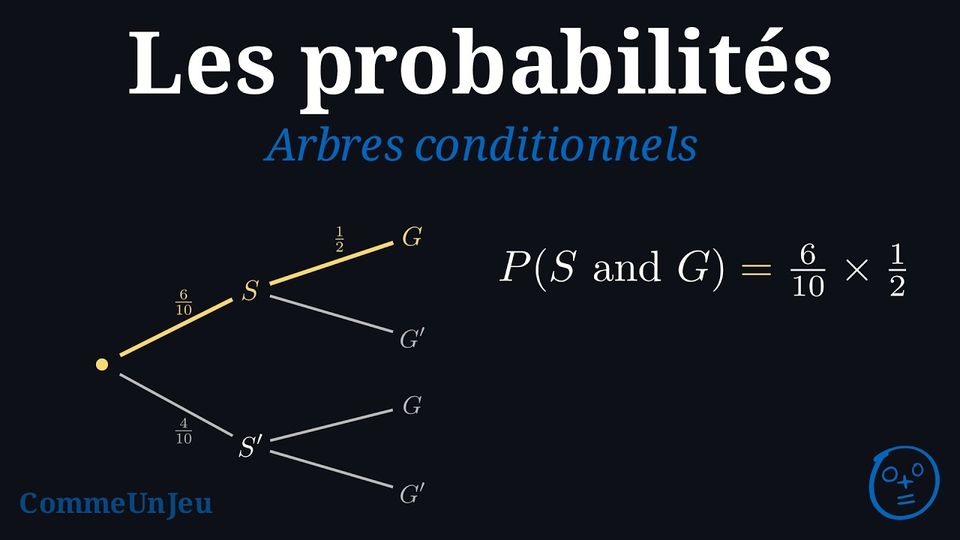
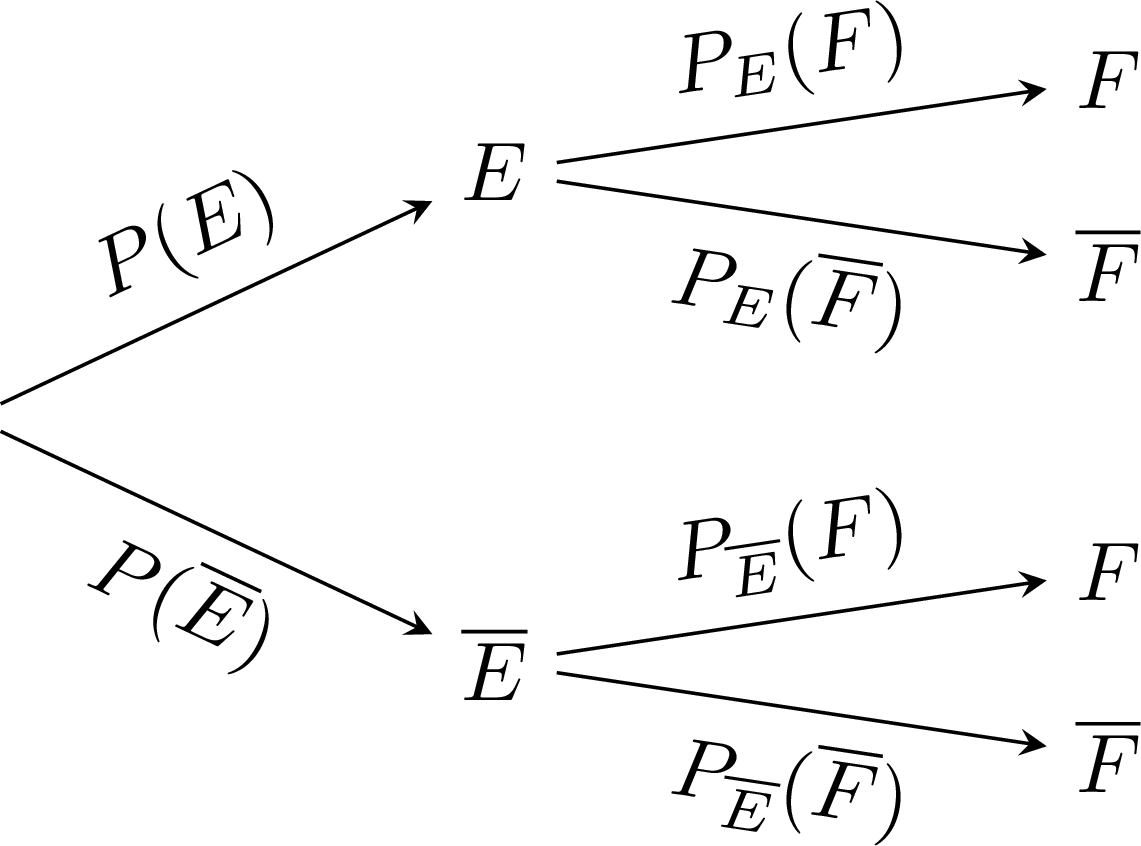
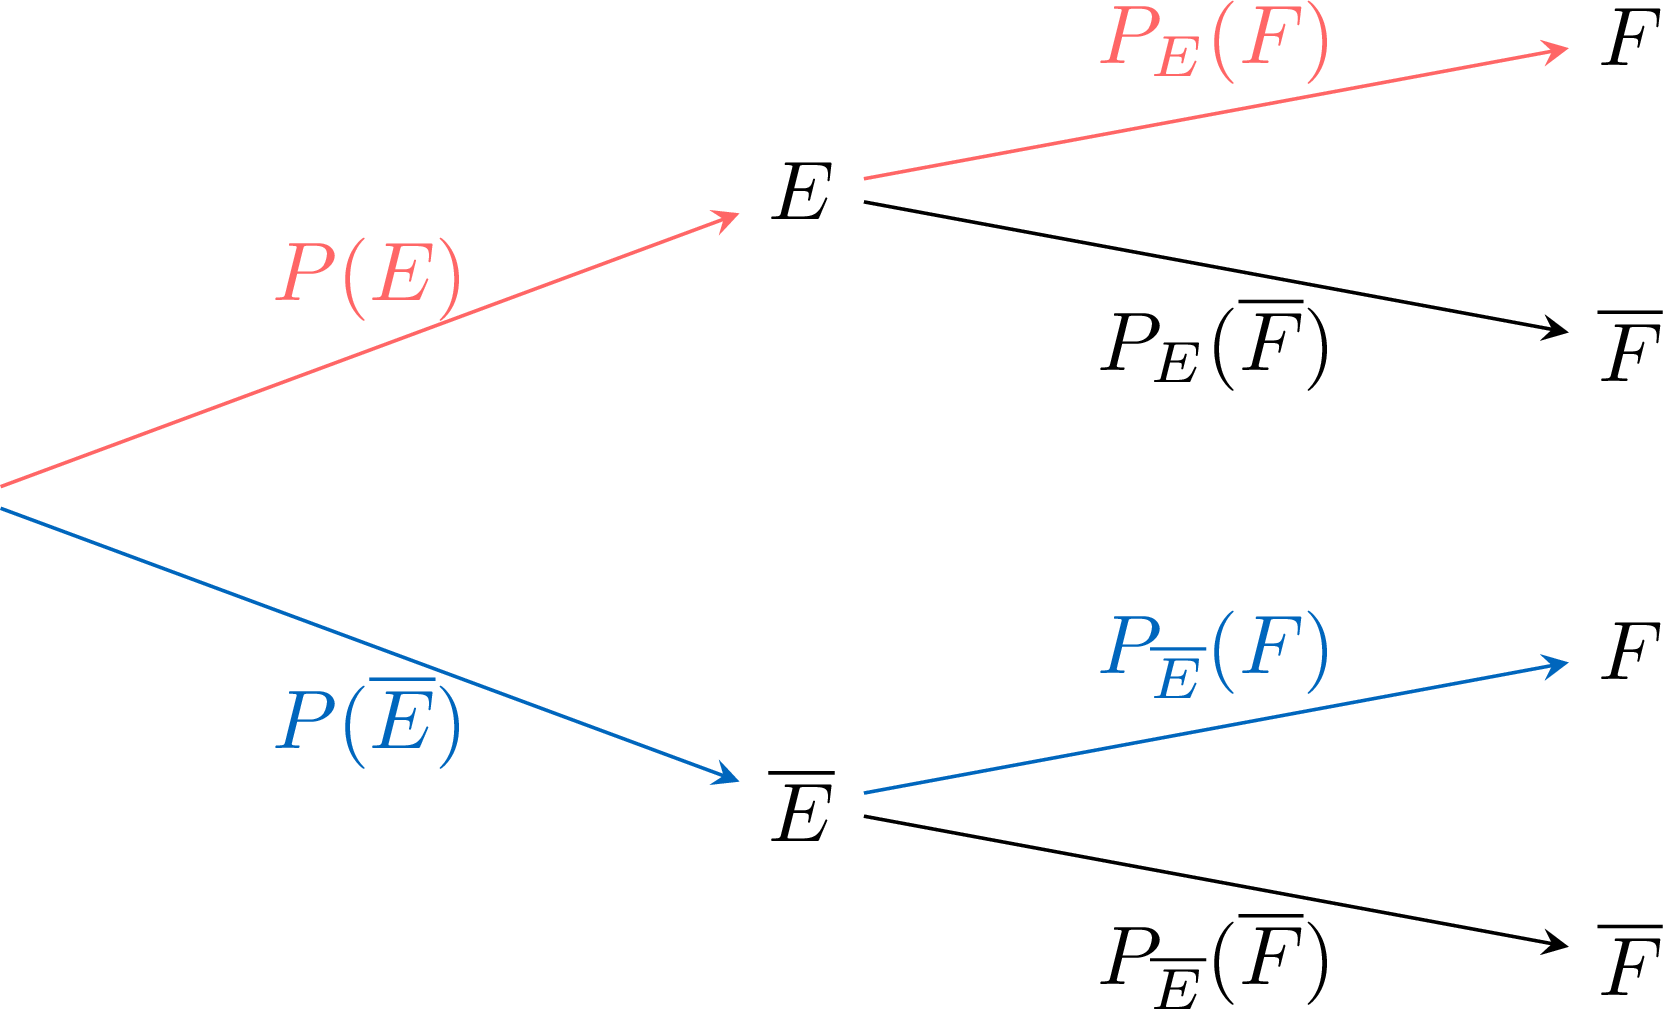
Un arbre pondéré (ou diagramme en arbre des probabilités conditionnelles) représente les probabilités d’une succession d’événements : - Chaque branche issue d’un nœud indique soit une probabilité non conditionnelle (par exemple, \(P(E)\)), soit une probabilité conditionnelle (par exemple, \(\PCondFr{F}{E}\)).
- Les événements sont indiqués à la fin de chaque branche.
- Les probabilités des branches issues d’un même nœud ont pour somme \(1\) (règle de la somme) : par exemple \(\PCondFr{\overline{F}}{E} = 1 - \PCondFr{F}{E}\).
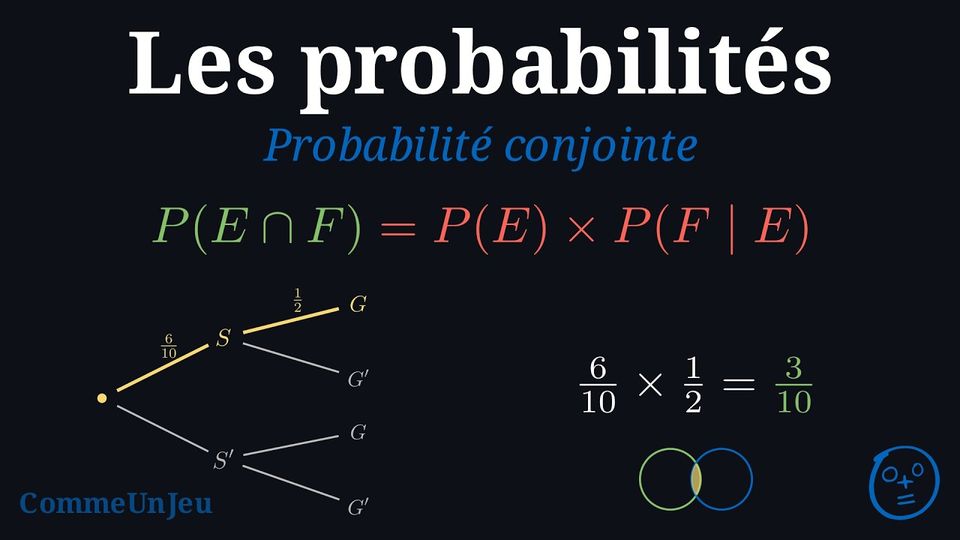
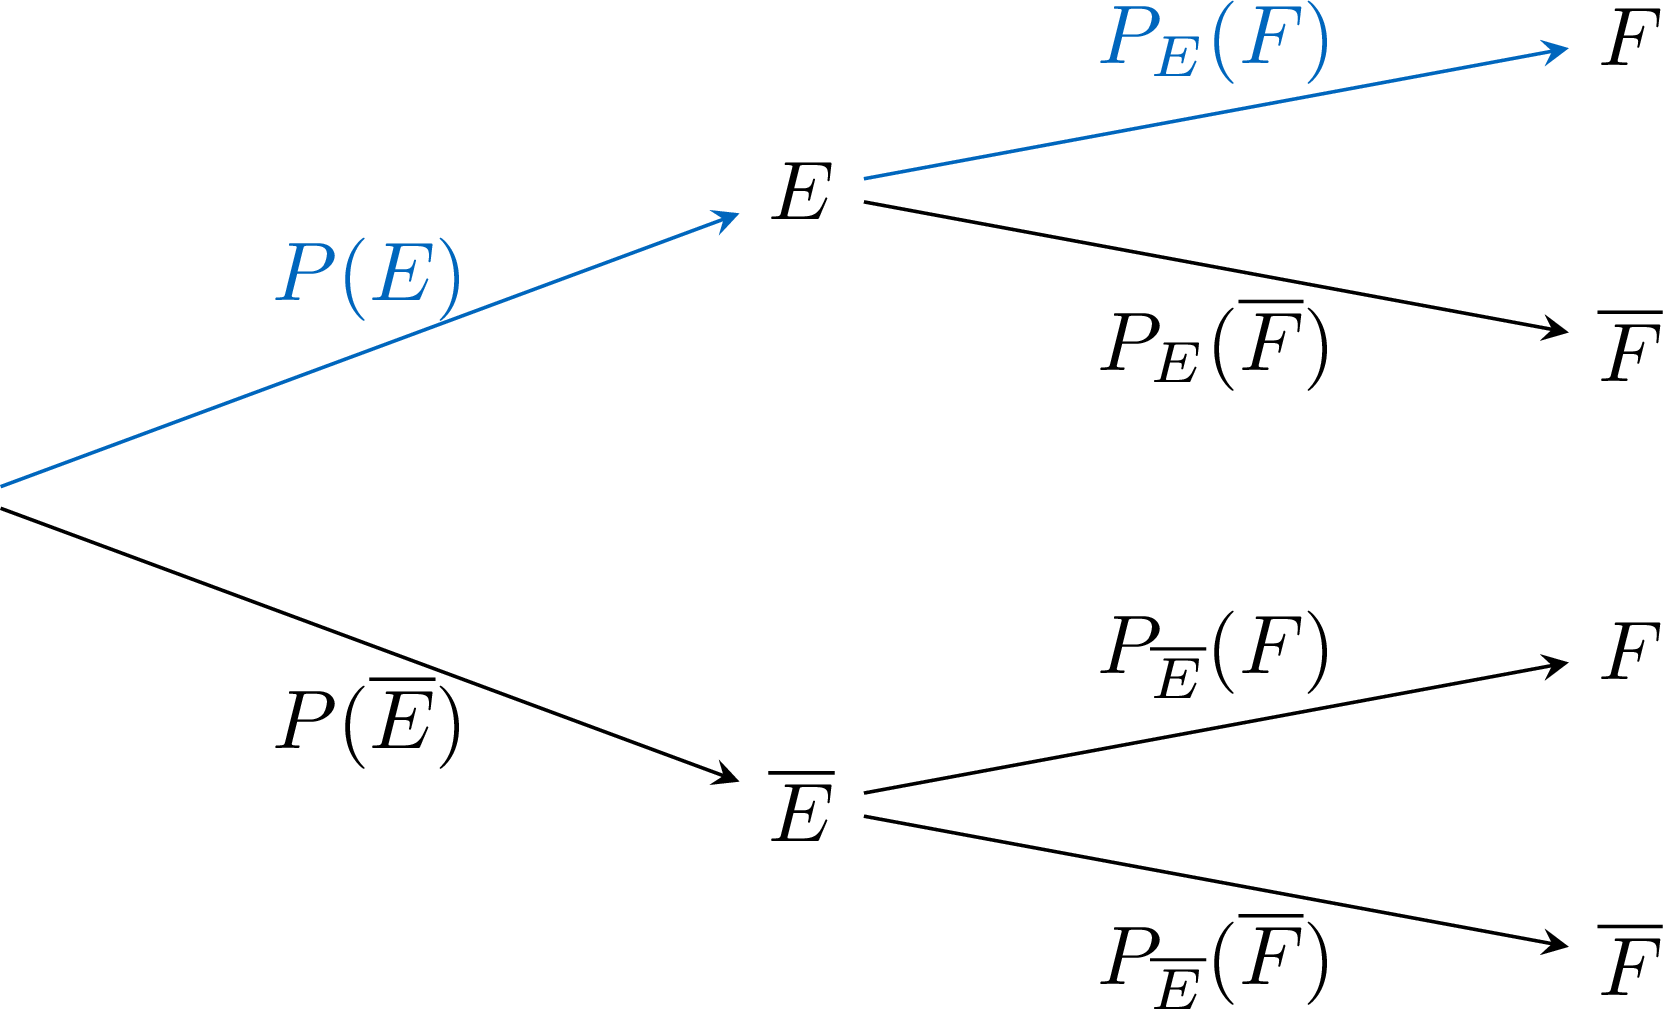
- La probabilité de l’intersection des événements rencontrés le long d’un chemin est le produit des probabilités le long de ce chemin (règle du produit).
Méthode — Calculer \(P(E \cap F)\) à l'aide d'un arbre pondéré
- Repérer le chemin qui réalise à la fois \(E\) et \(F\).
- Multiplier les probabilités le long de ce chemin.
Compétences à pratiquer
- Calculer des probabilités jointes avec des arbres
II.2
La formule des probabilités totales
Théorème — Formule des probabilités totales
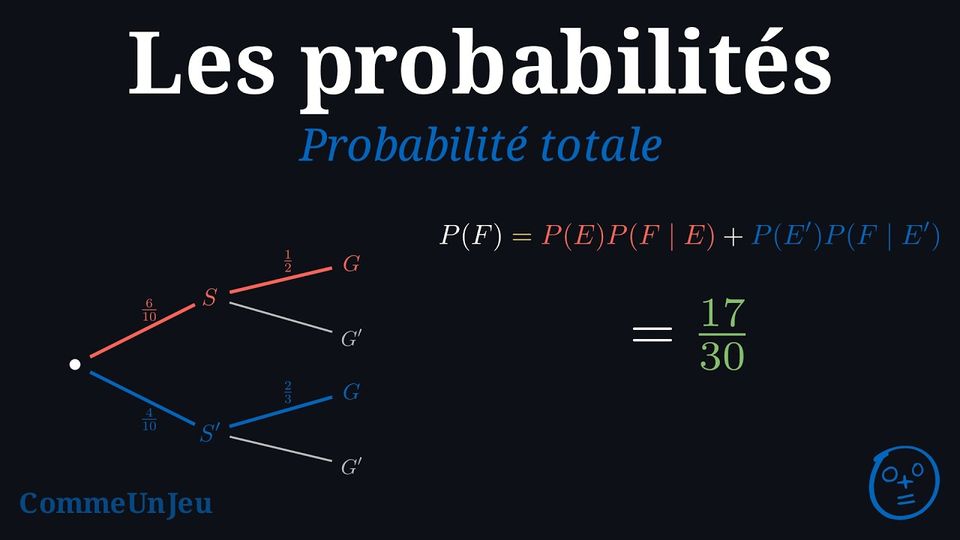
Pour des événements \(E\) et \(F\) avec \(0 < P(E) < 1\) : $$P(F) = P(E) \PCondFr{F}{E} + P(\overline{E}) \PCondFr{F}{\overline{E}}.$$ Ce résultat utilise la partition de l’univers formée par \(E\) et son contraire \(\overline{E}\). Plus généralement, si \((E_1,\dots,E_n)\) forme une partition de l’univers en événements de probabilités non nulles, alors $$P(F) = \sum_{i=1}^n P(E_i)\PCondFr{F}{E_i}.$$ Méthode — Calculer \(P(F)\) à l'aide d'un arbre
- Repérer tous les chemins qui mènent à \(F\).
- Calculer le produit des probabilités le long de chaque chemin, puis additionner ces produits.
Compétences à pratiquer
- Calculer des probabilités avec des arbres
II.3
Succession d'épreuves indépendantes
Définition — Succession d'épreuves
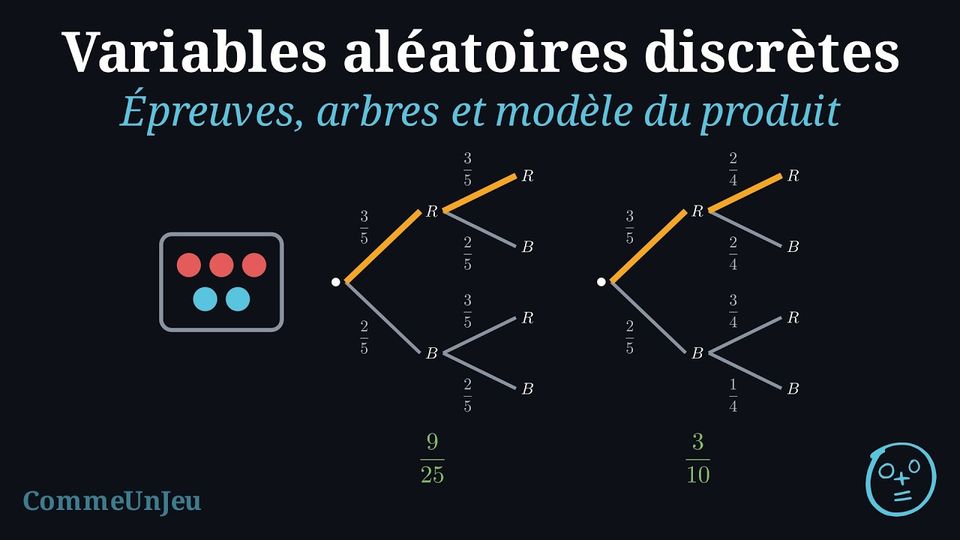
Une succession de \(n\) épreuves est une expérience aléatoire formée de \(n\) expériences aléatoires réalisées l'une après l'autre, d'ensembles d'issues \(E_1, E_2, \dots, E_n\). Une issue de la succession est la liste \((x_1\,;\,x_2\,;\,\dots\,;\,x_n)\) des résultats, avec \(x_i \in E_i\) ; l'univers est le produit cartésien \(E_1 \times E_2 \times \dots \times E_n\) de toutes ces listes. La succession se représente par un arbre à \(n\) niveaux, un par épreuve : un chemin de la racine à une feuille est une issue. Définition — Épreuves indépendantes : le modèle du produit
Les \(n\) épreuves sont indépendantes quand le résultat de chacune ne dépend pas des résultats des autres : sur l'arbre, chaque issue d'une épreuve garde la même probabilité quels que soient les résultats des épreuves précédentes, donc, à un niveau donné de l'arbre, les branches qui mènent à une même issue portent le même poids quel que soit le nœud d'où elles partent (les poids des différentes issues d'une épreuve n'ont pas à être égaux). Dans ce modèle, la probabilité d'une issue est le produit des probabilités de ses composantes : $$P\bigl((x_1\,;\,x_2\,;\,\dots\,;\,x_n)\bigr) = P_1(x_1) \times P_2(x_2) \times \dots \times P_n(x_n),$$ où \(P_i(x_i)\) est la probabilité du résultat \(x_i\) dans la \(i\)-ième épreuve. Pour deux épreuves, c'est la règle du produit des événements indépendants. Méthode — Calculer avec un arbre
- Dessiner l'arbre, un niveau par épreuve, et écrire la probabilité de chaque branche ; les probabilités des branches issues d'un même nœud ont pour somme \(1\).
- Probabilité d'un chemin : multiplier les probabilités le long du chemin, de la racine à la feuille.
- Probabilité d'un événement : additionner les probabilités des chemins qui le réalisent (deux chemins différents sont des issues disjointes).
- « Au moins un » : passer par le contraire « aucun », qui a bien moins de chemins (un seul quand chaque épreuve est réduite à « l'issue se produit ou non »).
Compétences à pratiquer
- Modéliser une succession d'épreuves par un arbre
III
Épreuve, loi et schéma de Bernoulli
III.1
Épreuve et loi de Bernoulli
Définition — Épreuve de Bernoulli
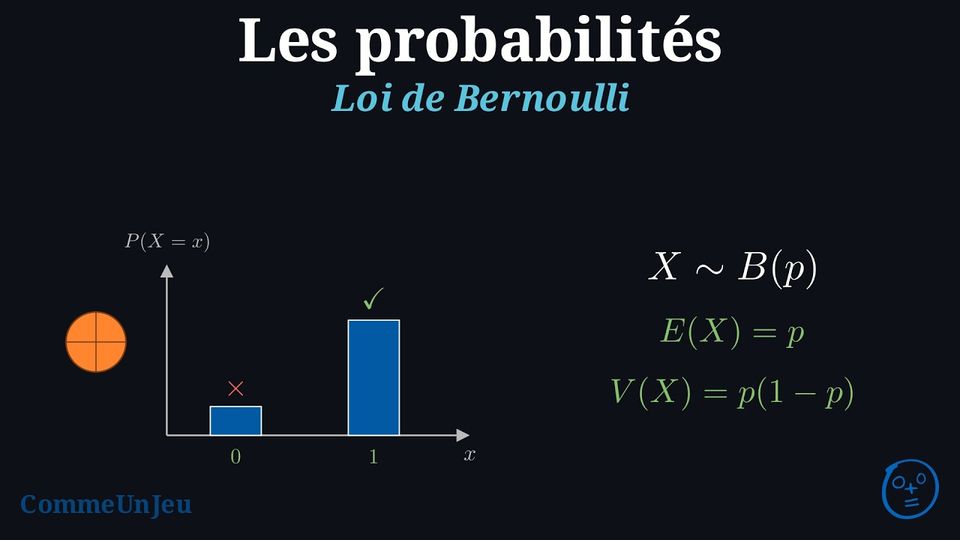
Une épreuve de Bernoulli est une expérience aléatoire à exactement deux issues, appelées succès et échec. La probabilité du succès se note \(p\), un nombre strictement compris entre \(0\) et \(1\) — un succès ni impossible ni certain ; la probabilité de l'échec est \(1 - p\). Lancer une pièce, tirer sur une cible, tirer une boule rouge ou non : toute expérience devient une épreuve de Bernoulli dès qu'un événement ni impossible ni certain est choisi comme « succès » et que l'on ne note que sa réalisation, sa non-réalisation étant l'échec.
Une épreuve de Bernoulli produit une variable aléatoire : \(X = 1\) si l'épreuve est un succès, \(X = 0\) si c'est un échec. Sa loi est la loi de Bernoulli de paramètre \(p\), la probabilité de succès.
Définition — Loi de Bernoulli
Une variable aléatoire \(X\) suit une loi de Bernoulli de paramètre \(p\) si : - Les valeurs possibles sont 0 et 1.
- \(P(X = 1) = p\) et \(P(X = 0) = 1 - p\).
Exemple
Un joueur de basketball a 80\(\pourcent\) de chances de réussir un lancer franc. Soit \(X = 1\) si le tir est réussi, et \(X = 0\) s'il est manqué. - \(X\) suit-elle une loi de Bernoulli ?
- Déterminer la probabilité de succès.
- Oui, les valeurs possibles de \(X\) sont 0 et 1. Donc elle suit une loi de Bernoulli.
- Probabilité de succès : \(P(X = 1) = 80\pourcent = 0{,}8\).
Proposition — Espérance et variance d’une loi de Bernoulli
Si \(X\) suit la loi de Bernoulli de paramètre \(p\), alors : - L'espérance est \(E(X) = p\),
- La variance est \(V(X) = p(1 - p)\),
- L’écart-type est \(\sigma(X) = \sqrt{p(1 - p)}\).
- \(\begin{aligned}[t]E(X)&=0\times P(X=0)+1\times P(X=1)\\&=0\times(1-p)+1\times p\\&=p\end{aligned}\)
- \(\begin{aligned}[t] V(X) &= (0-p)^2(1-p) + (1-p)^2 p \\ &= p^2(1-p) + p(1-p)^2 \\ &= p(1-p) [p + (1-p)] \\ &= p(1-p) \\ \end{aligned} \)
Compétences à pratiquer
- Reconnaître une loi de Bernoulli
- Déterminer une probabilité de succès
- Calculer l'espérance et l'écart-type d'une loi de Bernoulli
- Identifier et définir une épreuve de Bernoulli
III.2
Le schéma de Bernoulli et son arbre
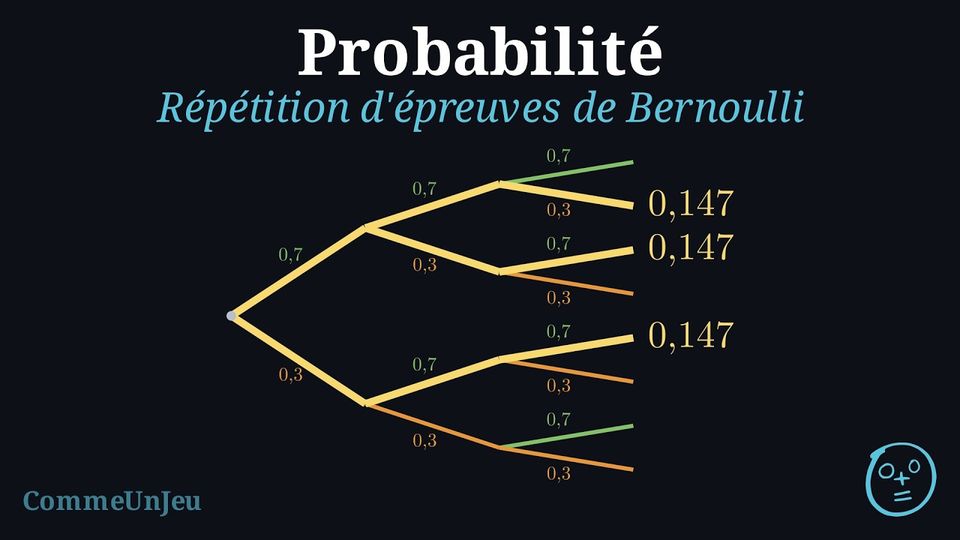
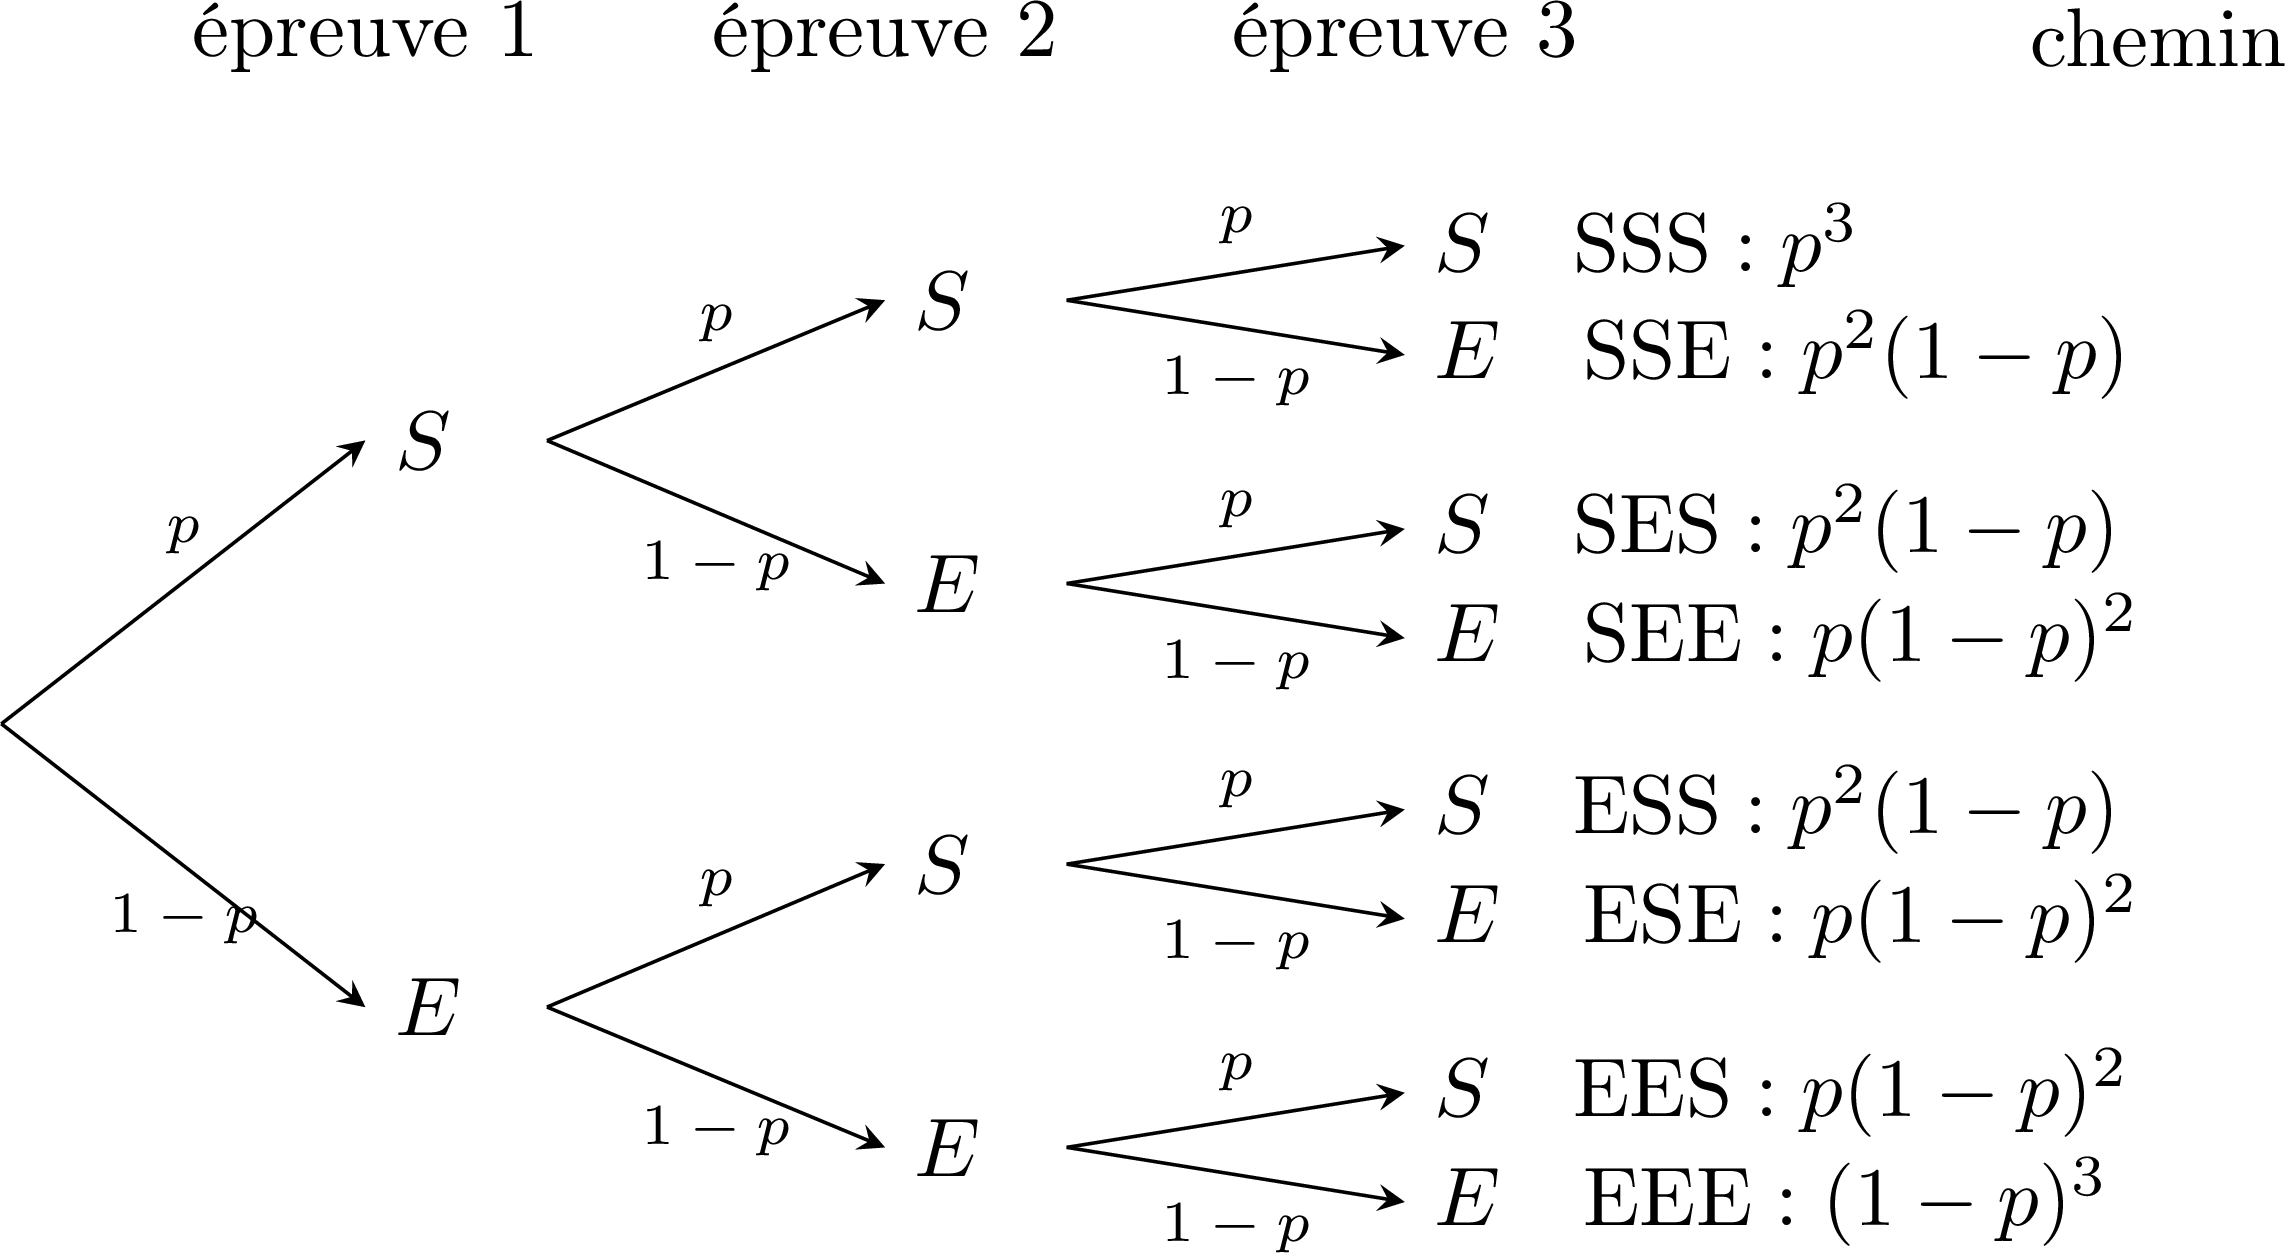
On suppose qu’un joueur de basketball effectue \(n\) lancers francs, et que l’on compte le nombre de tirs réussis. La probabilité de réussir un lancer franc est la même à chaque tentative, et chaque tir est indépendant des autres tirs. C'est un schéma de Bernoulli.
Définition — Schéma de Bernoulli
Un schéma de Bernoulli de paramètres \(n\) et \(p\) est la succession de \(n\) épreuves de Bernoulli identiques (même probabilité de succès \(p\)) et indépendantes : la même épreuve répétée \(n\) fois, sans qu'aucune influence les autres. On le reconnaît à quatre conditions : - un nombre fixé \(n\) d'épreuves ;
- chaque épreuve a deux issues, succès et échec ;
- la probabilité de succès \(p\) est la même à chaque épreuve ;
- les épreuves sont indépendantes.
Compétences à pratiquer
- Modéliser avec un schéma de Bernoulli
IV
Coefficients binomiaux et triangle de Pascal
IV.1
Compter les chemins à \(k\) succès
Compter les chemins à \(k\) succès
Dans l'arbre d'un schéma de Bernoulli de taille \(n\), tous les chemins à \(k\) succès ont la même probabilité \(p^k (1-p)^{n-k}\). Pour trouver \(P(X = k)\), où \(X\) est le nombre de succès, il reste à savoir combien de chemins portent exactement \(k\) succès. Pour \(n = 3\), les huit chemins de l'arbre se répartissent ainsi.
Pour de plus grandes valeurs de \(n\), dessiner l'arbre n'est plus envisageable : les nombres de chemins reçoivent un nom et une façon de les calculer sans aucun arbre.
| nombre de succès \(k\) | \(0\) | \(1\) | \(2\) | \(3\) |
| chemins | EEE | SEE, ESE, EES | SSE, SES, ESS | SSS |
| nombre de chemins | \(1\) | \(3\) | \(3\) | \(1\) |
Définition — Coefficient binomial
Soient \(n\) et \(k\) deux entiers avec \(0 \leq k \leq n\). Le coefficient binomial \(\dbinom{n}{k}\), lu « \(k\) parmi \(n\) », est le nombre de chemins à exactement \(k\) succès dans l'arbre d'un schéma de Bernoulli de taille \(n\) : le nombre de façons de placer \(k\) succès parmi \(n\) épreuves. En particulier \(\dbinom{n}{0} = 1\) (le seul chemin sans succès est \(\text{EE} \dots \text{E}\)) et \(\dbinom{n}{n} = 1\). Exemple
À l'aide du tableau ci-dessus, donner \(\dbinom{3}{1}\) et \(\dbinom{3}{2}\). Puis lister les chemins d'un schéma de taille \(4\) à exactement \(2\) succès et en déduire \(\dbinom{4}{2}\).
D'après le tableau, trois chemins portent un succès et trois en portent deux : \(\dbinom{3}{1} = 3\) et \(\dbinom{3}{2} = 3\). Pour \(n = 4\), un chemin à deux succès s'écrit en choisissant les deux positions de la lettre S parmi quatre : \(\text{SSEE}\), \(\text{SESE}\), \(\text{SEES}\), \(\text{ESSE}\), \(\text{ESES}\), \(\text{EESS}\). Il y en a six, donc \(\dbinom{4}{2} = 6\).
Compétences à pratiquer
- Compter les chemins d'un arbre
IV.2
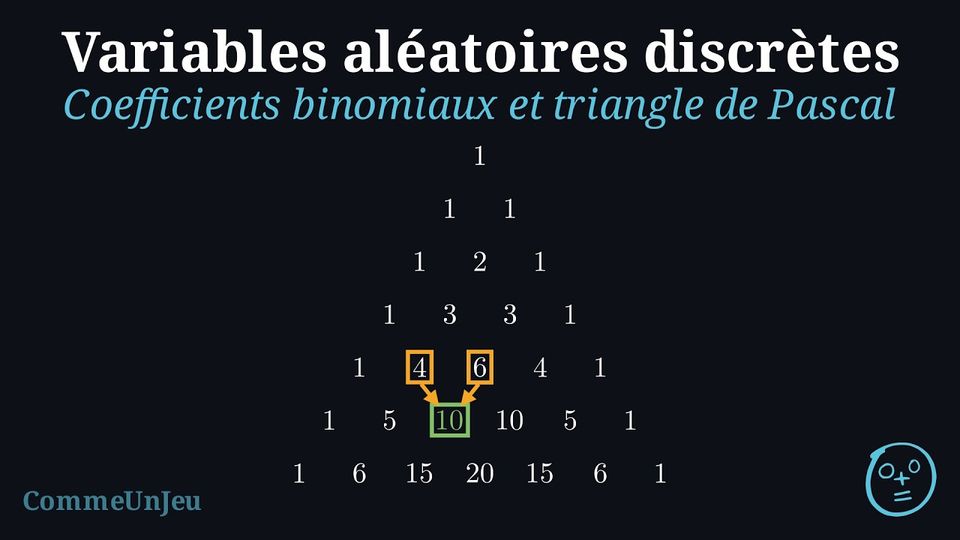
Le triangle de Pascal
Proposition — Symétrie et relation de Pascal
Soit \(n\) un entier avec \(n \geq 1\). - Bords : \(\dbinom{n}{0} = \dbinom{n}{n} = 1\).
- Symétrie : pour \(0 \leq k \leq n\), \(\dbinom{n}{k} = \dbinom{n}{n-k}\).
- Relation de Pascal : pour \(n \geq 2\) et \(1 \leq k \leq n - 1\), $$\binom{n}{k} = \binom{n-1}{k-1} + \binom{n-1}{k}.$$
- Somme des coefficients : $$\binom{n}{0} + \binom{n}{1} + \dots + \binom{n}{n} = 2^n,$$ car l'arbre à \(n\) niveaux a \(2^n\) chemins, chacun compté une fois, dans le terme \(\dbinom{n}{k}\) de son nombre \(k\) de succès.
Pourquoi ces relations sont vraies
Chacune de ces relations a une raison que l'arbre rend visible. Symétrie : échanger les lettres S et E dans un chemin transforme un chemin à \(k\) succès en un chemin à \(n - k\) succès, et réciproquement ; les deux familles ont la même taille. Relation de Pascal : trier les chemins à \(k\) succès d'un schéma de taille \(n\) selon leur dernière épreuve. Si la dernière épreuve est un succès, les \(n - 1\) premières portent \(k - 1\) succès : \(\dbinom{n-1}{k-1}\) chemins. Si c'est un échec, les \(n - 1\) premières portent les \(k\) succès : \(\dbinom{n-1}{k}\) chemins. Additionner les deux familles donne \(\dbinom{n}{k}\).
Méthode — Le triangle de Pascal
La relation de Pascal construit les coefficients binomiaux ligne par ligne, sans aucun arbre : dans le tableau ci-dessous, la ligne \(n\) contient \(\dbinom{n}{0}, \dbinom{n}{1}, \dots, \dbinom{n}{n}\). Chaque ligne commence et finit par \(1\), et toute autre case est la somme de la case juste au-dessus et de la case au-dessus à gauche. Pour lire \(\dbinom{n}{k}\), prendre la ligne \(n\) et la colonne \(k\). | \(n \backslash k\) | \(0\) | \(1\) | \(2\) | \(3\) | \(4\) | \(5\) | \(6\) |
| \(0\) | \(1\) | ||||||
| \(1\) | \(1\) | \(1\) | |||||
| \(2\) | \(1\) | \(2\) | \(1\) | ||||
| \(3\) | \(1\) | \(3\) | \(3\) | \(1\) | |||
| \(4\) | \(1\) | \(4\) | \(6\) | \(4\) | \(1\) | ||
| \(5\) | \(1\) | \(5\) | \(10\) | \(10\) | \(5\) | \(1\) | |
| \(6\) | \(1\) | \(6\) | \(15\) | \(20\) | \(15\) | \(6\) | \(1\) |
nCr ou fonction comb). Exemple
Lire \(\dbinom{6}{2}\) dans le triangle de Pascal, puis calculer \(\dbinom{7}{3}\) et \(\dbinom{7}{4}\) sans calculatrice.
Ligne \(6\), colonne \(2\) : \(\dbinom{6}{2} = 15\). Par la relation de Pascal, \(\dbinom{7}{3} = \dbinom{6}{2} + \dbinom{6}{3} = 15 + 20 = 35\), et par symétrie \(\dbinom{7}{4} = \dbinom{7}{7-4} = \dbinom{7}{3} = 35\).
Compétences à pratiquer
- Lire et compléter le triangle de Pascal
- Utiliser les bords, la symétrie et la relation de Pascal
V
La loi binomiale
V.1
La loi du nombre de succès
Définition — Loi binomiale
Dans un schéma de Bernoulli de paramètres \(n\) et \(p\), soit \(X\) le nombre de succès. \(X\) prend les valeurs \(0, 1, \dots, n\) ; sa loi de probabilité est appelée loi binomiale de paramètres \(n\) et \(p\), notée \(\mathcal{B}(n\,;\,p)\), et on écrit \(X \sim \mathcal{B}(n\,;\,p)\). Proposition — Probabilité de \(k\) succès
Soit \(X \sim \mathcal{B}(n\,;\,p)\). La loi de probabilité de \(X\) est : 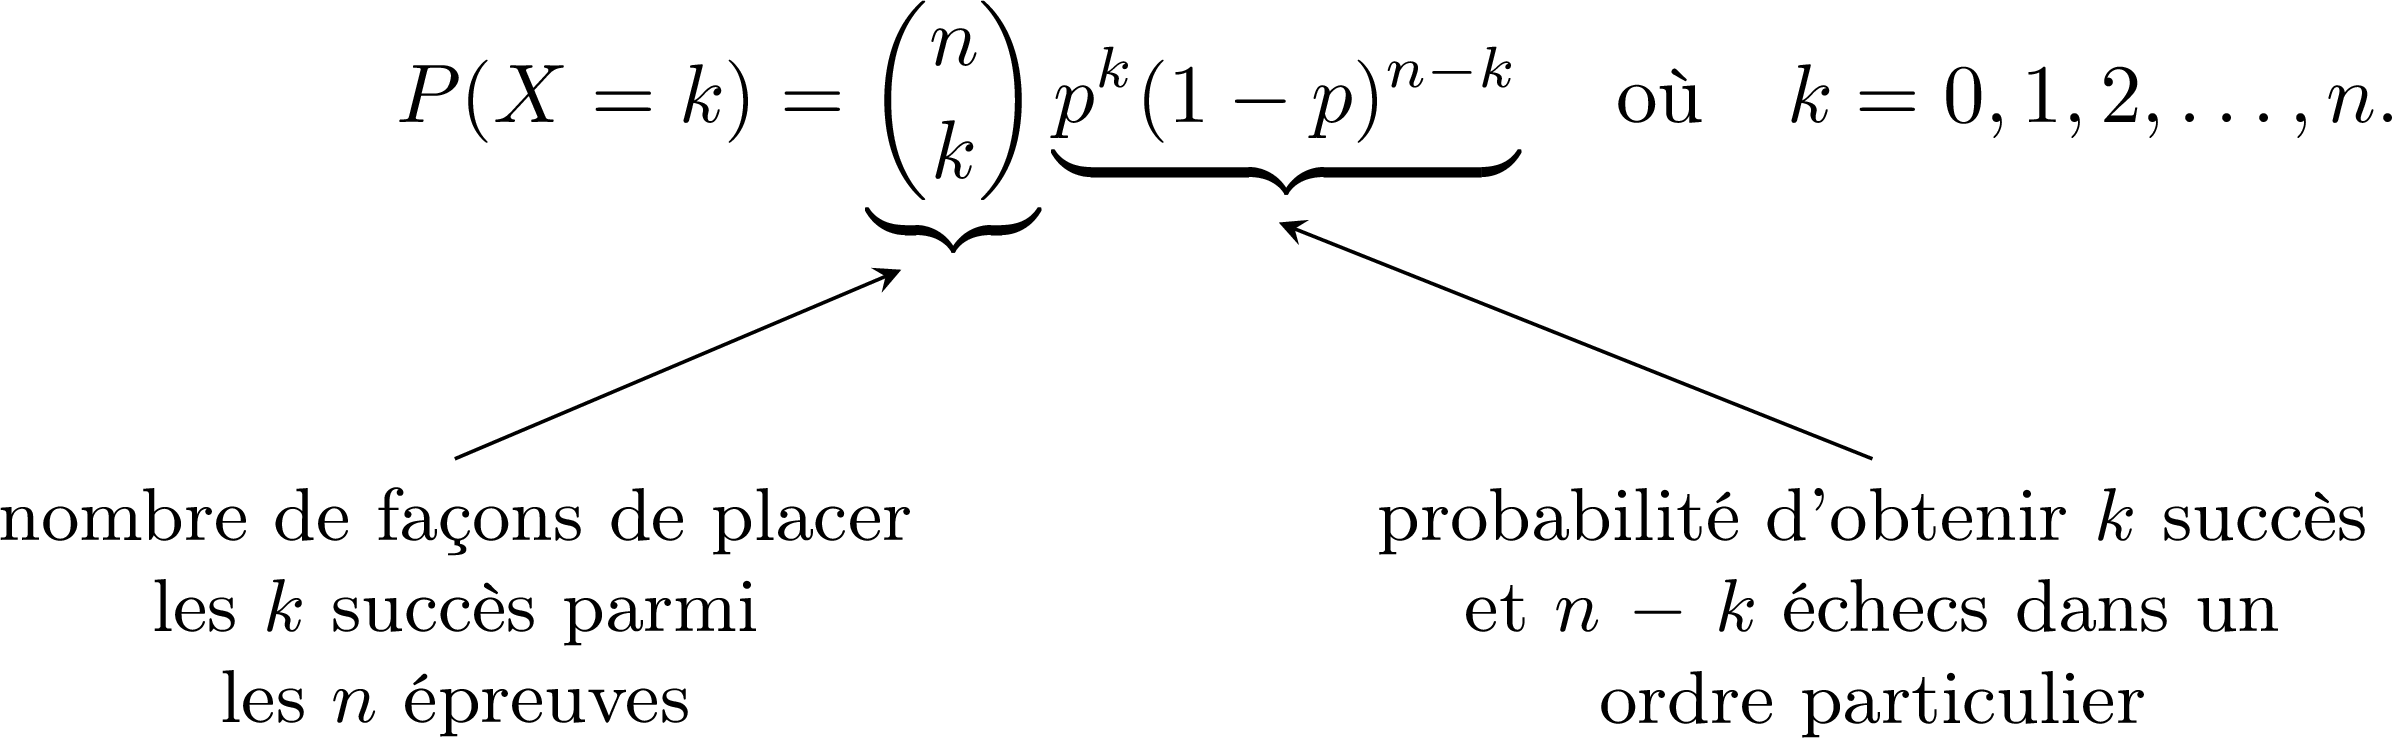
Exemple
Un joueur de basketball a 80\(\pourcent\) de chances de réussir un lancer franc et effectue 5 tirs, supposés indépendants les uns des autres. Soit \(X\) le nombre de tirs réussis. - \(X\) suit-elle une loi binomiale ?
- Déterminer la probabilité de réussir 4 tirs.
- Oui, \(X\) suit une loi binomiale car elle compte le nombre de succès (tirs réussis) dans 5 épreuves indépendantes (lancers francs), chacune avec la même probabilité de succès \(0{,}8\).
- Comme \(X \sim \mathcal{B}(5 ; 0{,}8)\), $$ \begin{aligned} P(X = 4) &= \binom{5}{4} (0{,}8)^4 (1-0{,}8)^1 \\ &= 5 \times 0{,}4096 \times 0{,}2 \\ &= 0{,}4096 \end{aligned} $$ La probabilité de réussir 4 tirs sur 5 est \(0{,}4096=40{,}96\pourcent\).
Compétences à pratiquer
- Reconnaître une loi binomiale
- Calculer une probabilité avec la loi binomiale
- Modéliser et calculer avec la loi binomiale
V.2
Espérance, écart-type et diagramme en bâtons
Proposition — Espérance et variance d'une loi binomiale
Pour \(X \sim \mathcal{B}(n ; p)\) : - \(E(X) = n p\) (espérance),
- \(V(X) = n p (1 - p)\) (variance),
- \(\sigma(X) = \sqrt{n p (1 - p)}\) (écart-type).
Exemple
Un joueur de basketball a 80\(\pourcent\) de chances de réussir un lancer franc et effectue 5 tirs, supposés indépendants les uns des autres. Déterminer l'espérance et l'écart-type du nombre de tirs réussis.
Soit \(X\) le nombre de tirs réussis. Les tirs étant indépendants, de même probabilité de succès \(0{,}8\), on a \(X \sim \mathcal{B}(5 ; 0{,}8)\).$$\begin{aligned}E(X) &= 5 \times 0{,}8 = 4, \\
V(X) &= 5 \times 0{,}8 \times (1 - 0{,}8) = 5 \times 0{,}8 \times 0{,}2 = 0{,}8, \\
\sigma(X) &= \sqrt{0{,}8} \approx 0{,}89.\end{aligned}$$ L'espérance est de 4 tirs réussis, l'écart-type d'environ \(0{,}89\).
Le diagramme en bâtons d'une loi binomiale
Le diagramme en bâtons de \(X \sim \mathcal{B}(n ; p)\) représente les probabilités \(P(X = k)\) pour \(k = 0, 1, \dots, n\). Son bâton le plus haut se trouve près de l'espérance \(E(X) = np\). Quand \(np\) et \(n(1-p)\) ne sont pas trop petits, le diagramme a une forme de cloche approximativement centrée sur \(np\) : les bâtons montent, culminent près de \(np\), puis redescendent de façon à peu près symétrique. Quand \(np\) (ou \(n(1-p)\)) est petit, ce qui arrive pour un \(n\) donné quand \(p\) est proche de \(0\) (ou de \(1\)), le diagramme perd sa symétrie : il est plaqué contre le bord, ses bâtons les plus hauts sont tout au début (ou tout à la fin) et il retombe vite d'un seul côté. Ci-dessous, \(\mathcal{B}(20 ; 0{,}6)\) avec \(E(X) = 12\), puis \(\mathcal{B}(20 ; 0{,}05)\) avec \(E(X) = 1\). 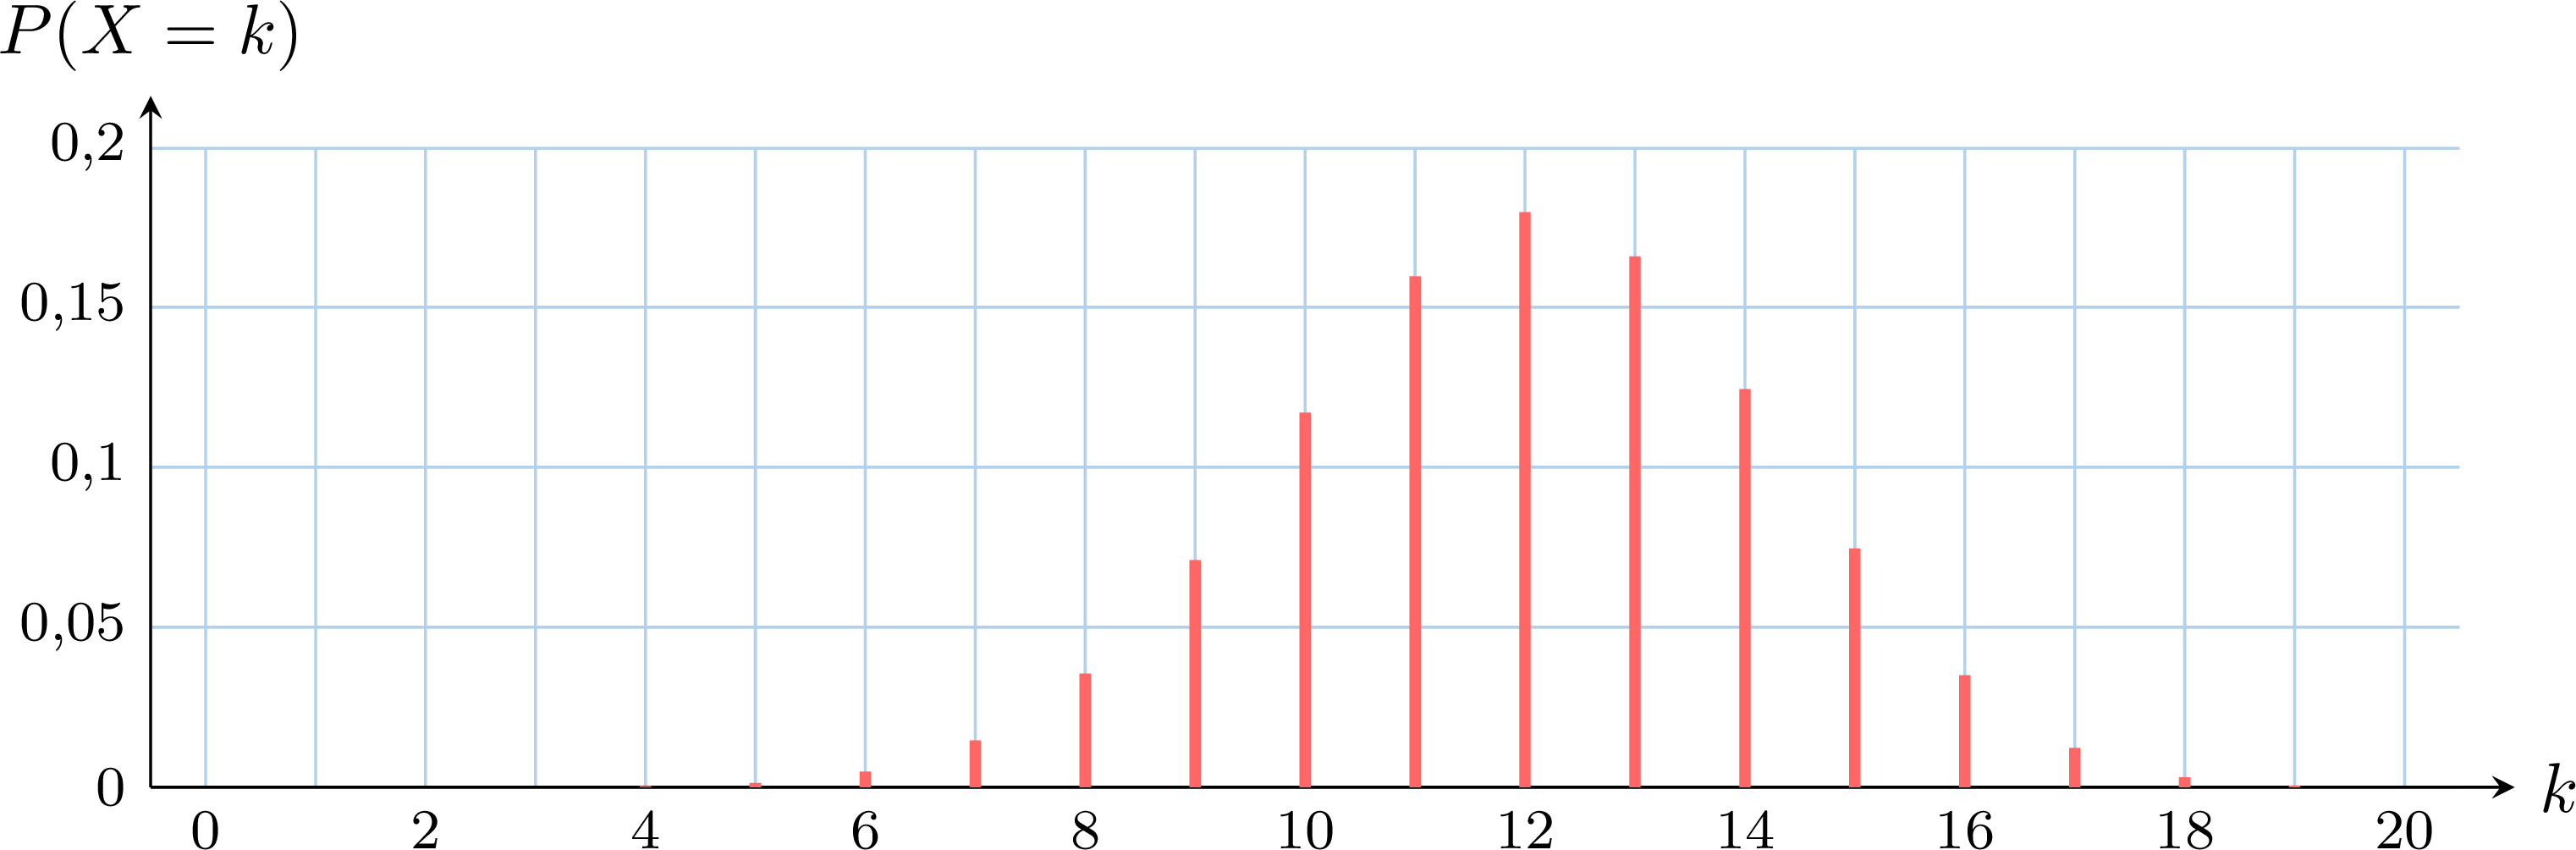
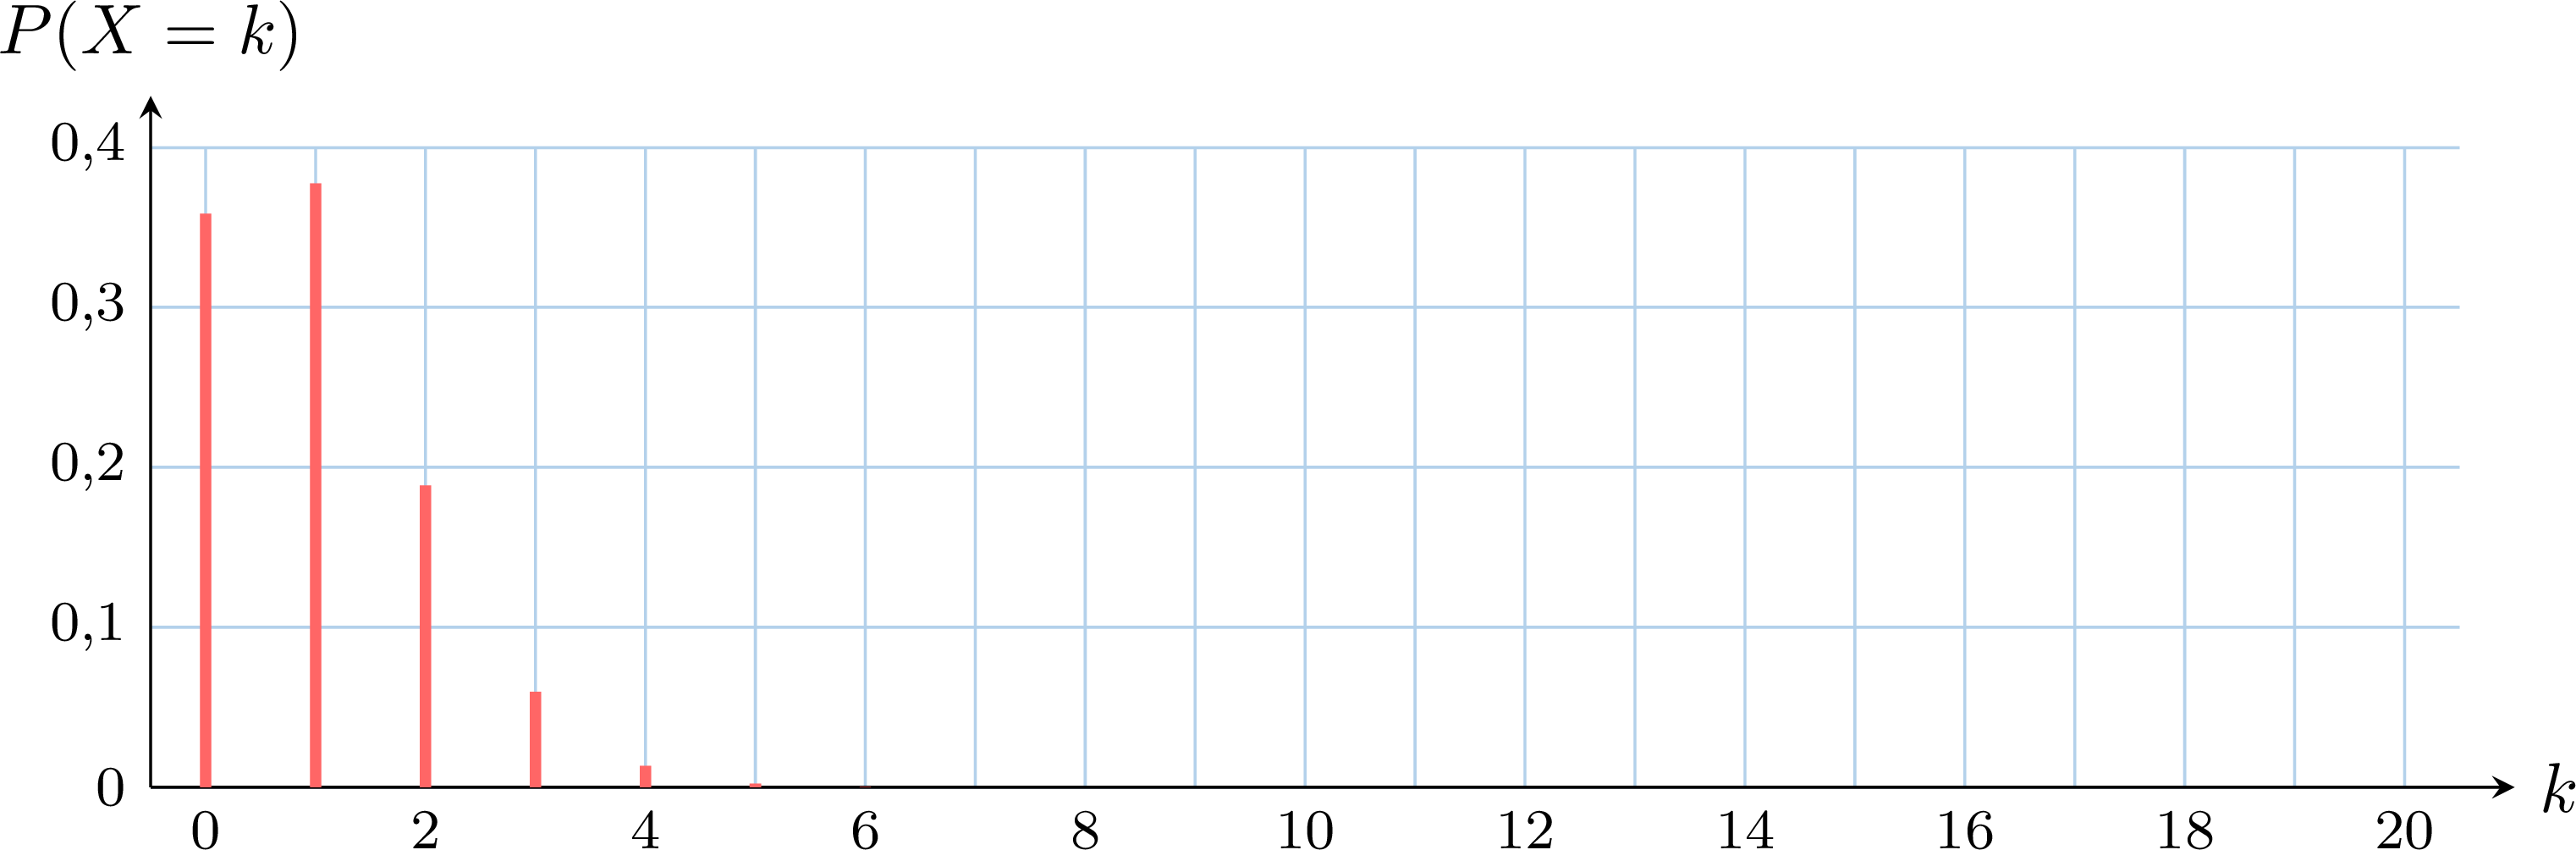
Lire un diagramme en bâtons dans l'autre sens renseigne sur les paramètres : l'abscisse du bâton le plus haut est proche de \(np\), elle donne donc une estimation de \(n\) quand \(p\) est connu, ou de \(p\) quand \(n\) est connu.
Compétences à pratiquer
- Calculer une espérance
- Calculer la variance d'une loi binomiale
- Retrouver et vérifier l'espérance d'une loi binomiale
VI
Calculer avec la loi binomiale
VI.1
Probabilités cumulées et algorithme
Méthode — Probabilités binomiales cumulées
Pour calculer des probabilités binomiales, on utilise une calculatrice graphique : sa fonction de probabilité donne \(P(X = k)\), et sa fonction de probabilité cumulée (ou fonction de répartition) donne les probabilités de la forme \(P(X \leq k)\). - Sur TI : Utiliser
binomFdp(n, p, k)pour \(P(X = k)\) etbinomfrép(n, p, k)pour \(P(X \leq k)\). - Sur Casio : Utiliser
BinomialPD(k, n, p)etBinomialCD(k, n, p). - Sur NumWorks : Application
Probabilités, choisirBinomiale.
- \(P(X < k) = P(X \leq k-1)\)
- \(P(X \geq k) = 1 - P(X \leq k-1)\)
- \(P(X > k) = 1 - P(X \leq k)\)
- \(P(a \leq X \leq b) = P(X \leq b) - P(X \leq a-1)\)
Exemple
On considère une variable aléatoire \(X\) qui suit la loi binomiale de paramètres \(n = 100\) et \(p = 0{,}78\). Calculer les probabilités suivantes. Arrondir les résultats au millième. $$P(X < 75), P(X > 79), P(X \geq 74), P(73 < X \leq 81)$$
Avec \(X \sim \mathcal{B}(100 ; 0{,}78)\), on utilise la fonction de répartition de la calculatrice :
- \(P(X<75) = P(X\leq 74) \approx \mathbf{0{,}197}\).
- \(P(X>79) = 1 - P(X\leq 79) \approx \mathbf{0{,}366}\).
- \(P(X\geq 74) = 1 - P(X\leq 73) \approx \mathbf{0{,}861}\).
- \(P(73
Méthode — Calculer des probabilités binomiales par un algorithme
La formule \(P(X = k) = \dbinom{n}{k} p^k (1-p)^{n-k}\) tient en une ligne de Python ; la probabilité cumulée \(P(X \leq k)\) est la somme de ces termes pour \(j = 0, \dots, k\) ; et un seuil se trouve par une boucle. La fonction capacity renvoie le plus petit entier \(k\) tel que \(P(X > k) \leq \alpha\) : avec \(n\) réservations, chacune honorée avec la probabilité \(p\) indépendamment, \(k\) places suffisent avec un risque au plus \(\alpha\) de refuser un client. from math import comb
def binomial_pmf(n, p, k):
"""P(X = k) for X ~ B(n, p)"""
return comb(n, k) * p**k * (1 - p)**(n - k)
def binomial_cdf(n, p, k):
"""P(X <= k)"""
return sum(binomial_pmf(n, p, j) for j in range(k + 1))
def capacity(n, p, alpha):
"""smallest k such that P(X > k) <= alpha"""
k = 0
while 1 - binomial_cdf(n, p, k) > alpha:
k = k + 1
return k
print(binomial_pmf(10, 0.3, 4)) # 0.2001...
print(binomial_cdf(10, 0.3, 4)) # 0.8497...
print(capacity(105, 0.95, 0.05)) # 103Compétences à pratiquer
- Utiliser la calculatrice pour des probabilités binomiales cumulées
- Modéliser des situations réelles avec la loi binomiale
VI.2
Chercher un seuil ou un intervalle
Méthode — Chercher un seuil
Pour déterminer le plus petit entier \(k\) tel que \(P(X \leq k) \geq 1-\alpha\) (où \(\alpha\) est un seuil, par exemple \(0{,}05\)), on utilise la fonction binomiale inverse ou un tableau de valeurs sur la calculatrice. Exemple
Soit \(X \sim \mathcal{B}(50 ; 0{,}4)\). Déterminer le plus petit entier \(k\) tel que \(P(X \leq k) \geq 0{,}95\).
D'après le tableau de valeurs de la calculatrice :
- \(P(X \leq 24) \approx 0{,}9022\)
- \(P(X \leq 25) \approx 0{,}9427\)
- \(P(X \leq 26) \approx 0{,}9686\)
Méthode — Chercher un intervalle de probabilité
Pour chercher un intervalle \(I=[a ; b]\) tel que \(P(X \in I) \geq 1-\alpha\) : - On cherche le plus petit entier \(a\) tel que \(P(X \leq a) > \frac{\alpha}{2}\).
- On cherche le plus petit entier \(b\) tel que \(P(X \leq b) \geq 1 - \frac{\alpha}{2}\).
Exemple
Soit \(X \sim \mathcal{B}(50 ; 0{,}4)\). Déterminer l'intervalle centré \([a ; b]\) tel que \(P(a \leq X \leq b) \geq 0{,}95\).
Ici, \(1-\alpha = 0{,}95\), donc \(\alpha = 0{,}05\) et \(\dfrac{\alpha}{2} = 0{,}025\).
- On cherche \(a\) tel que \(P(X \leq a) > 0{,}025\).
D'après la table : \(P(X \leq 12) \approx 0{,}013\) et \(P(X \leq 13) \approx 0{,}028\). Donc \(\mathbf{a = 13}\). - On cherche \(b\) tel que \(P(X \leq b) \geq 0{,}975\).
D'après la table : \(P(X \leq 26) \approx 0{,}969\) et \(P(X \leq 27) \approx 0{,}984\). Ainsi \(\mathbf{b = 27}\).
Compétences à pratiquer
- Déterminer un seuil
- Déterminer un seuil supérieur ou un intervalle
VII
La loi géométrique
VII.1
Le rang du premier succès
Jusqu'au premier succès
Un schéma de Bernoulli fixe à l'avance le nombre d'épreuves et compte les succès. Beaucoup de situations font l'inverse : la même épreuve de Bernoulli est répétée, de façon indépendante, jusqu'au premier succès, et ce que l'on compte est le nombre d'épreuves que cela demande. Un joueur lance un dé jusqu'au premier six ; une machine teste des pièces jusqu'à la première défectueuse. La variable aléatoire « rang du premier succès » peut prendre toute valeur \(k = 1, 2, 3, \dots\) : contrairement aux variables aléatoires rencontrées jusqu'ici, elle a une infinité de valeurs possibles. Pourtant le premier succès arrive avec la probabilité \(1\) : la probabilité de \(k\) échecs d'affilée est \((1-p)^k\), suite géométrique de raison \(1 - p\) dans \(\left]0 ; 1\right[\), qui tend vers \(0\) quand \(k\) grandit.
Définition — Loi géométrique
Une épreuve de Bernoulli de probabilité de succès \(p\), avec \(0 < p < 1\), est répétée de façon indépendante jusqu'au premier succès. La variable aléatoire \(X\) égale au rang du premier succès (le nombre d'épreuves nécessaires) suit la loi géométrique de paramètre \(p\), notée \(X \sim \mathcal{G}(p)\). L'événement \((X = k)\) est le chemin de l'arbre formé de \(k - 1\) échecs suivis d'un succès. 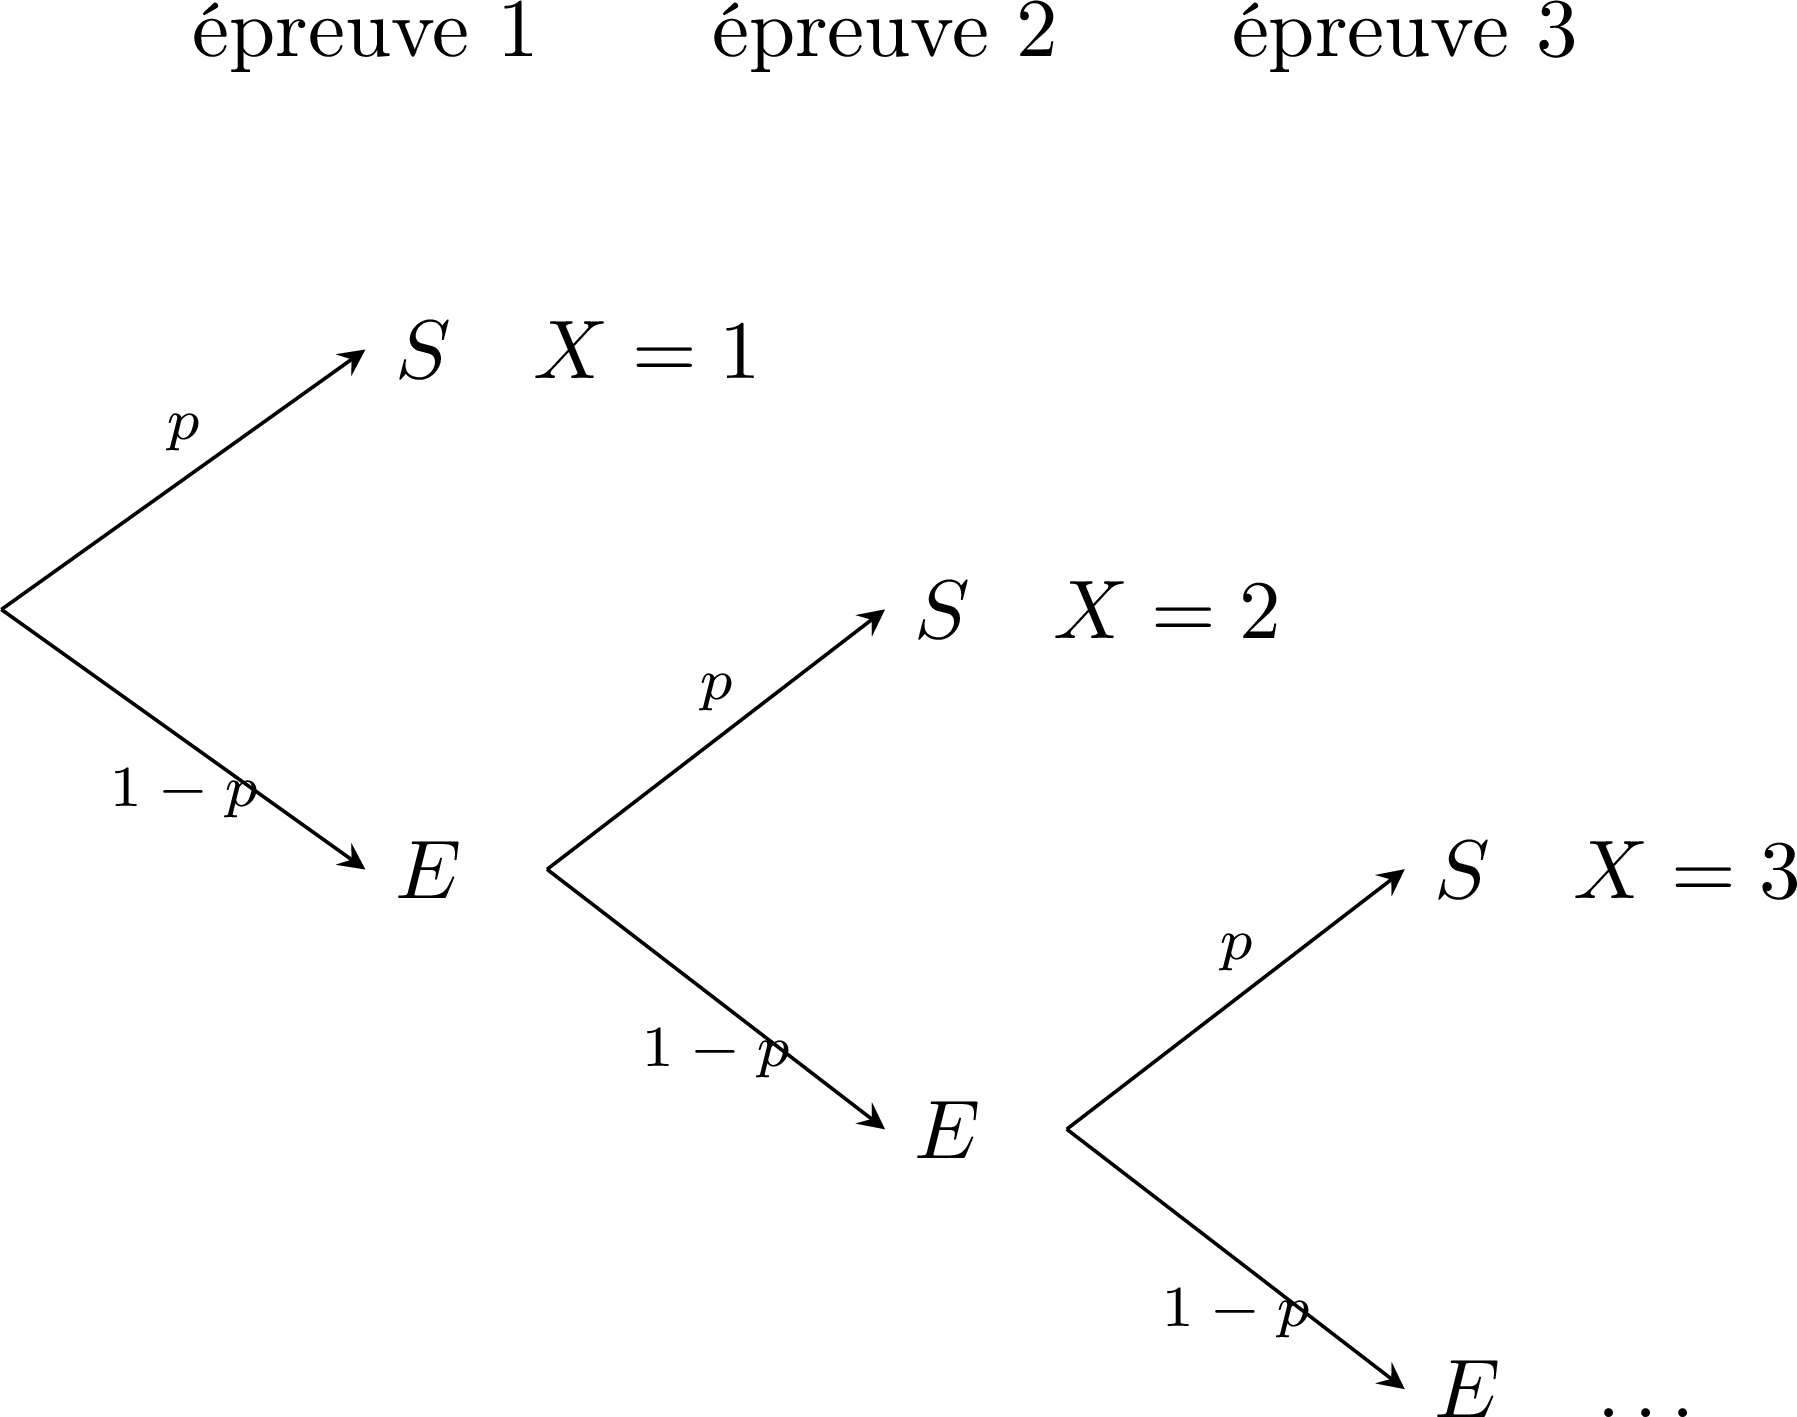
Proposition — Probabilités d'une loi géométrique
Soient \(X \sim \mathcal{G}(p)\) et \(k\) un entier avec \(k \geq 1\). Alors $$P(X = k) = (1-p)^{k-1}\,p, \qquad P(X > k) = (1-p)^k, \qquad P(X \leq k) = 1 - (1-p)^k.$$
Les épreuves sont indépendantes, donc la probabilité d'un chemin est le produit des probabilités de ses branches.
- L'événement \((X = k)\) est l'unique chemin \(\text{E} \dots \text{E}\,\text{S}\) à \(k - 1\) échecs puis un succès : \(P(X = k) = (1-p)^{k-1} \times p\).
- L'événement \((X > k)\), « aucun succès parmi les \(k\) premières épreuves », est le chemin \(\text{E} \dots \text{E}\) à \(k\) échecs : \(P(X > k) = (1-p)^k\).
- L'événement \((X \leq k)\) est le contraire de \((X > k)\) : \(P(X \leq k) = 1 - (1-p)^k\).
Proposition — Espérance d'une loi géométrique
Si \(X \sim \mathcal{G}(p)\), alors \(E(X) = \dfrac{1}{p}\). Ce résultat est admis. Il se lit comme une moyenne : sur un grand nombre de répétitions de l'expérience, le premier succès arrive en moyenne au bout de \(\dfrac{1}{p}\) épreuves. Exemple
Une archère atteint le centre de la cible avec la probabilité \(0{,}3\) à chaque flèche, indépendamment des flèches précédentes. Elle tire jusqu'à atteindre le centre ; soit \(X\) le nombre de flèches nécessaires. - Donner la loi de \(X\).
- Calculer la probabilité que la quatrième flèche soit la première à atteindre le centre.
- Calculer la probabilité qu'il lui faille au plus trois flèches.
- Combien de flèches lui faut-il en moyenne ?
- Chaque flèche est une épreuve de Bernoulli de probabilité de succès \(0{,}3\) ; les flèches sont indépendantes et \(X\) est le rang du premier succès : \(X \sim \mathcal{G}(0{,}3)\).
- \(P(X = 4) = 0{,}7^{3} \times 0{,}3 \approx 0{,}103\).
- \(P(X \leq 3) = 1 - 0{,}7^{3} = 1 - 0{,}343 = 0{,}657\).
- \(E(X) = \dfrac{1}{0{,}3} \approx 3{,}33\) : en moyenne, un peu plus de trois flèches.
Compétences à pratiquer
- Reconnaître une loi géométrique
- Calculer avec la loi géométrique
- Modéliser avec la loi géométrique
VII.2
Diagramme en bâtons et absence de mémoire
Proposition — Le diagramme en bâtons d'une loi géométrique
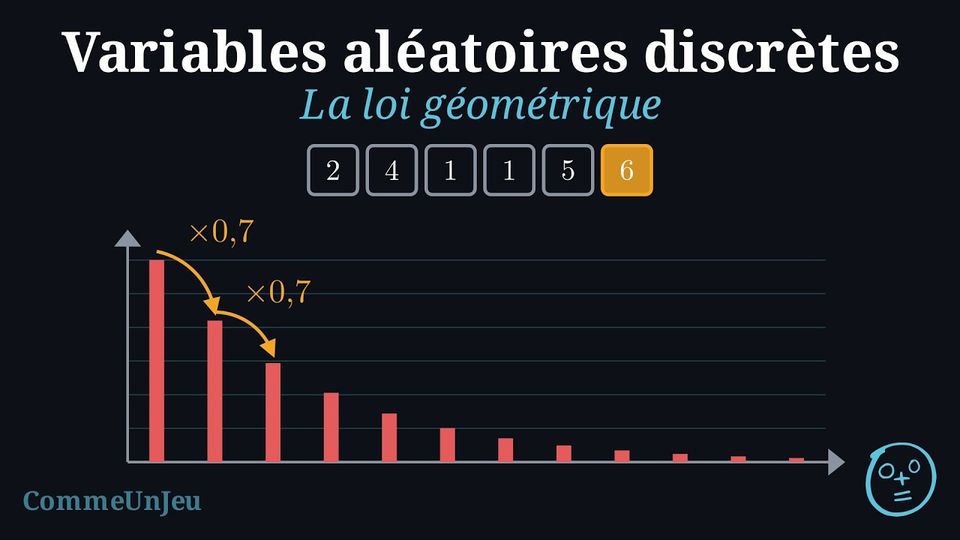
Si \(X \sim \mathcal{G}(p)\), le diagramme en bâtons de \(X\) décroît géométriquement : le premier bâton a pour hauteur \(P(X = 1) = p\), et chaque bâton s'obtient du précédent en multipliant par \(1 - p\). Ci-dessous, le diagramme de \(\mathcal{G}(0{,}3)\). 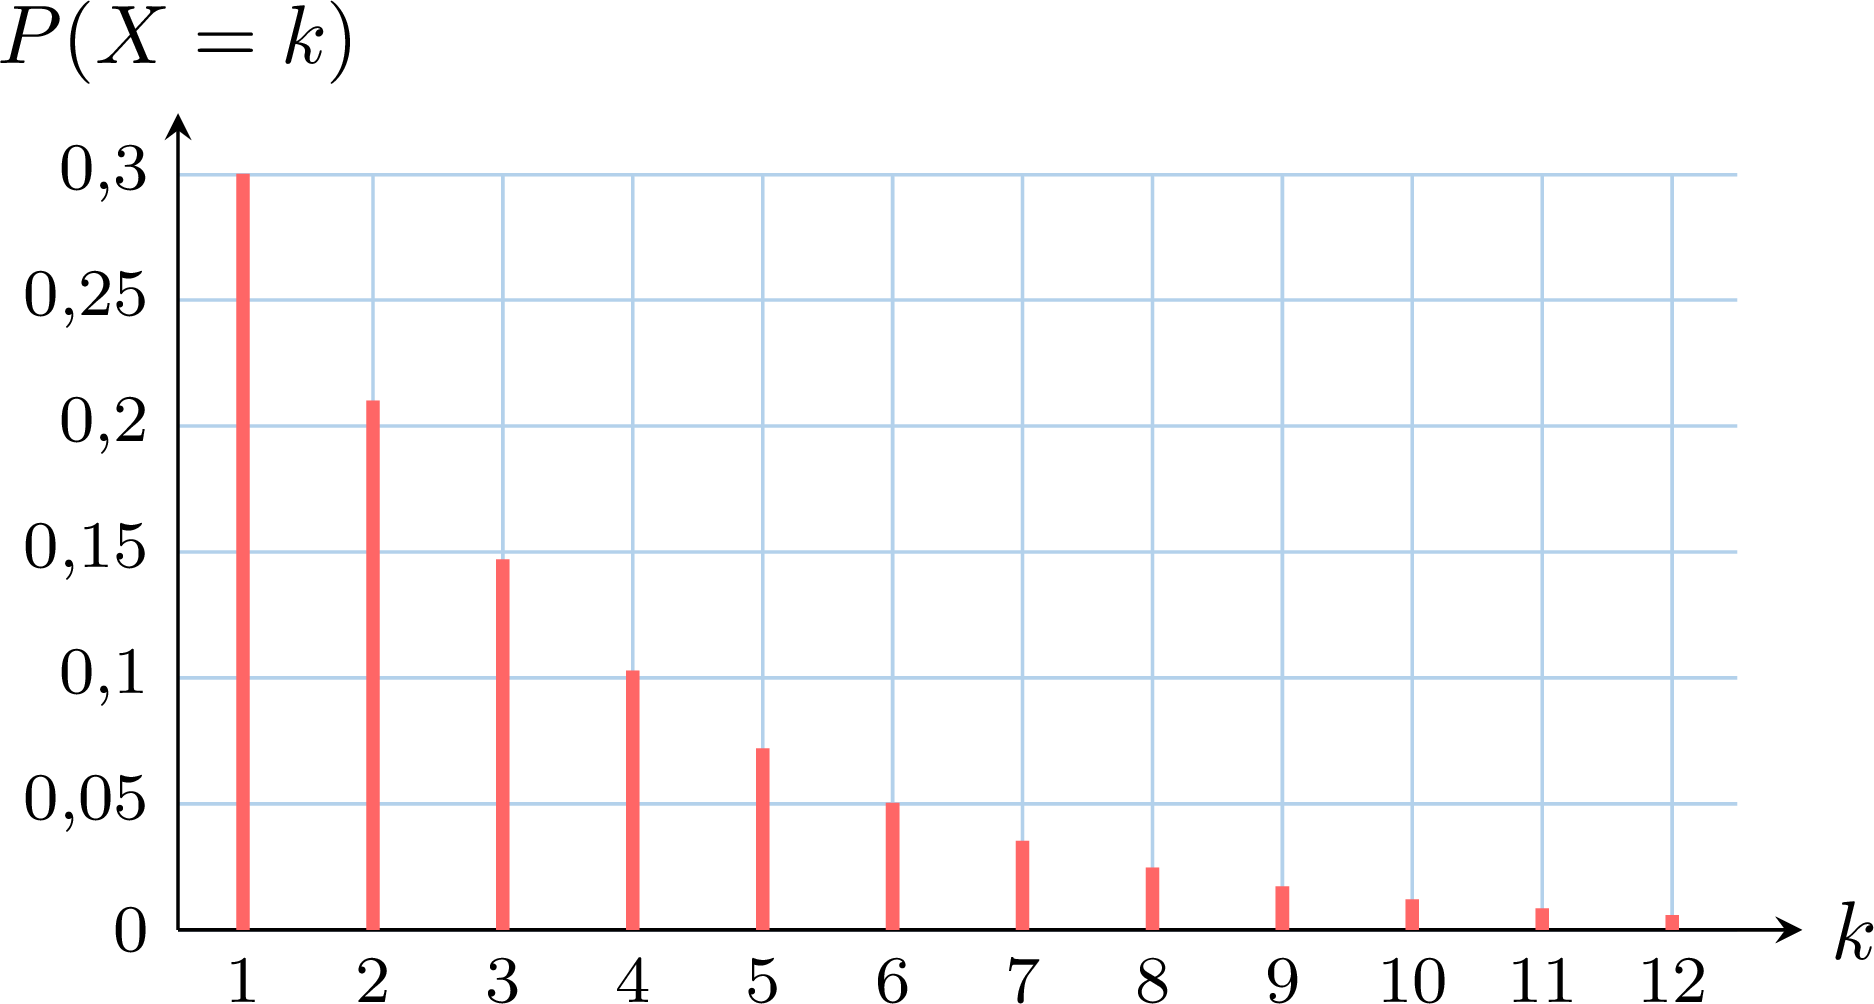
Proposition — Absence de mémoire
Soit \(X \sim \mathcal{G}(p)\). Pour tous entiers \(s \geq 0\) et \(t \geq 0\), $$\PCondFr{X > s + t}{X > s} = P(X > t).$$ Sachant que les \(s\) premières épreuves ont échoué, la probabilité d'attendre plus de \(t\) épreuves supplémentaires est la même qu'au départ : les échecs passés sont oubliés.
Comme \(s + t \geq s\), l'événement \((X > s + t)\) est inclus dans \((X > s)\), donc \((X > s + t) \cap (X > s) = (X > s + t)\). Comme \(P(X > s) = (1-p)^s > 0\), la probabilité conditionnelle est définie et $$\begin{aligned}[t] \PCondFr{X > s + t}{X > s} &= \frac{P\bigl((X > s + t) \cap (X > s)\bigr)}{P(X > s)} && \text{(définition d'une probabilité conditionnelle)}\\
&= \frac{P(X > s + t)}{P(X > s)} = \frac{(1-p)^{s+t}}{(1-p)^{s}} && \text{(formule de \(P(X > k)\))}\\
&= (1-p)^{t} = P(X > t). \end{aligned}$$
Une propriété caractéristique
L'absence de mémoire est caractéristique de la loi géométrique : réciproquement, si une variable aléatoire \(X\) prend ses valeurs dans \(\{1, 2, 3, \dots\}\), vérifie \(P(X > s) > 0\) pour tout entier \(s \geq 0\) et \(\PCondFr{X > s + t}{X > s} = P(X > t)\) pour tous entiers \(s \geq 0\) et \(t \geq 0\), alors \(X\) suit une loi géométrique, de paramètre \(p = P(X = 1)\). La démonstration de cette réciproque est un problème guidé en fin de chapitre : elle montre que la suite \(u_n = P(X > n)\) est géométrique. En pratique, la propriété donne des probabilités conditionnelles sans aucun calcul conditionnel : écrire l'événement sous la forme \((X > s + t)\) sachant \((X > s)\), puis lire \(t\).
Exemple
Un distributeur rend la pièce avec la probabilité \(0{,}3\) à chaque tentative, indépendamment des tentatives précédentes. Lucas a déjà essayé quatre fois sans succès. Calculer la probabilité qu'il lui faille plus de six tentatives au total.
Soit \(X\) le rang de la première tentative où la pièce est rendue : \(X \sim \mathcal{G}(0{,}3)\). La question demande \(\PCondFr{X > 6}{X > 4}\), c'est-à-dire \(\PCondFr{X > 4 + 2}{X > 4}\) avec \(s = 4\) et \(t = 2\). Par absence de mémoire, $$\PCondFr{X > 6}{X > 4} = P(X > 2) = 0{,}7^{2} = 0{,}49.$$ Les quatre tentatives ratées ne changent rien : la probabilité de deux échecs de plus est la même qu'au départ.
Compétences à pratiquer
- Utiliser l'absence de mémoire
- Comparer des lois discrètes
VIII
Thème : inférence bayésienne
VIII.1
Inverser un conditionnement : la formule de Bayes
Un test de dépistage d’une maladie rare est positif : cela signifie-t-il que l’on est malade ? Le théorème de Bayes permet d’inverser un conditionnement pour répondre à ce type de question : il met à jour une probabilité à la lumière d’une nouvelle information. Il est essentiel en médecine comme en science des données.
Théorème — Théorème de Bayes
$$\PCondFr{E}{F} = \frac{P(E) \PCondFr{F}{E}}{P(F)}, \quad \text{où } P(E) > 0 \text{ et } P(F) > 0.$$ En exprimant \(P(F)\) à l'aide de la formule des probabilités totales, lorsque \(\{E,\overline{E}\}\) forme une partition de l’univers avec \(0 < P(E) < 1\), on peut aussi écrire $$\PCondFr{E}{F} = \frac{P(E)\PCondFr{F}{E}}{P(E)\PCondFr{F}{E} + P(\overline{E})\PCondFr{F}{\overline{E}}}.$$
La formule de la probabilité conjointe donne \(P(E \cap F)\) de deux façons — en partant de \(F\), ou en partant de \(E\). Les deux décrivent le même événement, donc les deux produits sont égaux : $$\begin{aligned}[t] P(F)\,\PCondFr{E}{F} &= P(E \cap F) && \text{(probabilité conjointe, en partant de \(F\))}\\
&= P(E)\,\PCondFr{F}{E} && \text{(probabilité conjointe, en partant de \(E\)).} \end{aligned}$$ En divisant les deux membres par \(P(F)\), non nul par hypothèse, on obtient la première forme : $$\PCondFr{E}{F} = \frac{P(E)\,\PCondFr{F}{E}}{P(F)}.$$ Pour la seconde forme, \(\{E, \overline{E}\}\) est une partition de l'univers : la formule des probabilités totales réécrit le dénominateur. $$\begin{aligned}[t] P(F) &= P(E)\PCondFr{F}{E} + P(\overline{E})\PCondFr{F}{\overline{E}} && \text{(probabilité totale sur \(\{E, \overline{E}\}\)).} \end{aligned}$$ Le théorème de Bayes renverse donc le conditionnement : il transforme ce que l'on sait, \(\PCondFr{F}{E}\), en ce que l'on cherche, \(\PCondFr{E}{F}\) — et le dénominateur est exactement le prix de ce renversement.
Exemple
Une maladie rare touche environ 1 personne sur 1 000. Un test de dépistage de cette maladie a les caractéristiques suivantes : - sensibilité : si une personne est malade, le test est positif dans 99 \(\pourcent\) des cas ;
- spécificité : si une personne n’est pas malade, le test est négatif dans 95 \(\pourcent\) des cas.
On note les événements : 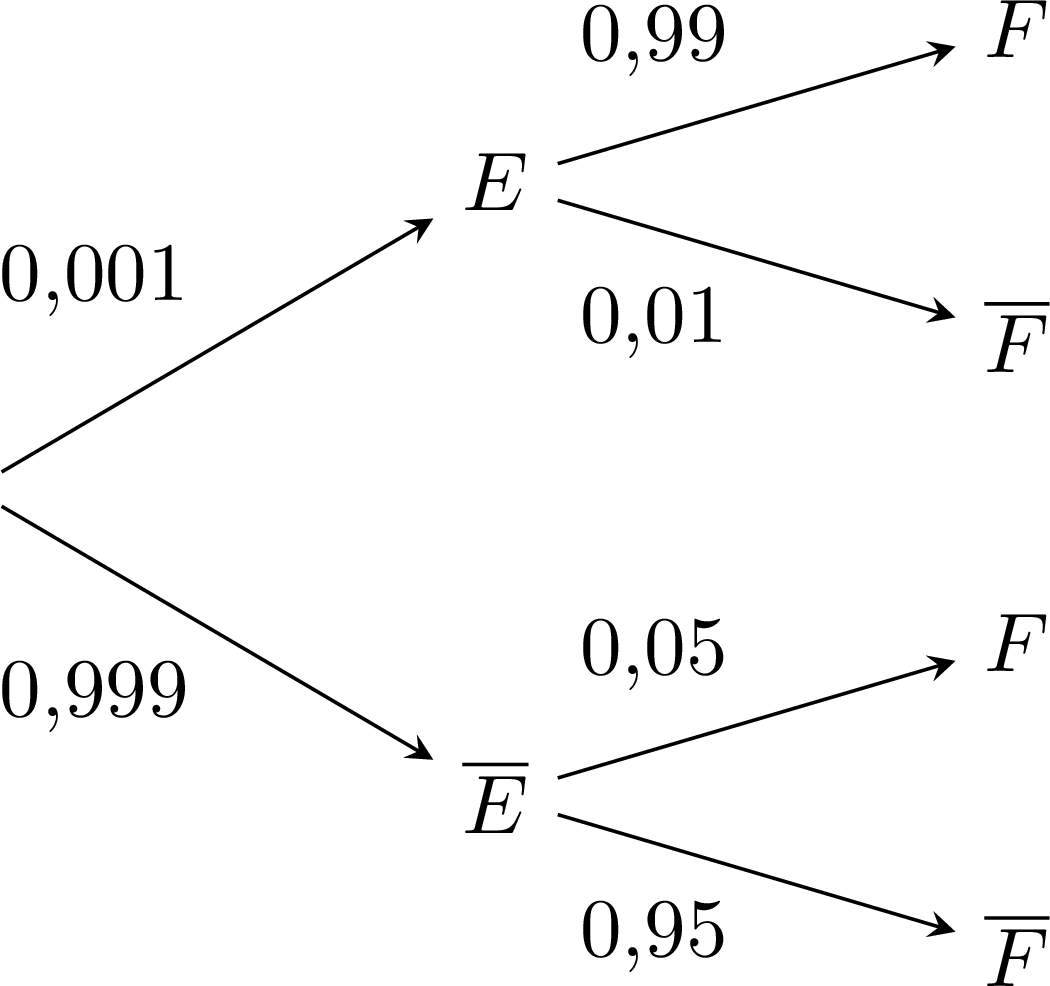
La probabilité recherchée est \(\PCondFr{E}{F}\). En utilisant le théorème de Bayes, on obtient : $$\PCondFr{E}{F} = \frac{P(E) \PCondFr{F}{E}}{P(F)}.$$ On calcule d’abord \(P(F)\) à l’aide de la formule des probabilités totales : $$\begin{aligned} P(F) &= P(E)\PCondFr{F}{E} + P(\overline{E})\PCondFr{F}{\overline{E}} \\
&= (0{,}001 \times 0{,}99) + (0{,}999 \times 0{,}05) \\
&= 0{,}00099 + 0{,}04995 \\
&= 0{,}05094. \end{aligned}$$ Ainsi, la probabilité conditionnelle recherchée est : $$\PCondFr{E}{F} = \frac{0{,}00099}{0{,}05094} \approx 0{,}0194.$$ La probabilité qu’une personne soit réellement malade sachant que son test est positif est donc d’environ \(1{,}94\,\pourcent\). C’est un point important du dépistage des maladies rares : même un test très fiable peut produire une forte proportion de faux positifs parmi les résultats positifs.
- \(E\) : « la personne est malade » ;
- \(F\) : « le test est positif ».
- \(P(E) = \frac{1}{1000} = 0{,}001\), donc \(P(\overline{E}) = 1 - 0{,}001 = 0{,}999\).
- \(\PCondFr{F}{E} = 0{,}99\), donc \(\PCondFr{\overline{F}}{E} = 1 - 0{,}99 = 0{,}01\).
- \(\PCondFr{\overline{F}}{\overline{E}} = 0{,}95\), donc \(\PCondFr{F}{\overline{E}} = 1 - 0{,}95 = 0{,}05\).
Compétences à pratiquer
- Appliquer la formule de Bayes
- Distinguer les deux probabilités conditionnelles
VIII.2
Tests de dépistage : sensibilité, spécificité et valeurs prédictives
Définition — Test de dépistage : sensibilité, spécificité, valeurs prédictives
Un test de dépistage répond par oui ou non à une question sur un individu (la personne est-elle malade ? le bagage contient-il un objet interdit ?) par un résultat qui peut être faux. Soient \(M\) l'événement « l'individu a la caractéristique » et \(T\) l'événement « le test est positif ». Les quatre situations possibles sont nommées : | test positif \(T\) | test négatif \(\overline{T}\) | |
| \(M\) (l'a) | vrai positif | faux négatif |
| \(\overline{M}\) (ne l'a pas) | faux positif | vrai négatif |
- sa sensibilité \(\PCondFr{T}{M}\), probabilité d'un résultat positif pour un individu qui a la caractéristique ;
- sa spécificité \(\PCondFr{\overline{T}}{\overline{M}}\), probabilité d'un résultat négatif pour un individu qui ne l'a pas.
- la valeur prédictive positive \(\PCondFr{M}{T}\), probabilité d'avoir la caractéristique quand le test est positif ;
- la valeur prédictive négative \(\PCondFr{\overline{M}}{\overline{T}}\), probabilité de ne pas l'avoir quand le test est négatif.
De l'a priori à l'a posteriori
Avant le test, pour un individu choisi au hasard dans la population, la probabilité d'avoir la caractéristique est \(P(M)\), la proportion de la population concernée : la probabilité a priori. Une fois le résultat connu, elle est remplacée par la probabilité conditionnelle \(\PCondFr{M}{T}\) si le test est positif, et \(\PCondFr{M}{\overline{T}} = 1 - \PCondFr{\overline{M}}{\overline{T}}\) s'il est négatif : la probabilité a posteriori. La formule de Bayes réalise cette mise à jour : $$\PCondFr{M}{T} = \frac{P(M)\,\PCondFr{T}{M}}{P(M)\,\PCondFr{T}{M} + P(\overline{M})\,\bigl(1 - \PCondFr{\overline{T}}{\overline{M}}\bigr)}.$$ Le numérateur est la branche des vrais positifs, le dénominateur y ajoute la branche des faux positifs. La sensibilité \(\PCondFr{T}{M}\) et la valeur prédictive \(\PCondFr{M}{T}\) ne sont pas égales en général : un test positif pour \(99\pourcent\) des malades peut encore se tromper la plupart du temps quand il est positif, si les malades sont rares. Confondre les deux probabilités conditionnelles est l'erreur classique de ce chapitre.
Exemple
Dans une population, \(2\pourcent\) des personnes portent un virus. Un test de dépistage a une sensibilité de \(0{,}9\) et une spécificité de \(0{,}95\). Une personne est testée au hasard. - Représenter la situation par un arbre pondéré.
- Calculer la valeur prédictive positive du test.
- Calculer sa valeur prédictive négative.
- Commenter.
- Premier niveau : \(M\) avec \(P(M) = 0{,}02\) et \(\overline{M}\) avec \(P(\overline{M}) = 0{,}98\). Second niveau : sous \(M\), \(T\) avec \(0{,}9\) et \(\overline{T}\) avec \(0{,}1\) ; sous \(\overline{M}\), \(\overline{T}\) avec \(0{,}95\) et \(T\) avec \(0{,}05\).
- Les vrais positifs ont la probabilité \(P(M \cap T) = 0{,}02 \times 0{,}9 = 0{,}018\), les faux positifs \(P(\overline{M} \cap T) = 0{,}98 \times 0{,}05 = 0{,}049\), donc \(P(T) = 0{,}067\) et $$\PCondFr{M}{T} = \frac{0{,}018}{0{,}067} \approx 0{,}269.$$
- Les vrais négatifs ont la probabilité \(P(\overline{M} \cap \overline{T}) = 0{,}98 \times 0{,}95 = 0{,}931\), les faux négatifs \(P(M \cap \overline{T}) = 0{,}02 \times 0{,}1 = 0{,}002\), donc \(P(\overline{T}) = 0{,}933\) et $$\PCondFr{\overline{M}}{\overline{T}} = \frac{0{,}931}{0{,}933} \approx 0{,}998.$$
- Un résultat négatif est très fiable. Un résultat positif ne l'est pas : environ \(27\pourcent\) seulement des personnes testées positives portent le virus, parce que les \(5\pourcent\) de faux positifs sont pris sur la grande majorité saine. Un résultat positif appelle un second test, pas un verdict.
Compétences à pratiquer
- Calculer des probabilités a posteriori
IX
Thème : répétition d'expériences et échantillonnage
IX.1
Échantillon et fluctuation d'échantillonnage
Définition — Échantillon aléatoire
Un échantillon aléatoire de taille \(n\) est constitué des résultats de \(n\) répétitions indépendantes de la même expérience aléatoire (par exemple, tirer un individu au hasard dans une grande population, le tirage étant répété dans des conditions identiques). Définition — Fluctuation d'échantillonnage
Dans une population, on note \(p\) la proportion d'individus présentant un certain caractère. Lorsqu'on prélève un échantillon et qu'on observe la fréquence \(f\) d'apparition de ce caractère, on constate que \(f\) varie d'un échantillon à l'autre. Ce phénomène est appelé fluctuation d'échantillonnage. Proposition — Intervalle de fluctuation
On suppose que la proportion réelle d'un caractère dans une population est \(p\), et que l'on prélève au hasard des échantillons de taille \(n\). Alors, dans environ \(95\,\pourcent\) de ces échantillons, la fréquence observée \(f\) appartient à l'intervalle de fluctuation $$ I_n = \left[\, p - \frac{1}{\sqrt{n}}\,;\; p + \frac{1}{\sqrt{n}} \,\right]. $$ On utilise ce résultat sous les conditions de validité usuelles \(n \ge 25\) et \(0{,}2 \le p \le 0{,}8\). L'intervalle est volontairement large : sa couverture dépend de \(p\) et de \(n\), et elle est la plus proche de \(95\,\pourcent\) quand \(p\) est voisin de \(0{,}5\). La demi-largeur \(\dfrac{1}{\sqrt{n}}\) diminue lorsque \(n\) augmente : l'intervalle est donc plus étroit pour les grands échantillons. Méthode — Lire l'intervalle à l'aide d'une simulation
L'intervalle de fluctuation décrit ce que révèle une simulation. Répéter un grand nombre de fois l'expérience « prélever un échantillon de taille \(n\) et relever la fréquence \(f\) ». Environ \(95\,\pourcent\) des fréquences relevées tombent dans \(I_n\), et environ \(5\,\pourcent\) tombent en dehors. Pour décider si une fréquence observée \(f\) est compatible avec un modèle de proportion \(p\) : - calculer l'intervalle \(I_n = \left[\, p - \dfrac{1}{\sqrt{n}}\,;\; p + \dfrac{1}{\sqrt{n}} \,\right]\) ;
- si \(f\) se situe à l'intérieur de \(I_n\), l'observation est compatible avec le modèle (elle fait partie des \(95\,\pourcent\) habituels) ;
- si \(f\) se situe à l'extérieur de \(I_n\), l'observation est un résultat surprenant : une telle valeur est rare sous le modèle, ce qui jette un doute sur la proportion supposée \(p\).
L'image de la fluctuation
Ici, \(25\) échantillons aléatoires de taille \(n = 100\) ont été prélevés dans une population où \(p = 0{,}5\). Chaque point est la fréquence observée dans un échantillon ; la bande est l'intervalle de fluctuation \(\left[\,p - \frac{1}{\sqrt{n}}\,;\; p + \frac{1}{\sqrt{n}}\,\right] = [\,0{,}4\,;\,0{,}6\,]\). 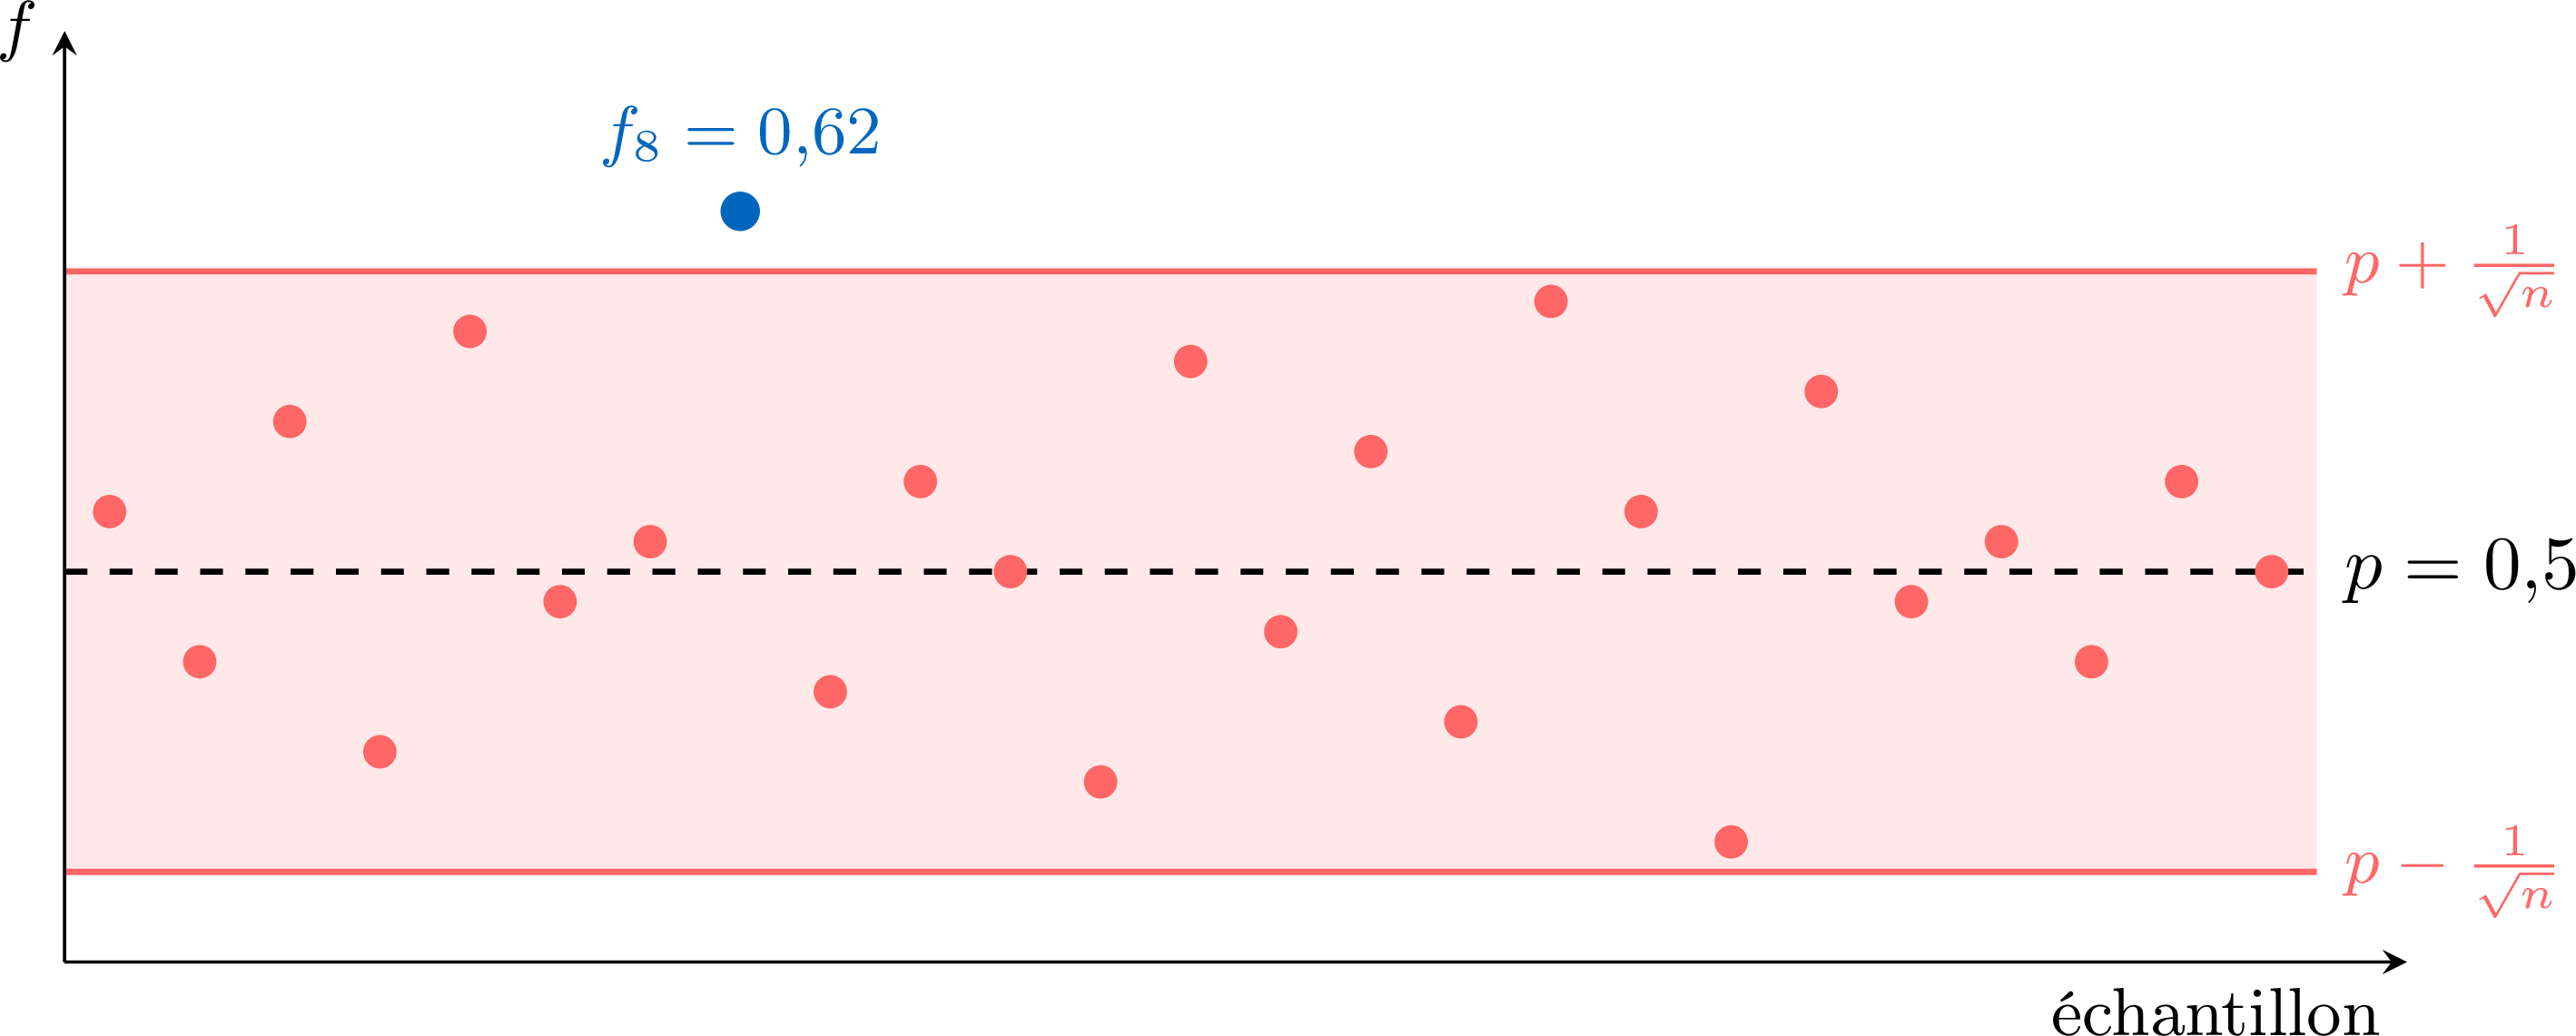
Environ \(95\pourcent\) des échantillons tombent dans la bande — ici \(24\) sur \(25\). Le point qui en sort n'est pas une anomalie : sur \(25\) échantillons, environ une sortie est attendue.
Compétences à pratiquer
- Comprendre la fluctuation d'échantillonnage
IX.2
Loi des grands nombres et estimation
Proposition — Loi des grands nombres
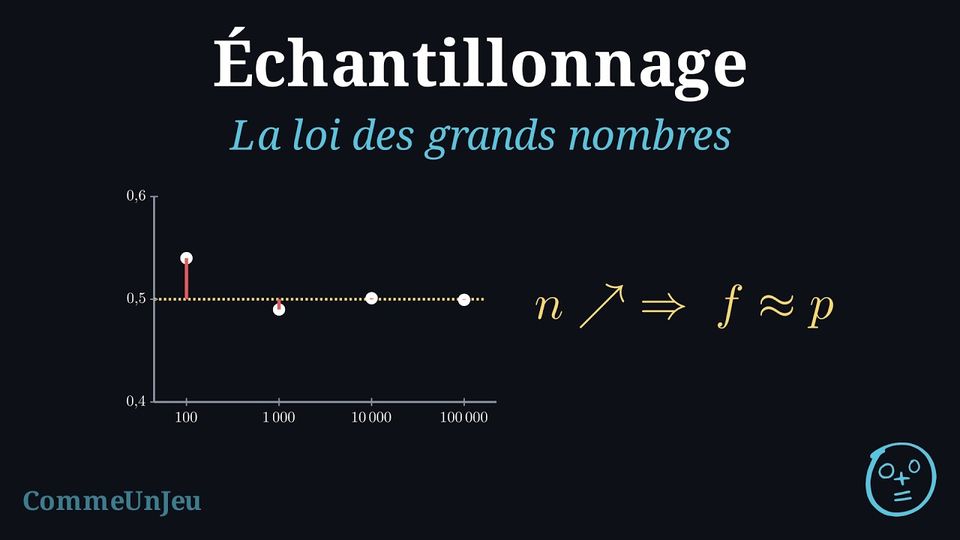
Pour des répétitions indépendantes dans les mêmes conditions, lorsque la taille \(n\) de l'échantillon devient grande, la fréquence observée \(f\) d'un caractère a tendance à se stabiliser autour de la probabilité réelle \(p\) (des fluctuations restent possibles, mais elles diminuent généralement). Lorsqu'un individu est tiré au hasard dans une population, la proportion d'un caractère dans la population est égale à la probabilité de le tirer — estimer l'une, c'est estimer l'autre. 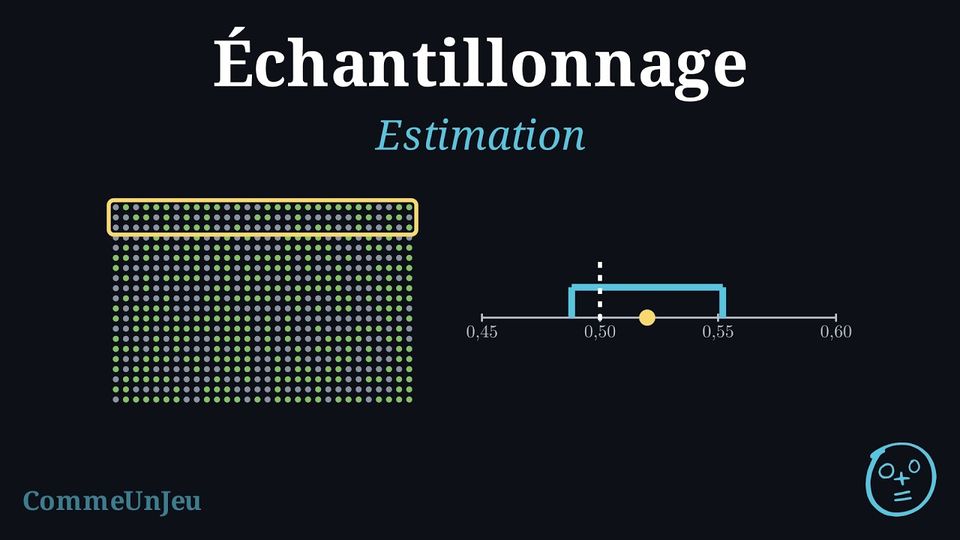
Définition — Estimation
Lorsque la proportion réelle \(p\) d'un caractère est inconnue, on utilise la fréquence \(f\) observée dans un échantillon aléatoire comme une estimation de \(p\). Méthode — Estimer une proportion par une fourchette
Lorsque la proportion réelle \(p\) est inconnue et qu'un échantillon aléatoire de taille \(n\) fournit une fréquence observée \(f\), on estime que la proportion \(p\) se situe dans la fourchette $$ \left[\, f - \frac{1}{\sqrt{n}}\,;\; f + \frac{1}{\sqrt{n}} \,\right]. $$ La demi-largeur \(\dfrac{1}{\sqrt{n}}\) est appelée la marge. Une taille d'échantillon \(n\) plus grande donne une marge plus petite : la fourchette est donc plus étroite et l'estimation de \(p\) est plus précise. Compétences à pratiquer
- Comprendre l'estimation
IX.3
Simuler une loi avec Python
Méthode — Simuler les lois classiques avec \texttt{random()}
La fonction random() du module random renvoie un nombre choisi au hasard dans \([0 ; 1[\), deux intervalles de même longueur étant également probables : la probabilité que le nombre tombe dans un intervalle est la longueur de cet intervalle, donc la probabilité qu'il tombe dans \([0 ; p[\) vaut \(p\). Ce seul outil simule toutes les lois du chapitre. Bernoulli : l'épreuve est un succès quand random() < p. Uniforme sur \(\{1, \dots, n\}\) : randint(1, n), ou 1 + int(n * random()). Binomiale : additionner les résultats de \(n\) épreuves de Bernoulli. Géométrique : répéter l'épreuve jusqu'au premier succès et compter les épreuves. Répéter une simulation un grand nombre de fois et calculer des fréquences donne, avec une grande probabilité, des valeurs proches des probabilités théoriques : c'est la loi des grands nombres à l'œuvre. from random import random, randint
def bernoulli(p):
"""1 with probability p, 0 otherwise"""
if random() < p:
return 1
return 0
def uniform(n):
"""a random integer of {1, ..., n}"""
return randint(1, n)
def binomial(n, p):
"""number of successes in n independent trials"""
return sum(bernoulli(p) for i in range(n))
def geometric(p):
"""rank of the first success"""
k = 1
while random() >= p: # failure: try again
k = k + 1
return k
N = 10000
print(sum(binomial(10, 0.3) == 4 for i in range(N)) / N) # about 0.200
print(sum(geometric(0.3) == 2 for i in range(N)) / N) # about 0.210Compétences à pratiquer
- Lire une simulation
- Simuler et calculer
IX.4
Juger un modèle : test d'une pièce, surréservation et sondage
Exemple
On suppose qu'une pièce est équilibrée, donc la proportion de Pile est \(p = 0{,}5\). On la lance \(n = 100\) fois et on obtient Pile \(62\) fois, soit une fréquence observée \(f = 0{,}62\). Déterminer si cette observation est compatible avec l'hypothèse d'une pièce équilibrée.
Les conditions de validité sont vérifiées : \(n = 100 \ge 25\) et \(0{,}2 \le 0{,}5 \le 0{,}8\). L'intervalle de fluctuation est $$ \begin{aligned} I_n &= \left[\, p - \frac{1}{\sqrt{n}}\,;\; p + \frac{1}{\sqrt{n}} \,\right] &&\text{(intervalle de fluctuation)} \\
&= \left[\, 0{,}5 - \frac{1}{\sqrt{100}}\,;\; 0{,}5 + \frac{1}{\sqrt{100}} \,\right] &&\text{(remplacer \(p=0{,}5\), \(n=100\))} \\
&= \left[\, 0{,}5 - 0{,}1\,;\; 0{,}5 + 0{,}1 \,\right] &&\text{(\(\sqrt{100}=10\), donc \(\tfrac{1}{10}=0{,}1\))} \\
&= \left[\, 0{,}4\,;\; 0{,}6 \,\right]. &&\text{(calculer)} \end{aligned} $$ La fréquence observée \(f = 0{,}62\) est à l'extérieur de \(I_n = [0{,}4\,;\,0{,}6]\), car \(0{,}62 > 0{,}6\). C'est un résultat surprenant sous le modèle de la pièce équilibrée : une telle valeur ne se produirait que pour moins de \(5\,\pourcent\) des échantillons de taille \(100\). L'observation jette un doute sur l'hypothèse \(p = 0{,}5\).
Compétences à pratiquer
- Décider à l'aide d'un modèle
- Estimer une proportion par une fourchette
X
Pour aller plus loin
Compétences à pratiquer
- Problèmes
- Type bac
- Quiz
Contrôle du chapitre
4 exercices, sur 20 points. Durée indicative : 1 h 30.
À traiter sur papier, puis à photographier : la correction est automatique, par IA.
Ce contrôle ne modifie pas la maîtrise du chapitre, quelle que soit la note.
Aucun exercice composé.
Aller à la section