Éducation Nationale Française · Terminale Complémentaire
Statistiques à deux variables
I
Séries statistiques à deux variables
I.1
Données bivariées
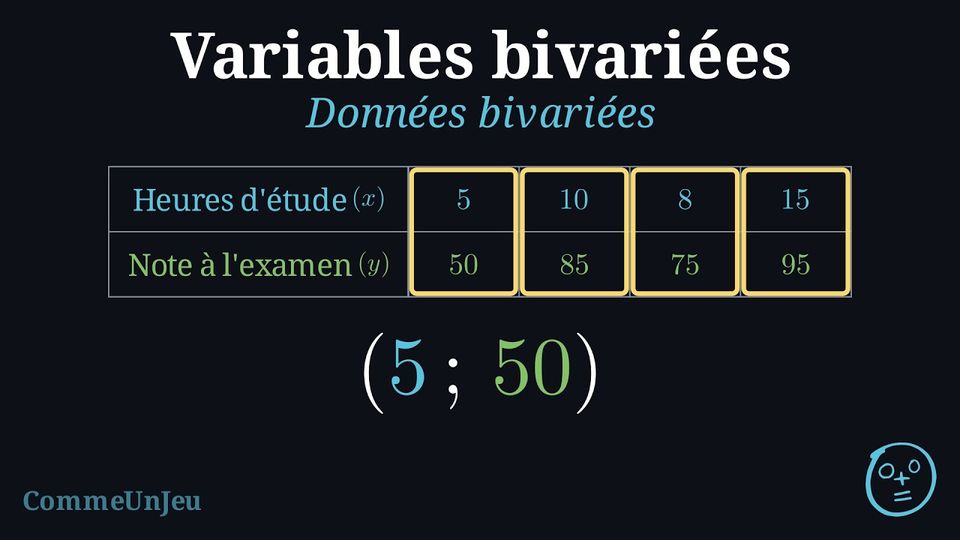
Deux mesures sur les mêmes individus
Au laboratoire de physique, on suspend successivement des masses à un ressort et on mesure chaque fois sa longueur. Chaque essai donne un couple de nombres : la masse \(x\), en grammes, et la longueur \(y\), en centimètres.
Deux variables mesurées sur les mêmes \(n\) individus (ici les \(n = 5\) essais) forment une série statistique à deux variables \((x_i ; y_i)_{1 \leq i \leq n}\), aussi appelée série double ou données bivariées. Chaque couple donne un point \(M_i(x_i ; y_i)\) du nuage de points. Les points du ressort sont presque alignés : ce chapitre cherche la droite qui les ajuste le mieux, mesure la qualité de cet ajustement et se demande ce qu'on peut en prévoir.
| Masse \(x\) (g) | \(50\) | \(100\) | \(150\) | \(200\) | \(250\) |
| Longueur \(y\) (cm) | \(12{,}1\) | \(13{,}9\) | \(16{,}2\) | \(17{,}8\) | \(20{,}0\) |
Définition — Données bivariées
Les données bivariées sont formées de couples de valeurs de deux variables quantitatives, relevées pour chaque individu d'une population. Lorsqu'une variable est étudiée comme explication possible de l'autre, on écrit les couples \((x ; y)\), où : - \(x\) est la variable indépendante (ou variable explicative).
- \(y\) est la variable dépendante (ou variable expliquée).
Compétences à pratiquer
- Identifier la variable explicative et la variable expliquée
I.2
Nuages de points
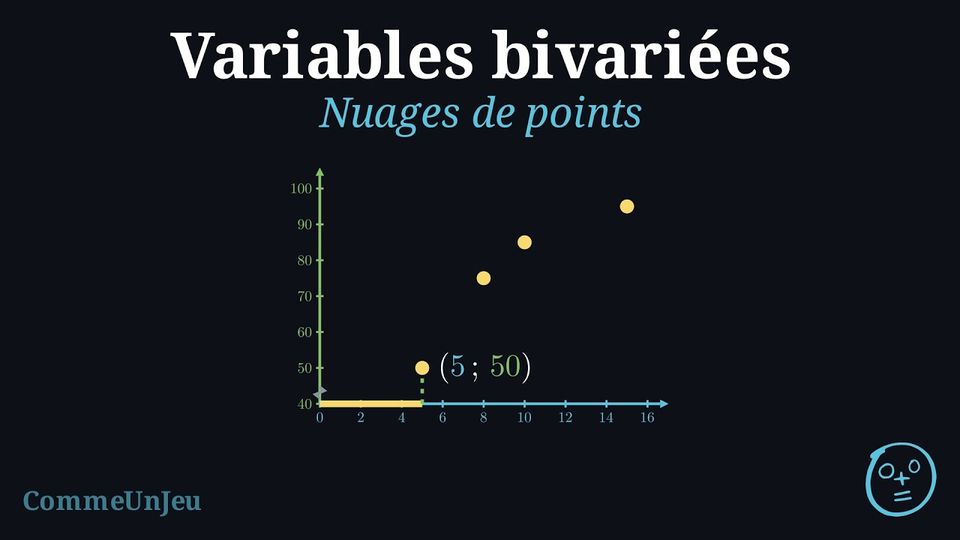
Un nuage de points est le principal outil pour repérer, à l'œil, une relation éventuelle, ou corrélation, entre deux variables quantitatives.
Définition — Nuage de points
Un nuage de points est un graphique qui représente des données bivariées par un ensemble de points dans un repère. La variable indépendante (explicative) est placée sur l'axe horizontal (axe des \(x\)), et la variable dépendante (expliquée) est placée sur l'axe vertical (axe des \(y\)). Méthode — Construire un nuage de points
- Identifier les variables : déterminer quelle variable est indépendante (\(x\)) et laquelle est dépendante (\(y\)).
- Préparer les axes : tracer et légender l'axe horizontal pour la variable \(x\) et l'axe vertical pour la variable \(y\), et choisir sur chaque axe une échelle adaptée à l'étendue des données.
- Placer les points : pour chaque couple \((x ; y)\) de la série, placer le point de coordonnées \((x ; y)\).
Exemple
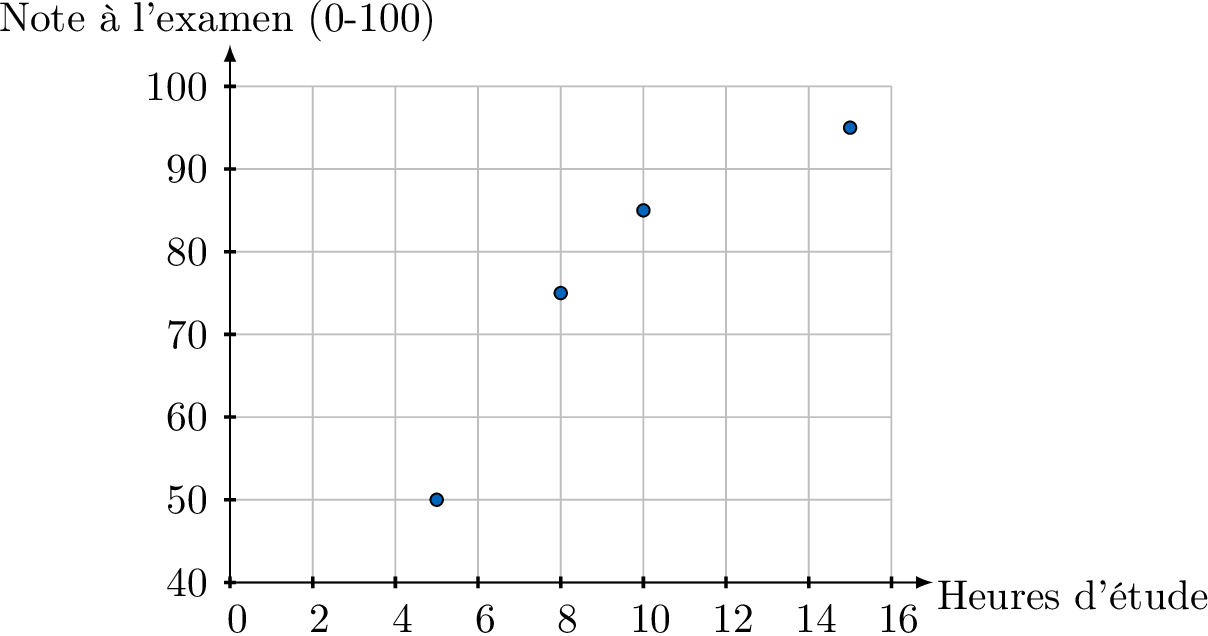
Un enseignant a relevé le nombre d’heures d’étude de ses élèves et leur note à l’examen : | Heures d’étude (\(x\)) | 5 | 10 | 8 | 15 |
| Note à l’examen (\(y\)) | 50 | 85 | 75 | 95 |
- Variables : « Heures d’étude » est la variable indépendante (\(x\)) et « Note à l’examen » est la variable dépendante (\(y\)).
- Axes : l’axe des abscisses porte « Heures d’étude » et l’axe des ordonnées « Note à l’examen » ; les échelles couvrent l’étendue des données.
- Placer les points : on place les quatre couples de coordonnées : \((5 ; 50)\), \((10 ; 85)\), \((8 ; 75)\) et \((15 ; 95)\).
Compétences à pratiquer
- Associer des tableaux de données à des nuages de points
- Tracer des nuages de points
I.3
Le point moyen
Définition — Point moyen
Le point moyen du nuage de points d'une série statistique à deux variables \((x_i ; y_i)_{1 \leq i \leq n}\) est le point \(G(\bar{x} ; \bar{y})\), où $$\bar{x} = \frac{x_1 + x_2 + \dots + x_n}{n} \quad \text{et} \quad \bar{y} = \frac{y_1 + y_2 + \dots + y_n}{n}$$ sont les moyennes des deux variables. Exemple
Pour la série du ressort ci-dessus, calculer les coordonnées du point moyen \(G\), puis placer \(G\) sur le nuage de points.
$$\begin{aligned} \bar{x} &= \frac{50 + 100 + 150 + 200 + 250}{5} = \frac{750}{5} = 150 \\
\bar{y} &= \frac{12{,}1 + 13{,}9 + 16{,}2 + 17{,}8 + 20{,}0}{5} = \frac{80}{5} = 16 \end{aligned}$$ Le point moyen est \(G(150 ; 16)\). Ce n'est aucun des points observés : l'essai à \(150\) g a donné \(16{,}2\) cm. Sur le graphique, l'axe vertical commence à \(10\) pour garder une échelle lisible. 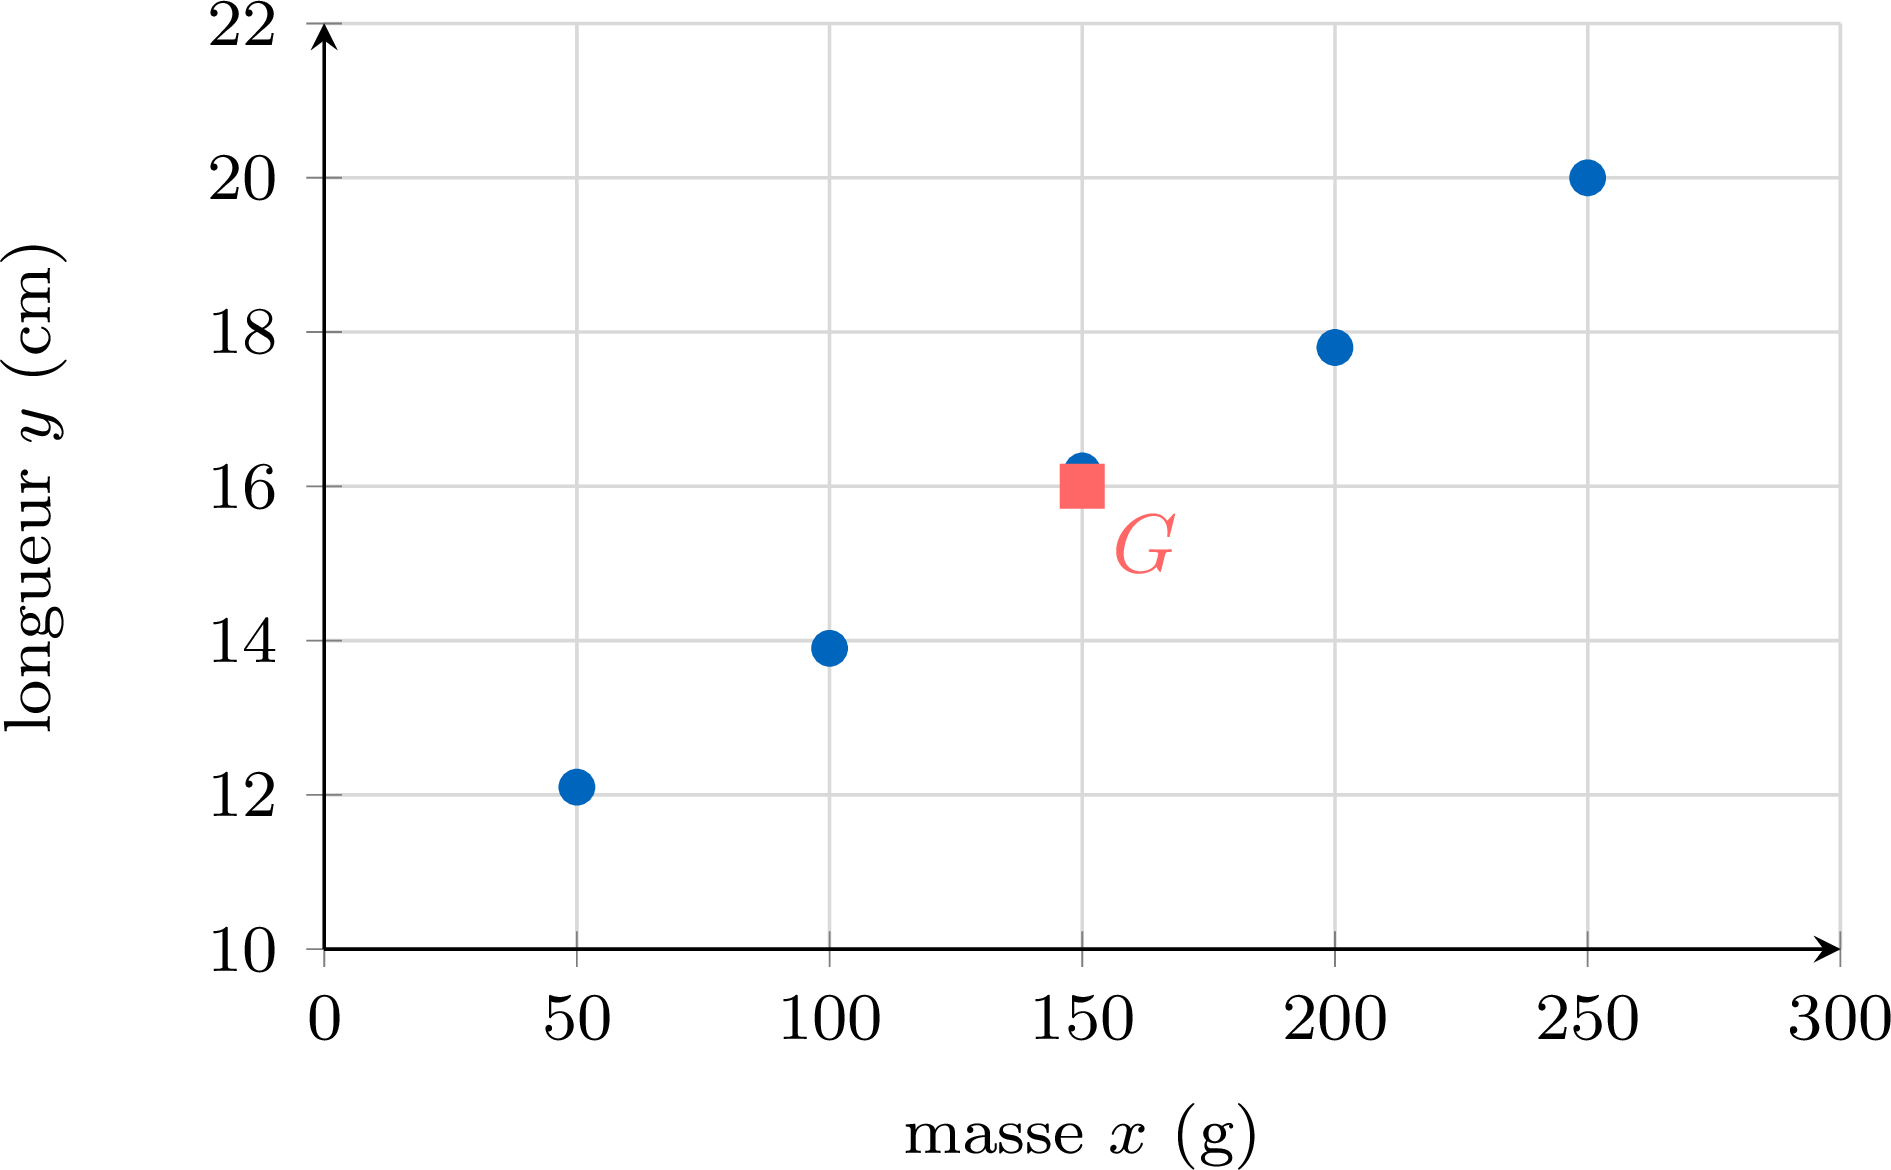
Compétences à pratiquer
- Calculer un point moyen
I.4
Décrire une corrélation
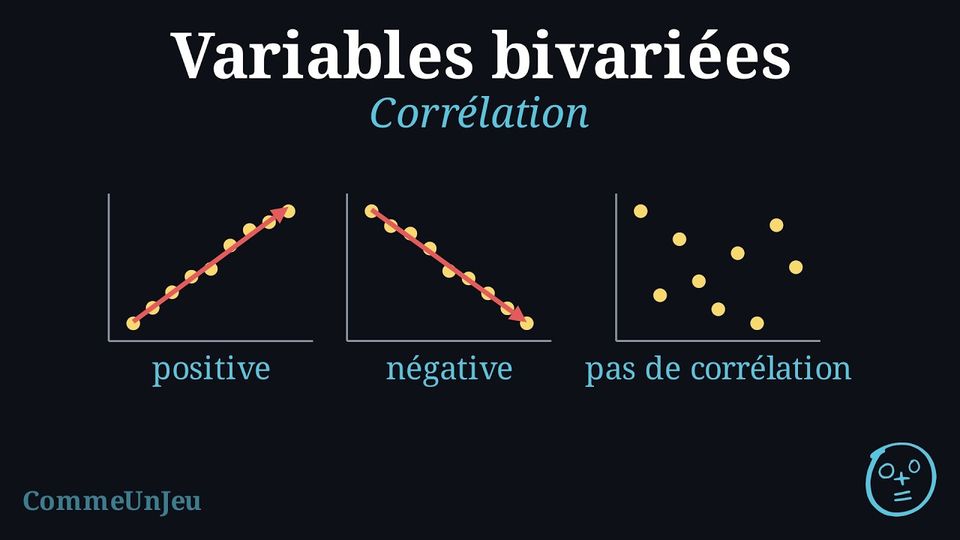
Définition — Corrélation
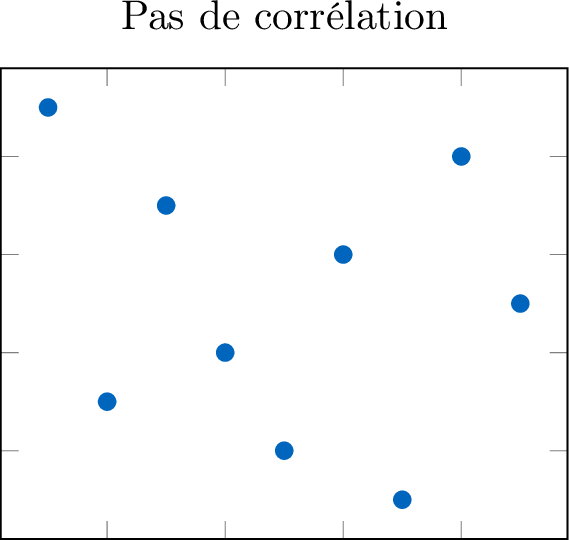
La corrélation décrit la nature de la relation entre deux variables quantitatives. Définition — Sens : corrélation positive ou négative
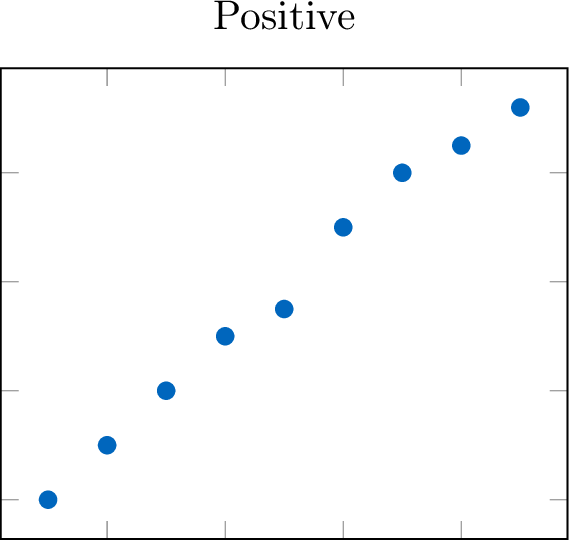
Le sens d'une corrélation décrit la tendance générale des données. - Positive : lorsque la variable indépendante (\(x\)) augmente, la variable dépendante (\(y\)) a tendance à augmenter. Les points suivent une tendance à la hausse.
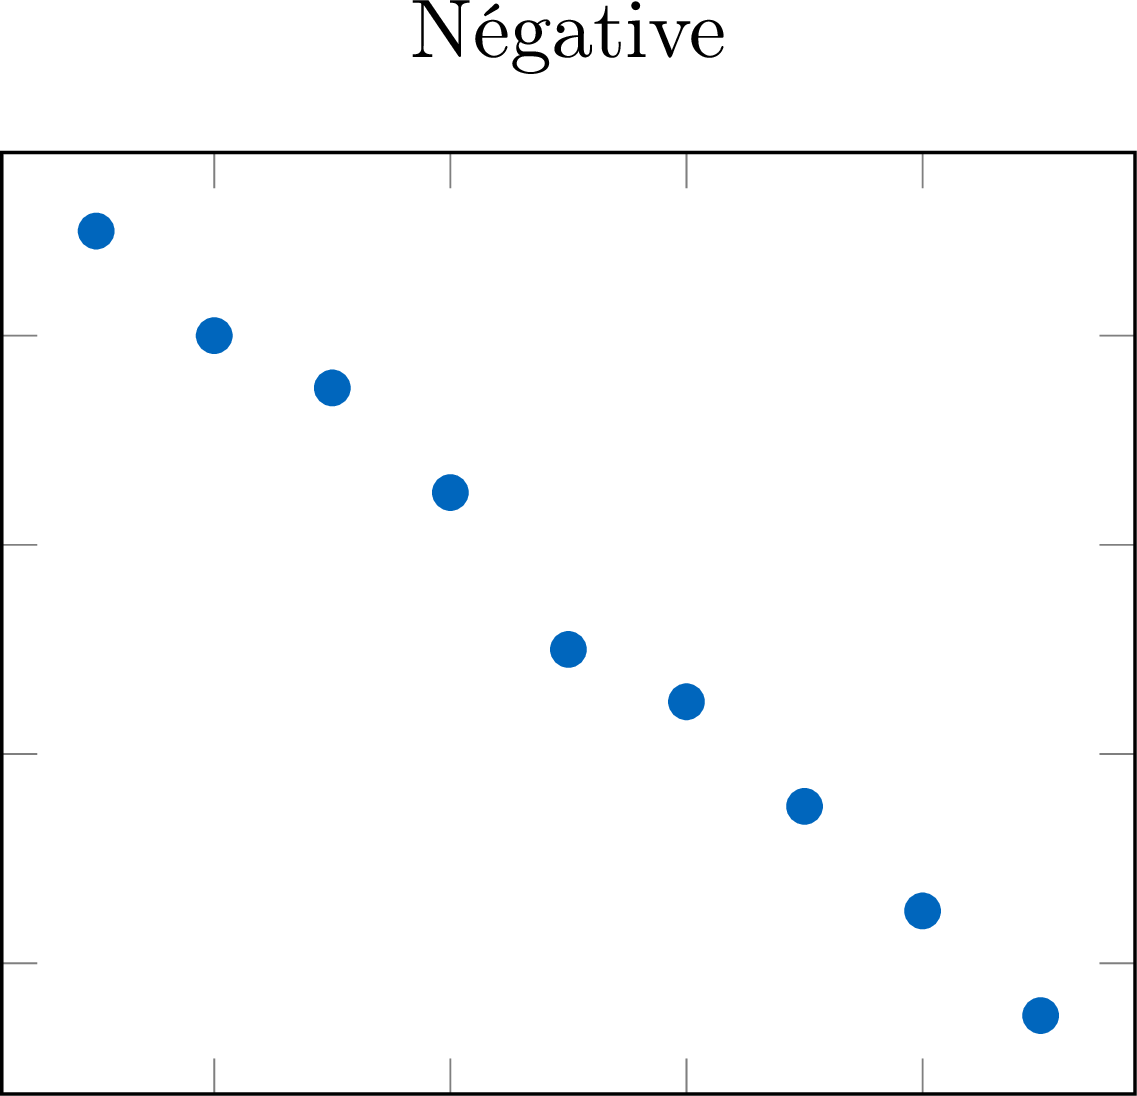
- Négative : lorsque la variable indépendante (\(x\)) augmente, la variable dépendante (\(y\)) a tendance à diminuer. Les points suivent une tendance à la baisse.
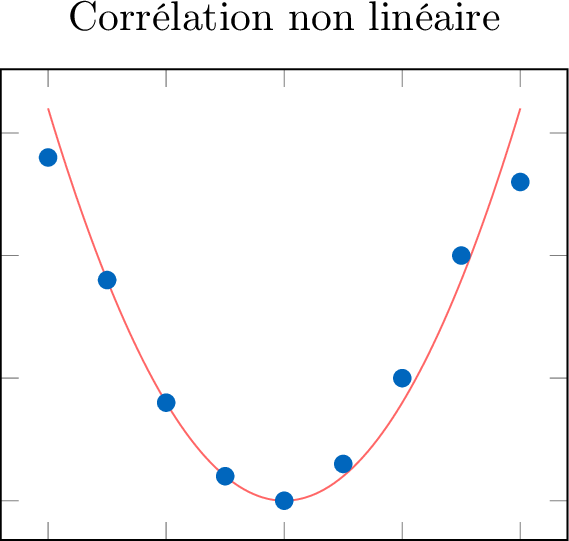
Définition — Forme : linéaire ou non linéaire
La forme de la relation est linéaire si les points semblent alignés le long d'une droite. S'ils suivent une courbe qui n'est pas une droite, la forme est non linéaire. 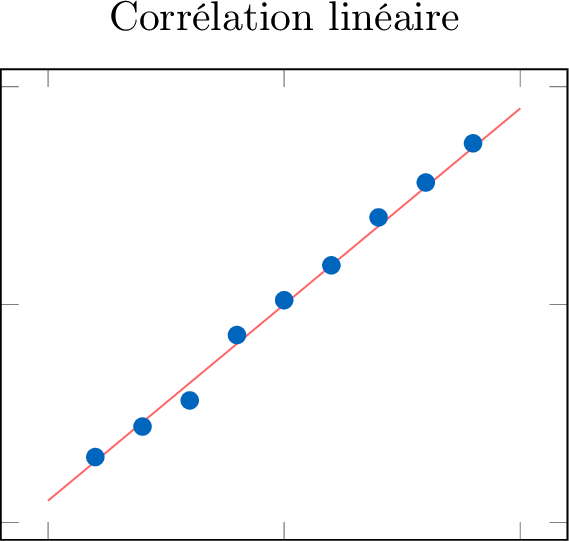
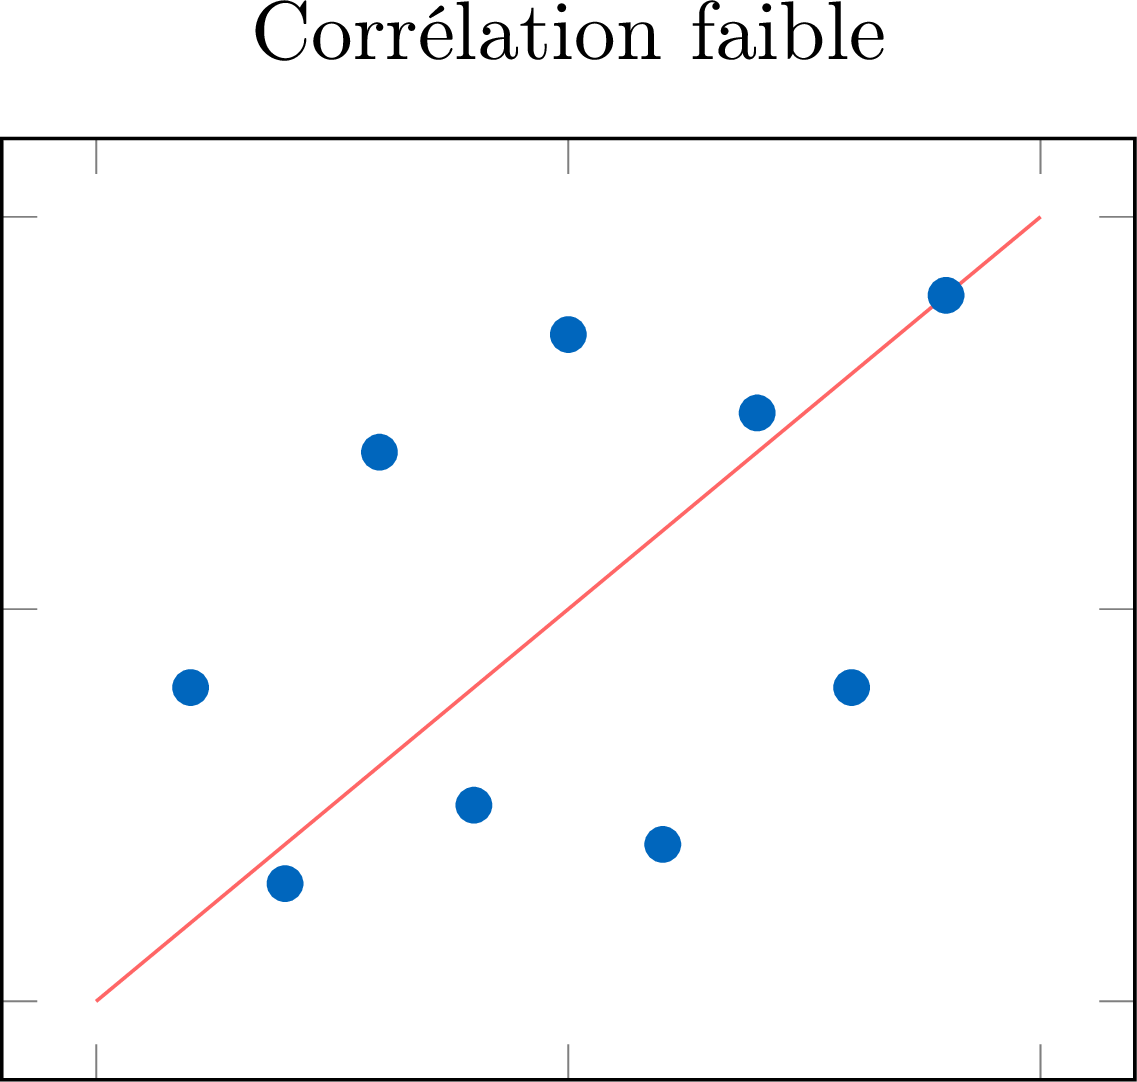
Définition — Force
La force d'une corrélation décrit à quel point les points sont proches de la forme repérée. 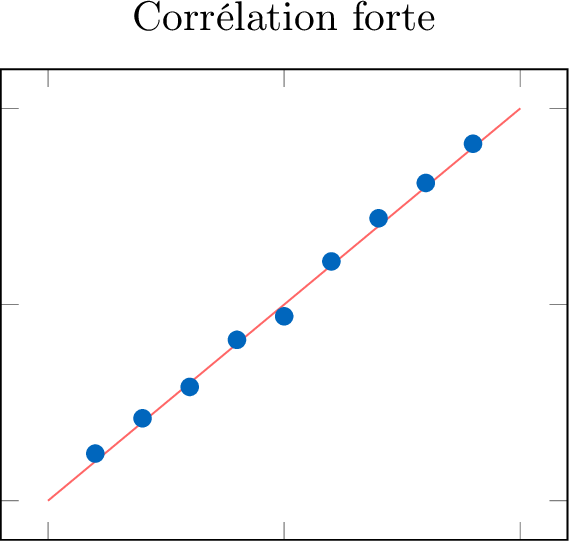
Définition — Données aberrantes
Une donnée aberrante est un point qui s'écarte nettement de la tendance générale du nuage. 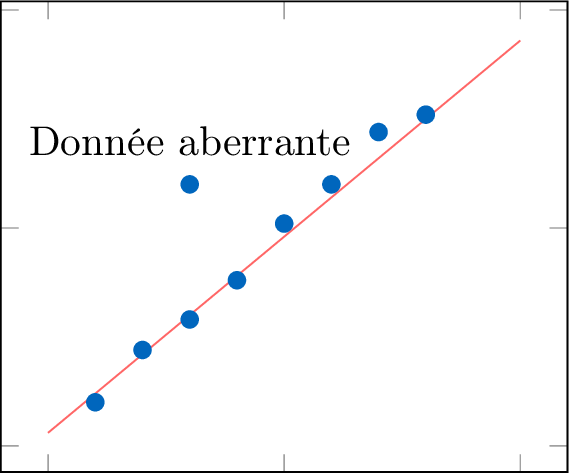
Méthode — Décrire une corrélation
Pour décrire la relation que montre un nuage de points, on commente toujours les quatre caractéristiques suivantes, en une phrase concise. - Sens : la tendance est-elle croissante (corrélation positive), décroissante (corrélation négative), ou ni l'une ni l'autre ?
- Forme : est-elle linéaire, non linéaire, ou sans forme nette ?
- Force : est-elle forte, modérée ou faible ?
- Données aberrantes : y a-t-il des données aberrantes ?
Exemple
Décrire la corrélation entre les heures d'étude et les notes à l'examen que montre ce nuage de points. 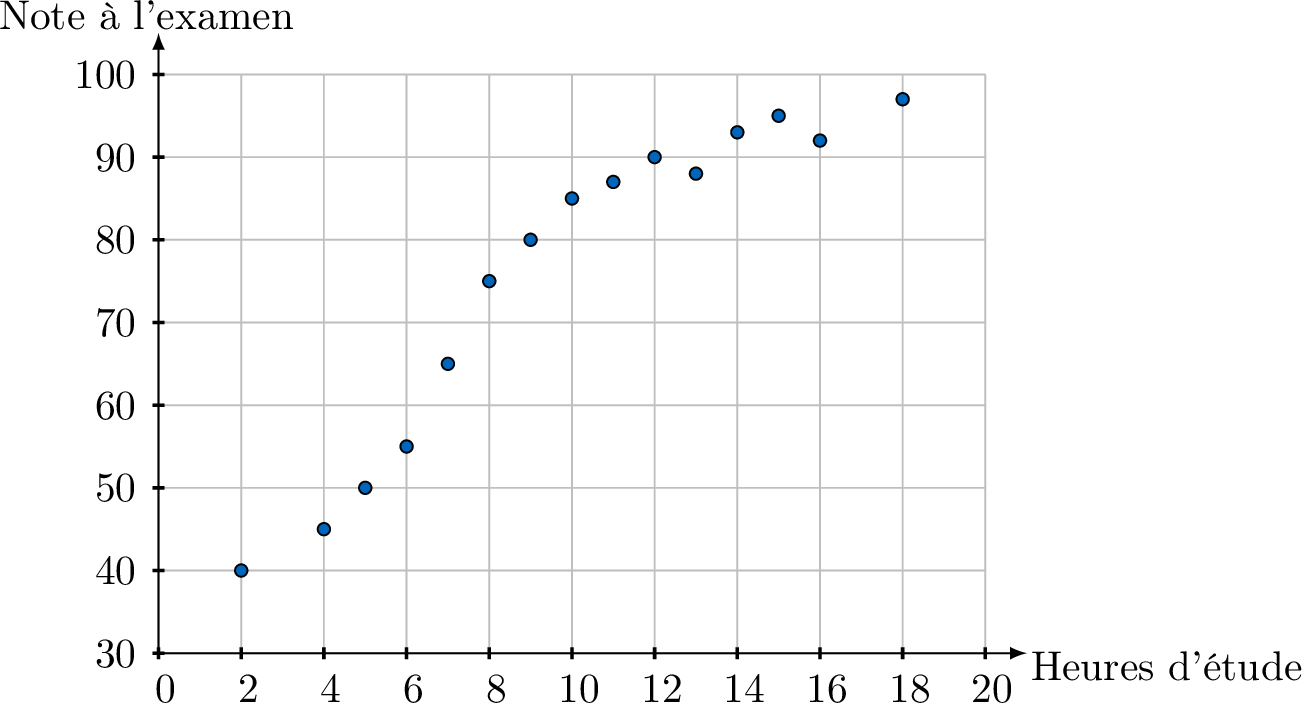
Il y a une corrélation positive et forte entre les heures d'étude et les notes à l'examen : à mesure que le nombre d'heures d'étude augmente, la note à l'examen a tendance à augmenter. Sa forme n'est pas tout à fait linéaire : les notes montent vite jusqu'à environ \(10\) heures, puis plafonnent, et le nuage se courbe. Il n'y a pas de données aberrantes évidentes.
Compétences à pratiquer
- Déterminer le sens d'une corrélation
- Déterminer la force d'une corrélation et interpréter une donnée aberrante
- Déterminer la forme d'une corrélation
- Interpréter la tendance d'un nuage de points
II
Ajustement affine
II.1
Écart type d'une série
L'écart-type mesure la dispersion en utilisant toutes les valeurs de la série. Il donne l'ordre de grandeur de l'écart des valeurs à la moyenne (plus précisément, c'est la moyenne quadratique des écarts). Un petit écart-type signifie que les valeurs sont regroupées près de la moyenne, tandis qu'un grand écart-type signifie qu'elles sont dispersées.
Définition — Écart-type
L'écart-type (\(\sigma\)) s'obtient en prenant la racine carrée de la moyenne des carrés des écarts à la moyenne.$$\sigma = \sqrt{\frac{\sum_{i=1}^{n}(x_i - \bar{x})^2}{n}}$$ où \(\bar{x}\) est la moyenne et \(n\) le nombre de valeurs. Il s'agit de l'écart-type de la population (descriptif) ; lorsqu'un échantillon sert à estimer une population, une variante divise par \(n-1\) au lieu de \(n\). Le symbole \(\sum\) signifie « somme sur toutes les valeurs ». Exemple
Calculer l’écart-type de la série suivante : $$2\ ;\ 4\ ;\ 4\ ;\ 4\ ;\ 5\ ;\ 5\ ;\ 7\ ;\ 9$$ - Calculer la moyenne (\(\bar{x}\)) : $$ \bar{x} = \frac{2 + 4 + 4 + 4 + 5 + 5 + 7 + 9}{8} = \frac{40}{8} = 5 $$
- Calculer les carrés des écarts à la moyenne : \((2-5)^2 = 9\), \((4-5)^2 = 1\), \((4-5)^2 = 1\), \((4-5)^2 = 1\), \((5-5)^2 = 0\), \((5-5)^2 = 0\), \((7-5)^2 = 4\), \((9-5)^2 = 16\).
- Calculer la moyenne des carrés des écarts (la variance) : $$ \frac{9 + 1 + 1 + 1 + 0 + 0 + 4 + 16}{8} = \frac{32}{8} = 4 $$
- Prendre la racine carrée pour obtenir l'écart-type (\(\sigma\)) : $$ \sigma = \sqrt{4} = 2 $$
Compétences à pratiquer
- Calculer un écart type
II.2
Covariance et droite des moindres carrés
Choisir une droite
Une règle posée « au jugé » sur un nuage de points donne une droite, mais une autre personne en poserait une autre : même par le point moyen, une infinité de droites passent près des points. Il faut un critère. Pour une droite \(y = ax + b\), le point \(P_i(x_i ; ax_i + b)\) de la droite a la même abscisse que le point \(M_i(x_i ; y_i)\) du nuage, et l'écart vertical entre eux vaut \(y_i - (ax_i + b)\). Dans une somme, les écarts au-dessus et au-dessous de la droite pourraient se compenser et masquer de grands écarts : on additionne donc leurs carrés : $$S(a ; b) = \sum_{i=1}^{n} \big(y_i - (ax_i + b)\big)^2 .$$ La droite des moindres carrés est la droite pour laquelle cette somme est la plus petite possible. 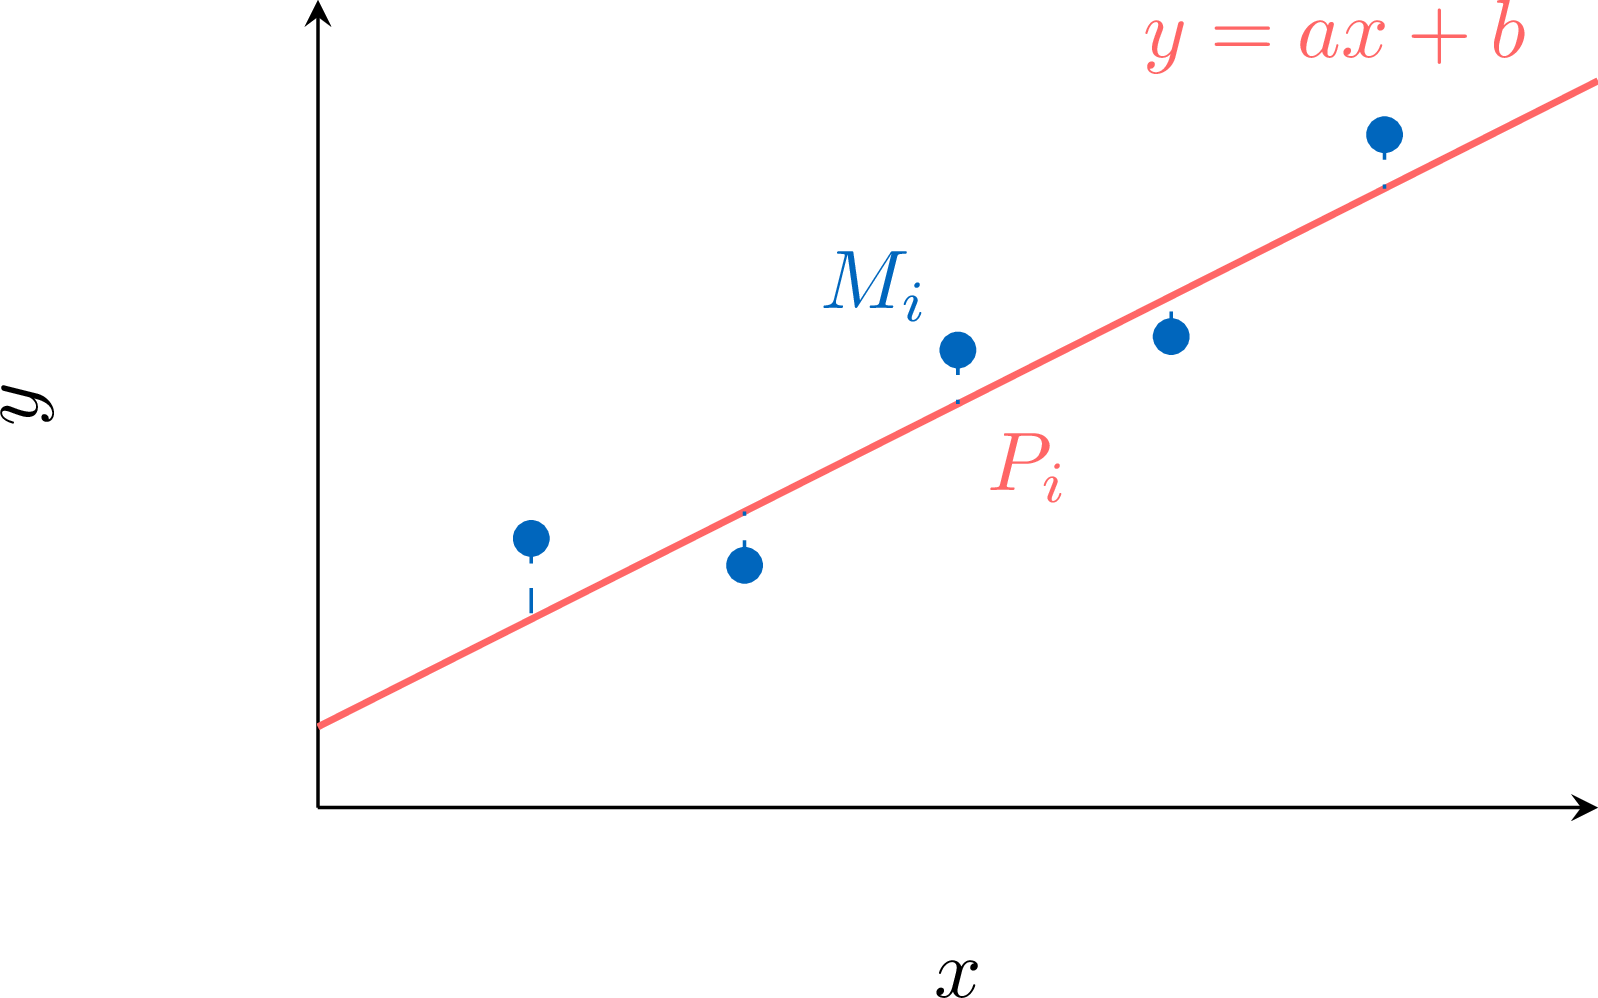
Les carrés et le second degré
Additionner les carrés des écarts verticaux, \(S(a ; b) = \sum_{i=1}^{n} \big(y_i - (ax_i + b)\big)^2\), a un second avantage : à \(a\) fixé, \(S\) est un polynôme du second degré en \(b\) ; une fois \(b\) remplacé par sa meilleure valeur, \(S\) devient un polynôme du second degré en \(a\) (dès que les \(x_i\) ne sont pas tous égaux) ; on trouve le minimum de chacun avec les outils du second degré.
Définition — Covariance
La covariance de la série statistique à deux variables \((x_i ; y_i)_{1 \leq i \leq n}\) est la moyenne des produits des écarts aux moyennes : $$\operatorname{cov}(x ; y) = \frac{1}{n}\sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y}).$$ En particulier, \(\operatorname{cov}(x ; x) = \dfrac{1}{n}\displaystyle\sum_{i=1}^{n} (x_i - \bar{x})^2\) est la variance \(V(x)\) de \(x\), et \(\sigma(x) = \sqrt{V(x)}\) est son écart type. Proposition — Une autre expression de la covariance
Pour toute série statistique à deux variables \((x_i ; y_i)_{1 \leq i \leq n}\), $$\operatorname{cov}(x ; y) = \frac{1}{n}\sum_{i=1}^{n} x_i y_i - \bar{x}\,\bar{y}.$$ En particulier, \(V(x) = \dfrac{1}{n}\displaystyle\sum_{i=1}^{n} x_i^2 - \bar{x}^2\).
Pour tout \(i\), \((x_i - \bar{x})(y_i - \bar{y}) = x_i y_i - \bar{y}\,x_i - \bar{x}\,y_i + \bar{x}\,\bar{y}\). En additionnant ces égalités pour \(i\) de \(1\) à \(n\) et en divisant par \(n\) : $$\begin{aligned} \operatorname{cov}(x ; y) &= \frac{1}{n}\sum_{i=1}^{n} x_i y_i - \bar{y}\times\frac{1}{n}\sum_{i=1}^{n} x_i - \bar{x}\times\frac{1}{n}\sum_{i=1}^{n} y_i + \bar{x}\,\bar{y} \\
&= \frac{1}{n}\sum_{i=1}^{n} x_i y_i - \bar{y}\,\bar{x} - \bar{x}\,\bar{y} + \bar{x}\,\bar{y} && \text{(définition des moyennes)} \\
&= \frac{1}{n}\sum_{i=1}^{n} x_i y_i - \bar{x}\,\bar{y}. \end{aligned}$$ Avec \(y = x\), on obtient l'expression de \(V(x)\).
Proposition — La droite des moindres carrés
Soit \((x_i ; y_i)_{1 \leq i \leq n}\) une série statistique à deux variables dont les valeurs \(x_i\) ne sont pas toutes égales, de sorte que \(V(x) > 0\). Parmi toutes les droites \(y = ax + b\), la somme \(S(a ; b) = \displaystyle\sum_{i=1}^{n} (y_i - ax_i - b)^2\) est minimale pour une seule droite, la droite des moindres carrés (ou droite de régression de \(y\) en \(x\)), avec $$a = \frac{\operatorname{cov}(x ; y)}{V(x)} \quad \text{et} \quad b = \bar{y} - a\,\bar{x}.$$ Comme \(\bar{y} = a\,\bar{x} + b\), la droite des moindres carrés passe par le point moyen \(G\).
Étape 1 : la pente \(a\) est fixée. En écrivant chaque terme \(\big((y_i - ax_i) - b\big)^2\) et en développant, $$S(a ; b) = n\,b^2 - 2b\sum_{i=1}^{n} (y_i - ax_i) + \sum_{i=1}^{n} (y_i - ax_i)^2 .$$ Comme fonction de \(b\), c'est un polynôme du second degré de coefficient dominant \(n > 0\) : il est minimal pour une seule valeur, l'abscisse du sommet de la parabole, $$b = \frac{2\sum_{i=1}^{n} (y_i - ax_i)}{2n} = \bar{y} - a\,\bar{x}.$$ Ainsi, pour tout couple \((a ; b)\), \(S(a ; b) \geq S(a ; \bar{y} - a\,\bar{x})\), avec égalité seulement si \(b = \bar{y} - a\,\bar{x}\).
Étape 2 : la pente. Lorsque \(b = \bar{y} - a\,\bar{x}\), chaque écart devient \(y_i - ax_i - b = (y_i - \bar{y}) - a(x_i - \bar{x})\), donc $$\begin{aligned} S(a ; \bar{y} - a\,\bar{x}) &= \sum_{i=1}^{n} (y_i - \bar{y})^2 - 2a\sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y}) + a^2\sum_{i=1}^{n} (x_i - \bar{x})^2 \\ &= n\big(V(y) - 2a\operatorname{cov}(x ; y) + a^2\,V(x)\big). && \text{(définitions)} \end{aligned}$$ Comme fonction de \(a\), c'est un polynôme du second degré de coefficient dominant \(n\,V(x) > 0\) : il est minimal pour une seule valeur, $$a_0 = \frac{2n\operatorname{cov}(x ; y)}{2n\,V(x)} = \frac{\operatorname{cov}(x ; y)}{V(x)}.$$ Conclusion. Soit \(b_0 = \bar{y} - a_0\,\bar{x}\). Pour tout couple \((a ; b)\), $$S(a ; b) \geq S(a ; \bar{y} - a\,\bar{x}) \geq S(a_0 ; b_0),$$ et les deux inégalités ne sont des égalités que si \(b = \bar{y} - a\,\bar{x}\) et \(a = a_0\), c'est-à-dire \((a ; b) = (a_0 ; b_0)\) : le minimum n'est atteint que pour une seule droite.
Étape 2 : la pente. Lorsque \(b = \bar{y} - a\,\bar{x}\), chaque écart devient \(y_i - ax_i - b = (y_i - \bar{y}) - a(x_i - \bar{x})\), donc $$\begin{aligned} S(a ; \bar{y} - a\,\bar{x}) &= \sum_{i=1}^{n} (y_i - \bar{y})^2 - 2a\sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y}) + a^2\sum_{i=1}^{n} (x_i - \bar{x})^2 \\ &= n\big(V(y) - 2a\operatorname{cov}(x ; y) + a^2\,V(x)\big). && \text{(définitions)} \end{aligned}$$ Comme fonction de \(a\), c'est un polynôme du second degré de coefficient dominant \(n\,V(x) > 0\) : il est minimal pour une seule valeur, $$a_0 = \frac{2n\operatorname{cov}(x ; y)}{2n\,V(x)} = \frac{\operatorname{cov}(x ; y)}{V(x)}.$$ Conclusion. Soit \(b_0 = \bar{y} - a_0\,\bar{x}\). Pour tout couple \((a ; b)\), $$S(a ; b) \geq S(a ; \bar{y} - a\,\bar{x}) \geq S(a_0 ; b_0),$$ et les deux inégalités ne sont des égalités que si \(b = \bar{y} - a\,\bar{x}\) et \(a = a_0\), c'est-à-dire \((a ; b) = (a_0 ; b_0)\) : le minimum n'est atteint que pour une seule droite.
Exemple
Pour la série du ressort, déterminer la droite des moindres carrés par le calcul, puis interpréter sa pente et son ordonnée à l'origine.
Avec \(G(150 ; 16)\), les écarts aux moyennes sont :
$$\begin{aligned} \operatorname{cov}(x ; y) &= \frac{390 + 105 + 0 + 90 + 400}{5} = \frac{985}{5} = 197 \\
V(x) &= \frac{10\,000 + 2\,500 + 0 + 2\,500 + 10\,000}{5} = 5\,000 \\
a &= \frac{197}{5\,000} = 0{,}0394 \\
b &= 16 - 0{,}0394 \times 150 = 10{,}09 \end{aligned}$$ La droite des moindres carrés a pour équation \(y = 0{,}0394x + 10{,}09\). 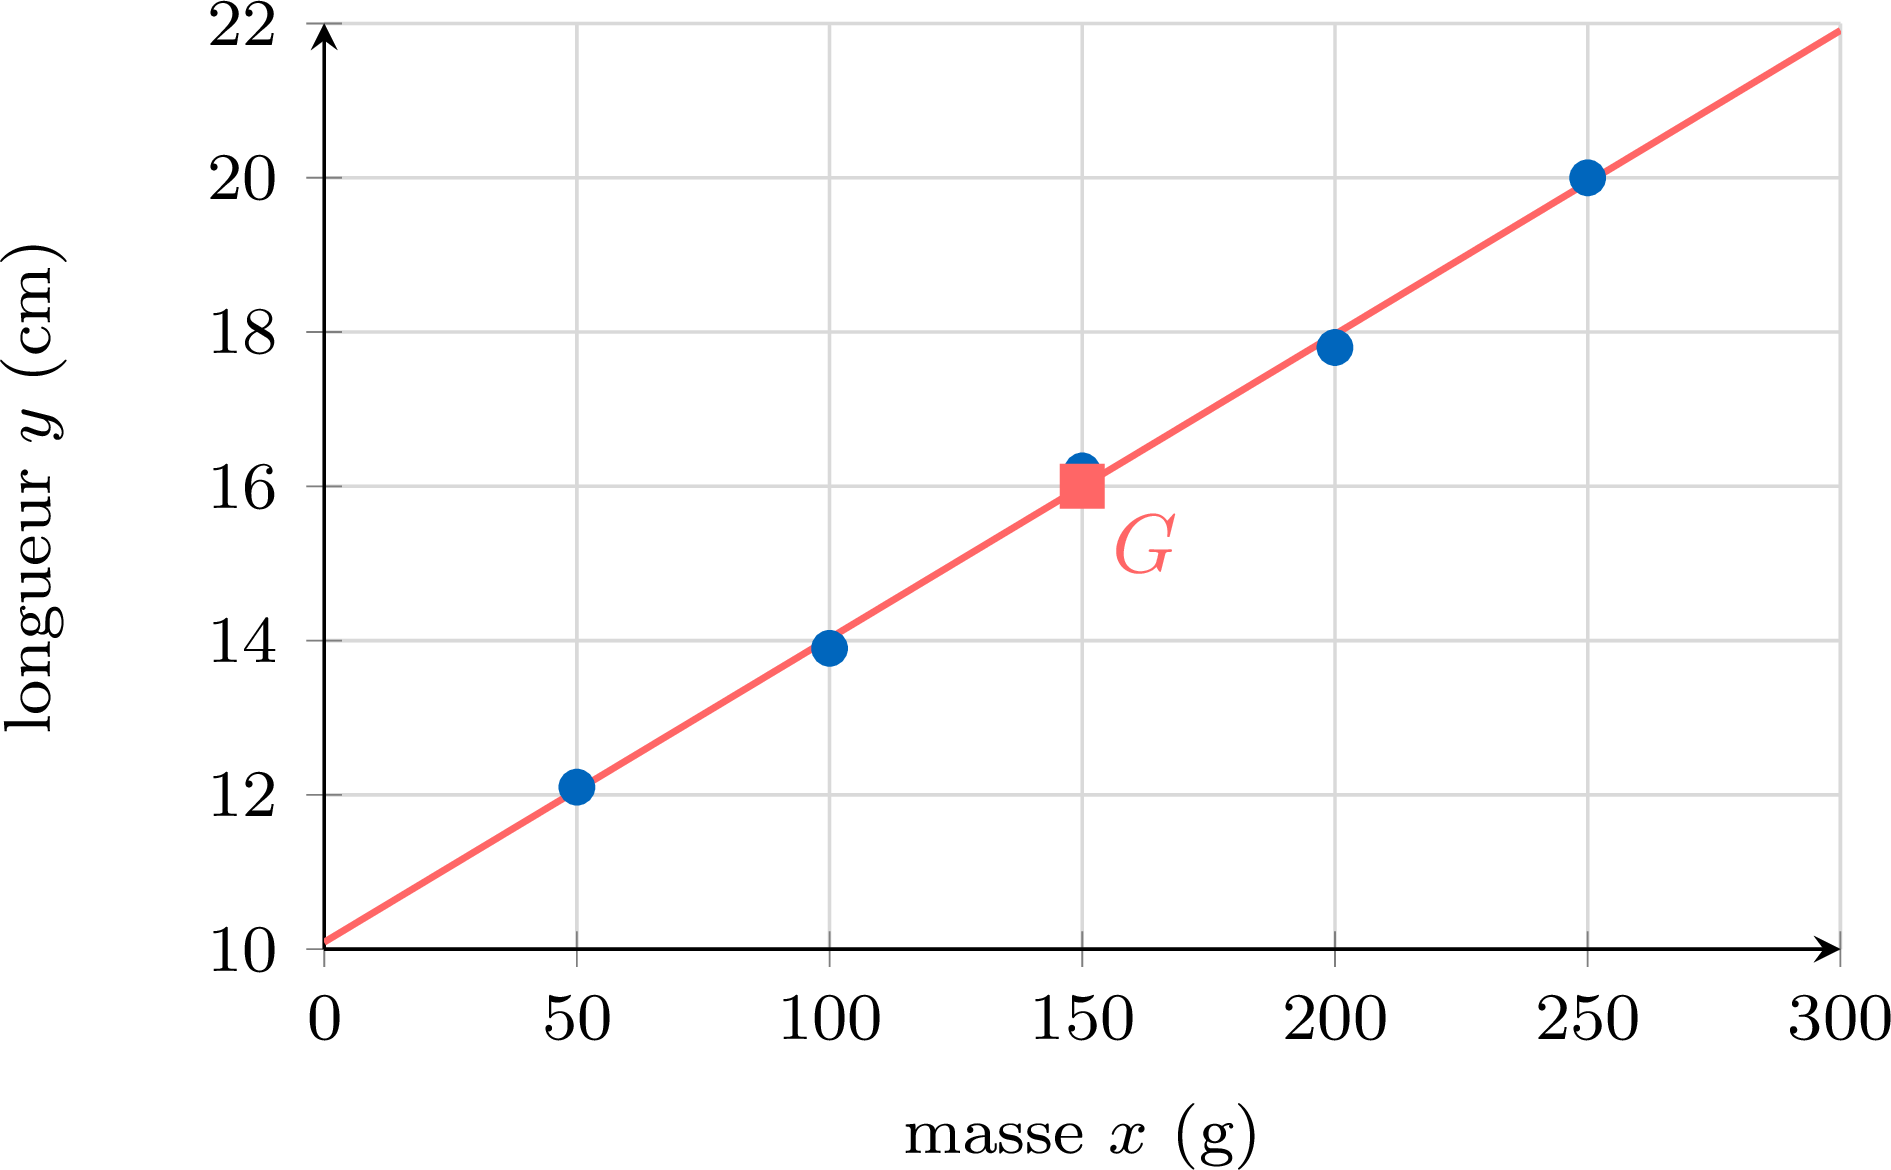
| \(x_i - \bar{x}\) | \(-100\) | \(-50\) | \(0\) | \(50\) | \(100\) |
| \(y_i - \bar{y}\) | \(-3{,}9\) | \(-2{,}1\) | \(0{,}2\) | \(1{,}8\) | \(4{,}0\) |
| \((x_i - \bar{x})(y_i - \bar{y})\) | \(390\) | \(105\) | \(0\) | \(90\) | \(400\) |
| \((x_i - \bar{x})^2\) | \(10\,000\) | \(2\,500\) | \(0\) | \(2\,500\) | \(10\,000\) |
- Pente : chaque gramme supplémentaire allonge le ressort d'environ \(0{,}039\) cm, soit environ \(3{,}9\) cm pour \(100\) g.
- Ordonnée à l'origine : sans masse, le modèle donne une longueur d'environ \(10{,}1\) cm, la longueur du ressort au repos. La valeur \(x = 0\) est en dehors des masses observées : cette lecture suppose que le comportement affine du ressort se poursuit jusqu'à \(0\) g, ce que la loi physique appuie ici.
Méthode — Obtenir la droite avec une calculatrice, un tableur ou Python
- Calculatrice : entrer les valeurs de \(x\) et de \(y\) dans deux listes, ouvrir le menu des statistiques à deux variables et choisir la régression linéaire \(y = ax + b\). L'écran donne \(a\), \(b\) et, souvent, le coefficient \(r\) de la sous-section suivante.
- Tableur : avec les valeurs de \(x\) en
A2:A6et celles de \(y\) enB2:B6, les formules=PENTE(B2:B6;A2:A6),=ORDONNEE.ORIGINE(B2:B6;A2:A6)et=COEFFICIENT.CORRELATION(A2:A6;B2:B6)donnent \(a\), \(b\) et \(r\). - Python : les formules du chapitre deviennent de courtes fonctions sur deux listes.
from math import sqrt

def mean(values):
    return sum(values) / len(values)

def covariance(xs, ys):
    mx = mean(xs)
    my = mean(ys)
    total = 0
    for i in range(len(xs)):
        total = total + (xs[i] - mx) * (ys[i] - my)
    return total / len(xs)

def least_squares(xs, ys):
    """slope a, intercept b and correlation coefficient r
    (neither the xs nor the ys may be all equal)"""
    a = covariance(xs, ys) / covariance(xs, xs)
    b = mean(ys) - a * mean(xs)
    r = covariance(xs, ys) / sqrt(covariance(xs, xs) * covariance(ys, ys))
    return a, b, r

masses = [50, 100, 150, 200, 250]
lengths = [12.1, 13.9, 16.2, 17.8, 20.0]
print(least_squares(masses, lengths))   # about (0.0394, 10.09, 0.9988)
Compétences à pratiquer
- Estimer à l'œil la droite d'ajustement
- Juger si un ajustement affine convient
- Calculer une covariance et une droite des moindres carrés
II.3
Le coefficient de corrélation linéaire
Un nuage de points permet de décrire une corrélation à l'œil, mais cette appréciation est subjective. Pour mesurer de façon précise et objective la force et le sens d'une relation linéaire, on utilise un coefficient numérique.
Définition — Coefficient de corrélation linéaire
Lorsque \(V(x) > 0\) et \(V(y) > 0\), le coefficient de corrélation linéaire de la série \((x_i ; y_i)_{1 \leq i \leq n}\), aussi appelé coefficient de Pearson, est $$r = \frac{\operatorname{cov}(x ; y)}{\sigma(x)\,\sigma(y)}.$$ Il a le signe de la covariance, donc le signe de la pente \(a\) de la droite des moindres carrés. Les facteurs \(\frac{1}{n}\) se simplifient : on peut aussi calculer \(r\) avec des sommes, \(r = \dfrac{\sum (x_i - \bar{x})(y_i - \bar{y})}{\sqrt{\sum (x_i - \bar{x})^2 \sum (y_i - \bar{y})^2}}\). Proposition — Bornes du coefficient de corrélation
Lorsque \(V(x) > 0\) et \(V(y) > 0\), - \(-1 \leq r \leq 1\) ;
- \(|r| = 1\) si et seulement si tous les points du nuage sont sur une même droite, qui est alors la droite des moindres carrés (cette droite n'est ni horizontale ni verticale, puisque \(V(y) > 0\) et \(V(x) > 0\)).
Soient \(a_0 = \dfrac{\operatorname{cov}(x ; y)}{V(x)}\) et \(b_0 = \bar{y} - a_0\,\bar{x}\) les coefficients de la droite des moindres carrés. L'étape 2 de la démonstration précédente donne le minimum de \(S\) : $$\begin{aligned} S(a_0 ; b_0) &= n\big(V(y) - 2a_0\operatorname{cov}(x ; y) + a_0^2\,V(x)\big) \\
&= n\left(V(y) - 2\,\frac{\operatorname{cov}(x ; y)^2}{V(x)} + \frac{\operatorname{cov}(x ; y)^2}{V(x)}\right) && \left(a_0 = \frac{\operatorname{cov}(x ; y)}{V(x)}\right) \\
&= n\,V(y)\left(1 - \frac{\operatorname{cov}(x ; y)^2}{V(x)\,V(y)}\right) \\
&= n\,V(y)\,(1 - r^2). && \text{(définition de } r\text{)} \end{aligned}$$ Une somme de carrés est positive et \(n\,V(y) > 0\), donc \(1 - r^2 \geq 0\), c'est-à-dire \(-1 \leq r \leq 1\). Si \(|r| = 1\), alors \(S(a_0 ; b_0) = 0\) : chaque écart \(y_i - (a_0 x_i + b_0)\) est nul et tous les points sont sur la droite des moindres carrés. Réciproquement, si tous les points sont sur une droite \(y = \alpha x + \beta\), alors \(S(\alpha ; \beta) = 0\), donc le minimum \(S(a_0 ; b_0)\) vaut \(0\), et \(1 - r^2 = 0\), c'est-à-dire \(|r| = 1\).
Exemple
Calculer le coefficient de corrélation linéaire de la série du ressort, arrondi à \(10^{-3}\) près, et commenter la valeur obtenue.
Avec les écarts de l'exemple précédent, $$\begin{aligned} V(y) &= \frac{(-3{,}9)^2 + (-2{,}1)^2 + 0{,}2^2 + 1{,}8^2 + 4{,}0^2}{5} = \frac{38{,}9}{5} = 7{,}78 \\
r &= \frac{197}{\sqrt{5\,000} \times \sqrt{7{,}78}} \approx \frac{197}{197{,}23} \approx 0{,}999 \end{aligned}$$ Le coefficient est très proche de \(1\) : les points sont presque alignés sur une droite de pente positive, et l'ajustement affine décrit bien la série. C'est cohérent avec la physique du ressort, dont l'allongement est proportionnel à la masse suspendue.
Lire un coefficient de corrélation
Le signe de \(r\) donne le sens de la tendance, et \(|r|\) mesure la proximité des points à une droite. Les mots « forte » ou « faible » sont des conventions, pas des théorèmes ; une convention courante se lit ainsi :
Trois limites sont à garder en tête.
| Valeur de \(|r|\) | Corrélation linéaire |
| \(|r| = 1\) | parfaite |
| \(0{,}9 \leq |r| < 1\) | très forte |
| \(0{,}7 \leq |r| < 0{,}9\) | forte |
| \(0{,}5 \leq |r| < 0{,}7\) | modérée |
| \(|r| < 0{,}5\) | faible ou nulle |
- \(r\) ne mesure qu'un alignement linéaire : les points \((-2 ; 4)\), \((-1 ; 1)\), \((0 ; 0)\), \((1 ; 1)\), \((2 ; 4)\) sont sur la parabole \(y = x^2\), et pourtant leur coefficient vaut \(r = 0\).
- Un seul point éloigné des autres peut beaucoup modifier \(r\).
- Un coefficient proche de \(1\) ne prouve ni qu'un modèle affine est le bon (un nuage légèrement courbe peut donner \(r = 0{,}95\)), ni qu'une variable est la cause de l'autre.
Compétences à pratiquer
- Estimer le coefficient de corrélation
- Lire un coefficient de corrélation
- Calculer un coefficient de corrélation
- Analyser la corrélation de données réelles
II.4
Interpolation et extrapolation
Le domaine d'étude
Un ajustement \(y = f(x)\) fait de la série un modèle qui permet d'estimer \(y\) pour une valeur de \(x\) non observée, ou, lorsque l'équation \(f(x) = y\) a une seule solution, \(x\) pour une valeur donnée de \(y\). Le domaine d'étude est l'intervalle qui va de la plus petite à la plus grande valeur observée de \(x\). À l'intérieur, une estimation est une interpolation : elle s'appuie sur les observations qui l'entourent, et elle est raisonnable lorsque le modèle ajuste bien les données. À l'extérieur, une estimation est une extrapolation : elle repose sur une hypothèse supplémentaire, que la tendance se poursuit au-delà des observations, ce que les données seules ne peuvent jamais garantir. Plus on s'éloigne du domaine d'étude, plus l'estimation est fragile. Lorsque \(x\) est le temps, extrapoler au-delà de la dernière observation, c'est prévoir : la prévision doit être donnée avec son hypothèse et avec des mots comme « environ » ou « si la tendance se poursuit ».
Exemple
Pour une enquête sur les heures d'étude et les notes d'examen (sur \(100\)), la calculatrice donne la droite d'ajustement \(y = 3{,}5x + 40\). Dans cette enquête, les heures d'étude allaient de 2 à 15 heures. - Estimer la note d'examen d'un élève qui a étudié pendant 11 heures.
- Estimer la note d'examen d'un élève qui a étudié pendant 25 heures.
- Commenter la fiabilité de l'estimation de la question 2.
- Comme \(x=11\) est dans l'intervalle des valeurs observées, il s'agit d'une interpolation. $$ y = 3{,}5(11) + 40 = 38{,}5 + 40 = 78{,}5 $$ La note estimée est \(78{,}5\).
- Comme \(x=25\) est en dehors de l'intervalle des valeurs observées, il s'agit d'une extrapolation. $$ y = 3{,}5(25) + 40 = 87{,}5 + 40 = 127{,}5 $$ La note estimée est \(127{,}5\).
- L'estimation de la question 2 n'est pas fiable : c'est une extrapolation, et rien ne garantit que la tendance linéaire se poursuive jusqu'à 25 heures d'étude. De plus, le modèle donne une note supérieure à 100, ce qui est impossible : c'est le danger de l'extrapolation.
Compétences à pratiquer
- Estimer des valeurs graphiquement
- Estimer des valeurs avec l'équation d'une droite
- Reconnaître une interpolation ou une extrapolation
- Déterminer et interpréter une droite des moindres carrés
III
Ajustements se ramenant à un ajustement affine
III.1
Ajustement exponentiel
Quand le nuage se courbe
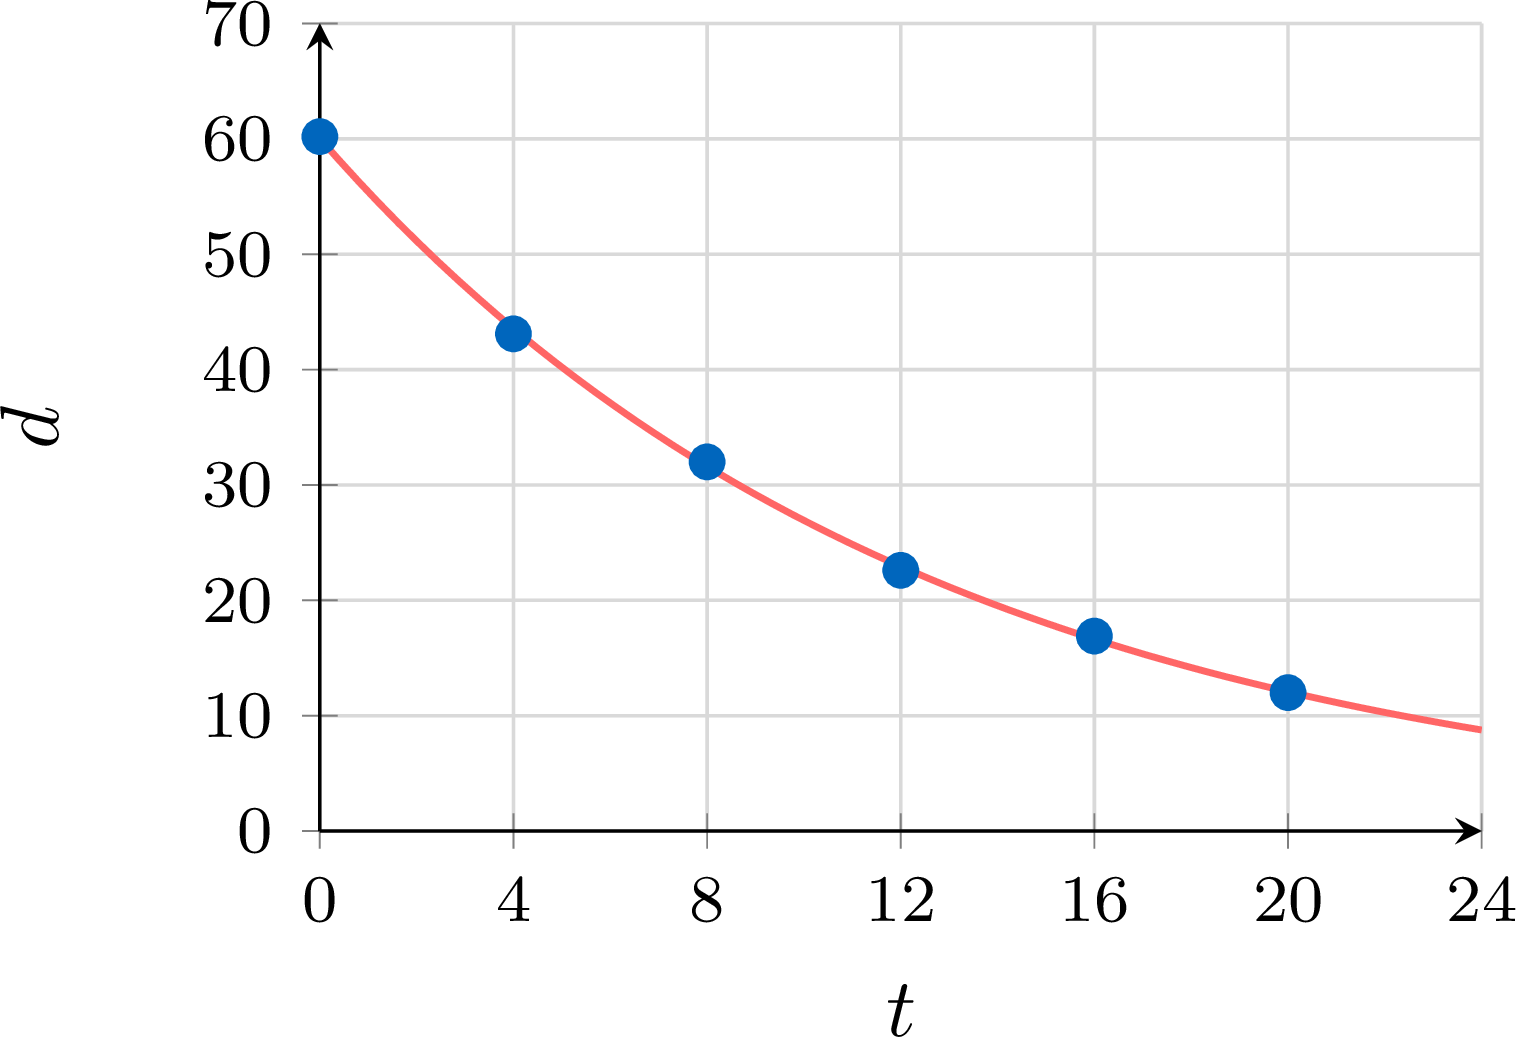
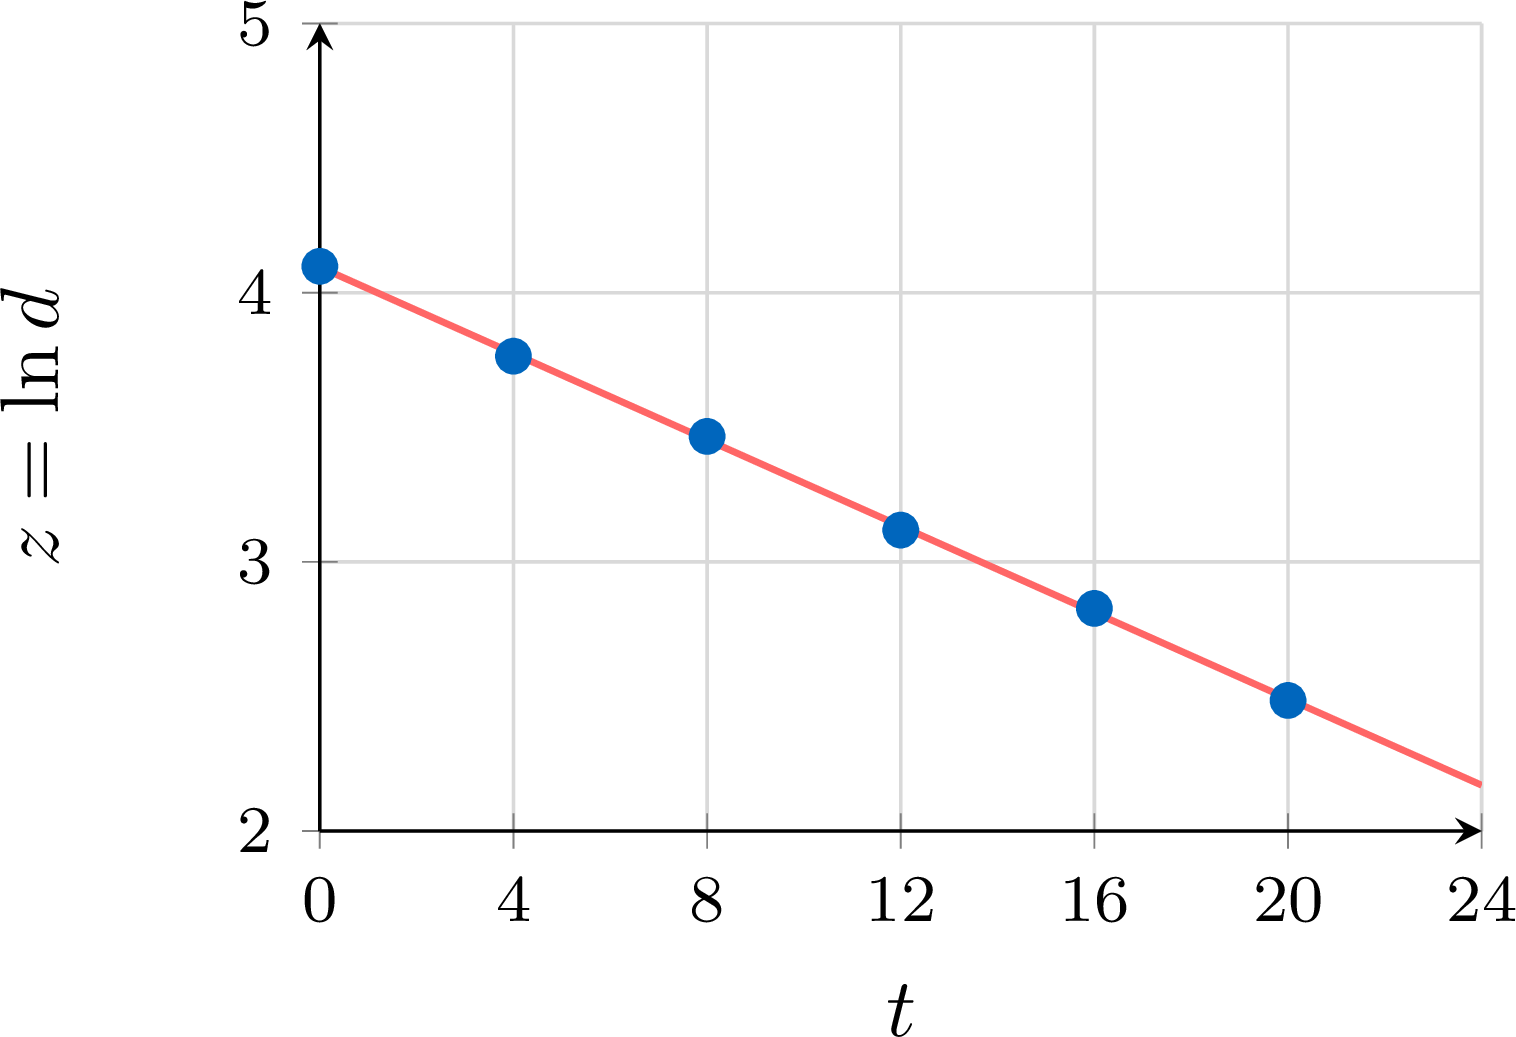
Une tasse de thé refroidit dans une pièce : l'écart \(d\) entre sa température et celle de la pièce diminue vite au début, puis de plus en plus lentement. Le nuage de points \((t ; d)\) est courbe, et aucune droite ne l'ajuste bien. Mais si l'on remplace chaque valeur de \(d\) par \(\ln d\), les points deviennent presque alignés. Une variation où chaque étape multiplie la grandeur par un même facteur devient, par le logarithme, une variation où chaque étape ajoute une même quantité, puisque \(\ln\left(k\,q^{t}\right) = \ln k + t\ln q\). C'est l'idée d'un changement de variable : transformer les données pour qu'un ajustement affine devienne pertinent, ajuster, puis revenir aux variables de départ.
Méthode — Réaliser un ajustement exponentiel
Lorsque le nuage de points \((x_i ; y_i)\) a l'allure de la courbe d'une fonction exponentielle et que tous les \(y_i\) sont strictement positifs : - Transformer : calculer \(z_i = \ln y_i\) pour chaque \(i\).
- Vérifier : les points \((x_i ; z_i)\) sont presque alignés, et le coefficient \(r\) de la série \((x ; z)\) est proche de \(1\) ou de \(-1\).
- Ajuster : déterminer la droite des moindres carrés \(z = ax + b\) de \(z\) en \(x\).
- Revenir : \(\ln y = ax + b\) équivaut à \(y = e^{ax + b} = e^{b} \times \left(e^{a}\right)^{x}\), c'est-à-dire \(y = k\,q^{x}\) avec \(k = e^{b} > 0\) et \(q = e^{a} > 0\).
Exemple
On laisse une tasse de thé dans une pièce. Toutes les \(4\) minutes, on relève l'écart \(d\), en degrés Celsius, entre sa température et la température de la pièce. | Temps \(t\) (min) | \(0\) | \(4\) | \(8\) | \(12\) | \(16\) | \(20\) |
| Écart \(d\) (\(^\circ\)C) | \(60{,}2\) | \(43{,}1\) | \(32{,}0\) | \(22{,}6\) | \(16{,}9\) | \(12{,}0\) |
- Calculer les valeurs \(z_i = \ln d_i\) arrondies à \(10^{-3}\) près, puis déterminer la droite des moindres carrés de \(z\) en \(t\), la pente arrondie à \(10^{-4}\) et l'ordonnée à l'origine à \(10^{-3}\).
- En déduire une expression de \(d\) en fonction de \(t\).
- Estimer l'écart au bout de \(30\) minutes, puis le temps au bout duquel l'écart initial a diminué de moitié.
- Les valeurs de \(z = \ln d\) sont \(4{,}098\), \(3{,}764\), \(3{,}466\), \(3{,}118\), \(2{,}827\), \(2{,}485\). La calculatrice donne \(z = -0{,}0802t + 4{,}095\), avec \(r \approx -0{,}9998\) : les points \((t ; z)\) sont presque alignés.
- \(\ln d = -0{,}0802t + 4{,}095\) équivaut à \(d = e^{4{,}095} \times \left(e^{-0{,}0802}\right)^{t}\), c'est-à-dire \(d \approx 60{,}0 \times 0{,}923^{t}\).
- Au bout de \(30\) minutes, \(d \approx e^{4{,}095 - 0{,}0802 \times 30} = e^{1{,}689} \approx 5{,}4\) \(^\circ\)C. La valeur \(t = 30\) est en dehors des observations : cette estimation suppose que le refroidissement se poursuit de la même façon. L'écart a diminué de moitié lorsque \(e^{-0{,}0802t} = \dfrac{1}{2}\), c'est-à-dire \(-0{,}0802t = -\ln 2\), donc \(t = \dfrac{\ln 2}{0{,}0802} \approx 8{,}6\) minutes.
Compétences à pratiquer
- Réaliser un ajustement exponentiel
- Modéliser par un ajustement exponentiel
III.2
Autres changements de variable
D'autres changements de variable
La même démarche s'applique dès qu'une transformation redresse le nuage. La transformation doit être définie pour toutes les données, et le retour aux variables de départ doit être possible sur les valeurs considérées.
| Changement de variable | Condition | Droite ajustée | Modèle après retour |
| \(u = \ln x\) | \(x > 0\) | \(y = au + b\) | \(y = a\ln x + b\) |
| \(u = \dfrac{1}{x}\) | \(x \neq 0\) | \(y = au + b\) | \(y = \dfrac{a}{x} + b\) |
| \(u = x^2\) | aucune | \(y = au + b\) | \(y = ax^2 + b\) |
| \(w = \sqrt{y}\) | \(y \geq 0\) | \(w = ax + b\) | \(y = (ax + b)^2\) là où \(ax + b \geq 0\) |
| \(w = y^2\) | \(y \geq 0\) | \(w = ax + b\) | \(y = \sqrt{ax + b}\) là où \(ax + b \geq 0\) |
| \(u = \ln x\), \(v = \ln y\) | \(x > 0\), \(y > 0\) | \(v = au + b\) | \(y = e^{b}\,x^{a}\) |
Exemple
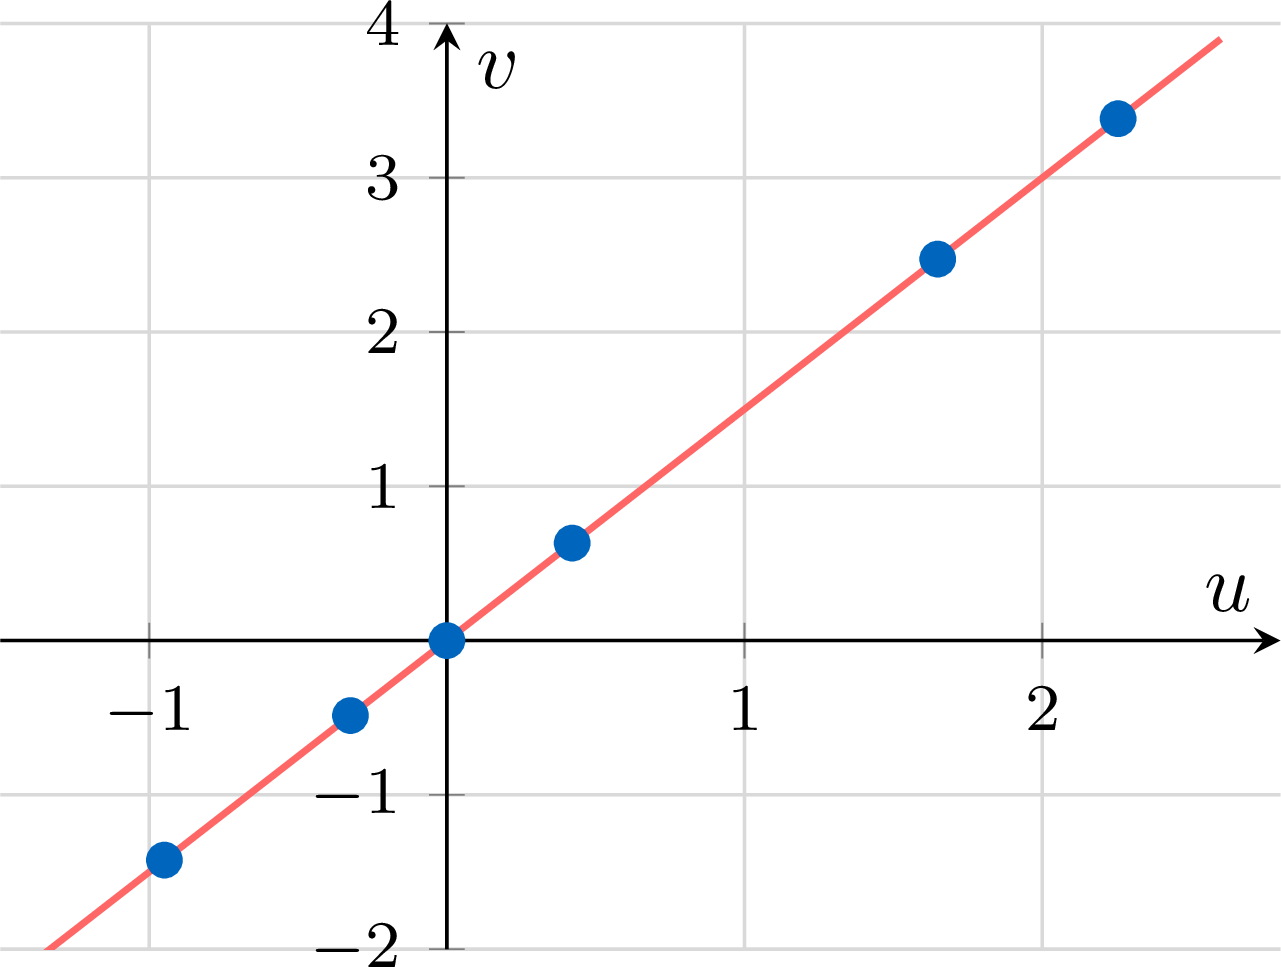
La troisième loi de Kepler. Pour six planètes, le tableau donne la distance moyenne \(D\) au Soleil (le demi-grand axe de son orbite), en unités astronomiques, et la période de révolution \(T\), en années, avec les valeurs de \(u = \ln D\) et \(v = \ln T\) arrondies à \(10^{-3}\) près. | Planète | Mercure | Vénus | Terre | Mars | Jupiter | Saturne |
| \(D\) | \(0{,}387\) | \(0{,}723\) | \(1{,}000\) | \(1{,}524\) | \(5{,}203\) | \(9{,}537\) |
| \(T\) | \(0{,}241\) | \(0{,}615\) | \(1{,}000\) | \(1{,}881\) | \(11{,}862\) | \(29{,}457\) |
| \(u = \ln D\) | \(-0{,}949\) | \(-0{,}324\) | \(0{,}000\) | \(0{,}421\) | \(1{,}649\) | \(2{,}255\) |
| \(v = \ln T\) | \(-1{,}423\) | \(-0{,}486\) | \(0{,}000\) | \(0{,}632\) | \(2{,}473\) | \(3{,}383\) |
- Déterminer la droite des moindres carrés de \(v\) en \(u\), les coefficients arrondis à \(10^{-3}\) près.
- En déduire une relation entre \(T\) et \(D\).
- La calculatrice donne \(v = 1{,}500u + 0{,}000\), avec \(r \approx 1{,}000\) : les points \((u ; v)\) sont presque alignés.
- L'ajustement donne \(\ln T \approx 1{,}5\ln D\) ; en passant à l'exponentielle, \(T \approx e^{1{,}5\ln D} = D^{1{,}5}\), un petit écart entre les logarithmes correspondant à un petit écart relatif entre les valeurs, c'est-à-dire \(T^2 \approx D^3\) avec ces unités. L'ajustement retrouve, à partir de six valeurs mesurées, la relation énoncée par Kepler en 1619 et expliquée plus tard par la théorie de la gravitation de Newton : le carré de la période est proportionnel au cube de la distance.
Juger un ajustement après un changement de variable
Le critère des moindres carrés porte sur les valeurs transformées : après un ajustement exponentiel, ce sont les écarts entre les \(z_i = \ln y_i\) et la droite que l'on rend minimaux, et non les écarts entre les \(y_i\) et la courbe. Un ajustement affine de \((x ; y)\) et un ajustement de \((x ; \ln y)\) ne minimisent donc pas des erreurs mesurées à la même échelle, et leurs coefficients \(r\) ne sont pas des notes que l'on peut comparer. Pour choisir entre deux modèles, on compare les écarts \(y_i - \hat{y}_i\) entre les valeurs observées et les valeurs \(\hat{y}_i\) prévues par chaque modèle, dans les unités de départ ; on regarde la forme du nuage ; et on utilise le contexte : un modèle qui prévoit un prix négatif, ou une grandeur qui croît sans limite là où une limite est connue, est écarté quel que soit son coefficient.
Exemple
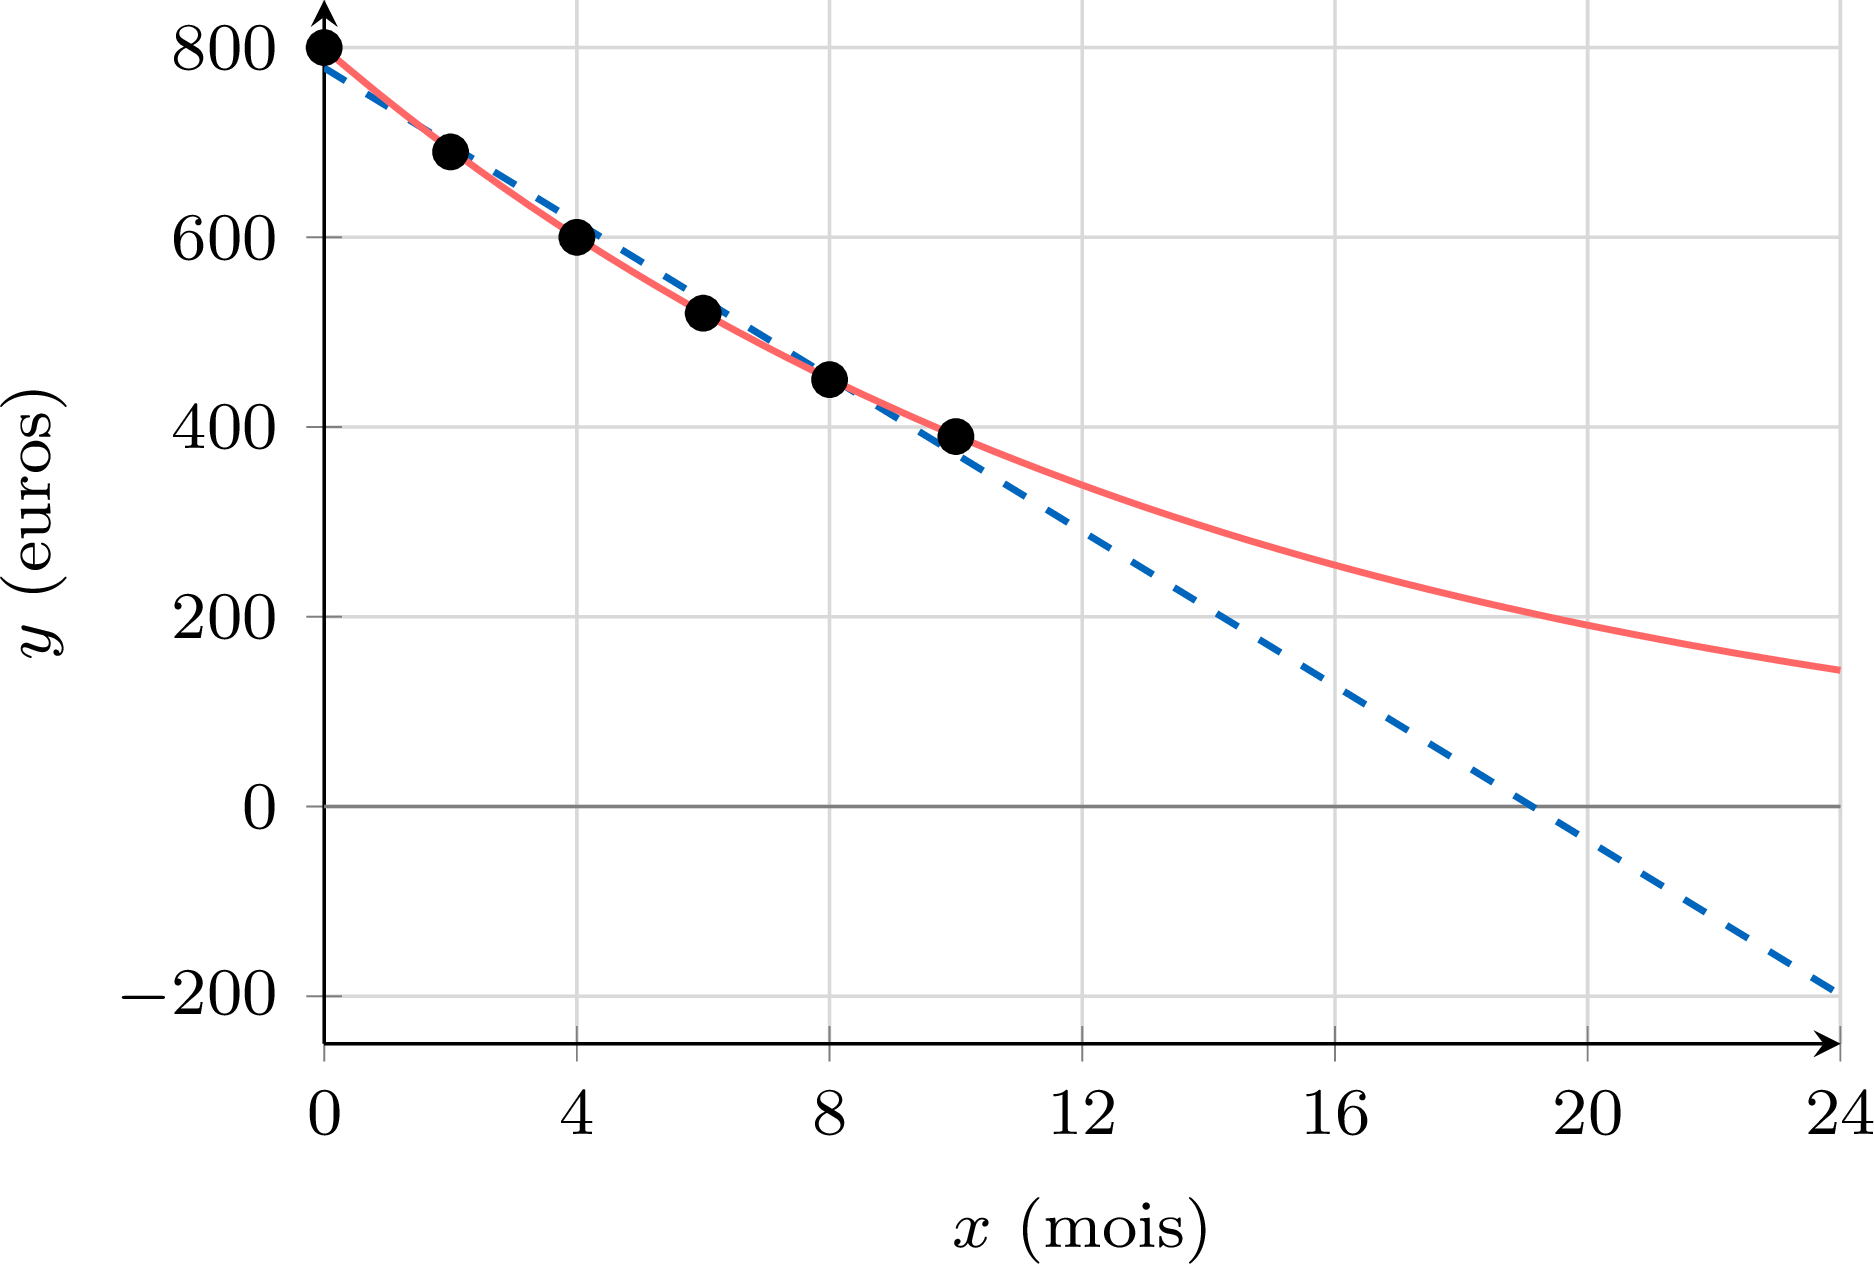
On relève tous les deux mois le prix \(y\), en euros, d'un modèle de smartphone après sa sortie, \(x\) étant le nombre de mois. | Mois \(x\) | \(0\) | \(2\) | \(4\) | \(6\) | \(8\) | \(10\) |
| Prix \(y\) (euros) | \(800\) | \(690\) | \(600\) | \(520\) | \(450\) | \(390\) |
- La droite des moindres carrés est \(y = -40{,}71x + 778{,}6\), avec \(r \approx -0{,}994\). Estimer le prix au bout de \(5\) mois, puis au bout de \(24\) mois, et commenter.
- Un ajustement exponentiel donne \(y \approx 799 \times 0{,}931^{x}\). Comparer les écarts entre les prix observés et les prix prévus par chaque modèle, puis estimer le prix au bout de \(24\) mois avec le modèle exponentiel.
- Au bout de \(5\) mois, une interpolation : \(-40{,}71 \times 5 + 778{,}6 \approx 575\) euros. Au bout de \(24\) mois, une extrapolation : \(-40{,}71 \times 24 + 778{,}6 \approx -198\) euros, un prix négatif, ce qui est absurde. La droite atteint \(0\) pour \(x \approx 19\) mois : la tendance affine ne peut pas se poursuivre, même si \(|r|\) est proche de \(1\).
- Écarts \(y_i - \hat{y}_i\) pour les six observations, calculés avec les deux modèles ci-dessus et arrondis au dixième :
\(x\) \(0\) \(2\) \(4\) \(6\) \(8\) \(10\) Modèle affine \(21{,}4\) \(-7{,}2\) \(-15{,}8\) \(-14{,}3\) \(-2{,}9\) \(18{,}5\) Modèle exponentiel \(1{,}0\) \(-2{,}5\) \(-0{,}3\) \(-0{,}3\) \(-1{,}0\) \(-0{,}9\)
Compétences à pratiquer
- Choisir un changement de variable
IV
Thème : corrélation et causalité
IV.1
Trois explications d'une corrélation
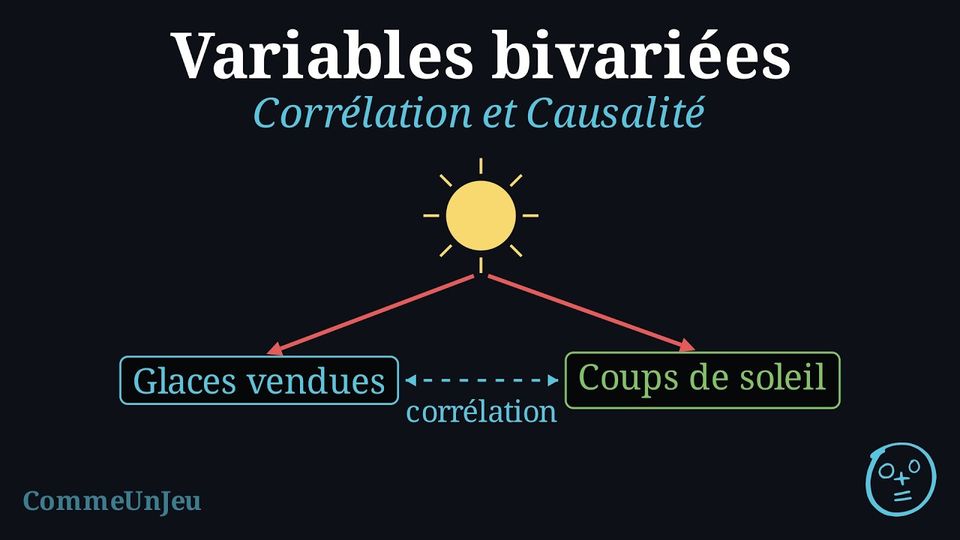
Trois explications d'une corrélation
Dans les villages d'une région, le nombre de nids de cigognes et le nombre de naissances par an sont fortement corrélés. Les cigognes n'apportent pas les bébés : les villages sont plus ou moins grands, et un village plus grand a à la fois plus de toits pour les nids et plus de naissances. Face à une forte corrélation entre deux variables \(x\) et \(y\), trois explications sont à examiner.
- Un lien de causalité : \(x\) agit sur \(y\), ou \(y\) agit sur \(x\) ; les données ne donnent pas le sens de la flèche.
- Un tiers facteur, observé ou non, qui agit sur les deux variables, aussi appelé variable de confusion ; ici, la taille du village.
- Le hasard : quand on compare beaucoup de couples de variables, certains présentent une forte corrélation par coïncidence.
Compétences à pratiquer
- Expliquer une corrélation
IV.2
Causalité et variable de confusion
Définition — Causalité
Il y a causalité lorsqu'une variation de la variable indépendante produit, directement ou par étapes intermédiaires, une variation de la variable dépendante. La preuve la plus solide d'une causalité est une expérience contrôlée bien conçue ; des observations seules suffisent rarement. Définition — Variable de confusion
Souvent, une corrélation entre deux variables (\(x\) et \(y\)) est créée ou déformée par un tiers facteur — observé ou non — appelé variable de confusion. Cette variable influence à la fois \(x\) et \(y\), si bien qu'une partie ou la totalité de leur corrélation vient d'elle et non d'un lien direct entre \(x\) et \(y\). Exemple
Les données montrent une forte corrélation positive entre les ventes de glaces et le nombre de personnes qui attrapent un coup de soleil.Cela signifie-t-il que manger des glaces provoque des coups de soleil ? Sinon, décrire la relation et indiquer la variable de confusion probable.
Non, manger des glaces ne provoque pas de coups de soleil. 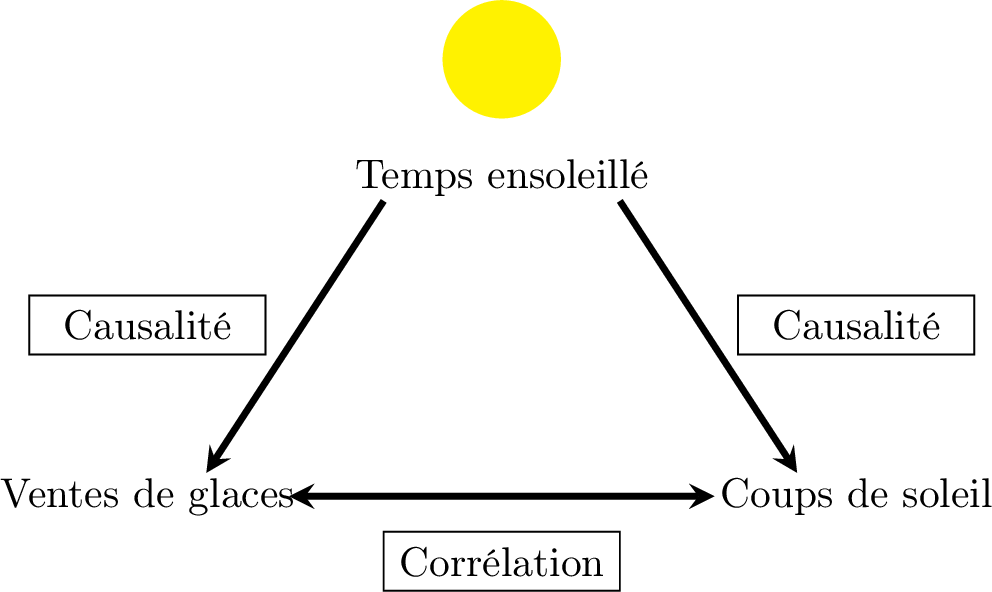
- La relation entre les ventes de glaces et les cas de coups de soleil est une corrélation, et non une causalité.
- La variable de confusion probable est le temps ensoleillé : les journées chaudes et ensoleillées provoquent à la fois une hausse des ventes de glaces et une hausse du nombre de personnes qui attrapent un coup de soleil.
Compétences à pratiquer
- Analyser corrélation et causalité par écrit
- Résoudre des problèmes du thème
V
Pour aller plus loin
Compétences à pratiquer
- Problèmes
- Démontrer des propriétés des moindres carrés
- Type bac
- Quiz
Contrôle du chapitre
4 exercices, sur 20 points. Durée indicative : 1 h 30.
À traiter sur papier, puis à photographier : la correction est automatique, par IA.
Ce contrôle ne modifie pas la maîtrise du chapitre, quelle que soit la note.
Aucun exercice composé.
Aller à la section