Éducation Nationale Française · BCPST
Statistique descriptive
La statistique descriptive est l'art de résumer une masse de mesures brutes — les masses de \(200\) truites, les pluies quotidiennes d'une année, la teneur en silice de \(50\) échantillons de roche — par quelques nombres et quelques images que l'\oe il et l'esprit saisissent d'un coup. Ce chapitre a deux moitiés. La moitié univariée étudie un seul caractère mesuré : comment le compter (fréquences), comment le dessiner (diagrammes en barres, histogrammes), où se situent ses valeurs (mode, moyenne, médiane) et combien elles sont dispersées (variance, écart-type, quartiles). La moitié bivariée étudie deux caractères mesurés sur les mêmes individus — taille et masse, température et vitesse de réaction — et demande s'ils varient ensemble : le nuage de points, la covariance, le coefficient de corrélation, et enfin la droite qui ajuste au mieux le nuage. Aucune probabilité n'intervient ici : on décrit des données déjà collectées, rien n'est aléatoire. Tout au long, \(n\) désigne le nombre d'individus observés.
I
Séries univariées et fréquences
I.1
Caractère, population et série statistique
Une étude statistique commence par une population d'individus sur lesquels on observe un caractère. Le caractère peut être un nombre (caractère quantitatif) ou une étiquette (caractère qualitatif) ; cette distinction décide des résumés qui ont un sens.
Définition — Population, caractère, série
La population est l'ensemble des \(n\) individus étudiés ; \(n\) est son effectif total. Le caractère est la propriété observée sur chaque individu. Il est quantitatif lorsque ses valeurs sont des nombres (masse, longueur, comptage) et qualitatif lorsque ses valeurs sont des catégories (espèce, groupe sanguin, type de roche). Un caractère quantitatif est discret lorsqu'il prend des valeurs isolées (un nombre d'agneaux) et continu lorsqu'il parcourt un intervalle (une longueur). La liste des valeurs observées est la série statistique ; les valeurs distinctes prises sont \(x_1, \dots, x_p\), et l'effectif \(n_i\) de la valeur \(x_i\) est le nombre d'individus qui la portent, de sorte que \(n_1 + \dots + n_p = n\). Exemple
Sur \(n = 20\) brebis on relève le nombre d'agneaux nés dans une saison. Le caractère quantitatif discret prend les valeurs distinctes \(0, 1, 2, 3\) d'effectifs : | \(x_i\) | \(0\) | \(1\) | \(2\) | \(3\) |
| \(n_i\) | \(3\) | \(7\) | \(8\) | \(2\) |
Exemple
Sur \(n = 30\) donneurs de sang on relève le groupe sanguin A, B, AB ou O. C'est un caractère qualitatif : les quatre valeurs sont des catégories sans sens numérique, on peut donc compter effectifs et fréquences mais ni les ordonner ni les moyenner. Définition — Fréquence
La fréquence de la valeur \(x_i\) est \(f_i = \dfrac{n_i}{n}\). C'est un nombre compris entre \(0\) et \(1\) (souvent lu en pourcentage), et les fréquences somment à \(1\) : \(f_1 + \dots + f_p = 1\). Exemple
Pour les \(20\) brebis ci-dessus, la fréquence de \(2\) agneaux est \(f = \dfrac{8}{20} = 0{,}4\), soit \(40\pourcent\) du troupeau. Les quatre fréquences sont \(0{,}15,\ 0{,}35,\ 0{,}40,\ 0{,}10\), et elles somment à \(1\). Exemple
Pourquoi les fréquences somment-elles toujours à \(1\) ? Parce que \(f_1 + \dots + f_p = \dfrac{n_1}{n} + \dots + \dfrac{n_p}{n} = \dfrac{n_1 + \dots + n_p}{n} = \dfrac{n}{n} = 1\). Cette identité est un contrôle gratuit de tout tableau de fréquences. Méthode — Construire un tableau de fréquences
Lister les valeurs distinctes \(x_i\) par ordre croissant ; compter l'effectif \(n_i\) de chacune ; vérifier que \(\sum n_i = n\) ; puis diviser chaque \(n_i\) par \(n\) pour obtenir \(f_i\) et vérifier que \(\sum f_i = 1\) (un contrôle utile du calcul). Compétences à pratiquer
- Construire des tableaux de fréquences
I.2
Effectifs et fréquences cumulés
Pour un caractère quantitatif, c'est souvent le total cumulé qui importe : combien d'individus ont une valeur au plus égale à \(x\). Ces effectifs cumulés répondent directement à des questions comme « quelle proportion de truites pèse moins de \(200\) g ».
Définition — Effectif et fréquence cumulés
Les valeurs étant ordonnées \(x_1 < x_2 < \dots < x_p\), l'effectif cumulé en \(x_i\) est \(N_i = n_1 + \dots + n_i\) (le nombre d'individus de valeur \(\le x_i\)), et la fréquence cumulée est \(F_i = f_1 + \dots + f_i = \dfrac{N_i}{n}\). Tous deux croissent avec \(i\), et \(N_p = n\), \(F_p = 1\). Exemple
Pour les \(20\) brebis, le tableau cumulé donne : | \(x_i\) | \(0\) | \(1\) | \(2\) | \(3\) |
| \(N_i\) | \(3\) | \(10\) | \(18\) | \(20\) |
| \(F_i\) | \(0{,}15\) | \(0{,}50\) | \(0{,}90\) | \(1\) |
Exemple
Pour les longueurs de feuilles de maïs de \(20\) plants regroupées en classes \([8,9[,\ [9,10[,\ \dots,\ [14,15[\), les effectifs cumulés sont \(1, 3, 6, 11, 15, 18, 20\). Les fréquences cumulées correspondantes en pourcentage sont \(5, 15, 30, 55, 75, 90, 100\) : ainsi \(55\pourcent\) des feuilles mesurent moins de \(12\) cm (et \(75\pourcent\) moins de \(13\) cm). Méthode — Lire une proportion seuil
Pour trouver la proportion de la population de valeur \(\le x_i\), lire \(F_i\) directement. Pour la proportion de valeur \(> x_i\), calculer \(1 - F_i\). Pour la proportion strictement comprise entre deux seuils, soustraire les deux fréquences cumulées. Compétences à pratiquer
- Cumuler des effectifs et lire des seuils
I.3
Représentations graphiques
Une image transmet d'un coup d'\oe il la forme d'une série. Le diagramme à employer dépend du caractère : un diagramme en barres pour un petit ensemble de valeurs discrètes ou qualitatives, un histogramme pour un caractère continu regroupé en classes, où c'est l'aire de chaque rectangle qui représente l'effectif.
Définition — Diagramme en barres et histogramme
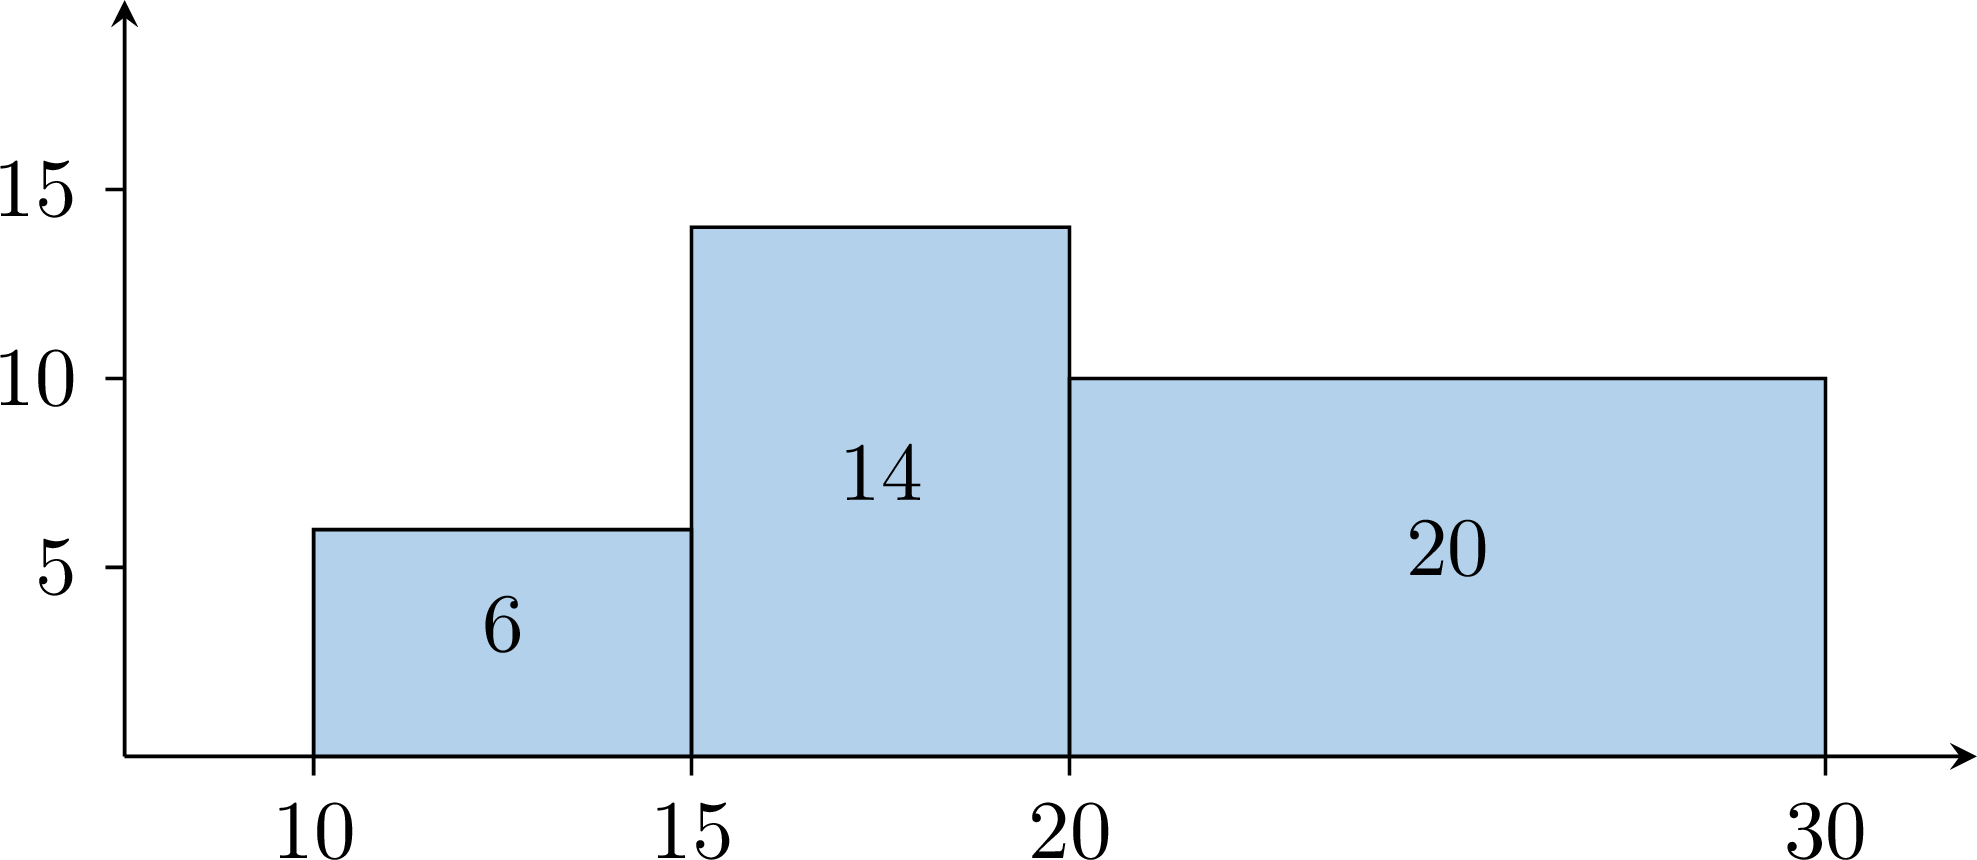
Un diagramme en barres dessine, au-dessus de chaque valeur \(x_i\), une barre dont la hauteur est l'effectif \(n_i\) (ou la fréquence \(f_i\)) ; les barres sont séparées. Un histogramme regroupe un caractère continu en classes adjacentes \([a_{i-1}, a_i[\) et dessine au-dessus de chaque classe un rectangle dont l'aire est proportionnelle à l'effectif de la classe ; lorsque toutes les classes ont la même largeur, la hauteur aussi est proportionnelle à l'effectif. Exemple
Les longueurs (en cm) de \(40\) poissons sont regroupées en quatre classes égales de largeur \(5\), d'effectifs \(6, 14, 13, 7\). Les classes étant de même largeur, on peut prendre les hauteurs égales aux effectifs : 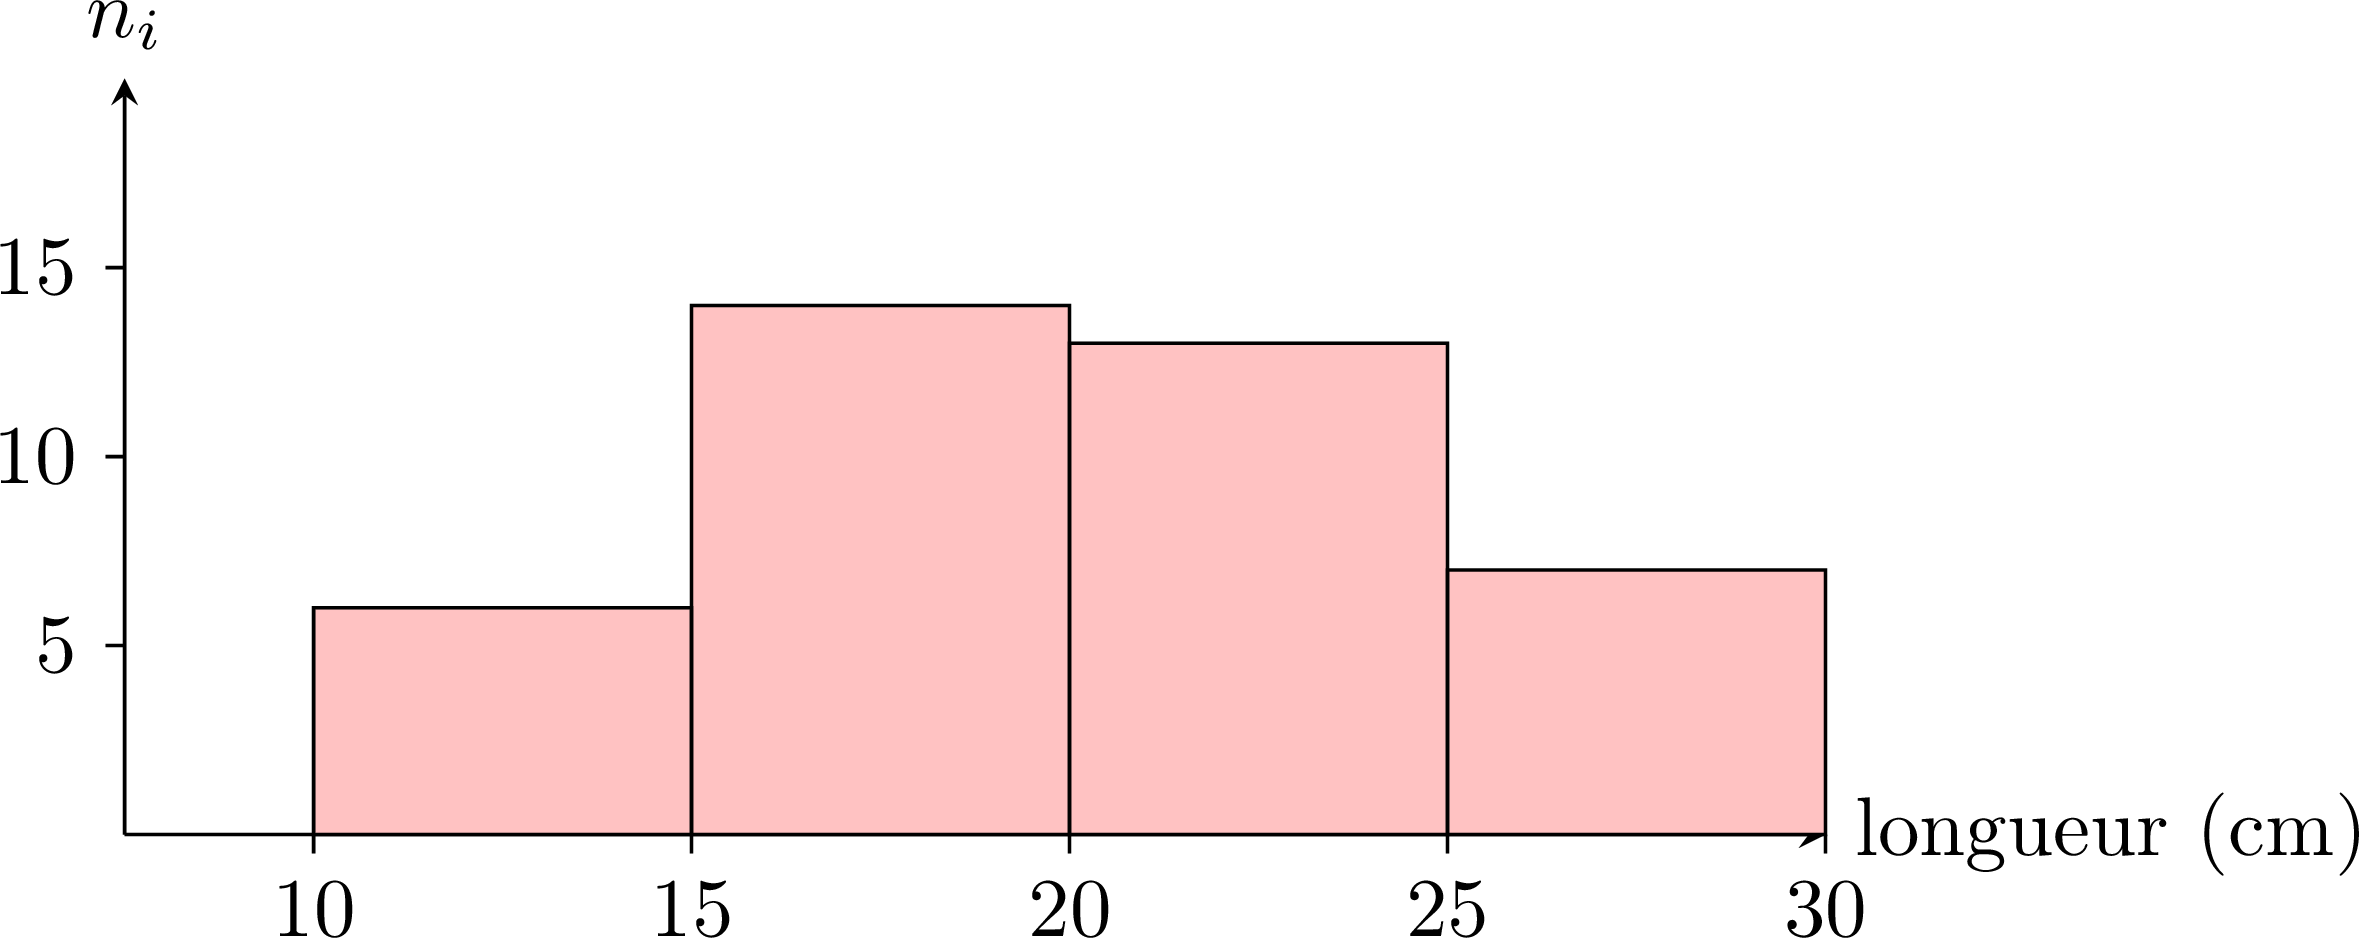
Exemple
Un diagramme en barres des \(20\) brebis dessine quatre barres séparées de hauteurs \(3, 7, 8, 2\) au-dessus des valeurs \(0, 1, 2, 3\). Les barres restent disjointes, car le caractère est discret et il n'y a rien entre deux valeurs consécutives — c'est la différence visible avec les rectangles jointifs de l'histogramme ci-dessus : 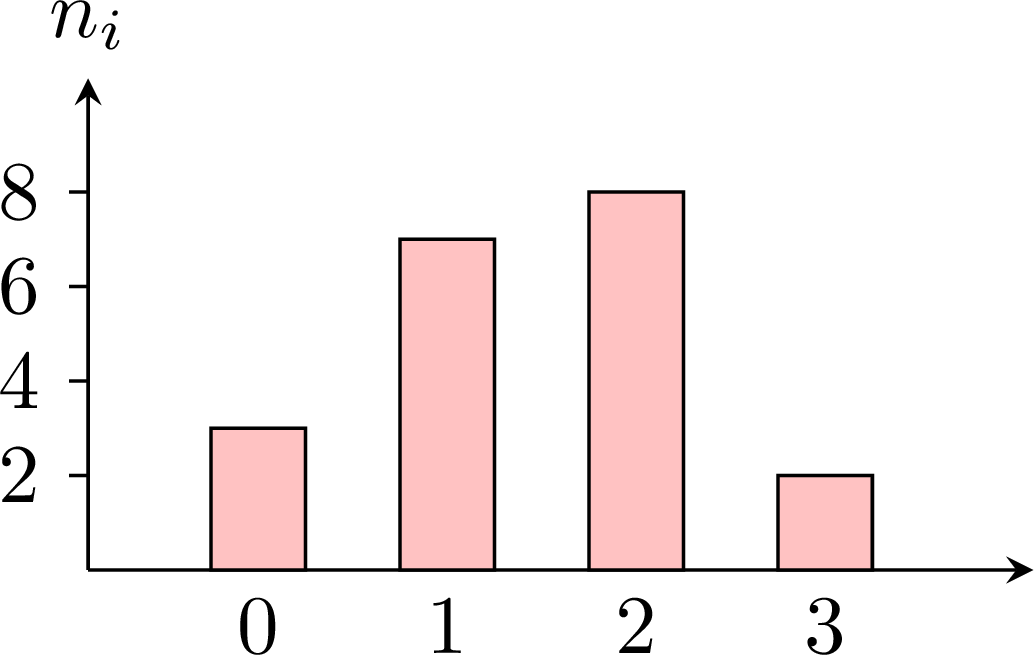
Pour un caractère qualitatif (espèce, type de roche) seuls un diagramme en barres ou un diagramme circulaire ont un sens : il n'y a pas d'ordre sur les catégories, donc effectifs cumulés, moyenne et médiane n'ont pas de sens. On réserve les résumés numériques de la section suivante aux caractères quantitatifs.
Compétences à pratiquer
- Lire des diagrammes en barres et histogrammes
II
Position et dispersion d'une série
II.1
Indicateurs de position : mode, moyenne et médiane
Un indicateur de position répond à « où est le centre des données ». Trois réponses classiques se complètent : le mode (valeur la plus fréquente), la moyenne (le point d'équilibre) et la médiane (la valeur du milieu).
Définition — Mode
Le mode d'une série est une valeur d'effectif maximal. Une série peut avoir plusieurs modes (quand plusieurs valeurs ont le même effectif maximal). Définition — Moyenne
La moyenne d'une série quantitative est $$\overline{x} = \frac{1}{n}\sum_{i=1}^{p} n_i x_i = \sum_{i=1}^{p} f_i x_i.$$ De façon équivalente, si \(v_1, \dots, v_n\) sont les \(n\) valeurs individuelles (avec répétition), \(\overline{x} = \dfrac{1}{n}\sum_{j=1}^{n} v_j\). Exemple
Pour les \(20\) brebis, le nombre moyen d'agneaux est $$\begin{aligned} \overline{x} &= \frac{1}{20}\bigl(3\cdot 0 + 7\cdot 1 + 8\cdot 2 + 2\cdot 3\bigr) && \text{(on pondère chaque valeur par son effectif)} \\
&= \frac{0 + 7 + 16 + 6}{20} \\
&= \frac{29}{20} \\
&= 1{,}45. \end{aligned}$$ Le mode est \(2\) (effectif maximal, \(8\)), et la moyenne \(1{,}45\) n'est pas forcément une valeur observée. Définition — Médiane
Ordonner les \(n\) valeurs individuelles par ordre croissant. La médiane \(\mathrm{Me}\) est une valeur qui partage la série en deux moitiés de même taille : au moins la moitié des valeurs sont \(\le \mathrm{Me}\) et au moins la moitié sont \(\ge \mathrm{Me}\). Lorsque \(n\) est impair, c'est la valeur centrale (rang \(\frac{n+1}{2}\)) ; lorsque \(n\) est pair, c'est la demi-somme des deux valeurs centrales (rangs \(\frac{n}{2}\) et \(\frac{n}{2}+1\)). Exemple
Les masses (g) de \(7\) mulots, ordonnées, sont \(18, 19, 21, 22, 24, 25, 30\). Ici \(n = 7\) est impair, donc la médiane est la \(4\)\textsuperscript{e} valeur, \(\mathrm{Me} = 22\). La moyenne est \(\overline{x} = \frac{159}{7} \approx 22{,}7\) : elle est tirée vers le haut par le mulot le plus lourd, tandis que la médiane résiste à une telle valeur extrême. Exemple
Les longueurs (cm) de \(6\) vers de terre, ordonnées, sont \(7, 8, 10, 11, 13, 15\). Ici \(n = 6\) est pair, donc la médiane est la demi-somme des \(3\)\textsuperscript{e} et \(4\)\textsuperscript{e} valeurs, \(\mathrm{Me} = \frac{10 + 11}{2} = 10{,}5\), qui n'est pas elle-même une valeur observée. Méthode — Choisir un indicateur de position
Utiliser la moyenne quand les valeurs sont homogènes et qu'on veut un point d'équilibre exploitant toutes les valeurs. Utiliser la médiane quand la série a des valeurs extrêmes ou est dissymétrique, car la médiane y est insensible. Utiliser le mode pour un caractère qualitatif ou pour nommer la valeur la plus typique. Compétences à pratiquer
- Calculer mode, moyenne et médiane
II.2
Indicateurs de dispersion : variance et écart-type
Deux séries de même moyenne peuvent être très différemment dispersées. La dispersion mesure de combien les valeurs s'écartent de la moyenne en moyenne ; l'écart-type est le plus employé, car il a la même unité que les données.
Définition — Variance et écart-type
La variance d'une série quantitative de moyenne \(\overline{x}\) est la moyenne des carrés des écarts : $$V = \frac{1}{n}\sum_{i=1}^{p} n_i (x_i - \overline{x})^2 = \sum_{i=1}^{p} f_i (x_i - \overline{x})^2.$$ L'écart-type est \(\sigma = \sqrt{V}\). Il s'exprime dans la même unité que les données, tandis que la variance est dans cette unité au carré. La variance est toujours \(\ge 0\), et elle vaut \(0\) seulement lorsque toutes les valeurs sont égales. Proposition — Formule de König–Huygens
La variance est égale à la moyenne des carrés moins le carré de la moyenne : $$V = \frac{1}{n}\sum_{i=1}^{p} n_i x_i^{\,2} - \overline{x}^{\,2} = \overline{x^2} - \overline{x}^{\,2}.$$ Cette forme est en général plus rapide à calculer que la définition.
On développe le carré dans la somme de définition et on utilise \(\sum n_i = n\) avec \(\sum n_i x_i = n\,\overline{x}\) : $$\begin{aligned} V &= \frac{1}{n}\sum_{i=1}^{p} n_i (x_i - \overline{x})^2 \\
&= \frac{1}{n}\sum_{i=1}^{p} n_i \bigl(x_i^{\,2} - 2\overline{x}\,x_i + \overline{x}^{\,2}\bigr) && \text{(on développe le carré)} \\
&= \frac{1}{n}\sum_{i=1}^{p} n_i x_i^{\,2} - 2\overline{x}\cdot\frac{1}{n}\sum_{i=1}^{p} n_i x_i + \overline{x}^{\,2}\cdot\frac{1}{n}\sum_{i=1}^{p} n_i && \text{(on sépare la somme)} \\
&= \overline{x^2} - 2\overline{x}\cdot\overline{x} + \overline{x}^{\,2}\cdot 1 && \text{(on reconna\^it } \overline{x^2},\ \overline{x},\ 1 \text{)} \\
&= \overline{x^2} - \overline{x}^{\,2}. \end{aligned}$$
Exemple
Pour les \(20\) brebis (\(\overline{x} = 1{,}45\)), la moyenne des carrés est $$\overline{x^2} = \frac{1}{20}\bigl(3\cdot 0^2 + 7\cdot 1^2 + 8\cdot 2^2 + 2\cdot 3^2\bigr) = \frac{0 + 7 + 32 + 18}{20} = \frac{57}{20} = 2{,}85,$$ donc \(V = 2{,}85 - 1{,}45^2 = 2{,}85 - 2{,}1025 = 0{,}7475\) et \(\sigma = \sqrt{0{,}7475} \approx 0{,}86\) agneau. Exemple
Deux lots de \(5\) résistances ont la même moyenne \(100\,\Omega\). Le lot A vaut \(98, 99, 100, 101, 102\) et le lot B vaut \(90, 95, 100, 105, 110\). Par König–Huygens, \(V_A = \frac{98^2 + 99^2 + 100^2 + 101^2 + 102^2}{5} - 100^2 = 2\), tandis que \(V_B = \frac{90^2 + 95^2 + 100^2 + 105^2 + 110^2}{5} - 100^2 = 50\). Même moyenne, mais \(\sigma_B = \sqrt{50} \approx 7{,}07\,\Omega\) vaut cinq fois \(\sigma_A = \sqrt{2} \approx 1{,}41\,\Omega\) : le lot B est bien moins régulier. Méthode — Calculer une variance
Calculer d'abord \(\overline{x}\). Puis, soit sommer les carrés des écarts \(n_i(x_i - \overline{x})^2\) (fidèle à la définition), soit, en général plus rapide, calculer \(\overline{x^2} = \frac{1}{n}\sum n_i x_i^{\,2}\) et soustraire \(\overline{x}^{\,2}\) par König–Huygens. Prendre la racine carrée pour \(\sigma\). Un résultat négatif signale une erreur de calcul, car \(V \ge 0\) toujours. Compétences à pratiquer
- Calculer variance et écart-type
II.3
Quartiles et diagramme en boîte
La médiane partage la série en deux ; les quartiles la partagent en quatre et les déciles en dix. Ils donnent une image robuste de la dispersion qui, contrairement à l'écart-type, n'est pas affectée par quelques valeurs extrêmes.
Définition — Quartiles, déciles et écart interquartile
Les valeurs étant ordonnées croissamment, le premier quartile \(Q_1\) est la plus petite valeur telle qu'au moins \(25\pourcent\) des données soient \(\le Q_1\), et le troisième quartile \(Q_3\) est la plus petite valeur telle qu'au moins \(75\pourcent\) des données soient \(\le Q_3\). La médiane est le deuxième quartile. Plus finement, les déciles \(D_1, \dots, D_9\) découpent la série ordonnée en dix parts égales, \(D_k\) étant la plus petite valeur telle qu'au moins \(\frac{k}{10}\) des données soient \(\le D_k\). L'écart interquartile est \(\mathrm{IQR} = Q_3 - Q_1\) ; il contient la moitié centrale des valeurs. Exemple
Le pH de \(12\) échantillons de sol, ordonné, est \(5{,}1,\ 5{,}4,\ 5{,}6,\ 5{,}8,\ 6{,}0,\ 6{,}1,\ 6{,}3,\ 6{,}4,\ 6{,}6,\ 6{,}9,\ 7{,}1,\ 7{,}4\). Avec \(n = 12\) : \(\frac{n}{4} = 3\), donc \(Q_1\) est la \(3\)\textsuperscript{e} valeur \(5{,}6\) ; \(\frac{3n}{4} = 9\), donc \(Q_3\) est la \(9\)\textsuperscript{e} valeur \(6{,}6\). La médiane est la demi-somme des \(6\)\textsuperscript{e} et \(7\)\textsuperscript{e} valeurs, \(\mathrm{Me} = \frac{6{,}1 + 6{,}3}{2} = 6{,}2\). Donc \(\mathrm{IQR} = 6{,}6 - 5{,}6 = 1{,}0\). Un diagramme en boîte affiche ce résumé en cinq nombres : 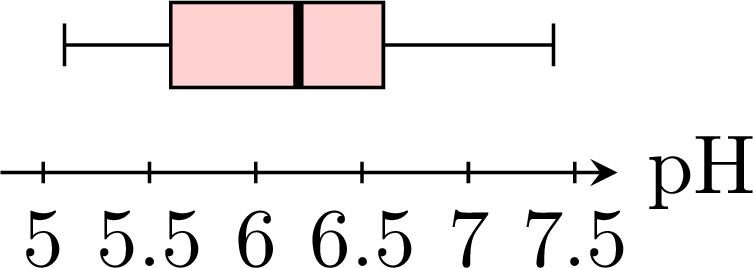
Exemple
Les masses (g) de \(5\) mulots, ordonnées, sont \(18, 21, 22, 25, 30\). Avec \(n = 5\) : \(\frac{n}{4} = 1{,}25\), arrondi au rang supérieur \(2\), donc \(Q_1 = 21\) ; \(\frac{3n}{4} = 3{,}75\), arrondi au rang supérieur \(4\), donc \(Q_3 = 25\), et \(\mathrm{IQR} = 25 - 21 = 4\) g mesure la dispersion des masses centrales. Méthode — Déterminer les quartiles
Ordonner les valeurs. Calculer \(\frac{n}{4}\) et \(\frac{3n}{4}\) : si le quotient n'est pas entier, arrondir au rang supérieur ; s'il est entier, la convention ici prend ce rang même. Lire \(Q_1\) et \(Q_3\) à ces rangs ; l'IQR est leur différence. Les déciles se lisent de même aux rangs \(\frac{kn}{10}\). Compétences à pratiquer
- Déterminer quartiles, déciles et écart interquartile
III
Séries à deux variables
III.1
Série double et nuage de points
On observe maintenant deux caractères quantitatifs sur les mêmes \(n\) individus, ce qui donne \(n\) couples \((x_i, y_i)\). Représenter ces couples par des points révèle d'un coup d'\oe il si les deux caractères tendent à varier ensemble.
Définition — Série double, nuage de points et point moyen
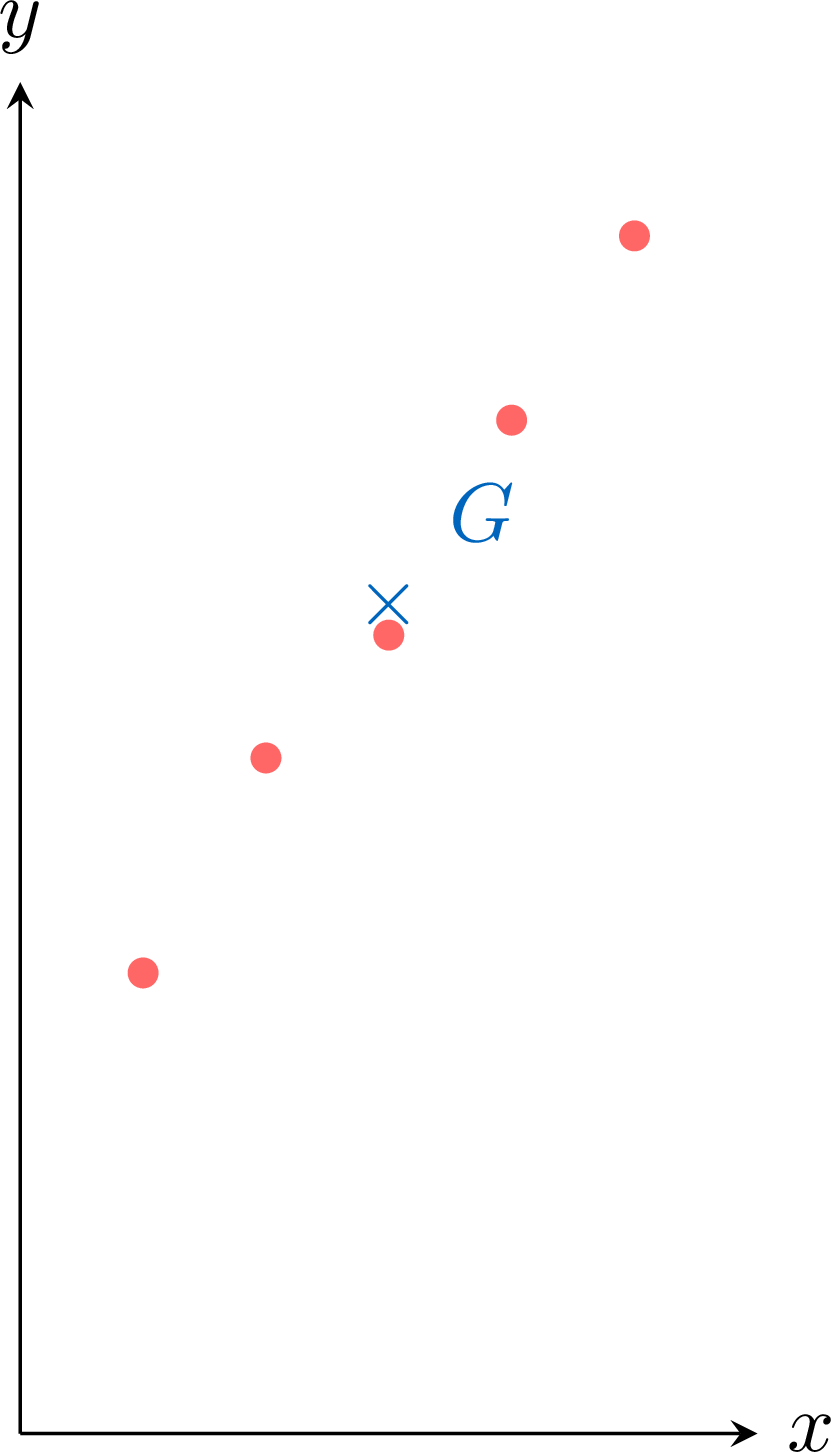
Une série double est une liste de \(n\) couples \((x_i, y_i)\), \(1 \le i \le n\). Le nuage de points est l'ensemble des points de coordonnées \((x_i, y_i)\) dans le plan. Le point moyen \(G\) a pour coordonnées \((\overline{x}, \overline{y})\), les moyennes des deux caractères ; c'est le centre de gravité du nuage. Exemple
Sur \(5\) lézards on mesure la température corporelle \(x\) (en \(^{\circ}\)C) et la vitesse de course \(y\) (en cm/s) : | \(x_i\) | \(20\) | \(24\) | \(28\) | \(32\) | \(36\) |
| \(y_i\) | \(15\) | \(22\) | \(26\) | \(33\) | \(39\) |
Exemple
Sur \(4\) panneaux isolants on mesure l'épaisseur \(x\) (cm) et la résistance thermique \(y\) : les couples sont \((6 ; 1{,}5)\), \((9 ; 2{,}2)\), \((11 ; 2{,}8)\), \((14 ; 3{,}5)\). Le point moyen est $$G\Bigl(\tfrac{6+9+11+14}{4} ;\ \tfrac{1{,}5+2{,}2+2{,}8+3{,}5}{4}\Bigr) = G(10 ; 2{,}5),$$ à nouveau au c\oe ur du nuage croissant. Compétences à pratiquer
- Tracer des nuages et placer le point moyen
III.2
Covariance et corrélation
La covariance mesure comment les deux caractères varient ensemble : positive quand ils tendent à croître ensemble, négative quand l'un croît tandis que l'autre décroît. Diviser par les deux écarts-types supprime les unités et donne le coefficient de corrélation, un nombre pur compris entre \(-1\) et \(1\).
Définition — Covariance
La covariance de la série double \((x_i, y_i)\) est la moyenne des produits des écarts : $$\mathrm{cov}(x, y) = \frac{1}{n}\sum_{i=1}^{n} (x_i - \overline{x})(y_i - \overline{y}).$$ Proposition — König–Huygens pour la covariance
La covariance est égale à la moyenne des produits moins le produit des moyennes : $$\mathrm{cov}(x, y) = \frac{1}{n}\sum_{i=1}^{n} x_i y_i - \overline{x}\,\overline{y} = \overline{xy} - \overline{x}\,\overline{y}.$$ En particulier \(\mathrm{cov}(x, x) = V_x\), la variance de \(x\).
On développe le produit dans la somme de définition, exactement comme pour la variance : $$\begin{aligned} \mathrm{cov}(x, y) &= \frac{1}{n}\sum_{i=1}^{n} (x_i - \overline{x})(y_i - \overline{y}) \\
&= \frac{1}{n}\sum_{i=1}^{n} \bigl(x_i y_i - \overline{y}\,x_i - \overline{x}\,y_i + \overline{x}\,\overline{y}\bigr) && \text{(on développe le produit)} \\
&= \overline{xy} - \overline{y}\cdot\overline{x} - \overline{x}\cdot\overline{y} + \overline{x}\,\overline{y} && \text{(on sépare, avec } \tfrac1n\textstyle\sum x_i = \overline{x} \text{)} \\
&= \overline{xy} - \overline{x}\,\overline{y}. \end{aligned}$$ En prenant \(y = x\) on obtient \(\mathrm{cov}(x, x) = \overline{x^2} - \overline{x}^{\,2} = V_x\).
Définition — Coefficient de corrélation
Lorsque \(\sigma_x > 0\) et \(\sigma_y > 0\), le coefficient de corrélation linéaire de la série double est $$r = \frac{\mathrm{cov}(x, y)}{\sigma_x\,\sigma_y}.$$ Proposition — Domaine du coefficient de corrélation
Le coefficient de corrélation vérifie toujours \(-1 \le r \le 1\). De plus \(r = 1\) (resp. \(r = -1\)) exactement lorsque les points sont alignés sur une même droite croissante (resp. décroissante). Plus \(|r|\) est proche de \(1\), plus le nuage est aligné ; plus il est proche de \(0\), moins il l'est.
L'inégalité \(-1 \le r \le 1\) est admise ici : elle découle directement de l'inégalité de Cauchy–Schwarz appliquée aux écarts \((x_i - \overline{x})\) et \((y_i - \overline{y})\), le cas d'égalité donnant exactement l'alignement parfait des points. Attention : \(r\) ne mesure que l'alignement linéaire ; un nuage peut suivre une forte courbe (par exemple une parabole) et avoir pourtant un \(r\) proche de \(0\).
Exemple
Pour les \(5\) lézards, \(\overline{x} = 28\) et \(\overline{y} = 27\). Les écarts et leurs produits sont : | \(x_i - \overline{x}\) | \(y_i - \overline{y}\) | produit | \((x_i - \overline{x})^2\) |
| \(-8\) | \(-12\) | \(96\) | \(64\) |
| \(-4\) | \(-5\) | \(20\) | \(16\) |
| \(0\) | \(-1\) | \(0\) | \(0\) |
| \(4\) | \(6\) | \(24\) | \(16\) |
| \(8\) | \(12\) | \(96\) | \(64\) |
Méthode — Calculer covariance et corrélation
Calculer \(\overline{x}\) et \(\overline{y}\). Puis obtenir \(\mathrm{cov}(x, y)\) soit par les écarts \((x_i - \overline{x})(y_i - \overline{y})\), soit, plus vite, par \(\overline{xy} - \overline{x}\,\overline{y}\). Calculer \(\sigma_x\) et \(\sigma_y\) par König–Huygens, puis \(r = \frac{\mathrm{cov}(x, y)}{\sigma_x \sigma_y}\). Contrôle : \(r\) doit tomber dans \([-1, 1]\) et avoir le signe de la covariance. Compétences à pratiquer
- Calculer la covariance et le coefficient de corrélation
III.3
Ajustement affine par les moindres carrés
Lorsqu'un nuage est à peu près aligné, on le résume par une droite \(y = ax + b\) servant à prédire \(y\) à partir de \(x\). Parmi toutes les droites, la droite des moindres carrés est celle qui minimise la somme des carrés des écarts verticaux aux points ; ses formules font intervenir exactement la covariance et la variance rencontrées.
Définition — Droite des moindres carrés
La droite de régression de \(y\) en \(x\) par les moindres carrés est la droite \(y = ax + b\) qui minimise la somme des carrés des écarts verticaux \(\displaystyle\sum_{i=1}^{n}\bigl(y_i - (ax_i + b)\bigr)^2\). Proposition — Coefficients de la régression
Si \(V_x > 0\), la droite des moindres carrés de \(y\) en \(x\) existe et est unique ; sa pente et son ordonnée à l'origine sont $$a = \frac{\mathrm{cov}(x, y)}{V_x}, \qquad b = \overline{y} - a\,\overline{x}.$$ En particulier la droite passe par le point moyen \(G(\overline{x}, \overline{y})\). L'optimalité de ces coefficients est admise. Exemple
Pour les \(5\) lézards, \(\mathrm{cov}(x, y) = 47{,}2\) et \(V_x = 32\), donc la pente est \(a = \frac{47{,}2}{32} = 1{,}475\) et l'ordonnée à l'origine est \(b = 27 - 1{,}475 \times 28 = 27 - 41{,}3 = -14{,}3\). La droite de régression \(y = 1{,}475\,x - 14{,}3\) passe par \(G(28, 27)\) et ajuste le nuage : 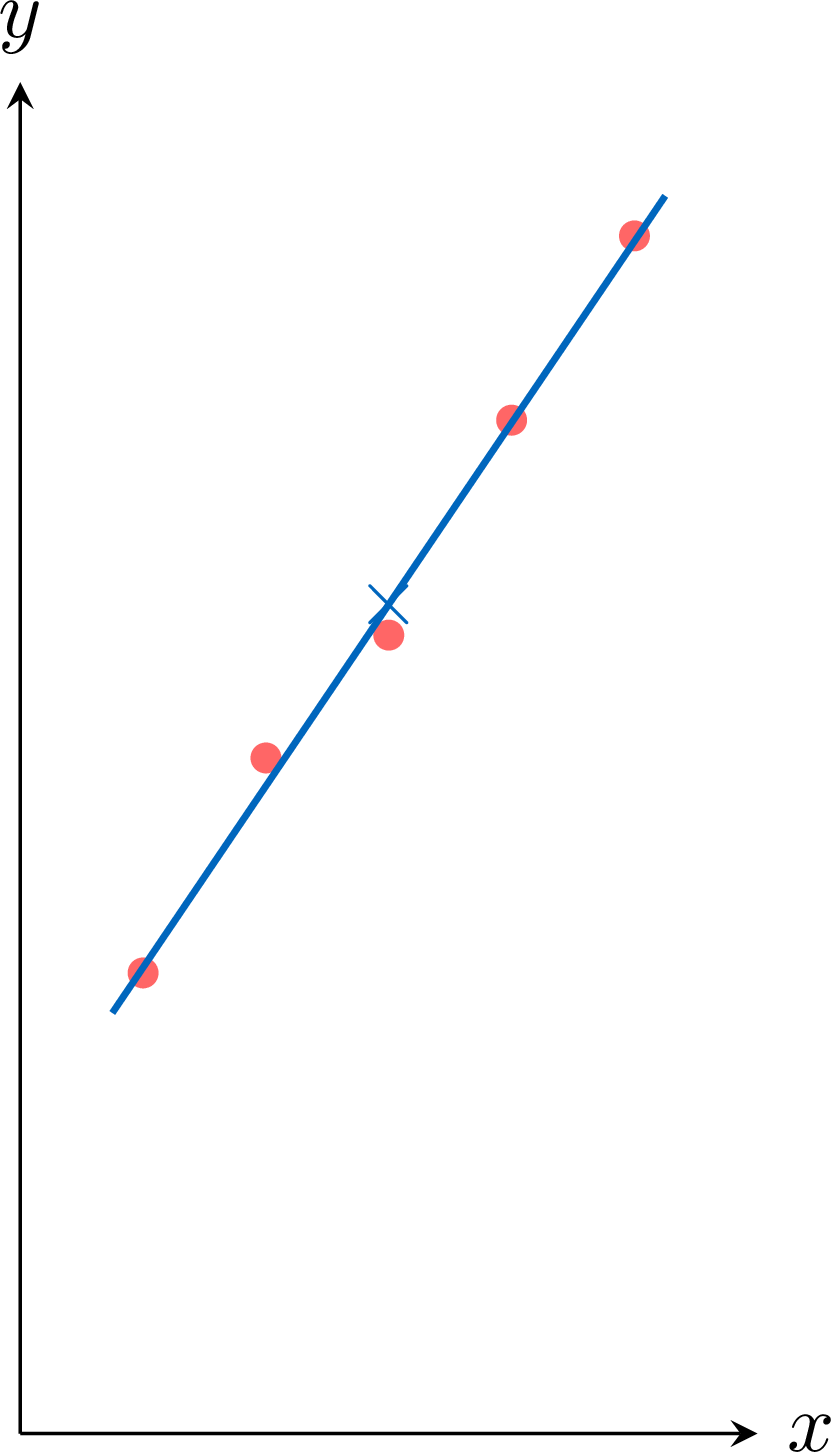
Exemple
Pour les \(4\) panneaux isolants, on trouve \(\mathrm{cov}(x, y) = 2{,}15\) et \(V_x = 8{,}5\), donc \(a = \frac{2{,}15}{8{,}5} \approx 0{,}253\) et \(b = 2{,}5 - 0{,}253 \times 10 \approx -0{,}03\). La droite ajustée \(y \approx 0{,}253\,x - 0{,}03\) prédit, pour un panneau de \(20\) cm, une résistance thermique \(y \approx 0{,}253 \times 20 - 0{,}03 \approx 5{,}0\) — valeur bien au-delà des épaisseurs observées, donc à n'utiliser qu'avec prudence. Méthode — Ajuster et exploiter une droite de régression
Vérifier d'abord, via \(r\) et un coup d'\oe il au nuage de points, qu'un ajustement linéaire est raisonnable. Calculer \(\overline{x}, \overline{y}, \mathrm{cov}(x, y), V_x\) ; puis \(a = \frac{\mathrm{cov}(x, y)}{V_x}\) et \(b = \overline{y} - a\overline{x}\). Pour prédire, substituer le \(x\) voulu dans \(y = ax + b\) ; rester dans le domaine observé de \(x\), car extrapoler loin au-dehors n'est pas fiable.
Pour aller plus loin
Les nombres de ce chapitre reviennent dans toutes les sciences expérimentales : la moyenne et l'écart-type résument toute série de mesures avec son incertitude, la droite de régression est l'outil quotidien des courbes d'étalonnage en chimie et des études dose-réponse en biologie, et le coefficient de corrélation quantifie la force du lien entre deux variables — sans jamais, à lui seul, prouver que l'une cause l'autre. Les chapitres probabilistes à venir réinterpréteront la moyenne comme une espérance et la variance comme la dispersion d'une variable aléatoire, transformant ces outils descriptifs en instruments d'inférence.
Compétences à pratiquer
- Ajuster une droite de régression et prédire
IV
Pour aller plus loin
Compétences à pratiquer
- Transformations affines et linéarisation de lois
Aller à la section