Éducation Nationale Française · Terminale Spécialité
Sommes de variables aléatoires, concentration, loi des grands nombres
I
Somme de deux variables aléatoires : espérance et variance
I.1
Espérance et variance
Définition — Espérance
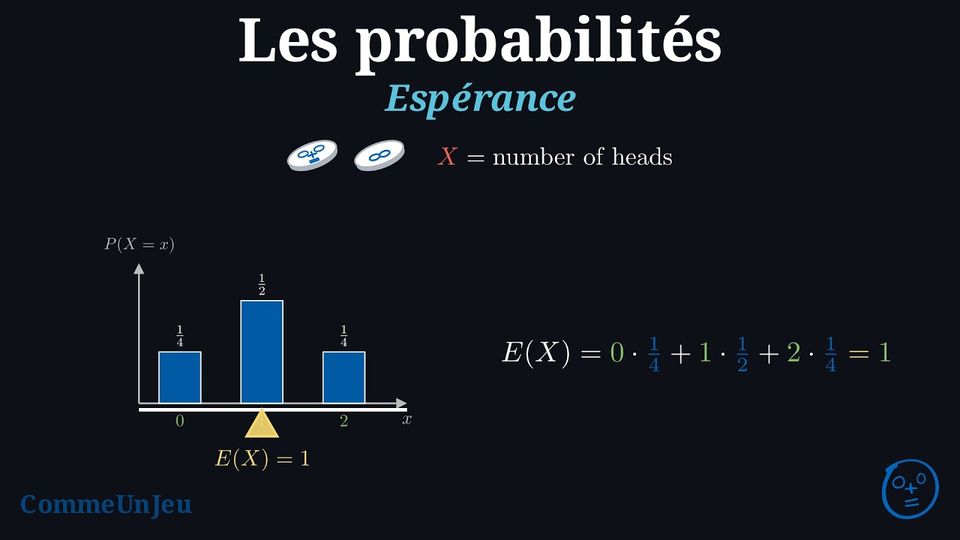
Soit \(X\) une variable aléatoire prenant les valeurs \(x_1, x_2, \ldots, x_n\). L'espérance de \(X\), notée \(E(X)\) et aussi appelée moyenne, est :$$\begin{aligned}E(X) &= \sum_{i=1}^{n} x_i P(X = x_i)\\
&= x_1 P(X = x_1) + x_2 P(X = x_2) + \cdots + x_n P(X = x_n)\\
\end{aligned}$$ 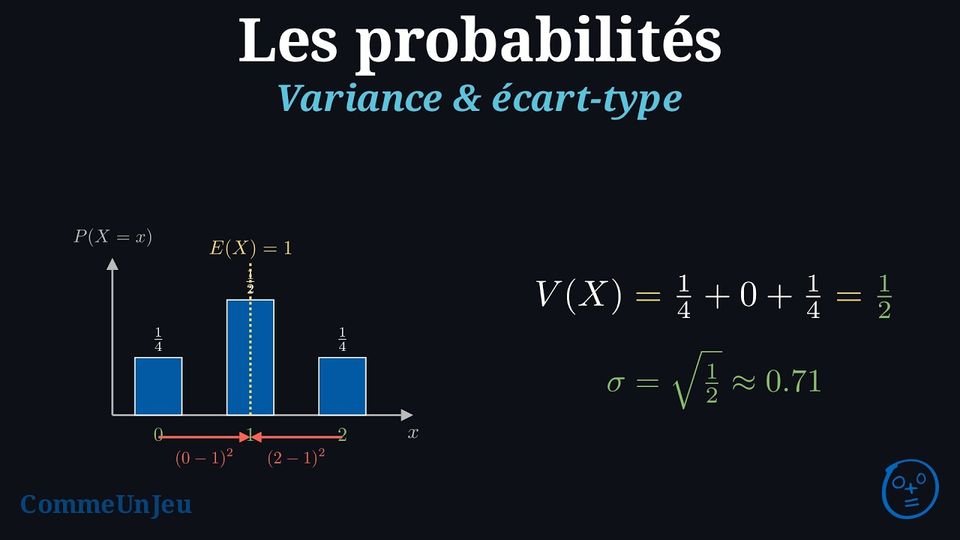
Définition — Variance et écart-type
La variance, notée \(V(X)\), est :$$\begin{aligned}V(X) &= \sum_{i=1}^{n} (x_i - E(X))^2 P(X = x_i)\\
&= \left(x_1-E(X)\right)^2 P(X = x_1) + \left(x_2-E(X)\right)^2 P(X = x_2) + \cdots + \left(x_n-E(X)\right)^2 P(X = x_n)\\
\end{aligned}$$ L’écart-type, noté \(\sigma(X)\), est \(\sigma(X) = \sqrt{V(X)}\). Compétences à pratiquer
- Calculer des espérances
I.2
Somme et produit par un réel
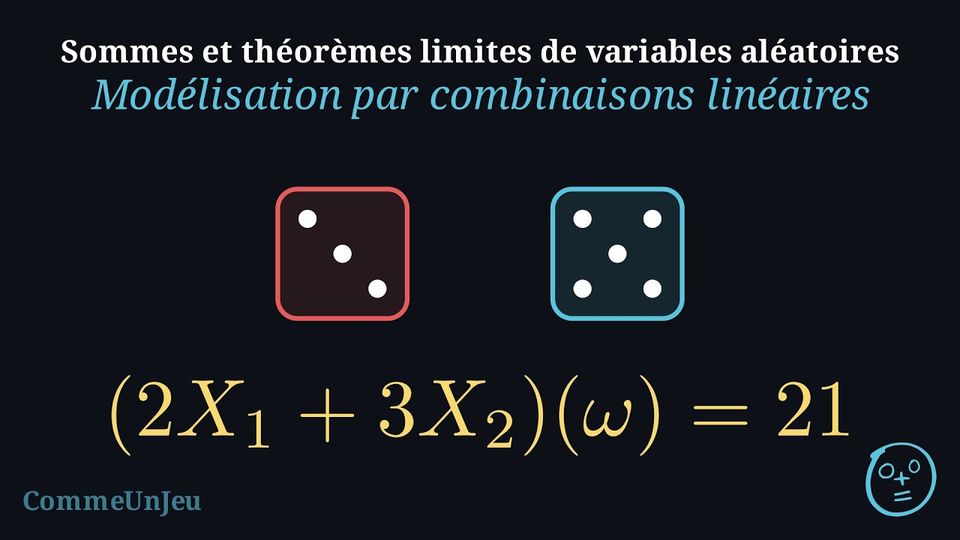
En théorie des probabilités, on analyse souvent des situations qui résultent de la répétition d'une même expérience ou de la combinaison de plusieurs phénomènes aléatoires. Pour les modéliser, on introduit de nouvelles variables aléatoires comme des sommes, des moyennes, ou plus généralement des combinaisons linéaires de variables plus simples.
Par exemple, le profit total sur une semaine est la somme des profits quotidiens.
Par exemple, le profit total sur une semaine est la somme des profits quotidiens.
Définition — Somme et produit par un réel
Soient \(X\) et \(Y\) deux variables aléatoires définies sur le même univers fini \(\Omega\), c'est-à-dire sur la même expérience aléatoire (toutes les variables aléatoires de ce chapitre prennent un nombre fini de valeurs, leurs espérances et leurs variances existent donc). La somme \(X + Y\) est la variable aléatoire qui, à chaque issue \(\omega\), associe \(X(\omega) + Y(\omega)\) ; pour un réel \(a\), le produit \(aX\) associe \(a \times X(\omega)\). Plus généralement, pour des réels \(a_1, \dots, a_n\), \(a_1 X_1 + \dots + a_n X_n\) est une variable aléatoire, combinaison linéaire de \(X_1, \dots, X_n\). Définition — Variables aléatoires indépendantes
Dans une succession d'épreuves indépendantes, des variables aléatoires qui ne dépendent chacune que du résultat de leur propre épreuve, les épreuves étant distinctes, sont indépendantes : les valeurs prises par certaines d'entre elles ne modifient pas les probabilités des valeurs prises par les autres, conjointement. Cela vaut pour toute la famille \(X_1, \dots, X_n\) (indépendance mutuelle). C'est la situation de ce chapitre : l'indépendance vient du modèle de l'expérience, elle n'est jamais à démontrer. Exemple
Dans chaque cas, dire si les variables aléatoires sont indépendantes. - \(X_1\) et \(X_2\), les résultats de deux dés équilibrés lancés ensemble, les deux lancers étant indépendants.
- On tire au hasard une boule de l'urne ci-dessous, on la remet et on mélange, puis on tire au hasard une seconde boule ; \(X_1 = 1\) si la première boule est rouge et \(0\) sinon, \(X_2\) de même pour la seconde.
- Les deux mêmes tirages, sans remise.
- \(X\) le résultat d'un dé équilibré et \(Y = 2X\).
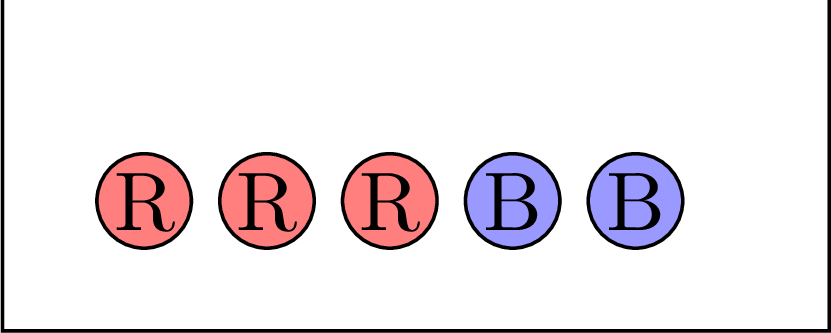
Une urne : trois boules rouges, deux boules bleues
- Oui : deux épreuves distinctes d'une succession d'épreuves indépendantes, chaque variable lisant son propre dé.
- Oui : avec remise, les deux tirages sont des épreuves indépendantes et chaque variable lit son propre tirage.
- Non : \(P(X_2 = 1) = \frac{3}{5}\), mais après une première boule rouge \(P_{(X_1 = 1)}(X_2 = 1) = \frac{2}{4}\) et après une bleue \(P_{(X_1 = 0)}(X_2 = 1) = \frac{3}{4}\). Le premier résultat modifie les probabilités du second.
- Non : connaître \(X\) donne \(Y\). Par exemple \(P(Y = 12) = \frac{1}{6}\), mais une fois \(X = 6\) connu, \(Y = 12\) est certain.
Compétences à pratiquer
- Modéliser des situations avec des sommes et des moyennes
I.3
Linéarité de l'espérance et variance d'une somme
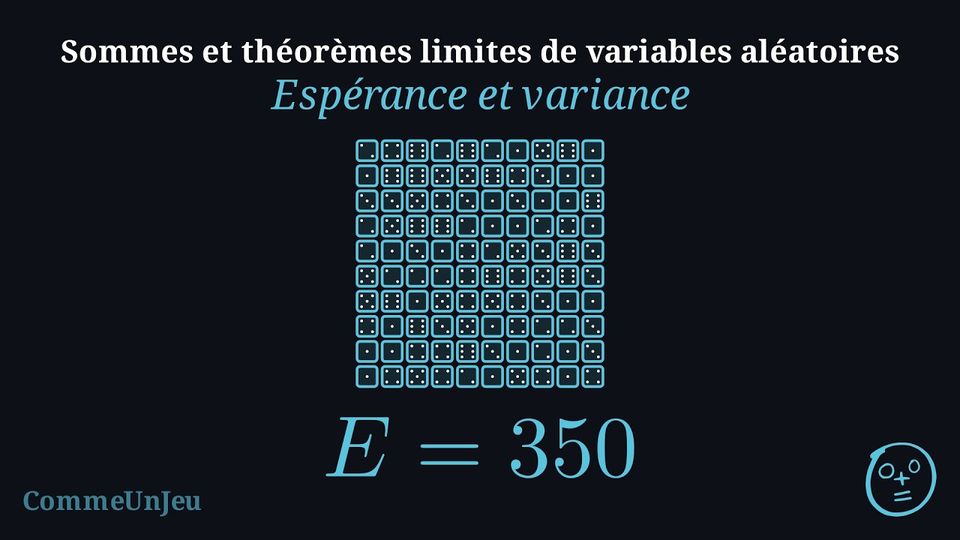
Lorsqu'une variable aléatoire est définie comme la somme ou la moyenne d'autres variables, déterminer sa loi de probabilité peut être très laborieux (par exemple, établir la loi de la somme de \(100\) dés).
Heureusement, grâce à la linéarité de l'espérance et à l'additivité de la variance (en cas d'indépendance), on peut calculer l'espérance et la variance de ces combinaisons directement à partir des variables individuelles, sans établir la loi complète du résultat.
Heureusement, grâce à la linéarité de l'espérance et à l'additivité de la variance (en cas d'indépendance), on peut calculer l'espérance et la variance de ces combinaisons directement à partir des variables individuelles, sans établir la loi complète du résultat.
Proposition — Linéarité de l'espérance
Pour des variables aléatoires \(X\) et \(Y\) définies sur le même univers et tout réel \(a\) : $$E(X + Y) = E(X) + E(Y) \qquad \text{et} \qquad E(aX) = a\,E(X).$$ Par conséquent, pour des réels \(a\) et \(b\) : \(E(aX + bY) = aE(X) + bE(Y)\), \(E(X - Y) = E(X) - E(Y)\), \(E(X + b) = E(X) + b\), et pour \(n\) variables \(E(X_1 + \dots + X_n) = E(X_1) + \dots + E(X_n)\).Aucune indépendance n'est requise. Cette propriété est admise : sa démonstration écrit l'espérance comme une moyenne pondérée sur les issues de l'expérience.
Exemple
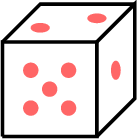
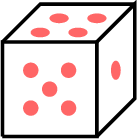
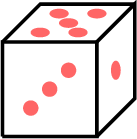
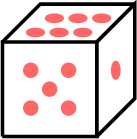
On lance une fois un dé équilibré et on joue à deux jeux sur le même lancer. Le jeu 1 rapporte \(10\) euros si le nombre est pair et \(5\) euros sinon. Le jeu 2 rapporte \(5\) euros si le nombre est \(1\) ou \(2\), \(2\) euros si c'est \(3\), et rien sinon. Soit \(X\) le gain au jeu 1, \(Y\) le gain au jeu 2 et \(Z = X + Y\) le gain total. 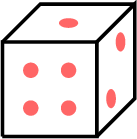

- Calculer \(E(X)\) et \(E(Y)\).
- Déterminer la loi de \(Z\) et calculer \(E(Z)\).
- Vérifier la linéarité de l'espérance sur cet exemple.
- \(X\) prend les valeurs \(10\) et \(5\) avec la probabilité \(\frac{1}{2}\) chacune : \(E(X) = 10 \times \frac{1}{2} + 5 \times \frac{1}{2} = 7{,}5\). \(Y\) prend la valeur \(5\) avec la probabilité \(\frac{2}{6}\), \(2\) avec la probabilité \(\frac{1}{6}\) et \(0\) avec la probabilité \(\frac{3}{6}\) : \(E(Y) = 5 \times \frac{2}{6} + 2 \times \frac{1}{6} = 2\).
- La valeur de \(Z\) pour chaque face :
face \(1\) \(2\) \(3\) \(4\) \(5\) \(6\) \(X\) (jeu 1) \(5\) \(10\) \(5\) \(10\) \(5\) \(10\) \(Y\) (jeu 2) \(5\) \(5\) \(2\) \(0\) \(0\) \(0\) \(Z = X + Y\) \(10\) \(15\) \(7\) \(10\) \(5\) \(10\) - \(E(X) + E(Y) = 7{,}5 + 2 = 9{,}5 = E(Z)\) : l'espérance de la somme est la somme des espérances, alors que \(X\) et \(Y\) sont lues sur le même lancer et sont loin d'être indépendantes. La linéarité donne \(E(Z)\) sans le tableau de \(Z\).
Proposition — Variance d'une somme de variables indépendantes
- Si \(X\) et \(Y\) sont indépendantes, alors \(V(X + Y) = V(X) + V(Y)\) (additivité, admise). Plus généralement, si \(X_1, \dots, X_n\) sont indépendantes, \(V(X_1 + \dots + X_n) = V(X_1) + \dots + V(X_n)\).
- Pour toute variable aléatoire \(X\) et tous réels \(a\) et \(b\) : \(V(aX) = a^2\,V(X)\) et \(\sigma(aX) = |a|\,\sigma(X)\). De plus \(V(aX + b) = a^2\,V(X)\) : comme \(E(aX + b) = E(aX) + b\), l'écart \((aX + b) - E(aX + b)\) est égal à \(aX - E(aX)\), donc ajouter \(b\) ne change pas la variance.
Pour le second point : par définition, \(V(Z) = E\bigl((Z - E(Z))^2\bigr)\) pour toute variable aléatoire \(Z\), l'espérance du carré de l'écart à la moyenne, et l'espérance est linéaire : $$\begin{aligned} V(aX) &= E\bigl((aX - E(aX))^2\bigr) && \text{(définition)}\\
&= E\bigl((aX - aE(X))^2\bigr) && \text{(} E(aX) = aE(X) \text{)}\\
&= E\bigl(a^2 (X - E(X))^2\bigr) && \text{(factorisation)}\\
&= a^2\,E\bigl((X - E(X))^2\bigr) = a^2\,V(X) && \text{(linéarité)}. \end{aligned}$$ Puis \(\sigma(aX) = \sqrt{a^2 V(X)} = |a|\,\sigma(X)\).
Exemple
Soit \(X\) le résultat d'un dé équilibré, \(V(X) = \dfrac{35}{12}\). Calculer \(V(X + X)\) et comparer avec \(V(X) + V(X)\). Que montre ce calcul ?
\(X + X = 2X\), donc \(V(X + X) = V(2X) = 4\,V(X) = \dfrac{35}{3}\), alors que \(V(X) + V(X) = 2\,V(X) = \dfrac{35}{6}\). Les deux diffèrent : \(X\) n'est pas indépendante d'elle-même, et l'additivité de la variance peut tomber en défaut sans indépendance, comme ici. Avec deux dés différents \(X_1\) et \(X_2\), indépendants, on a bien \(V(X_1 + X_2) = \dfrac{35}{6}\).
Méthode — Représenter une variable comme une somme
Pour calculer l'espérance, ou la variance, d'une variable \(X\) qui compte ou additionne quelque chose au fil de plusieurs étapes : - Repérer les étapes de l'expérience (épreuve \(1\), …, épreuve \(n\)).
- Définir une variable simple \(X_i\) sur chaque étape : un résultat, ou une indicatrice valant \(1\) si un événement se produit et \(0\) sinon.
- Écrire \(X = X_1 + \dots + X_n\) et expliquer pourquoi l'égalité vaut pour toute issue : ce que chaque terme apporte.
- Additionner : \(E(X) = E(X_1) + \dots + E(X_n)\) toujours ; \(V(X) = V(X_1) + \dots + V(X_n)\) quand les \(X_i\) sont indépendantes (sans indépendance, l'additivité peut tomber en défaut).
Exemple
Des cartes numérotées de \(1\) à \(n\) sont mélangées puis disposées au hasard en ligne, sur des places numérotées de \(1\) à \(n\). Une carte est à sa place quand la carte numéro \(k\) occupe la place \(k\). Soit \(X\) le nombre de cartes à leur place. Calculer \(E(X)\). 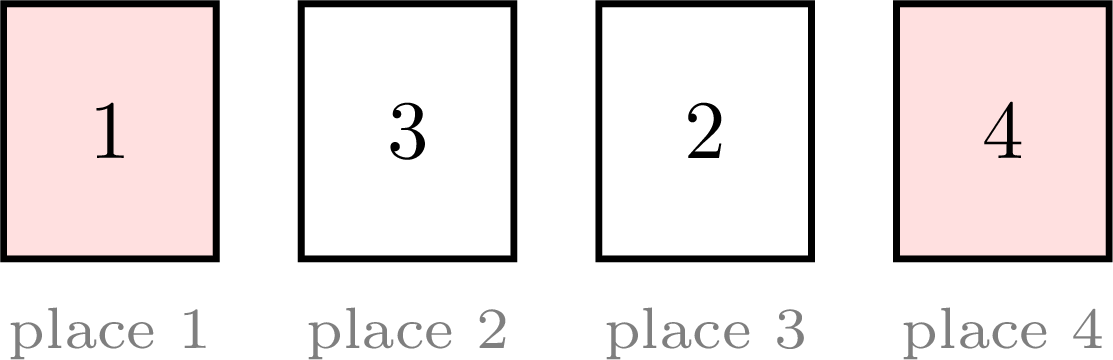
Pour \(i\) de \(1\) à \(n\), soit \(X_i = 1\) si la carte \(i\) se trouve à la place \(i\) et \(X_i = 0\) sinon. Alors \(X = X_1 + \dots + X_n\) : la somme compte les cartes à leur place. La carte qui occupe la place \(i\) a autant de chances d'être n'importe laquelle des \(n\) cartes, donc \(P(X_i = 1) = \dfrac{1}{n}\) et \(E(X_i) = \dfrac{1}{n}\). Par linéarité, $$E(X) = E(X_1) + \dots + E(X_n) = n \times \frac{1}{n} = 1,$$ quel que soit le nombre de cartes. Pour \(n \ge 2\) les \(X_i\) ne sont pas indépendantes (si \(n - 1\) cartes sont à leur place, la dernière l'est aussi) et la loi de \(X\) serait difficile à établir : la linéarité n'a besoin ni de l'une ni de l'autre.
Exemple
Soient \(X_1\) et \(X_2\) les résultats du lancer de deux dés équilibrés. Pour un dé, on sait que \(E(X_1)=3{,}5\) et \(V(X_1)=\dfrac{35}{12}\approx 2{,}92\). - L'espérance de la somme est \(E(X_1+X_2)=E(X_1)+E(X_2)=3{,}5+3{,}5=7\).
- Les dés étant indépendants, la variance de la somme est \(V(X_1+X_2)=V(X_1)+V(X_2)=\dfrac{70}{12}\approx 5{,}83\).
Compétences à pratiquer
- Analyser des sommes, des combinaisons linéaires et leurs paramètres
- Calculer les paramètres d'une combinaison linéaire
II
Somme de variables indépendantes suivant la même loi
II.1
Somme de variables de Bernoulli et loi binomiale
Proposition — Somme de variables de Bernoulli et loi binomiale
- Si \(X_1, \dots, X_n\) sont des variables de Bernoulli indépendantes de même paramètre \(p\), alors \(X_1 + \dots + X_n\) suit la loi binomiale \(\mathcal{B}(n\,;\,p)\).
- Réciproquement, une variable \(X \sim \mathcal{B}(n\,;\,p)\), nombre de succès d'un schéma de Bernoulli, se décompose en \(X = X_1 + \dots + X_n\), où \(X_i = 1\) si l'épreuve \(i\) est un succès et \(X_i = 0\) sinon ; les \(X_i\) sont des variables de Bernoulli indépendantes de paramètre \(p\).
Chaque \(X_i\) est l'indicatrice d'un succès dans une épreuve de Bernoulli de paramètre \(p\) ; les \(n\) épreuves sont identiques (même \(p\)) et indépendantes : elles forment un schéma de Bernoulli. La somme \(X_1 + \dots + X_n\) ajoute \(1\) à chaque succès et \(0\) à chaque échec, donc elle compte les succès du schéma, et le nombre de succès d'un schéma de Bernoulli suit \(\mathcal{B}(n\,;\,p)\). Réciproquement, quand \(X\) compte les succès d'un schéma, définir \(X_i\) comme l'indicatrice d'un succès à l'épreuve \(i\) donne \(n\) variables de Bernoulli indépendantes de paramètre \(p\) (chacune lit sa propre épreuve), et leur somme compte exactement les succès : \(X = X_1 + \dots + X_n\).
Exemple
La fonction Python bernoulli(p) ci-dessous renvoie \(1\) avec la probabilité \(p\) et \(0\) sinon. import random
def bernoulli(p):
if random.random() < p:
return 1
return 0
def binomial(n, p):
s = 0
for i in range(n):
s = s + bernoulli(p)
return s
print(binomial(50, 0.21))- Expliquer pourquoi
bernoulli(p)simule une variable de Bernoulli de paramètre \(p\). - Expliquer pourquoi la valeur renvoyée par
binomial(n, p)suit la loi binomiale \(\mathcal{B}(n\,;\,p)\). - Que simule
binomial(50, 0.21)?
-
random.random()renvoie un nombre uniformément réparti entre \(0\) et \(1\) ; il est inférieur à \(p\) avec la probabilité \(p\). La fonction renvoie \(1\) (succès) avec la probabilité \(p\) et \(0\) (échec) avec la probabilité \(1 - p\) : une variable de Bernoulli de paramètre \(p\). - La boucle appelle
bernoulli(p)\(n\) fois ; les appels sont indépendants et de même paramètre, donc les \(n\) valeurs sont des variables de Bernoulli indépendantes de paramètre \(p\). Leur sommessuit \(\mathcal{B}(n\,;\,p)\) d'après la proposition. - Une variable qui suit \(\mathcal{B}(50\,;\,0{,}21)\) : le nombre de succès de \(50\) épreuves indépendantes de probabilité \(0{,}21\), par exemple le nombre de pièces défectueuses dans un lot de \(50\) quand chaque pièce, indépendamment des autres, est défectueuse avec la probabilité \(0{,}21\).
Proposition — Espérance et variance d'une loi binomiale
Pour \(X \sim \mathcal{B}(n ; p)\) : - \(E(X) = n p\) (espérance),
- \(V(X) = n p (1 - p)\) (variance),
- \(\sigma(X) = \sqrt{n p (1 - p)}\) (écart-type).
La variable \(X\) compte les succès d'un schéma de Bernoulli de \(n\) épreuves de probabilité \(p\). Pour \(i\) de \(1\) à \(n\), soit \(X_i = 1\) si l'épreuve \(i\) est un succès et \(X_i = 0\) sinon : \(X_i\) suit la loi de Bernoulli de paramètre \(p\), donc \(E(X_i) = p\) et \(V(X_i) = p(1 - p)\), et \(X = X_1 + \dots + X_n\) puisque la somme ajoute \(1\) à chaque succès.
- Par linéarité de l'espérance : \(E(X) = E(X_1) + \dots + E(X_n) = np\).
- Les épreuves sont indépendantes, donc les \(X_i\) sont indépendantes et la variance est additive : \(V(X) = V(X_1) + \dots + V(X_n) = np(1 - p)\).
- D'où \(\sigma(X) = \sqrt{np(1 - p)}\).
Compétences à pratiquer
- Calculer la variance d'une loi binomiale
- Sommer des variables de Bernoulli et décomposer une variable binomiale
II.2
Échantillon de taille \(n\) : somme et moyenne
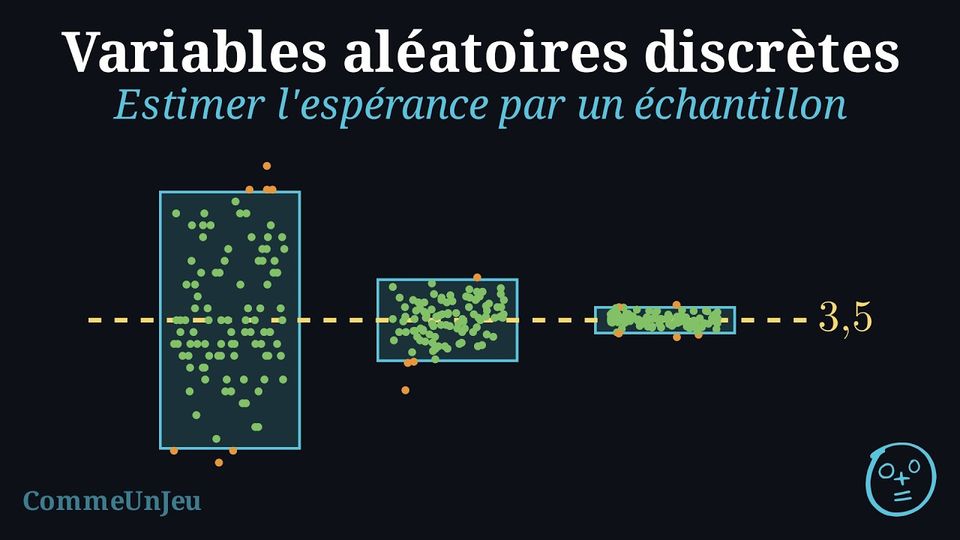
L'espérance est un nombre calculé à partir de la loi de probabilité de \(X\). On peut aussi l'approcher sans la loi, par l'observation : répéter l'expérience \(n\) fois de façon indépendante et dans les mêmes conditions, relever les \(n\) valeurs de \(X\) et calculer leur moyenne \(m\). C'est la loi des grands nombres, qui disait qu'une fréquence approche une probabilité ; ici la moyenne d'un échantillon approche l'espérance. La moyenne \(m\) fluctue d'un échantillon à l'autre, et la fluctuation se resserre quand \(n\) grandit. Les simulations montrent, sans le démontrer, que le plus souvent l'écart entre \(m\) et \(E(X)\) est au plus \(\dfrac{2\sigma(X)}{\sqrt{n}}\) ; un échantillon isolé peut encore tomber au-delà. Une simulation, par exemple avec Python, permettrait de le voir : une fonction qui tire \(n\) valeurs de \(X\) et renvoie leur moyenne.
Définition — Échantillon de taille \(n\)
Soit \(X\) une variable aléatoire et \(n \ge 1\) un entier. Un échantillon de taille \(n\) de la loi de \(X\) est une liste \((X_1\,;\,X_2\,;\,\dots\,;\,X_n)\) de \(n\) variables aléatoires indépendantes qui suivent toutes la loi de \(X\). Concrètement, l'expérience est répétée \(n\) fois dans des conditions identiques et indépendantes, et \(X_i\) est la valeur observée à la \(i\)-ième répétition.La somme de l'échantillon est \(S_n = X_1 + X_2 + \dots + X_n\) et sa moyenne est $$M_n = \frac{S_n}{n} = \frac{X_1 + X_2 + \dots + X_n}{n},$$ aussi notée \(\overline{X}_n\).
Exemple
On lance deux dés équilibrés à six faces. On note \(X_1\) le résultat du premier dé et \(X_2\) le résultat du second dé . - Le score total est \(S_2 = X_1 + X_2\).
- Le score moyen est \(M_2 = \dfrac{X_1 + X_2}{2}\).
Proposition — Espérance de la somme et de la moyenne d'un échantillon
Soit \((X_1\,;\,\dots\,;\,X_n)\) un échantillon de taille \(n\) de la loi d'une variable \(X\) d'espérance \(\mu = E(X)\). Alors $$E(S_n) = n\mu \qquad \text{et} \qquad E(M_n) = \mu.$$
Par linéarité de l'espérance :$$ \begin{aligned}E(S_n) &= E(X_1 + \cdots + X_n) = E(X_1) + \cdots + E(X_n) = n\mu,\\
E(M_n) &= E\!\left(\frac{S_n}{n}\right) = \frac{1}{n}E(S_n) = \frac{n\mu}{n} = \mu.\end{aligned} $$
Exemple
Si l'on lance \(n=10\) dés, l'espérance du score moyen par dé reste \(3{,}5\) :$$ E(M_{10}) = E(X_1) = 3{,}5. $$ Le score total attendu est \(E(S_{10}) = 10 \times 3{,}5 = 35\). Proposition — Variance de la somme et de la moyenne d'un échantillon
Soit \((X_1\,;\,\dots\,;\,X_n)\) un échantillon de taille \(n\) de la loi d'une variable \(X\) de variance \(V(X) = \sigma^2\) et d'écart-type \(\sigma\). Alors : - Pour la somme : $$V(S_n) = n\sigma^2 \quad \text{et} \quad \sigma(S_n) = \sigma\sqrt{n}.$$
- Pour la moyenne : $$V(M_n) = \frac{\sigma^2}{n} \quad \text{et} \quad \sigma(M_n) = \frac{\sigma}{\sqrt{n}}.$$
Les \(X_i\) sont indépendantes, donc la variance est additive, et \(V(aX) = a^2 V(X)\) :$$ \begin{aligned}V(S_n) &= V(X_1 + \cdots + X_n) = V(X_1) + \cdots + V(X_n) = n\sigma^2,\\
\sigma(S_n) &= \sqrt{V(S_n)} = \sqrt{n\sigma^2} = \sigma\sqrt{n},\\
V(M_n) &= V\!\left(\frac{1}{n}S_n\right) = \frac{1}{n^2}V(S_n) = \frac{n\sigma^2}{n^2} = \frac{\sigma^2}{n},\\
\sigma(M_n) &= \sqrt{V(M_n)} = \sqrt{\frac{\sigma^2}{n}} = \frac{\sigma}{\sqrt{n}}.\end{aligned} $$
Exemple
On considère le lancer de \(n=100\) dés. La variance de la moyenne \(M_{100}\) est :$$ V(M_{100}) = \frac{V(X_1)}{100} \approx \frac{2{,}92}{100} = 0{,}0292. $$ L'écart-type vaut \(\sigma(M_{100}) = \dfrac{\sigma(X_1)}{\sqrt{100}} \approx \dfrac{1{,}71}{10} = 0{,}171\).Comparée à celle d'un seul dé (\(\sigma \approx 1{,}71\)), la moyenne de \(100\) dés est beaucoup moins dispersée et donc beaucoup plus stable (elle se concentre autour de l'espérance).
Compétences à pratiquer
- Analyser la somme et la moyenne d'un échantillon
- Calculer les paramètres de la moyenne d'un échantillon
- Choisir \(n\) pour un écart-type de la moyenne donné
III
Inégalités de Bienaymé-Tchebychev et de concentration
III.1
L'inégalité de Bienaymé-Tchebychev
Lorsque l'on connaît l'espérance \(\mu\) et la variance \(V\) d'une variable aléatoire, on veut souvent savoir quelle est la probabilité que la variable prenne une valeur très éloignée de sa moyenne.
Les inégalités de concentration fournissent un moyen mathématique de majorer cette probabilité. Contrairement aux lois de probabilité spécifiques, ces inégalités fonctionnent pour n'importe quelle variable aléatoire, offrant une limite supérieure sur la probabilité d'un écart. Ces inégalités sont des outils fondamentaux qui serviront à démontrer rigoureusement la loi des grands nombres.
Les inégalités de concentration fournissent un moyen mathématique de majorer cette probabilité. Contrairement aux lois de probabilité spécifiques, ces inégalités fonctionnent pour n'importe quelle variable aléatoire, offrant une limite supérieure sur la probabilité d'un écart. Ces inégalités sont des outils fondamentaux qui serviront à démontrer rigoureusement la loi des grands nombres.
Théorème — Inégalité de Bienaymé-Tchebychev
Soit \(X\) une variable aléatoire d'espérance \(\mu\) et de variance \(V(X)\). Pour tout réel \(\delta>0\) :$$ P\bigl(|X-\mu|\ge \delta\bigr)\le \frac{V(X)}{\delta^2}. $$ Cette inégalité majore la probabilité que \(X\) s'écarte de son espérance d'au moins \(\delta\). Elle est admise. 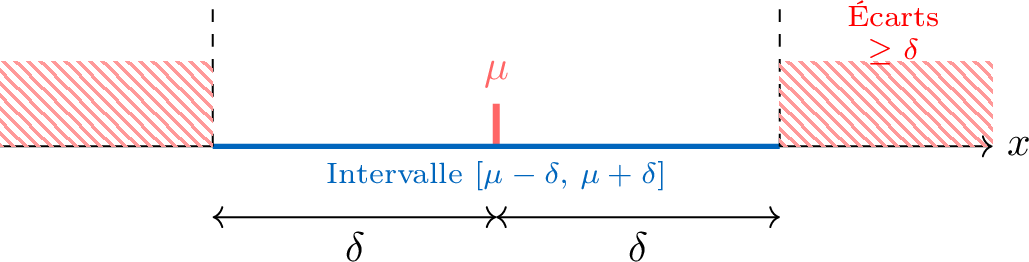
Exemple
Une usine produit des sacs de sucre de poids moyen \(\mu=1000\,\text{g}\) et de variance \(V(X)=25\). On cherche à majorer la probabilité que le poids d'un sac s'écarte de la moyenne de \(10\,\text{g}\) ou plus. Ici \(\delta=10\). D'après l'inégalité :$$ P(|X-1000|\ge 10)\le \frac{25}{10^2}=0{,}25. $$ Il y a au plus \(25\,\pourcent\) de chances qu'un sac soit en dehors de l'intervalle \([990,\,1010]\). Proposition — Écarts de \(k\) écarts-types
Soit \(X\) une variable aléatoire d'espérance \(\mu\) et d'écart-type \(\sigma > 0\). Pour tout réel \(k > 0\) : $$P\bigl(|X - \mu| \ge k\sigma\bigr) \le \frac{1}{k^2} \qquad \text{et} \qquad P\bigl(|X - \mu| < k\sigma\bigr) \ge 1 - \frac{1}{k^2}.$$ En particulier, un écart d'au moins \(2\sigma\) a une probabilité au plus \(\dfrac{1}{4}\), un écart d'au moins \(3\sigma\) au plus \(\dfrac{1}{9}\) : l'écart-type est l'unité naturelle pour mesurer de combien \(X\) s'éloigne de son espérance.
On applique l'inégalité de Bienaymé-Tchebychev avec \(\delta = k\sigma > 0\) : $$P\bigl(|X - \mu| \ge k\sigma\bigr) \le \frac{V(X)}{(k\sigma)^2} = \frac{\sigma^2}{k^2 \sigma^2} = \frac{1}{k^2}.$$ L'événement \(|X - \mu| < k\sigma\) est le contraire de \(|X - \mu| \ge k\sigma\), donc sa probabilité est au moins \(1 - \dfrac{1}{k^2}\).
Méthode — Majorer ou minorer une probabilité avec Bienaymé-Tchebychev
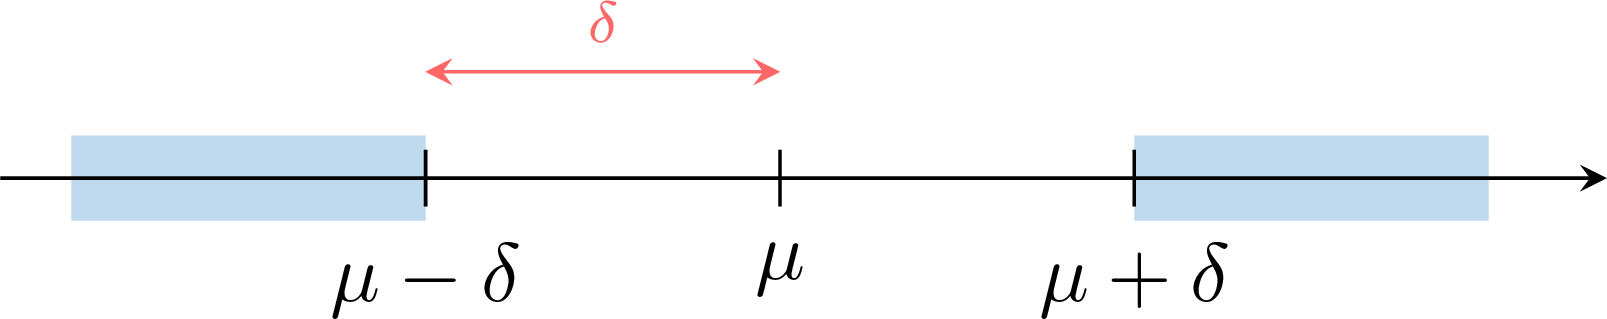
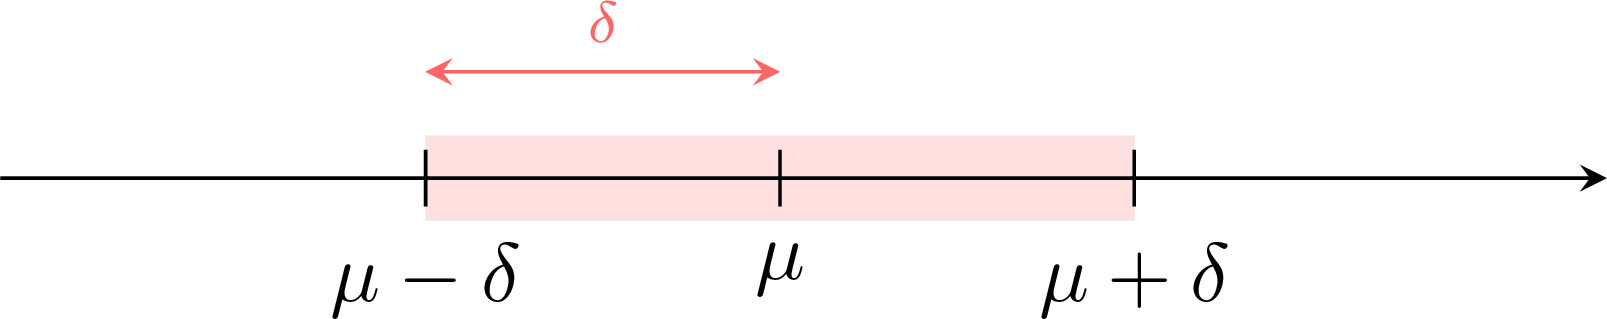
Pour encadrer une probabilité de la forme \(P(|X - \mu| \ge \delta)\), c'est-à-dire \(P(X \le \mu - \delta \text{ ou } X \ge \mu + \delta)\) : - Identifier \(\mu\), \(V\) et \(\delta\) : \(\delta\) est la distance de \(\mu\) aux bornes de l'intervalle, sa demi-largeur, pas sa largeur.
- Appliquer l'inégalité : \(P(|X - \mu| \ge \delta) \le \dfrac{V}{\delta^2}\).
- Pour une minoration de \(P(\mu - \delta < X < \mu + \delta)\), passer au contraire : \(P(|X - \mu| < \delta) \ge 1 - \dfrac{V}{\delta^2}\).
- Lire le résultat comme une borne, « au plus » ou « au moins », jamais comme la valeur de la probabilité.
Exemple
Soit \(X \sim \mathcal{B}(20\,;\,0{,}45)\), donc \(\mu = 9\) et \(\sigma = \sqrt{20 \times 0{,}45 \times 0{,}55} \approx 2{,}22\). - Majorer \(P(|X - 9| \ge 2\sigma)\) avec la proposition.
- Calculer cette probabilité à la calculatrice et commenter.
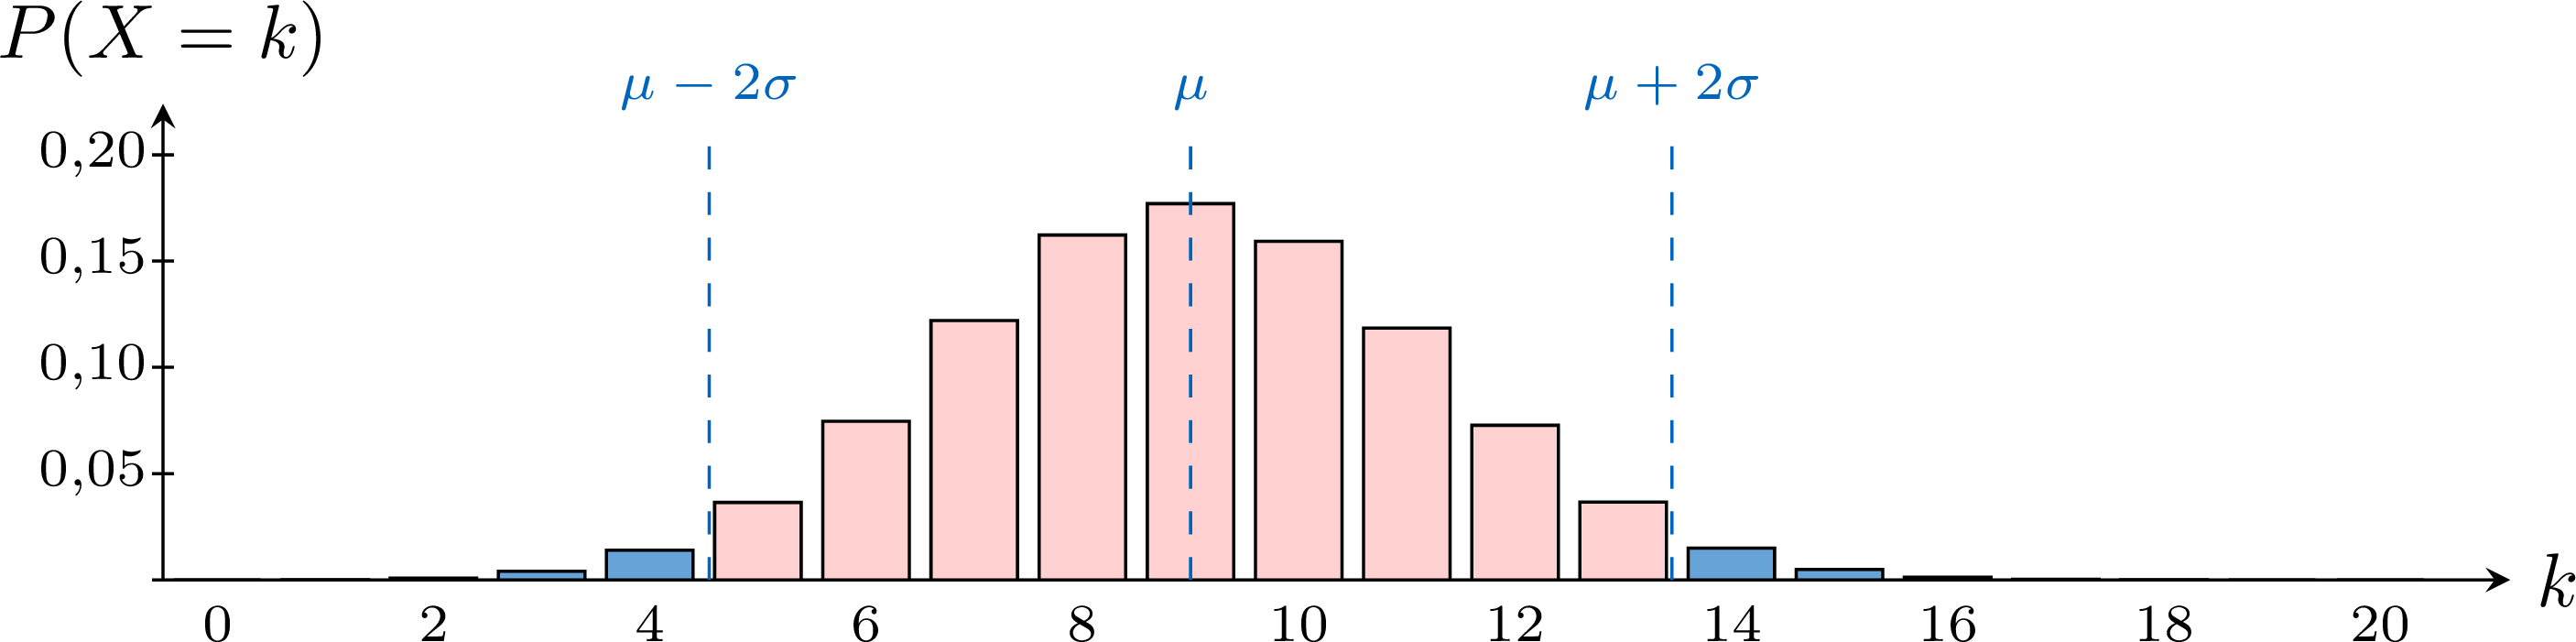
- Avec \(k = 2\) : \(P(|X - 9| \ge 2\sigma) \le \dfrac{1}{4} = 0{,}25\).
- \(2\sigma \approx 4{,}45\), et \(X\) prend des valeurs entières, donc \(|X - 9| \ge 4{,}45\) signifie \(X \le 4\) ou \(X \ge 14\) : $$P(X \le 4) + P(X \ge 14) \approx 0{,}019 + 0{,}021 = 0{,}040.$$ La borne \(0{,}25\) est juste mais six fois trop grande. L'inégalité est universelle, elle vaut pour toute loi de cette espérance et de cette variance, et pour certaines la borne est atteinte ; pour la loi binomiale elle est grossière. C'est une garantie, pas une estimation.
Compétences à pratiquer
- Analyser l'inégalité de Bienaymé-Tchebychev
- Appliquer l'inégalité de Bienaymé-Tchebychev
III.2
L'inégalité de concentration
Proposition — Inégalité de concentration
Soit \((X_1\,;\,\dots\,;\,X_n)\) un échantillon de taille \(n \ge 1\) d'une loi d'espérance \(\mu\) et de variance \(V\), et \(M_n\) sa moyenne. Pour tout réel \(\delta > 0\) : $$P\bigl(|M_n - \mu| \ge \delta\bigr) \le \frac{V}{n\delta^2}.$$ De manière équivalente, \(P(\mu - \delta < M_n < \mu + \delta) \ge 1 - \dfrac{V}{n\delta^2}\). Quand \(n\) augmente, la probabilité que la moyenne de l'échantillon soit loin de \(\mu\) devient aussi petite que l'on veut.
La moyenne \(M_n\) est une variable aléatoire d'espérance \(E(M_n) = \mu\) et de variance \(V(M_n) = \dfrac{V}{n}\) (propositions sur la somme et la moyenne d'un échantillon). En appliquant l'inégalité de Bienaymé-Tchebychev à \(M_n\) avec le réel \(\delta > 0\) : $$P\bigl(|M_n - \mu| \ge \delta\bigr) \le \frac{V(M_n)}{\delta^2} = \frac{V}{n\delta^2}.$$
Exemple
On lance une pièce équilibrée \(n=1000\) fois. Soit \(M_n\) la proportion observée de face : la moyenne de l'échantillon des variables \(X_i = 1\) si le lancer \(i\) donne face, \(0\) sinon. On a alors \(\mu=0{,}5\) et \(V=0{,}25\). Majorer la probabilité que la proportion s'écarte de \(0{,}5\) d'au moins \(0{,}05\). En utilisant l'inégalité de concentration avec \(\delta=0{,}05\) :$$ P(|M_{1000}-0{,}5|\ge 0{,}05)\le \frac{0{,}25}{1000\times (0{,}05)^2}= \frac{0{,}25}{1000\times 0{,}0025}= \frac{0{,}25}{2{,}5}= 0{,}1. $$ Il y a au plus \(10\,\pourcent\) de chances que la proportion soit en dehors de l'intervalle \([0{,}45;\,0{,}55]\). Méthode — Déterminer une taille d'échantillon
Étant donné une précision \(\delta > 0\) et un risque \(\alpha\) avec \(0 < \alpha < 1\), on cherche une taille d'échantillon \(n\) telle que \(P(|M_n - \mu| \ge \delta) \le \alpha\). - Écrire l'inégalité de concentration : \(P(|M_n - \mu| \ge \delta) \le \dfrac{V}{n\delta^2}\).
- Exiger que la borne soit au plus \(\alpha\) : \(\dfrac{V}{n\delta^2} \le \alpha\), c'est-à-dire \(n \ge \dfrac{V}{\alpha\delta^2}\).
- Prendre pour \(n\) le plus petit entier strictement positif au moins égal à \(\dfrac{V}{\alpha\delta^2}\) : cette taille suffit, elle n'est pas forcément la plus petite qui convienne, car l'inégalité n'est pas exacte.
- Pour une fréquence (\(X_i\) indicatrices d'un événement de probabilité \(p\)), \(V = p(1 - p) \le \dfrac{1}{4}\), donc \(n \ge \dfrac{1}{4\alpha\delta^2}\) suffit quel que soit \(p\).
Exemple
Un institut de sondage veut estimer la proportion inconnue \(p\) des électeurs qui soutiennent un candidat, par la fréquence \(M_n\) observée sur \(n\) électeurs tirés au hasard dans le corps électoral, indépendamment les uns des autres. Combien d'électeurs interroger pour que la fréquence soit à moins de \(0{,}02\) de \(p\), avec un risque d'au plus \(5\,\pourcent\) ? Même question avec une précision de \(0{,}01\).
Chaque réponse est une indicatrice (\(1\) pour un soutien), donc \(M_n\) est la moyenne d'un échantillon de variables de Bernoulli de paramètre \(p\) et \(V = p(1 - p) \le \dfrac{1}{4}\). Avec \(\delta = 0{,}02\) et \(\alpha = 0{,}05\) : $$n \ge \frac{1}{4 \times 0{,}05 \times 0{,}02^2} = \frac{1}{0{,}00008} = 12\,500.$$ Interroger \(12\,500\) électeurs garantit \(P(|M_n - p| \ge 0{,}02) \le 0{,}05\), quel que soit \(p\). Avec \(\delta = 0{,}01\) : \(n \ge \dfrac{1}{4 \times 0{,}05 \times 0{,}01^2} = 50\,000\). Diviser la précision par deux multiplie la taille de l'échantillon par quatre.
Compétences à pratiquer
- Appliquer l'inégalité de concentration
- Déterminer une taille d'échantillon avec l'inégalité de concentration
- Encadrer des écarts avec les inégalités de concentration
IV
La loi des grands nombres
IV.1
La fréquence se stabilise
Définition — Fluctuation d'échantillonnage
Dans une population, on note \(p\) la proportion d'individus présentant un certain caractère. Lorsqu'on prélève un échantillon et qu'on observe la fréquence \(f\) d'apparition de ce caractère, on constate que \(f\) varie d'un échantillon à l'autre. Ce phénomène est appelé fluctuation d'échantillonnage. Proposition — Intervalle de fluctuation
On suppose que la proportion réelle d'un caractère dans une population est \(p\), et que l'on prélève au hasard des échantillons de taille \(n\). Alors, dans environ \(95\,\pourcent\) de ces échantillons, la fréquence observée \(f\) appartient à l'intervalle de fluctuation $$ I_n = \left[\, p - \frac{1}{\sqrt{n}}\,;\; p + \frac{1}{\sqrt{n}} \,\right]. $$ On utilise ce résultat sous les conditions de validité usuelles \(n \ge 25\) et \(0{,}2 \le p \le 0{,}8\). L'intervalle est volontairement large : sa couverture dépend de \(p\) et de \(n\), et elle est la plus proche de \(95\,\pourcent\) quand \(p\) est voisin de \(0{,}5\). La demi-largeur \(\dfrac{1}{\sqrt{n}}\) diminue lorsque \(n\) augmente : l'intervalle est donc plus étroit pour les grands échantillons. 
Proposition — Loi des grands nombres
Pour des répétitions indépendantes dans les mêmes conditions, lorsque la taille \(n\) de l'échantillon devient grande, la fréquence observée \(f\) d'un caractère a tendance à se stabiliser autour de la probabilité réelle \(p\) (des fluctuations restent possibles, mais elles diminuent généralement). Lorsqu'un individu est tiré au hasard dans une population, la proportion d'un caractère dans la population est égale à la probabilité de le tirer — estimer l'une, c'est estimer l'autre. Compétences à pratiquer
- Comprendre la loi des grands nombres
IV.2
De l'inégalité au théorème
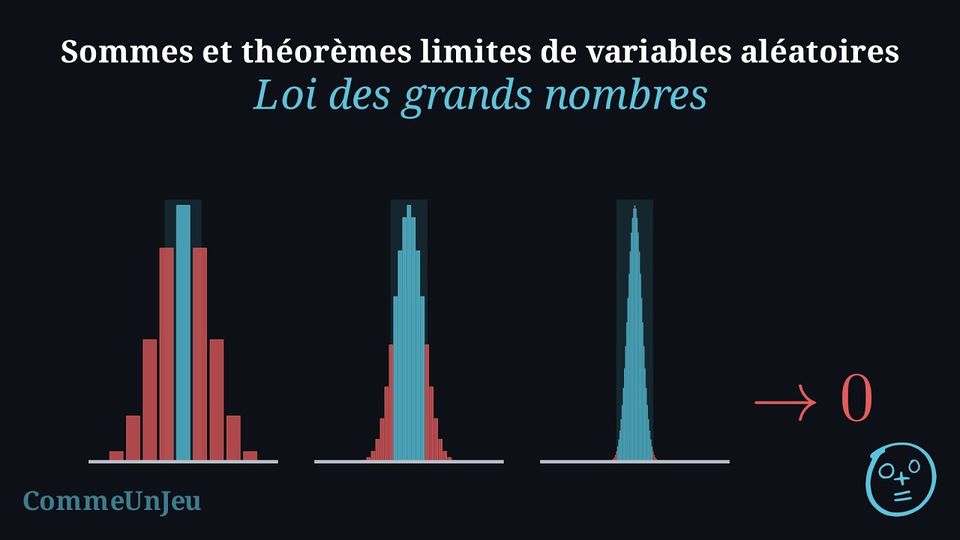
Depuis l'enfance, on utilise intuitivement les fréquences expérimentales pour estimer des probabilités — par exemple, en lançant une pièce de monnaie de nombreuses fois pour vérifier si elle est équilibrée. La loi des grands nombres apporte une justification mathématique rigoureuse à cette intuition : à mesure que le nombre d'essais indépendants augmente, la moyenne de l'échantillon devient une estimation de plus en plus fiable de l'espérance théorique.
Théorème — Loi des grands nombres
Soit \((X_i)_{i \ge 1}\) une suite de variables aléatoires indépendantes qui suivent toutes la même loi, d'espérance \(\mu\) et de variance \(V\), et pour tout \(n \ge 1\) soit \(M_n = \dfrac{X_1 + \dots + X_n}{n}\) la moyenne de l'échantillon \((X_1\,;\,\dots\,;\,X_n)\). Pour tout réel \(\delta > 0\) fixé : $$\lim_{n \to +\infty} P\bigl(|M_n - \mu| \ge \delta\bigr) = 0.$$ Autrement dit, quelle que soit la précision \(\delta\) choisie, la probabilité que la moyenne de l'échantillon s'écarte de \(\mu\) d'au moins \(\delta\) tend vers \(0\) quand la taille de l'échantillon tend vers \(+\infty\).
D'après l'inégalité de concentration :$$ P(|M_n-\mu|\ge \delta)\le \frac{V}{n\delta^2}. $$ Comme \(V\) et \(\delta\) sont fixés, on a$$ \lim_{n \to +\infty}\frac{V}{n\delta^2}=0. $$ La probabilité étant positive et majorée par une suite qui tend vers \(0\), on conclut (théorème des gendarmes) que$$ \lim_{n \to +\infty} P(|M_n-\mu|\ge \delta)=0. $$
Exemple
On considère le lancer d'une pièce équilibrée (\(p=0{,}5\)). Pour \(n=100\), l'inégalité de concentration donne :$$ P(|M_{100}-0{,}5|\ge 0{,}1)\le \frac{0{,}25}{100\times 0{,}1^2}=0{,}25. $$ Mais pour \(n=1\,000\,000\) :$$ P(|M_{1\,000\,000}-0{,}5|\ge 0{,}1)\le \frac{0{,}25}{1\,000\,000\times 0{,}1^2}=0{,}000025. $$ La moyenne devient extrêmement stable autour de la valeur théorique à mesure que \(n\) augmente.
Le couronnement de l'échantillonnage
Dans le chapitre sur l'échantillonnage, deux faits ont été observés par simulation : la fréquence \(f\) d'un caractère dans un échantillon de taille \(n\) se trouve, dans environ \(95\,\pourcent\) des échantillons, dans l'intervalle \(\left[p - \frac{1}{\sqrt{n}}\,;\, p + \frac{1}{\sqrt{n}}\right]\), et la fréquence se stabilise autour de \(p\) quand \(n\) grandit. La stabilisation repose maintenant sur une démonstration, et l'intervalle sur une garantie.
La fréquence est la moyenne \(M_n\) d'un échantillon de variables de Bernoulli (\(X_i = 1\) quand le \(i\)-ième individu a le caractère), avec \(\mu = p\) et \(V = p(1 - p) \le \dfrac{1}{4}\). L'inégalité de concentration avec \(\delta = \dfrac{1}{\sqrt{n}}\) donne $$P\left(|M_n - p| \ge \frac{1}{\sqrt{n}}\right) \le \frac{1/4}{n \times 1/n} = \frac{1}{4} :$$ l'intervalle capture la fréquence avec une probabilité d'au moins \(\dfrac{3}{4}\), quels que soient \(p\) et \(n\). C'est une garantie, plus grossière que les « environ \(95\,\pourcent\) » observés par simulation pour les valeurs usuelles de \(n\) et \(p\) : une observation, pas une valeur universelle, que le calcul exact avec la loi binomiale peut vérifier au cas par cas. Et la stabilisation de la fréquence est la loi des grands nombres elle-même : pour tout \(\delta\), \(P(|M_n - p| \ge \delta)\) tend vers \(0\).
De même, pour une variable d'écart-type \(\sigma > 0\), la règle « la moyenne d'un échantillon est le plus souvent à moins de \(\dfrac{2\sigma}{\sqrt{n}}\) de \(E(X)\) » est l'inégalité de concentration avec \(\delta = \dfrac{2\sigma}{\sqrt{n}}\) : la probabilité de tomber en dehors est au plus \(\dfrac{1}{4}\), et pour les lois usuelles (un dé, une pièce) les simulations en montrent bien moins.
Compétences à pratiquer
- Analyser la loi des grands nombres
- Estimer la taille d'une population avec la loi des grands nombres
IV.3
Simuler des échantillons
Ce que montre une simulation
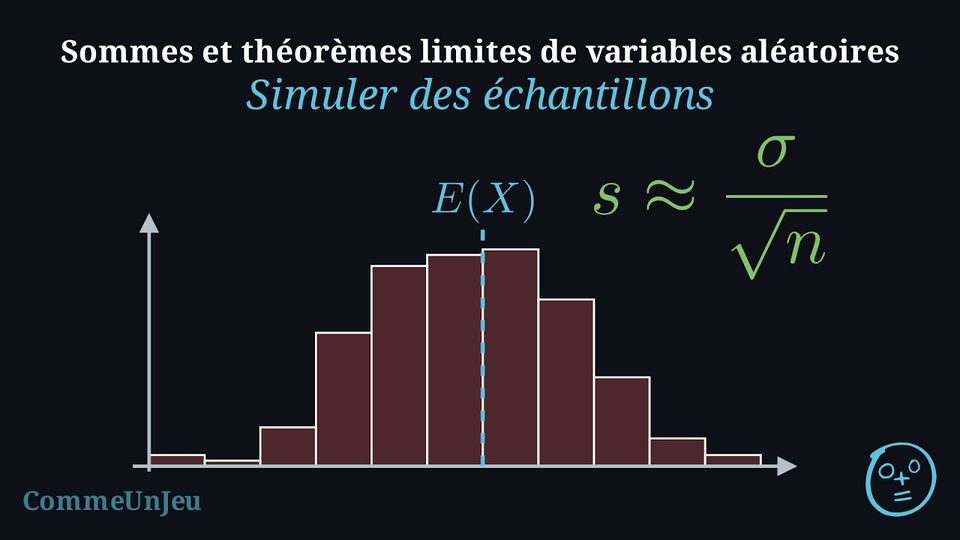
L'inégalité de concentration majore la probabilité d'un écart ; elle ne dit pas à quelle fréquence les écarts se produisent réellement. Une simulation le montre : un ordinateur tire un grand nombre d'échantillons de même taille, calcule leurs moyennes, et fait voir comment ces moyennes se dispersent autour de \(E(X)\). La dispersion se mesure par l'écart-type \(s\) de la série des moyennes, à comparer à la valeur théorique \(\sigma(M_n) = \dfrac{\sigma}{\sqrt{n}}\), et par la proportion des échantillons dont la moyenne est à moins de \(k \dfrac{\sigma}{\sqrt{n}}\) de \(E(X)\), pour \(k = 1\), \(2\), \(3\), à comparer aux garanties \(1 - \dfrac{1}{k^2}\).
Méthode — Simuler des échantillons et leurs moyennes
Pour simuler \(N\) échantillons de taille \(n\) d'une variable aléatoire \(X\), ici le résultat d'un dé équilibré (\(E(X) = 3{,}5\), \(\sigma \approx 1{,}708\)) : - Simuler un échantillon : une fonction qui renvoie une liste de \(n\) valeurs de \(X\).
- Calculer la moyenne de chaque échantillon et ranger les \(N\) moyennes dans une liste.
- Mesurer la dispersion : l'écart-type \(s\) de la liste des moyennes, à comparer à \(\dfrac{\sigma}{\sqrt{n}}\).
- Compter la proportion des moyennes à distance au plus \(k \dfrac{\sigma}{\sqrt{n}}\) de \(E(X)\), pour \(k = 1\), \(2\), \(3\).
import random

def sample(n):
    """n rolls of a fair die"""
    return [random.randint(1, 6) for _ in range(n)]

def mean(values):
    return sum(values) / len(values)

def std(values):
    m = mean(values)
    return (sum((v - m) ** 2 for v in values) / len(values)) ** 0.5

N, n = 200, 100                       # N samples of size n
means = [mean(sample(n)) for _ in range(N)]
s = std(means)                        # spread of the N sample means
print(s, 1.708 / n ** 0.5)            # to compare with sigma / sqrt(n)
for k in (1, 2, 3):
    inside = sum(1 for m in means if abs(m - 3.5) <= k * 1.708 / n ** 0.5)
    print(k, inside / N)
Exemple
Une exécution du programme ci-dessus, avec \(N = 200\) échantillons de \(n = 100\) lancers, a donné \(s \approx 0{,}180\) et les proportions \(0{,}66\), \(0{,}955\) et \(0{,}99\) pour \(k = 1\), \(2\), \(3\). L'histogramme montre les \(200\) moyennes. 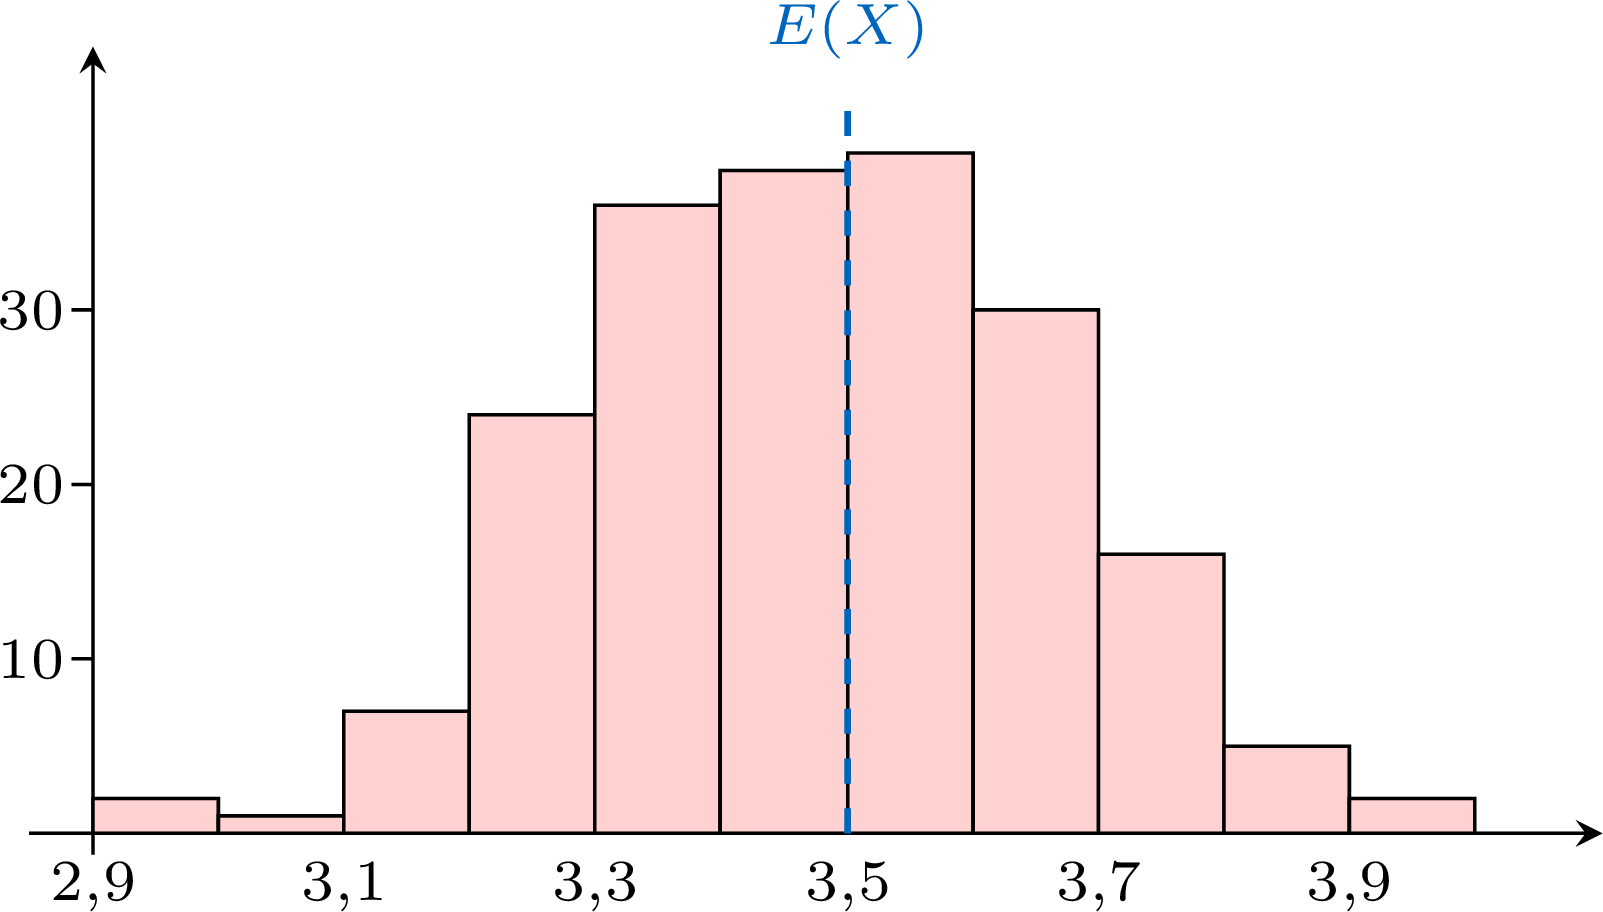
- Comparer \(s\) à \(\dfrac{\sigma}{\sqrt{n}}\).
- Comparer les proportions aux garanties de l'inégalité de concentration.
- Que changerait-on avec des échantillons de taille \(n = 400\) ?
- \(\dfrac{\sigma}{\sqrt{n}} = \dfrac{1{,}708}{10} \approx 0{,}171\) : la dispersion observée \(s \approx 0{,}180\) en est proche, comme le prévoit la proposition sur la variance de la moyenne. Une autre exécution donne une autre valeur de \(s\), typiquement voisine de \(0{,}171\).
- Pour un échantillon, l'inégalité garantit une probabilité d'au moins \(1 - \dfrac{1}{k^2}\) de tomber à l'intérieur : au moins \(0\) pour \(k = 1\) (aucune information), au moins \(\dfrac{3}{4}\) pour \(k = 2\), au moins \(\dfrac{8}{9} \approx 0{,}889\) pour \(k = 3\). Les proportions observées estiment ces probabilités ; ici \(0{,}66\), \(0{,}955\) et \(0{,}99\) sont nettement au-dessus des garanties (une autre exécution donnerait des proportions un peu différentes) : la borne est sûre, la réalité plus concentrée.
- Avec \(n = 400\), \(\dfrac{\sigma}{\sqrt{n}} = \dfrac{1{,}708}{20} \approx 0{,}085\) : les moyennes seraient deux fois plus resserrées autour de \(3{,}5\). Diviser la dispersion par deux coûte quatre fois plus de lancers par échantillon.
Compétences à pratiquer
- Simuler un échantillon avec Python
V
Pour aller plus loin
Compétences à pratiquer
- Diagnostiquer et corriger
- Problèmes
- Type bac
- Quiz
Contrôle du chapitre
4 exercices, sur 20 points. Durée indicative : 1 h 30.
À traiter sur papier, puis à photographier : la correction est automatique, par IA.
Ce contrôle ne modifie pas la maîtrise du chapitre, quelle que soit la note.
Aucun exercice composé.
Aller à la section