Éducation Nationale Française · ECGapprofondies
Variables aléatoires discrètes
Nous étendons la théorie finie des variables aléatoires (chapitre Variables aléatoires finies) au cas où l'ensemble des valeurs est dénombrable. La nouveauté est double : l'ensemble \(X(\Omega)\) peut être infini (une partie de \(\mathbb{N}\), par exemple \(\mathbb{N}^*\) pour le rang d'un premier succès), et les espérances deviennent des sommes infinies — la convergence absolue (du chapitre Séries numériques) est désormais le critère pour « l'espérance existe ». On définit la v.a.\ discrète sur un espace probabilisé général (chapitre Espaces probabilisés quelconques), on décrit sa loi et la loi de \(Y = g(X)\), on énonce l'indépendance mutuelle, puis on construit espérance, variance et fonction de répartition \(F_X\). On termine sur les deux lois discrètes usuelles du chapitre : la loi géométrique \(\mathcal{G}(p)\) (rang du premier succès dans un processus de Bernoulli sans mémoire) et la loi de Poisson \(\mathcal{P}(\lambda)\) (comptage d'événements rares). Conventions. \((\Omega, \mathcal{A}, P)\) est un espace probabilisé général ; \(X(\Omega) = \{u_i\}_{i \in I}\) avec \(I \subset \mathbb{N}\) fini ou dénombrable, la famille \((u_i)\) étant injective (les valeurs listées sont deux à deux distinctes). On note \(P(X = x)\), \(P(X \in J)\), \(P(X \le x)\), \(E(X)\), \(V(X)\), \(\sigma(X)\), \(F_X\), et on utilise \(X \hookrightarrow \mathcal{G}(p)\) et \(X \hookrightarrow \mathcal{P}(\lambda)\) pour les deux nouvelles lois. Le théorème de transfert, la linéarité de l'espérance et le critère d'existence par domination sont admis à ce niveau (programme) ; on les utilise librement. Le cas fini (ch.~Variables aléatoires finies) est récupéré comme le cas \(I\)-fini de chaque énoncé.
I
Variables aléatoires réelles discrètes
I.1
Définition et événements liés à \(X\)
La définition étend le cas fini de Variables aléatoires finies dans une seule direction : l'ensemble des valeurs \(X(\Omega)\) peut désormais être infini, mais dénombrable — indexé par une partie \(I\) de \(\mathbb{N}\). L'exemple standard est le rang du premier pile dans un lancer infini de pièce, qui prend toute valeur dans \(\mathbb{N}^*\). Les événements \([X = u_i]\) forment un système complet dénombrable de \(\Omega\), exactement comme dans le cas fini — avec la \(\sigma\)-additivité de \(P\) (chapitre Espaces probabilisés quelconques).
Définition — Variable aléatoire réelle discrète
Soit \((\Omega, \mathcal{A}, P)\) un espace probabilisé. Une application $$ X : \Omega \longrightarrow \mathbb{R}, \qquad \omega \longmapsto X(\omega) $$ est une variable aléatoire réelle discrète (en abrégé, v.a.\ discrète) lorsque : - \(X(\Omega) = \{u_i\}_{i \in I}\) avec \(I \subset \mathbb{N}\) fini ou dénombrable, la famille \((u_i)_{i \in I}\) étant injective (les valeurs listées sont deux à deux distinctes) ;
- pour tout \(i \in I\), \([X = u_i] = \{\omega \in \Omega \mid X(\omega) = u_i\}\) est un événement (appartient à \(\mathcal{A}\)).
Exemple
Toute v.a.\ finie (chapitre Variables aléatoires finies) est une v.a.\ discrète : on prend \(I\) fini. Le chapitre Variables aléatoires finies est le cas particulier \(|I| < +\infty\) du présent chapitre. Exemple — Rang du premier pile
Lancer infini d'une pièce \(\Omega = \{H, T\}^{\mathbb{N}^*}\) avec la probabilité standard de lancers équilibrés du chapitre Espaces probabilisés quelconques. On définit \(N : \Omega \to \mathbb{R}\) par \(N(\omega) = k\) quand le premier pile apparaît au rang \(k \in \mathbb{N}^*\), et \(N(\omega) = 1\) sur l'événement négligeable \(A_0 = \) « aucun pile n'apparaît » (valeur réelle conventionnelle sur un \(P\)-négligeable ; tout \(k \in \mathbb{N}^*\) fixé conviendrait, le choix est sans incidence puisque \(P(A_0) = 0\)). Alors \(N\) est une v.a.\ discrète avec \(N(\Omega) = \mathbb{N}^*\). Les événements \([N = k]\) pour \(k \ge 2\) sont explicites : \([N = k] = \) « \(k - 1\) faces puis un pile » \(\cap\) « n'importe quoi ensuite », auquel le modèle standard attribue la probabilité \((1/2)^{k-1} \cdot (1/2) = (1/2)^k\). Pour \(k = 1\), \([N = 1]\) est « pile au premier lancer, n'importe quoi ensuite » réuni à \(A_0\), de probabilité \(1/2 + 0 = 1/2\). Note pédagogique. La valeur de \(N\) sur \(A_0\) est conventionnelle ; la loi de \(N\) ne dépend pas du choix, puisque \(P(A_0) = 0\). Ce \(N\) est le prototype de la loi géométrique \(\mathcal{G}(1/2)\) (\(N(\Omega) = \mathbb{N}^*\) avec \(P(N = k) = (1/2)^k = (1/2)(1/2)^{k-1}\)). Exemple — Nombre d'échecs avant le premier succès
Sur le même lancer infini, posons \(K = N - 1\) où \(N\) est la variable rang-du-premier-pile ci-dessus. Alors \(K : \Omega \to \mathbb{R}\) est une v.a.\ discrète avec \(K(\Omega) = \mathbb{N}\) (puisque \(N(\Omega) = \mathbb{N}^*\)) : \(K = 0\) quand le premier pile apparaît au rang \(1\) (ou sur \(A_0\), par la convention \(N = 1\)), \(K = 1\) quand le premier pile apparaît au rang \(2\), etc. La loi est \(P(K = j) = P(N = j + 1) = (1/2)^{j+1}\) pour \(j \in \mathbb{N}\). C'est la même expérience indexée différemment — une situation de ré-indexation typique traitée au Loi d'une variable aléatoire discrète. Proposition — Système complet dénombrable associé à \(X\)
Soit \(X\) une v.a.\ discrète sur \((\Omega, \mathcal{A}, P)\) avec \(X(\Omega) = \{u_i\}_{i \in I}\). La famille $$ \bigl( [X = u_i] \bigr)_{i \in I} $$ est un système complet dénombrable d'événements de \(\Omega\) : les événements sont deux à deux disjoints et leur union vaut \(\Omega\). Par conséquent $$ \textcolor{colorprop}{\sum_{i \in I} P(X = u_i) = 1,} $$ la somme étant finie quand \(I\) est fini et la somme d'une série absolument convergente quand \(I\) est dénombrable.
Disjonction. Pour \(i \ne j\) dans \(I\), \([X = u_i] \cap [X = u_j]\) est l'ensemble des \(\omega \in \Omega\) avec \(X(\omega) = u_i\) et \(X(\omega) = u_j\) ; comme la famille \((u_i)\) est injective, \(u_i \ne u_j\) et aucun tel \(\omega\) n'existe, donc l'intersection est vide. Recouvrement. Pour tout \(\omega \in \Omega\), \(X(\omega) \in X(\Omega) = \{u_i\}_{i \in I}\), donc il existe exactement un indice \(i\) tel que \(X(\omega) = u_i\) ; donc \(\omega \in [X = u_i]\) et l'union recouvre \(\Omega\). Par \(\sigma\)-additivité de \(P\) sur cette partition disjointe dénombrable (chapitre Espaces probabilisés quelconques), $$ \begin{aligned} 1 \ =\ P(\Omega) \ &=\ P\!\left(\bigsqcup_{i \in I} [X = u_i]\right) && \text{(recouvrement)} \\
&=\ \sum_{i \in I} P(X = u_i) && \text{(}\sigma\text{-additivité).} \end{aligned} $$ La série est à termes positifs de somme \(1\), donc absolument convergente.
Compétences à pratiquer
- Identifier une variable aléatoire discrète
I.2
Loi d'une variable aléatoire discrète
Connaître une v.a.\ discrète en pratique signifie connaître ses valeurs et la probabilité de chacune. La seule différence avec le cas fini est que la somme \(\sum P(X = u_i)\) est maintenant une série (quand \(I\) est infini) — mais cette série converge et vaut \(1\) par la Proposition précédente.
Définition — Loi d'une variable aléatoire discrète
La loi (ou distribution de probabilité) d'une v.a.\ discrète \(X\) est la donnée de \(X(\Omega)\) et des valeurs \(P(X = u_i)\) pour \(i \in I\). De manière équivalente, la loi est l'application $$ \textcolor{colordef}{P_X : X(\Omega) \longrightarrow [0, 1], \qquad x \longmapsto P(X = x).} $$ Deux v.a.\ discrètes \(X\) et \(Y\) ont la même loi quand \(P(X = x) = P(Y = x)\) pour tout \(x \in \mathbb{R}\) (avec la convention \(P(X = x) = 0\) pour \(x \notin X(\Omega)\)). Elles peuvent rester distinctes comme applications sur \(\Omega\), et leurs ensembles de valeurs peuvent différer à des négligeables près. Proposition — Caractérisation d'une loi discrète
Soit \(X(\Omega) = \{u_i\}_{i \in I}\) l'ensemble des valeurs et \((p_i)_{i \in I}\) les probabilités correspondantes \(p_i = P(X = u_i)\). Alors : - tout \(p_i\) vérifie \(p_i \in [0, 1]\) ;
- \(\sum_{i \in I} p_i = 1\) (somme finie quand \(I\) est fini, somme d'une série convergente à termes positifs quand \(I\) est dénombrable).
Pour le sens direct, \(p_i = P(X = u_i) \in [0, 1]\) car \(P\) est à valeurs dans \([0, 1]\) ; \(\sum p_i = 1\) par la Proposition de système complet dénombrable du Définition et événements liés à \(X\). La réciproque est admise (la construction place la probabilité \(p_i\) sur le singleton \(\{u_i\}\) et étend par \(\sigma\)-additivité, exactement comme dans l'exemple « singletons pondérés sur \(\mathbb{N}\) » du chapitre Espaces probabilisés quelconques).
Exemple — Loi du rang du premier pile
Pour la variable \(N\) du Définition et événements liés à \(X\) (pièce équilibrée), \(N(\Omega) = \mathbb{N}^*\) et la loi est $$ P(N = k) = \frac{1}{2^k} \quad \text{pour } k \in \mathbb{N}^*. $$ Vérification : \(\sum_{k=1}^{+\infty} 1/2^k = (1/2) / (1 - 1/2) = 1\) (série géométrique de raison \(1/2\), chapitre Séries numériques). Exemple — Une loi sur \(\mathbb{N}\)
On définit \(X\) avec \(X(\Omega) = \mathbb{N}\) et \(P(X = k) = c / 2^k\) pour \(k \in \mathbb{N}\), \(c\) étant choisi pour que \(\sum P(X = k) = 1\). Alors $$ 1 = c \sum_{k=0}^{+\infty} \frac{1}{2^k} = c \cdot 2, \qquad \text{donc } c = \frac{1}{2}. $$ Donc \(P(X = k) = 1 / 2^{k+1}\) pour \(k \in \mathbb{N}\) — la loi construite dans l'exemple « singletons pondérés » du chapitre Espaces probabilisés quelconques. Méthode — Déterminer la loi d'une v.a.\ discrète
Pour déterminer la loi d'une v.a.\ discrète \(X\) : - Décrire \(X(\Omega)\) sous la forme \(\{u_i\}_{i \in I}\) avec \(I \subset \mathbb{N}\) fini ou dénombrable.
- Calculer \(P(X = u_i)\) pour chaque \(i \in I\) (souvent par \(\sigma\)-additivité sur une décomposition de \([X = u_i]\), par une formule de système complet, ou par énumération directe dans un cadre fini).
- Vérification : contrôler que \(\sum_{i \in I} p_i = 1\). Une somme erronée signale une décomposition incorrecte ou un cas oublié.
Compétences à pratiquer
- Calculer la loi d'une variable aléatoire discrète
I.3
La variable \(Y \equal g(X)\)
Appliquer une fonction \(g\) à une v.a.\ discrète \(X\) donne une nouvelle v.a.\ discrète \(Y = g(X)\). L'ensemble des valeurs de \(Y\) est l'image \(g(X(\Omega))\), au plus dénombrable, et la loi de \(Y\) s'obtient en regroupant les valeurs de \(X\) que \(g\) envoie sur la même image.
Proposition — \(Y \equal g(X)\) est une v.a.\ discrète
Soit \(X\) une v.a.\ discrète avec \(X(\Omega) = \{u_i\}_{i \in I}\) et \(g : X(\Omega) \to \mathbb{R}\) une application quelconque. Alors \(Y = g \circ X : \Omega \to \mathbb{R}\) est une v.a.\ discrète ; son ensemble de valeurs \(Y(\Omega) = g(X(\Omega))\) est fini ou dénombrable.
\(Y(\Omega) = g(X(\Omega))\) est l'image de l'ensemble au plus dénombrable \(X(\Omega)\) par \(g\), donc au plus dénombrable. Pour chaque \(y \in Y(\Omega)\), l'ensemble \(\{i \in I \mid g(u_i) = y\}\) est au plus dénombrable et $$ [Y = y] = \bigcup_{i \in I,\ g(u_i) = y} [X = u_i]. $$ C'est une union dénombrable disjointe d'événements (disjointe car les \([X = u_i]\) sont deux à deux disjoints d'après Définition et événements liés à \(X\)), donc appartient à \(\mathcal{A}\) par stabilité par union dénombrable (chapitre Espaces probabilisés quelconques). Les deux conditions de la Définition de v.a.\ discrète sont vérifiées, donc \(Y\) est une v.a.\ discrète.
Proposition — Loi de \(Y \equal g(X)\)
Avec les notations ci-dessus, pour tout \(y \in Y(\Omega)\), $$ \textcolor{colorprop}{P(Y = y) = \sum_{i \in I,\ g(u_i) = y} P(X = u_i)} $$ (somme finie ou somme d'une série convergente à termes positifs).
On applique la \(\sigma\)-additivité de \(P\) à la décomposition disjointe dénombrable \([Y = y] = \bigsqcup_{g(u_i) = y} [X = u_i]\) de la preuve précédente.
Exemple
Soit \(X\) avec \(X(\Omega) = \mathbb{Z}\) et \(P(X = n) = p_n\) pour \(n \in \mathbb{Z}\) (loi quelconque). Posons \(Y = X^2\). Alors \(Y(\Omega) = \{n^2 \mid n \in \mathbb{Z}\} = \{0, 1, 4, 9, 16, \dots\}\), l'ensemble des carrés parfaits. Pour \(y = m^2\) avec \(m \in \mathbb{N}^*\), $$ P(Y = m^2) = P(X^2 = m^2) = P(X = m) + P(X = -m) = p_m + p_{-m}, $$ car l'équation \(x^2 = m^2\) sur \(\mathbb{Z}\) a les deux solutions entières \(\pm m\). Pour \(y = 0\), \(P(Y = 0) = P(X = 0) = p_0\). Exemple
Soit \(X\) avec \(X(\Omega) = \mathbb{N}\) et \(P(X = k) = 1 / 2^{k+1}\), et \(Y = \mathbf{1}_{X \ge 1}\) (indicatrice : \(1\) si \(X \ge 1\), \(0\) sinon). Alors \(Y(\Omega) = \{0, 1\}\) et $$ P(Y = 0) = P(X = 0) = \frac{1}{2}, \qquad P(Y = 1) = \sum_{k = 1}^{+\infty} \frac{1}{2^{k+1}} = \frac{1}{2}. $$ \(Y\) est une v.a.\ de Bernoulli de paramètre \(1/2\). Méthode — Calculer la loi de \(g(X)\)
- Lister \(Y(\Omega) = g(X(\Omega))\) (regrouper les doublons si \(g\) n'est pas injective).
- Pour chaque \(y \in Y(\Omega)\), lister les \(u_i\) tels que \(g(u_i) = y\).
- Sommer \(P(Y = y) = \sum_{g(u_i) = y} P(X = u_i)\).
- Vérification \(\sum_y P(Y = y) = 1\).
Compétences à pratiquer
- Calculer la loi de \(Y \equal g(X)\)
I.4
Indépendance mutuelle de \(n\) variables aléatoires discrètes
Le chapitre fini Variables aléatoires finies définissait l'indépendance de deux v.a.\ finies ; on étend la définition à \(n\) v.a.\ discrètes (programme S2 III.2). L'intuition est la même : un atome conjoint \([X_1 = x_1] \cap \dots \cap [X_n = x_n]\) a la probabilité produit de ses marginales.
Définition — Indépendance mutuelle de \(n\) v.a.\ discrètes
Soient \(X_1, \dots, X_n\) \(n\) v.a.\ discrètes sur le même espace probabilisé \((\Omega, \mathcal{A}, P)\). Elles sont mutuellement indépendantes lorsque, pour tout \((x_1, \dots, x_n) \in X_1(\Omega) \times \dots \times X_n(\Omega)\), $$ \textcolor{colordef}{P\Bigl(\bigcap_{i=1}^{n} [X_i = x_i]\Bigr) = \prod_{i=1}^{n} P(X_i = x_i).} $$ Exemple — \(n\) v.a.\ de Bernoulli indépendantes
Sur l'espace probabilisé standard d'un processus de Bernoulli (chapitre Espaces probabilisés quelconques), soit \(X_i = \mathbf{1}_{H_i}\) pour \(i = 1, \dots, n\), avec \(H_i = \) « pile au tirage \(i\) » et \(P(H_i) = p\). L'indépendance mutuelle des événements \((H_i)\) (chapitre Espaces probabilisés quelconques) se transfère aux v.a.\ \(X_i\) via les complémentaires : tout atome conjoint \([X_1 = x_1] \cap \dots \cap [X_n = x_n]\) est une intersection de \(H_i\) et de complémentaires, tous indépendants, de probabilité \(\prod p^{x_i} (1-p)^{1-x_i}\). La Définition est vérifiée, donc \((X_1, \dots, X_n)\) est mutuellement indépendant.
Deux à deux versus mutuelle
L'indépendance mutuelle de \(X_1, \dots, X_n\) entraîne l'indépendance deux à deux : fixons deux indices \(i \ne j\) et un couple \((x_i, x_j) \in X_i(\Omega) \times X_j(\Omega)\). Par décomposition dénombrable, $$ [X_i = x_i] \cap [X_j = x_j] = \bigsqcup_{(x_k)_{k \ne i, j}} \bigcap_{k=1}^n [X_k = x_k], $$ où l'union disjointe parcourt le produit au plus dénombrable \(\prod_{k \ne i, j} X_k(\Omega)\). Par \(\sigma\)-additivité et factorisation conjointe, $$ \begin{aligned} P([X_i = x_i] \cap [X_j = x_j]) &= \sum_{(x_k)_{k \ne i, j}} \prod_{k=1}^n P(X_k = x_k) && \text{(}\sigma\text{-additivité + indép mutuelle)} \\
&= P(X_i = x_i) P(X_j = x_j) \prod_{k \ne i, j} \sum_{x_k} P(X_k = x_k) && \text{(factorisation + Fubini positif)} \\
&= P(X_i = x_i) P(X_j = x_j) && \text{(chaque marginale somme à } 1\text{).} \end{aligned} $$ La réciproque (deux à deux \(\Rightarrow\) mutuelle) est fausse pour \(n \ge 3\) : voir le contre-exemple des trois « événements de parité d'une expérience uniforme à 4 issues » du chapitre Espaces probabilisés quelconques.
Compétences à pratiquer
- Manipuler l'indépendance mutuelle de v.a.\ discrètes
II
Espérance
II.1
Définition et existence
Dans le cas fini (Variables aléatoires finies), \(E(X)\) était une somme finie et existait toujours. Quand \(X(\Omega)\) est dénombrable, la somme devient une série, et \(E(X)\) n'est défini que lorsque cette série converge absolument. Cette exigence vient du chapitre Séries numériques : la convergence absolue garantit que la somme est bien définie quelle que soit la façon d'énumérer \(X(\Omega)\) (un fait admis à ce niveau).
Définition — Espérance quand \(X(\Omega)\) est infini
Soit \(X\) une v.a.\ discrète avec \(X(\Omega) = \{u_i\}_{i \in I}\), \(I \subset \mathbb{N}\) dénombrable. \(X\) admet une espérance quand la série $$ \sum_{i \in I} u_i\, P(X = u_i) $$ est absolument convergente, c'est-à-dire quand \(\sum_{i \in I} |u_i|\, P(X = u_i)\) converge. Dans ce cas, $$ \textcolor{colordef}{E(X) = \sum_{i \in I} u_i\, P(X = u_i),} $$ et cette valeur ne dépend pas de l'énumération de \(X(\Omega)\) (admis : indépendance par rapport à l'indexation d'une série absolument convergente). Quand \(X(\Omega)\) est fini, la définition se réduit à la somme finie du chapitre Variables aléatoires finies (toujours absolument convergente car finie).
Deux modes d'échec
La condition de convergence absolue est le prix technique de la dénombrabilité. Deux modes d'échec peuvent survenir. Soit \(\sum |u_i| P(X = u_i) = +\infty\) (typique d'un \(X\) à valeurs positives dont l'espérance vaudrait \(+\infty\), comme dans le paradoxe de Saint-Pétersbourg) ; soit la série signée ne converge que conditionnellement, et alors la valeur de la somme peut dépendre de l'énumération de \(X(\Omega)\) — ce n'est plus un nombre bien défini. L'hypothèse de convergence absolue exclut les deux modes, et \(E(X)\) est alors bien défini quelle que soit l'énumération.
Exemple — Une v.a.\ avec espérance
Prenons \(X(\Omega) = \mathbb{N}^*\) avec \(P(X = k) = 1/2^k\) (le rang du premier pile d'une pièce équilibrée, Définition et événements liés à \(X\)). La série \(\sum k / 2^k\) est à termes positifs et majorée par la série géométrique dérivée convergente \(\sum k q^{k-1}\) en \(q = 1/2\) (chapitre Séries numériques), donc absolument convergente. Donc \(E(X)\) existe. On calcule sa valeur au Séries de Riemann (un bloc Method utilise le transfert pour évaluer \(E(X)\) et donne \(E(X) = 2\)). Exemple — Une v.a.\ sans espérance
Prenons \(X(\Omega) = \mathbb{N}^*\) avec \(P(X = k) = c / k^2\), où \(c = 1 / (\sum_{k \ge 1} 1/k^2) > 0\) est la constante de normalisation (la série de Riemann d'exposant \(2\) converge par le chapitre Séries numériques, donc \(c\) est bien défini ; sa valeur close n'est pas utilisée ici). Alors $$ \sum_{k \ge 1} k P(X = k) = c \sum_{k \ge 1} \frac{1}{k} $$ est la série harmonique divergente. La série d'espérance n'est pas absolument convergente (elle diverge vers \(+\infty\)), donc \(X\) n'a pas d'espérance. La loi reste valide : \(\sum P(X = k) = c \cdot (1/c) = 1\). Proposition — Existence par domination
Soient \(X, Y\) deux v.a.\ discrètes sur \((\Omega, \mathcal{A}, P)\) avec \(0 \le |X| \le Y\) ponctuellement sur \(\Omega\), et supposons que \(Y\) admet une espérance. Alors \(X\) admet une espérance et $$ \textcolor{colorprop}{|E(X)| \le E(Y).} $$ Résultat admis à ce niveau (programme). Méthode — Décider si \(E(X)\) existe
- Écrire la série \(\sum_{i \in I} |u_i| P(X = u_i)\).
- Décider de sa convergence avec les outils du chapitre Séries numériques : comparaison à une série de Riemann \(\sum 1/k^\alpha\), géométrique \(\sum q^k\), géométrique dérivée \(\sum k q^{k-1}\), exponentielle \(\sum 1/k!\).
- Si convergente, \(E(X)\) existe et vaut \(\sum u_i P(X = u_i)\) (Définition). Sinon, \(E(X)\) N'existe PAS.
- Variante : dominer \(|X|\) par un \(Y\) d'espérance connue (Existence par domination).
Compétences à pratiquer
- Décider de l'existence d'une espérance
II.2
Linéarité, transfert et applications
Deux outils centraux du chapitre côté espérance : la linéarité (formule du cas fini, énoncée ici dans le cas dénombrable) et le théorème de transfert (un moyen de calculer \(E(g(X))\) sans calculer la loi de \(g(X)\) d'abord). Les deux sont admis à ce niveau (programme) ; on les utilise librement.
Proposition — Linéarité et croissance de l'espérance
Soient \(X\) et \(Y\) deux v.a.\ discrètes admettant une espérance et \((a, b) \in \mathbb{R}^2\). Alors \(aX + bY\) admet une espérance et $$ \textcolor{colorprop}{E(aX + bY) = a E(X) + b E(Y).} $$ De plus, si \(X \le Y\) presque sûrement et que les deux admettent une espérance, alors \(E(X) \le E(Y)\) (croissance). En particulier, \(X \ge 0\) p.s.\ entraîne \(E(X) \ge 0\) (positivité). Résultat admis à ce niveau (programme). Théorème — Théorème de transfert
Soit \(X\) une v.a.\ discrète avec \(X(\Omega) = \{u_i\}_{i \in I}\) infini, et \(g : X(\Omega) \to \mathbb{R}\) une application quelconque. Alors \(g(X)\) admet une espérance si et seulement si la série $$ \sum_{i \in I} g(u_i)\, P(X = u_i) $$ est absolument convergente. Dans ce cas, $$ \textcolor{colorprop}{E(g(X)) = \sum_{i \in I} g(u_i)\, P(X = u_i),} $$ et cette valeur ne dépend pas de l'énumération de \(X(\Omega)\). Quand \(X(\Omega)\) est fini, la formule se réduit au transfert du cas fini de Variables aléatoires finies (déjà démontré). Résultat admis à ce niveau (programme). Exemple — \(E(X)\) du rang du premier pile
Calculer \(E(X)\) pour \(X\) avec \(X(\Omega) = \mathbb{N}^*\) et \(P(X = k) = 1/2^k\) (pièce équilibrée).
Par la Définition (avec \(g\) = identité), \(E(X) = \sum_{k \ge 1} k / 2^k\) une fois la convergence absolue vérifiée (faite dans l'Exemple du Définition et existence). On factorise \(1/2\) pour reconnaître la série géométrique dérivée première en \(q = 1/2\) : $$ \begin{aligned} E(X) &= \sum_{k=1}^{+\infty} \frac{k}{2^k} && \text{(Définition)} \\
&= \frac{1}{2} \sum_{k=1}^{+\infty} k \left( \frac{1}{2} \right)^{k-1} && \text{(factoriser } 1/2\text{)} \\
&= \frac{1}{2} \cdot \frac{1}{(1 - 1/2)^2} && \text{(géométrique dérivée première, ch.~\textit{Séries numériques})} \\
&= \frac{1}{2} \cdot 4 = 2. \end{aligned} $$
Exemple — \(E(X^2)\) par transfert
Même \(X\). Calculer \(E(X^2)\) par le théorème de transfert avec \(g(t) = t^2\).
Par transfert, \(E(X^2) = \sum_{k \ge 1} k^2 / 2^k\) sous réserve de convergence absolue. On décompose \(k^2 = k(k - 1) + k\) pour reconnaître les formes canoniques géométriques dérivées : $$ \begin{aligned} E(X^2) &= \sum_{k=1}^{+\infty} \frac{k(k-1)}{2^k} + \sum_{k=1}^{+\infty} \frac{k}{2^k} && \text{(linéarité, les deux séries convergent)} \\
&= \sum_{k=2}^{+\infty} \frac{k(k-1)}{2^k} + 2 && \text{(}k = 1 \text{ donne } k(k-1) = 0 \text{; deuxième somme} = E(X) = 2\text{)} \\
&= \frac{1}{4} \sum_{k=2}^{+\infty} k(k-1) \left( \frac{1}{2} \right)^{k-2} + 2 && \text{(factoriser } (1/2)^2 = 1/4\text{)} \\
&= \frac{1}{4} \cdot \frac{2}{(1 - 1/2)^3} + 2 && \text{(géométrique dérivée seconde)} \\
&= \frac{1}{4} \cdot 16 + 2 = 4 + 2 = 6. \end{aligned} $$
Méthode — Calculer une espérance
- Vérifier l'existence : écrire \(\sum |u_i| P(X = u_i)\) et conclure (Méthode du Définition et existence).
- Calculer la valeur :
- Appliquer le transfert si \(X\) est donné via la loi d'une v.a.\ plus simple.
- Reconnaître une série géométrique / géométrique dérivée / exponentielle / de Riemann et utiliser la forme close du chapitre Séries numériques.
- Décomposer les polynômes en \(k\) : \(k = k\), \(k^2 = k(k - 1) + k\), \(k^3 = k(k-1)(k-2) + 3 k(k - 1) + k\), etc., pour utiliser les formes closes géométriques dérivées.
- Utiliser la linéarité de l'espérance pour découper \(X\) en briques plus simples.
Compétences à pratiquer
- Appliquer la linéarité et le théorème de transfert
III
Variance, écart-type et fonction de répartition
III.1
Variance et Koenig-Huygens
La variance était définie dans Variables aléatoires finies par \(V(X) = E((X - E(X))^2)\). La définition discrète est identique, mais on demande maintenant que les séries pertinentes convergent. Koenig-Huygens ramène la variance au moment d'ordre \(2\) : \(E(X^2)\).
Définition — Variance et écart-type
Soit \(X\) une v.a.\ discrète admettant une espérance. \(X\) admet une variance quand \((X - E(X))^2\) admet une espérance ; dans ce cas, $$ \textcolor{colordef}{V(X) = E\bigl((X - E(X))^2\bigr) \ge 0, \qquad \sigma(X) = \sqrt{V(X)}.} $$ \(\sigma(X)\) est appelé l'écart-type de \(X\). Proposition — \(V(aX + b) \equal a^2 V(X)\)
Pour \((a, b) \in \mathbb{R}^2\), si \(X\) admet une variance, alors \(aX + b\) aussi et $$ \textcolor{colorprop}{V(aX + b) = a^2 V(X).} $$
Par linéarité de \(E\), \(E(aX + b) = a E(X) + b\), donc $$ (aX + b - E(aX + b))^2 = (aX + b - a E(X) - b)^2 = a^2 (X - E(X))^2. $$ Comme \(X\) admet une variance, \((X - E(X))^2\) admet une espérance ; par linéarité de \(E\), \(a^2 (X - E(X))^2\) aussi, d'espérance \(a^2 E((X - E(X))^2)\). Donc \(aX + b\) admet une variance et $$ V(aX + b) = E(a^2 (X - E(X))^2) = a^2 E((X - E(X))^2) = a^2 V(X). $$
Proposition — Formule de Koenig-Huygens
On suppose que \(X\) admet une espérance. Alors \(X\) admet une variance si et seulement si \(X^2\) admet une espérance. Dans ce cas, $$ \textcolor{colorprop}{V(X) = E(X^2) - (E(X))^2.} $$
\(X\) admet une espérance \(E(X)\) par hypothèse. On démontre les deux sens de l'équivalence puis on en déduit la formule.
- Sens \((X - E(X))^2\) a \(E\) \(\Rightarrow\) \(X^2\) a \(E\). Utiliser la majoration élémentaire \((a + b)^2 \le 2 a^2 + 2 b^2\) avec \(a = X - E(X)\) et \(b = E(X)\) pour obtenir \(X^2 = (a + b)^2 \le 2 (X - E(X))^2 + 2 E(X)^2\). Le membre de droite est une v.a.\ discrète positive d'espérance \(2 V(X) + 2 E(X)^2\) (linéarité, constante \(E(X)^2\)). Par Existence par domination, \(X^2\) admet une espérance.
- Sens \(X^2\) a \(E\) \(\Rightarrow\) \((X - E(X))^2\) a \(E\). Développer \((X - E(X))^2 = X^2 - 2 E(X) X + E(X)^2\). Chaque sommand admet une espérance (\(X^2\) par hypothèse, \(X\) par l'hypothèse de l'énoncé, \(E(X)^2\) est constante). Par linéarité, \((X - E(X))^2\) admet une espérance.
- La formule. Une fois les deux côtés d'espérance définie, on développe et applique la linéarité de \(E\) : $$ \begin{aligned} V(X) &= E\bigl((X - E(X))^2\bigr) && \text{(Définition)} \\ &= E\bigl(X^2 - 2 E(X) X + E(X)^2\bigr) && \text{(développer)} \\ &= E(X^2) - 2 E(X) \cdot E(X) + E(X)^2 && \text{(linéarité, } E(X) \text{ est constante)} \\ &= E(X^2) - (E(X))^2. \end{aligned} $$
Exemple — Variance du rang du premier pile
Même \(X\) qu'au Linéarité, transfert et applications : \(E(X) = 2\), \(E(X^2) = 6\). Par Koenig-Huygens, $$ V(X) = E(X^2) - (E(X))^2 = 6 - 4 = 2, \qquad \sigma(X) = \sqrt{2}. $$ Proposition — Cas \(V(X) \equal 0\)
Si \(X\) admet une variance et \(V(X) = 0\), alors \(X\) est presque sûrement constante égale à \(E(X)\) — c'est-à-dire \(P(X = E(X)) = 1\).
Posons \(m = E(X)\). Par transfert, \(V(X) = E((X - m)^2) = \sum_i (u_i - m)^2 P(X = u_i)\) comme série absolument convergente de termes positifs. Une série à termes positifs de somme nulle a tous ses termes nuls (chapitre Séries numériques) : pour tout \(i\) avec \(u_i \ne m\), \((u_i - m)^2 > 0\), forçant \(P(X = u_i) = 0\). Deux cas. Si \(m \notin X(\Omega)\), alors tout \(u_i \ne m\) et \(\sum_i P(X = u_i) = 0\) — or la Proposition de système complet du Définition et événements liés à \(X\) donne \(\sum_i P(X = u_i) = 1\), contradiction ; ce cas est donc impossible. Donc \(m \in X(\Omega)\), et $$ P(X = m) = 1 - \sum_{i \mid u_i \ne m} P(X = u_i) = 1 - 0 = 1, $$ donc \(X = m\) presque sûrement.
Définition — Variable centrée réduite
Lorsque \(X\) admet une variance avec \(V(X) > 0\), la variable centrée réduite associée à \(X\) est $$ X^* = \frac{X - E(X)}{\sigma(X)}. $$ C'est une v.a.\ discrète avec \(E(X^*) = 0\) (centrée) et \(V(X^*) = 1\) (réduite). Méthode — Calculer \(V(X)\) via Koenig-Huygens
- Vérifier que \(E(X^2)\) existe (transfert avec \(g(t) = t^2\) ; vérifier la convergence absolue de \(\sum u_i^2 P(X = u_i)\)). Ceci assure l'existence de \(V(X)\).
- Calculer \(E(X^2)\).
- Calculer \(E(X)\) (souvent déjà connu).
- Appliquer \(V(X) = E(X^2) - (E(X))^2\).
Compétences à pratiquer
- Calculer des variances par Koenig-Huygens
III.2
La fonction de répartition
Aux côtés de la loi, une seconde description universelle d'une v.a.\ est sa fonction de répartition \(F_X(x) = P(X \le x)\), définie pour tout \(x \in \mathbb{R}\). La fonction de répartition est l'objet naturel pour comparer une v.a.\ discrète à une v.a.\ continue (introduite l'année prochaine) et le moyen naturel de lire les probabilités d'événements demi-droites et intervalles.
Définition — Fonction de répartition
La fonction de répartition d'une v.a.\ discrète \(X\) est la fonction $$ \textcolor{colordef}{F_X : \mathbb{R} \longrightarrow [0, 1], \qquad x \longmapsto F_X(x) = P(X \le x).} $$ Proposition — Propriétés de \(F_X\)
Soit \(X\) une v.a.\ discrète. - \(F_X\) est croissante sur \(\mathbb{R}\).
- \(\lim_{x \to -\infty} F_X(x) = 0\) et \(\lim_{x \to +\infty} F_X(x) = 1\).
- \(F_X\) est continue à droite : pour tout \(x_0 \in \mathbb{R}\), \(\lim_{x \to x_0^+} F_X(x) = F_X(x_0)\).
Croissance : pour \(x \le y\), \([X \le x] \subset [X \le y]\), donc \(F_X(x) \le F_X(y)\) par monotonie de \(P\). Limite en \(-\infty\) : pour \(x \to -\infty\), \([X \le x] \downarrow \emptyset\) (tout \(\omega \in \Omega\) a \(X(\omega) \in \mathbb{R}\), donc pour \(x < X(\omega)\), \(\omega \notin [X \le x]\)), donc par limite monotone (chapitre Espaces probabilisés quelconques), \(F_X(x) \to P(\emptyset) = 0\). Limite en \(+\infty\) : \([X \le x] \uparrow \Omega\) quand \(x \to +\infty\) (tout \(\omega \in \Omega\) a \(X(\omega) \in \mathbb{R}\), donc pour \(x \ge X(\omega)\), \(\omega \in [X \le x]\)), donc \(F_X(x) \to P(\Omega) = 1\). Continuité à droite : pour \(x_n \downarrow x_0\), \([X \le x_n] \downarrow [X \le x_0]\), la limite monotone donne \(F_X(x_n) \to F_X(x_0)\). (À ce niveau, on admet les détails techniques de passage à la limite sur un paramètre continu plutôt qu'une suite.)
Proposition — Récupération de la loi à partir de la fonction de répartition
Pour tout \(x \in \mathbb{R}\), $$ \textcolor{colorprop}{P(X = x) = F_X(x) - F_X(x^-),} $$ où \(F_X(x^-) = \lim_{t \to x^-} F_X(t)\) est la limite à gauche en \(x\). En particulier, \(P(X = x) > 0\) si et seulement si \(x\) est un point de discontinuité (saut) de \(F_X\), et l'ensemble des points de saut coïncide avec les valeurs de \(X\) de probabilité strictement positive (une partie de \(X(\Omega)\) ; l'égalité a lieu dès que la loi attribue une probabilité strictement positive à chaque valeur listée).
On écrit \([X \le x] = [X < x] \sqcup [X = x]\) (partition disjointe). En appliquant \(P\) : $$ F_X(x) = P(X < x) + P(X = x). $$ Par l'argument de limite monotone de la Proposition précédente appliqué à \([X \le t] \uparrow [X < x]\) quand \(t \uparrow x\) (strictement), \(P(X < x) = \lim_{t \to x^-} F_X(t) = F_X(x^-)\). Donc \(P(X = x) = F_X(x) - F_X(x^-)\).
Exemple — Fonction de répartition d'une petite v.a.\ finie
Soit \(X\) prenant les valeurs \(1, 2, 3\) avec probabilités \(1/2, 1/4, 1/4\). Alors \(F_X\) est la fonction en escalier avec sauts en \(1, 2, 3\) de hauteurs respectives \(1/2, 1/4, 1/4\), de somme \(1\). 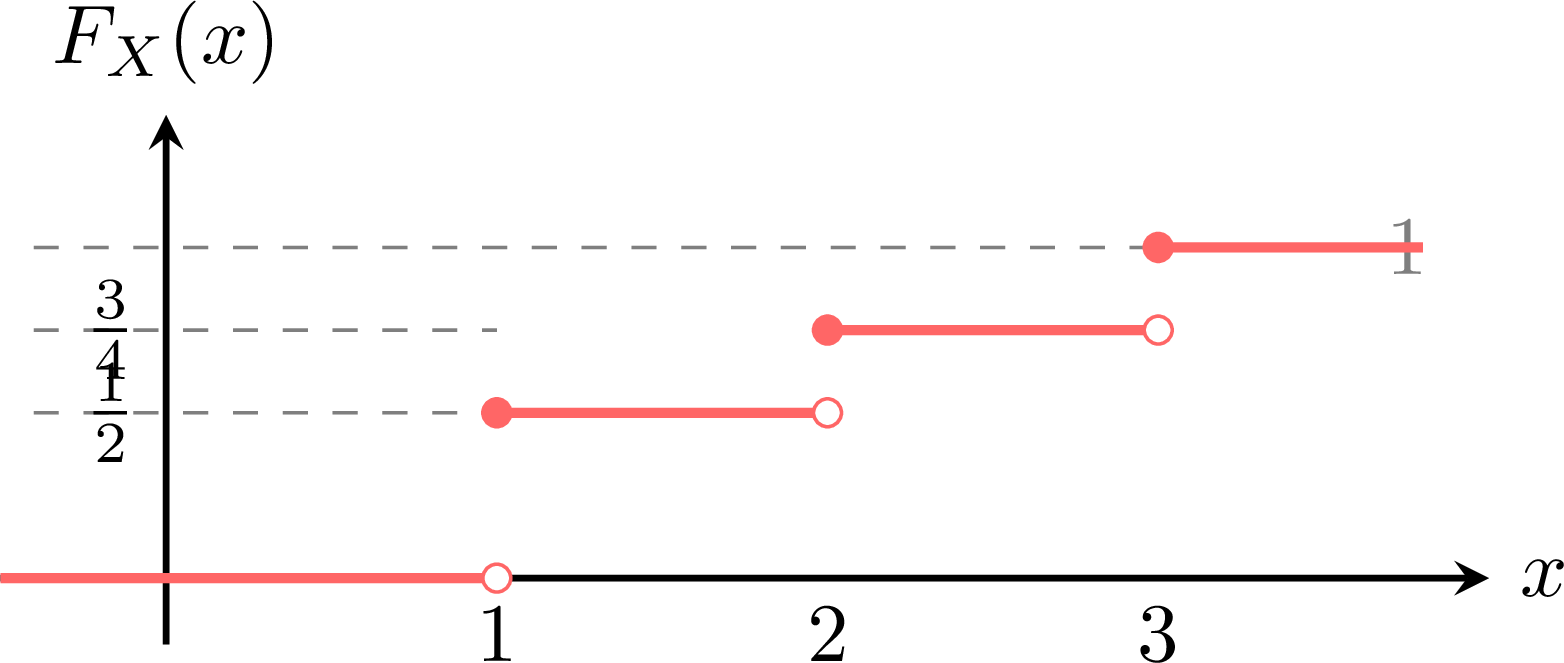
Méthode — Tracer ou lire une fonction de répartition
La recette ci-dessous s'applique dès que \(X(\Omega) \subset \mathbb{N}\) ou, plus généralement, dès que les valeurs de \(X\) de probabilité strictement positive forment une suite \(u_1 < u_2 < \dots\) sans point d'accumulation dans \(\mathbb{R}\) (le cas typique de ce chapitre). - Lister les valeurs \(u_1 < u_2 < \dots\) de \(X\) avec \(P(X = u_k) > 0\), triées dans l'ordre croissant.
- Calculer les probabilités cumulées \(F_X(u_k) = \sum_{i \le k} P(X = u_i)\).
- Tracer la fonction en escalier : \(F_X = 0\) sur \(]-\infty, u_1[\) ; constante égale à \(F_X(u_k)\) sur \([u_k, u_{k+1}[\) ; atteint \(1\) à la dernière valeur (si \(X(\Omega)\) est fini) ou tend vers \(1\) quand \(x \to +\infty\) (si la suite est infinie).
Compétences à pratiquer
- Tracer et utiliser la fonction de répartition
IV
Lois discrètes usuelles
IV.1
Lois certaine et de Bernoulli revisitées via la fonction de répartition
Bref rappel des v.a.\ certaines et de Bernoulli du chapitre Variables aléatoires finies, maintenant lues via leur fonction de répartition. Cela fixe le modèle « fonction en escalier » avant les nouvelles lois des §La loi géométrique \(\mathcal{G}(p)\)–4.3.
Exemple — Fonction de répartition d'une v.a.\ certaine
Soit \(X = a\) presque sûrement, \(a \in \mathbb{R}\). Alors \(F_X(x) = 0\) pour \(x < a\) et \(F_X(x) = 1\) pour \(x \ge a\) — l'échelon de Heaviside en \(a\). Exemple — Fonction de répartition d'une v.a.\ de Bernoulli
\(X \hookrightarrow \mathcal{B}(p)\) avec \(p \in {]0, 1[}\) a \(X(\Omega) = \{0, 1\}\), \(P(X = 0) = 1 - p\), \(P(X = 1) = p\). Alors $$ F_X(x) = \begin{cases} 0 & \text{si } x < 0, \\
1 - p & \text{si } 0 \le x < 1, \\
1 & \text{si } x \ge 1. \end{cases} $$ Deux sauts de hauteurs \(1 - p\) et \(p\), de somme \(1\). Compétences à pratiquer
- Lire la fonction de répartition des lois certaine et de Bernoulli
IV.2
La loi géométrique \(\mathcal{G}(p)\)
La loi géométrique modélise le rang du premier succès dans un processus de Bernoulli sans mémoire. C'est la loi discrète non bornée la plus simple de l'année et l'exemple prototype d'une « espérance par série ».
Définition — Loi géométrique \(\mathcal{G}(p)\)
Soit \(p \in {]0, 1[}\). Une v.a.\ discrète \(X\) suit la loi géométrique de paramètre \(p\), notée $$ \textcolor{colordef}{X \hookrightarrow \mathcal{G}(p),} $$ quand \(X(\Omega) = \mathbb{N}^*\) et, pour tout \(k \in \mathbb{N}^*\), $$ \textcolor{colordef}{P(X = k) = p (1 - p)^{k-1}.} $$ Le cadre qui produit une telle loi est « répéter la même expérience indépendamment, à probabilité de succès \(p\) à chaque essai ; \(X\) = rang du premier succès ». L'« indépendance » et la « probabilité de succès constante \(p\) » sont toutes deux essentielles : sans indépendance, \(P(X = k) = p(1-p)^{k-1}\) ne serait plus valide. Proposition — \(\mathcal{G}(p)\) est une loi valide
Pour \(p \in {]0, 1[}\), \(\sum_{k \ge 1} p (1 - p)^{k-1} = 1\).
Posons \(q = 1 - p \in {]0, 1[}\). Par la série géométrique (chapitre Séries numériques), $$ \sum_{k=1}^{+\infty} p q^{k-1} = p \sum_{k=1}^{+\infty} q^{k-1} = p \cdot \frac{1}{1 - q} = \frac{p}{p} = 1. $$
Exemple — Lancer un dé équilibré jusqu'au premier six
On lance un dé équilibré ; \(X\) = rang du premier \(6\). Chaque lancer est un succès (\(6\)) avec probabilité \(p = 1/6\), indépendamment. Alors \(X \hookrightarrow \mathcal{G}(1/6)\) : $$ P(X = 1) = \frac{1}{6}, \quad P(X = 2) = \frac{5}{6} \cdot \frac{1}{6} = \frac{5}{36}, \quad P(X = 3) = \left( \frac{5}{6} \right)^2 \cdot \frac{1}{6} = \frac{25}{216}. $$ Proposition — Espérance et variance de \(\mathcal{G}(p)\)
Si \(X \hookrightarrow \mathcal{G}(p)\), alors \(X\) admet espérance et variance, avec $$ \textcolor{colorprop}{E(X) = \frac{1}{p}, \qquad V(X) = \frac{1 - p}{p^2}.} $$
Posons \(q = 1 - p\). Espérance. Par transfert (existence et valeur) : la série $$ \sum_{k \ge 1} k \cdot p q^{k-1} = p \sum_{k \ge 1} k q^{k-1} $$ converge absolument (termes positifs, série géométrique dérivée première en \(q \in {]0, 1[}\), chapitre Séries numériques). Donc \(X\) a une espérance et $$ \begin{aligned} E(X) &= \sum_{k=1}^{+\infty} k \cdot p q^{k-1} && \text{(Définition / transfert)} \\
&= p \sum_{k=1}^{+\infty} k q^{k-1} && \text{(factoriser } p\text{)} \\
&= p \cdot \frac{1}{(1 - q)^2} && \text{(géométrique dérivée première, ch.~\textit{Séries numériques})} \\
&= p \cdot \frac{1}{p^2} = \frac{1}{p}. \end{aligned} $$ Moment d'ordre 2. On décompose \(k^2 = k(k - 1) + k\) pour utiliser la géométrique dérivée seconde. La série \(\sum k(k-1) p q^{k-1}\) converge absolument (termes positifs, géométrique dérivée seconde en \(q \in {]0, 1[}\)). Avec l'étape précédente, \(E(X^2)\) existe et $$ \begin{aligned} E(X(X - 1)) &= \sum_{k=1}^{+\infty} k(k - 1)\, p q^{k-1} && \text{(transfert)} \\
&= p q \sum_{k=2}^{+\infty} k(k - 1)\, q^{k-2} && \text{(factoriser } pq\text{ ; le terme } k = 1 \text{ est nul)} \\
&= p q \cdot \frac{2}{(1 - q)^3} && \text{(géométrique dérivée seconde)} \\
&= p q \cdot \frac{2}{p^3} = \frac{2 q}{p^2} = \frac{2(1 - p)}{p^2}. \end{aligned} $$ Par linéarité, \(E(X^2) = E(X(X - 1)) + E(X) = 2(1 - p)/p^2 + 1/p = (2 - 2p + p)/p^2 = (2 - p)/p^2\). Variance par Koenig-Huygens. $$ V(X) = E(X^2) - (E(X))^2 = \frac{2 - p}{p^2} - \frac{1}{p^2} = \frac{1 - p}{p^2}. $$
Exemple — Application numérique au dé
\(X \hookrightarrow \mathcal{G}(1/6)\) : \(E(X) = 6\) (en moyenne, six lancers pour obtenir le premier \(6\)), \(V(X) = (5/6) / (1/36) = 30\), \(\sigma(X) = \sqrt{30} \approx 5{,}48\). Proposition — Fonction de répartition de \(\mathcal{G}(p)\)
Pour \(X \hookrightarrow \mathcal{G}(p)\) et \(x \in \mathbb{R}\), $$ \textcolor{colorprop}{F_X(x) = \begin{cases} 0 & \text{si } x < 1, \\
1 - (1 - p)^{\lfloor x \rfloor} & \text{si } x \ge 1, \end{cases}} $$ où \(\lfloor x \rfloor\) est la partie entière de \(x\).
Pour \(x < 1\), \([X \le x] = \emptyset\) (car \(X \ge 1\) toujours), donc \(F_X(x) = 0\). Pour un entier \(k \ge 1\), posons \(q = 1 - p\) : $$ \begin{aligned} F_X(k) &= \sum_{j=1}^{k} p q^{j-1} && \text{(Définition de } F_X\text{ ; somme finie)} \\
&= p \cdot \frac{1 - q^k}{1 - q} && \text{(somme géométrique finie)} \\
&= 1 - q^k = 1 - (1 - p)^k. \end{aligned} $$ Pour un \(x \ge 1\) non entier, \(X(\Omega) \subset \mathbb{N}^*\) donne \([X \le x] = [X \le \lfloor x \rfloor]\), donc \(F_X(x) = F_X(\lfloor x \rfloor) = 1 - (1 - p)^{\lfloor x \rfloor}\).
Méthode — Reconnaître une loi géométrique
Le motif distinctif : répéter une expérience indépendamment à probabilité de succès constante \(p\), jusqu'au premier succès ; \(X\) est le rang de ce premier succès. Alors \(X \hookrightarrow \mathcal{G}(p)\), et les formules \(E(X) = 1/p\), \(V(X) = (1 - p)/p^2\), \(F_X(k) = 1 - (1 - p)^k\) s'appliquent. Les deux piliers sont l'indépendance des essais et la constance de la probabilité de succès \(p\). Compétences à pratiquer
- Manipuler la loi géométrique \(\mathcal{G}(p)\)
IV.3
La loi de Poisson \(\mathcal{P}(\lambda)\)
La loi de Poisson modélise un comptage d'événements rares — le nombre d'occurrences indépendantes rares dans une fenêtre fixée : fautes de frappe sur une page, appels téléphoniques en une heure, particules \(\alpha\) émises par une source en une seconde. C'est la « cousine continue » de la binomiale, et la limite \(\mathcal{B}(n, \lambda/n) \to \mathcal{P}(\lambda)\) quand \(n \to \infty\) est le résultat phare du chapitre suivant Convergences et approximations.
Définition — Loi de Poisson \(\mathcal{P}(\lambda)\)
Soit \(\lambda > 0\). Une v.a.\ discrète \(X\) suit la loi de Poisson de paramètre \(\lambda\), notée $$ \textcolor{colordef}{X \hookrightarrow \mathcal{P}(\lambda),} $$ quand \(X(\Omega) = \mathbb{N}\) et, pour tout \(k \in \mathbb{N}\), $$ \textcolor{colordef}{P(X = k) = e^{-\lambda} \frac{\lambda^k}{k!}.} $$ Proposition — \(\mathcal{P}(\lambda)\) est une loi valide
Pour \(\lambda > 0\), \(\sum_{k \ge 0} e^{-\lambda} \lambda^k / k! = 1\).
On factorise \(e^{-\lambda}\) et on applique la série exponentielle (chapitre Séries numériques, admise) : $$ \sum_{k=0}^{+\infty} e^{-\lambda} \frac{\lambda^k}{k!} = e^{-\lambda} \sum_{k=0}^{+\infty} \frac{\lambda^k}{k!} = e^{-\lambda} \cdot e^{\lambda} = 1. $$
Exemple — Modélisation
Nombre d'appels reçus à un petit centre d'appels en une heure (moyenne \(\lambda = 3\) par heure) : sous l'hypothèse d'indépendance des événements rares, \(X \hookrightarrow \mathcal{P}(3)\), et $$ P(X = 0) = e^{-3} \approx 0{,}050, \qquad P(X = 1) = 3 e^{-3} \approx 0{,}149, \qquad P(X = 2) = \frac{9}{2} e^{-3} \approx 0{,}224. $$ 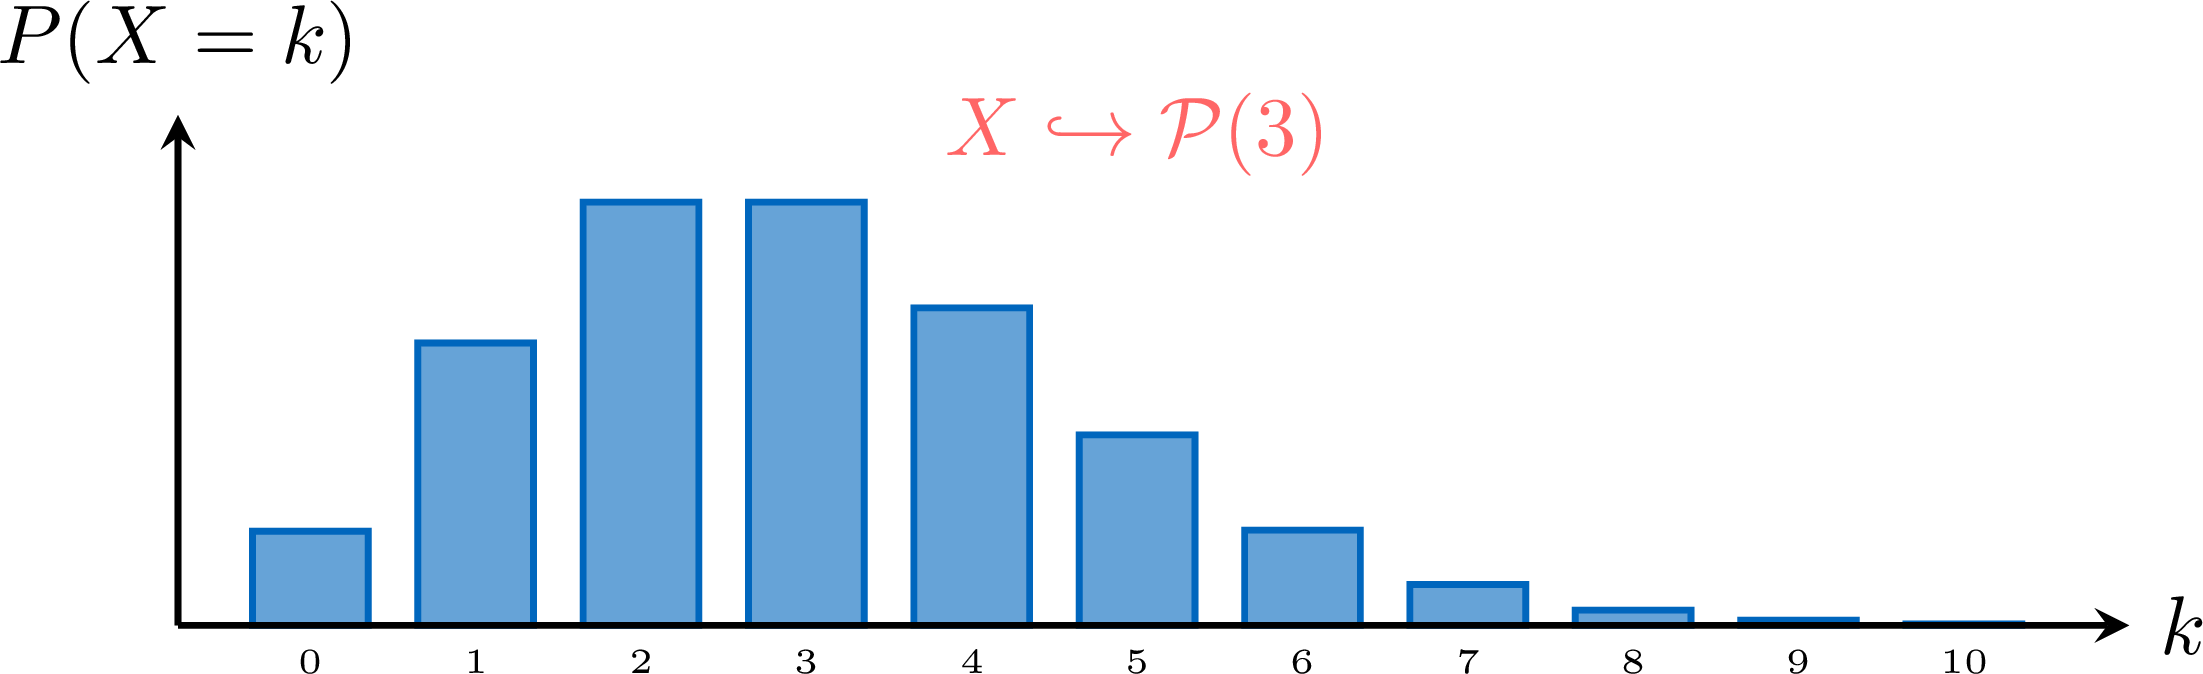
Proposition — Espérance et variance de \(\mathcal{P}(\lambda)\)
Si \(X \hookrightarrow \mathcal{P}(\lambda)\), alors \(X\) admet espérance et variance, avec $$ \textcolor{colorprop}{E(X) = \lambda, \qquad V(X) = \lambda.} $$
Espérance. Par transfert, \(E(X) = \sum_{k \ge 0} k e^{-\lambda} \lambda^k / k!\) sous réserve de convergence absolue. La série est à termes positifs et coïncide avec la queue de la série exponentielle après un décalage d'un cran : $$ \begin{aligned} \sum_{k=0}^{+\infty} k\, e^{-\lambda} \frac{\lambda^k}{k!} &= e^{-\lambda} \sum_{k=1}^{+\infty} k \cdot \frac{\lambda^k}{k!} && \text{(le terme } k = 0 \text{ est nul)} \\
&= e^{-\lambda} \sum_{k=1}^{+\infty} \frac{\lambda^k}{(k - 1)!} && \text{(simplifier } k / k! = 1 / (k - 1)!\text{)} \\
&= e^{-\lambda} \lambda \sum_{k=1}^{+\infty} \frac{\lambda^{k-1}}{(k - 1)!} && \text{(factoriser un } \lambda \text{)} \\
&= e^{-\lambda} \lambda \sum_{j=0}^{+\infty} \frac{\lambda^j}{j!} && \text{(changement } j = k - 1\text{)} \\
&= e^{-\lambda} \lambda \cdot e^{\lambda} = \lambda. && \text{(série exponentielle)} \end{aligned} $$ La série exponentielle converge pour tout argument réel (chapitre Séries numériques, admise), donc la convergence absolue requise par le théorème de transfert est acquise ; \(X\) admet une espérance égale à \(\lambda\). Moment d'ordre 2. On décompose \(k^2 = k(k - 1) + k\). De même, $$ \begin{aligned} E(X(X - 1)) &= \sum_{k=0}^{+\infty} k(k - 1)\, e^{-\lambda} \frac{\lambda^k}{k!} && \text{(transfert)} \\
&= e^{-\lambda} \sum_{k=2}^{+\infty} \frac{\lambda^k}{(k - 2)!} && \text{(}k = 0, 1 \text{ contribuent nul ; simplifier } k(k-1)/k! = 1/(k-2)!\text{)} \\
&= e^{-\lambda} \lambda^2 \sum_{k=2}^{+\infty} \frac{\lambda^{k-2}}{(k - 2)!} && \text{(factoriser } \lambda^2\text{)} \\
&= e^{-\lambda} \lambda^2 \cdot e^{\lambda} = \lambda^2. \end{aligned} $$ Donc \(E(X^2) = E(X(X - 1)) + E(X) = \lambda^2 + \lambda\). Variance par Koenig-Huygens. $$ V(X) = E(X^2) - (E(X))^2 = \lambda^2 + \lambda - \lambda^2 = \lambda. $$
Exemple — Application numérique au centre d'appels
\(X \hookrightarrow \mathcal{P}(3)\) : \(E(X) = 3\), \(V(X) = 3\), \(\sigma(X) = \sqrt{3} \approx 1{,}73\). Donc en moyenne \(3\) appels par heure avec un écart-type d'environ \(\pm \sqrt{3}\). Méthode — Reconnaître une loi de Poisson
Le motif distinctif : un comptage d'événements rares et indépendants dans une fenêtre fixée de temps, de longueur, de surface, etc. ; le paramètre \(\lambda\) est le comptage moyen, qui est aussi la variance. Alors \(X \hookrightarrow \mathcal{P}(\lambda)\), \(E(X) = V(X) = \lambda\), et \(P(X = k) = e^{-\lambda} \lambda^k / k!\). Compétences à pratiquer
- Manipuler la loi de Poisson \(\mathcal{P}(\lambda)\)
IV.4
Python — simulation et statistiques empiriques
Le programme rattache la simulation des lois discrètes usuelles (S2-P8) et le calcul de statistiques empiriques (S2-P9) à ce chapitre. On utilise la bibliothèque
numpy.random, abrégée rd.
Méthode — Simuler une expérience avec \texttt{rd.random}
rd.random() renvoie un tirage uniforme dans \([0, 1[\). Pour simuler une Bernoulli de paramètre \(p\) : \begin{verbatim} import numpy.random as rd def bernoulli(p): return 1 if rd.random() < p else 0 \end{verbatim} Pour simuler une loi géométrique \(\mathcal{G}(p)\) par expérience directe (lancer jusqu'au premier succès) : \begin{verbatim} def geometric(p): k = 1 while rd.random() >= p: k += 1 return k \end{verbatim} Méthode — Simuler les lois discrètes usuelles
numpy.random fournit des échantillonneurs prêts à l'emploi, paramétrés par la taille d'échantillon \(N\) : \begin{verbatim} rd.binomial(n, p, size=N) # B(n, p) rd.geometric(p, size=N) # G(p), rang du premier succès dans N* (convention numpy) rd.poisson(lam, size=N) # P(lambda) \end{verbatim} Chaque appel renvoie un tableau de taille \(N\) de tirages indépendants suivant la loi correspondante. La convention de rd.geometric correspond à notre \(\mathcal{G}(p)\) (rang du premier succès, valeurs dans \(\mathbb{N}^*\)). Méthode — Calculer les statistiques empiriques d'un échantillon
À partir d'un échantillon X = [x_1, ..., x_N] : \begin{verbatim} import numpy as np freq = [np.mean(X == k) for k in range(K)] # frequences empiriques P(X=k) cum = [np.mean(X <= k) for k in range(K)] # frequences cumulees (FdR empirique) mean = np.mean(X) # moyenne empirique -> E(X) mediane = np.median(X) # mediane empirique var = np.mean((X - mean)**2) # variance empirique -> V(X) ecart = np.sqrt(var) # ecart-type empirique import matplotlib.pyplot as plt plt.hist(X, bins='auto') # histogramme \end{verbatim} Lien pédagogique. Quand \(N\) grandit, les fréquences empiriques convergent vers la loi vraie et la moyenne empirique vers l'espérance : c'est la loi des grands nombres, énoncée et démontrée au chapitre suivant Convergences et approximations. La médiane empirique se lit sur la fonction de répartition empirique comme la plus petite valeur \(x\) telle que cum[x] \(\ge 1/2\).
Pour aller plus loin
Les chapitres suivants généralisent ce matériel. Couples de variables aléatoires discrètes (chapitre suivant) étend la loi, l'espérance et la variance à un couple \((X, Y)\) — avec la loi conjointe, les lois marginales, et l'espérance d'un produit \(E(XY)\) sous indépendance. Convergences et approximations démontre les inégalités de Markov et de Bienaymé-Tchebychev, la loi faible des grands nombres (qui rend rigoureuse l'heuristique « moyenne empirique \(\to E(X)\) » du Python — simulation et statistiques empiriques), et montre que \(\mathcal{B}(n, \lambda/n) \to \mathcal{P}(\lambda)\) quand \(n \to \infty\) — la limite des événements rares qui motive la loi de Poisson au départ.
Compétences à pratiquer
- Simuler des lois discrètes en Python
V
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section