Éducation Nationale Française · ECGapprofondies
Convergences et approximations
Ce chapitre mesure, puis exploite, la façon dont une variable aléatoire se concentre autour de son espérance. On construit trois outils successifs. D'abord, deux inégalités de concentration : l'inégalité de Markov majore la probabilité qu'une variable positive soit grande à l'aide de sa seule espérance, et l'inégalité de Bienaymé-Tchebychev majore la probabilité d'un écart à la moyenne à l'aide de la variance. On en déduit le résultat phare du chapitre, la loi faible des grands nombres : la moyenne empirique \(\bar X_n = \frac1n \sum_{i=1}^n X_i\) de variables indépendantes de même loi devient, avec une probabilité tendant vers \(1\), arbitrairement proche de l'espérance commune \(m\). Enfin on retient une approximation : une loi binomiale comportant beaucoup d'épreuves indépendantes, chacune rare, est proche d'une loi de Poisson. Un volet Python compare ces lois expérimentalement et estime des probabilités par des fréquences observées.
Conventions. \((\Omega, \mathcal{A}, P)\) est un espace probabilisé général (chapitre Espaces probabilisés quelconques) ; toutes les variables sont des variables aléatoires réelles discrètes sur cet espace (chapitre Variables aléatoires discrètes). « \(X\) admet une espérance » et « \(X\) admet une variance » s'emploient comme au chapitre Variables aléatoires discrètes. Pour une suite \((X_n)_{n \ge 1}\) de variables, on note \(\bar X_n = \frac1n \sum_{i=1}^n X_i\) la moyenne empirique des \(n\) premières. On utilise \(X \hookrightarrow \mathcal{B}(n, p)\) pour la loi binomiale et \(X \hookrightarrow \mathcal{P}(\lambda)\) pour la loi de Poisson, avec les espérances et variances établies au chapitre Variables aléatoires discrètes.
Conventions. \((\Omega, \mathcal{A}, P)\) est un espace probabilisé général (chapitre Espaces probabilisés quelconques) ; toutes les variables sont des variables aléatoires réelles discrètes sur cet espace (chapitre Variables aléatoires discrètes). « \(X\) admet une espérance » et « \(X\) admet une variance » s'emploient comme au chapitre Variables aléatoires discrètes. Pour une suite \((X_n)_{n \ge 1}\) de variables, on note \(\bar X_n = \frac1n \sum_{i=1}^n X_i\) la moyenne empirique des \(n\) premières. On utilise \(X \hookrightarrow \mathcal{B}(n, p)\) pour la loi binomiale et \(X \hookrightarrow \mathcal{P}(\lambda)\) pour la loi de Poisson, avec les espérances et variances établies au chapitre Variables aléatoires discrètes.
I
Inégalités de Markov et de Bienaymé-Tchebychev
I.1
L'inégalité de Markov
On commence par l'énoncé de concentration le plus simple. Si une variable aléatoire ne prend que des valeurs positives et a une moyenne connue, alors elle ne peut pas être grande trop souvent : la probabilité de dépasser un seuil \(\lambda\) est contrôlée par l'espérance divisée par \(\lambda\). Plus le seuil est grand, plus la majoration est petite. De façon remarquable, seule l'espérance intervient — pas la loi tout entière.
Théorème — Inégalité de Markov
Soit \(X\) une variable aléatoire discrète positive ou nulle (\(X \ge 0\)) admettant une espérance. Alors $$ \textcolor{colorprop}{\forall \lambda > 0, \quad P(X \ge \lambda) \le \frac{E(X)}{\lambda}.} $$
Écrivons \(X(\Omega) = \{x_i\}_{i \in I}\) avec chaque \(x_i \ge 0\). Par définition de l'espérance (chapitre Variables aléatoires discrètes), \(E(X) = \sum_{i \in I} x_i P(X = x_i)\), somme absolument convergente de termes positifs. Fixons \(\lambda > 0\) et scindons l'ensemble d'indices en \(\{i : x_i < \lambda\}\) et \(\{i : x_i \ge \lambda\}\) : $$ \begin{aligned} E(X) \ &=\ \sum_{x_i < \lambda} x_i P(X = x_i) + \sum_{x_i \ge \lambda} x_i P(X = x_i) && \text{(découpage de la somme)} \\
&\ge\ \sum_{x_i \ge \lambda} x_i P(X = x_i) && \text{(suppression d'une somme de termes \(\ge 0\))} \\
&\ge\ \sum_{x_i \ge \lambda} \lambda P(X = x_i) && \text{(\(x_i \ge \lambda\) sur cet ensemble)} \\
&=\ \lambda \sum_{x_i \ge \lambda} P(X = x_i) \ =\ \lambda \, P(X \ge \lambda). && \text{(définition de \(P(X \ge \lambda)\))} \end{aligned} $$ En divisant par \(\lambda > 0\), on obtient \(P(X \ge \lambda) \le E(X)/\lambda\).
Exemple
Un centre d'assistance reçoit, chaque jour, un nombre \(X\) de tickets d'assistance positif d'espérance moyenne \(E(X) = 3\). Majorer la probabilité qu'il reçoive au moins \(10\) tickets dans une journée.
Comme \(X \ge 0\) admet l'espérance \(E(X) = 3\), l'inégalité de Markov au seuil \(\lambda = 10\) donne $$ P(X \ge 10) \le \frac{E(X)}{10} = \frac{3}{10} = 0{,}3. $$ Au plus \(30\pourcent\) des journées voient \(10\) tickets ou plus — obtenu à partir de la seule moyenne.
Deux remarques. La même majoration vaut avec une inégalité stricte à gauche, car \([X > \lambda] \subset [X \ge \lambda]\) donne \(P(X > \lambda) \le P(X \ge \lambda) \le E(X)/\lambda\). Et la majoration est souvent grossière : elle n'utilise que \(E(X)\), en ignorant la dispersion des valeurs de \(X\). Sa force est précisément ce minimum d'information.
Méthode — Appliquer l'inégalité de Markov
- Vérifier que \(X \ge 0\) (Markov exige une variable positive ou nulle).
- Identifier l'espérance \(E(X)\).
- Pour le seuil \(\lambda > 0\), lire la majoration \(P(X \ge \lambda) \le E(X)/\lambda\).
Compétences à pratiquer
- Appliquer l'inégalité de Markov
I.2
L'inégalité de Bienaymé-Tchebychev
On mesure maintenant la dispersion autour de la moyenne. Les événements en jeu sont les événements d'écart \([\, |X - E(X)| \ge \varepsilon \,]\) : « \(X\) s'écarte d'au moins \(\varepsilon\) de son espérance ». L'inégalité de Bienaymé-Tchebychev majore leur probabilité par la variance, divisée par \(\varepsilon^2\). Elle découle de Markov appliquée à la variable positive \((X - E(X))^2\).
Théorème — Inégalité de Bienaymé-Tchebychev
Soit \(X\) une variable aléatoire discrète admettant une espérance et une variance. Alors $$ \textcolor{colorprop}{\forall \varepsilon > 0, \quad P\bigl(|X - E(X)| \ge \varepsilon\bigr) \le \frac{V(X)}{\varepsilon^2}.} $$
Posons \(Y = (X - E(X))^2\). Alors \(Y \ge 0\), et \(Y\) admet une espérance égale à la variance : \(E(Y) = E\bigl((X - E(X))^2\bigr) = V(X)\) par définition de la variance (chapitre Variables aléatoires discrètes). Fixons \(\varepsilon > 0\). Les événements \([\, |X - E(X)| \ge \varepsilon \,]\) et \([\, Y \ge \varepsilon^2 \,]\) sont égaux, car la fonction carré est croissante sur \([0, +\infty[\) : $$ |X - E(X)| \ge \varepsilon \iff (X - E(X))^2 \ge \varepsilon^2 \iff Y \ge \varepsilon^2. $$ En appliquant l'inégalité de Markov à \(Y \ge 0\) au seuil \(\varepsilon^2 > 0\), $$ \begin{aligned} P\bigl(|X - E(X)| \ge \varepsilon\bigr) \ &=\ P(Y \ge \varepsilon^2) && \text{(événements égaux)} \\
&\le\ \frac{E(Y)}{\varepsilon^2} && \text{(inégalité de Markov)} \\
&=\ \frac{V(X)}{\varepsilon^2}. && \text{(\(E(Y) = V(X)\))} \end{aligned} $$
Exemple
On lance \(400\) fois une pièce équilibrée et \(X\) compte les piles, donc \(X \hookrightarrow \mathcal{B}(400, 1/2)\), avec \(E(X) = 200\) et \(V(X) = 400 \cdot \tfrac12 \cdot \tfrac12 = 100\) (donc \(\sigma(X) = 10\)). Majorer la probabilité \(P(|X - 200| \ge 25)\), et comparer à la valeur exacte \(\approx 0{,}014\).
Bienaymé-Tchebychev avec \(\varepsilon = 25\) donne $$ P(|X - 200| \ge 25) \le \frac{V(X)}{25^2} = \frac{100}{625} \approx 0{,}16. $$ La majoration \(\approx 0{,}16\) est correcte mais grossière : la probabilité exacte vaut environ \(0{,}014\), environ dix fois plus petite. C'est typique — l'inégalité vaut pour toute loi de cette variance, elle ne peut donc pas exploiter la forme particulière de la binomiale.
Proposition — Écart en unités d'écart-type
Soit \(X\) admettant une espérance et une variance, avec \(\sigma(X) > 0\) (donc \(X\) n'est pas presque sûrement constante). Alors $$ \textcolor{colorprop}{\forall t > 0, \quad P\bigl(|X - E(X)| \ge t \, \sigma(X)\bigr) \le \frac{1}{t^2}.} $$ En particulier \(X\) se situe à moins de \(2\sigma\) de sa moyenne avec une probabilité au moins \(1 - 1/4 = 3/4\), et à moins de \(3\sigma\) avec une probabilité au moins \(1 - 1/9 = 8/9\).
On applique Bienaymé-Tchebychev avec \(\varepsilon = t \, \sigma(X) > 0\) (c'est ici \(\sigma(X) > 0\) qui assure \(\varepsilon > 0\)). Comme \(V(X) = \sigma(X)^2\), $$ P\bigl(|X - E(X)| \ge t \, \sigma(X)\bigr) \le \frac{V(X)}{(t \, \sigma(X))^2} = \frac{\sigma(X)^2}{t^2 \, \sigma(X)^2} = \frac{1}{t^2}. $$
Comme Markov, cette inégalité est universelle — elle vaut pour toute loi de variance finie — et tout aussi grossière. Elle n'apprend rien d'utile lorsque \(\varepsilon \le \sigma(X)\) : la majoration \(V(X)/\varepsilon^2 \ge 1\) est alors triviale, puisque toute probabilité est déjà \(\le 1\).
Méthode — Appliquer l'inégalité de Bienaymé-Tchebychev
- Identifier \(E(X)\) et \(V(X)\).
- Choisir l'écart \(\varepsilon > 0\) et lire la majoration \(P(|X - E(X)| \ge \varepsilon) \le V(X)/\varepsilon^2\).
- Pour minorer la probabilité de rester proche, passer à l'événement contraire : \(P(|X - E(X)| < \varepsilon) \ge 1 - V(X)/\varepsilon^2\).
Compétences à pratiquer
- Appliquer l'inégalité de Bienaymé-Tchebychev
II
Loi faible des grands nombres
II.1
Concentration de la moyenne empirique
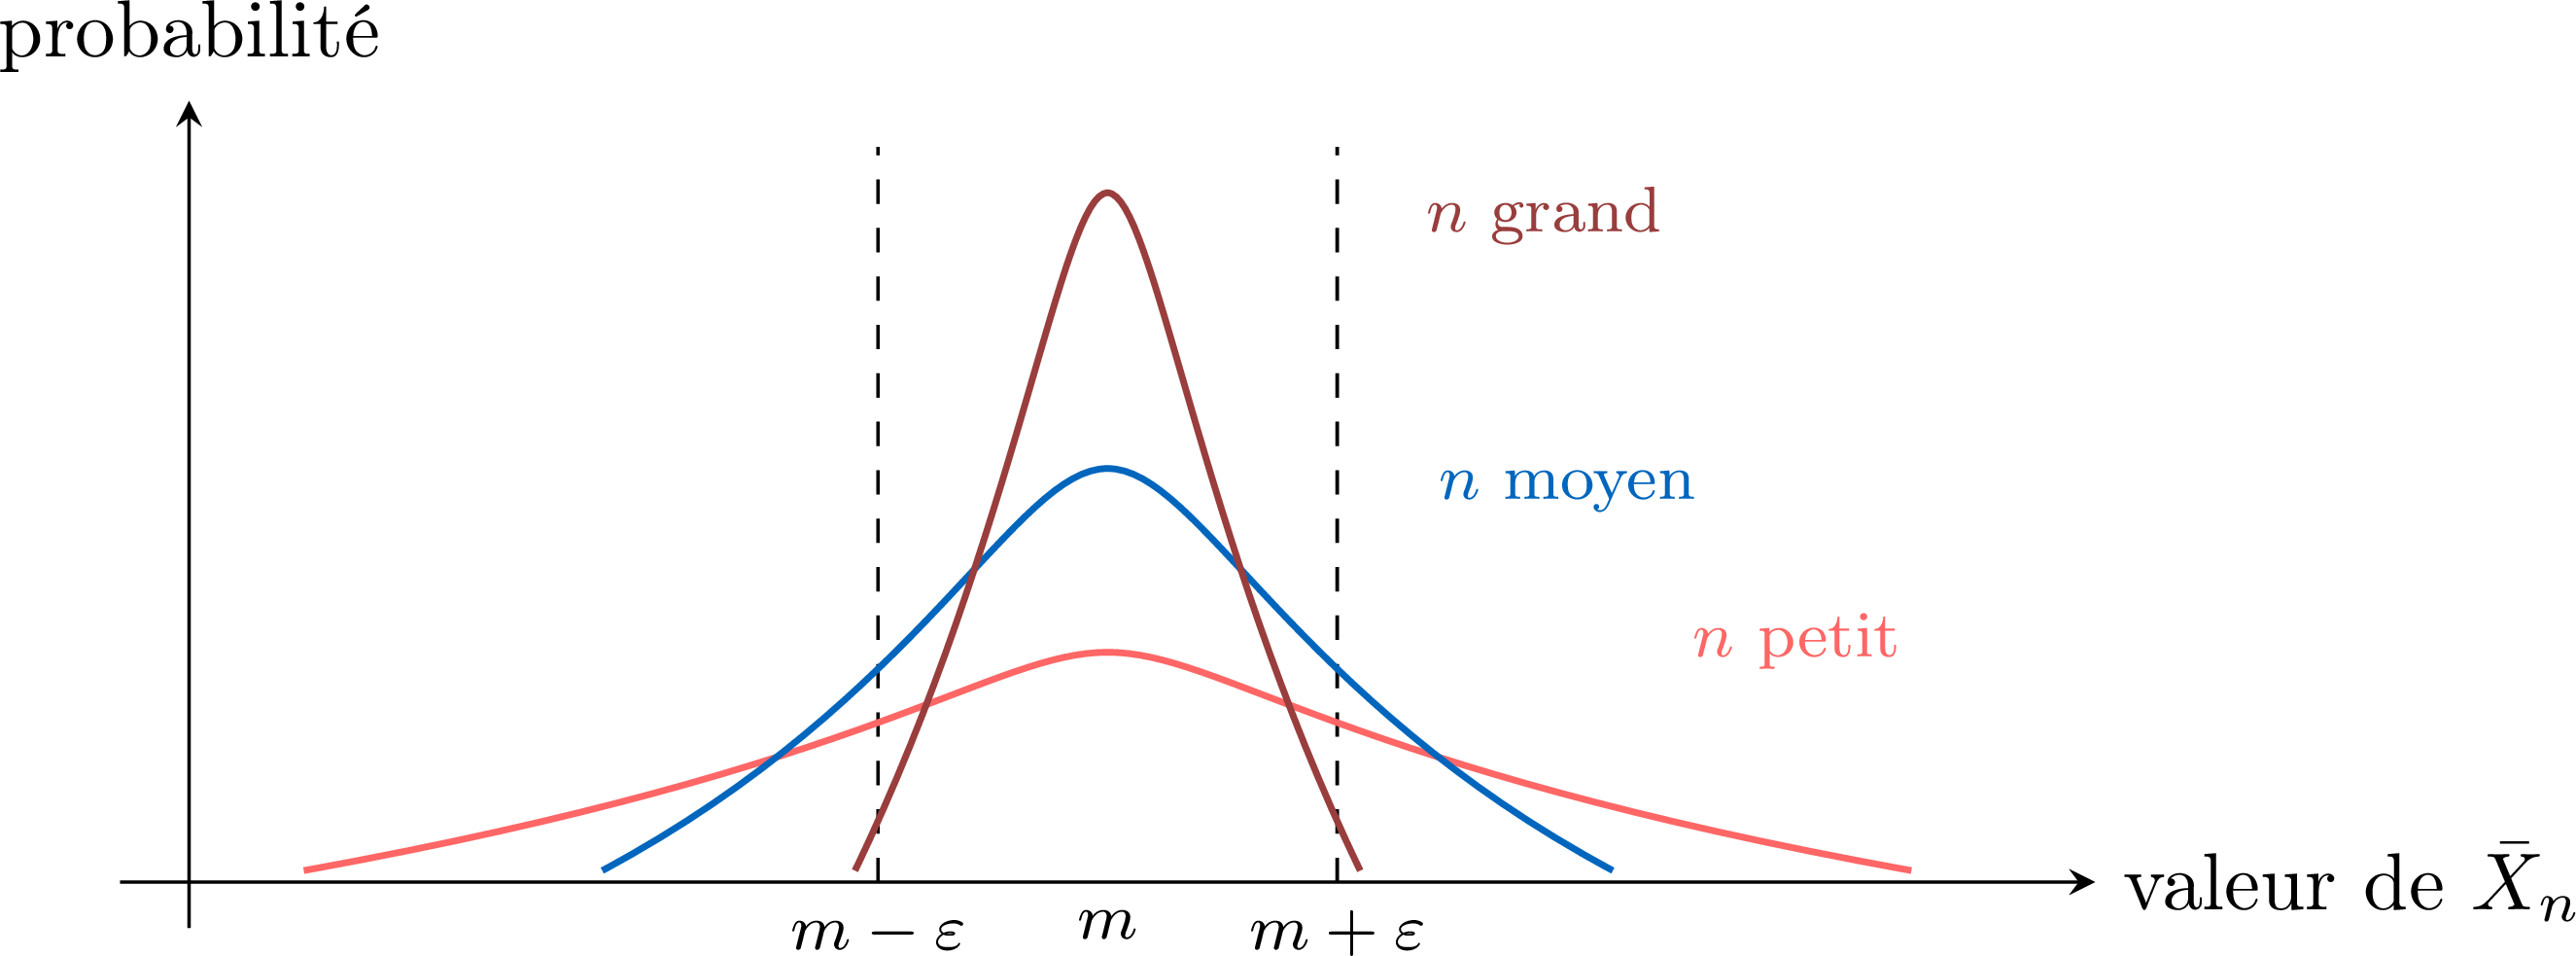
On répète maintenant une expérience de façon indépendante : \((X_n)_{n \ge 1}\) sont des variables aléatoires indépendantes de même loi, d'espérance commune \(m\) et de variance commune \(v\). Leur moyenne empirique \(\bar X_n = \frac1n \sum_{i=1}^n X_i\) est la moyenne courante des \(n\) premières observations. Intuitivement, moyenner annule les fluctuations : la variance de \(\bar X_n\) décroît comme \(1/n\), donc \(\bar X_n\) se concentre de plus en plus étroitement autour de \(m\). On le précise avec Bienaymé-Tchebychev.
Définition — Moyenne empirique
Étant données des variables aléatoires \(X_1, \dots, X_n\), leur moyenne empirique est la variable aléatoire $$ \textcolor{colordef}{\bar X_n = \frac1n \sum_{i=1}^n X_i.} $$ Proposition — Espérance et variance de la moyenne empirique
Soient \(X_1, \dots, X_n\) des variables aléatoires mutuellement indépendantes d'espérance commune \(E(X_i) = m\) et de variance commune \(V(X_i) = v\). Alors \(\bar X_n\) admet une espérance et une variance, avec $$ \textcolor{colorprop}{E(\bar X_n) = m \qquad \text{et} \qquad V(\bar X_n) = \frac{v}{n}.} $$
Pour l'espérance, par linéarité de l'espérance (chapitre Variables aléatoires), $$ E(\bar X_n) = E\!\left(\frac1n \sum_{i=1}^n X_i\right) = \frac1n \sum_{i=1}^n E(X_i) = \frac1n \cdot n m = m. $$ Pour la variance, l'indépendance mutuelle entraîne en particulier l'indépendance deux à deux, hypothèse du résultat sur la variance d'une somme du chapitre Couples de variables aléatoires discrètes, qui donne \(V\!\left(\sum_{i=1}^n X_i\right) = \sum_{i=1}^n V(X_i) = n v\). Puis, avec \(V(aX) = a^2 V(X)\) (chapitre Variables aléatoires) et \(a = 1/n\), $$ \begin{aligned} V(\bar X_n) \ &=\ V\!\left(\frac1n \sum_{i=1}^n X_i\right) \\
&=\ \frac{1}{n^2} \, V\!\left(\sum_{i=1}^n X_i\right) && \text{(\(V(aX) = a^2 V(X)\))} \\
&=\ \frac{1}{n^2} \sum_{i=1}^n V(X_i) && \text{(variance d'une somme, indépendance)} \\
&=\ \frac{1}{n^2} \cdot n v \ =\ \frac{v}{n}. \end{aligned} $$
Proposition — Inégalité de concentration de la moyenne empirique
Sous les mêmes hypothèses (\(X_1, \dots, X_n\) mutuellement indépendantes, espérance \(m\), variance \(v\)), $$ \textcolor{colorprop}{\forall \varepsilon > 0, \quad P\bigl(|\bar X_n - m| \ge \varepsilon\bigr) \le \frac{v}{n \varepsilon^2}.} $$
La variable \(\bar X_n\) admet l'espérance \(E(\bar X_n) = m\) et la variance \(V(\bar X_n) = v/n\) (Proposition précédente). On applique Bienaymé-Tchebychev à \(\bar X_n\) : $$ P\bigl(|\bar X_n - m| \ge \varepsilon\bigr) = P\bigl(|\bar X_n - E(\bar X_n)| \ge \varepsilon\bigr) \le \frac{V(\bar X_n)}{\varepsilon^2} = \frac{v/n}{\varepsilon^2} = \frac{v}{n \varepsilon^2}. $$
Exemple
Un référendum a lieu ; soit \(p\) la proportion inconnue de « oui » dans toute la population. Un sondage interroge \(n = 500\) personnes de façon indépendante ; soit \(X_i \hookrightarrow \mathcal{B}(p)\) l'indicatrice d'un « oui » de la personne \(i\), de sorte que \(\bar X_n\) est la fréquence observée de « oui ». Minorer la probabilité que \(\bar X_n\) soit à moins de \(\varepsilon = 0{,}05\) de \(p\).
Chaque \(X_i \hookrightarrow \mathcal{B}(p)\) a pour variance \(v = p(1 - p)\). Comme \(p(1 - p) \le 1/4\) pour tout \(p \in [0, 1]\), l'inégalité de concentration (forme contraire) donne $$ \begin{aligned} P\bigl(|\bar X_n - p| < \varepsilon\bigr) \ &=\ 1 - P\bigl(|\bar X_n - p| \ge \varepsilon\bigr) && \text{(événement contraire)} \\
&\ge\ 1 - \frac{p(1 - p)}{n \varepsilon^2} && \text{(inégalité de concentration)} \\
&\ge\ 1 - \frac{1/4}{n \varepsilon^2} && \text{(\(p(1 - p) \le 1/4\))} \\
&=\ 1 - \frac{1}{4 \cdot 500 \cdot 0{,}05^2} = 1 - \frac{1}{5} = 0{,}8. \end{aligned} $$ La fréquence observée est à moins de \(0{,}05\) de la vraie proportion avec une probabilité au moins \(0{,}8\), quelle que soit la valeur de \(p\).
La figure ci-dessous représente la loi de \(\bar X_n\) pour trois tailles d'échantillon \(n\) croissantes. Quand \(n\) grandit, les barres se resserrent de plus en plus dans la bande \([m - \varepsilon, m + \varepsilon]\) : c'est la concentration en action.
Compétences à pratiquer
- Borner la moyenne empirique
II.2
La loi faible des grands nombres
On peut maintenant énoncer le résultat phare. Quand la taille d'échantillon \(n\) tend vers l'infini, la probabilité que la moyenne empirique s'écarte de \(m\) d'au moins \(\varepsilon\) tend vers \(0\) — et ce, pour toute précision fixée \(\varepsilon > 0\). La preuve est un encadrement de la majoration de concentration qu'on vient d'obtenir.
Théorème — Loi faible des grands nombres
Soit \((X_n)_{n \ge 1}\) des variables aléatoires mutuellement indépendantes de même loi, d'espérance commune finie \(m\) et de variance commune finie \(v\). Posons \(\bar X_n = \frac1n \sum_{i=1}^n X_i\). Alors $$ \textcolor{colorprop}{\forall \varepsilon > 0, \quad \lim_{n \to +\infty} P\bigl(|\bar X_n - m| \ge \varepsilon\bigr) = 0.} $$
Fixons \(\varepsilon > 0\). Par l'inégalité de concentration, pour tout \(n \ge 1\), $$ 0 \le P\bigl(|\bar X_n - m| \ge \varepsilon\bigr) \le \frac{v}{n \varepsilon^2}. $$ Le membre de droite \(\dfrac{v}{n \varepsilon^2} \to 0\) quand \(n \to +\infty\) (\(\varepsilon\) et \(v\) étant fixés). Par le théorème d'encadrement, \(P(|\bar X_n - m| \ge \varepsilon) \to 0\).
On dit que la moyenne empirique converge en probabilité vers \(m\) : pour toute précision choisie \(\varepsilon\), la probabilité de manquer \(m\) de \(\varepsilon\) ou plus s'évanouit quand l'échantillon grandit. Ce nom décrit la limite en mots ; l'étude systématique de ce mode de convergence relève d'un cours ultérieur.
Méthode — Reconnaître et utiliser la loi faible des grands nombres
- Vérifier les hypothèses : les \(X_i\) sont mutuellement indépendantes, de même loi, d'espérance finie et de variance finie.
- Conclure que la moyenne empirique \(\bar X_n\) se rapproche de la moyenne théorique \(m\) avec une probabilité tendant vers \(1\).
- Le cas de Bernoulli \(X_i \hookrightarrow \mathcal{B}(p)\) se lit : la fréquence empirique d'un événement estime sa probabilité \(p\) — la lecture fréquentiste de la probabilité.
Exemple
On lance \(n\) fois une pièce équilibrée et \(\bar X_n\) est la fréquence observée de piles. Que dit la loi faible des grands nombres sur \(\bar X_n\) ?
On code chaque lancer par \(X_i \hookrightarrow \mathcal{B}(1/2)\) (pile \(= 1\)), les \(X_i\) étant mutuellement indépendantes de même loi, \(m = E(X_i) = 1/2\) et \(v = V(X_i) = 1/4 < +\infty\). Les hypothèses de la loi faible des grands nombres sont vérifiées, donc pour tout \(\varepsilon > 0\), $$ \lim_{n \to +\infty} P\bigl(|\bar X_n - \tfrac12| \ge \varepsilon\bigr) = 0. $$ La fréquence empirique de piles converge en probabilité vers \(1/2\) : c'est la forme rigoureuse de « à la longue, environ la moitié des lancers sont des piles », et cela justifie d'estimer une probabilité inconnue par une fréquence observée.
Compétences à pratiquer
- Appliquer la loi faible des grands nombres
III
Approximation d'une loi binomiale par une loi de Poisson
III.1
La limite binomiale vers Poisson
Le dernier résultat du chapitre concerne les événements rares : beaucoup d'épreuves indépendantes (\(n\) grand), chacune de petite probabilité de succès \(p\), mais un nombre moyen modéré \(n p = \lambda\). Alors le nombre de succès, exactement binomial \(\mathcal{B}(n, p)\), est bien approché par la loi de Poisson \(\mathcal{P}(\lambda)\) rappelée du chapitre Variables aléatoires discrètes (\(P(X = k) = e^{-\lambda} \lambda^k / k!\)). C'est pourquoi la loi de Poisson est le modèle naturel du « nombre d'occurrences rares dans une fenêtre fixée ».
Théorème — Approximation d'une loi binomiale par une loi de Poisson
Soit \(\lambda > 0\). Pour chaque entier \(n \ge \lambda\) (de sorte que \(\lambda/n \in {]0, 1]}\) soit une probabilité valide), soit \(X_n \hookrightarrow \mathcal{B}(n, \lambda/n)\), et soit \(X \hookrightarrow \mathcal{P}(\lambda)\). Alors $$ \textcolor{colorprop}{\forall k \in \mathbb{N}, \quad \lim_{n \to +\infty} P(X_n = k) = e^{-\lambda} \frac{\lambda^k}{k!} = P(X = k).} $$
Admise à ce niveau (la limite se calcule en exercice via \(\binom{n}{k} \sim n^k / k!\) et \((1 - \lambda/n)^n \to e^{-\lambda}\)).
Exemple
Un atelier produit \(n = 1000\) articles, chacun défectueux indépendamment avec probabilité \(p = 0{,}003\), donc \(\lambda = n p = 3\). Soit \(X \hookrightarrow \mathcal{B}(1000, 0{,}003)\) le nombre d'articles défectueux. Comparer \(P(X = 2)\) à l'approximation de Poisson \(\mathcal{P}(3)\).
La valeur binomiale exacte est $$ P(X = 2) = \binom{1000}{2} (0{,}003)^2 (0{,}997)^{998} \approx 0{,}2240. $$ L'approximation de Poisson avec \(\lambda = 3\) donne $$ P(X = 2) \approx e^{-3} \frac{3^2}{2!} = \frac{9}{2} e^{-3} \approx 0{,}2240. $$ Les deux valeurs coïncident à quatre décimales : l'approximation est excellente dans ce régime d'événements rares (\(n\) grand, \(p\) petit, \(n p\) modéré), et évite le coefficient binomial lourd et la puissance \((0{,}997)^{998}\).
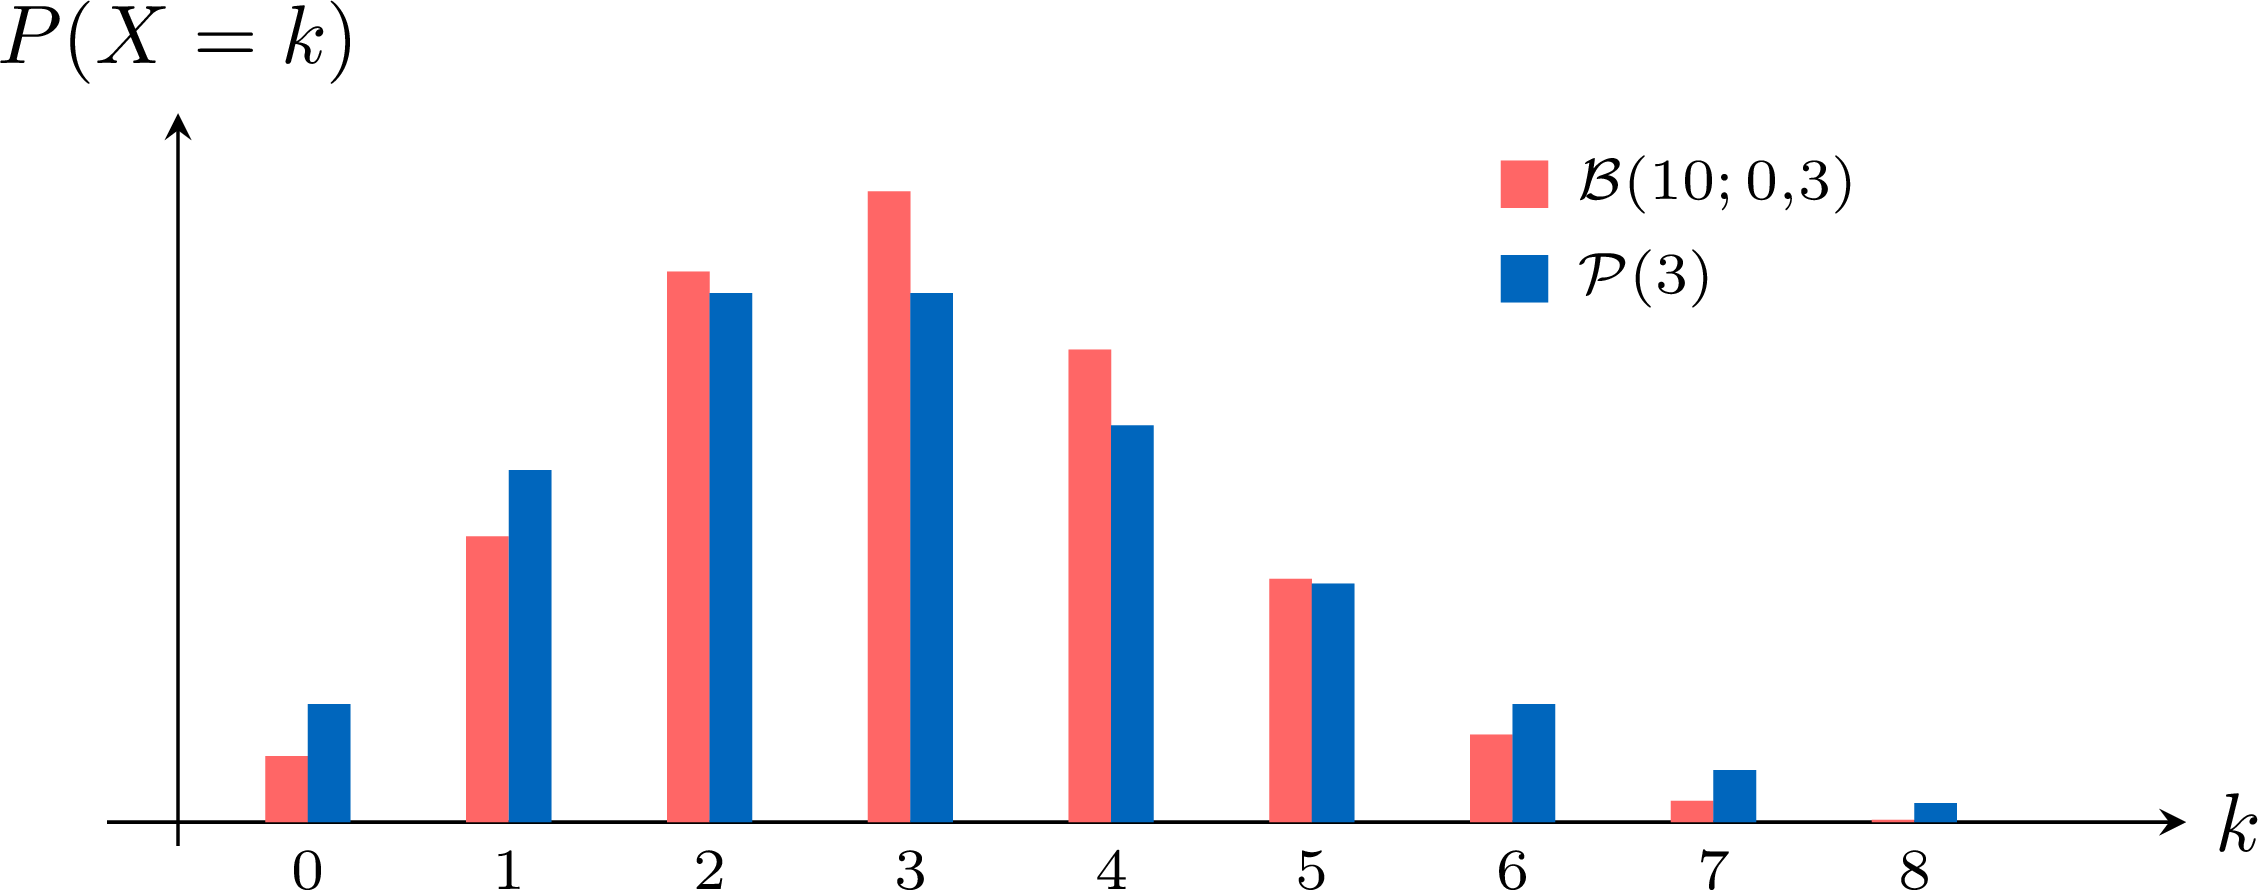
La figure ci-dessous superpose les barres de \(\mathcal{B}(10, 0{,}3)\) (donc \(\lambda = 3\)) et de \(\mathcal{P}(3)\) : même pour le modeste \(n = 10\) les deux profils sont déjà proches, et se rapprochent encore quand \(n\) grandit.
Méthode — Approcher une binomiale par une loi de Poisson
- Vérifier le régime de validité : \(n\) grand, \(p\) petit, le produit \(n p\) modéré.
- Poser \(\lambda = n p\).
- Remplacer le poids binomial exact \(\binom{n}{k} p^k (1 - p)^{n - k}\) par le poids de Poisson \(e^{-\lambda} \lambda^k / k!\).
Compétences à pratiquer
- Approcher une binomiale par une loi de Poisson
III.2
Python — comparer et estimer
On rassemble ici les trois tâches Python que le programme rattache à ce chapitre, chacune illustrant expérimentalement un résultat antérieur : comparer \(\mathcal{B}(n, \lambda/n)\) avec \(\mathcal{P}(\lambda)\) illustre l'approximation du La limite binomiale vers Poisson (P10) ; estimer une probabilité par une fréquence observée illustre la loi faible des grands nombres du section 2 (P12) ; et observer l'expérience de la courbe de Gauss annonce un résultat étudié dans un cours ultérieur (P11). On utilise
numpy comme np, numpy.random comme rd, et matplotlib.pyplot comme plt.
Méthode — Comparer une binomiale et une loi de Poisson par un diagramme en bâtons
Pour éviter les factorielles, on construit les deux vecteurs de poids par la récurrence \(P(X = k+1) = \frac{\lambda}{k+1} P(X = k)\) pour la loi de Poisson, et \(P(X = k+1) = \frac{n - k}{k + 1} \cdot \frac{p}{1 - p} P(X = k)\) pour la binomiale, puis on superpose les deux avec plt.bar : \begin{verbatim} import numpy as np import matplotlib.pyplot as plt lam, n = 3.0, 10 p = lam / n N = 12 # rang de troncature Pois = np.zeros(N + 1) Pois[0] = np.exp(-lam) # P(X = 0) for k in range(N): Pois[k+1] = Pois[k] * lam / (k+1) Bino = np.zeros(N + 1) Bino[0] = (1 - p)**n # P(X = 0) for k in range(N): Bino[k+1] = Bino[k] * (n - k) / (k+1) * p / (1 - p) plt.bar(np.arange(N+1)-0.2, Bino, 0.4, label='B') plt.bar(np.arange(N+1)+0.2, Pois, 0.4, label='P') plt.legend(); plt.show() \end{verbatim} Méthode — Estimer une probabilité par une fréquence
Pour estimer \(P(A)\), on simule \(N\) répétitions indépendantes de l'expérience, on enregistre le booléen « \(A\) s'est produit » pour chacune, et on prend la moyenne empirique comme \(\hat P(A)\). La loi faible des grands nombres garantit \(\hat P(A) \to P(A)\) quand \(N\) grandit. Exemple : estimer \(P(X \ge 5)\) pour \(X \hookrightarrow \mathcal{B}(10, 0{,}3)\) : \begin{verbatim} import numpy.random as rd import numpy as np N = 100000 X = rd.binomial(10, 0.3, size=N) # N tirages independants de B(10, 0.3) estimate = np.mean(X >= 5) # frequence empirique de [X >= 5] print(estimate) # -> proche du vrai P(X >= 5) \end{verbatim} Méthode — Observer l'expérience de la courbe de Gauss
On centre et réduit la binomiale en retranchant sa moyenne et en divisant par son écart-type, on l'échantillonne de nombreuses fois, et on trace l'histogramme du résultat ; on superpose la courbe \(x \mapsto e^{-x^2/2} / \sqrt{2\pi}\). L'histogramme épouse visiblement la courbe — c'est ici une observation purement expérimentale ; le théorème qui la fonde est étudié dans un cours ultérieur. \begin{verbatim} import numpy.random as rd import numpy as np import matplotlib.pyplot as plt n, p, N = 100, 0.3, 100000 X = rd.binomial(n, p, size=N) Z = (X - n*p) / np.sqrt(n*p*(1-p)) # binomiale centree reduite plt.hist(Z, bins=50, density=True) t = np.linspace(-4, 4, 200) plt.plot(t, np.exp(-t**2/2) / np.sqrt(2*np.pi)) plt.show() \end{verbatim}
Pour aller plus loin
La loi faible des grands nombres et l'expérience de la courbe de Gauss pointent toutes deux vers la suite. Un cours ultérieur définit la convergence en loi et démontre le théorème central limite, qui rend rigoureuse l'observation de la courbe de Gauss du Python — comparer et estimer : la moyenne empirique centrée réduite converge vers une loi en cloche fixe, indépendamment de la loi initiale des \(X_i\). Ce même cours ultérieur bâtit la statistique sur la loi des grands nombres — estimateurs d'une moyenne ou d'une proportion inconnue, et intervalles de confiance quantifiant la qualité de ces estimations.
Compétences à pratiquer
- Écrire des simulations Python
IV
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section