Éducation Nationale Française · ECGapprofondies
Variables aléatoires finies
Lors d'une expérience aléatoire on observe rarement l'issue elle-même ; on observe un nombre lu sur l'issue — le score d'un dé, le nombre de piles dans une suite de lancers, l'amplitude de la variation d'un cours de bourse, le nombre d'objets défectueux dans un lot. Une variable aléatoire est exactement cela : un nombre attaché à chaque issue de l'expérience. Ce chapitre se place entièrement sur un univers \(\Omega\) fini muni de la probabilité \(P\) du chapitre précédent. On définit une variable aléatoire, les événements \((X = x)\), \((X \le x)\) et la loi de \(X\), la variable \(Y = g(X)\) obtenue en appliquant une fonction, puis les deux nombres qui résument \(X\) : son espérance \(E(X)\) (la valeur moyenne) et sa variance \(V(X)\) (la dispersion autour de la moyenne). On termine par les lois rencontrées le plus souvent en pratique : les lois constante, de Bernoulli, binomiale et uniforme. Convention. Dans tout ce chapitre \((\Omega, \mathcal{P}(\Omega), P)\) est un espace probabilisé fini issu du chapitre Probabilités sur un ensemble fini. On utilise les notations en lettres droites \(P\), \(E\), \(V\), \(\sigma\) (sans lettres ajourées), le coefficient binomial \(\binom{n}{k}\) et le binôme de Newton viennent du chapitre Méthodes de calcul, et on note \(X \hookrightarrow \mathcal{B}(p)\), \(X \hookrightarrow \mathcal{B}(n, p)\), \(X \hookrightarrow \mathcal{U}(\llbracket a, b \rrbracket)\) pour dire que \(X\) suit la loi correspondante. Aucune hypothèse de positivité du support n'est nécessaire : si une valeur de \(X(\Omega)\) est de probabilité nulle, toute formule dégénère proprement (les termes correspondants s'annulent dans \(E(X)\) et \(V(X)\)).
I
Variables aléatoires, événements et loi
I.1
Variable aléatoire sur un univers fini
Lors d'une expérience aléatoire, ce qui importe souvent n'est pas l'issue élémentaire elle-même mais un nombre lu sur cette issue. Une variable aléatoire formalise cela : c'est simplement une application \(X : \Omega \to \mathbb{R}\). Comme \(\Omega\) est fini, l'ensemble des valeurs que peut prendre \(X\) est lui-même fini, ce qui fait que toutes les formules de ce chapitre sont des sommes finies.
Définition — Variable aléatoire réelle finie
Une variable aléatoire réelle finie (en abrégé v.a.\ finie) sur l'espace probabilisé \((\Omega, \mathcal{P}(\Omega), P)\) est une application $$ X : \Omega \longrightarrow \mathbb{R}, \qquad \omega \longmapsto X(\omega). $$ L'ensemble des valeurs de \(X\), noté \(X(\Omega) = \{X(\omega), \ \omega \in \Omega\}\), est une partie finie de \(\mathbb{R}\). On dit « ensemble des valeurs » plutôt que « support » pour éviter la convention post-bac qui réserve « support » aux valeurs de probabilité strictement positive. Exemple
On lance une pièce avec \(\Omega = \{P, F\}\). L'application \(X\) envoyant \(P\) sur \(1\) et \(F\) sur \(0\) est une v.a.\ finie ; son ensemble de valeurs est \(X(\Omega) = \{0, 1\}\). Exemple
On lance deux dés distinguables avec \(\Omega = \llbracket 1, 6 \rrbracket^2\). L'application \(S : (i, j) \mapsto i + j\) est une v.a.\ finie (la « somme des deux dés ») ; son ensemble de valeurs est \(S(\Omega) = \llbracket 2, 12 \rrbracket\), onze valeurs au total. Exemple
Trois lancers indépendants d'une pièce avec \(\Omega = \{P, F\}^3\), les huit issues étant équiprobables. On note \(N\) le nombre de piles obtenus. Alors \(N\) est une v.a.\ finie avec \(N(\Omega) = \{0, 1, 2, 3\}\). L'application constante \(C : \omega \mapsto 7\) est aussi une v.a.\ finie, avec \(C(\Omega) = \{7\}\).
Deux variables de même loi ne sont pas forcément égales
Attention : deux v.a.\ finies peuvent prendre les mêmes valeurs avec les mêmes probabilités tout en étant des applications distinctes sur \(\Omega\). En lançant une pièce équilibrée, soit \(X\) valant \(1\) sur Pile et \(0\) sur Face, et \(Y\) valant \(1\) sur Face et \(0\) sur Pile. Chacune de \(X\) et \(Y\) prend les valeurs \(0\) et \(1\) avec probabilité \(1/2\) — mais pour toute issue \(\omega\), \(X(\omega) \ne Y(\omega)\). La loi (sous-sections suivantes) résume \(X\) mais ne la caractérise pas comme application.
Compétences à pratiquer
- Identifier l'ensemble des valeurs
- Modéliser une v.a.\ finie à partir d'une expérience
I.2
Événements liés à \(X\) et système complet associé
Une fois \(X\) fixée, des expressions comme « \(X\) vaut \(x\) » ou « \(X\) est compris entre \(a\) et \(b\) » décrivent des événements de l'expérience — des parties de \(\Omega\) — auxquelles on applique la probabilité \(P\). Tout le vocabulaire des événements du chapitre précédent (intersection, événement contraire, additivité…) se transporte sur ces nouveaux ensembles.
Définition — Événements liés à \(X\)
Soit \(X\) une v.a.\ finie sur \((\Omega, \mathcal{P}(\Omega), P)\). Pour \(x \in \mathbb{R}\), \(a, b \in \mathbb{R}\) avec \(a \le b\), et \(I \subset \mathbb{R}\), on note $$ \begin{aligned} (X = x) &= \{\omega \in \Omega, \ X(\omega) = x\}, \\
(X \le x) &= \{\omega \in \Omega, \ X(\omega) \le x\}, \\
(a \le X \le b) &= \{\omega \in \Omega, \ a \le X(\omega) \le b\}, \\
(X \in I) &= \{\omega \in \Omega, \ X(\omega) \in I\}. \end{aligned} $$ Chacun de ces objets est un événement, c'est-à-dire une partie de \(\Omega\) ; on lui applique \(P\) comme au chapitre précédent. Les abréviations \(P(X = x)\), \(P(X \le x)\) remplacent les pesantes \(P((X = x))\), \(P((X \le x))\). Exemple
Pour la somme de deux dés \(S\) avec \(\Omega = \llbracket 1, 6 \rrbracket^2\) équiprobable, l'événement \((S = 4)\) est l'ensemble des couples de somme \(4\) : $$ (S = 4) = \{(1, 3), \ (2, 2), \ (3, 1)\}, \qquad P(S = 4) = \frac{3}{36} = \frac{1}{12}. $$ Exemple
Même cadre, l'événement \((S \le 3)\) est \(\{(1, 1), (1, 2), (2, 1)\}\), donc \(P(S \le 3) = 3/36 = 1/12\) ; et \((S \in \{2, 12\})\) est \(\{(1, 1), (6, 6)\}\), donc \(P(S \in \{2, 12\}) = 2/36 = 1/18\). Proposition — Système complet associé à \(X\)
Soit \(X\) une v.a.\ finie avec \(X(\Omega) = \{x_1, \dots, x_p\}\) (valeurs distinctes). La famille $$ \bigl( (X = x_1), \ (X = x_2), \ \dots, \ (X = x_p) \bigr) $$ est un système complet d'événements de \(\Omega\) — les \(p\) événements sont deux à deux disjoints et leur réunion est \(\Omega\). Par conséquent $$ \textcolor{colorprop}{\sum_{i = 1}^{p} P(X = x_i) = 1.} $$
Disjonction. Pour \(i \ne j\), \((X = x_i) \cap (X = x_j)\) est l'ensemble des \(\omega \in \Omega\) avec \(X(\omega) = x_i\) et \(X(\omega) = x_j\) ; comme \(x_i \ne x_j\), aucun tel \(\omega\) n'existe, donc l'intersection est vide. Recouvrement. Pour tout \(\omega \in \Omega\), \(X(\omega) \in X(\Omega) = \{x_1, \dots, x_p\}\), donc \(\omega\) est dans exactement un \((X = x_i)\). La réunion vaut donc \(\Omega\). Par additivité de \(P\) sur une partition finie (rappelée du chapitre précédent), $$ \begin{aligned} 1 \ =\ P(\Omega) \ &=\ P\!\left(\bigcup_{i = 1}^{p} (X = x_i)\right) && \text{(recouvrement)} \\
&=\ \sum_{i = 1}^{p} P(X = x_i) && \text{(disjonction + additivité).} \end{aligned} $$
Compétences à pratiquer
- Décrire les événements \([X \equal x]\) et \([X \le x]\) comme parties de \(\Omega\)
- Utiliser \(\sum P(X \equal x) \equal 1\) pour trouver un poids manquant
I.3
Loi d'une variable aléatoire
Connaître une variable aléatoire en pratique signifie savoir, pour chaque valeur qu'elle peut prendre, avec quelle probabilité elle la prend. C'est exactement sa loi.
Définition — Loi d'une variable aléatoire finie
La loi (ou distribution de probabilité) d'une v.a.\ finie \(X\) est l'application $$ \textcolor{colordef}{P_X : X(\Omega) \longrightarrow [0, 1], \qquad x \longmapsto P(X = x).} $$ D'après la proposition précédente, les valeurs \(P_X(x_i) = P(X = x_i)\) sont positives ou nulles et de somme \(1\) sur \(X(\Omega) = \{x_1, \dots, x_p\}\). La loi se présente souvent sous forme de tableau : $$ \begin{array}{|c|c|c|c|c|} \hline x_i & x_1 & x_2 & \dots & x_p \\
\hline P(X = x_i) & P(X = x_1) & P(X = x_2) & \dots & P(X = x_p) \\
\hline \end{array} $$ Une valeur \(x \in X(\Omega)\) donnée peut vérifier \(P(X = x) = 0\) (quand l'événement \((X = x)\) est vide ou ne contient que des issues de probabilité nulle) ; de telles valeurs ne contribuent pas aux espérances et variances et sont usuellement omises du tableau. Deux v.a.\ \(X\) et \(Y\) sont dites de même loi lorsque \(X(\Omega) = Y(\Omega)\) et \(P(X = x) = P(Y = x)\) pour tout \(x \in X(\Omega)\) — elles peuvent rester distinctes en tant qu'applications sur \(\Omega\) (voir le bloc Text de Variable aléatoire sur un univers fini). Exemple
On lance un dé équilibré à six faces. Soit \(X\) valant \(1\) si le résultat est au moins \(5\), et \(0\) sinon. Alors \(X(\Omega) = \{0, 1\}\), avec \((X = 1) = \{5, 6\}\) donc \(P(X = 1) = 2/6 = 1/3\), et \(P(X = 0) = 1 - 1/3 = 2/3\). Exemple
Pour la somme \(S\) de deux dés équilibrés, \(S(\Omega) = \llbracket 2, 12 \rrbracket\) et le tableau de loi est $$ \begin{array}{|c|c|c|c|c|c|c|c|c|c|c|c|} \hline k & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & 10 & 11 & 12 \\
\hline P(S = k) & \tfrac{1}{36} & \tfrac{2}{36} & \tfrac{3}{36} & \tfrac{4}{36} & \tfrac{5}{36} & \tfrac{6}{36} & \tfrac{5}{36} & \tfrac{4}{36} & \tfrac{3}{36} & \tfrac{2}{36} & \tfrac{1}{36} \\
\hline \end{array} $$ Les onze coefficients somment à \(36/36 = 1\), ce qui confirme l'identité du système complet. Méthode — Déterminer la loi d'une v.a.\ finie
Pour déterminer la loi d'une v.a.\ finie \(X\) : - énumérer son ensemble de valeurs \(X(\Omega)\) en lisant l'expérience ;
- pour chaque \(x \in X(\Omega)\), décrire l'événement \((X = x)\) comme partie de \(\Omega\) et calculer \(P(X = x)\) (par équiprobabilité, par les règles du chapitre précédent, ou par un arbre) ;
- vérifier que \(\sum_{x \in X(\Omega)} P(X = x) = 1\).
Exemple
Une urne contient \(3\) boules blanches et \(2\) boules noires. On tire \(2\) boules simultanément. Soit \(X\) le nombre de boules blanches tirées. Déterminer la loi de \(X\).
On applique la méthode.
- Ensemble de valeurs : avec \(2\) tirages et \(3\) boules blanches disponibles, \(X \in \{0, 1, 2\}\), donc \(X(\Omega) = \{0, 1, 2\}\).
- Par équiprobabilité avec \(\binom{5}{2} = 10\) paires non ordonnées de boules : $$ \begin{aligned} P(X = 0) &= \frac{\binom{2}{2}}{\binom{5}{2}} = \frac{1}{10} && \text{(deux noires),} \\ P(X = 1) &= \frac{\binom{3}{1} \binom{2}{1}}{\binom{5}{2}} = \frac{6}{10} && \text{(une de chaque),} \\ P(X = 2) &= \frac{\binom{3}{2}}{\binom{5}{2}} = \frac{3}{10} && \text{(deux blanches).} \end{aligned} $$
- Vérification : \(\dfrac{1}{10} + \dfrac{6}{10} + \dfrac{3}{10} = \dfrac{10}{10} = 1\). La loi est valide.
Compétences à pratiquer
- Tabuler la loi d'une variable finie
- Déduire \(P(X \in I)\) de la loi
II
Variable aléatoire fonction d'une autre
II.1
La variable \(Y \equal g(X)\)
Composer une variable aléatoire avec une fonction réelle donne une nouvelle variable aléatoire. Cette construction est partout : \(aX + b\) rééchelonne, \(X^2\) élève au carré, \(|X|\) replie autour de \(0\). Connaissant la loi de \(X\), on peut toujours lire la loi de \(Y = g(X)\) en regroupant les antécédents.
Définition — Composée \(Y \equal g(X)\)
Soient \(X\) une v.a.\ finie sur \((\Omega, \mathcal{P}(\Omega), P)\) et \(g : X(\Omega) \to \mathbb{R}\) une fonction. L'application $$ Y = g(X) : \Omega \longrightarrow \mathbb{R}, \qquad \omega \longmapsto g(X(\omega)) $$ est une v.a.\ finie sur \((\Omega, \mathcal{P}(\Omega), P)\), d'ensemble de valeurs \(Y(\Omega) = g(X(\Omega))\). Exemple
Soit \(X\) prenant ses valeurs dans \(\{-1, 0, 1, 2\}\) (selon une loi quelconque sur ces quatre valeurs). Pour \(g : x \mapsto x^2\), la variable \(Y = X^2\) prend ses valeurs dans \(g(\{-1, 0, 1, 2\}) = \{0, 1, 4\}\) : les valeurs \(-1\) et \(1\) se confondent en \(1\). (On évite ici le mot « uniforme » car la loi uniforme n'est introduite qu'à la dernière section.) Exemple
Pour toute v.a.\ finie \(X\), la composée \(|X|\) replie les valeurs négatives sur leur valeur absolue : si \(X(\Omega) = \{-3, -1, 0, 2, 5\}\), alors \(|X|(\Omega) = \{0, 1, 2, 3, 5\}\). De même \(2X + 1\) a pour valeurs \(\{-5, -1, 1, 5, 11\}\) — un changement d'étiquettes, sans confusion. Proposition — Loi de \(Y \equal g(X)\)
Soient \(X\) une v.a.\ finie et \(g : X(\Omega) \to \mathbb{R}\). Pour tout \(y \in g(X(\Omega))\), $$ \textcolor{colorprop}{P(Y = y) = \sum_{x \in X(\Omega),\ g(x) = y} P(X = x).} $$ La somme est prise sur les antécédents de \(y\) par \(g\) qui sont dans \(X(\Omega)\).
L'événement \((Y = y) = (g(X) = y)\) est, par définition, \(\{\omega \in \Omega, \ g(X(\omega)) = y\}\), ou encore \(\{\omega \in \Omega, \ X(\omega) \in g^{-1}(\{y\})\}\). En posant \(A_y = \{x \in X(\Omega), \ g(x) = y\}\), cela se réécrit $$ \begin{aligned} (Y = y) &= \bigcup_{x \in A_y} (X = x) && \text{(partition par valeur de \(X\))}, \\
P(Y = y) &= \sum_{x \in A_y} P(X = x) && \text{(union disjointe, additivité de \(P\)).} \end{aligned} $$ La disjonction vient de la disjonction des \((X = x)\) pour \(x\) distincts (Proposition sur le système complet).
Méthode — Déterminer la loi de \(g(X)\)
Pour déterminer la loi de \(Y = g(X)\) : - énumérer \(Y(\Omega) = g(X(\Omega))\) en appliquant \(g\) à chaque valeur de \(X\) et en retirant les répétitions ;
- pour chaque \(y \in Y(\Omega)\), réunir les antécédents \(\{x \in X(\Omega), \ g(x) = y\}\) et sommer leurs \(P(X = x)\) ;
- vérifier \(\sum_{y \in Y(\Omega)} P(Y = y) = 1\).
Compétences à pratiquer
- Trouver la loi de \(g(X)\) par antécédents
- Tabuler la loi de \(Y \equal X^2\)
II.2
Cas simples, \(aX + b\) et \(X^2\)
Les deux cas simples de la méthode précédente méritent d'être isolés : la transformée affine \(Y = aX + b\) ré-étiquette la loi, et le carré \(Y = X^2\) regroupe les valeurs \(x\) et \(-x\) quand toutes deux sont dans \(X(\Omega)\).
Proposition — Loi d'une transformée affine
Soient \(X\) une v.a.\ finie, \(a \in \mathbb{R}^*\) et \(b \in \mathbb{R}\). La variable \(Y = aX + b\) a pour ensemble de valeurs \(Y(\Omega) = a \cdot X(\Omega) + b = \{a x + b, \ x \in X(\Omega)\}\) et $$ \forall y \in Y(\Omega), \qquad \textcolor{colorprop}{P(Y = y) = P\!\left(X = \frac{y - b}{a}\right).} $$
La fonction \(g : x \mapsto ax + b\) sur \(\mathbb{R}\) est injective (car \(a \ne 0\)) : si \(a x_1 + b = a x_2 + b\) alors \(x_1 = x_2\). Donc pour tout \(y \in Y(\Omega)\), l'ensemble des antécédents \(\{x \in X(\Omega), \ ax + b = y\}\) est un singleton : son unique élément est \(x = (y - b)/a\). Par la Proposition précédente, \(P(Y = y) = P(X = (y - b)/a)\).
Exemple
Soit \(X\) de tableau de loi $$ \begin{array}{|c|c|c|c|} \hline x_i & 1 & 2 & 3 \\
\hline P(X = x_i) & \tfrac{1}{6} & \tfrac{1}{3} & \tfrac{1}{2} \\
\hline \end{array} $$ Déterminer la loi de \(Y = 2X + 1\).
On applique la proposition de ré-étiquetage avec \(a = 2\), \(b = 1\). Alors \(Y(\Omega) = 2 \cdot \{1, 2, 3\} + 1 = \{3, 5, 7\}\) et les poids se transportent : $$ \begin{array}{|c|c|c|c|} \hline y_i & 3 & 5 & 7 \\
\hline P(Y = y_i) & \tfrac{1}{6} & \tfrac{1}{3} & \tfrac{1}{2} \\
\hline \end{array} $$ Vérification : \(\tfrac{1}{6} + \tfrac{1}{3} + \tfrac{1}{2} = \tfrac{1 + 2 + 3}{6} = 1\).
Exemple
Une application économique simple : un rendement d'action \(X\) prend les valeurs \(\{-0{,}05, 0, 0{,}05\}\) (une perte de \(5\pourcent\), pas de variation, un gain de \(5\pourcent\)) avec les poids \(\{0{,}3, 0{,}4, 0{,}3\}\). Le gain en euros d'un investisseur sur une position de \(1000\) euros est la transformée affine \(Y = 1000 \, X\). Par la proposition de ré-étiquetage avec \(a = 1000\), \(b = 0\), \(Y\) prend les valeurs \(\{-50, 0, 50\}\) avec les mêmes poids \(\{0{,}3, 0{,}4, 0{,}3\}\) — le gain en euros a la même structure de risque que le rendement en pourcentage, avec des issues remises à l'échelle. Proposition — Loi de \(X^2\)
Soit \(X\) une v.a.\ finie. La variable \(Y = X^2\) a pour ensemble de valeurs \(Y(\Omega) = \{x^2, \ x \in X(\Omega)\}\). De plus, pour \(y \in Y(\Omega)\) : - si \(y > 0\), \(\textcolor{colorprop}{P(Y = y) = P(X = \sqrt{y}) + P(X = -\sqrt{y})}\), où chaque terme \(P(X = \alpha)\) vaut \(0\) lorsque \(\alpha \notin X(\Omega)\) (car \((X = \alpha) = \varnothing\) dans ce cas) ;
- si \(y = 0\), \(\textcolor{colorprop}{P(Y = 0) = P(X = 0)}\).
Pour \(y > 0\), \(g(x) = y\) se réécrit \(x^2 = y\), c'est-à-dire \(x = \sqrt{y}\) ou \(x = -\sqrt{y}\) ; l'ensemble des antécédents dans \(X(\Omega)\) contient au plus ces deux valeurs distinctes, d'où la formule par somme. Pour \(y = 0\), \(x^2 = 0\) force \(x = 0\), donc l'ensemble des antécédents est \(\{0\}\) si \(0 \in X(\Omega)\), vide sinon. On applique la Proposition sur la loi de \(g(X)\).
Exemple
Soit \(X\) de \(X(\Omega) = \{-2, -1, 0, 1, 2\}\) avec les poids \(P(X = k) = 1/5\) pour chaque \(k\). Alors \(Y = X^2\) prend ses valeurs dans \(\{0, 1, 4\}\), avec $$ \begin{aligned} P(Y = 0) &= P(X = 0) \ =\ 1/5, \\
P(Y = 1) &= P(X = 1) + P(X = -1) \ =\ 1/5 + 1/5 \ =\ 2/5, \\
P(Y = 4) &= P(X = 2) + P(X = -2) \ =\ 1/5 + 1/5 \ =\ 2/5. \end{aligned} $$ Les deux valeurs \(-1\) et \(1\) de \(X\) se confondent en \(1\) pour \(Y\) (et de même \(-2, 2\) se confondent en \(4\)), donc les poids s'additionnent. Vérification : \(1/5 + 2/5 + 2/5 = 1\). Compétences à pratiquer
- Tabuler la loi de \(Y \equal aX + b\)
- Calculer la loi de \(Y \equal X^2\) sur un support symétrique
III
Espérance
III.1
Définition et premières propriétés
L'espérance d'une variable aléatoire est sa valeur moyenne, pondérée par les probabilités de ses valeurs. Deux points de vue équivalents entrent en jeu : une somme sur les valeurs de \(X\) (son ensemble \(X(\Omega)\)), et une somme sur les issues de \(\Omega\). Le second est l'outil de travail pour la linéarité et la croissance — il transforme l'espérance en une honnête somme finie sur \(\Omega\).
Définition — Espérance d'une v.a.\ finie
Soit \(X\) une v.a.\ finie avec \(X(\Omega) = \{x_1, \dots, x_p\}\). L'espérance de \(X\) est le réel $$ \textcolor{colordef}{E(X) \ =\ \sum_{i = 1}^{p} x_i \, P(X = x_i) \ =\ \sum_{x \in X(\Omega)} x \, P(X = x).} $$ La somme est finie, donc \(E(X)\) existe toujours. Géométriquement, \(E(X)\) est la moyenne pondérée des valeurs de \(X\). Exemple
Calculer \(E(X)\) pour le tableau de loi $$ \begin{array}{|c|c|c|c|} \hline x_i & 1 & 2 & 3 \\
\hline P(X = x_i) & \tfrac{1}{6} & \tfrac{1}{3} & \tfrac{1}{2} \\
\hline \end{array} $$
Par définition, $$ \begin{aligned} E(X) &= 1 \cdot \tfrac{1}{6} + 2 \cdot \tfrac{1}{3} + 3 \cdot \tfrac{1}{2} && \text{(définition de \(E(X)\))} \\
&= \tfrac{1}{6} + \tfrac{4}{6} + \tfrac{9}{6} && \text{(dénominateur commun \(6\))} \\
&= \tfrac{14}{6} \ =\ \tfrac{7}{3} && \text{(arithmétique).} \end{aligned} $$
Exemple
Pour une variable constante \(C\) d'ensemble de valeurs \(C(\Omega) = \{7\}\), \(E(C) = 7 \cdot 1 = 7\). La moyenne d'une constante est cette constante. Exemple
Pour la loi \(\{0, 1, 2\}\) avec les poids \(\{1/4, 1/2, 1/4\}\), \(E(X) = 0 \cdot 1/4 + 1 \cdot 1/2 + 2 \cdot 1/4 = 1\). La moyenne est au centre de la loi symétrique. Proposition — Espérance comme somme sur \(\Omega\)
Sur un espace probabilisé fini \((\Omega, \mathcal{P}(\Omega), P)\), pour toute v.a.\ finie \(X\), $$ \textcolor{colorprop}{E(X) \ =\ \sum_{\omega \in \Omega} X(\omega) \, P(\{\omega\}).} $$
On partitionne \(\Omega\) selon le système complet associé à \(X\) : en écrivant \(X(\Omega) = \{x_1, \dots, x_p\}\), toute \(\omega \in \Omega\) est dans exactement un événement \((X = x_i)\). Alors $$ \begin{aligned} \sum_{\omega \in \Omega} X(\omega) P(\{\omega\}) &= \sum_{i = 1}^{p} \ \sum_{\omega \in (X = x_i)} X(\omega) P(\{\omega\}) && \text{(partition de \(\Omega\))} \\
&= \sum_{i = 1}^{p} \ \sum_{\omega \in (X = x_i)} x_i \, P(\{\omega\}) && \text{(\(X(\omega) = x_i\) sur \((X = x_i)\))} \\
&= \sum_{i = 1}^{p} x_i \ \sum_{\omega \in (X = x_i)} P(\{\omega\}) && \text{(on sort \(x_i\) de la somme)} \\
&= \sum_{i = 1}^{p} x_i \, P(X = x_i) && \text{(\(P\) est additive sur un ensemble fini)} \\
&= E(X) && \text{(définition de \(E(X)\)).} \end{aligned} $$
Proposition — Encadrement et croissance de l'espérance
Soient \(X\), \(Y\) des v.a.\ finies sur le même \((\Omega, \mathcal{P}(\Omega), P)\). - encadrement : si \(X(\Omega) \subset [a, b]\), alors \(a \le E(X) \le b\) ; en particulier, si \(X \ge 0\) (toute valeur de \(X\) est positive ou nulle), alors \(E(X) \ge 0\) ;
- croissance : si \(X \le Y\) sur \(\Omega\) (c'est-à-dire \(X(\omega) \le Y(\omega)\) pour toute \(\omega\)), alors \(E(X) \le E(Y)\).
On utilise la formule sur \(\Omega\). Encadrement — borne supérieure. À partir de \(X(\omega) \le b\) pour toute \(\omega \in \Omega\), on multiplie par \(P(\{\omega\}) \ge 0\) et on somme : $$ \begin{aligned} \sum_{\omega \in \Omega} X(\omega) P(\{\omega\}) &\le \sum_{\omega \in \Omega} b \, P(\{\omega\}) && \text{(monotonie de \(\Sigma\))} \\
E(X) &\le b \sum_{\omega \in \Omega} P(\{\omega\}) && \text{(formule sur \(\Omega\), on sort \(b\))} \\
E(X) &\le b \cdot 1 \ =\ b && \text{(\(\sum_\omega P(\{\omega\}) = 1\)).} \end{aligned} $$ Encadrement — borne inférieure. Symétriquement à partir de \(a \le X(\omega)\), \(a \le E(X)\). En particulier, dans le cas \(a = 0\), \(X \ge 0\) donne \(E(X) \ge 0\). Croissance. À partir de \(X(\omega) \le Y(\omega)\) sur \(\Omega\), on multiplie par \(P(\{\omega\}) \ge 0\) et on somme : $$ \sum_{\omega \in \Omega} X(\omega) P(\{\omega\}) \ \le\ \sum_{\omega \in \Omega} Y(\omega) P(\{\omega\}), \qquad \text{c'est-à-dire } E(X) \le E(Y). $$
Compétences à pratiquer
- Calculer une espérance à partir d'un tableau de loi
- Encadrer \(E(X)\) par le support
III.2
Linéarité et théorème de transfert
La propriété la plus puissante de l'espérance est la linéarité — l'espérance d'une somme de variables est la somme des espérances, sans référence à une loi jointe ni à une indépendance. Combinée au théorème de transfert, qui permet de lire \(E(g(X))\) sur la seule loi de \(X\), elle donne accès à \(E(X^2)\), \(E(aX + b)\), \(E(aX + bY)\), et à la variance de la section suivante.
Proposition — Espérance d'une transformée affine
Soient \(X\) une v.a.\ finie et \((a, b) \in \mathbb{R}^2\). Alors $$ \textcolor{colorprop}{E(aX + b) \ =\ a \, E(X) + b.} $$
Par la formule sur \(\Omega\) et la linéarité de la somme finie (rappelée de Méthodes de calcul) : $$ \begin{aligned} E(aX + b) &= \sum_{\omega \in \Omega} (a X(\omega) + b) P(\{\omega\}) && \text{(formule sur \(\Omega\) appliquée à \(aX + b\))} \\
&= a \sum_{\omega \in \Omega} X(\omega) P(\{\omega\}) + b \sum_{\omega \in \Omega} P(\{\omega\}) && \text{(linéarité de \(\Sigma\))} \\
&= a \, E(X) + b \cdot 1 && \text{(formule sur \(\Omega\) et \(\sum_\omega P(\{\omega\}) = 1\))} \\
&= a \, E(X) + b. \end{aligned} $$
Proposition — Linéarité pour deux variables
Soient \(X\), \(Y\) des v.a.\ finies sur le même \((\Omega, \mathcal{P}(\Omega), P)\) et \((a, b) \in \mathbb{R}^2\). Alors $$ \textcolor{colorprop}{E(aX + bY) \ =\ a \, E(X) + b \, E(Y).} $$
Par la formule sur \(\Omega\) et la linéarité de \(\Sigma\) : $$ \begin{aligned} E(aX + bY) &= \sum_{\omega \in \Omega} \bigl( a X(\omega) + b Y(\omega) \bigr) P(\{\omega\}) && \text{(formule sur \(\Omega\))} \\
&= a \sum_{\omega \in \Omega} X(\omega) P(\{\omega\}) + b \sum_{\omega \in \Omega} Y(\omega) P(\{\omega\}) && \text{(linéarité de \(\Sigma\))} \\
&= a \, E(X) + b \, E(Y) && \text{(formule sur \(\Omega\) appliquée à \(X\) et \(Y\)).} \end{aligned} $$
Exemple
Soient \(X\) et \(Y\) deux v.a.\ finies sur le même \(\Omega\) avec \(E(X) = 3\) et \(E(Y) = -1\). Par linéarité, \(E(2X - 3Y + 4) = 2 E(X) - 3 E(Y) + 4 = 2 \cdot 3 - 3 \cdot (-1) + 4 = 6 + 3 + 4 = 13\), calculé sans jamais connaître la loi de \(X\), la loi de \(Y\), ni le comportement joint des deux. C'est la force de la linéarité : elle ignore complètement la loi jointe. Théorème — Théorème de transfert
Soient \(X\) une v.a.\ finie sur \((\Omega, \mathcal{P}(\Omega), P)\) et \(g : X(\Omega) \to \mathbb{R}\). Alors $$ \textcolor{colorprop}{E\bigl( g(X) \bigr) \ =\ \sum_{x \in X(\Omega)} g(x) \, P(X = x).} $$ Admis à ce niveau (le résultat peut être obtenu en combinant la loi de \(g(X)\) du La variable \(Y \equal g(X)\) avec la définition de l'espérance ; le programme inscrit ce théorème comme admis, on l'utilisera donc tel quel). Exemple
Même loi qu'au-dessus pour \(X\) sur \(\{1, 2, 3\}\) avec les poids \(1/6, 1/3, 1/2\). Calculer \(E(X^2)\) par le théorème de transfert.
Par le théorème de transfert avec \(g(x) = x^2\), $$ \begin{aligned} E(X^2) &= \sum_{x \in \{1, 2, 3\}} x^2 P(X = x) && \text{(théorème de transfert)} \\
&= 1^2 \cdot \tfrac{1}{6} + 2^2 \cdot \tfrac{1}{3} + 3^2 \cdot \tfrac{1}{2} && \text{(substitution)} \\
&= \tfrac{1}{6} + \tfrac{8}{6} + \tfrac{27}{6} && \text{(dénominateur commun \(6\))} \\
&= \tfrac{36}{6} \ =\ 6. \end{aligned} $$
Méthode — Calculer \(E\) par linéarité
Pour calculer \(E(X)\), ne pas toujours sommer sur les valeurs de \(X\) : - décomposer \(X\) en somme de v.a.\ plus simples — typiquement comme \(aY + b\) pour un \(Y\) connu, ou comme somme d'indicatrices (section suivante) ;
- calculer l'espérance de chaque morceau ;
- combiner par linéarité \(E(aX + bY) = a E(X) + b E(Y)\).
Compétences à pratiquer
- Appliquer la linéarité à \(E(aX + b)\)
- Utiliser le théorème de transfert pour \(E(g(X))\)
IV
Variance et écart-type
IV.1
Définition, \(V(aX + b)\), et le cas \(V(X) \equal 0\)
L'espérance résume la valeur typique de \(X\), mais pas l'écart entre \(X\) et cette valeur. La variance mesure cet écart : c'est l'espérance du carré de l'écart \((X - E(X))^2\). Une petite variance signifie que \(X\) reste proche de sa moyenne ; une variance nulle force \(X\) à être quasi certainement constante.
Définition — Variance et écart-type
La variance d'une v.a.\ finie \(X\) est le réel $$ \textcolor{colordef}{V(X) \ =\ E\bigl( (X - E(X))^2 \bigr).} $$ Par le théorème de transfert avec \(g(x) = (x - E(X))^2\), $$ \textcolor{colordef}{V(X) \ =\ \sum_{x \in X(\Omega)} (x - E(X))^2 \, P(X = x) \ \ge\ 0.} $$ L'écart-type de \(X\) est le réel \(\sigma(X) = \sqrt{V(X)} \ge 0\). Il a la même dimension physique que \(X\), donc c'est lui que l'on lit usuellement pour mesurer la dispersion. Exemple
Pour \(X\) sur \(\{1, 2, 3\}\) avec les poids \(1/6, 1/3, 1/2\) (donc \(E(X) = 7/3\)), calculer \(V(X)\) directement à partir de la définition.
Avec \(E(X) = 7/3\), les écarts valent \(1 - 7/3 = -4/3\), \(2 - 7/3 = -1/3\), \(3 - 7/3 = 2/3\). En les élevant au carré : \(16/9\), \(1/9\), \(4/9\). Alors $$ \begin{aligned} V(X) &= \tfrac{16}{9} \cdot \tfrac{1}{6} + \tfrac{1}{9} \cdot \tfrac{1}{3} + \tfrac{4}{9} \cdot \tfrac{1}{2} && \text{(définition)} \\
&= \tfrac{16}{54} + \tfrac{1}{27} + \tfrac{4}{18} && \text{(produits)} \\
&= \tfrac{16}{54} + \tfrac{2}{54} + \tfrac{12}{54} && \text{(dénominateur commun \(54\))} \\
&= \tfrac{30}{54} \ =\ \tfrac{5}{9} && \text{(simplification).} \end{aligned} $$ L'écart-type vaut \(\sigma(X) = \sqrt{5/9} = \sqrt{5}/3\).
Proposition — Variance d'une transformée affine
Soient \(X\) une v.a.\ finie et \((a, b) \in \mathbb{R}^2\). Alors $$ \textcolor{colorprop}{V(aX + b) \ =\ a^2 \, V(X), \qquad \sigma(aX + b) \ =\ |a| \, \sigma(X).} $$
Par linéarité, \(E(aX + b) = a E(X) + b\), donc $$ \begin{aligned} (aX + b) - E(aX + b) &= (aX + b) - (a E(X) + b) && \text{(par linéarité)} \\
&= a \bigl( X - E(X) \bigr) && \text{(le \(b\) se simplifie).} \end{aligned} $$ On élève au carré et on prend l'espérance ; en sortant la constante \(a^2\) (linéarité à nouveau) : $$ V(aX + b) \ =\ E\!\bigl( a^2 (X - E(X))^2 \bigr) \ =\ a^2 \, E\!\bigl( (X - E(X))^2 \bigr) \ =\ a^2 \, V(X). $$ La forme avec l'écart-type s'en déduit par racine carrée : \(\sigma(aX + b) = \sqrt{a^2 V(X)} = |a| \, \sigma(X)\).
Proposition — \(V(X) \equal 0\) ssi \(X\) est quasi certainement constante
Soit \(X\) une v.a.\ finie. Alors $$ \textcolor{colorprop}{V(X) = 0 \ \Longleftrightarrow \ \exists a \in \mathbb{R}, \ P(X = a) = 1.} $$ Dans ce cas on dit que \(X\) est quasi certainement constante, égale à la valeur \(a = E(X)\) avec probabilité \(1\).
On note \(X(\Omega) = \{x_1, \dots, x_p\}\).
- (\(\Rightarrow\)). Supposons \(V(X) = 0\). Par la formule via théorème de transfert, $$ V(X) \ =\ \sum_{i = 1}^{p} (x_i - E(X))^2 \, P(X = x_i) \ =\ 0. $$ C'est une somme de termes positifs ou nuls égale à zéro, donc chaque terme est nul : pour tout \(i\), \((x_i - E(X))^2 P(X = x_i) = 0\). Si \(P(X = x_i) > 0\), alors \((x_i - E(X))^2 = 0\), donc \(x_i = E(X)\). Ainsi toutes les valeurs de probabilité strictement positive valent l'unique nombre \(a := E(X)\) ; en posant \(a = E(X)\), \(P(X = a) = \sum_{x_i = a} P(X = x_i) = \sum_{i = 1}^{p} P(X = x_i) = 1\).
- (\(\Leftarrow\)). Supposons \(P(X = a) = 1\) pour un \(a \in \mathbb{R}\). Alors \(\sum_{i, \ x_i \ne a} P(X = x_i) = 1 - P(X = a) = 0\), donc \(P(X = x_i) = 0\) pour tout \(x_i \ne a\). Alors \(E(X) = a \cdot 1 + \sum_{x_i \ne a} x_i \cdot 0 = a\), et $$ V(X) \ =\ (a - a)^2 \cdot 1 \ +\ \sum_{x_i \ne a} (x_i - a)^2 \cdot 0 \ =\ 0. $$
Compétences à pratiquer
- Calculer une variance à partir de la définition
- Appliquer \(V(aX + b) \equal a^2 V(X)\)
IV.2
Koenig-Huygens et variable centrée réduite
La définition directe de la variance est rarement la voie de calcul la plus rapide. La formule de Koenig-Huygens \(V(X) = E(X^2) - E(X)^2\) remplace une somme avec les écarts \((x_i - E(X))^2\) par deux moments plus simples : \(E(X^2)\) par transfert, et \(E(X)^2\) en élevant l'espérance au carré. Une fois \(V(X)\) obtenu, normaliser \(X\) pour qu'elle soit centrée et de variance \(1\) donne la variable centrée réduite, la forme standard utilisée dans tous les théorèmes de convergence plus tard dans l'année.
Proposition — Formule de Koenig-Huygens
Soit \(X\) une v.a.\ finie. Alors $$ \textcolor{colorprop}{V(X) \ =\ E(X^2) \ -\ E(X)^2.} $$ En particulier, \(E(X^2) \ge E(X)^2\), avec égalité ssi \(X\) est quasi certainement constante.
On développe \((X - E(X))^2 = X^2 - 2 E(X) X + E(X)^2\). Le nombre \(E(X)\) est une constante, donc par linéarité de l'espérance : $$ \begin{aligned} V(X) &= E\!\bigl( (X - E(X))^2 \bigr) && \text{(définition)} \\
&= E\!\bigl( X^2 - 2 E(X) X + E(X)^2 \bigr) && \text{(développement du carré)} \\
&= E(X^2) - 2 E(X) \cdot E(X) + E(X)^2 \cdot 1 && \text{(linéarité, \(E(X)\) et \(E(X)^2\) sortent)} \\
&= E(X^2) - 2 E(X)^2 + E(X)^2 && \text{(arithmétique)} \\
&= E(X^2) - E(X)^2. \end{aligned} $$ Comme \(V(X) \ge 0\), on obtient \(E(X^2) \ge E(X)^2\) ; l'égalité force \(V(X) = 0\), c'est-à-dire \(X\) quasi certainement constante.
Exemple
Recalculer \(V(X)\) pour \(X\) sur \(\{1, 2, 3\}\) avec les poids \(1/6, 1/3, 1/2\), cette fois par Koenig-Huygens.
On a déjà \(E(X) = 7/3\) et \(E(X^2) = 6\) (du calcul par transfert précédent). Par Koenig-Huygens, $$ \begin{aligned} V(X) &= E(X^2) - E(X)^2 && \text{(Koenig-Huygens)} \\
&= 6 - \left( \tfrac{7}{3} \right)^2 && \text{(on substitue)} \\
&= 6 - \tfrac{49}{9} && \text{(au carré)} \\
&= \tfrac{54}{9} - \tfrac{49}{9} \ =\ \tfrac{5}{9} && \text{(dénominateur commun).} \end{aligned} $$ Même réponse que par le calcul direct, avec moins d'étapes arithmétiques.
Définition — Variable centrée, réduite, centrée réduite
Une v.a.\ finie \(X\) est - centrée quand \(E(X) = 0\) ;
- réduite quand \(V(X) = 1\) ;
- centrée réduite quand simultanément \(E(X) = 0\) et \(V(X) = 1\).
Proposition — \(X^*\) est centrée réduite
Soit \(X\) une v.a.\ finie avec \(\sigma(X) > 0\). Alors $$ \textcolor{colorprop}{E(X^*) \ =\ 0, \qquad V(X^*) \ =\ 1.} $$
La variable \(X^*\) est la transformée affine \(X^* = (1/\sigma(X)) X + (-E(X)/\sigma(X))\). Par les propositions sur les transformées affines, $$ \begin{aligned} E(X^*) &= \tfrac{1}{\sigma(X)} E(X) - \tfrac{E(X)}{\sigma(X)} && \text{(\(E(aX + b) = a E(X) + b\))} \\
&= \tfrac{E(X) - E(X)}{\sigma(X)} \ =\ 0, \\
V(X^*) &= \left( \tfrac{1}{\sigma(X)} \right)^2 V(X) && \text{(\(V(aX + b) = a^2 V(X)\))} \\
&= \tfrac{V(X)}{\sigma(X)^2} \ =\ \tfrac{V(X)}{V(X)} \ =\ 1 && \text{(\(\sigma(X)^2 = V(X)\)).} \end{aligned} $$
Méthode — Centrer et réduire une variable
Pour centrer et réduire une v.a.\ finie \(X\) avec \(\sigma(X) > 0\) : - calculer \(E(X)\) à partir de la loi (ou par linéarité) ;
- calculer \(V(X)\), typiquement par Koenig-Huygens : \(V(X) = E(X^2) - E(X)^2\) ;
- former \(X^* = (X - E(X))/\sigma(X)\) avec \(\sigma(X) = \sqrt{V(X)}\).
Compétences à pratiquer
- Calculer \(V(X)\) par Koenig-Huygens
- Centrer et réduire \(X\)
V
Lois finies usuelles
V.1
Lois constante et de Bernoulli
On clôt le chapitre par les quatre lois que l'on rencontre le plus souvent en probabilités finies. Les deux premières modélisent les expériences les plus petites : une valeur fixe (la loi constante) et un lancer de pièce (la loi de Bernoulli). La loi de Bernoulli est en fait la brique à partir de laquelle se construit la loi binomiale de la sous-section suivante.
Définition — Loi constante (ou certaine)
Une v.a.\ finie \(X\) suit la loi constante de valeur \(a \in \mathbb{R}\) quand \(P(X = a) = 1\). De façon équivalente (puisque \(X\) est finie, par la proposition \(V(X) = 0\) de section 4), \(X\) prend la valeur \(a\) quasi certainement ; en particulier \(E(X) = a\) et \(V(X) = 0\). Exemple
Un dé pipé donnant toujours \(6\) définit une v.a.\ constante d'ensemble de valeurs \(X(\Omega) = \{6\}\) ; \(E(X) = 6\), \(V(X) = 0\). Définition — Épreuve de Bernoulli et loi de Bernoulli
Une épreuve de Bernoulli est une expérience aléatoire dans laquelle on distingue un seul événement \(A\), conventionnellement appelé succès, et son contraire, l'échec \(\overline{A}\) — ce cadre est typique d'une situation d'indicatrice où l'expérience peut avoir de nombreuses issues élémentaires, mais où on ne note que la réalisation ou non de \(A\). Une v.a.\ finie \(X\) suit la loi de Bernoulli de paramètre \(p \in [0, 1]\), ce que l'on note $$ X \hookrightarrow \mathcal{B}(p), $$ quand \(X(\Omega) \subset \{0, 1\}\) avec \(P(X = 1) = p\) et \(P(X = 0) = 1 - p\). L'inclusion \(X(\Omega) \subset \{0, 1\}\) (et non l'égalité) couvre les cas dégénérés \(p = 0\) (alors \(X = 0\) quasi certainement) et \(p = 1\) (alors \(X = 1\) quasi certainement). Exemple
Un lancer d'une pièce équilibrée codé \(1\) sur Pile et \(0\) sur Face donne \(X \hookrightarrow \mathcal{B}(1/2)\). Une pièce biaisée avec \(P(\text{Pile}) = 0{,}9\) donne \(X \hookrightarrow \mathcal{B}(0{,}9)\). Une « pièce » déterministe donnant toujours Face donne \(X \hookrightarrow \mathcal{B}(0)\) — le cas dégénéré où le succès a probabilité \(0\). Définition — Indicatrice d'un événement
Pour un événement \(A \subset \Omega\), l'indicatrice de \(A\) est la v.a.\ finie \(\mathbf{1}_A : \Omega \to \mathbb{R}\) définie par $$ \mathbf{1}_A(\omega) \ =\ \begin{cases} 1 & \text{si } \omega \in A, \\
0 & \text{si } \omega \notin A. \end{cases} $$ Alors \(\mathbf{1}_A \hookrightarrow \mathcal{B}(P(A))\) : l'indicatrice de \(A\) suit la loi de Bernoulli de paramètre \(P(A)\). Exemple
On lance un dé équilibré avec \(\Omega = \llbracket 1, 6 \rrbracket\) et soit \(A = \{2, 4, 6\}\) l'événement « le résultat est pair ». Alors \(P(A) = 3/6 = 1/2\), donc \(\mathbf{1}_A \hookrightarrow \mathcal{B}(1/2)\). L'indicatrice \(\mathbf{1}_A\) vaut \(1\) sur \(\{2, 4, 6\}\) et \(0\) sur \(\{1, 3, 5\}\). Proposition — Espérance et variance de \(\mathcal{B}(p)\)
Si \(X \hookrightarrow \mathcal{B}(p)\), alors $$ \textcolor{colorprop}{E(X) \ =\ p, \qquad V(X) \ =\ p(1 - p), \qquad \sigma(X) \ =\ \sqrt{p(1 - p)}.} $$
Par la définition de l'espérance, $$ E(X) \ =\ 0 \cdot (1 - p) + 1 \cdot p \ =\ p. $$ Pour la variance, on calcule \(E(X^2)\) par le théorème de transfert avec \(g(x) = x^2\) (en notant \(0^2 = 0\) et \(1^2 = 1\)) : $$ E(X^2) \ =\ 0^2 \cdot (1 - p) + 1^2 \cdot p \ =\ p. $$ Puis par Koenig-Huygens, $$ \begin{aligned} V(X) &= E(X^2) - E(X)^2 && \text{(Koenig-Huygens)} \\
&= p - p^2 && \text{(valeurs au-dessus)} \\
&= p (1 - p) && \text{(factorisation de \(p\)).} \end{aligned} $$ L'écart-type vaut \(\sigma(X) = \sqrt{p(1 - p)}\).
Compétences à pratiquer
- Identifier une loi constante
- Identifier un modèle de Bernoulli
- Travailler avec une indicatrice d'événement
V.2
Loi binomiale
Heuristiquement, la loi binomiale compte le nombre de succès lorsqu'une expérience de probabilité de succès \(p\) est répétée \(n\) fois sous des conditions qui n'interfèrent pas les unes avec les autres (avec remise, lancers indépendants). À ce niveau on adopte la formule explicite \(P(X = k) = \binom{n}{k} p^k (1 - p)^{n - k}\) comme définition de la loi binomiale ; l'étude formelle de l'indépendance entre variables aléatoires sera développée plus tard dans l'année. La formule fait intervenir le coefficient binomial et le binôme de Newton du chapitre Méthodes de calcul, dont on se sert ci-dessous pour vérifier \(\sum_k P(X = k) = 1\).
Définition — Loi binomiale \(\mathcal{B}(n\virgule p)\)
Soient \(n \in \mathbb{N}^*\) et \(p \in [0, 1]\). Une v.a.\ finie \(X\) suit la loi binomiale de paramètres \(n\) et \(p\), ce que l'on note $$ X \hookrightarrow \mathcal{B}(n, p), $$ quand \(X(\Omega) \subset \llbracket 0, n \rrbracket\) et $$ \forall k \in \llbracket 0, n \rrbracket, \qquad \textcolor{colordef}{P(X = k) \ =\ \binom{n}{k} \, p^k \, (1 - p)^{n - k}.} $$ L'inclusion \(X(\Omega) \subset \llbracket 0, n \rrbracket\) (et non l'égalité) couvre les cas dégénérés \(p = 0\) et \(p = 1\). Avec la convention \(0^0 = 1\) (utilisée ici lorsque \(p = 0\) en \(k = 0\), ou \(1 - p = 0\) en \(k = n\)), la formule donne \(P(X = 0) = 1\), \(P(X = k) = 0\) pour \(k \ge 1\) quand \(p = 0\), et symétriquement \(P(X = n) = 1\) quand \(p = 1\) — comme attendu dans ces cas dégénérés. La loi de Bernoulli de paramètre \(p\) est la loi binomiale avec \(n = 1\) : \(\mathcal{B}(1, p) = \mathcal{B}(p)\). Exemple
Le diagramme en barres ci-dessous représente la loi de \(X \hookrightarrow \mathcal{B}(10, 1/2)\). Les sept barres centrales portent l'essentiel de la masse de probabilité ; la loi est symétrique autour de \(k = 5\) car \(p = 1 - p = 1/2\). 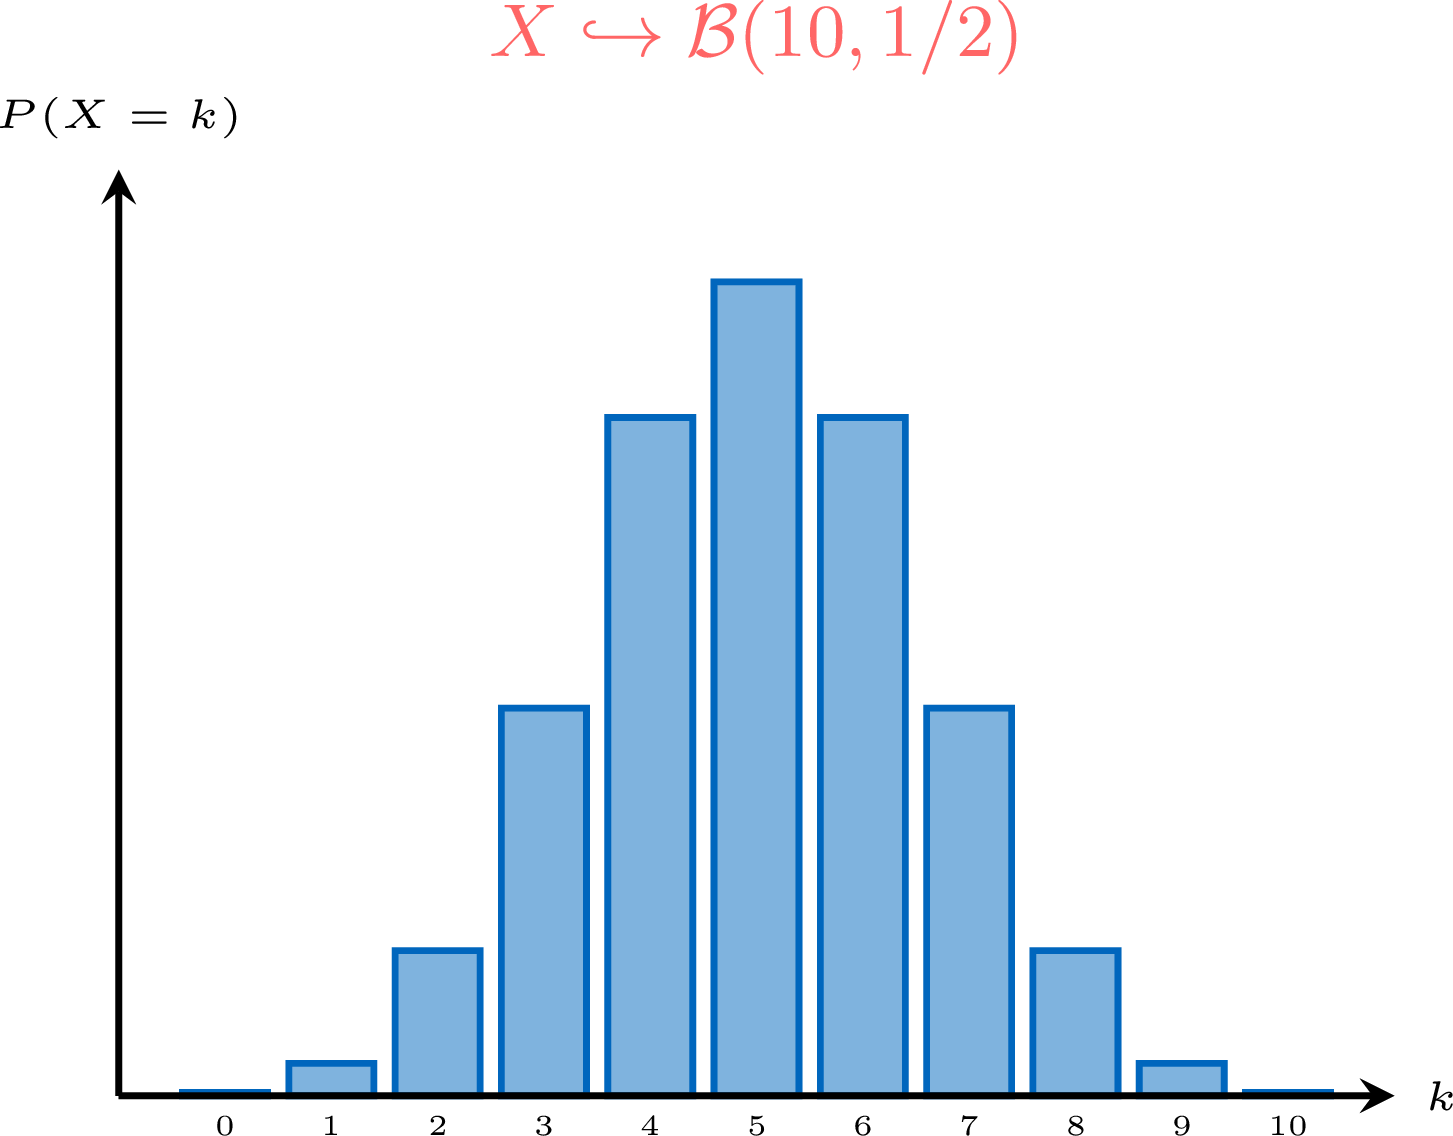
Proposition — \(\mathcal{B}(n\virgule p)\) est bien une loi
Pour tous \(n \in \mathbb{N}^*\) et \(p \in [0, 1]\), les nombres \(\binom{n}{k} p^k (1 - p)^{n - k}\) sont positifs ou nuls pour \(k \in \llbracket 0, n \rrbracket\), et $$ \textcolor{colorprop}{\sum_{k = 0}^{n} \binom{n}{k} p^k (1 - p)^{n - k} \ =\ 1.} $$
Positivité. Le coefficient binomial \(\binom{n}{k}\) est un entier positif (de Méthodes de calcul), et les deux facteurs \(p^k\) et \((1 - p)^{n - k}\) sont positifs ou nuls puisque \(p \in [0, 1]\) et \(1 - p \in [0, 1]\). Leur produit est donc positif ou nul. Somme égale à un. Par le binôme de Newton (Méthodes de calcul) appliqué aux réels \(p\) et \(1 - p\) : $$ \begin{aligned} \sum_{k = 0}^{n} \binom{n}{k} p^k (1 - p)^{n - k} &= \bigl( p + (1 - p) \bigr)^n && \text{(binôme de Newton)} \\
&= 1^n \ =\ 1 && \text{(en simplifiant \(p + (1-p) = 1\)).} \end{aligned} $$
Exemple
Une urne contient \(4\) boules rouges et \(6\) boules bleues. On tire \(5\) boules avec remise. Soit \(X\) le nombre de rouges tirées. Identifier la loi de \(X\), puis calculer \(P(X = 2)\).
Les tirages avec remise gardent la proportion de rouges constante à \(p = 4/10 = 0{,}4\) à chaque tirage, et les cinq tirages n'interfèrent pas les uns avec les autres — le modèle est \(X \hookrightarrow \mathcal{B}(5, 0{,}4)\). Alors $$ \begin{aligned} P(X = 2) &= \binom{5}{2} (0{,}4)^2 (0{,}6)^3 && \text{(définition de \(\mathcal{B}(n, p)\))} \\
&= 10 \cdot 0{,}16 \cdot 0{,}216 && \text{(valeurs)} \\
&= 0{,}3456 && \text{(produit).} \end{aligned} $$
Proposition — Espérance et variance de \(\mathcal{B}(n\virgule p)\)
Si \(X \hookrightarrow \mathcal{B}(n, p)\), alors $$ \textcolor{colorprop}{E(X) \ =\ n p, \qquad V(X) \ =\ n p (1 - p).} $$
Espérance. Par la définition de \(E\) appliquée à la loi binomiale, $$ \begin{aligned} E(X) &= \sum_{k = 0}^{n} k \binom{n}{k} p^k (1 - p)^{n - k} && \text{(définition de \(E\))} \\
&= \sum_{k = 1}^{n} k \binom{n}{k} p^k (1 - p)^{n - k} && \text{(le terme \(k = 0\) est nul)} \\
&= \sum_{k = 1}^{n} n \binom{n - 1}{k - 1} p^k (1 - p)^{n - k} && \text{(par \(k \binom{n}{k} = n \binom{n-1}{k-1}\), \textit{Méthodes de calcul})} \\
&= n p \sum_{k = 1}^{n} \binom{n - 1}{k - 1} p^{k - 1} (1 - p)^{n - k} && \text{(on sort \(np\))} \\
&= n p \sum_{j = 0}^{n - 1} \binom{n - 1}{j} p^j (1 - p)^{n - 1 - j} && \text{(décalage \(j = k - 1\))} \\
&= n p \cdot 1 \ =\ n p && \text{(binôme de Newton à nouveau).} \end{aligned} $$ Variance. Pour \(n = 1\), \(\mathcal{B}(1, p) = \mathcal{B}(p)\), donc \(V(X) = p(1 - p) = 1 \cdot p \cdot (1 - p)\) est déjà connu. Pour \(n \ge 2\), on calcule \(E(X(X - 1))\) par la même technique avec l'identité \(k(k - 1) \binom{n}{k} = n(n - 1) \binom{n - 2}{k - 2}\) (Méthodes de calcul) : $$ \begin{aligned} E(X(X - 1)) &= \sum_{k = 0}^{n} k(k - 1) \binom{n}{k} p^k (1 - p)^{n - k} && \text{(théorème de transfert)} \\
&= \sum_{k = 2}^{n} n(n - 1) \binom{n - 2}{k - 2} p^k (1 - p)^{n - k} && \text{(les termes \(k = 0\) et \(k = 1\) sont nuls)} \\
&= n(n - 1) p^2 \sum_{j = 0}^{n - 2} \binom{n - 2}{j} p^j (1 - p)^{n - 2 - j} && \text{(décalage \(j = k - 2\))} \\
&= n(n - 1) p^2 \cdot 1 \ =\ n(n - 1) p^2 && \text{(Newton).} \end{aligned} $$ Puis \(E(X^2) = E(X(X - 1)) + E(X) = n(n - 1) p^2 + n p\), et par Koenig-Huygens $$ \begin{aligned} V(X) &= E(X^2) - E(X)^2 && \text{(Koenig-Huygens)} \\
&= n(n - 1) p^2 + n p - n^2 p^2 && \text{(on substitue)} \\
&= n p \bigl( (n - 1) p + 1 - n p \bigr) && \text{(factorisation par \(n p\))} \\
&= n p (1 - p) && \text{(\((n - 1)p - np = -p\)).} \end{aligned} $$ Les deux cas donnent \(V(X) = n p (1 - p)\).
Méthode — Modéliser par la loi binomiale
Un comptage aléatoire \(X\) est modélisé par \(X \hookrightarrow \mathcal{B}(n, p)\) quand : - l'expérience est la répétition de \(n\) épreuves, chacune de probabilité de succès \(p\) (supposée constante d'une épreuve à l'autre) ;
- les épreuves n'interfèrent pas les unes avec les autres — cas types : tirages avec remise dans une urne, lancers répétés indépendants adoptés comme hypothèse de travail.
Compétences à pratiquer
- Calculer \(P(X \equal k)\) sous \(\mathcal{B}(n\virgule p)\)
- Appliquer \(E(X) \equal np\) et \(V(X) \equal np(1 - p)\)
V.3
Loi uniforme
La loi uniforme modélise l'expérience finie la plus « équilibrée » : chaque entier d'une plage choisie est équiprobable. C'est la loi d'un dé équilibré (à \(n\) faces), d'un entier tiré au hasard dans \(\llbracket a, b \rrbracket\), d'une position de carte tirée sans biais.
Définition — Loi uniforme sur \(\llbracket 1\virgule n \rrbracket\)
Soit \(n \in \mathbb{N}^*\). Une v.a.\ finie \(X\) suit la loi uniforme sur \(\llbracket 1, n \rrbracket\), ce que l'on note $$ X \hookrightarrow \mathcal{U}(\llbracket 1, n \rrbracket), $$ quand \(X(\Omega) = \llbracket 1, n \rrbracket\) et \(\forall k \in \llbracket 1, n \rrbracket, \ P(X = k) = 1/n\). Exemple
Un lancer d'un dé équilibré à six faces donne le résultat sous la forme \(X \hookrightarrow \mathcal{U}(\llbracket 1, 6 \rrbracket)\). Les six valeurs \(1, \dots, 6\) sont équiprobables, chacune de probabilité \(1/6\). Proposition — Espérance et variance de \(\mathcal{U}(\llbracket 1\virgule n \rrbracket)\)
Si \(X \hookrightarrow \mathcal{U}(\llbracket 1, n \rrbracket)\), alors $$ \textcolor{colorprop}{E(X) \ =\ \frac{n + 1}{2}, \qquad V(X) \ =\ \frac{n^2 - 1}{12}.} $$
Par la définition de l'espérance et les sommes classiques de Méthodes de calcul (\(\sum_{k = 1}^{n} k = n(n + 1)/2\), \(\sum_{k = 1}^{n} k^2 = n(n + 1)(2 n + 1)/6\)) : $$ \begin{aligned} E(X) &= \sum_{k = 1}^{n} k \cdot \tfrac{1}{n} \ =\ \tfrac{1}{n} \sum_{k = 1}^{n} k && \text{(définition, \(1/n\) en facteur)} \\
&= \tfrac{1}{n} \cdot \tfrac{n(n + 1)}{2} \ =\ \tfrac{n + 1}{2} && \text{(forme close de \(\sum k\)).} \end{aligned} $$ Pour \(E(X^2)\) par le théorème de transfert avec \(g(x) = x^2\), $$ \begin{aligned} E(X^2) &= \sum_{k = 1}^{n} k^2 \cdot \tfrac{1}{n} \ =\ \tfrac{1}{n} \sum_{k = 1}^{n} k^2 && \text{(transfert + \(1/n\) en facteur)} \\
&= \tfrac{1}{n} \cdot \tfrac{n(n + 1)(2 n + 1)}{6} \ =\ \tfrac{(n + 1)(2 n + 1)}{6} && \text{(forme close de \(\sum k^2\)).} \end{aligned} $$ Par Koenig-Huygens, $$ \begin{aligned} V(X) &= E(X^2) - E(X)^2 && \text{(Koenig-Huygens)} \\
&= \tfrac{(n + 1)(2 n + 1)}{6} - \tfrac{(n + 1)^2}{4} && \text{(valeurs ci-dessus)} \\
&= \tfrac{2(n + 1)(2 n + 1) - 3(n + 1)^2}{12} && \text{(dénominateur commun \(12\))} \\
&= \tfrac{(n + 1) \bigl( 2(2 n + 1) - 3(n + 1) \bigr)}{12} && \text{(factorisation par \((n + 1)\))} \\
&= \tfrac{(n + 1)(n - 1)}{12} \ =\ \tfrac{n^2 - 1}{12} && \text{(simplification).} \end{aligned} $$
Définition — Loi uniforme sur \(\llbracket a\virgule b \rrbracket\)
Soient \((a, b) \in \mathbb{Z}^2\) avec \(a \le b\). Une v.a.\ finie \(X\) suit la loi uniforme sur \(\llbracket a, b \rrbracket\), ce que l'on note $$ X \hookrightarrow \mathcal{U}(\llbracket a, b \rrbracket), $$ quand \(X(\Omega) = \llbracket a, b \rrbracket\) et \(\forall k \in \llbracket a, b \rrbracket, \ P(X = k) = 1 / (b - a + 1)\). Exemple
Une face de dé à six faces numérotée \(0, 1, 2, 3, 4, 5\) définit \(X \hookrightarrow \mathcal{U}(\llbracket 0, 5 \rrbracket)\) avec \(E(X) = (0 + 5)/2 = 5/2\) et \(V(X) = ((5 - 0 + 1)^2 - 1)/12 = (36 - 1)/12 = 35/12\) (par la proposition suivante). Proposition — Espérance et variance de \(\mathcal{U}(\llbracket a\virgule b \rrbracket)\)
Si \(X \hookrightarrow \mathcal{U}(\llbracket a, b \rrbracket)\), alors $$ \textcolor{colorprop}{E(X) \ =\ \frac{a + b}{2}, \qquad V(X) \ =\ \frac{(b - a + 1)^2 - 1}{12}.} $$
On pose \(Y = X - a + 1\). Alors \(Y\) prend ses valeurs dans \(\llbracket 1, b - a + 1 \rrbracket\), chacune avec probabilité \(1/(b - a + 1)\), donc \(Y \hookrightarrow \mathcal{U}(\llbracket 1, b - a + 1 \rrbracket)\). Par la proposition précédente avec \(n = b - a + 1\), \(E(Y) = (b - a + 2)/2\) et \(V(Y) = ((b - a + 1)^2 - 1)/12\). Or \(X = Y + a - 1\) est une transformée affine de \(Y\) de pente \(1\) et translation \(a - 1\) ; par linéarité de l'espérance et la proposition sur la variance d'une transformée affine, $$ \begin{aligned} E(X) &= E(Y) + (a - 1) && \text{(linéarité de \(E\))} \\
&= \tfrac{b - a + 2}{2} + a - 1 \ =\ \tfrac{b - a + 2 + 2a - 2}{2} \ =\ \tfrac{a + b}{2}, \\
V(X) &= 1^2 \cdot V(Y) \ =\ V(Y) && \text{(\(V(aZ + b) = a^2 V(Z)\) avec pente \(1\))} \\
&= \tfrac{(b - a + 1)^2 - 1}{12}. \end{aligned} $$
Pour aller plus loin
Le cadre de ce chapitre — un univers \(\Omega\) fini, une v.a.\ réelle finie \(X\) — est le plus simple dans lequel on peut définir l'espérance et la variance. Trois prolongements naturels attendent plus loin dans l'année : la fonction de répartition \(F_X(x) = P(X \le x)\), qui caractérise la loi de \(X\) et s'adapte sans heurt à des ensembles de valeurs non finis ; l'étude formelle de l'indépendance de deux variables aléatoires, qui valide l'heuristique des « épreuves identiques et indépendantes » de la construction de la loi binomiale ; et l'extension aux variables aléatoires discrètes à valeurs en quantité dénombrable, où les sommes finies deviennent des séries numériques et où il faudra surveiller la convergence. Le vocabulaire \(E\), \(V\), \(\sigma\), la formule de Koenig-Huygens, la variable centrée réduite et les quatre lois nommées de ce chapitre se transportent à tous ces cadres.
Compétences à pratiquer
- Calculer une probabilité uniforme
- Appliquer \(E(X) \equal (a + b)/2\) et \(V(X) \equal ((b - a + 1)^2 - 1)/12\)
VI
Pour aller plus loin
Compétences à pratiquer
- Synthèse : loi complète, espérance et variance
Aller à la section