Éducation Nationale Française · ECGappliquées 2
Couples de variables aléatoires discrètes
Nous étendons la théorie à une variable du chapitre Variables aléatoires discrètes à un couple \((X, Y)\). Le nouvel objet central est la loi conjointe, la donnée de \(P([X = x] \cap [Y = y])\) pour tout \((x, y)\) ; on en déduit les deux lois marginales (par probabilités totales) et les lois conditionnelles (par conditionnement). L'indépendance de deux v.a.\ discrètes (rappel du chapitre Variables aléatoires discrètes) s'exprime alors comme la factorisation de la loi conjointe en le produit des marginales. On calcule la loi de \(Z = g(X, Y)\) dans trois cas privilégiés — \(\min(X, Y)\), \(\max(X, Y)\), \(X + Y\) — et on démontre, par convolution discrète, que les lois binomiale et de Poisson sont stables par somme indépendante. On termine sur l'espérance conjointe : le théorème de transfert pour un couple (admis), \(E(XY) = E(X) E(Y)\) sous indépendance (admis), et le complément naturel — covariance, variance d'une somme, et coefficient de corrélation. Conventions. \((\Omega, \mathcal{A}, P)\) est un espace probabilisé général (chapitre Espaces probabilisés quelconques) ; \(X\) et \(Y\) sont des variables aléatoires réelles discrètes sur cet espace (chapitre Variables aléatoires discrètes) ; \(X(\Omega) = \{x_i\}_{i \in I}\), \(Y(\Omega) = \{y_j\}_{j \in J}\) avec \(I, J \subset \mathbb{N}\) finis ou dénombrables, les familles \((x_i)_{i \in I}\) et \((y_j)_{j \in J}\) étant injectives (les valeurs listées sont deux à deux distinctes). L'ensemble produit \(X(\Omega) \times Y(\Omega)\) est alors au plus dénombrable. On utilise la notation abrégée \(P(X = x, Y = y) = P([X = x] \cap [Y = y])\). Tout au long du chapitre, le théorème de transfert du chapitre Variables aléatoires discrètes (cas à une v.a.), Fubini pour les séries doubles absolument convergentes (du chapitre Séries numériques) et la linéarité de l'espérance sont rappelés et utilisés librement. Aux Définition ; la convergence absolue implique la convergence et Linéarité de l'espérance et formule du produit nous admettons le théorème de transfert multi-variables et la formule du produit \(E(XY) = E(X) E(Y)\), conformément au programme.
I
Loi conjointe d'un couple
I.1
Définition d'un couple et de sa loi conjointe
Que signifie « connaître \((X, Y)\) » en pratique ? Une v.a.\ discrète est connue dès que son ensemble de valeurs et ses probabilités individuelles le sont (chapitre Variables aléatoires discrètes). Pour un couple, l'objet naturel est la probabilité conjointe de chaque paire de valeurs — la donnée de \(P(X = x_i, Y = y_j)\) pour tout \((i, j)\). Les lois marginales (les lois de \(X\) seule et de \(Y\) seule) ne suffisent pas : elles décrivent chaque variable séparément et ignorent la manière dont elles interagissent.
Définition — Couple de v.a. discrètes et loi conjointe
Soient \(X\) et \(Y\) deux variables aléatoires réelles discrètes sur \((\Omega, \mathcal{A}, P)\), avec \(X(\Omega) = \{x_i\}_{i \in I}\) et \(Y(\Omega) = \{y_j\}_{j \in J}\). L'application \((X, Y) : \Omega \to \mathbb{R}^2\), \(\omega \longmapsto (X(\omega), Y(\omega))\) est le couple de \(X\) et \(Y\) ; son ensemble de valeurs \((X, Y)(\Omega) \subset X(\Omega) \times Y(\Omega)\) est au plus dénombrable. La loi conjointe de \((X, Y)\) est la famille des valeurs $$ \textcolor{colordef}{p_{i, j} = P(X = x_i, Y = y_j) = P([X = x_i] \cap [Y = y_j]), \quad (i, j) \in I \times J.} $$ De manière équivalente, la loi conjointe est l'application $$ P_{X, Y} : X(\Omega) \times Y(\Omega) \longrightarrow [0, 1], \qquad (x, y) \longmapsto P(X = x, Y = y). $$ Exemple — Deux dés équilibrés
On lance deux dés équilibrés de façon indépendante. Soit \(X\) le score du premier dé et \(Y\) celui du second. Alors \(X(\Omega) = Y(\Omega) = \llbracket 1, 6 \rrbracket\) et, par indépendance des lancers, $$ P(X = i, Y = j) = \frac{1}{6} \cdot \frac{1}{6} = \frac{1}{36} \quad \text{pour tout } (i, j) \in \llbracket 1, 6 \rrbracket^2. $$ La loi conjointe est uniforme sur les \(36\) cases. Exemple — Une urne avec quatre boules numérotées
Une urne contient quatre boules numérotées \(1, 2, 3, 4\). On effectue successivement deux tirages avec remise. Soit \(X\) le numéro de la première boule tirée et \(Y\) celui de la seconde. Alors \(X(\Omega) = Y(\Omega) = \llbracket 1, 4 \rrbracket\) et (les deux tirages étant indépendants) $$ P(X = i, Y = j) = \frac{1}{4} \cdot \frac{1}{4} = \frac{1}{16} \quad \text{pour tout } (i, j) \in \llbracket 1, 4 \rrbracket^2. $$ Le tableau de la loi conjointe : 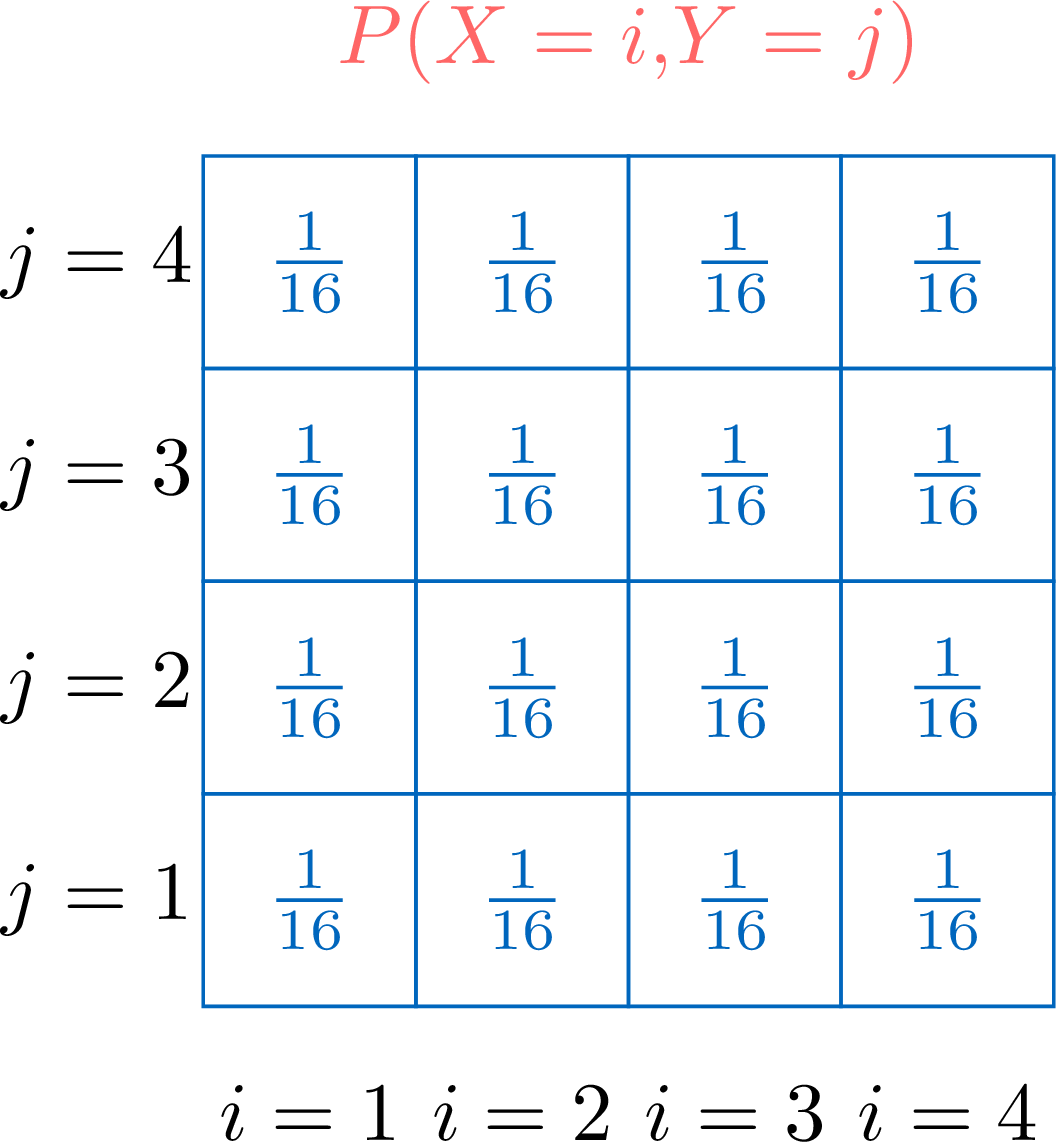
Proposition — Caractérisation d'une loi conjointe
La loi conjointe \((p_{i, j})_{(i, j) \in I \times J}\) d'un couple \((X, Y)\) vérifie - \(p_{i, j} \ge 0\) pour tout \((i, j) \in I \times J\) ;
- la somme double est absolument convergente et vaut \(1\) : $$ \textcolor{colorprop}{\sum_{(i, j) \in I \times J} p_{i, j} = 1.} $$
Positivité. Chaque \(p_{i, j} = P([X = x_i] \cap [Y = y_j])\) est une probabilité, donc appartient à \([0, 1]\). Somme égale à 1. La famille d'événements \(([X = x_i] \cap [Y = y_j])_{(i, j) \in I \times J}\) est un système complet dénombrable de \(\Omega\) :
- deux à deux disjoints : si \((i, j) \neq (i', j')\), alors \(x_i \neq x_{i'}\) ou \(y_j \neq y_{j'}\) (les familles étant injectives), donc \([X = x_i] \cap [X = x_{i'}] = \emptyset\) ou \([Y = y_j] \cap [Y = y_{j'}] = \emptyset\), donc les atomes conjoints sont disjoints ;
- recouvrement : pour tout \(\omega \in \Omega\), \(X(\omega) = x_i\) pour un certain \(i \in I\) et \(Y(\omega) = y_j\) pour un certain \(j \in J\), donc \(\omega \in [X = x_i] \cap [Y = y_j]\).
Méthode — Écrire la loi conjointe d'un petit couple
- Identifier \(X(\Omega)\) et \(Y(\Omega)\).
- Pour tout \((x, y) \in X(\Omega) \times Y(\Omega)\), calculer \(p_{x, y} = P(X = x, Y = y)\) (souvent par dénombrement d'issues équiprobables, ou par indépendance lorsque c'est applicable).
- Disposer les valeurs dans un tableau rectangulaire (lignes = valeurs de \(X\), colonnes = valeurs de \(Y\)) ; les cases contiennent les \(p_{x, y}\).
- Vérification : \(\sum p_{x, y} = 1\).
Compétences à pratiquer
- Construire la loi conjointe d'un petit couple
I.2
Lois marginales
À partir de la loi conjointe, la loi de \(X\) seule (« première marginale ») et la loi de \(Y\) seule (« seconde marginale ») s'obtiennent en sommant sur les lignes et sur les colonnes du tableau conjoint. C'est l'analogue, pour le cas à deux variables, des probabilités totales (chapitre Espaces probabilisés quelconques).
Définition — Première et seconde lois marginales
Soit \((X, Y)\) un couple de v.a.\ discrètes. La loi de \(X\) est appelée première loi marginale du couple ; la loi de \(Y\) est appelée seconde loi marginale. Proposition — Marginales à partir de la loi conjointe
Soit \((X, Y)\) un couple de v.a.\ discrètes de loi conjointe \((p_{i, j})\). Alors pour tout \(i \in I\) et tout \(j \in J\), $$ \textcolor{colorprop}{P(X = x_i) = \sum_{j \in J} P(X = x_i, Y = y_j) = \sum_{j \in J} p_{i, j},} $$ $$ \textcolor{colorprop}{P(Y = y_j) = \sum_{i \in I} P(X = x_i, Y = y_j) = \sum_{i \in I} p_{i, j}.} $$ La série en \(j\) (resp.\ en \(i\)) est à termes positifs et majorée par \(P(X = x_i) \le 1\) (resp.\ \(\le 1\)), donc convergente.
Fixons \(i \in I\). La famille \(([Y = y_j])_{j \in J}\) est un système complet dénombrable d'événements de \(\Omega\) (Proposition du chapitre Variables aléatoires discrètes appliquée à \(Y\)). Par probabilités totales (chapitre Espaces probabilisés quelconques, forme additive), pour l'événement \(B = [X = x_i]\), $$ \begin{aligned} P(X = x_i) \ &=\ \sum_{j \in J} P([X = x_i] \cap [Y = y_j]) && \text{(probabilités totales, forme additive)} \\
&=\ \sum_{j \in J} p_{i, j}. \end{aligned} $$ Le même argument avec le système \(([X = x_i])_{i \in I}\) donne \(P(Y = y_j) = \sum_{i \in I} p_{i, j}\). La convergence de chaque série découle de la majoration \(0 \le \sum_j p_{i, j} \le \sum_{(i', j)} p_{i', j} = 1\).
Exemple — Marginales d'un tableau conjoint fini
Supposons \(X(\Omega) = \{0, 1\}\) et \(Y(\Omega) = \{0, 1, 2\}\) de loi conjointe $$ P(X = 0\virgule Y = 0) = 0{,}1, \quad P(X = 0\virgule Y = 1) = 0{,}2, \quad P(X = 0\virgule Y = 2) = 0{,}1, $$ $$ P(X = 1\virgule Y = 0) = 0{,}2, \quad P(X = 1\virgule Y = 1) = 0{,}3, \quad P(X = 1\virgule Y = 2) = 0{,}1. $$ La marginale de \(X\) est la somme des lignes : \(P(X = 0) = 0{,}1 + 0{,}2 + 0{,}1 = 0{,}4\) et \(P(X = 1) = 0{,}2 + 0{,}3 + 0{,}1 = 0{,}6\). La marginale de \(Y\) est la somme des colonnes : \(P(Y = 0) = 0{,}1 + 0{,}2 = 0{,}3\), \(P(Y = 1) = 0{,}5\), \(P(Y = 2) = 0{,}2\). Vérification : \(0{,}4 + 0{,}6 = 1\) et \(0{,}3 + 0{,}5 + 0{,}2 = 1\). Méthode — Calculer les marginales à partir d'une loi conjointe
- Pour la marginale de \(X\) : sommer chaque ligne du tableau conjoint (somme sur \(j \in J\) à \(i\) fixé).
- Pour la marginale de \(Y\) : sommer chaque colonne (somme sur \(i \in I\) à \(j\) fixé).
- Vérification : chaque marginale a pour somme \(1\).
Piège — les marginales ne déterminent pas la loi conjointe
Les deux lois marginales ne déterminent pas la loi conjointe. Deux tableaux conjoints différents peuvent avoir les mêmes sommes de lignes et de colonnes. Par exemple, avec \(X(\Omega) = Y(\Omega) = \{0, 1\}\), les deux tableaux suivants ont tous deux pour marginales \(P(X = 0) = P(X = 1) = 1/2\) et \(P(Y = 0) = P(Y = 1) = 1/2\) : $$ \begin{array}{c|cc} & Y = 0 & Y = 1 \\
\hline X = 0 & 1/4 & 1/4 \\
X = 1 & 1/4 & 1/4 \end{array} \qquad \begin{array}{c|cc} & Y = 0 & Y = 1 \\
\hline X = 0 & 1/2 & 0 \\
X = 1 & 0 & 1/2 \end{array} $$ Le tableau de gauche correspond à deux pièces équilibrées indépendantes ; celui de droite à une seule pièce utilisée pour \(X\) et pour \(Y\) (donc \(Y = X\) presque sûrement). Mêmes marginales, comportements conjoints très différents. La loi conjointe contient strictement plus d'information que la paire des marginales — en particulier, elle gouverne la manière dont les deux variables varient ensemble (le section 5 quantifiera cela avec la covariance).
Compétences à pratiquer
- Calculer les marginales à partir d'une loi conjointe
I.3
Lois conditionnelles
Lorsque \(P(X = x_i) > 0\), le chapitre Espaces probabilisés quelconques associe à l'événement \(C = [X = x_i]\) la probabilité conditionnelle \(P_C\) (la « probabilité sachant \(C\) ») ; la loi conditionnelle de \(Y\) sachant \([X = x_i]\) est la loi de \(Y\) sous \(P_C\). La loi conjointe se factorise alors en marginale fois conditionnelle — analogue discret des « probabilités totales » avec conditionnement.
Définition — Loi conditionnelle de \(Y\) sachant \(\lbrack X \equal x_i\rbrack\)
Soit \((X, Y)\) un couple de v.a.\ discrètes et \(i \in I\) avec \(P(X = x_i) > 0\). En posant \(C = [X = x_i]\), la loi conditionnelle de \(Y\) sachant \(\lbrack X = x_i\rbrack\) est la famille des valeurs $$ \textcolor{colordef}{P_C(Y = y_j) = P_{[X = x_i]}(Y = y_j) = \frac{P(X = x_i, Y = y_j)}{P(X = x_i)}, \quad j \in J,} $$ c'est-à-dire la loi de la v.a.\ discrète \(Y\) sous la probabilité conditionnelle \(P_C\). Symétriquement, lorsque \(P(Y = y_j) > 0\), la loi conditionnelle de \(X\) sachant \([Y = y_j]\) est la famille \(P_{[Y = y_j]}(X = x_i) = P(X = x_i, Y = y_j) / P(Y = y_j)\) pour \(i \in I\). Proposition — Loi conjointe à partir d'une marginale et d'une conditionnelle
Soit \((X, Y)\) un couple de v.a.\ discrètes. Pour tout \((i, j) \in I \times J\) tel que \(P(X = x_i) > 0\), $$ \textcolor{colorprop}{P(X = x_i, Y = y_j) = P(X = x_i) \cdot P_{[X = x_i]}(Y = y_j).} $$ Les indices \(i\) tels que \(P(X = x_i) = 0\) contribuent à \(0\) dans la loi conjointe sur la ligne \(i\) (et la loi conditionnelle sur la ligne \(i\) n'est pas définie — on retire cette ligne).
Conséquence directe de la définition de la probabilité conditionnelle (chapitre Espaces probabilisés quelconques) : pour \(C = [X = x_i]\) avec \(P(C) > 0\), $$ P_C(Y = y_j) = \frac{P(C \cap [Y = y_j])}{P(C)} = \frac{P(X = x_i, Y = y_j)}{P(X = x_i)}, $$ et un produit en croix donne la formule. Le cas marginale nulle découle de \(0 \le P(X = x_i, Y = y_j) \le P(X = x_i) = 0\).
Exemple — Choisir des pièces à l'aveugle
Soit \(N\) un entier avec \(N \ge 2\) et \(n \in \llbracket 1, N - 1 \rrbracket\). On dispose de \(N\) pièces non équilibrées, donnant pile avec probabilité \(p \in {]0, 1[}\), toutes lancées simultanément et de manière indépendante. Soit \(X\) le nombre total de piles. Un joueur, les yeux bandés, choisit \(n\) pièces parmi les \(N\) au hasard ; soit \(Y\) le nombre de piles parmi les \(n\) choisies. Alors \(X \hookrightarrow \mathcal{B}(N, p)\) (loi binomiale, chapitre Variables aléatoires finies). Conditionnellement à \([X = k]\), le joueur prélève \(n\) pièces parmi \(N\), dont \(k\) sont sur pile : \(Y\) sachant \([X = k]\) suit la loi hypergéométrique \(\mathcal{H}(N, n, k)\), avec \(P_{[X = k]}(Y = j) = \binom{k}{j} \binom{N - k}{n - j} / \binom{N}{n}\) pour \(\max(0, n - N + k) \le j \le \min(n, k)\) et \(0\) sinon. La loi conjointe s'assemble en \(P(X = k, Y = j) = \binom{N}{k} p^k (1 - p)^{N - k} \cdot P_{[X = k]}(Y = j)\). Méthode — Assembler la loi conjointe à partir d'une marginale et de conditionnelles
- Identifier la variable dont la marginale est la plus facile à écrire directement (souvent la « cause » dans l'expérience).
- Calculer la loi conditionnelle de l'autre variable sachant chaque valeur de la première.
- Multiplier : \(P(X = x_i, Y = y_j) = P(X = x_i) \cdot P_{[X = x_i]}(Y = y_j)\).
- Vérification : \(\sum_{(i, j)} P(X = x_i, Y = y_j) = 1\) (de manière équivalente, \(\sum_i P(X = x_i) = 1\) et pour chaque \(i\), \(\sum_j P_{[X = x_i]}(Y = y_j) = 1\)).
Compétences à pratiquer
- Assembler une loi conjointe à partir de conditionnelles
II
Indépendance de deux variables aléatoires discrètes
II.1
Définition et caractérisation
Le chapitre Variables aléatoires discrètes a défini l'indépendance mutuelle de \(n\) v.a.\ discrètes par la factorisation de chaque atome conjoint. Le cas \(n = 2\) est exactement l'indépendance de deux v.a.\ discrètes — rappelé ici comme l'élément central du chapitre et reformulé dans le langage des lois conjointes.
Proposition — Indépendance de deux v.a. discrètes — rappel
Deux v.a.\ discrètes \(X, Y\) sur \((\Omega, \mathcal{A}, P)\) sont indépendantes lorsque $$ \textcolor{colorprop}{\forall (x, y) \in X(\Omega) \times Y(\Omega), \quad P(X = x, Y = y) = P(X = x) \cdot P(Y = y).} $$ De manière équivalente : la loi conjointe est le produit des marginales, $$ \forall (i, j) \in I \times J, \quad p_{i, j} = P(X = x_i) \cdot P(Y = y_j). $$ (C'est le cas \(n = 2\) de l'indépendance mutuelle de \(n\) v.a.\ discrètes du chapitre Variables aléatoires discrètes.)
La factorisation est la Définition de l'indépendance mutuelle de \(n = 2\) v.a.\ discrètes du chapitre Variables aléatoires discrètes, Indépendance mutuelle de \(n\) variables aléatoires discrètes : l'atome conjoint \([X = x] \cap [Y = y]\) a pour probabilité \(P(X = x) P(Y = y)\). La forme équivalente réécrit \(p_{i, j}\) en fonction des marginales. Aucune démonstration nouvelle n'est nécessaire.
Exemple — Deux dés indépendants
Avec \(X, Y\) les deux scores de deux dés équilibrés indépendants, \(P(X = i) = P(Y = j) = 1/6\), donc la loi conjointe \(P(X = i, Y = j) = 1/36 = (1/6)(1/6) = P(X = i) P(Y = j)\) correspond à la factorisation : \(X\) et \(Y\) sont indépendantes (ce qui est exactement le raisonnement utilisé pour écrire la loi conjointe au Définition d'un couple et de sa loi conjointe). Exemple — Deux v.a. de Bernoulli indépendantes
Soient \(X \hookrightarrow \mathcal{B}(p_1)\) et \(Y \hookrightarrow \mathcal{B}(p_2)\) deux variables de Bernoulli indépendantes. Le tableau conjoint sur \(\{0, 1\}^2\) est $$ \begin{array}{c|cc} & Y = 0 & Y = 1 \\
\hline X = 0 & (1 - p_1)(1 - p_2) & (1 - p_1) p_2 \\
X = 1 & p_1 (1 - p_2) & p_1 p_2 \end{array} $$ Vérification : les sommes des lignes valent \(1 - p_1\) et \(p_1\) (marginale de \(X\)) ; les sommes des colonnes valent \(1 - p_2\) et \(p_2\) (marginale de \(Y\)). Exemple — Un couple non indépendant — somme et produit de deux dés
On lance deux dés équilibrés indépendamment. Soit \(X\) = somme des deux scores et \(Y\) = produit. Alors \(X\) et \(Y\) ne sont PAS indépendantes. Un test rapide : \(P(X = 2) = 1/36\) (seule l'issue \((1, 1)\)), \(P(Y = 1) = 1/36\) (même issue), et \(P(X = 2\virgule Y = 1) = 1/36\) (l'issue \((1, 1)\) réalise les deux événements) — la factorisation demanderait \(P(X = 2) P(Y = 1) = (1/36)^2 = 1/1296\). Puisque \(1/36 \ne 1/1296\), l'égalité échoue en \((x, y) = (2, 1)\) et \(X, Y\) ne sont pas indépendantes. Méthode — Décider de l'indépendance de deux v.a. discrètes
- Calculer les deux marginales \(P(X = x_i)\) et \(P(Y = y_j)\) à partir de la loi conjointe (sommes des lignes et des colonnes).
- Pour tout \((i, j) \in I \times J\), vérifier si \(p_{i, j} = P(X = x_i) P(Y = y_j)\).
- Un seul échec prouve la non-indépendance ; trouver un échec rapidement suffit.
- Test pratique équivalent : la loi conditionnelle de \(Y\) sachant \([X = x_i]\) ne doit PAS dépendre de \(i\) lorsque \(X, Y\) sont indépendantes (elle est alors égale à la marginale de \(Y\)).
Compétences à pratiquer
- Décider de l'indépendance de deux v.a. discrètes
III
Loi de \(Z \equal g(X\virgule Y)\)
III.1
Principe général
Appliquer une fonction \(g\) à valeurs réelles à un couple \((X, Y)\) donne une nouvelle v.a.\ discrète. Sa loi se récupère en sommant les probabilités conjointes sur la préimage de chaque valeur — l'analogue à deux variables du chapitre Variables aléatoires discrètes La variable \(Y \equal g(X)\).
Théorème — Loi de \(Z \equal g(X\virgule Y)\)
Soient \(X, Y\) deux v.a.\ discrètes et \(g : X(\Omega) \times Y(\Omega) \to \mathbb{R}\) une application. Alors \(Z = g(X, Y) : \Omega \to \mathbb{R}\) est une v.a.\ discrète. Son ensemble de valeurs \(Z(\Omega) \subset g(X(\Omega) \times Y(\Omega))\) est au plus dénombrable, et pour tout \(z \in Z(\Omega)\), $$ \textcolor{colorprop}{P(Z = z) = \sum_{\substack{(x, y) \in X(\Omega) \times Y(\Omega) \\
g(x, y) = z}} P(X = x, Y = y)} $$ (somme finie ou série à termes positifs convergente).
\(Z(\Omega)\) est contenu dans \(g(X(\Omega) \times Y(\Omega))\), image par \(g\) de l'ensemble au plus dénombrable \(X(\Omega) \times Y(\Omega)\), donc au plus dénombrable. Pour \(z \in Z(\Omega)\), $$ [Z = z] = \bigsqcup_{\substack{(x, y) \in X(\Omega) \times Y(\Omega) \\
g(x, y) = z}} \bigl([X = x] \cap [Y = y]\bigr) $$ est une union disjointe dénombrable d'événements de \(\Omega\), donc un événement (stabilité de \(\mathcal{A}\) par union dénombrable, chapitre Espaces probabilisés quelconques). Par \(\sigma\)-additivité, $$ P(Z = z) = \sum_{\substack{(x, y) \\
g(x, y) = z}} P([X = x] \cap [Y = y]) = \sum_{\substack{(x, y) \\
g(x, y) = z}} P(X = x, Y = y). $$ La série est une sous-série à termes positifs de \(\sum_{(x, y)} P(X = x, Y = y) = 1\), donc convergente.
Méthode — Calculer la loi de \(Z \equal g(X\virgule Y)\)
- Calculer \(Z(\Omega) = g(X(\Omega) \times Y(\Omega))\).
- Pour chaque \(z \in Z(\Omega)\), lister les couples \((x, y) \in X(\Omega) \times Y(\Omega)\) tels que \(g(x, y) = z\).
- Sommer les probabilités conjointes \(P(X = x, Y = y)\) sur cette liste.
- Vérification : \(\sum_{z \in Z(\Omega)} P(Z = z) = 1\).
Compétences à pratiquer
- Calculer la loi de \(Z \equal g(X\virgule Y)\)
III.2
Maximum et minimum de deux v.a. discrètes
Pour \(X, Y\) à valeurs entières, l'observation centrale est \([\max(X, Y) \le k] = [X \le k] \cap [Y \le k]\) : le maximum est au plus \(k\) ssi les deux le sont. Symétriquement, \([\min(X, Y) \ge k] = [X \ge k] \cap [Y \ge k]\). Sous indépendance, chaque intersection se factorise, ce qui donne des fonctions de répartition explicites.
Proposition — Fonction de répartition de \(\max(X\virgule Y)\) sous indépendance
Soient \(X, Y\) deux v.a.\ discrètes indépendantes avec \(X(\Omega), Y(\Omega) \subset \mathbb{Z}\). Soit \(M = \max(X, Y)\). Alors pour tout \(k \in \mathbb{Z}\), $$ \textcolor{colorprop}{F_M(k) = P(M \le k) = F_X(k) \cdot F_Y(k),} $$ et la loi de \(M\) se récupère par \(P(M = k) = F_M(k) - F_M(k - 1)\) pour \(k \in M(\Omega)\).
Pour tout \(k \in \mathbb{Z}\) on a l'identité ensembliste \([\max(X, Y) \le k] = [X \le k] \cap [Y \le k]\) (le max est au plus \(k\) exactement lorsque les deux variables le sont). Comme \(X\) et \(Y\) sont indépendantes, les deux événements \([X \le k]\) et \([Y \le k]\) sont indépendants, donc leur probabilité conjointe se factorise : $$ \begin{aligned} F_M(k) \ &=\ P([X \le k] \cap [Y \le k]) && \text{(identité ensembliste ci-dessus)} \\
&=\ P(X \le k) \cdot P(Y \le k) && \text{(indépendance de \(X\) et \(Y\))} \\
&=\ F_X(k) \cdot F_Y(k). \end{aligned} $$ La loi se récupère ensuite depuis la fonction de répartition par \(P(M = k) = F_M(k) - F_M(k - 1)\) pour \(k\) entier (chapitre Variables aléatoires discrètes).
Proposition — Fonction de survie de \(\min(X\virgule Y)\) sous indépendance
Soient \(X, Y\) deux v.a.\ discrètes indépendantes avec \(X(\Omega), Y(\Omega) \subset \mathbb{Z}\). Soit \(W = \min(X, Y)\). Alors pour tout \(k \in \mathbb{Z}\), $$ \textcolor{colorprop}{P(W \ge k) = P(X \ge k) \cdot P(Y \ge k),} $$ et la loi de \(W\) se récupère par \(P(W = k) = P(W \ge k) - P(W \ge k + 1)\) pour \(k \in W(\Omega)\).
Pour tout \(k \in \mathbb{Z}\) on a l'identité ensembliste \([\min(X, Y) \ge k] = [X \ge k] \cap [Y \ge k]\) (le min est au moins \(k\) exactement lorsque les deux variables le sont). Les événements \([X \ge k]\) et \([Y \ge k]\) sont indépendants (car \(X, Y\) le sont), donc $$ P(W \ge k) = P([X \ge k] \cap [Y \ge k]) = P(X \ge k) \cdot P(Y \ge k). $$ La récupération suit de \(P(W = k) = P(W \ge k) - P(W \ge k + 1)\) pour \(k\) entier.
Exemple — Max et min de deux uniformes indépendantes sur \(\llbracket 1\virgule n \rrbracket\)
Soient \(X, Y\) uniformes indépendantes sur \(\llbracket 1, n \rrbracket\). Leur fonction de répartition est \(F_X(k) = F_Y(k) = k/n\) pour \(k \in \llbracket 1, n \rrbracket\) (et \(0\) pour \(k < 1\), \(1\) pour \(k \ge n\)). Max. \(F_M(k) = (k/n)^2\) pour \(k \in \llbracket 1, n \rrbracket\). Donc pour \(k \in \llbracket 1, n \rrbracket\), $$ P(M = k) = F_M(k) - F_M(k - 1) = \frac{k^2 - (k - 1)^2}{n^2} = \frac{2k - 1}{n^2}. $$ Min. \(P(X \ge k) = (n - k + 1)/n\) pour \(k \in \llbracket 1, n \rrbracket\). Donc \(P(W \ge k) = ((n - k + 1)/n)^2\), et pour \(k \in \llbracket 1, n \rrbracket\), $$ P(W = k) = P(W \ge k) - P(W \ge k + 1) = \frac{(n - k + 1)^2 - (n - k)^2}{n^2} = \frac{2(n - k) + 1}{n^2}. $$ Vérification : \(\sum_{k = 1}^n P(M = k) = (\sum (2k - 1))/n^2 = n^2/n^2 = 1\) (télescopage). Méthode — Max et min de deux v.a. entières indépendantes
- Pour le max : écrire \(F_M(k) = F_X(k) F_Y(k)\), puis \(P(M = k) = F_M(k) - F_M(k - 1)\).
- Pour le min : écrire \(P(W \ge k) = P(X \ge k) P(Y \ge k)\), puis \(P(W = k) = P(W \ge k) - P(W \ge k + 1)\).
- Sans indépendance, la factorisation de la fonction de répartition échoue ; revenir à la Méthode générale du Principe général.
Compétences à pratiquer
- Calculer les lois du max et du min
III.3
Somme de deux v.a. discrètes — convolution discrète
La somme \(X + Y\) prend la valeur \(z\) sur la droite \(\{(x, y) : x + y = z\}\). Sommer les probabilités conjointes le long de cette droite donne la loi de \(X + Y\). Sous indépendance, la loi conjointe se factorise en un produit de marginales, et la somme sur la droite devient une convolution discrète.
Théorème — Formule de convolution discrète
Soient \(X, Y\) deux v.a.\ discrètes indépendantes avec \(X(\Omega), Y(\Omega) \subset \mathbb{Z}\). Alors pour tout \(z \in (X + Y)(\Omega)\), $$ \textcolor{colorprop}{P(X + Y = z) = \sum_{x \in X(\Omega)} P(X = x) \cdot P(Y = z - x).} $$ La série est à termes positifs et converge (sous-série de \(\sum_{x, y} P(X = x) P(Y = y) = 1\)).
La famille \(([X = x])_{x \in X(\Omega)}\) est un système complet dénombrable de \(\Omega\) (chapitre Variables aléatoires discrètes). Par la forme additive des probabilités totales, $$ \begin{aligned} P(X + Y = z) \ &=\ \sum_{x \in X(\Omega)} P([X = x] \cap [X + Y = z]) && \text{(probabilités totales)} \\
&=\ \sum_{x \in X(\Omega)} P([X = x] \cap [Y = z - x]) && \text{(\(X = x\) sur le premier événement \(\Rightarrow\) \(Y = z - x\))} \\
&=\ \sum_{x \in X(\Omega)} P(X = x) \cdot P(Y = z - x) && \text{(indépendance de \(X\) et \(Y\)).} \end{aligned} $$ Un terme \(P(Y = z - x)\) pour lequel \(z - x \notin Y(\Omega)\) est nul par convention, donc la somme porte effectivement sur les \(x \in X(\Omega)\) tels que \(z - x \in Y(\Omega)\).
Exemple — Loi triangulaire de la somme de deux uniformes
Soient \(X, Y\) uniformes indépendantes sur \(\llbracket 1, n \rrbracket\). Alors \((X + Y)(\Omega) = \llbracket 2, 2n \rrbracket\), et pour \(z \in \llbracket 2, 2n \rrbracket\), $$ P(X + Y = z) = \sum_{x = 1}^n \frac{1}{n} \cdot \mathbf{1}_{[1 \le z - x \le n]} \cdot \frac{1}{n} = \frac{\#\{x \in \llbracket 1, n \rrbracket : 1 \le z - x \le n\}}{n^2}. $$ La contrainte s'écrit \(\max(1, z - n) \le x \le \min(n, z - 1)\), donc le cardinal vaut \(\min(n, z - 1) - \max(1, z - n) + 1\) qui se simplifie en \(z - 1\) pour \(z \in \llbracket 2, n + 1 \rrbracket\) et \(2n - z + 1\) pour \(z \in \llbracket n + 1, 2n \rrbracket\). La loi de \(X + Y\) est la loi triangulaire classique sur \(\llbracket 2, 2n \rrbracket\). Méthode — Calculer la loi de \(X + Y\) sous indépendance
- Identifier \((X + Y)(\Omega)\).
- Pour chaque \(z\), appliquer la formule de convolution : \(P(X + Y = z) = \sum_x P(X = x) P(Y = z - x)\), la somme portant sur les \(x \in X(\Omega)\) tels que \(z - x \in Y(\Omega)\).
- Vérification : lorsque les marginales sont explicites, \(\sum_z P(X + Y = z) = 1\).
Compétences à pratiquer
- Appliquer la formule de convolution discrète
III.4
Stabilité des lois \(\mathcal{B}\) et \(\mathcal{P}\) par somme indépendante
Deux familles particulières se comportent particulièrement bien par somme indépendante : les lois binomiale (même paramètre \(p\)) et de Poisson sont stables — le type de loi est préservé, et les paramètres s'additionnent. Ces deux résultats de stabilité sont des calculs directs de convolution utilisant une identité combinatoire (Vandermonde pour la binomiale, binôme de Newton pour la Poisson).
Proposition — Identité de Vandermonde — rappel
Pour tout \((n_1, n_2) \in \mathbb{N}^2\) et tout \(k \in \mathbb{N}\), $$ \textcolor{colorprop}{\sum_{j = 0}^k \binom{n_1}{j} \binom{n_2}{k - j} = \binom{n_1 + n_2}{k},} $$ avec la convention \(\binom{n}{m} = 0\) pour \(m > n\). (Rappel du chapitre Méthodes de calcul.) Proposition — Stabilité de la loi binomiale
Soient \(n_1, n_2 \in \mathbb{N}\), \(p \in [0, 1]\), et \(X_1, X_2\) deux v.a.\ discrètes indépendantes avec \(X_1 \hookrightarrow \mathcal{B}(n_1, p)\) et \(X_2 \hookrightarrow \mathcal{B}(n_2, p)\) (même paramètre \(p\)). Alors $$ \textcolor{colorprop}{X_1 + X_2 \hookrightarrow \mathcal{B}(n_1 + n_2, p).} $$
\(X_1(\Omega) = \llbracket 0, n_1 \rrbracket\), \(X_2(\Omega) = \llbracket 0, n_2 \rrbracket\), donc \((X_1 + X_2)(\Omega) \subset \llbracket 0, n_1 + n_2 \rrbracket\). Posons \(q = 1 - p\). Pour tout \(k \in \llbracket 0, n_1 + n_2 \rrbracket\), par la formule de convolution discrète (Somme de deux v.a. discrètes — convolution discrète), $$ \begin{aligned} P(X_1 + X_2 = k) \ &=\ \sum_{j = 0}^k P(X_1 = j) \cdot P(X_2 = k - j) && \text{(convolution, indépendance)} \\
&=\ \sum_{j = 0}^k \binom{n_1}{j} p^j q^{n_1 - j} \cdot \binom{n_2}{k - j} p^{k - j} q^{n_2 - (k - j)} && \text{(lois binomiales)} \\
&=\ p^k q^{n_1 + n_2 - k} \sum_{j = 0}^k \binom{n_1}{j} \binom{n_2}{k - j} && \text{(factorisation des puissances de \(p\) et \(q\))} \\
&=\ p^k q^{n_1 + n_2 - k} \binom{n_1 + n_2}{k} && \text{(Vandermonde).} \end{aligned} $$ C'est la valeur \(\binom{n_1 + n_2}{k} p^k (1 - p)^{(n_1 + n_2) - k}\), la loi \(\mathcal{B}(n_1 + n_2, p)\).
Proposition — Stabilité de la loi de Poisson
Soient \(\lambda_1, \lambda_2 > 0\) et \(X_1, X_2\) deux v.a.\ discrètes indépendantes avec \(X_1 \hookrightarrow \mathcal{P}(\lambda_1)\) et \(X_2 \hookrightarrow \mathcal{P}(\lambda_2)\). Alors $$ \textcolor{colorprop}{X_1 + X_2 \hookrightarrow \mathcal{P}(\lambda_1 + \lambda_2).} $$
\(X_1(\Omega) = X_2(\Omega) = \mathbb{N}\), donc \((X_1 + X_2)(\Omega) = \mathbb{N}\). Pour \(k \in \mathbb{N}\), par la formule de convolution discrète, $$ \begin{aligned} P(X_1 + X_2 = k) \ &=\ \sum_{j = 0}^k P(X_1 = j) \cdot P(X_2 = k - j) && \text{(convolution)} \\
&=\ \sum_{j = 0}^k \mathrm{e}^{-\lambda_1} \frac{\lambda_1^j}{j!} \cdot \mathrm{e}^{-\lambda_2} \frac{\lambda_2^{k - j}}{(k - j)!} && \text{(lois de Poisson)} \\
&=\ \mathrm{e}^{-(\lambda_1 + \lambda_2)} \frac{1}{k!} \sum_{j = 0}^k \binom{k}{j} \lambda_1^j \lambda_2^{k - j} && \text{(factorisation ; on multiplie et divise par \(k!\))} \\
&=\ \mathrm{e}^{-(\lambda_1 + \lambda_2)} \frac{(\lambda_1 + \lambda_2)^k}{k!} && \text{(binôme de Newton).} \end{aligned} $$ C'est la loi \(\mathcal{P}(\lambda_1 + \lambda_2)\).
Exemple — Deux sources de Poisson indépendantes
Un centre d'appels reçoit des appels de deux groupes de clients indépendants ; le nombre horaire du premier groupe est \(X_1 \hookrightarrow \mathcal{P}(2)\), celui du second \(X_2 \hookrightarrow \mathcal{P}(3)\). Le nombre total horaire est \(X_1 + X_2 \hookrightarrow \mathcal{P}(5)\). Donc \(P(X_1 + X_2 = 0) = \mathrm{e}^{-5} \approx 0{,}0067\). 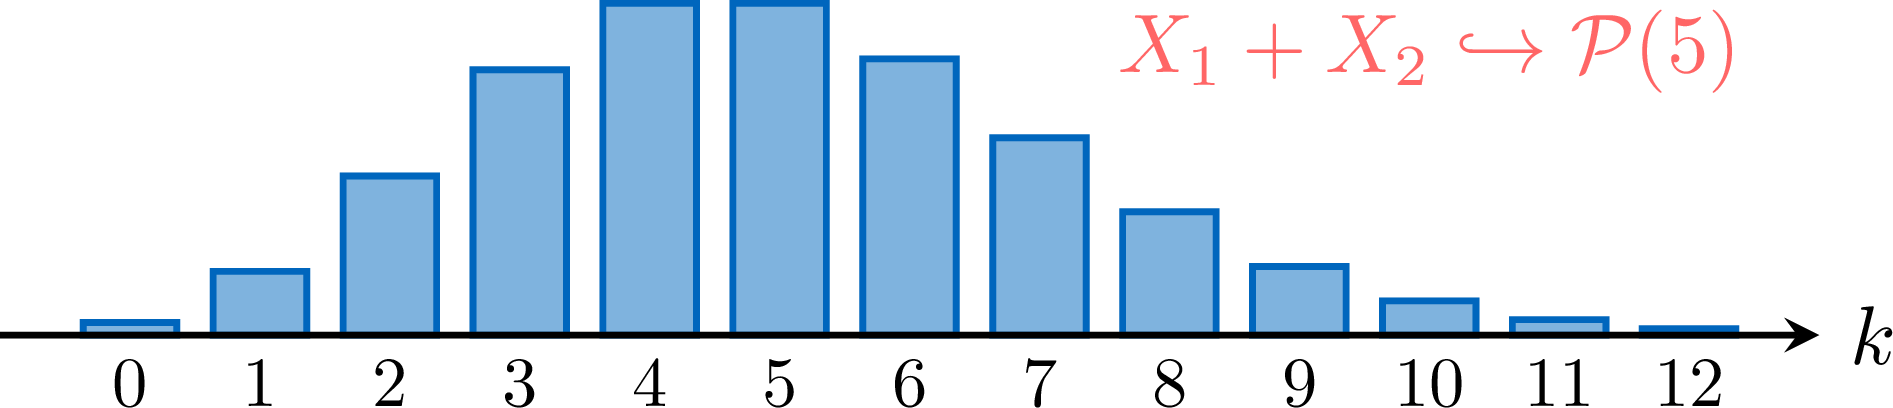
Méthode — Reconnaître la loi d'une somme indépendante
- Si deux \(\mathcal{B}(n_1, p)\) et \(\mathcal{B}(n_2, p)\) indépendantes ont le même \(p\), leur somme suit \(\mathcal{B}(n_1 + n_2, p)\).
- Si deux \(\mathcal{P}(\lambda_1)\) et \(\mathcal{P}(\lambda_2)\) indépendantes, leur somme suit \(\mathcal{P}(\lambda_1 + \lambda_2)\) — aucune contrainte de compatibilité.
- Attention : la loi géométrique \(\mathcal{G}\) n'est PAS stable par somme indépendante (la somme de deux \(\mathcal{G}(p)\) indépendantes ne suit aucune \(\mathcal{G}(q)\) ; c'est la loi « binomiale négative », hors programme).
- De même : \(\mathcal{B}(n_1, p_1) + \mathcal{B}(n_2, p_2)\) avec \(p_1 \ne p_2\) n'est PAS binomiale.
Compétences à pratiquer
- Appliquer la stabilité de \(\mathcal{B}\) et \(\mathcal{P}\)
IV
Espérance d'une fonction d'un couple
IV.1
Théorème de transfert pour un couple
Du chapitre Variables aléatoires discrètes on a le théorème de transfert pour \(g(X)\). L'extension à deux variables est l'analogue naturel en somme double : l'espérance de \(g(X, Y)\), lorsqu'elle existe, est la somme double \(\sum_{(x, y)} g(x, y) P(X = x, Y = y)\).
Théorème — Théorème de transfert pour un couple — admis
Soient \(X, Y\) deux v.a.\ discrètes et \(g : X(\Omega) \times Y(\Omega) \to \mathbb{R}\) une application. Alors \(g(X, Y)\) admet une espérance ssi la série double $$ \sum_{(x, y) \in X(\Omega) \times Y(\Omega)} |g(x, y)| \cdot P(X = x, Y = y) $$ est convergente (dans tout ordre d'itération ; Fubini, du chapitre Séries numériques, rend l'ordre indifférent pour les séries doubles à termes positifs). Dans ce cas, $$ \textcolor{colorprop}{E(g(X, Y)) = \sum_{(x, y) \in X(\Omega) \times Y(\Omega)} g(x, y) \cdot P(X = x, Y = y),} $$ et cette valeur ne dépend pas de l'indexation de \(X(\Omega) \times Y(\Omega)\). Admis à ce niveau (programme). Lorsque \((X, Y)\) prend un nombre fini de valeurs, la somme double est finie et la convergence absolue est automatique. Exemple — Transfert sur un petit tableau fini
Reprenons le tableau conjoint du Lois marginales, avec \(X \in \{0, 1\}\), \(Y \in \{0, 1, 2\}\) et les six probabilités données. Calculer \(E(\max(X, Y))\) par transfert avec \(g(x, y) = \max(x, y)\).
Tabulons \(\max(x, y)\) pour chaque \((x, y)\) : \((0, 0) \mapsto 0\), \((0, 1) \mapsto 1\), \((0, 2) \mapsto 2\), \((1, 0) \mapsto 1\), \((1, 1) \mapsto 1\), \((1, 2) \mapsto 2\). Par transfert, $$ \begin{aligned} E(\max(X, Y)) \ &=\ 0 \cdot 0{,}1 + 1 \cdot 0{,}2 + 2 \cdot 0{,}1 + 1 \cdot 0{,}2 + 1 \cdot 0{,}3 + 2 \cdot 0{,}1 && \text{(formule de transfert)} \\
&=\ 0 + 0{,}2 + 0{,}2 + 0{,}2 + 0{,}3 + 0{,}2 && \text{(produits individuels)} \\
&=\ 1{,}1. \end{aligned} $$
Méthode — Appliquer le théorème de transfert pour un couple
- Calculer la série double \(\sum_{(x, y)} |g(x, y)| P(X = x, Y = y)\) et vérifier la convergence absolue (automatique si finie).
- Une fois la convergence acquise, calculer \(E(g(X, Y)) = \sum_{(x, y)} g(x, y) P(X = x, Y = y)\) dans l'ordre d'itération le plus pratique (souvent : somme sur \(y\) à \(x\) fixé, puis sur \(x\) — Fubini).
- Vérification : lorsque \((X, Y)\) est finie, la somme double est une somme sur les cases du tableau conjoint.
Compétences à pratiquer
- Appliquer le théorème de transfert pour un couple
IV.2
Linéarité de l'espérance et formule du produit
Le théorème de transfert pour un couple a deux corollaires marquants : la linéarité de l'espérance s'obtient en séparant la somme double, et la formule multiplicative pour les v.a.\ indépendantes en découle par factorisation de la probabilité conjointe.
Proposition — Linéarité de l'espérance — corollaire du transfert
Soient \(X, Y\) deux v.a.\ discrètes admettant une espérance et \((a, b) \in \mathbb{R}^2\). Alors \(aX + bY\) admet une espérance et $$ \textcolor{colorprop}{E(aX + bY) = a \cdot E(X) + b \cdot E(Y).} $$
On applique le théorème de transfert avec \(g(x, y) = ax + by\). La vérification de convergence absolue donne \(\sum_{(x, y)} |ax + by| P(X = x, Y = y) \le |a| \sum_{(x, y)} |x| P(X = x, Y = y) + |b| \sum_{(x, y)} |y| P(X = x, Y = y)\). La première somme intérieure vaut \(\sum_x |x| (\sum_y P(X = x, Y = y)) = \sum_x |x| P(X = x)\) par marginalisation (Lois marginales), et converge car \(X\) admet une espérance ; la seconde est symétrique. La convergence acquise, $$ \begin{aligned} E(aX + bY) \ &=\ \sum_{(x, y)} (ax + by) P(X = x, Y = y) && \text{(transfert)} \\
&=\ a \sum_{(x, y)} x P(X = x, Y = y) + b \sum_{(x, y)} y P(X = x, Y = y) && \text{(linéarité de la somme)} \\
&=\ a \sum_x x \left(\sum_y P(X = x, Y = y)\right) + b \sum_y y \left(\sum_x P(X = x, Y = y)\right) && \text{(Fubini)} \\
&=\ a \sum_x x P(X = x) + b \sum_y y P(Y = y) && \text{(marginalisation)} \\
&=\ a \cdot E(X) + b \cdot E(Y) && \text{(définition de \(E\)).} \end{aligned} $$
Théorème — Espérance d'un produit indépendant — admis
Soient \(X, Y\) deux v.a.\ discrètes indépendantes admettant une espérance. Alors \(XY\) admet une espérance et $$ \textcolor{colorprop}{E(XY) = E(X) \cdot E(Y).} $$ Admis à ce niveau (programme). L'idée motivante est d'appliquer le transfert avec \(g(x, y) = xy\) et de factoriser \(P(X = x, Y = y) = P(X = x) P(Y = y)\) : $$ E(XY) = \sum_{(x, y)} xy \cdot P(X = x) P(Y = y) = \left(\sum_x x P(X = x)\right) \left(\sum_y y P(Y = y)\right) = E(X) E(Y), $$ le point rigoureux étant la convergence absolue de la série double du produit, qui est précisément le contenu admis par le programme. Exemple — Deux v.a. de Bernoulli indépendantes
Soient \(X \hookrightarrow \mathcal{B}(p)\) et \(Y \hookrightarrow \mathcal{B}(q)\) indépendantes. Alors \(E(X) = p\), \(E(Y) = q\), et \(E(XY) = pq\). De plus, \(XY = \mathbf{1}_{[X = 1] \cap [Y = 1]}\), donc \(E(XY) = P(X = 1, Y = 1) = P(X = 1) P(Y = 1) = pq\) — la formule du produit retrouve un calcul direct par dénombrement. Méthode — Factoriser une espérance par indépendance
- Repérer un produit \(XY\) de deux v.a.\ indépendantes.
- Si chaque facteur admet une espérance, alors \(E(XY) = E(X) E(Y)\).
- Attention : si \(X, Y\) ne sont PAS indépendantes, la formule du produit est GÉNÉRALEMENT FAUSSE (le contre-exemple du sous-section 5.1 le montre).
Compétences à pratiquer
- Calculer \(E(aX + bY)\) et \(E(XY)\) en cas d'indépendance
V
Variance d'une somme\virgule covariance et coefficient de corrélation
V.1
Covariance — définition et propriétés
La covariance mesure la variation conjointe de deux v.a.\ autour de leurs espérances respectives. Sous indépendance, elle s'annule (aucune variation conjointe). C'est le nombre unique qui gouverne la variance de \(X + Y\).
Définition — Covariance
Soient \(X, Y\) deux v.a.\ discrètes admettant chacune une variance (et donc une espérance). La covariance de \(X\) et \(Y\) est $$ \textcolor{colordef}{\mathrm{Cov}(X, Y) = E\bigl((X - E(X))(Y - E(Y))\bigr),} $$ en supposant que cette espérance existe (c'est le cas, puisque \(X, Y\) ont chacune une variance finie : la variable aléatoire \((X - E(X))(Y - E(Y))\) est dominée par \(\tfrac{1}{2}((X - E(X))^2 + (Y - E(Y))^2)\), qui admet une espérance par le critère d'existence par domination du chapitre Variables aléatoires discrètes). Proposition — Forme de Koenig-Huygens de la covariance
Sous les hypothèses de la Définition, $$ \textcolor{colorprop}{\mathrm{Cov}(X, Y) = E(XY) - E(X) \cdot E(Y).} $$
Développer le produit définissant et appliquer la linéarité de l'espérance : $$ \begin{aligned} \mathrm{Cov}(X, Y) \ &=\ E\bigl((X - E(X))(Y - E(Y))\bigr) && \text{(Définition)} \\
&=\ E\bigl(XY - X \cdot E(Y) - E(X) \cdot Y + E(X) E(Y)\bigr) && \text{(développer le produit)} \\
&=\ E(XY) - E(Y) \cdot E(X) - E(X) \cdot E(Y) + E(X) E(Y) && \text{(linéarité ; \(E(X), E(Y)\) sont des constantes)} \\
&=\ E(XY) - E(X) \cdot E(Y) && \text{(combiner les trois derniers termes).} \end{aligned} $$
Proposition — Propriétés de la covariance
Pour \(X, X', Y, Y'\) v.a.\ discrètes admettant des variances et \(a, b \in \mathbb{R}\) : - symétrie : \(\mathrm{Cov}(X, Y) = \mathrm{Cov}(Y, X)\) ;
- linéarité à gauche : \(\mathrm{Cov}(aX + bX', Y) = a \cdot \mathrm{Cov}(X, Y) + b \cdot \mathrm{Cov}(X', Y)\) ;
- linéarité à droite : \(\mathrm{Cov}(X, aY + bY') = a \cdot \mathrm{Cov}(X, Y) + b \cdot \mathrm{Cov}(X, Y')\) (conséquence de la symétrie et de la linéarité à gauche) ;
- diagonale : \(\mathrm{Cov}(X, X) = V(X)\) ;
- axe constant : \(\mathrm{Cov}(X, c) = 0\) pour toute v.a.\ constante \(c\) (une constante n'est corrélée à rien).
Chaque propriété découle de Koenig-Huygens et de la linéarité de l'espérance.
- Symétrie : \(\mathrm{Cov}(X, Y) = E(XY) - E(X) E(Y) = E(YX) - E(Y) E(X) = \mathrm{Cov}(Y, X)\) (multiplication commutative).
- Linéarité à gauche : par linéarité de \(E\), \(E((aX + bX') Y) = a E(XY) + b E(X' Y)\) et \(E(aX + bX') = a E(X) + b E(X')\), d'où \(\mathrm{Cov}(aX + bX', Y) = (a E(XY) + b E(X' Y)) - (a E(X) + b E(X')) E(Y) = a \mathrm{Cov}(X, Y) + b \mathrm{Cov}(X', Y)\).
- Linéarité à droite : combiner la linéarité à gauche et la symétrie.
- Diagonale : \(\mathrm{Cov}(X, X) = E(X^2) - E(X)^2 = V(X)\) (Koenig-Huygens pour la variance, chapitre Variables aléatoires discrètes).
- Axe constant : une constante \(c\) vérifie \(E(c) = c\) et \(E(Xc) = c \cdot E(X)\), donc \(\mathrm{Cov}(X, c) = c \cdot E(X) - E(X) \cdot c = 0\).
Proposition — L'indépendance implique covariance nulle
Soient \(X, Y\) deux v.a.\ discrètes indépendantes admettant des variances. Alors \(\mathrm{Cov}(X, Y) = 0\).
Par la formule du produit du Linéarité de l'espérance et formule du produit, \(E(XY) = E(X) E(Y)\) sous indépendance. Par Koenig-Huygens (Proposition ci-dessus), \(\mathrm{Cov}(X, Y) = E(XY) - E(X) E(Y) = 0\).
Contre-exemple : covariance nulle n'implique PAS indépendance
La réciproque est fausse. Soit \(X\) uniforme sur \(\{-1, 0, 1\}\) (donc \(P(X = -1) = P(X = 0) = P(X = 1) = 1/3\)) et \(Y = X^2\). Alors \(Y(\Omega) = \{0, 1\}\). Calculons \(E(X) = ((-1) + 0 + 1)/3 = 0\) et $$ E(XY) = E(X \cdot X^2) = E(X^3) = ((-1)^3 + 0^3 + 1^3)/3 = 0 $$ (la fonction \(x^3\) est impaire, le support est symétrique). Donc $$ \mathrm{Cov}(X, Y) = E(XY) - E(X) E(Y) = 0 - 0 \cdot E(Y) = 0. $$ Pourtant \(Y = X^2\) est une fonction (déterministe) de \(X\) : connaître \(X\) fixe entièrement \(Y\). Elles ne sont PAS indépendantes (par ex.\ \(P(X = 0, Y = 1) = 0\) mais \(P(X = 0) P(Y = 1) = (1/3)(2/3) \ne 0\)). Conclusion. \(\mathrm{Cov}(X, Y) = 0\) mesure la dépendance linéaire ; une dépendance non linéaire (ici, quadratique) peut être parfaite et donner une covariance nulle.
Méthode — Calculer une covariance
- Privilégier Koenig-Huygens : calculer \(E(X)\), \(E(Y)\), \(E(XY)\) (le dernier par transfert ou énumération directe), puis \(\mathrm{Cov}(X, Y) = E(XY) - E(X) E(Y)\).
- Si \(X\) et \(Y\) sont indépendantes : \(\mathrm{Cov}(X, Y) = 0\), sans calcul.
- Si \(X = \sum X_i\) et \(Y = \sum Y_j\), utiliser la bilinéarité pour développer \(\mathrm{Cov}(X, Y)\) en une somme de covariances « atomiques » \(\mathrm{Cov}(X_i, Y_j)\).
- Rappel : \(\mathrm{Cov}(X, Y) = 0\) n'implique PAS l'indépendance (contre-exemple ci-dessus).
Compétences à pratiquer
- Calculer des covariances
V.2
Variance d'une somme
La variance d'une somme est la somme des variances plus une correction de covariance. Sous indépendance, la correction s'annule.
Proposition — Variance de \(X + Y\)
Soient \(X, Y\) deux v.a.\ discrètes admettant des variances. Alors \(X + Y\) admet une variance et $$ \textcolor{colorprop}{V(X + Y) = V(X) + V(Y) + 2 \cdot \mathrm{Cov}(X, Y).} $$
Par la propriété diagonale et la bilinéarité de la covariance (Covariance — définition et propriétés), $$ \begin{aligned} V(X + Y) \ &=\ \mathrm{Cov}(X + Y, X + Y) && \text{(propriété diagonale)} \\
&=\ \mathrm{Cov}(X, X + Y) + \mathrm{Cov}(Y, X + Y) && \text{(linéarité à gauche)} \\
&=\ \mathrm{Cov}(X, X) + \mathrm{Cov}(X, Y) + \mathrm{Cov}(Y, X) + \mathrm{Cov}(Y, Y) && \text{(linéarité à droite, deux fois)} \\
&=\ V(X) + V(Y) + 2 \cdot \mathrm{Cov}(X, Y) && \text{(diagonale, symétrie).} \end{aligned} $$
Proposition — Variance d'une somme sous indépendance
Soient \(X, Y\) deux v.a.\ discrètes indépendantes admettant des variances. Alors $$ \textcolor{colorprop}{V(X + Y) = V(X) + V(Y).} $$
Corollaire de la Proposition précédente avec \(\mathrm{Cov}(X, Y) = 0\) (indépendance, Covariance — définition et propriétés).
Proposition — Variance d'une somme de \(n\) v.a. discrètes
Soient \(X_1, \dots, X_n\) des v.a.\ discrètes admettant des variances. Alors \(X_1 + \dots + X_n\) admet une variance et $$ \textcolor{colorprop}{V\!\left(\sum_{i = 1}^n X_i\right) = \sum_{i = 1}^n V(X_i) + 2 \sum_{1 \le i < j \le n} \mathrm{Cov}(X_i, X_j).} $$ Si de plus \(X_1, \dots, X_n\) sont deux à deux indépendantes (en particulier, si elles sont mutuellement indépendantes), chaque \(\mathrm{Cov}(X_i, X_j) = 0\) pour \(i \neq j\) et $$ \textcolor{colorprop}{V\!\left(\sum_{i = 1}^n X_i\right) = \sum_{i = 1}^n V(X_i).} $$
Par bilinéarité de la covariance (Covariance — définition et propriétés) appliquée à \(\mathrm{Cov}(\sum X_i, \sum X_j)\) : $$ \begin{aligned} V\!\left(\sum_{i = 1}^n X_i\right) \ &=\ \mathrm{Cov}\!\left(\sum_{i = 1}^n X_i, \sum_{j = 1}^n X_j\right) && \text{(propriété diagonale)} \\
&=\ \sum_{i = 1}^n \sum_{j = 1}^n \mathrm{Cov}(X_i, X_j) && \text{(bilinéarité des deux côtés)} \\
&=\ \sum_{i = 1}^n V(X_i) + \sum_{\substack{i, j = 1 \\
i \neq j}}^n \mathrm{Cov}(X_i, X_j) && \text{(séparer \(i = j\) et \(i \neq j\))} \\
&=\ \sum_{i = 1}^n V(X_i) + 2 \sum_{1 \le i < j \le n} \mathrm{Cov}(X_i, X_j) && \text{(symétrie : appariement \((i, j)\) et \((j, i)\)).} \end{aligned} $$ L'indépendance deux à deux annule chaque terme hors-diagonale, par Covariance — définition et propriétés.
Exemple — Variance de \(\mathcal{B}(n\virgule p)\) via des Bernoulli indépendantes
Soit \(X \hookrightarrow \mathcal{B}(n, p)\). Décomposons \(X = X_1 + \dots + X_n\) en une somme de \(n\) v.a.\ de Bernoulli mutuellement indépendantes \(X_i \hookrightarrow \mathcal{B}(p)\) (le modèle du chapitre 16 : \(n\) épreuves indépendantes de probabilité de succès \(p\)). Chaque \(X_i\) a pour variance \(p(1 - p)\). Par le cas indépendant deux à deux de la Proposition précédente, $$ V(X) = \sum_{i = 1}^n V(X_i) = n \cdot p(1 - p). $$ Méthode — Calculer la variance d'une somme
- Si les termes de la somme sont deux à deux indépendants : \(V(\sum X_i) = \sum V(X_i)\), aucune covariance à calculer.
- Sinon : ajouter la correction hors-diagonale \(2 \sum_{i < j} \mathrm{Cov}(X_i, X_j)\).
- Astuce utile : décomposer une v.a.\ compliquée (par ex.\ \(\mathcal{B}(n, p)\)) en somme de Bernoulli indépendantes pour calculer \(V\) en une ligne.
Compétences à pratiquer
- Calculer la variance d'une somme
V.3
Coefficient de corrélation
La covariance a la dimension de \(V\) (i.e.\ le carré de l'unité de \(X\) ou de \(Y\)) ; la normaliser par \(\sigma(X) \sigma(Y)\) donne un indicateur sans dimension dans \([-1, 1]\).
Définition — Coefficient de corrélation
Soient \(X, Y\) deux v.a.\ discrètes admettant des variances, avec \(V(X) > 0\) et \(V(Y) > 0\). Le coefficient de corrélation de \(X\) et \(Y\) est $$ \textcolor{colordef}{\rho(X, Y) = \frac{\mathrm{Cov}(X, Y)}{\sigma(X) \cdot \sigma(Y)}.} $$ Proposition — Bornes du coefficient de corrélation
Pour tout \(X, Y\) comme dans la Définition, $$ \textcolor{colorprop}{\rho(X, Y) \in [-1, 1].} $$ De plus, \(|\rho(X, Y)| = 1\) ssi il existe \((a, b) \in \mathbb{R}^* \times \mathbb{R}\) avec \(Y = aX + b\) presque sûrement ; \(\rho = +1\) correspond à \(a > 0\), \(\rho = -1\) à \(a < 0\) (dépendance linéaire parfaite à pente positive / négative). La caractérisation du cas d'égalité est admise à ce niveau ; seule la borne est démontrée ci-dessous.
Posons les variables centrées réduites \(X^* = (X - E(X)) / \sigma(X)\) et \(Y^* = (Y - E(Y)) / \sigma(Y)\) (chapitre Variables aléatoires discrètes) ; chacune a pour espérance \(0\) et pour variance \(1\). Leur covariance est exactement le coefficient de corrélation : $$ \mathrm{Cov}(X^*, Y^*) = \frac{\mathrm{Cov}(X - E(X), Y - E(Y))}{\sigma(X) \sigma(Y)} = \frac{\mathrm{Cov}(X, Y)}{\sigma(X) \sigma(Y)} = \rho(X, Y) $$ (bilinéarité de la covariance et \(\mathrm{Cov}(X - E(X), Y - E(Y)) = \mathrm{Cov}(X, Y)\), l'axe constant étant inerte). On applique alors \(V \ge 0\) à \(X^* + Y^*\) et à \(X^* - Y^*\) : $$ \begin{aligned} 0 \ \le\ V(X^* + Y^*) \ &=\ V(X^*) + V(Y^*) + 2 \mathrm{Cov}(X^*, Y^*) && \text{(variance d'une somme)} \\
&=\ 1 + 1 + 2 \rho(X, Y) \ =\ 2 + 2 \rho(X, Y), \\
0 \ \le\ V(X^* - Y^*) \ &=\ V(X^*) + V(Y^*) - 2 \mathrm{Cov}(X^*, Y^*) && \text{(variance d'une différence)} \\
&=\ 1 + 1 - 2 \rho(X, Y) \ =\ 2 - 2 \rho(X, Y). \end{aligned} $$ La première donne \(\rho(X, Y) \ge -1\) et la seconde \(\rho(X, Y) \le 1\), donc \(\rho(X, Y) \in [-1, 1]\).
Exemple — \(\rho \equal 0\) pour des v.a. indépendantes
Si \(X, Y\) sont indépendantes et admettent des variances strictement positives, alors \(\mathrm{Cov}(X, Y) = 0\) par le Covariance — définition et propriétés, donc \(\rho(X, Y) = 0\). Rappel : la réciproque est FAUSSE (contre-exemple du Covariance — définition et propriétés : \(\rho(X, X^2) = 0\) sur \(X\) uniforme sur \(\{-1, 0, 1\}\), alors que \(X^2\) est une fonction de \(X\)). Exemple — Dépendance linéaire parfaite à pente positive
Soit \(X\) une v.a.\ discrète avec \(V(X) > 0\) et \(Y = 2X + 3\). Alors \(E(Y) = 2 E(X) + 3\), \(V(Y) = 4 V(X)\), \(\sigma(Y) = 2 \sigma(X)\), et $$ \mathrm{Cov}(X, Y) = \mathrm{Cov}(X, 2X + 3) = 2 \mathrm{Cov}(X, X) + \mathrm{Cov}(X, 3) = 2 V(X) + 0 = 2 V(X). $$ Donc \(\rho(X, Y) = 2 V(X) / (\sigma(X) \cdot 2 \sigma(X)) = V(X) / \sigma(X)^2 = 1\). Exemple — Dépendance linéaire parfaite à pente négative
Même cadre avec \(Y = -X\). Alors \(\mathrm{Cov}(X, -X) = -\mathrm{Cov}(X, X) = -V(X)\), \(\sigma(Y) = \sigma(X)\), donc \(\rho(X, Y) = -V(X) / \sigma(X)^2 = -1\). Méthode — Calculer et interpréter le coefficient de corrélation
- Calculer \(\mathrm{Cov}(X, Y)\) (Koenig-Huygens), \(\sigma(X) = \sqrt{V(X)}\) et \(\sigma(Y) = \sqrt{V(Y)}\), puis \(\rho = \mathrm{Cov}/(\sigma_X \sigma_Y)\).
- \(|\rho|\) proche de \(1\) signale une dépendance quasi linéaire ; \(\rho = 0\) signale une indépendance linéaire mais PAS l'indépendance.
- Signe : \(\rho > 0\) quand \(X\) et \(Y\) tendent à varier dans le même sens ; \(\rho < 0\) quand elles tendent à varier en sens inverse.
Pour aller plus loin
La formule de la variance d'une somme dans le cas indépendant est le moteur des chapitres de probabilités suivants. Le chapitre Suites de variables aléatoires discrètes utilise \(V(\sum X_i) = \sum V(X_i)\) pour \(n\) v.a.\ indépendantes et de même loi, puis Convergences et approximations en tire l'inégalité de Bienaymé-Tchebychev et la loi faible des grands nombres — l'énoncé rigoureux du fait qu'une moyenne empirique se concentre autour de son espérance. Les mêmes outils de covariance et de corrélation reparaissent dans Statistiques bivariées, où ils mesurent le lien linéaire entre deux séries de données observées. Enfin, la théorie analogue pour des variables qui varient continûment plutôt que par sauts — comportement conjoint décrit par des densités et des intégrales — est développée dans Variables aléatoires à densité.
Compétences à pratiquer
- Calculer et interpréter le coefficient de corrélation
VI
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section