Éducation Nationale Française · ECGappliquées 2
Statistiques bivariées
Le cours précédent décrivait un seul caractère quantitatif mesuré sur un échantillon : sa moyenne \(\bar{x}\), sa variance \(s_x^2\), son écart-type \(s_x\). Ce cours mesure deux caractères \(x\) et \(y\) sur les mêmes \(n\) individus, et étudie comment ils varient ensemble. On représente les couples par un nuage de points, on résume le comportement conjoint par la covariance empirique \(s_{xy}\) et le coefficient de corrélation linéaire \(r_{xy}\), puis on ajuste le nuage par la meilleure droite au sens des moindres carrés — la droite de régression. La motivation économique est présente partout : des données comme la croissance de la production d'un pays et la variation de son chômage (la relation connue sous le nom de loi d'Okun) sont exactement le type de séries appariées que ce cours analyse. Convention : dans tout ce cours, \(n \ge 1\) est la taille de l'échantillon, \(x = (x_1, \dots, x_n)\) et \(y = (y_1, \dots, y_n)\) sont deux séries statistiques de moyennes respectives \(\bar{x}, \bar{y}\) et d'écarts-types \(s_x, s_y\) ; le couple \((x_i, y_i)\) est relevé sur le même individu \(i\).
I
Nuage de points et point moyen
I.1
Le nuage de points et son centre
Lorsque deux caractères quantitatifs sont mesurés sur chaque individu, la première image naturelle représente l'un en fonction de l'autre : chaque individu devient un point du plan, et la forme du nuage obtenu suggère déjà si les deux caractères évoluent ensemble. Son point d'équilibre, obtenu en moyennant coordonnée par coordonnée, est le premier résumé que l'on retient.
Définition — Série statistique à deux variables
Une série statistique à deux variables quantitatives est la liste des couples \((x_i, y_i)\) pour \(i\) de \(1\) à \(n\), où \(x_i\) et \(y_i\) sont les deux valeurs relevées sur l'individu \(i\). Les deux séries \(x = (x_1, \dots, x_n)\) et \(y = (y_1, \dots, y_n)\) sont les séries marginales. Définition — Nuage de points, point moyen
Le nuage de points de la série \((x, y)\) est l'ensemble des points du plan de coordonnées \((x_i, y_i)\) pour \(i\) de \(1\) à \(n\). Le point moyen du nuage est le point \(G\) de coordonnées \((\bar{x}, \bar{y})\), où $$ \bar{x} = \frac{1}{n} \sum_{i=1}^{n} x_i, \qquad \bar{y} = \frac{1}{n} \sum_{i=1}^{n} y_i. $$ Exemple
Pour les cinq individus \((x_i, y_i) = (1 ; 2), (2 ; 3), (3 ; 5), (4 ; 4), (5 ; 6)\), le nuage compte cinq points. Les moyennes valent \(\bar{x} = \frac{1 + 2 + 3 + 4 + 5}{5} = 3\) et \(\bar{y} = \frac{2 + 3 + 5 + 4 + 6}{5} = 4\), donc le point moyen est \(G(3 ; 4)\).
Voici le nuage de points des cinq points ci-dessus, avec le point moyen \(G\) marqué. Le nuage monte à peu près le long d'une droite, signe visuel d'une relation positive entre \(x\) et \(y\). 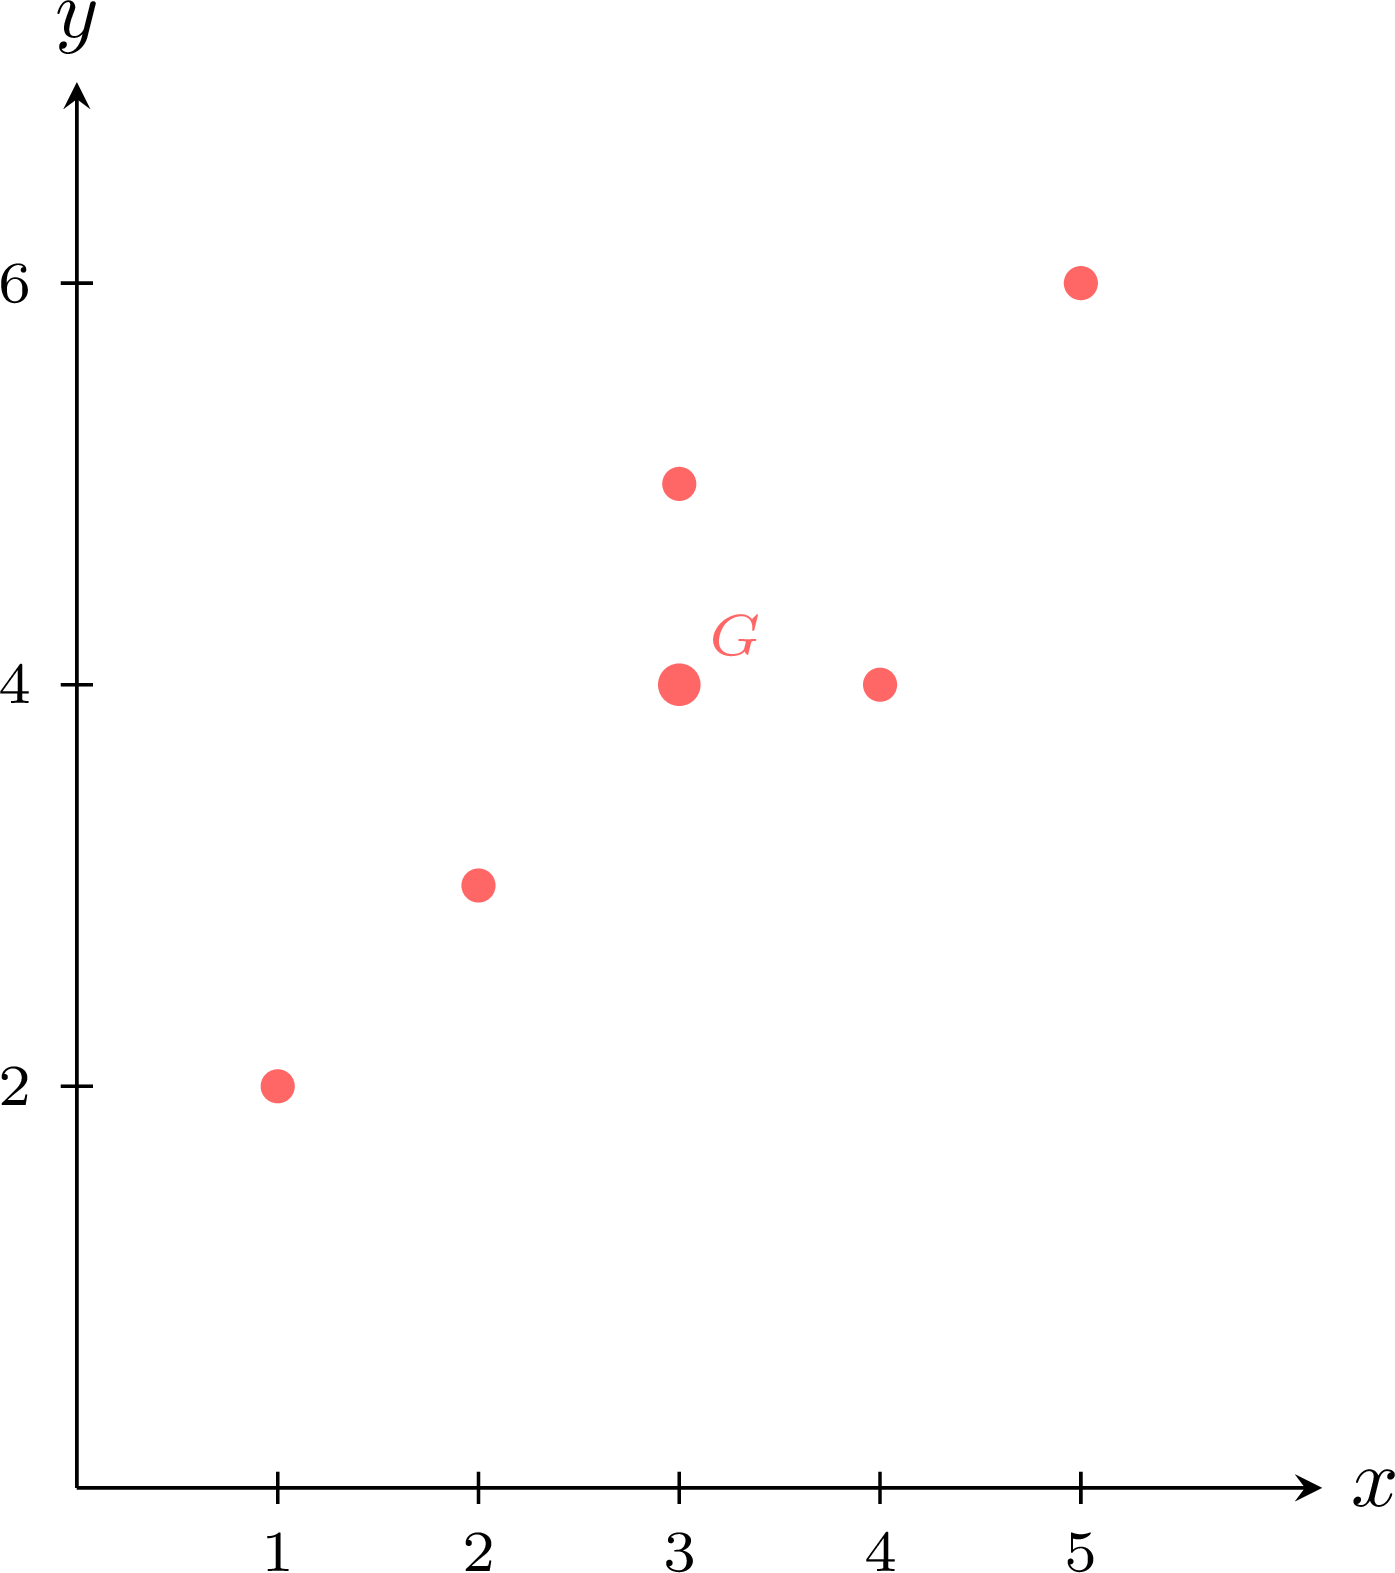
Exemple
Un macroéconomiste relève, sur six années, la croissance de la production \(x_i\) (en pour cent) et la variation du taux de chômage \(y_i\) (en points de pourcentage) d'un pays. Le nuage des six couples \((x_i, y_i)\) descend, car une croissance plus rapide tend à s'accompagner d'une baisse du chômage ; le point moyen \((\bar{x}, \bar{y})\) se situe au centre de cette bande descendante. C'est le contenu empirique de la loi d'Okun. Compétences à pratiquer
- Calculer un point moyen
II
Covariance et coefficient de corrélation linéaire
II.1
Covariance empirique
Le point moyen indique où se situe le nuage, mais pas comment ses deux coordonnées varient ensemble. La covariance mesure exactement cette variation conjointe : c'est la moyenne des produits des écarts de \(x\) et de \(y\) à leurs moyennes. Une covariance positive signifie qu'un \(x\) supérieur à la moyenne tend à aller avec un \(y\) supérieur à la moyenne ; une covariance négative signifie le contraire.
Définition — Covariance empirique
La covariance empirique de la série \((x, y)\) est le réel $$ s_{xy} = \frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y}). $$
Deux remarques fixent la notation. D'abord, la covariance d'une série avec elle-même est sa variance : \(s_{xx} = \frac{1}{n} \sum (x_i - \bar{x})^2 = s_x^2\), rappelée du cours précédent. Ensuite, la covariance est symétrique : \(s_{xy} = s_{yx}\), car le produit \((x_i - \bar{x})(y_i - \bar{y})\) ne dépend pas de l'ordre des facteurs.
Proposition — Formule de Koenig-Huygens pour la covariance
La covariance empirique peut se calculer par $$ s_{xy} = \left( \frac{1}{n} \sum_{i=1}^{n} x_i y_i \right) - \bar{x}\,\bar{y}. $$
En développant le produit sous la somme et en utilisant la linéarité : $$ \begin{aligned} s_{xy} &= \frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y}) \\
&= \frac{1}{n} \sum_{i=1}^{n} \bigl( x_i y_i - \bar{y}\, x_i - \bar{x}\, y_i + \bar{x}\,\bar{y} \bigr) \\
&= \frac{1}{n} \sum_{i=1}^{n} x_i y_i - \bar{y} \cdot \frac{1}{n} \sum_{i=1}^{n} x_i - \bar{x} \cdot \frac{1}{n} \sum_{i=1}^{n} y_i + \bar{x}\,\bar{y} && \text{(linéarité)} \\
&= \frac{1}{n} \sum_{i=1}^{n} x_i y_i - \bar{y}\,\bar{x} - \bar{x}\,\bar{y} + \bar{x}\,\bar{y} && \text{(définition de } \bar{x}, \bar{y}) \\
&= \left( \frac{1}{n} \sum_{i=1}^{n} x_i y_i \right) - \bar{x}\,\bar{y}. \end{aligned} $$
Exemple
Pour la série \((1 ; 2), (2 ; 3), (3 ; 5), (4 ; 4), (5 ; 6)\) avec \(\bar{x} = 3\) et \(\bar{y} = 4\), on calcule \(\sum x_i y_i = 1\cdot 2 + 2 \cdot 3 + 3 \cdot 5 + 4 \cdot 4 + 5 \cdot 6 = 2 + 6 + 15 + 16 + 30 = 69\). Par la formule de Koenig-Huygens, \(s_{xy} = \frac{69}{5} - 3 \cdot 4 = 13{,}8 - 12 = 1{,}8\). La covariance est positive, ce qui confirme la tendance croissante vue sur le graphe. Exemple
Pour les trois points \((0 ; 4), (1 ; 2), (2 ; 0)\) on a \(\bar{x} = 1\), \(\bar{y} = 2\), et \(\sum x_i y_i = 0 \cdot 4 + 1 \cdot 2 + 2 \cdot 0 = 2\). Donc \(s_{xy} = \frac{2}{3} - 1 \cdot 2 = \frac{2}{3} - 2 = -\frac{4}{3} < 0\) : lorsque \(x\) croît, \(y\) décroît, donc la covariance est négative. Méthode — Calculer une covariance
Pour calculer \(s_{xy}\) à la main, on dispose les données dans un tableau et on forme, colonne par colonne, les trois quantités \(\bar{x}\), \(\bar{y}\), et \(\frac{1}{n}\sum x_i y_i\) ; puis on applique la formule de Koenig-Huygens \(s_{xy} = \frac{1}{n}\sum x_i y_i - \bar{x}\,\bar{y}\). C'est presque toujours plus rapide que la forme par écarts \(\frac{1}{n}\sum (x_i - \bar{x})(y_i - \bar{y})\), car cela évite de retrancher les moyennes dans chaque terme. Compétences à pratiquer
- Calculer une covariance
II.2
Coefficient de corrélation linéaire
La covariance a le défaut de dépendre des unités : mesurer \(x\) en centimètres plutôt qu'en mètres multiplie \(s_{xy}\) par \(100\). Diviser par les deux écarts-types supprime les unités et produit un nombre pur, toujours compris entre \(-1\) et \(1\), dont la valeur absolue mesure la proximité du nuage à une droite.
Définition — Coefficient de corrélation linéaire
On suppose \(s_x\) et \(s_y\) non nuls. Le coefficient de corrélation linéaire de la série \((x, y)\) est le réel $$ r_{xy} = \frac{s_{xy}}{s_x\, s_y}. $$
Comme le dénominateur \(s_x s_y\) est positif, le coefficient \(r_{xy}\) a le même signe que la covariance \(s_{xy}\) : corrélation positive lorsque les deux caractères tendent à croître ensemble, négative lorsque l'un croît tandis que l'autre décroît.
Proposition — Inégalité de Cauchy-Schwarz et bornes de la corrélation
La covariance vérifie l'inégalité de Cauchy-Schwarz \(s_{xy}^2 \le s_x^2\, s_y^2\). Par conséquent, lorsque \(s_x\) et \(s_y\) sont non nuls, $$ -1 \le r_{xy} \le 1. $$
Posons \(u_i = x_i - \bar{x}\) et \(v_i = y_i - \bar{y}\). Pour tout réel \(t\), la somme de carrés \(\sum_{i=1}^{n} (u_i + t\, v_i)^2\) est un réel positif, car chaque terme est un carré. En développant, $$ \begin{aligned} 0 \le \sum_{i=1}^{n} (u_i + t\, v_i)^2 &= \left( \sum_{i=1}^{n} v_i^2 \right) t^2 + 2 \left( \sum_{i=1}^{n} u_i v_i \right) t + \sum_{i=1}^{n} u_i^2. \end{aligned} $$ C'est un polynôme de degré \(2\) en \(t\) (son coefficient dominant \(\sum v_i^2 = n\, s_y^2\) est positif car \(s_y \neq 0\)) qui reste positif, donc son discriminant est \(\le 0\) : $$ \begin{aligned} \left( 2 \sum u_i v_i \right)^2 - 4 \left( \sum v_i^2 \right)\left( \sum u_i^2 \right) &\le 0 \\
\left( \sum u_i v_i \right)^2 &\le \left( \sum u_i^2 \right)\left( \sum v_i^2 \right). \end{aligned} $$ En divisant les deux membres par \(n^2\), on obtient \(s_{xy}^2 \le s_x^2\, s_y^2\). En prenant les racines carrées, \(|s_{xy}| \le s_x\, s_y\), donc \(|r_{xy}| = \frac{|s_{xy}|}{s_x s_y} \le 1\), soit \(-1 \le r_{xy} \le 1\).
Proposition — Le cas extrême de la corrélation parfaite
On suppose \(s_x \neq 0\) et \(s_y \neq 0\), de sorte que \(r_{xy}\) est défini. On a \(|r_{xy}| = 1\) si et seulement si les points du nuage sont exactement alignés, c'est-à-dire qu'il existe des réels \(a \neq 0\) et \(b\) tels que \(y_i = a\, x_i + b\) pour tout \(i\). De plus, la pente \(a\) a le même signe que \(r_{xy}\) : si \(r_{xy} = 1\) alors \(a > 0\), et si \(r_{xy} = -1\) alors \(a < 0\).
L'égalité \(|r_{xy}| = 1\) signifie l'égalité dans Cauchy-Schwarz, qui a lieu si et seulement si le discriminant ci-dessus est nul, c'est-à-dire que le polynôme en \(t\) a une racine double \(t_0\), soit \(\sum_{i=1}^{n} (u_i + t_0 v_i)^2 = 0\). Une somme de carrés est nulle si et seulement si chaque terme est nul, donc \(u_i = -t_0\, v_i\) pour tout \(i\), c'est-à-dire \(x_i - \bar{x} = -t_0 (y_i - \bar{y})\). Avec \(t_0 \neq 0\) (sinon tous les \(u_i = 0\) et \(s_x = 0\)), cela se réarrange en \(y_i = a\, x_i + b\) avec \(a = -\frac{1}{t_0}\) et \(b = \bar{y} - a\, \bar{x}\). Le signe de \(a\) coïncide avec celui de \(r_{xy}\) car, comme noté ci-dessus, \(r_{xy}\) et \(s_{xy}\) ont même signe, et pour des points alignés \(s_{xy} = a\, s_x^2\) a le signe de \(a\).
Plus \(|r_{xy}|\) est proche de \(1\), plus le nuage est concentré le long d'une droite, et mieux un modèle affine décrira les données. Plus \(|r_{xy}|\) est proche de \(0\), plus le nuage est diffus et plus toute relation linéaire est faible. Les trois nuages ci-dessous illustrent une forte corrélation positive (\(r_{xy}\) proche de \(1\)), une forte corrélation négative (\(r_{xy}\) proche de \(-1\)), et une corrélation quasi nulle. 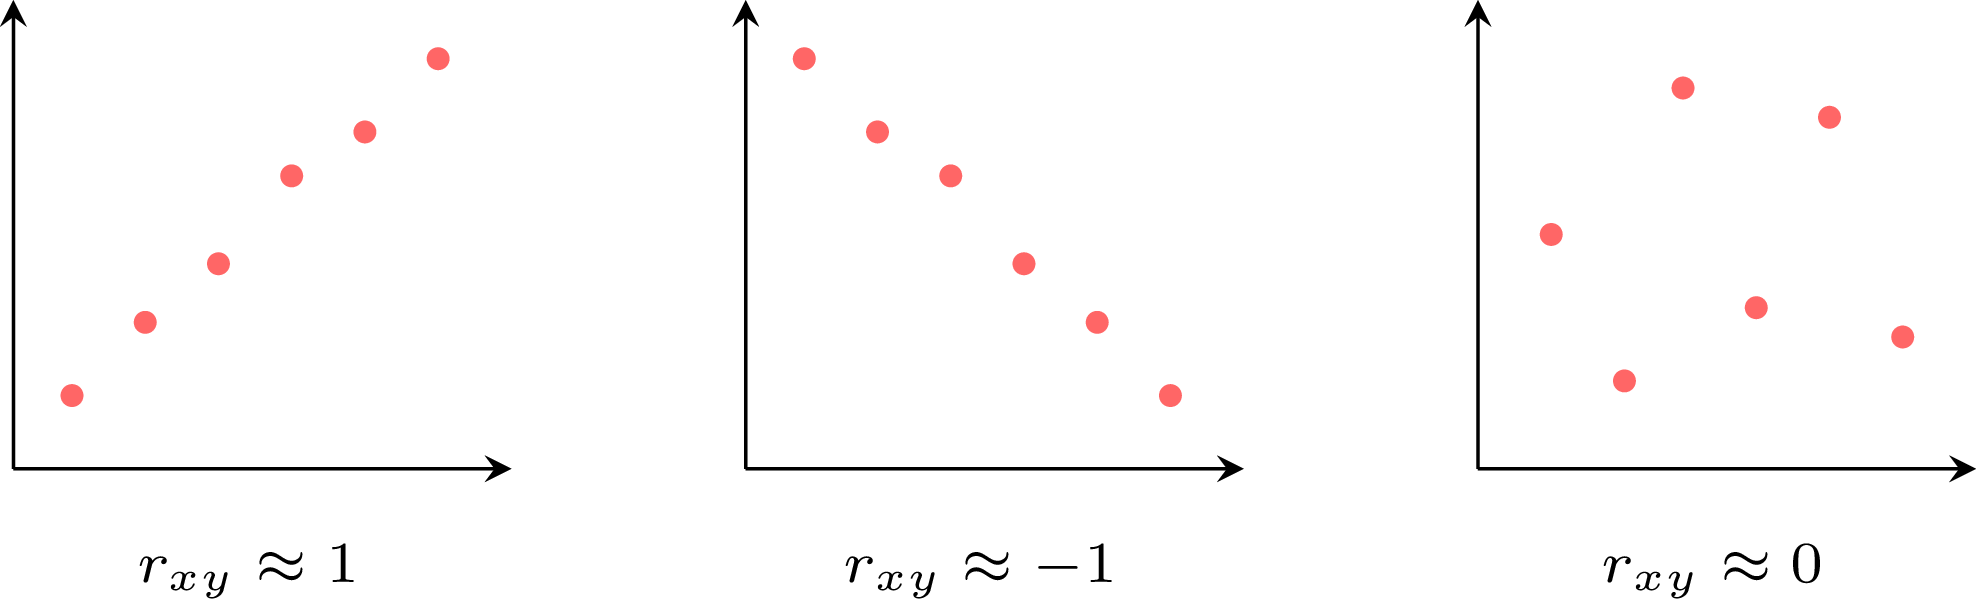
Exemple
En poursuivant avec la série \((1 ; 2), (2 ; 3), (3 ; 5), (4 ; 4), (5 ; 6)\) : on a trouvé \(s_{xy} = 1{,}8\). Les variances valent \(s_x^2 = \frac{1}{5}\sum x_i^2 - \bar{x}^2 = \frac{55}{5} - 9 = 2\) et \(s_y^2 = \frac{1}{5}\sum y_i^2 - \bar{y}^2 = \frac{90}{5} - 16 = 2\), donc \(s_x = s_y = \sqrt{2}\). Donc \(r_{xy} = \frac{1{,}8}{\sqrt{2}\cdot\sqrt{2}} = \frac{1{,}8}{2} = 0{,}9\). Proche de \(1\), cela signale une forte relation linéaire positive. Exemple
Pour les trois points alignés \((0 ; 1), (1 ; 3), (2 ; 5)\), on a \(y_i = 2 x_i + 1\) exactement. Ici \(\bar{x} = 1\), \(\bar{y} = 3\), \(s_{xy} = \frac{1}{3}(0\cdot 1 + 1 \cdot 3 + 2 \cdot 5) - 1 \cdot 3 = \frac{13}{3} - 3 = \frac{4}{3}\), \(s_x^2 = \frac{1}{3}(0 + 1 + 4) - 1 = \frac{2}{3}\), \(s_y^2 = \frac{1}{3}(1 + 9 + 25) - 9 = \frac{8}{3}\). Alors \(r_{xy} = \frac{4/3}{\sqrt{2/3}\,\sqrt{8/3}} = \frac{4/3}{\sqrt{16/9}} = \frac{4/3}{4/3} = 1\), comme attendu pour des points parfaitement alignés à pente positive. Méthode — Interpréter le coefficient de corrélation
Une fois \(r_{xy}\) calculé, on l'interprète en deux temps. D'abord on lit son signe : positif signifie que \(x\) et \(y\) tendent à varier dans le même sens, négatif en sens opposés. Puis on lit sa valeur absolue : plus \(|r_{xy}|\) est proche de \(1\), plus un ajustement affine est justifié ; plus elle est proche de \(0\), moins une droite capture les données. Une valeur comme \(|r_{xy}| = 0{,}9\) soutient un modèle affine ; une valeur comme \(0{,}2\) non. Il ne faut jamais lire un \(|r_{xy}|\) élevé comme une preuve qu'un caractère cause l'autre — corrélation n'est pas causalité. Compétences à pratiquer
- Calculer et interpréter un coefficient de corrélation
III
Ajustement des moindres carrés et droites de régression
III.1
La droite de régression des moindres carrés
Lorsque le nuage paraît à peu près aligné, on veut la seule droite qui l'ajuste le mieux. Il faut d'abord décider quel caractère on traite comme connu — la variable explicative, ici \(x\) — et lequel on veut prédire — la variable à expliquer, ici \(y\). Le principe des moindres carrés choisit alors la droite \(y = a x + b\) qui rend la somme des carrés des erreurs verticales \(\sum (y_i - a x_i - b)^2\) aussi petite que possible.
Définition — Variables explicative et à expliquer, principe des moindres carrés
Dans un ajustement de \(y\) en fonction de \(x\), la variable \(x\) est la variable explicative et \(y\) la variable à expliquer. Pour une droite candidate \(y = a x + b\), l'erreur commise à l'individu \(i\) est \(y_i - (a x_i + b)\). Le principe des moindres carrés choisit le couple \((a, b)\) qui minimise la somme des carrés des erreurs $$ S(a, b) = \sum_{i=1}^{n} \bigl( y_i - a x_i - b \bigr)^2. $$ Théorème — Droite de régression des moindres carrés de \(y\) en \(x\)
On suppose \(s_x \neq 0\). Il existe un unique couple \((a, b)\) minimisant \(S(a, b)\), donné par $$ a = \frac{s_{xy}}{s_x^2}, \qquad b = \bar{y} - a\, \bar{x}. $$ La droite correspondante \(y = a x + b\) est la droite de régression des moindres carrés de \(y\) en \(x\) ; elle passe par le point moyen \(G(\bar{x}, \bar{y})\).
Pour une pente \(a\) fixée, on minimise \(S(a, b)\) en \(b\). L'application \(b \mapsto S(a, b)\) est un polynôme de degré \(2\) en \(b\) à coefficient dominant positif \(n\), donc admet un unique minimum là où sa dérivée en \(b\) s'annule : $$ \begin{aligned} \frac{\mathrm{d}}{\mathrm{d}b} S(a, b) &= \sum_{i=1}^{n} -2\bigl( y_i - a x_i - b \bigr) = 0 \\
&\iff \sum_{i=1}^{n} \bigl( y_i - a x_i - b \bigr) = 0 \\
&\iff n \bar{y} - a\, n \bar{x} - n b = 0 \iff b = \bar{y} - a\, \bar{x}. \end{aligned} $$ Ceci montre déjà que la droite optimale passe par \(G\), puisque \(\bar{y} = a\,\bar{x} + b\). En substituant \(b = \bar{y} - a\bar{x}\) dans \(S\) et en posant \(u_i = x_i - \bar{x}\), \(v_i = y_i - \bar{y}\), $$ \begin{aligned} S(a, \bar{y} - a\bar{x}) &= \sum_{i=1}^{n} \bigl( (y_i - \bar{y}) - a (x_i - \bar{x}) \bigr)^2 \\
&= \sum_{i=1}^{n} \bigl( v_i - a\, u_i \bigr)^2 = \left( \sum u_i^2 \right) a^2 - 2 \left( \sum u_i v_i \right) a + \sum v_i^2. \end{aligned} $$ C'est un polynôme de degré \(2\) en \(a\) à coefficient dominant positif \(\sum u_i^2 = n s_x^2 > 0\), d'où un unique minimiseur $$ a = \frac{\sum u_i v_i}{\sum u_i^2} = \frac{n\, s_{xy}}{n\, s_x^2} = \frac{s_{xy}}{s_x^2}. $$
Deux conséquences sont à retenir. La pente \(a = s_{xy}/s_x^2\) a le même signe que la covariance, donc le même signe que \(r_{xy}\) : un nuage croissant donne une droite de régression croissante. Et la droite passe toujours par le point moyen, donc une fois la pente connue, toute la droite est fixée par \(G(\bar{x}, \bar{y})\).
Exemple
Pour la série \((1 ; 2), (2 ; 3), (3 ; 5), (4 ; 4), (5 ; 6)\) on avait \(s_{xy} = 1{,}8\), \(s_x^2 = 2\), \(\bar{x} = 3\), \(\bar{y} = 4\). La droite de régression de \(y\) en \(x\) a pour pente \(a = \frac{1{,}8}{2} = 0{,}9\) et pour ordonnée à l'origine \(b = 4 - 0{,}9 \cdot 3 = 1{,}3\), donc son équation est \(y = 0{,}9\, x + 1{,}3\). Vérification : en \(x = \bar{x} = 3\), \(y = 0{,}9 \cdot 3 + 1{,}3 = 4 = \bar{y}\), donc la droite passe par \(G\). Exemple
Le nuage ci-dessous montre les mêmes cinq points avec la droite de régression ajustée \(y = 0{,}9\, x + 1{,}3\) tracée par le point moyen \(G(3 ; 4)\). 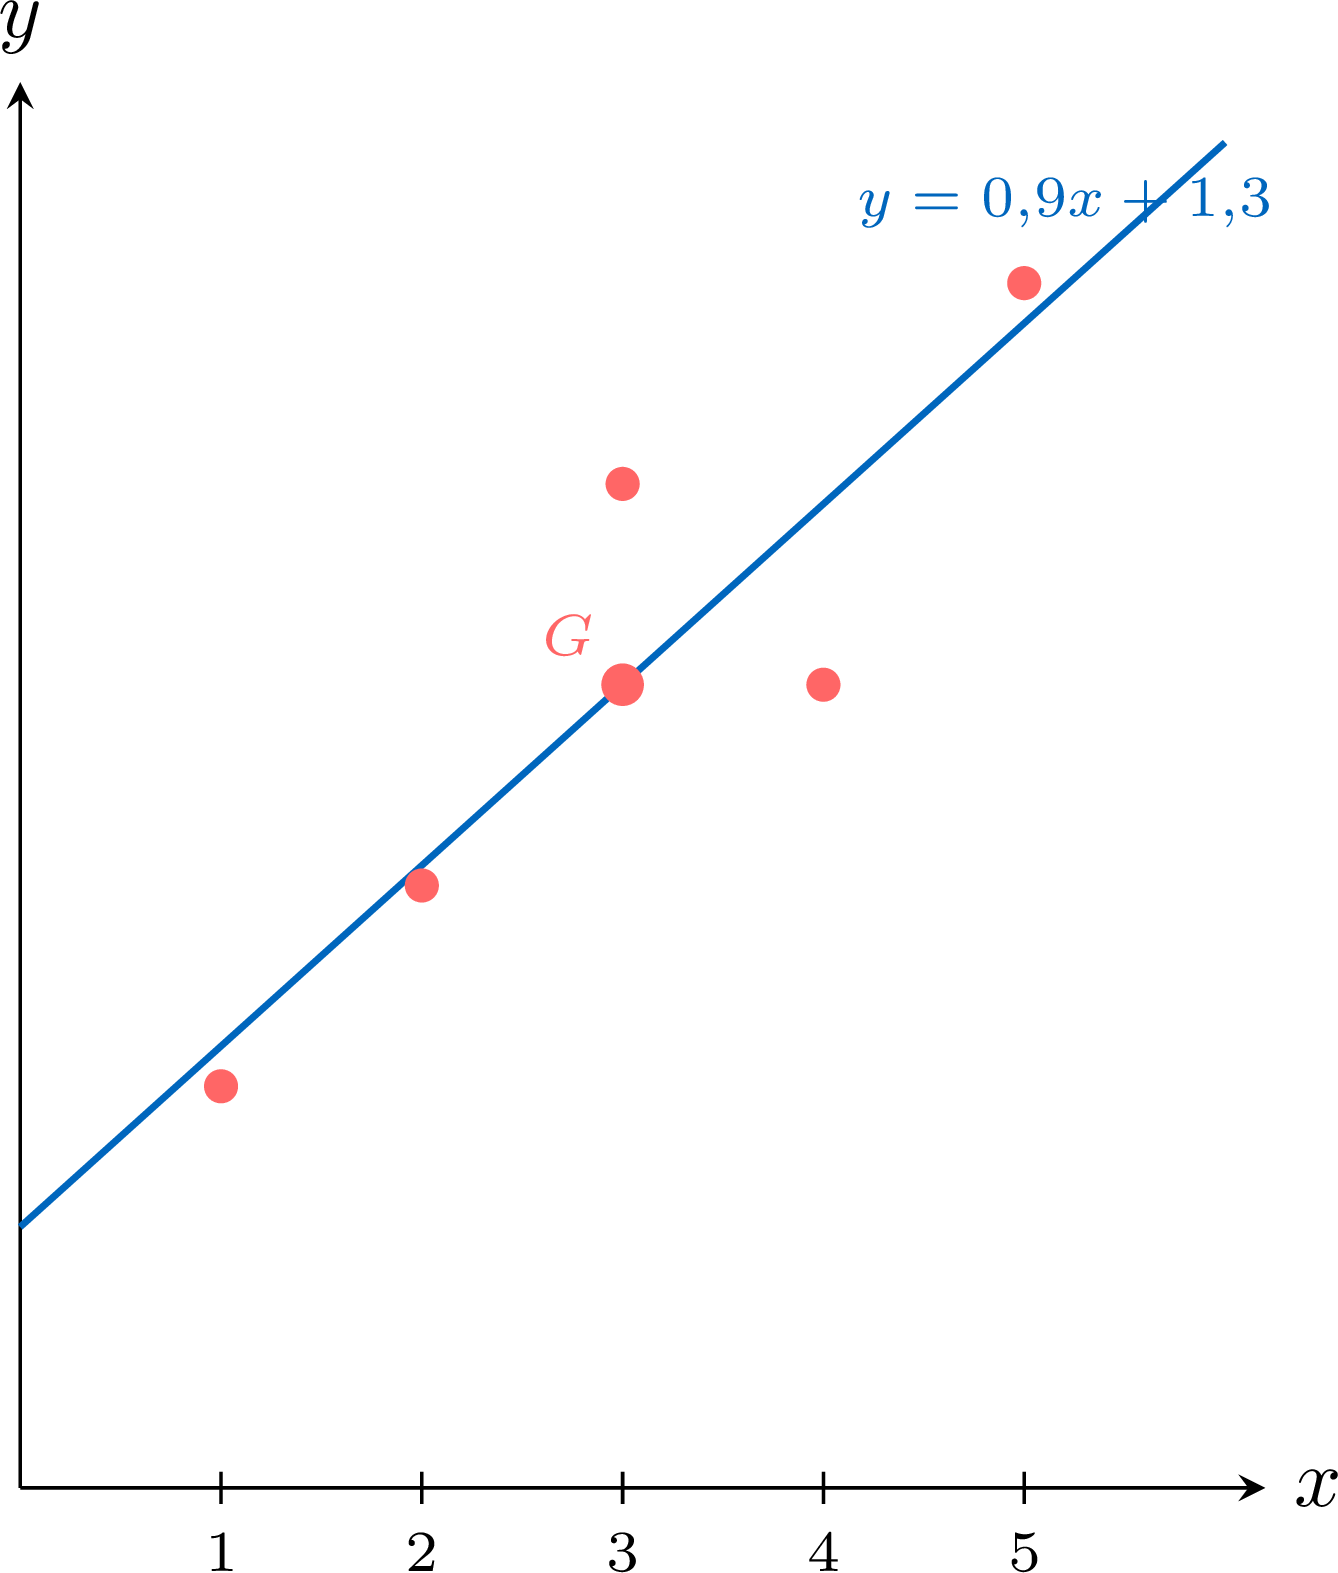
Méthode — Ajuster une droite de régression des moindres carrés
Pour ajuster \(y\) en \(x\) : (1) on décide quelle variable est explicative (\(x\)) et laquelle est à expliquer (\(y\)) ; (2) on calcule \(\bar{x}\), \(\bar{y}\), puis \(s_x^2\) et \(s_{xy}\) par les formules de Koenig-Huygens ; (3) on forme la pente \(a = s_{xy}/s_x^2\) et l'ordonnée à l'origine \(b = \bar{y} - a\bar{x}\) ; (4) on écrit la droite \(y = a x + b\), et l'on vérifie qu'elle passe par \(G(\bar{x}, \bar{y})\). Pour prédire la valeur à expliquer pour une nouvelle valeur \(x_0\), on évalue \(a x_0 + b\) — mais seulement si \(x_0\) est dans la plage des données observées. Compétences à pratiquer
- Ajuster une droite de régression
III.2
Pertinence de la régression et pré-transformations
Dès que \(s_x \neq 0\), une droite de régression peut être calculée, mais elle n'a de sens que lorsque le nuage est réellement proche d'une droite. Le coefficient de corrélation est l'indicateur usuel de cette pertinence, et une identité propre relie les deux (un \(|r_{xy}|\) élevé soutient un ajustement affine mais n'exclut pas à lui seul une tendance courbe ou une pente due à une valeur aberrante). Lorsque le nuage n'est pas linéaire mais suit une forme courbe connue, un changement de variable peut souvent ramener le problème au cas linéaire.
Proposition — Somme des carrés des résidus et corrélation
On suppose \(s_x \neq 0\) et \(s_y \neq 0\). Soit \((a, b)\) les coefficients des moindres carrés de \(y\) en \(x\). La somme minimale des carrés des erreurs est $$ S(a, b) = n\, s_y^2 \bigl( 1 - r_{xy}^2 \bigr). $$ En particulier \(S(a, b) = 0\) si et seulement si \(|r_{xy}| = 1\), c'est-à-dire que les points sont exactement alignés ; et plus \(r_{xy}^2\) est proche de \(1\), plus l'erreur résiduelle est petite et meilleur est l'ajustement.
En utilisant \(b = \bar{y} - a\bar{x}\) et \(u_i = x_i - \bar{x}\), \(v_i = y_i - \bar{y}\) : $$ \begin{aligned} S(a, b) &= \sum_{i=1}^{n} \bigl( v_i - a\, u_i \bigr)^2 \\
&= \sum v_i^2 - 2a \sum u_i v_i + a^2 \sum u_i^2 \\
&= n s_y^2 - 2a \cdot n s_{xy} + a^2 \cdot n s_x^2 && \text{(définitions)} \\
&= n s_y^2 - 2 \frac{s_{xy}}{s_x^2}\, n s_{xy} + \frac{s_{xy}^2}{s_x^4}\, n s_x^2 && (a = s_{xy}/s_x^2) \\
&= n s_y^2 - \frac{n\, s_{xy}^2}{s_x^2} = n s_y^2 \left( 1 - \frac{s_{xy}^2}{s_x^2 s_y^2} \right) = n s_y^2 \bigl( 1 - r_{xy}^2 \bigr). \end{aligned} $$ Comme \(n s_y^2 > 0\), le résidu \(S(a, b)\) est nul exactement lorsque \(r_{xy}^2 = 1\), et décroît à mesure que \(r_{xy}^2\) croît vers \(1\).
Cette identité précise la règle énoncée plus haut : la pertinence d'une régression linéaire est gouvernée par \(r_{xy}^2\), la part de la variation de \(y\) que la droite explique. Une valeur de \(r_{xy}^2\) proche de \(1\) signifie que la droite explique presque toute la dispersion ; une valeur proche de \(0\) signifie que la droite est essentiellement inutile et qu'un modèle linéaire doit être rejeté pour ces données.
Méthode — Pré-transformer pour se ramener à un ajustement linéaire
Lorsque le nuage suit une loi courbe connue plutôt qu'une droite, on change de variables pour rendre la relation linéaire, on ajuste la droite dans les nouvelles variables, puis on revient aux variables d'origine. Deux cas fréquents : - Si \(y \approx C\, \mathrm{e}^{a x}\) (croissance exponentielle), et pourvu que chaque \(y_i > 0\) pour que le logarithme soit défini, on prend les logarithmes : \(\ln y \approx \ln C + a x\), linéaire en \(x\). On ajuste \(\ln y\) en \(x\), on lit \(a\) et \(\ln C\).
- Si \(y \approx a\, x^2 + b\) (parabolique), on pose \(X = x^2\) : alors \(y \approx a X + b\) est linéaire en \(X\). On ajuste \(y\) en \(X\).
Exemple
Une population \(y\) double à peu près à chaque période et se modélise par \(y \approx C\, \mathrm{e}^{a x}\). Tracer \(y\) en fonction de \(x\) donne un nuage courbe avec une corrélation modeste, mais tracer \(\ln y\) en fonction de \(x\) donne un nuage presque rectiligne avec \(r\) proche de \(1\). La régression de \(\ln y\) en \(x\) fournit une pente \(a \approx 0{,}69\) (donc le facteur par période \(\mathrm{e}^{a} \approx 2\)) et une ordonnée à l'origine \(\ln C\), ce qui restitue le modèle exponentiel.
Une dernière mise en garde a sa place ici, au moment d'interpréter un ajustement. Une forte corrélation entre deux caractères ne prouve pas que l'un cause l'autre : les deux peuvent être entraînés par un troisième facteur caché, ou la corrélation peut même être fortuite. Avant de tirer une conclusion économique d'une régression, on doit se demander si un lien causal est plausible, s'il existe une variable confondante, et si la corrélation pourrait être due au hasard.
Compétences à pratiquer
- Évaluer la pertinence et pré-transformer
IV
Statistiques descriptives bivariées avec Python
IV.1
Calculer les résumés sur un échantillon
En pratique les résumés ci-dessus sont calculés par la machine. On stocke les deux séries comme des tableaux numériques et l'on utilise la bibliothèque scientifique standard pour obtenir les moyennes, la covariance, le coefficient de corrélation et les coefficients de régression. Le code ci-dessous reproduit, ligne par ligne, la procédure à la main des sections précédentes ; il se lit ici seulement comme une transcription des formules, non comme une mathématique nouvelle.
Exemple
La session ci-dessous charge les cinq observations appariées, trace le nuage, et calcule le point moyen, la covariance, le coefficient de corrélation, ainsi que la pente et l'ordonnée à l'origine de la régression. \begin{verbatim} import numpy as np import matplotlib.pyplot as plt x = np.array([1, 2, 3, 4, 5]) y = np.array([2, 3, 5, 4, 6]) n = len(x) xbar, ybar = x.mean(), y.mean() # point moyen (3.0, 4.0) sxy = (x*y).mean() - xbar*ybar # covariance 1.8 sx2 = (x**2).mean() - xbar**2 # variance de x : 2.0 r = sxy / np.sqrt(sx2 * ((y**2).mean() - ybar**2)) # 0.9 a = sxy / sx2 # pente 0.9 b = ybar - a*xbar # ordonnee a l'origine 1.3 plt.plot(x, y, "b+") # nuage de points plt.plot(x, a*x + b, "r-") # droite de regression plt.show() \end{verbatim} Son exécution renvoie \(\bar{x} = 3\), \(\bar{y} = 4\), \(s_{xy} = 1{,}8\), \(r \approx 0{,}9\), \(a = 0{,}9\), \(b = 1{,}3\) — les mêmes nombres trouvés à la main. Méthode — Lire une session Python de statistiques
Lorsqu'on demande de lire ou compléter une telle session, on identifie chaque ligne avec sa formule : x.mean() est \(\bar{x}\) ; (x*y).mean() - xbar*ybar est la covariance de Koenig-Huygens \(s_{xy}\) ; (x**2).mean() - xbar**2 est la variance \(s_x^2\) ; sxy/sx2 est la pente \(a\) ; ybar - a*xbar est l'ordonnée à l'origine \(b\). La corrélation est \(s_{xy}\) divisée par le produit des deux écarts-types. Lire le code, c'est relire les formules une fois de plus. Compétences à pratiquer
- Lire et compléter une session Python
V
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section