Éducation Nationale Française · Terminale Maths Expertes
Chaînes de Markov
I
Propriété de Markov
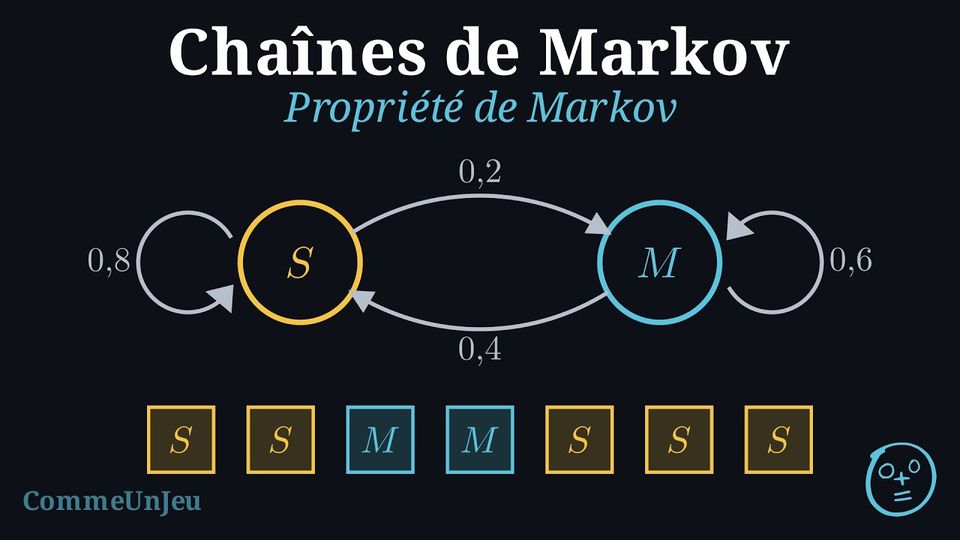
Dans de nombreux modèles réels, on suppose des résultats déterministes : si l'on connaît les données d'entrée, on peut calculer exactement la sortie. Cependant, de nombreux systèmes présentent des variations aléatoires. Un modèle stochastique utilise les probabilités pour décrire et prédire des résultats lorsque le hasard intervient.
Les chaînes de Markov sont une classe particulière de modèles stochastiques permettant de décrire des systèmes qui évoluent au cours du temps, et pour lesquels l'avenir ne dépend que de l'état présent.
Les chaînes de Markov sont une classe particulière de modèles stochastiques permettant de décrire des systèmes qui évoluent au cours du temps, et pour lesquels l'avenir ne dépend que de l'état présent.
Pour modéliser un système au cours du temps, on considère une suite de variables aléatoires \((X_0, X_1, X_2, \dots)\). Chaque variable \(X_n\) représente l'état du système à l'étape \(n\). La caractéristique essentielle d'une chaîne de Markov est que la probabilité d'évoluer vers un état futur ne dépend que de l'état actuel, et non de l'historique des états précédents.
Définition — Espace des états et propriété de Markov
Soit \(E\) un ensemble fini \(\{e_1, e_2, \dots, e_k\}\) appelé espace des états.Une suite de variables aléatoires \((X_n)_{n \in \mathbb{N}}\) à valeurs dans \(E\) est une chaîne de Markov si, pour tout \(n \in \mathbb{N}\), pour tous indices \(i,j \in \{1,\dots,k\}\), et pour tous indices \(i_0,\dots,i_{n-1} \in \{1,\dots,k\}\) tels que l'événement de conditionnement soit de probabilité non nulle,$$P\!\Bigl(X_{n+1}=e_j \,\Big|\, X_n=e_i,\; X_{n-1}=e_{i_{n-1}},\dots,\; X_0=e_{i_0}\Bigr)=P\!\Bigl(X_{n+1}=e_j \,\Big|\, X_n=e_i\Bigr).$$ On se place dans le cas homogène, c'est-à-dire que la probabilité conditionnelle$$p_{ij}=P\!\bigl(X_{n+1}=e_j \mid X_n=e_i\bigr)$$ ne dépend pas de \(n\). La valeur \(p_{ij} \in [0 ; 1]\) est la probabilité de transition de l'état \(e_i\) vers l'état \(e_j\).
Méthode — Du langage naturel au modèle de chaîne de Markov
Lorsqu'une situation est décrite en langage courant, on construit un modèle de chaîne de Markov en suivant les étapes suivantes : - Repérer les instants. Choisir ce que représente une étape (un jour, une semaine, une transaction, etc.).
- Choisir les états. Lister les situations possibles du système à chaque étape (ensemble fini \(E=\{e_1,\dots,e_k\}\)).
- Indexer les états. Fixer un ordre sur \(E\) et associer à chaque état un indice : $$ e_1 \leftrightarrow 1,\quad e_2 \leftrightarrow 2,\quad \dots,\quad e_k \leftrightarrow k. $$ Cette indexation servira à construire des vecteurs et des matrices.
- Définir les variables aléatoires. Introduire \((X_n)_{n\in\mathbb{N}}\) où \(X_n\) désigne l'état du système à l'instant \(n\), avec valeurs dans \(E\).
- Traduire l'hypothèse « sans mémoire ». Écrire que l'avenir ne dépend que du présent : $$ P(X_{n+1}=e_j \mid X_n=e_i,\dots,X_0=e_{i_0})=P(X_{n+1}=e_j \mid X_n=e_i). $$
- Extraire les probabilités de transition. Pour chaque couple \((i ; j)\), on définit $$ p_{ij}=P(X_{n+1}=e_j\mid X_n=e_i). $$
Exemple — Modèle météo - États (avec indexation)
- Langage naturel.
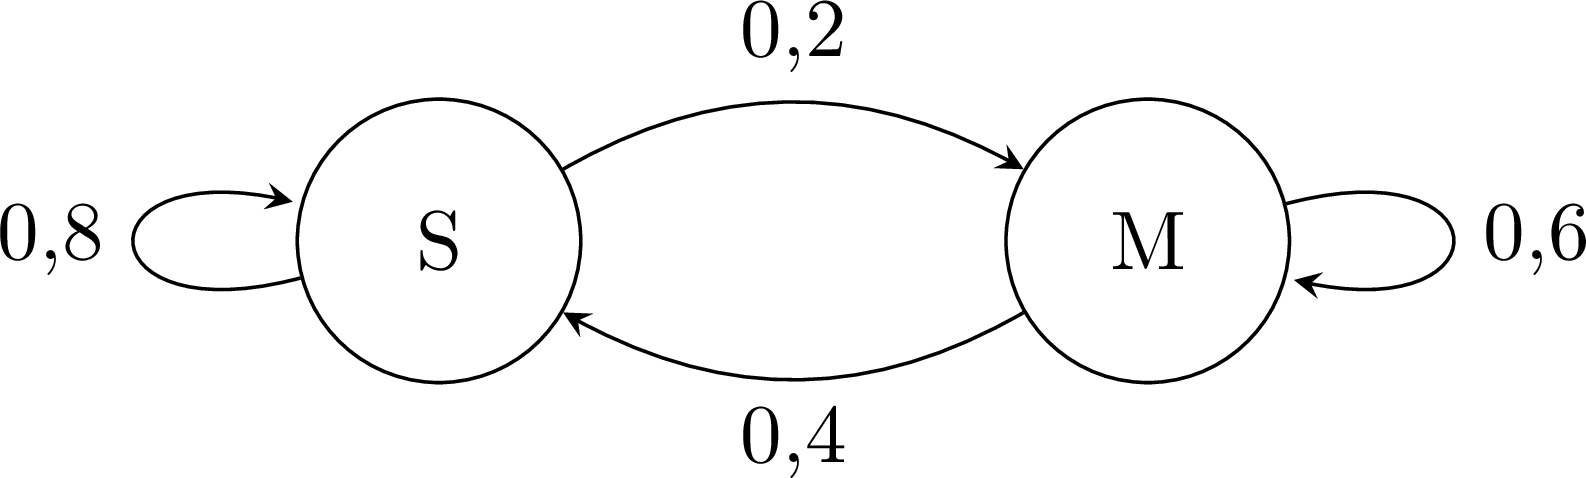
On considère la météo d'une ville. Chaque jour, le temps est soit ensoleillé, soit pluvieux. On suppose que :- s'il fait soleil aujourd'hui, alors la probabilité qu'il pleuve demain est \(0{,}2\) ;
- s'il pleut aujourd'hui, alors la probabilité qu'il fasse soleil demain est \(0{,}4\).
- Formalisme mathématique.
On choisit comme pas de temps un jour. On retient deux états :$$e_1=S \quad (\text{Soleil}), \qquad e_2=M \quad (\text{Mauvais temps : il pleut}),$$ donc l'espace des états est \(E=\{e_1,e_2\}=\{S,M\}\), avec l'indexation$$S \leftrightarrow 1,\qquad M \leftrightarrow 2.$$ On définit une suite de variables aléatoires \((X_n)_{n\in\mathbb{N}}\) en posant : \(X_n\) est l'état de la météo au jour \(n\), avec valeurs dans \(E\). L'expression « ne dépendent pas du temps qu'il faisait les jours précédents » se traduit par la propriété de Markov. Les probabilités de transition sont alors :$$p_{12}=P(X_{n+1}=e_2\mid X_n=e_1)=P(X_{n+1}=M\mid X_n=S)=0{,}2,$$ $$p_{21}=P(X_{n+1}=e_1\mid X_n=e_2)=P(X_{n+1}=S\mid X_n=M)=0{,}4.$$ Comme la somme des probabilités sortantes d'un état vaut \(1\), on en déduit aussi :$$p_{11}=1-p_{12}=0{,}8, \qquad p_{22}=1-p_{21}=0{,}6.$$ Ainsi, l'ensemble des probabilités de transition est :$$p_{11}=0{,}8,\quad p_{12}=0{,}2,\quad p_{21}=0{,}4,\quad p_{22}=0{,}6.$$
Compétences à pratiquer
- Analyser la propriété de Markov
- Modéliser une situation par une chaîne de Markov
II
Graphe probabiliste
Définition — Graphe probabiliste
On peut visualiser une chaîne de Markov à l'aide d'un graphe probabiliste : - Chaque sommet représente un état de \(E\).
- Chaque arête orientée (flèche) de \(i\) vers \(j\) représente la transition \(i \to j\).
- Le poids de l'arête est la probabilité \(p_{ij}\).
- Règle : La somme des probabilités des flèches sortant d'un sommet doit être égale à \(1\).
Exemple — Graphe de la météo
Compétences à pratiquer
- Analyser des graphes probabilistes
- Lire des graphes probabilistes
- Construire des graphes probabilistes
III
Distribution et matrice de transition
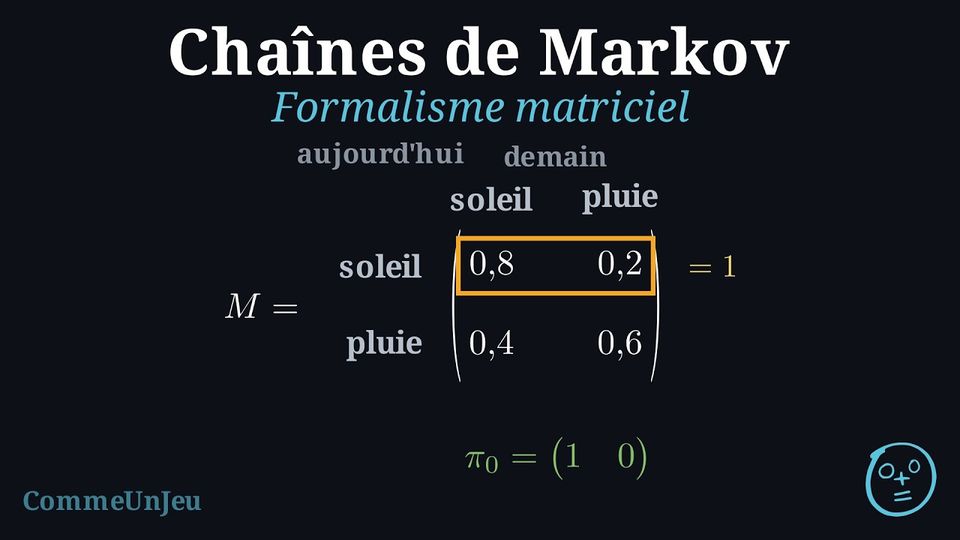
Pour effectuer des calculs, on associe à chaque état un indice (en général \(1,2,\dots,k\)). On peut alors organiser les probabilités de transition sous forme de vecteurs et de matrices, et utiliser le calcul matriciel pour étudier l'évolution du système.
Définition — Vecteur probabilité
La distribution de probabilité à l'étape \(n\) est représentée par un vecteur ligne \(\pi_n\) (une matrice ligne à \(k\) colonnes) :$$\pi_n = \begin{pmatrix} P(X_n = e_1) & P(X_n = e_2) & \dots & P(X_n = e_k) \end{pmatrix}.$$ Chaque composante appartient à \([0 ; 1]\), et la somme des composantes est toujours égale à \(1\). Le vecteur \(\pi_0\) s'appelle la distribution initiale. Définition — Matrice de transition
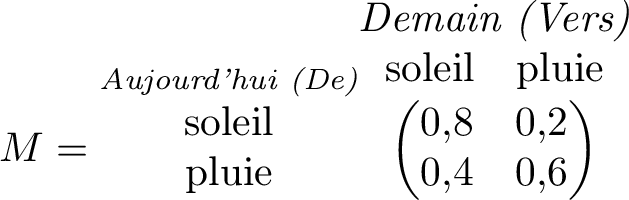
La matrice de transition \(M\) est une matrice carrée dont le coefficient \(m_{ij}\) de la \(i\)-ème ligne et de la \(j\)-ème colonne est :$$m_{ij} = P(X_{n+1} = e_j \mid X_n = e_i)=p_{ij}.$$ Matrice stochastique : Dans ce cadre, la somme des coefficients de chaque ligne de \(M\) est égale à \(1\).
Dans une matrice de transition \(M = (m_{ij})\) :
- Les lignes représentent l'état actuel (Départ).
- Les colonnes représentent l'état suivant (Arrivée).
- Le coefficient \(m_{ij}\) est la probabilité de passer à l'état \(j\) sachant qu'on est à l'état \(i\).
- La somme des coefficients de chaque ligne est égale à 1.
Exemple — Matrice de transition de la météo
Soit l'état 1 = Soleil et l'état 2 = Mauvais temps (il pleut).Si aujourd'hui il fait beau avec certitude, \(\pi_0 = \begin{pmatrix} 1 & 0 \end{pmatrix}\). La matrice est :
Compétences à pratiquer
- Analyser la représentation matricielle
- Écrire des distributions
- Construire et lire des matrices de transition
IV
Distribution après n transitions
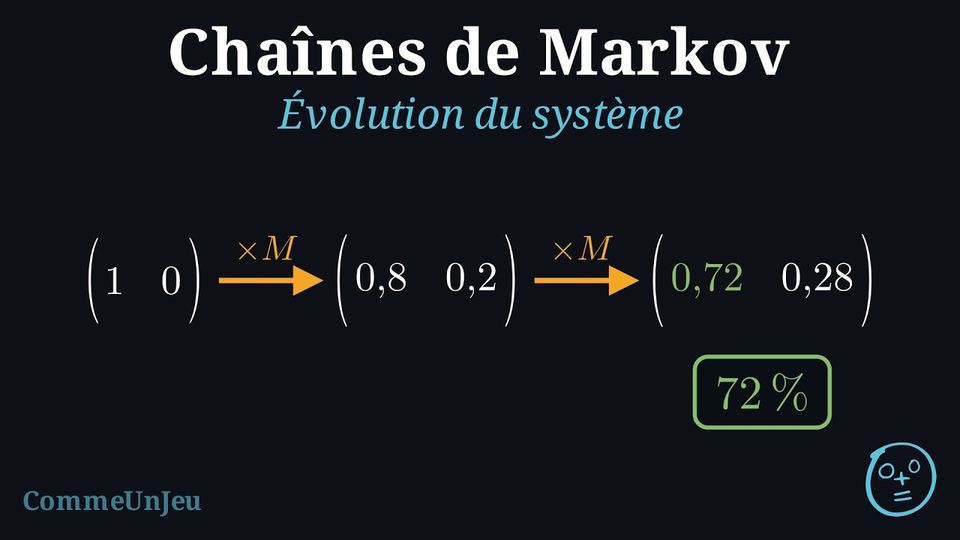
Une fois la matrice de transition définie, on peut calculer la distribution du système à tout instant \(n\) grâce au calcul matriciel.
Proposition — Règle d'évolution
Pour une chaîne de Markov de matrice de transition \(M\) et de vecteur probabilité \(\pi_n\) :$$\pi_{n+1} = \pi_n M\quad \text{et, par récurrence,} \quad\pi_n = \pi_0 M^n.$$
On démontre cette propriété en deux étapes.
- Démonstration de \(\pi_{n+1} = \pi_n M\) : Les événements \((X_n = e_i)\), pour \(i = 1, \dots, k\), forment une partition de l'univers, donc d'après la formule des probabilités totales, pour tout état \(e_j\) (les termes où \(P(X_n = e_i) = 0\) sont nuls) : $$ P(X_{n+1} = e_j) = \sum_{i=1}^{k} P(X_n = e_i) \times P(X_{n+1} = e_j \mid X_n = e_i) $$ Avec les notations introduites (\((\pi_n)_i\) pour le vecteur et \(m_{ij}\) pour la matrice) : $$ (\pi_{n+1})_j = \sum_{i=1}^{k} (\pi_n)_i \times m_{ij} $$ Cette somme correspond à la définition du produit d'un vecteur ligne par une matrice. On a donc : $$ \pi_{n+1} = \pi_n \times M $$
- Démonstration de \(\pi_n = \pi_0 M^n\) par récurrence :
- Initialisation : Pour \(n=0\), \(\pi_0 M^0 = \pi_0 I = \pi_0\).
- Hérédité : Si \(\pi_n = \pi_0 M^n\), alors \(\pi_{n+1} = \pi_n M = (\pi_0 M^n) M = \pi_0 M^{n+1}\).
- Conclusion : Par récurrence, la propriété est vraie pour tout \(n \in \mathbb{N}\).
Compétences à pratiquer
- Analyser l'évolution d'une chaîne de Markov
- Calculer les distributions successives
V
Coefficient de la puissance n-ième
Proposition — Coefficient \((i ; j)\) de \(M^n\)
Soit \(M\) la matrice de transition d'une chaîne de Markov \((X_n)\), et soit \(e_i\) un état tel que \(P(X_0 = e_i) > 0\).Pour tout \(n \in \mathbb{N}\) et tout état \(e_j\), le coefficient situé à la \(i\)-ème ligne et à la \(j\)-ème colonne de la matrice \(M^n\), noté \((M^n)_{ij}\), est la probabilité d'être dans l'état \(e_j\) après \(n\) étapes, sachant que le système était initialement dans l'état \(e_i\) :$$ (M^n)_{ij} = P(X_n = e_j \mid X_0 = e_i). $$ Plus généralement, par homogénéité, \((M^m)_{ij} = P(X_{n+m} = e_j \mid X_n = e_i)\) dès que \(P(X_n = e_i) > 0\) : le coefficient \((i ; j)\) de \(M^m\) est la probabilité de passer de \(e_i\) à \(e_j\) en \(m\) transitions.
Soit \(e_i\) un état tel que \(P(X_0 = e_i) > 0\), et on note \(P_i\) la probabilité conditionnelle sachant \(X_0 = e_i\) : pour tout événement \(A\), \(P_i(A) = P(A \mid X_0 = e_i)\). On démontre par récurrence sur \(n \in \mathbb{N}\) la propriété \((H_n)\) : « pour tout état \(e_j\), \(P_i(X_n = e_j) = (M^n)_{ij}\) ».
- Initialisation. Pour \(n = 0\), \(M^0 = I\), donc \((M^0)_{ij}\) vaut \(1\) si \(j = i\) et \(0\) sinon ; et \(P_i(X_0 = e_j) = P(X_0 = e_j \mid X_0 = e_i)\) vaut aussi \(1\) si \(j = i\) et \(0\) sinon. Donc \((H_0)\) est vraie.
- Hérédité. On suppose \((H_n)\) vraie pour un certain \(n \in \mathbb{N}\), et soit \(e_j\) un état. Les événements \((X_n = e_l)\), pour \(l = 1, \dots, k\), forment une partition de l'univers, donc la formule des probabilités totales, appliquée à la probabilité \(P_i\), donne $$P_i(X_{n+1} = e_j) = \sum_{l} P_i(X_n = e_l)\, P_i(X_{n+1} = e_j \mid X_n = e_l),$$ la somme portant sur les états \(e_l\) tels que \(P_i(X_n = e_l) > 0\) (les autres états n'apportent rien). Pour un tel état, \(P_i(X_{n+1} = e_j \mid X_n = e_l) = P(X_{n+1} = e_j \mid X_n = e_l \cap X_0 = e_i)\) ; d'après la propriété de Markov, connaître l'état initial en plus de l'état présent \(e_l\) ne change pas la probabilité de transition, et par homogénéité cette probabilité vaut \(m_{lj}\) (la propriété de Markov de la définition, qui conditionne par tout le passé, le donne après sommation sur les états possibles aux instants \(1\) à \(n-1\)). D'où, avec \((H_n)\), $$P_i(X_{n+1} = e_j) = \sum_{l} (M^n)_{il}\, m_{lj} = (M^{n+1})_{ij},$$ où la somme peut porter sur tous les états, puisque \((M^n)_{il} = P_i(X_n = e_l) = 0\) pour les états écartés ; la dernière égalité est la définition du produit \(M^n M\). Donc \((H_{n+1})\) est vraie.
- Conclusion. Par récurrence, \((H_n)\) est vraie pour tout \(n \in \mathbb{N}\).
Exemple — Prédiction météo
Aujourd'hui il fait beau. Trouver la probabilité qu'il fasse beau après-demain. - Méthode 1 (évolution pas à pas).
On utilise la matrice météo$$M=\begin{pmatrix} 0{,}8 & 0{,}2 \\ 0{,}4 & 0{,}6 \end{pmatrix}$$ et la distribution initiale (aujourd'hui il fait soleil avec certitude)$$\pi_0=\begin{pmatrix} 1 & 0 \end{pmatrix}.$$ On calcule alors :$$\pi_1=\pi_0 M=\begin{pmatrix} 1 & 0 \end{pmatrix}\begin{pmatrix} 0{,}8 & 0{,}2 \\ 0{,}4 & 0{,}6 \end{pmatrix}=\begin{pmatrix} 0{,}8 & 0{,}2 \end{pmatrix}.$$ Puis, après deux jours (\(n=2\)) :$$\pi_2=\pi_1 M=\begin{pmatrix} 0{,}8 & 0{,}2 \end{pmatrix}\begin{pmatrix} 0{,}8 & 0{,}2 \\ 0{,}4 & 0{,}6 \end{pmatrix}=\begin{pmatrix} 0{,}72 & 0{,}28 \end{pmatrix}.$$ Ainsi, la probabilité qu'il fasse soleil après-demain est \(0{,}72\), soit \(72\pourcent\). - Méthode 2 (puissance de matrice).
On calcule directement$$M^2=\begin{pmatrix} 0{,}8 & 0{,}2 \\ 0{,}4 & 0{,}6 \end{pmatrix}\begin{pmatrix} 0{,}8 & 0{,}2 \\ 0{,}4 & 0{,}6 \end{pmatrix}=\begin{pmatrix}0{,}72 & 0{,}28 \\ 0{,}56 & 0{,}44\end{pmatrix}.$$ Comme le système démarre dans l'état \(S\) (indice \(1\)), la probabilité cherchée est le coefficient \((1 ; 1)\) :$$(M^2)_{11}=P(X_2=S\mid X_0=S)=0{,}72.$$
Compétences à pratiquer
- Calculer la distribution après deux étapes
VI
Distribution invariante et convergence
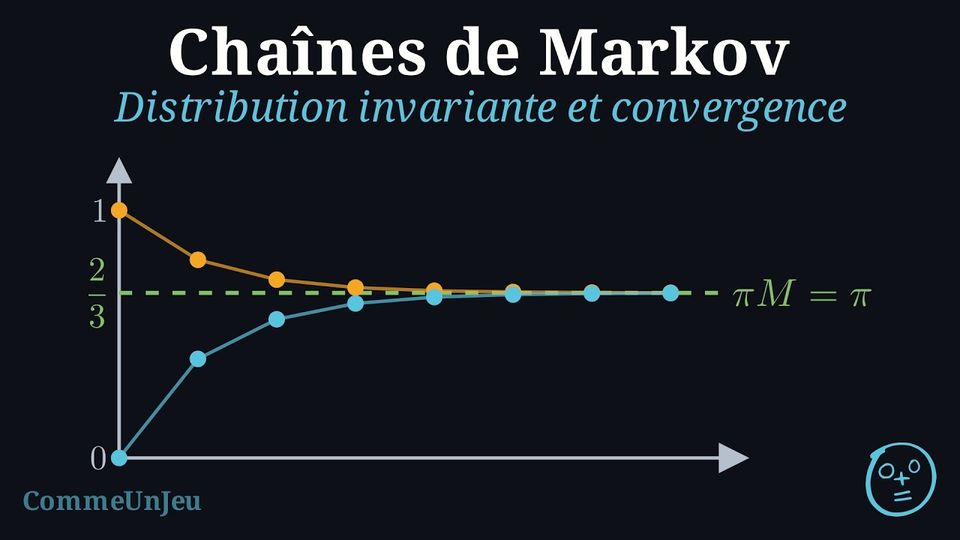
Une distribution qui ne change plus d'une étape à l'autre est appelée distribution invariante. Sur une longue période, de nombreuses chaînes de Markov se rapprochent d'un tel équilibre : leurs distributions se rapprochent de plus en plus d'une distribution invariante. Savoir si c'est bien le cas est une question distincte, étudiée à la fin de cette section.
Définition — Distribution invariante
Un vecteur probabilité \(\pi\) est une distribution invariante (on dit aussi un état stable) si :$$\pi M = \pi.$$ Proposition — Existence et unicité de la distribution invariante
Soit \(M\) la matrice de transition d'une chaîne de Markov à \(k \geq 2\) états. Si tous les coefficients de \(M\) situés hors de sa diagonale principale sont non nuls, alors la chaîne admet une unique distribution invariante. (Admis ; pour une chaîne à deux états dont les probabilités de transition \(p\), \(q\) sont strictement comprises entre \(0\) et \(1\), la proposition de fin de section le démontre directement et donne aussi la limite des distributions.)Par exemple, la chaîne de la météo, dont les deux coefficients hors diagonale, \(0{,}2\) et \(0{,}4\), sont non nuls, admet une unique distribution invariante.
Méthode — Calculer la distribution invariante
Pour déterminer une distribution invariante \(\pi=\begin{pmatrix} x & y \end{pmatrix}\) dans le cas de deux états : - On résout l'équation matricielle \(\begin{pmatrix} x & y \end{pmatrix} M = \begin{pmatrix} x & y \end{pmatrix}\).
- On obtient un système d'équations dont l'une est redondante.
- On ajoute la condition de normalisation \(x+y=1\), et on garde les solutions telles que \(x \geq 0\) et \(y \geq 0\).
Exemple — Distribution invariante de la météo
Pour \(M=\begin{pmatrix}0{,}8 & 0{,}2\\ 0{,}4 & 0{,}6\end{pmatrix},\) la résolution de \(\begin{cases}\pi M = \pi\\x + y = 1\end{cases}\quad\text{avec}\quad\pi=\begin{pmatrix} x & y \end{pmatrix}\) donne :$$\begin{cases}\begin{pmatrix} x & y \end{pmatrix} \begin{pmatrix} 0{,}8 & 0{,}2 \\
0{,}4 & 0{,}6 \end{pmatrix} = \begin{pmatrix} x & y \end{pmatrix}\\
x + y = 1\end{cases}\Leftrightarrow\begin{cases}0{,}8x + 0{,}4y = x \\
0{,}2x + 0{,}6y = y \\
x + y = 1\end{cases}\Leftrightarrow\begin{cases}-0{,}2x+0{,}4y=0 \\
x + y = 1\end{cases}\Leftrightarrow\begin{cases}x = 2y \\
3y = 1\end{cases}$$ Ainsi, la distribution invariante est$$\pi=\begin{pmatrix}\dfrac{2}{3} & \dfrac{1}{3}\end{pmatrix}.$$ Interprétation : les distributions de cette chaîne convergent vers \(\pi\) (c'est ce que démontre la proposition de fin de section), donc à long terme la probabilité d'être dans l'état \(S\) (soleil) est \(\dfrac{2}{3}\). Proposition — Convergence d'une chaîne à deux états
Soit \((X_n)\) une chaîne de Markov à deux états \(e_1\), \(e_2\), de matrice de transition$$M = \begin{pmatrix} 1 - p & p \\
q & 1 - q \end{pmatrix}, \qquad p \in \left]0 ; 1\right[, \quad q \in \left]0 ; 1\right[.$$ Alors, quelle que soit la distribution initiale \(\pi_0\), la suite des distributions \((\pi_n)\) converge vers$$\pi = \begin{pmatrix} \dfrac{q}{p+q} & \dfrac{p}{p+q} \end{pmatrix},$$ qui est l'unique distribution invariante de la chaîne.
On écrit \(\pi_n = \begin{pmatrix} a_n & b_n \end{pmatrix}\) avec \(a_n + b_n = 1\). Le premier coefficient de la relation \(\pi_{n+1} = \pi_n M\) s'écrit$$a_{n+1} = (1-p)\,a_n + q\,b_n = (1-p)\,a_n + q\,(1 - a_n) = (1 - p - q)\,a_n + q.$$ La suite \((a_n)\) est donc arithmético-géométrique. On pose \(\ell = \dfrac{q}{p+q}\) : c'est le point fixe, puisque \((1-p-q)\ell + q = \ell - (p+q)\ell + q = \ell\). Par soustraction, \(a_{n+1} - \ell = (1-p-q)(a_n - \ell)\) : la suite \((u_n)\) définie par \(u_n = a_n - \ell\) est géométrique de raison \(r = 1 - p - q\), donc \(u_n = r^n u_0\). Comme \(0 < p + q < 2\), on a \(-1 < r < 1\), donc \(r^n \to 0\) et \(a_n \to \ell\) ; puis \(b_n = 1 - a_n \to 1 - \ell = \dfrac{p}{p+q}\). Cela démontre la convergence de \((\pi_n)\) vers \(\pi\), quelle que soit \(\pi_0\).
La limite est invariante : son premier coefficient vérifie \((1-p-q)\ell + q = \ell\), c'est-à-dire \(\pi M = \pi\) (le second coefficient suit, les deux lignes de \(M\) ayant pour somme \(1\)). C'est la seule distribution invariante : \(\begin{pmatrix} x & y \end{pmatrix} M = \begin{pmatrix} x & y \end{pmatrix}\) avec \(x + y = 1\) donne \((1-p-q)x + q = x\), soit \((p+q)x = q\), dont l'unique solution est \(x = \ell\).
La limite est invariante : son premier coefficient vérifie \((1-p-q)\ell + q = \ell\), c'est-à-dire \(\pi M = \pi\) (le second coefficient suit, les deux lignes de \(M\) ayant pour somme \(1\)). C'est la seule distribution invariante : \(\begin{pmatrix} x & y \end{pmatrix} M = \begin{pmatrix} x & y \end{pmatrix}\) avec \(x + y = 1\) donne \((1-p-q)x + q = x\), soit \((p+q)x = q\), dont l'unique solution est \(x = \ell\).
Exemple — La météo à long terme
Pour la chaîne de la météo, \(p = 0{,}2\) et \(q = 0{,}4\), donc \(r = 1 - p - q = 0{,}4\) et les distributions convergent vers \(\pi = \begin{pmatrix} \dfrac{0{,}4}{0{,}6} & \dfrac{0{,}2}{0{,}6} \end{pmatrix} = \begin{pmatrix} \dfrac{2}{3} & \dfrac{1}{3} \end{pmatrix}\), la distribution invariante trouvée plus haut. En partant d'un jour de soleil, \(a_n = \dfrac{2}{3} + \dfrac{1}{3}\,(0{,}4)^n\) : la probabilité de soleil au jour \(n\) décroît vers \(\dfrac{2}{3}\), et \(a_5 \approx 0{,}670\). Compétences à pratiquer
- Analyser les distributions invariantes et la convergence
- Observer et calculer des distributions invariantes
VII
Pour aller plus loin
Compétences à pratiquer
- Diagnostiquer et corriger
- Problèmes
- Type bac
- Quiz
Contrôle du chapitre
4 exercices, sur 20 points. Durée indicative : 1 h 30.
À traiter sur papier, puis à photographier : la correction est automatique, par IA.
Ce contrôle ne modifie pas la maîtrise du chapitre, quelle que soit la note.
Aucun exercice composé.
Aller à la section