Éducation Nationale Française · ECGappliquées 2
Variables aléatoires à densité
Beaucoup de grandeurs — une durée de vie, une erreur de mesure, un temps d'attente — varient de façon continue, prenant toute valeur d'un intervalle. Une telle variable n'a aucun atome : \(P(X = a) = 0\) pour tout \(a\), donc elle ne peut être décrite par une liste de probabilités \(P(X = k)\). On étudie les variables continues qui de plus portent une densité \(f_X\) : une fonction positive ou nulle d'intégrale totale \(1\), avec \(P(a \le X \le b) = \int_a^b f_X\) et \(F_X(x) = \int_{-\infty}^x f_X\) — la version continue de la fonction de masse discrète, construite sur la fonction de répartition du cours précédent. On définit ensuite l'espérance et la variance par des intégrales (remplaçant les sommes discrètes), et on étudie les trois lois usuelles à densité : uniforme, exponentielle et normale. Conventions : \((\Omega, \mathcal{A}, P)\) est un espace probabilisé ; toutes les variables sont réelles ; \(f_X\) désigne une densité de \(X\) (elle n'est pas unique). On rappelle librement les outils d'intégrales impropres du cours précédent, en particulier \(\int_{-\infty}^{+\infty} e^{-x^2/2}\,\mathrm{d}x = \sqrt{2\pi}\).
I
Variables aléatoires à densité
I.1
Densité et fonction de répartition
Une variable continue n'a aucun atome, donc au lieu d'une fonction de masse elle est décrite par une densité. On rappelle du chapitre précédent que toute variable réelle porte une fonction de répartition \(F_X(x) = P(X \le x)\) ; une variable à densité est celle dont \(F_X\) est continue et assez régulière pour être l'intégrale d'une fonction — cette fonction est la densité.
Définition — Variable aléatoire à densité
Une variable aléatoire réelle \(X\) est une variable à densité (ou variable continue) lorsque sa fonction de répartition \(F_X\) est continue sur \(\mathbb{R}\) et de classe \(\mathcal{C}^1\) sur \(\mathbb{R}\), sauf éventuellement en un nombre fini de points. Définition — Densité d'une variable
Soit \(X\) une variable à densité. Une densité de \(X\) est une fonction \(f_X : \mathbb{R} \to \mathbb{R}\) positive ou nulle (\(f_X \ge 0\)) et égale à \(F_X'(x)\) en tout point où \(F_X\) est dérivable (sur l'ensemble fini exceptionnel, on attribue à \(f_X\) une valeur positive ou nulle quelconque).
La densité n'est pas unique
Changer \(f_X\) en un nombre fini de points (en gardant des valeurs positives ou nulles) donne une autre densité de \(X\). On parle donc d'une densité, non de la densité.
Proposition — Fonction de répartition et probabilités à partir de la densité
Soit \(X\) une variable de densité \(f_X\). Alors l'intégrale \(\int_{-\infty}^x f_X\) converge et $$ F_X(x) = \int_{-\infty}^x f_X(t)\,\mathrm{d}t. $$ De plus \(P(X = a) = 0\) pour tout \(a\), et pour \(a \le b\), $$ P(a \le X \le b) = P(a < X < b) = \int_a^b f_X(t)\,\mathrm{d}t $$ (les quatre formes d'intervalle coïncident).
Là où \(F_X\) est dérivable, \(F_X' = f_X\) ; en intégrant et en utilisant \(\lim_{-\infty} F_X = 0\) (rappelé du chapitre précédent) on obtient \(F_X(x) = \int_{-\infty}^x f_X\). Comme \(F_X\) est continue, le saut en \(a\) est nul, donc \(P(X = a) = F_X(a) - \lim_{t \to a^-} F_X(t) = 0\). Ainsi les bornes ne portent aucune probabilité et, pour \(a \le b\), $$ \begin{aligned} P(a \le X \le b) &= F_X(b) - F_X(a) && \text{(pas d'atome en } a\text{ ; chapitre précédent)} \\
&= \int_a^b f_X(t)\,\mathrm{d}t. && \text{(Chasles)} \end{aligned} $$
Théorème — Caractérisation d'une densité
Une fonction \(f : \mathbb{R} \to \mathbb{R}\) est une densité d'une variable aléatoire si et seulement si : - \(f\) est positive ou nulle sur \(\mathbb{R}\) ;
- \(f\) est continue sur \(\mathbb{R}\) sauf en un nombre fini de points ;
- \(\int_{-\infty}^{+\infty} f(t)\,\mathrm{d}t\) converge et vaut \(1\).
L'implication directe découle de la Proposition précédente (\(f_X \ge 0\), \(\int_{\mathbb{R}} f_X = \lim_{+\infty} F_X = 1\)). La réciproque — toute telle \(f\) est la densité d'une variable — est admise (elle nécessite la construction d'un espace probabilisé adapté).
Exemple
Déterminer le réel \(c\) pour lequel \(f(t) = \dfrac{c}{1 + t^2}\) est une densité, et donner la fonction de répartition de la variable correspondante.
Pour \(c \ge 0\), \(f\) est positive ou nulle et continue sur \(\mathbb{R}\). Son intégrale : $$ \begin{aligned} \int_{-\infty}^{+\infty} \frac{c}{1+t^2}\,\mathrm{d}t &= c\,[\arctan t]_{-\infty}^{+\infty} && \\
&= c\left(\tfrac\pi2 - \left(-\tfrac\pi2\right)\right) = c\pi. && \end{aligned} $$ Cela vaut \(1\) ssi \(c = \dfrac1\pi\) (la loi de Cauchy). Alors \(F_X(x) = \int_{-\infty}^x \frac{1}{\pi(1+t^2)}\,\mathrm{d}t = \dfrac1\pi\left(\arctan x + \tfrac\pi2\right) = \dfrac12 + \dfrac1\pi \arctan x\).
Exemple
La fonction \(f(t) = \mathbf{1}_{[0,1]}(t)\) (égale à \(1\) sur \([0,1]\) et \(0\) ailleurs) est une densité : elle est positive ou nulle, continue sauf en \(0\) et \(1\), et \(\int_{\mathbb{R}} f = \int_0^1 1\,\mathrm{d}t = 1\). Sa variable est uniforme sur \([0,1]\), avec \(F_X(x) = x\) sur \([0,1]\) (étudiée en Section~3). 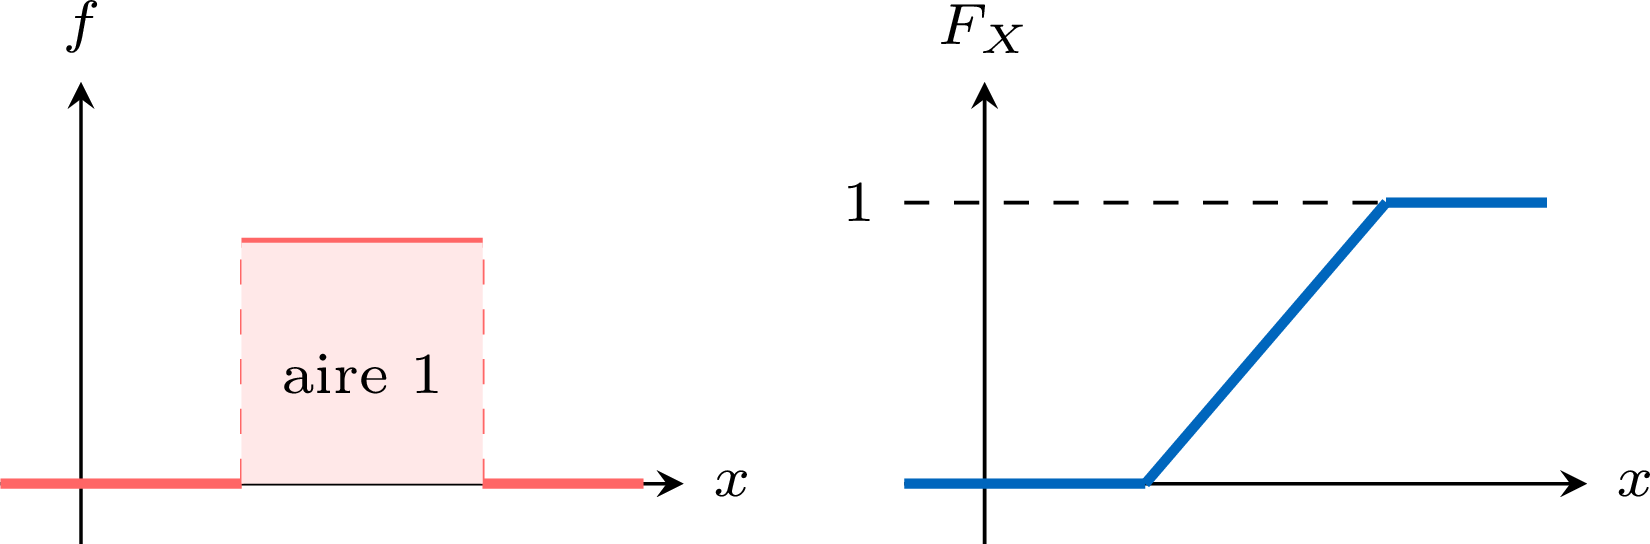
Exemple
Montrer que \(f(t) = 2t\,\mathbf{1}_{[0,1]}(t)\) est une densité, et calculer \(P(X \le \tfrac12)\).
\(f \ge 0\), continue sauf en \(0\) et \(1\), et \(\int_0^1 2t\,\mathrm{d}t = [t^2]_0^1 = 1\) : une densité. Alors \(P(X \le \tfrac12) = \int_0^{1/2} 2t\,\mathrm{d}t = \tfrac14\).
Méthode — Montrer qu'une fonction est une densité et trouver la loi
Pour montrer que \(f\) est une densité : on vérifie qu'elle est positive ou nulle, continue sauf en un nombre fini de points, et \(\int_{-\infty}^{+\infty} f(t)\,\mathrm{d}t = 1\) (cela fixe souvent une constante inconnue). La loi de la variable est alors caractérisée par \(f\), et sa fonction de répartition est \(F_X(x) = \int_{-\infty}^x f(t)\,\mathrm{d}t\). Compétences à pratiquer
- Démontrer qu'une fonction est une densité
I.2
Fonctions d'une variable à densité
Si \(X\) est à densité et \(g\) une fonction, \(g(X)\) est-elle encore à densité ? Pas toujours — il faut le vérifier. La voie fiable passe toujours par la fonction de répartition \(F_{g(X)}\), exprimée à l'aide de \(F_X\), puis dérivée. On traite d'abord le cas affine, où une formule nette en résulte.
Proposition — Transformée affine d'une variable à densité
Soit \(X\) une variable à densité de densité \(f_X\), et \(a \ne 0\), \(b \in \mathbb{R}\). Alors \(Y = aX + b\) est une variable à densité, de densité $$ f_Y : t \longmapsto \frac{1}{|a|}\, f_X\!\left(\frac{t - b}{a}\right). $$
On calcule \(F_Y(t) = P(aX + b \le t)\) selon le signe de \(a\).
- Si \(a > 0\) : \(aX + b \le t \iff X \le \frac{t-b}{a}\), donc \(F_Y(t) = F_X\!\left(\frac{t-b}{a}\right)\). En dérivant, \(f_Y(t) = \frac1a f_X\!\left(\frac{t-b}{a}\right)\).
- Si \(a < 0\) : \(aX + b \le t \iff X \ge \frac{t-b}{a}\), donc \(F_Y(t) = 1 - F_X\!\left(\frac{t-b}{a}\right)\) (pas d'atome). En dérivant, \(f_Y(t) = -\frac1a f_X\!\left(\frac{t-b}{a}\right)\).
Exemple
Soit \(X \sim \mathcal{E}(2)\) (la loi exponentielle, définie en Section~3 ; densité \(f_X(u) = 2e^{-2u}\) pour \(u \ge 0\) et \(0\) sinon). Déterminer une densité de \(Y = -2X + 3\).
Par la formule de transformée affine avec \(a = -2\), \(b = 3\), \(f_Y(t) = \frac{1}{2} f_X\!\left(\frac{t-3}{-2}\right) = \frac12 f_X\!\left(\frac{3-t}{2}\right)\). Or \(f_X(u) = 2e^{-2u}\) pour \(u \ge 0\) et \(0\) sinon ; ici \(u = \frac{3-t}{2} \ge 0 \iff t \le 3\). Donc $$ f_Y(t) = \begin{cases} \tfrac12 \cdot 2 e^{-2 \cdot \frac{3-t}{2}} = e^{-(3-t)} = e^{t-3} & \text{si } t \le 3, \\
0 & \text{si } t > 3. \end{cases} $$
Méthode — Montrer que \(Y \equal g(X)\) est à densité : les quatre étapes
- Fixer une densité de \(X\) et son image \(X(\Omega)\) ; en déduire \(Y(\Omega)\) pour savoir où \(F_Y\) vaut \(0\) ou \(1\) sans calcul.
- Exprimer \(F_Y(t) = P(g(X) \le t)\) à l'aide de \(F_X\), en résolvant l'inéquation \(g(X) \le t\) (attention au sens des inégalités).
- Étudier la continuité de \(F_Y\) sur \(\mathbb{R}\) et son caractère \(\mathcal{C}^1\) sauf en un nombre fini de points : conclure que \(Y\) est (ou non) à densité.
- Dériver \(F_Y\) là où c'est possible pour obtenir une densité de \(Y\) (valeurs positives arbitraires aux points exceptionnels).
Exemple
Soit \(X\) une variable à densité de densité \(f_X\). Montrer que \(Y = X^2\) est à densité et en donner une densité.
Ici \(Y = X^2 \ge 0\), donc \(F_Y(t) = 0\) pour \(t < 0\). Pour \(t \ge 0\), $$ \begin{aligned} F_Y(t) &= P(X^2 \le t) = P(-\sqrt t \le X \le \sqrt t) && \\
&= F_X(\sqrt t) - F_X(-\sqrt t). && \text{(pas d'atome)} \end{aligned} $$ \(F_Y\) est continue sur \(\mathbb{R}\) et \(\mathcal{C}^1\) sur \(\mathbb{R}^*\) sauf aux quelques points où \(F_X\) n'est pas \(\mathcal{C}^1\) (composée d'applications \(\mathcal{C}^1\), \(\sqrt{\ }\) étant \(\mathcal{C}^1\) sur \(]0,+\infty[\)), donc \(Y\) est à densité. En dérivant pour \(t > 0\), $$ f_Y(t) = \frac{1}{2\sqrt t}\bigl(f_X(\sqrt t) + f_X(-\sqrt t)\bigr), $$ et \(f_Y(t) = 0\) pour \(t \le 0\).
Exemple
Soit \(X\) une variable à densité et \(Y = e^X\). Montrer que \(Y\) est à densité et en donner une densité (l'application \(\varphi = \exp\) est \(\mathcal{C}^1\) strictement croissante).
Ici \(Y = e^X > 0\), donc \(F_Y(t) = 0\) pour \(t \le 0\). Pour \(t > 0\), comme \(\exp\) est croissante, \(e^X \le t \iff X \le \ln t\), donc \(F_Y(t) = F_X(\ln t)\). Ceci est continue et \(\mathcal{C}^1\) sur \(]0,+\infty[\) sauf aux quelques points \(e^c\) où \(F_X\) n'est pas \(\mathcal{C}^1\) (\(\ln\) y étant \(\mathcal{C}^1\)), donc \(Y\) est à densité, avec pour \(t > 0\) $$ f_Y(t) = f_X(\ln t) \cdot \frac1t, $$ et \(f_Y(t) = 0\) pour \(t \le 0\). (Pour une application \(\varphi\) \(\mathcal{C}^1\) strictement décroissante la même méthode donne \(f_Y(t) = f_X(\varphi^{-1}(t))\,|(\varphi^{-1})'(t)|\) pour \(t\) dans l'image \(\varphi(X(\Omega))\) et \(f_Y(t) = 0\) en dehors, la valeur absolue gérant le signe.)
Compétences à pratiquer
- Déterminer la densité d'une variable transformée
II
Espérance, variance et moments
II.1
Espérance et théorème de transfert
L'espérance discrète \(\sum_x x\, P(X = x)\) devient, pour une variable à densité, l'intégrale \(\int t\, f_X(t)\,\mathrm{d}t\). Avant les calculs, on rappelle les outils d'intégrales impropres de la première année utilisés partout : la convergence de \(\int_0^{+\infty} t^n e^{-\lambda t}\,\mathrm{d}t\) (intégration par parties), les critères de comparaison et de domination, et l'intégrale de Gauss \(\int_{-\infty}^{+\infty} e^{-x^2/2}\,\mathrm{d}x = \sqrt{2\pi}\) (admise, comme en première année).
Définition — Espérance d'une variable à densité
Soit \(X\) une variable à densité de densité \(f_X\). On dit que \(X\) admet une espérance lorsque \(\int_{-\infty}^{+\infty} t\, f_X(t)\,\mathrm{d}t\) converge absolument, et alors $$ E(X) = \int_{-\infty}^{+\infty} t\, f_X(t)\,\mathrm{d}t. $$ \(X\) est centrée lorsque \(E(X) = 0\). Exemple
Calculer \(E(X)\) pour \(X \sim \mathcal{E}(\lambda)\) (la loi exponentielle de la Section~3 ; densité \(\lambda e^{-\lambda t}\mathbf{1}_{t \ge 0}\), \(\lambda > 0\)).
L'intégrande \(t \lambda e^{-\lambda t}\) est positif sur \([0,+\infty[\), donc la convergence absolue est la convergence simple. Par intégration par parties (rappelée de la première année), $$ \begin{aligned} E(X) &= \int_0^{+\infty} t\, \lambda e^{-\lambda t}\,\mathrm{d}t \\
&= \Bigl[-t e^{-\lambda t}\Bigr]_0^{+\infty} + \int_0^{+\infty} e^{-\lambda t}\,\mathrm{d}t && \text{(parties)} \\
&= 0 + \frac1\lambda = \frac1\lambda. && \text{(}\int_0^{+\infty} e^{-\lambda t} = \tfrac1\lambda\text{)} \end{aligned} $$
Exemple
La loi de Cauchy (densité \(\frac{1}{\pi(1+t^2)}\)) n'a pas d'espérance : \(\int_{-\infty}^{+\infty} \frac{|t|}{\pi(1+t^2)}\,\mathrm{d}t\) diverge (l'intégrande se comporte comme \(\frac{1}{\pi|t|}\) à l'infini). Cela montre que la condition de convergence absolue est une vraie condition, non une formalité. Proposition — Opérations sur l'espérance
Soient \(X, Y\) des variables à densité admettant une espérance. - Linéarité : pour \(\lambda, \mu \in \mathbb{R}\), \(\lambda X + \mu Y\) admet une espérance et \(E(\lambda X + \mu Y) = \lambda E(X) + \mu E(Y)\).
- Croissance : si \(X \le Y\) et que les deux admettent une espérance, alors \(E(X) \le E(Y)\).
- Domination : si \(|X| \le Y\) et que \(Y\) admet une espérance, alors \(X\) admet une espérance.
- Une variable à densité bornée (c'est-à-dire d'image \(X(\Omega)\) bornée — il s'agit de la variable, non de la densité) admet une espérance.
Énoncé admis par le programme. (L'espérance est ici prise dans le cadre général admis : \(\lambda X + \mu Y\) n'est pas nécessairement à densité, mais son espérance est bien définie et la règle vaut.)
Théorème — Théorème de transfert
Soit \(X\) une variable à densité de densité \(f_X\), et \(\varphi\) une fonction continue sur \(\mathbb{R}\) sauf en un nombre fini de points. Alors \(\varphi(X)\) admet une espérance si et seulement si \(\int_{-\infty}^{+\infty} \varphi(t) f_X(t)\,\mathrm{d}t\) converge absolument, et dans ce cas $$ E(\varphi(X)) = \int_{-\infty}^{+\infty} \varphi(t)\, f_X(t)\,\mathrm{d}t $$ (l'intégrande s'annule là où \(f_X = 0\), donc en pratique l'intégrale porte sur l'intervalle où \(f_X \ne 0\)).
Énoncé admis. Le programme déclare cette démonstration non exigible (même lorsque \(\varphi\) est \(\mathcal{C}^1\) strictement monotone) ; on l'admet et on l'utilise librement.
Proposition — Espérance d'une transformée affine
Si \(X\) admet une espérance, alors pour tous \(a, b \in \mathbb{R}\), \(aX + b\) admet une espérance et \(E(aX + b) = a E(X) + b\).
On applique le théorème de transfert avec \(\varphi(t) = at + b\). La convergence absolue tient car $$ |(at + b) f_X(t)| \le |a|\, |t| f_X(t) + |b|\, f_X(t), $$ et \(\int |t(t)|\,\mathrm{d}t f_X\) converge (\(X\) a une espérance) tandis que \(\int f_X = 1\) ; par comparaison \(\int (at+b(t))\,\mathrm{d}t f_X\) converge absolument. Puis, par linéarité de l'intégrale, $$ E(aX + b) = \int_{-\infty}^{+\infty}(at+b) f_X(t)\,\mathrm{d}t = a\int t f_X(t)\,\mathrm{d}t + b\int f_X(t)\,\mathrm{d}t = aE(X) + b. $$
Méthode — Calculer une espérance
Pour calculer \(E(X)\) : intégrer \(\int t f_X(t)\,\mathrm{d}t\). Pour calculer \(E(\varphi(X))\) : utiliser le théorème de transfert, \(\int \varphi(t) f_X(t)\,\mathrm{d}t\). Dans les deux cas, justifier d'abord la convergence absolue de l'intégrale (impropre), puis la calculer avec les outils de première année (parties, changement de variable, intégrales connues). Compétences à pratiquer
- Calculer une espérance
II.2
Variance et moments
La variance mesure la dispersion de \(X\) autour de sa moyenne, définie comme dans le cas discret par l'espérance de \((X - E(X))^2\). Comme là, la formule de Koenig–Huygens la rend calculable à partir des deux moments \(E(X)\) et \(E(X^2)\).
Définition — Moment d'ordre \(r\) ; variance
Soit \(X\) une variable à densité et \(r \in \mathbb{N}^*\). \(X\) admet un moment d'ordre \(r\) lorsque \(X^r\) admet une espérance, c'est-à-dire lorsque \(\int_{-\infty}^{+\infty} t^r f_X(t)\,\mathrm{d}t\) converge absolument ; alors \(m_r(X) = E(X^r)\). en supposant que \(X\) admet une espérance, \(X\) admet une variance lorsque \((X - E(X))^2\) admet une espérance, et alors $$ V(X) = E\bigl((X - E(X))^2\bigr) = \int_{-\infty}^{+\infty} (t - E(X))^2 f_X(t)\,\mathrm{d}t $$ (la forme intégrale par le théorème de transfert). Proposition — Formule de Koenig–Huygens
Soit \(X\) une variable à densité admettant une espérance. Alors \(X\) admet une variance si et seulement si \(X\) admet un moment d'ordre \(2\), et dans ce cas $$ V(X) = E(X^2) - E(X)^2. $$
L'équivalence (variance existe \(\iff\) \(E(X^2)\) existe) est admise. Lorsque les deux existent, on développe par le théorème de transfert et la linéarité : $$ \begin{aligned} V(X) &= E\bigl((X - E(X))^2\bigr) \\
&= E\bigl(X^2 - 2E(X) X + E(X)^2\bigr) && \text{(développement)} \\
&= E(X^2) - 2E(X) E(X) + E(X)^2 && \text{(linéarité)} \\
&= E(X^2) - E(X)^2. && \end{aligned} $$
Proposition — Variance d'une transformée affine ; positivité
Soit \(X\) admettant une variance et \(a, b \in \mathbb{R}\). Alors \(aX + b\) admet une variance, avec \(V(aX + b) = a^2 V(X)\), et \(V(X) \ge 0\).
\(V(X) = \int (t - E(X))^2 f_X(t)\,\mathrm{d}t \ge 0\) par positivité de l'intégrale (l'intégrande est \(\ge 0\)). Pour la transformée affine, \(E(aX+b) = aE(X)+b\), donc $$ \begin{aligned} V(aX + b) &= E\bigl((aX + b - aE(X) - b)^2\bigr) && \\
&= E\bigl(a^2 (X - E(X))^2\bigr) = a^2 V(X). && \text{(linéarité)} \end{aligned} $$
Définition — Écart-type ; variable centrée réduite
Lorsque \(X\) admet une variance, son écart-type est \(\sigma(X) = \sqrt{V(X)}\). Lorsque de plus \(\sigma(X) > 0\), la variable \(X^* = \dfrac{X - E(X)}{\sigma(X)}\) est centrée réduite : \(E(X^*) = 0\) et \(V(X^*) = 1\). Méthode — Calculer une variance
Préférer la formule de Koenig–Huygens \(V(X) = E(X^2) - E(X)^2\) : calculer \(E(X)\) et \(E(X^2)\) (ce dernier par le théorème de transfert avec \(\varphi(t) = t^2\)), puis soustraire. Justifier d'abord l'existence du moment d'ordre \(2\). Exemple
Calculer \(V(X)\) pour \(X \sim \mathcal{E}(\lambda)\).
Par le théorème de transfert et deux intégrations par parties, \(E(X^2) = \int_0^{+\infty} t^2 \lambda e^{-\lambda t}\,\mathrm{d}t = \dfrac{2}{\lambda^2}\). Avec \(E(X) = \dfrac1\lambda\), Koenig–Huygens donne $$ V(X) = E(X^2) - E(X)^2 = \frac{2}{\lambda^2} - \frac{1}{\lambda^2} = \frac{1}{\lambda^2}. $$
Compétences à pratiquer
- Calculer une variance
III
Lois usuelles à densité
III.1
Lois uniforme et exponentielle
On rencontre les trois lois continues de référence. Les deux plus simples : la loi uniforme, équiprobabilité sur un intervalle ; et la loi exponentielle, durée de vie continue, remarquable par son absence de mémoire.
Définition — Loi uniforme
Pour \(a < b\), \(X\) suit la loi uniforme sur \([a,b]\), notée \(X \sim \mathcal{U}([a,b])\), lorsqu'elle a pour densité $$ f(t) = \frac{1}{b-a}\mathbf{1}_{[a,b]}(t). $$ Proposition — Loi uniforme : fonction de répartition, espérance, variance
Pour \(X \sim \mathcal{U}([a,b])\) : \(F_X(x) = 0\) pour \(x < a\), \(\dfrac{x-a}{b-a}\) pour \(a \le x \le b\), et \(1\) pour \(x > b\) ; et $$ E(X) = \frac{a+b}{2}, \qquad V(X) = \frac{(b-a)^2}{12}. $$
La fonction de répartition est \(\int_{-\infty}^x f(t)\,\mathrm{d}t\), donnant la formule affine par morceaux. Pour les moments, $$ \begin{aligned} E(X) &= \int_a^b \frac{t}{b-a}\,\mathrm{d}t = \frac{1}{b-a}\cdot\frac{b^2 - a^2}{2} = \frac{a+b}{2}, \\
E(X^2) &= \int_a^b \frac{t^2}{b-a}\,\mathrm{d}t = \frac{b^3 - a^3}{3(b-a)} = \frac{a^2 + ab + b^2}{3}. \end{aligned} $$ Par Koenig–Huygens, \(V(X) = \dfrac{a^2+ab+b^2}{3} - \dfrac{(a+b)^2}{4} = \dfrac{(b-a)^2}{12}\). 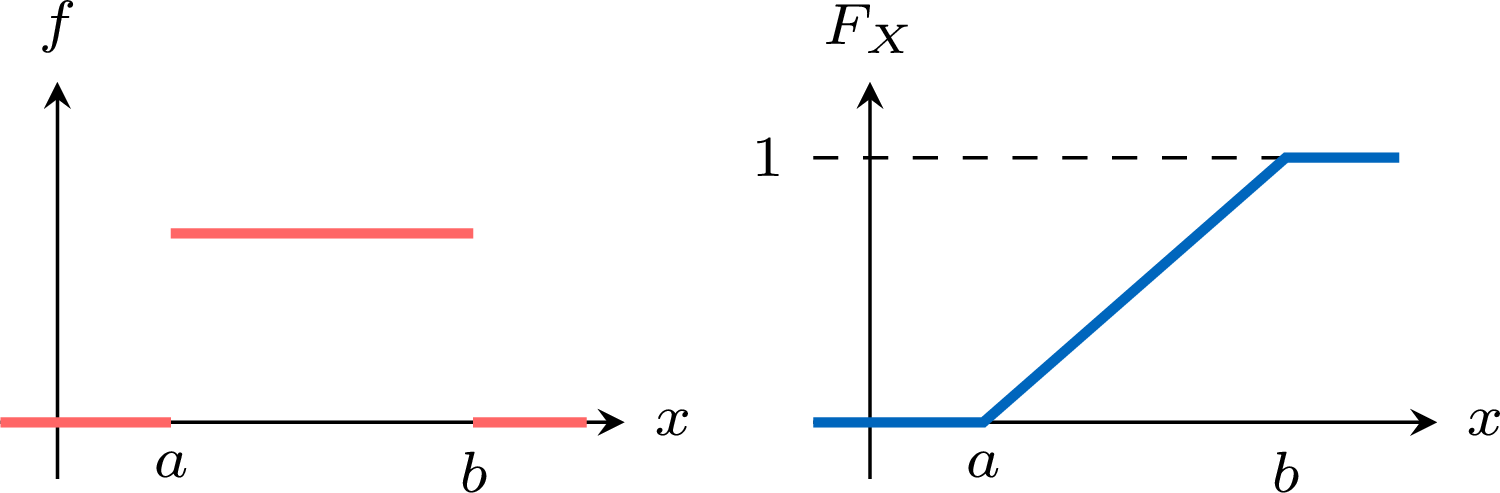
Proposition — De l'uniforme unité à l'uniforme générale
Pour \(a < b\) : \(X \sim \mathcal{U}([0,1]) \iff a + (b-a)X \sim \mathcal{U}([a,b])\). Exemple
Soit \(X \sim \mathcal{U}([2,6])\). Donner \(E(X)\), \(V(X)\) et \(P(3 \le X \le 5)\).
\(E(X) = \frac{2+6}{2} = 4\), \(V(X) = \frac{(6-2)^2}{12} = \frac{16}{12} = \frac43\), et \(P(3 \le X \le 5) = \int_3^5 \frac{1}{4}\,\mathrm{d}t = \frac{5-3}{4} = \frac12\).
Définition — Loi exponentielle
Pour \(\lambda > 0\), \(X\) suit la loi exponentielle de paramètre \(\lambda\), notée \(X \sim \mathcal{E}(\lambda)\), lorsqu'elle a pour densité $$ f(t) = \begin{cases} 0 & \text{si } t < 0, \\
\lambda e^{-\lambda t} & \text{si } t \ge 0. \end{cases} $$ Proposition — Loi exponentielle : fonction de répartition, espérance, variance
Pour \(X \sim \mathcal{E}(\lambda)\) : \(F_X(x) = 0\) pour \(x < 0\) et \(F_X(x) = 1 - e^{-\lambda x}\) pour \(x \ge 0\) ; et \(E(X) = \dfrac1\lambda\), \(V(X) = \dfrac1{\lambda^2}\).
Pour \(x \ge 0\), \(F_X(x) = \int_0^x \lambda e^{-\lambda t}\,\mathrm{d}t = 1 - e^{-\lambda x}\). L'espérance \(E(X) = \frac1\lambda\) et la variance \(V(X) = \frac1{\lambda^2}\) ont été calculées en Section~2 (espérance) et juste au-dessus (variance, via \(E(X^2) = \frac2{\lambda^2}\) et Koenig–Huygens). 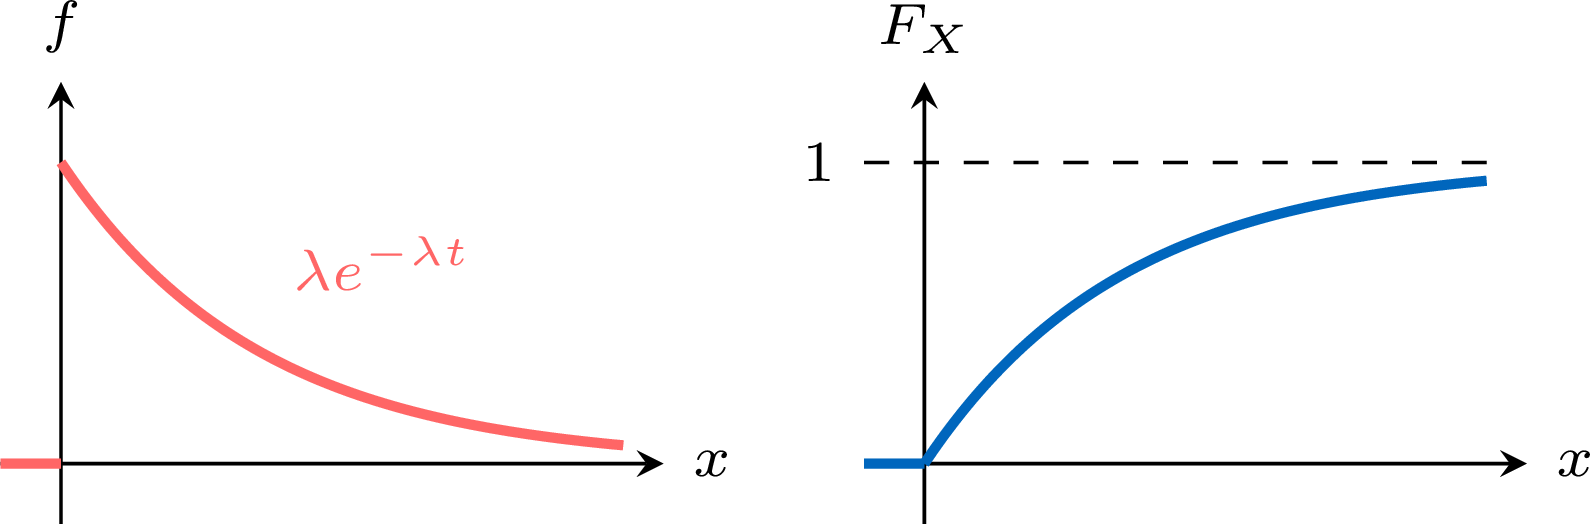
Théorème — Absence de mémoire de la loi exponentielle
Soit \(X \sim \mathcal{E}(\lambda)\). Pour tous \(s, t \ge 0\), $$ P(X > s + t \mid X > s) = P(X > t). $$
Pour \(u \ge 0\), \(P(X > u) = 1 - F_X(u) = e^{-\lambda u}\). Comme \([X > s+t] \subset [X > s]\), $$ \begin{aligned} P(X > s+t \mid X > s) &= \frac{P(X > s + t)}{P(X > s)} && \text{(probabilité conditionnelle)} \\
&= \frac{e^{-\lambda(s+t)}}{e^{-\lambda s}} = e^{-\lambda t} = P(X > t). && \end{aligned} $$
L'exponentielle est l'analogue continu de la loi géométrique : un temps d'attente sans mémoire. « Avoir déjà attendu \(s\) » ne renseigne en rien sur l'attente restante.
Exemple
La durée de vie \(X\) (en années) d'un composant suit \(\mathcal{E}(\tfrac12)\). Calculer la probabilité qu'il dure plus de \(3\) ans.
\(P(X > 3) = 1 - F_X(3) = e^{-\frac12 \cdot 3} = e^{-3/2} \approx 0{,}223\). (Sa durée de vie moyenne est \(E(X) = 1/\tfrac12 = 2\) ans.)
Compétences à pratiquer
- Manipuler les lois uniforme et exponentielle
III.2
La loi normale
La loi normale (ou de Gauss) est la loi continue la plus importante : c'est la limite universelle des sommes de variables indépendantes (le théorème central limite d'un chapitre ultérieur). Toute probabilité normale se ramène, par centrage-réduction, à la fonction de répartition \(\Phi\) de la normale centrée réduite, lue dans une table.
Définition — Loi normale
Pour \(\mu \in \mathbb{R}\) et \(\sigma > 0\), \(X\) suit la loi normale de paramètres \((\mu, \sigma^2)\), notée \(X \sim \mathcal{N}(\mu, \sigma^2)\), lorsqu'elle a pour densité $$ \varphi(t) = \frac{1}{\sigma\sqrt{2\pi}}\, e^{-\frac12\left(\frac{t-\mu}{\sigma}\right)^2}. $$
C'est bien une densité : le changement de variable \(u = \frac{t-\mu}{\sigma}\) transforme \(\int_{\mathbb{R}} \varphi\) en \(\frac{1}{\sqrt{2\pi}}\int_{\mathbb{R}} e^{-u^2/2}\,\mathrm{d}u = 1\), par l'intégrale de Gauss \(\int_{\mathbb{R}} e^{-u^2/2} = \sqrt{2\pi}\) (admise, rappelée de la première année).
Exemple
La densité \(\mathcal{N}(\mu, \sigma^2)\) est une courbe en cloche, symétrique autour de son centre \(\mu\) (où elle est maximale), de largeur réglée par \(\sigma\) : un petit \(\sigma\) donne une cloche haute et étroite, un grand \(\sigma\) une cloche basse et large. Pour \(\mathcal{N}(0,1)\) la valeur au sommet est \(\frac{1}{\sqrt{2\pi}} \approx 0{,}399\) en \(t = 0\). 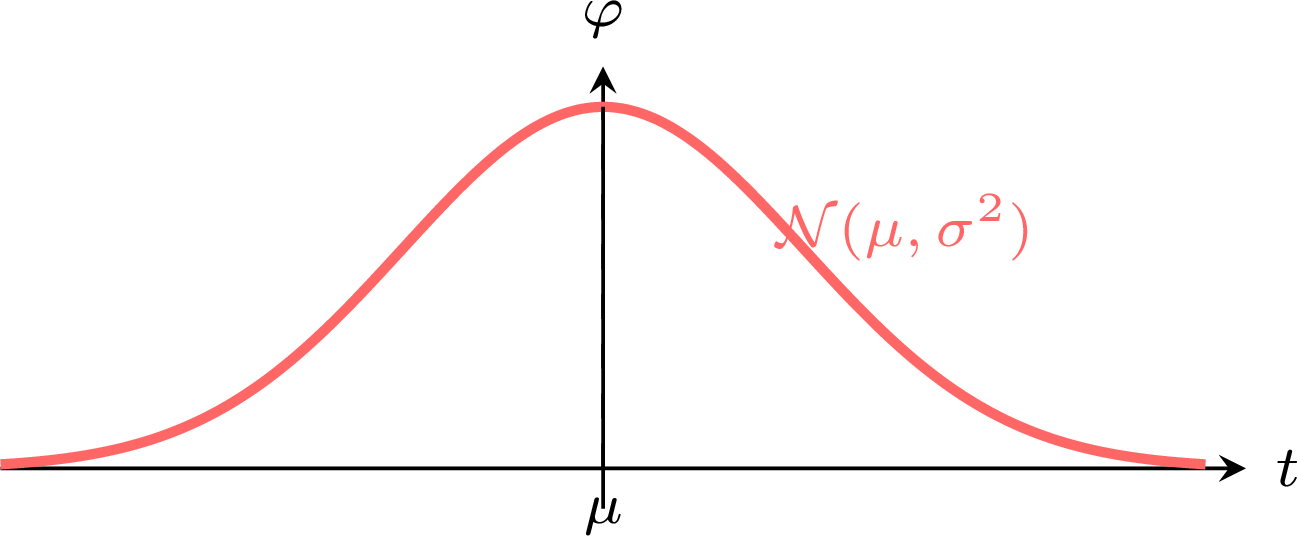
Définition — Loi normale centrée réduite et \(\Phi\)
\(\mathcal{N}(0,1)\) est la loi normale centrée réduite, de densité \(\frac{1}{\sqrt{2\pi}} e^{-t^2/2}\) et de fonction de répartition $$ \Phi(x) = \frac{1}{\sqrt{2\pi}}\int_{-\infty}^x e^{-t^2/2}\,\mathrm{d}t, $$ qui n'a pas d'expression close avec les fonctions usuelles (elle est donc tabulée). Théorème — Transformée affine et centrage-réduction
Soit \(X \sim \mathcal{N}(\mu, \sigma^2)\) et \(a \ne 0\), \(b \in \mathbb{R}\). Alors \(aX + b \sim \mathcal{N}(a\mu + b, a^2\sigma^2)\). En particulier, $$ \frac{X - \mu}{\sigma} \sim \mathcal{N}(0, 1). $$
Par la formule de transformée affine de la Section~1, \(Y = aX + b\) a pour densité \(\frac{1}{|a|}\varphi\!\left(\frac{t-b}{a}\right)\) où \(\varphi\) est la densité \(\mathcal{N}(\mu,\sigma^2)\). En substituant et simplifiant l'exposant on obtient exactement la densité \(\mathcal{N}(a\mu + b, a^2\sigma^2)\). En prenant \(a = \frac1\sigma\), \(b = -\frac\mu\sigma\) on obtient \(\frac{X-\mu}\sigma \sim \mathcal{N}(0,1)\).
Proposition — Espérance et variance de la loi normale
Pour \(X \sim \mathcal{N}(\mu, \sigma^2)\) : \(E(X) = \mu\) et \(V(X) = \sigma^2\).
D'abord le cas centré réduit \(Z \sim \mathcal{N}(0,1)\). L'intégrale \(\int_{\mathbb{R}} |t| e^{-t^2/2}\,\mathrm{d}t = 2\int_0^{+\infty} t e^{-t^2/2}\,\mathrm{d}t = 2\) converge, donc \(Z\) a une espérance ; la densité \(\frac{1}{\sqrt{2\pi}} e^{-t^2/2}\) étant paire, \(t \mapsto t\, e^{-t^2/2}\) est impaire, d'où \(E(Z) = \frac{1}{\sqrt{2\pi}}\int_{\mathbb{R}} t e^{-t^2/2}\,\mathrm{d}t = 0\). Pour \(V(Z) = E(Z^2)\), une intégration par parties (\(u = t\), \(v' = t e^{-t^2/2}\)) : $$ \begin{aligned} E(Z^2) &= \frac{1}{\sqrt{2\pi}}\int_{\mathbb{R}} t^2 e^{-t^2/2}\,\mathrm{d}t \\
&= \frac{1}{\sqrt{2\pi}}\left(\Bigl[-t e^{-t^2/2}\Bigr]_{-\infty}^{+\infty} + \int_{\mathbb{R}} e^{-t^2/2}\,\mathrm{d}t\right) && \text{(parties)} \\
&= \frac{1}{\sqrt{2\pi}}\bigl(0 + \sqrt{2\pi}\bigr) = 1. && \text{(intégrale de Gauss)} \end{aligned} $$ Donc \(E(Z) = 0\), \(V(Z) = 1\). En général \(X = \sigma Z + \mu\) (par le théorème de centrage-réduction ci-dessus, dont la preuve ne repose que sur la formule de transformée affine de la Section~1, non sur cette Proposition), donc \(E(X) = \sigma \cdot 0 + \mu = \mu\) et \(V(X) = \sigma^2 V(Z) = \sigma^2\).
Proposition — Symétrie de \(\Phi\)
Pour tout \(x \in \mathbb{R}\), \(\Phi(-x) = 1 - \Phi(x)\) ; en particulier \(\Phi(0) = \tfrac12\).
La densité \(t \mapsto \frac{1}{\sqrt{2\pi}}e^{-t^2/2}\) est paire, donc par le changement de variable \(u = -t\), $$ \Phi(-x) = \frac{1}{\sqrt{2\pi}}\int_{-\infty}^{-x} e^{-t^2/2}\,\mathrm{d}t = \frac{1}{\sqrt{2\pi}}\int_x^{+\infty} e^{-u^2/2}\,\mathrm{d}u = P(Z > x) = 1 - \Phi(x). $$ En posant \(x = 0\) on a \(\Phi(0) = 1 - \Phi(0)\), donc \(\Phi(0) = \tfrac12\). 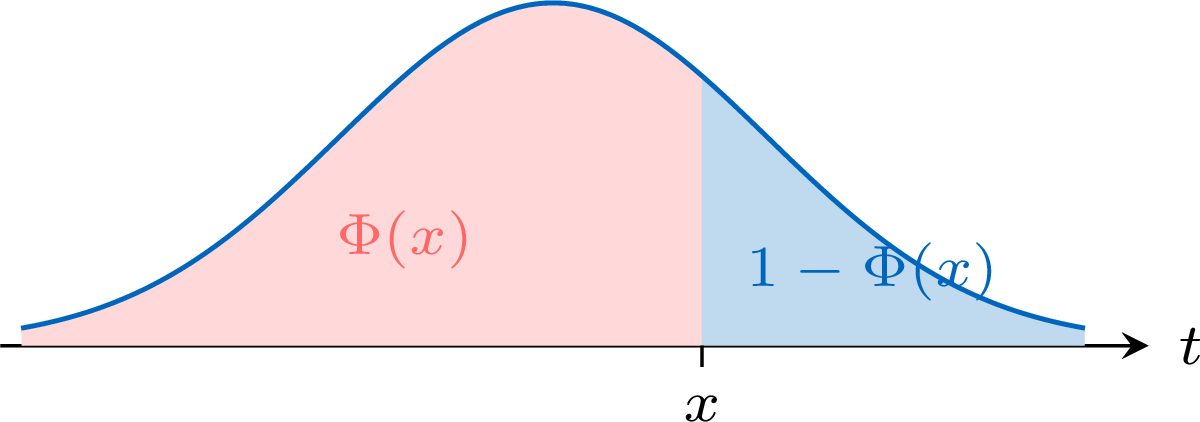
Exemple
Soit \(Z \sim \mathcal{N}(0,1)\). À l'aide de \(\Phi(1) \approx 0{,}8413\), calculer \(P(Z \le 1)\), \(P(Z > 1)\) et \(P(-1 \le Z \le 1)\).
\(P(Z \le 1) = \Phi(1) \approx 0{,}8413\) ; \(P(Z > 1) = 1 - \Phi(1) \approx 0{,}1587\) ; et $$ P(-1 \le Z \le 1) = \Phi(1) - \Phi(-1) = \Phi(1) - (1 - \Phi(1)) = 2\Phi(1) - 1 \approx 0{,}6826. $$
Méthode — Calculer une probabilité normale avec la table
Pour calculer \(P(a \le X \le b)\) pour \(X \sim \mathcal{N}(\mu, \sigma^2)\) : centrer-réduire avec \(Z = \frac{X-\mu}\sigma \sim \mathcal{N}(0,1)\), écrire \(P(a \le X \le b) = \Phi\!\left(\frac{b-\mu}\sigma\right) - \Phi\!\left(\frac{a-\mu}\sigma\right)\), puis lire \(\Phi\) dans la table, en utilisant \(\Phi(-x) = 1 - \Phi(x)\) pour les arguments négatifs. Exemple
Soit \(X \sim \mathcal{N}(3, \tfrac14)\) (donc \(\mu = 3\), \(\sigma = \tfrac12\)). À l'aide de \(\Phi(2) \approx 0{,}9772\), donner une valeur approchée de \(P(2 \le X \le 4)\).
On centre-réduit : \(Z = \frac{X - 3}{1/2} = 2(X-3) \sim \mathcal{N}(0,1)\). Alors $$ \begin{aligned} P(2 \le X \le 4) &= \Phi\!\left(\tfrac{4-3}{1/2}\right) - \Phi\!\left(\tfrac{2-3}{1/2}\right) = \Phi(2) - \Phi(-2) \\
&= \Phi(2) - (1 - \Phi(2)) = 2\Phi(2) - 1 \\
&\approx 2(0{,}9772) - 1 = 0{,}9544. \end{aligned} $$
Exemple
Une machine remplit des sacs dont le poids \(X\) (en grammes) suit \(\mathcal{N}(500, 100)\) (donc \(\sigma = 10\)). À l'aide de \(\Phi(1) \approx 0{,}8413\) et \(\Phi(1{,}5) \approx 0{,}9332\), déterminer la probabilité qu'un sac pèse entre \(490\) et \(515\) grammes.
On centre-réduit : \(Z = \frac{X - 500}{10}\). Les bornes deviennent \(\frac{490 - 500}{10} = -1\) et \(\frac{515 - 500}{10} = 1{,}5\), donc $$ \begin{aligned} P(490 \le X \le 515) &= \Phi(1{,}5) - \Phi(-1) = \Phi(1{,}5) - (1 - \Phi(1)) \\
&\approx 0{,}9332 - (1 - 0{,}8413) = 0{,}7745. \end{aligned} $$
Méthode — Python — simuler les lois usuelles
Le sous-module numpy.random simule les lois usuelles. Attention aux conventions de paramètre : l'exponentielle prend \(1/\lambda\) (la moyenne), et la normale prend \(\sigma\) (non \(\sigma^2\)). On peut aussi simuler par la méthode d'inversion : si \(U \sim \mathcal{U}([0,1])\) et \(F\) est continue strictement croissante, alors \(X = F^{-1}(U)\) a pour fonction de répartition \(F\). Pour l'exponentielle cela donne la relation \(X = -\frac1\lambda\ln(1-U) \sim \mathcal{E}(\lambda)\) que le programme demande de connaître. \begin{verbatim} import numpy.random as rd U = rd.random() # uniforme sur [0,1] E = rd.exponential(1/2) # exponentielle E(2) : argument 1/lambda N = rd.normal(3, 0.5) # normale N(3, 0.25) : argument sigma, pas sigma^2 # methode d'inversion pour l'exponentielle E(lambda) : import numpy as np lam = 2 X = -np.log(1 - rd.random()) / lam \end{verbatim}
Pour aller plus loin
Les variables à densité sont au fondement de l'étude des suites et de la convergence de variables aléatoires des chapitres suivants, où le théorème central limite fait de la loi normale la limite universelle des sommes centrées réduites — la raison de son nom « normale ». Elles sont aussi le modèle continu utilisé tout au long de l'estimation et des intervalles de confiance en fin de ce cours.
Compétences à pratiquer
- Calculer avec la loi normale
IV
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section