Éducation Nationale Française · ECGappliquées
Statistiques univariées
La statistique descriptive résume un ensemble d'observations — les revenus d'un panel de ménages, les ventes quotidiennes d'un magasin, le nombre d'enfants par famille — par quelques nombres et graphiques : où les données sont centrées (moyenne, médiane), à quel point elles sont dispersées (étendue, variance), comment elles se répartissent (fréquences, quantiles, boîte à moustaches). C'est la première étape de toute analyse de données, avant la statistique inférentielle — tirer des conclusions sur une population entière à partir d'un échantillon — étudiée plus tard. La plupart du vocabulaire a été vu au lycée ; il est ici fixé précisément et étendu par la variance et la formule de König.
Cadre. Une variable statistique peut être qualitative ou quantitative (discrète ou continue) ; dans ce chapitre tous les indicateurs calculés (fréquences, quantiles, moyenne, variance) portent sur une série quantitative discrète — une liste finie d'observations numériques. Le symbole \(\sum\) et ses règles sont ceux du chapitre Méthodes de calcul, rappelés mais non redémontrés.
Cadre. Une variable statistique peut être qualitative ou quantitative (discrète ou continue) ; dans ce chapitre tous les indicateurs calculés (fréquences, quantiles, moyenne, variance) portent sur une série quantitative discrète — une liste finie d'observations numériques. Le symbole \(\sum\) et ses règles sont ceux du chapitre Méthodes de calcul, rappelés mais non redémontrés.
I
Série statistique et vocabulaire
Une étude statistique commence par nommer ce que l'on observe et sur qui. La population est l'ensemble de tous les individus étudiés, un échantillon en est une partie effectivement observée, et la variable statistique est le caractère relevé sur chaque individu. Les valeurs observées, listées, forment la série statistique.
Définition — Population, échantillon, variable statistique
La population est l'ensemble de tous les individus étudiés ; un échantillon en est une partie finie sur laquelle on fait effectivement les observations. La variable statistique est le caractère relevé sur chaque individu. Elle est : - qualitative si ses valeurs sont des catégories (couleur des yeux, secteur d'activité) ;
- quantitative si ses valeurs sont des nombres, soit discrète (valeurs isolées : nombre d'enfants), soit continue (toute valeur d'un intervalle : taille).
Définition — Série statistique
Une série statistique de taille \(n\) est le \(n\)-uplet \((x_1, x_2, \dots, x_n)\) des valeurs prises par la variable sur les \(n\) individus de l'échantillon. Les valeurs distinctes sont notées \(v_1 < v_2 < \dots < v_p\), et \(n_k\) est l'effectif de \(v_k\) (le nombre d'individus prenant la valeur \(v_k\)), de sorte que \(n_1 + n_2 + \dots + n_p = n\). Les indicateurs descriptifs de ce chapitre ne dépendent que des valeurs et de leurs effectifs, pas de l'ordre dans lequel les observations ont été recueillies (ils sont inchangés par une permutation des \(x_i\)). Exemple
Une enquête relève le nombre d'enfants dans \(n = 10\) familles : $$0, 1, 1, 2, 2, 2, 3, 3, 4, 5.$$ La variable « nombre d'enfants » est quantitative discrète. Ses valeurs distinctes et effectifs sont \(v_1 = 0\) (\(n_1 = 1\)), \(v_2 = 1\) (\(n_2 = 2\)), \(v_3 = 2\) (\(n_3 = 3\)), \(v_4 = 3\) (\(n_4 = 2\)), \(v_5 = 4\) (\(n_5 = 1\)), \(v_6 = 5\) (\(n_6 = 1\)) ; les effectifs somment à \(10 = n\). Cette série est l'exemple fil rouge du chapitre. Méthode — Mettre en place une étude statistique
Identifier, dans l'ordre : la population (qui est étudié), l'échantillon (qui est observé), la variable (ce qui est relevé) et son type. Pour une variable quantitative discrète, organiser les données en un tableau des valeurs distinctes \(v_k\) avec leurs effectifs \(n_k\) — tout indicateur ci-dessous se lit ou se calcule à partir de ce tableau. Le résumé descriptif vient d'abord ; les conclusions inférentielles sur la population entière viennent ensuite. Compétences à pratiquer
- Lire une série statistique
II
Fréquences et fonction de répartition
Les effectifs deviennent comparables entre échantillons de tailles différentes une fois transformés en fréquences (proportions). Les cumuler donne la fonction de répartition empirique, d'où se lisent les quantiles — médiane, quartiles — puis la boîte à moustaches, résumé visuel compact.
Définition — Effectif, fréquence, fréquence cumulée
Pour une valeur \(v_k\) de la série, son effectif est \(n_k\), sa fréquence est \(f_k = \dfrac{n_k}{n}\) (une proportion de \([0, 1]\), avec \(\sum_k f_k = 1\)), et sa fréquence cumulée est $$F_k = f_1 + f_2 + \dots + f_k = \sum_{j=1}^{k} f_j,$$ la proportion d'observations dont la valeur est au plus \(v_k\). Exemple
Pour la série fil rouge, le tableau des fréquences et fréquences cumulées est $$\begin{array}{c|cccccc} v_k & 0 & 1 & 2 & 3 & 4 & 5 \\
\hline n_k & 1 & 2 & 3 & 2 & 1 & 1 \\
f_k & 0{,}1 & 0{,}2 & 0{,}3 & 0{,}2 & 0{,}1 & 0{,}1 \\
F_k & 0{,}1 & 0{,}3 & 0{,}6 & 0{,}8 & 0{,}9 & 1{,}0 \end{array}$$ Les fréquences cumulées croissent de \(0{,}1\) à \(1\), comme elles le doivent. Les représenter en fonction des valeurs donne le diagramme des fréquences cumulées ci-dessous, un graphe en escalier croissant (point plein là où chaque palier est atteint, point creux là où le saut suivant commence) ; en lire les quantiles est l'objet de la définition suivante. 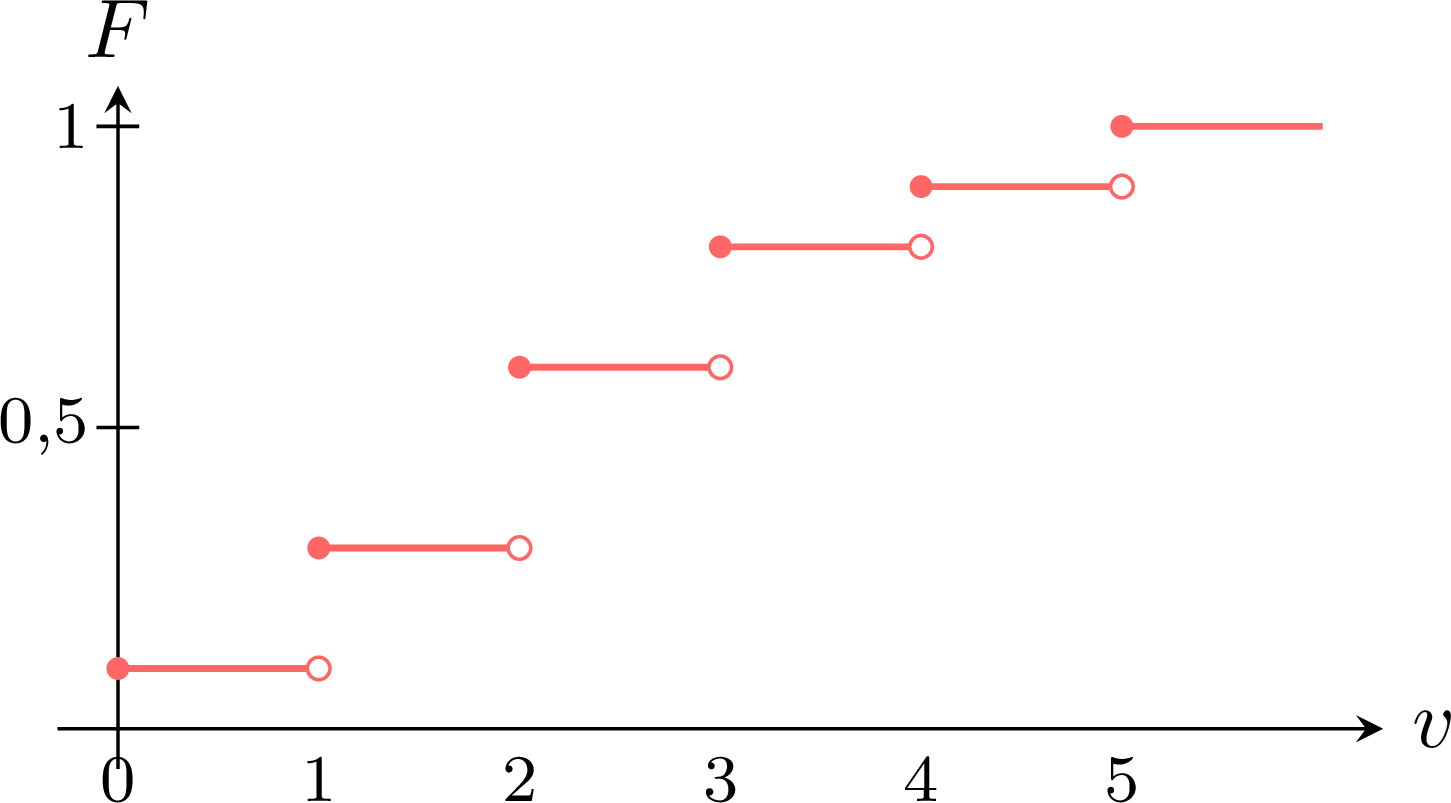
Définition — Fonction de répartition et quantiles
La fonction de répartition empirique de la série est la fonction \(F\) définie sur \(\mathbb{R}\) par $$F(x) = \text{proportion d'observations} \le x,$$ une fonction en escalier croissante allant de \(0\) à \(1\). Pour \(\alpha \in \mathopen]0, 1\mathclose[\), le quantile d'ordre \(\alpha\) est la plus petite valeur \(x\) de la série telle que \(F(x) \ge \alpha\). En particulier la médiane est le quantile d'ordre \(\tfrac{1}{2}\), le premier quartile \(Q_1\) celui d'ordre \(\tfrac{1}{4}\), et le troisième quartile \(Q_3\) celui d'ordre \(\tfrac{3}{4}\). On fixe ainsi la convention du chapitre : chaque quantile est une valeur effective de la série, ce qui diffère de l'habitude du lycée consistant à moyenner les deux observations centrales pour un échantillon de taille paire (et de l'interpolation linéaire utilisée par défaut en Python). Exemple
Lire la médiane et les quartiles de la série fil rouge à partir de ses fréquences cumulées.
À l'aide des fréquences cumulées \(F(0) = 0{,}1\), \(F(1) = 0{,}3\), \(F(2) = 0{,}6\), \(F(3) = 0{,}8\) :
- médiane (ordre \(0{,}5\)) : la plus petite valeur avec \(F \ge 0{,}5\) est \(2\) (car \(F(1) = 0{,}3 < 0{,}5 \le 0{,}6 = F(2)\)), donc \(\mathrm{med} = 2\) ;
- \(Q_1\) (ordre \(0{,}25\)) : la plus petite valeur avec \(F \ge 0{,}25\) est \(1\) (\(F(0) = 0{,}1 < 0{,}25 \le 0{,}3 = F(1)\)), donc \(Q_1 = 1\) ;
- \(Q_3\) (ordre \(0{,}75\)) : la plus petite valeur avec \(F \ge 0{,}75\) est \(3\) (\(F(2) = 0{,}6 < 0{,}75 \le 0{,}8 = F(3)\)), donc \(Q_3 = 3\).
Méthode — Construire et lire le résumé en cinq nombres
Le résumé en cinq nombres d'une série est \((\min, Q_1, \mathrm{med}, Q_3, \max)\). La boîte à moustaches dessine une boîte de \(Q_1\) à \(Q_3\) avec la médiane marquée à l'intérieur, et des moustaches s'étendant jusqu'au minimum et au maximum. Elle montre d'un coup d'œil le centre (médiane), le gros des données (la boîte, qui s'étend sur la partie centrale des données de \(Q_1\) à \(Q_3\)), et l'étendue globale (les moustaches). En Python, numpy.median et numpy.quantile calculent des valeurs analogues — mais avec une convention différente : sur une série de taille paire numpy.median moyenne les deux observations centrales, et numpy.quantile interpole linéairement entre observations consécutives, de sorte qu'ils ne renvoient pas nécessairement une valeur effectivement présente dans la série, contrairement à la convention « plus petit \(x\) tel que \(F(x) \ge \alpha\) » utilisée ici. 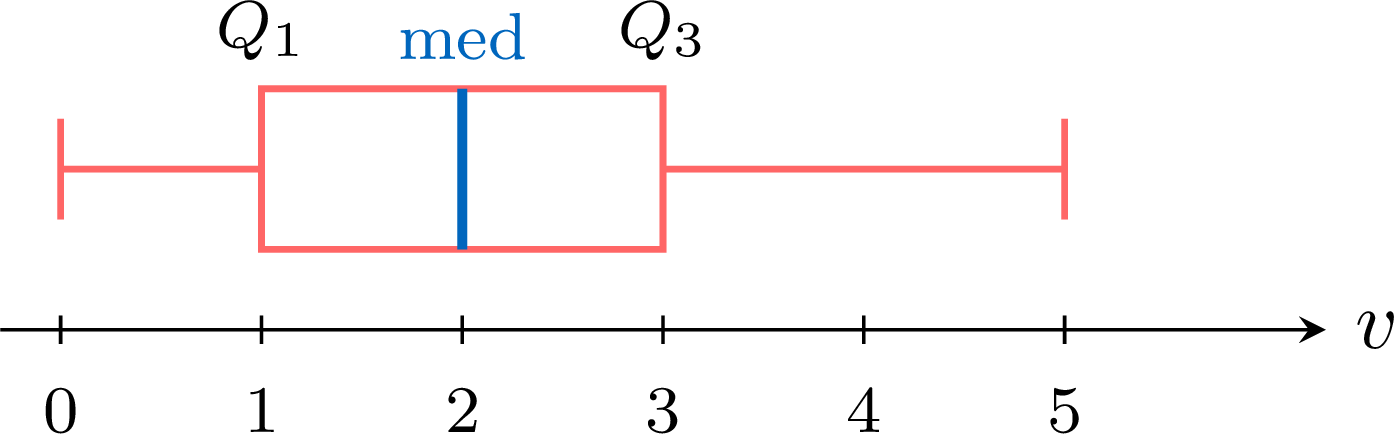
Compétences à pratiquer
- Calculer fréquences et quantiles
III
Tendance centrale
Deux nombres situent le « centre » d'une série : la moyenne, qui équilibre les valeurs, et la médiane, qui partage l'effectif en deux. Elles répondent autrement à la même question, et réagissent différemment aux valeurs extrêmes — un contraste que les mesures de dispersion de la section suivante précisent.
Définition — Moyenne d'une série
La moyenne d'une série \((x_1, \dots, x_n)\) est $$\bar{x} = \frac{1}{n} \sum_{i=1}^{n} x_i = \sum_{k=1}^{p} f_k v_k,$$ la deuxième forme sommant sur les valeurs distinctes \(v_k\) pondérées par leurs fréquences \(f_k\). La médiane est le quantile d'ordre \(\tfrac{1}{2}\) défini à la section précédente : la plus petite valeur à laquelle la proportion d'observations qui ne la dépassent pas atteint \(\tfrac{1}{2}\). Exemple
Calculer la moyenne et la médiane de la série fil rouge.
La moyenne, par la forme des fréquences, $$\bar{x} = \sum_k f_k v_k = 0{,}1 \cdot 0 + 0{,}2 \cdot 1 + 0{,}3 \cdot 2 + 0{,}2 \cdot 3 + 0{,}1 \cdot 4 + 0{,}1 \cdot 5 = 2{,}3.$$ La médiane vaut \(2\) d'après la section précédente. La moyenne \(2{,}3\) dépasse la médiane \(2\) : les quelques grandes familles (valeurs \(4\) et \(5\)) tirent la moyenne à droite de la médiane.
Proposition — Transformation affine de la moyenne
Si une nouvelle série est formée par \(y_i = a x_i + b\) pour des réels fixés \(a, b\), alors sa moyenne est $$\bar{y} = a \bar{x} + b.$$
Par linéarité de la somme (chapitre Méthodes de calcul), $$ \begin{aligned} \bar{y} &= \frac{1}{n} \sum_{i=1}^{n} y_i = \frac{1}{n} \sum_{i=1}^{n} (a x_i + b) && \text{(définition de } y_i \text{)} \\
&= \frac{1}{n} \left( a \sum_{i=1}^{n} x_i + \sum_{i=1}^{n} b \right) && \text{(linéarité de la somme)} \\
&= a \cdot \frac{1}{n} \sum_{i=1}^{n} x_i + \frac{1}{n} \cdot n b && \text{(} \textstyle\sum b = nb \text{)} \\
&= a \bar{x} + b. \end{aligned} $$
La médiane se transforme de la même façon sous un changement affine croissant \(y_i = a x_i + b\) avec \(a > 0\) : l'application \(x \mapsto ax + b\) préserve l'ordre des données, donc avec la convention « plus petit \(x\) tel que \(F(x) \ge \alpha\) » tout quantile se transforme en \(a \cdot (\text{quantile de } x) + b\) ; en particulier \(\mathrm{med}(y) = a\,\mathrm{med}(x) + b\). Pour \(a < 0\) l'application inverse l'ordre des données, de sorte que les plus petite et plus grande valeurs échangent leurs rôles et que les quantiles ne se transforment plus par cette règle simple.
Méthode — Choisir entre moyenne et médiane
Utiliser la moyenne quand chaque valeur doit compter (un total à partager, un coût moyen) et que les données n'ont pas de valeurs aberrantes. Utiliser la médiane quand les données sont asymétriques ou comportent des valeurs extrêmes (revenus, prix de l'immobilier) : la médiane est robuste — éloigner fortement la plus grande valeur la laisse inchangée, alors qu'elle déplace la moyenne. Donner les deux, et noter l'écart entre elles, est le réflexe critique demandé par le programme. En Python/pandas, s.mean() et s.median() les calculent. Compétences à pratiquer
- Calculer la moyenne et la médiane
IV
Dispersion
Deux séries peuvent partager la même moyenne tout en étant complètement différentes — l'une resserrée, l'autre largement dispersée. La dispersion mesure cet étalement : de façon économique par l'étendue et l'écart interquartile, et finement par la variance et l'écart-type, dont le calcul est rendu pratique par la formule de König.
Définition — Étendue et écart interquartile
L'étendue d'une série est \(\max - \min\), l'amplitude de toutes les données. L'écart interquartile est \(Q_3 - Q_1\), l'amplitude de la partie centrale des données entre les premier et troisième quartiles (il laisse de côté les queues extrêmes des données, donc résiste aux valeurs aberrantes — éloigner fortement la plus grande ou la plus petite valeur le laisse inchangé). Définition — Variance et écart-type
La variance (empirique) d'une série \((x_1, \dots, x_n)\) de moyenne \(\bar{x}\) est la moyenne des carrés des écarts à la moyenne : $$s_x^2 = \frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})^2 = \sum_{k=1}^{p} f_k (v_k - \bar{x})^2.$$ L'écart-type est \(s_x = \sqrt{s_x^2}\), exprimé dans la même unité que les données. Le dénominateur est \(n\) (tout l'échantillon est l'objet d'étude). Proposition — Formule de König
La variance est aussi donnée par $$s_x^2 = \frac{1}{n} \sum_{i=1}^{n} x_i^2 - \bar{x}^2 = \left( \sum_{k=1}^{p} f_k v_k^2 \right) - \bar{x}^2,$$ la moyenne des carrés moins le carré de la moyenne.
Développer le carré dans la somme définissante et utiliser la linéarité de la somme (chapitre Méthodes de calcul), avec \(\sum_{i} x_i = n \bar{x}\) : $$ \begin{aligned} s_x^2 &= \frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})^2 \\
&= \frac{1}{n} \sum_{i=1}^{n} \left( x_i^2 - 2 \bar{x} x_i + \bar{x}^2 \right) && \text{(développement du carré)} \\
&= \frac{1}{n} \sum_{i=1}^{n} x_i^2 - 2 \bar{x} \cdot \frac{1}{n} \sum_{i=1}^{n} x_i + \frac{1}{n} \cdot n \bar{x}^2 && \text{(linéarité de la somme)} \\
&= \frac{1}{n} \sum_{i=1}^{n} x_i^2 - 2 \bar{x} \cdot \bar{x} + \bar{x}^2 && \text{(} \textstyle\frac{1}{n}\sum x_i = \bar{x} \text{)} \\
&= \frac{1}{n} \sum_{i=1}^{n} x_i^2 - \bar{x}^2. \end{aligned} $$
Exemple
Calculer la variance et l'écart-type de la série fil rouge avec la formule de König.
La moyenne des carrés, par les fréquences, $$\sum_k f_k v_k^2 = 0{,}1 \cdot 0 + 0{,}2 \cdot 1 + 0{,}3 \cdot 4 + 0{,}2 \cdot 9 + 0{,}1 \cdot 16 + 0{,}1 \cdot 25 = 7{,}3.$$ Par König, \(s_x^2 = 7{,}3 - \bar{x}^2 = 7{,}3 - 2{,}3^2 = 7{,}3 - 5{,}29 = 2{,}01\), et \(s_x = \sqrt{2{,}01} \approx 1{,}42\).
Proposition — Variance sous transformation affine
Si \(y_i = a x_i + b\) pour des réels fixés \(a, b\), alors $$s_y^2 = a^2 s_x^2, \qquad s_y = |a|\, s_x.$$ Une translation de \(b\) ne change pas la dispersion ; une dilatation de \(a\) multiplie la variance par \(a^2\).
Comme \(\bar{y} = a \bar{x} + b\), chaque écart vaut \(y_i - \bar{y} = (a x_i + b) - (a \bar{x} + b) = a (x_i - \bar{x})\). En élevant au carré et en moyennant, $$s_y^2 = \frac{1}{n} \sum_{i=1}^{n} (y_i - \bar{y})^2 = \frac{1}{n} \sum_{i=1}^{n} a^2 (x_i - \bar{x})^2 = a^2 \cdot \frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})^2 = a^2 s_x^2.$$ En prenant les racines carrées, \(s_y = |a|\, s_x\).
Méthode — Calculer la variance par König
Pour calculer une variance à la main, la forme de König \(s_x^2 = \frac{1}{n}\sum x_i^2 - \bar{x}^2\) est la plus efficace : un seul passage sur les données accumule \(\sum x_i\) (pour \(\bar{x}\)) et \(\sum x_i^2\), puis la variance est une soustraction — inutile de reparcourir les données pour former les écarts \(x_i - \bar{x}\). En Python/pandas, s.var(ddof=0) et s.std(ddof=0) renvoient cette variance et cet écart-type ; le ddof=0 est essentiel, car le défaut ddof=1 divise par \(n - 1\) (la variance inférentielle) au lieu de \(n\).
Pour aller plus loin
Le programme relie ce chapitre à l'ordinateur : des jeux de données socio-économiques réels (issus de
data.gouv, de l'INSEE) sont chargés et résumés en Python avec la bibliothèque pandas — describe, mean, median, std(ddof=0) — étudiée systématiquement dans le chapitre Algorithmique et Python. Les suites naturelles, au-delà de cette première année, sont les statistiques bivariées (deux variables à la fois : corrélation, régression linéaire) et les statistiques inférentielles, qui infèrent les propriétés d'une population entière à partir d'un échantillon — le pont vers les chapitres de probabilités qui suivent.
Compétences à pratiquer
- Calculer la variance
V
Pour aller plus loin
Compétences à pratiquer
- Résumer et comparer des jeux de données
Aller à la section