Éducation Nationale Française · PT
Espérance, variance, génératrices et inégalités
Ce chapitre munit une variable aléatoire discrète de ses deux résumés numériques fondamentaux — l'espérance (sa valeur moyenne) et la variance (son écart quadratique autour de cette moyenne) — puis développe trois outils qui s'appuient sur eux : la fonction génératrice d'une variable à valeurs dans \(\mathbb{N}\), qui encode toute la loi dans une seule série entière et transforme l'indépendance en multiplication ; et les deux inégalités de concentration de Markov et de Bienaymé-Tchebychev, qui aboutissent à la loi faible des grands nombres. Tout au long, une variable aléatoire discrète réelle \(X\) prend ses valeurs dans un ensemble au plus dénombrable \(X(\Omega) \subset \mathbb{R}\), dont les valeurs distinctes sont énumérées sans répétition sous la forme \(\{x_n\}\) (\(n\) décrivant un intervalle fini ou \(\mathbb{N}\)), et l'existence d'une somme sur \(X(\Omega)\) se ramène toujours à la convergence absolue d'une série numérique \(\sum_n x_n \mathbb{P}(X = x_n)\) — le cadre de première année des séries absolument convergentes, utilisé partout.
I
Espérance d'une variable aléatoire discrète
L'espérance étend la notion de première année des supports finis aux supports dénombrables infinis. La seule difficulté nouvelle est que la somme \(\sum_n x_n \mathbb{P}(X = x_n)\) peut désormais être une série infinie ; on lui demande de converger absolument, ce qui garantit que la valeur est finie et ne dépend pas de l'ordre de sommation. La formule de transfert \(\mathbb{E}(f(X)) = \sum_n f(x_n) \mathbb{P}(X = x_n)\) est le cheval de bataille de tout calcul concret, et la linéarité, la positivité et la formule du produit pour des variables indépendantes en découlent.
I.1
Définition, existence
Quand la somme \(\sum_n x_n \mathbb{P}(X = x_n)\) a-t-elle un sens ? L'image \(X(\Omega)\) étant au plus dénombrable, la somme est une série numérique ; on lui demande de converger absolument comme condition de bonne définition. La valeur \(\mathbb{E}(X)\) est alors la somme de cette série, et elle ne dépend pas de l'ordre dans lequel on énumère les valeurs \(x_n\).
Définition — Espérance finie, espérance
Soit \(X\) une variable aléatoire discrète réelle. Son support \(X(\Omega)\) étant au plus dénombrable, on énumère ses valeurs distinctes sans répétition : \(X(\Omega) = \{x_n\}\) où \(n\) décrit \(\{0 \virgule \dots \virgule N\}\) (support fini) ou \(\mathbb{N}\) (support dénombrable infini), les \(x_n\) étant deux à deux distincts. On dit que \(X\) admet une espérance finie (ou est intégrable) lorsque la série \(\sum_n x_n \mathbb{P}(X = x_n)\) converge absolument, c'est-à-dire $$ \sum_{n} |x_n| \, \mathbb{P}(X = x_n) \,<\, +\infty. $$ On appelle alors espérance de \(X\) le réel $$ \mathbb{E}(X) \,=\, \sum_{n} x_n \, \mathbb{P}(X = x_n), $$ dont la valeur ne dépend pas de l'énumération sans répétition choisie de \(X(\Omega)\). Proposition — Support fini : l'espérance existe toujours
Lorsque \(X(\Omega)\) est fini, toute variable aléatoire discrète réelle \(X\) admet une espérance finie, et la valeur est la somme finie usuelle \(\mathbb{E}(X) = \sum_{x \in X(\Omega)} x \, \mathbb{P}(X = x)\) étudiée en première année. Exemple — Une variable aléatoire bornée
Si \(|X| \le M\) sur \(\Omega\) pour une constante \(M \ge 0\), alors pour toute valeur \(x\) on a \(|x| \le M\), donc \(\sum_x |x| \mathbb{P}(X = x) \le M \sum_x \mathbb{P}(X = x) = M < +\infty\). Donc \(X\) admet une espérance finie. En particulier l'indicatrice \(\mathbf{1}_A\) d'un événement \(A\) prend ses valeurs dans \(\{0 \virgule 1\}\), donc \(\mathbb{E}(\mathbf{1}_A) = 0 \cdot \mathbb{P}(A^c) + 1 \cdot \mathbb{P}(A) = \mathbb{P}(A)\). Exemple — Les lois géométrique et de Poisson admettent une espérance finie
Pour \(X \sim \mathcal{G}(p)\) avec \(0 < p < 1\), la série positive \(\sum_{n \ge 1} n (1-p)^{n-1} p\) converge par la règle de d'Alembert, car \(\frac{(n+1)(1-p)^n}{n (1-p)^{n-1}} = (1-p)\frac{n+1}{n} \to 1 - p < 1\). Donc \(X\) admet une espérance finie, de valeur \(1/p\) calculée à la sous-section 1.5. Pour \(X \sim \mathcal{P}(\lambda)\) avec \(\lambda > 0\), la série positive \(\sum_{n \ge 0} n \mathrm{e}^{-\lambda} \lambda^n/n!\) converge par la même règle, de rapport limite \(\lambda/n \to 0 < 1\) ; sa valeur \(\mathbb{E}(X) = \lambda\) est également calculée à la sous-section 1.5. Exemple — Une loi sans espérance finie
Posons \(\mathbb{P}(X = n) = c/n^2\) pour \(n \ge 1\), avec \(c = 6/\pi^2\) pour que \(\sum_{n \ge 1} \mathbb{P}(X = n) = 1\). Alors \(\sum_{n \ge 1} n \mathbb{P}(X = n) = c \sum_{n \ge 1} 1/n = +\infty\) (série harmonique). La série de définition ne converge pas, donc \(X\) n'admet pas d'espérance finie : sa queue \(\mathbb{P}(X = n) \sim c/n^2\) alloue tant de masse aux grandes valeurs que la moyenne serait infinie. Proposition — Formule de la queue pour une variable à valeurs dans \(\mathbb{N}\)
Soit \(X\) une variable aléatoire discrète avec \(X(\Omega) \subset \mathbb{N}\). Alors \(X\) admet une espérance finie si et seulement si la série positive \(\sum_{n \ge 1} \mathbb{P}(X \ge n)\) converge, et dans ce cas $$ \mathbb{E}(X) \,=\, \sum_{n \ge 1} \mathbb{P}(X \ge n). $$
Tous les termes sont positifs, donc les deux membres sont à valeurs dans \([0 \virgule +\infty]\) et l'on peut réordonner librement. En écrivant \(\mathbb{P}(X \ge n) = \sum_{k \ge n} \mathbb{P}(X = k)\) et en échangeant les deux sommations sur la série double positive : $$ \begin{aligned} \sum_{n \ge 1} \mathbb{P}(X \ge n) &\,=\, \sum_{n \ge 1} \sum_{k \ge n} \mathbb{P}(X = k) && \text{(définition de \(\mathbb{P}(X \ge n)\))} \\
&\,=\, \sum_{k \ge 1} \mathbb{P}(X = k) \, \#\{n \ge 1 \mid n \le k\} && \text{(chaque couple \((n \virgule k)\) avec \(n \le k\) compté une fois)} \\
&\,=\, \sum_{k \ge 1} k \, \mathbb{P}(X = k). \end{aligned} $$ Le membre de droite est la série de définition de \(\mathbb{E}(X)\) pour la variable positive \(X\). Les deux membres sont simultanément finis ou infinis, d'où l'équivalence ; lorsqu'ils sont finis, ils ont même valeur.
Exemple — La somme de queue comme aire sous un escalier
Le graphe de la fonction de survie \(n \mapsto \mathbb{P}(X \ge n)\) sur \(\mathbb{N}^*\) est un escalier décroissant ; le total de ses hauteurs vaut \(\mathbb{E}(X)\). 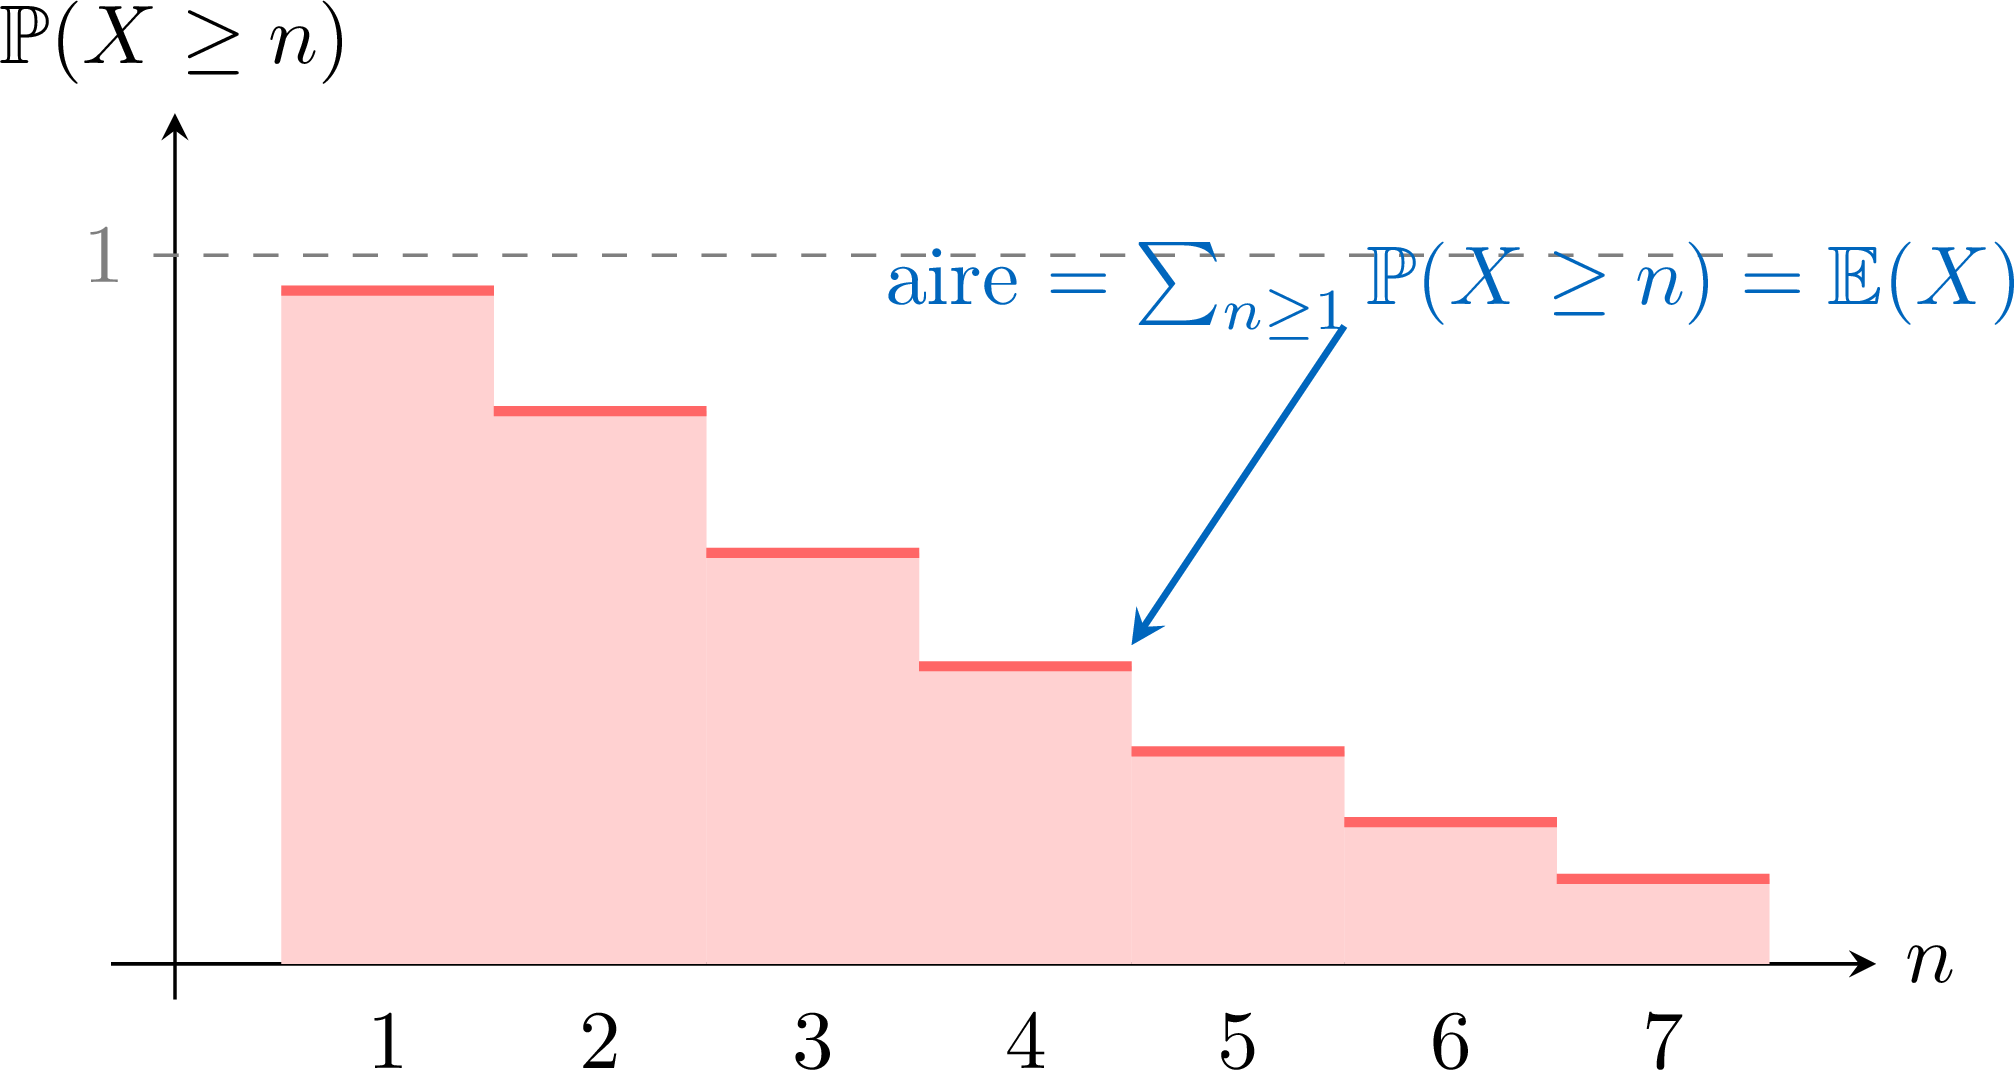
Méthode — Décider si \(X\) admet une espérance finie
Trois voies, à utiliser tour à tour.- Raccourci par borne. Si \(|X| \le M\) sur \(\Omega\), alors \(X\) admet immédiatement une espérance finie. Cela couvre \(\mathcal{B}(p)\), \(\mathcal{B}(n \virgule p)\) et \(\mathcal{U}(\{1 \virgule \dots \virgule n\})\) d'un coup.
- Étudier la série positive. Pour un support non borné, écrire la série positive \(\sum_n |x_n| \, \mathbb{P}(X = x_n)\) et étudier sa convergence par la règle de d'Alembert, par comparaison avec une série de Riemann ou géométrique connue, ou par dérivation d'une somme connue en forme close.
- Formule de la queue. Lorsque \(X(\Omega) \subset \mathbb{N}\) et que \(\mathbb{P}(X \ge n)\) admet une forme close, appliquer la Proposition de la queue : \(X\) admet une espérance finie si et seulement si \(\sum_{n \ge 1} \mathbb{P}(X \ge n)\) converge, et cette somme vaut alors \(\mathbb{E}(X)\).
Compétences à pratiquer
- Décider si \(X\) admet une espérance finie
I.2
La formule de transfert
Le cheval de bataille du chapitre. Pour calculer \(\mathbb{E}(f(X))\), il n'est pas nécessaire de déterminer la loi de la nouvelle variable \(Y = f(X)\) : une seule somme sur \(X(\Omega)\), pondérée par \(\mathbb{P}(X = x)\), suffit, à condition que la série correspondante converge absolument. Le même test de convergence absolue que pour \(\mathbb{E}(X)\) s'applique.
Théorème — Formule de transfert
Soit \(X\) une variable aléatoire discrète, les valeurs distinctes de son support \(X(\Omega)\) étant énumérées sans répétition sous la forme \(\{x_n\}\), et \(f\) une fonction réelle définie sur \(X(\Omega)\). Alors \(f(X)\) admet une espérance finie si et seulement si la série \(\sum_n f(x_n) \mathbb{P}(X = x_n)\) converge absolument, et dans ce cas $$ \mathbb{E}(f(X)) \,=\, \sum_{n} f(x_n) \, \mathbb{P}(X = x_n). $$ La formule s'applique verbatim à un couple ou un \(n\)-uplet de variables aléatoires : pour \(f\) une fonction réelle sur l'image de \((X_1 \virgule \dots \virgule X_r)\), \(\mathbb{E}(f(X_1 \virgule \dots \virgule X_r)) = \sum f(x_1 \virgule \dots \virgule x_r) \, \mathbb{P}(X_1 = x_1 \virgule \dots \virgule X_r = x_r)\) sous la même condition de convergence absolue. C'est la forme utilisée aux sous-sections 1{,}3 et 1{,}4 pour obtenir la linéarité et la formule du produit, via \(f(x_1 \virgule x_2) = \lambda x_1 + \mu x_2\) et \(f(x_1 \virgule x_2) = x_1 x_2\).
Admise (hors programme). L'argument regroupe les valeurs de \(X\) selon les ensembles de niveaux de \(f\) et repose sur le réarrangement des séries absolument convergentes.
Exemple — Moment d'ordre 2 d'une géométrique
Pour \(X \sim \mathcal{G}(p)\) avec \(0 < p < 1\), appliquer le transfert avec \(f(n) = n^2\). La série positive \(\sum_{n \ge 1} n^2 (1-p)^{n-1} p\) converge (rapport de d'Alembert \((1-p)\frac{(n+1)^2}{n^2} \to 1 - p < 1\)), donc \(X^2\) admet une espérance finie. En écrivant \(n^2 = n(n-1) + n\) et en utilisant la somme géométrique \(\sum_{n \ge 0} t^n = 1/(1-t)\) dérivée une et deux fois, \(\sum_{n \ge 1} n t^{n-1} = 1/(1-t)^2\) et \(\sum_{n \ge 2} n(n-1) t^{n-2} = 2/(1-t)^3\) sur \(|t| < 1\), évaluées en \(t = 1 - p\) : $$ \mathbb{E}(X) = p \cdot \frac{1}{p^2} = \frac{1}{p}, \qquad \mathbb{E}(X(X-1)) = p(1-p) \cdot \frac{2}{p^3} = \frac{2(1-p)}{p^2}, $$ d'où $$ \mathbb{E}(X^2) \,=\, \mathbb{E}(X(X-1)) + \mathbb{E}(X) \,=\, \frac{2(1-p)}{p^2} + \frac{1}{p} \,=\, \frac{2 - p}{p^2}. $$ Exemple — Espérance de \(1/(X+1)\) pour une loi de Poisson
Pour \(X \sim \mathcal{P}(\lambda)\) avec \(\lambda > 0\), appliquer le transfert avec \(f(n) = 1/(n+1)\). La série converge absolument, car chaque terme est majoré par \(\mathbb{P}(X = n)\) (puisque \(0 \le 1/(n+1) \le 1\)) et \(\sum_n \mathbb{P}(X = n) = 1 < +\infty\), et $$ \mathbb{E}\!\left(\frac{1}{X+1}\right) \,=\, \sum_{n \ge 0} \frac{\mathrm{e}^{-\lambda} \lambda^n}{(n+1)!} \,=\, \frac{\mathrm{e}^{-\lambda}}{\lambda} \sum_{n \ge 0} \frac{\lambda^{n+1}}{(n+1)!} \,=\, \frac{\mathrm{e}^{-\lambda}}{\lambda} (\mathrm{e}^\lambda - 1) \,=\, \frac{1 - \mathrm{e}^{-\lambda}}{\lambda}. $$ Méthode — Calculer une espérance par transfert
Quatre étapes fiables.- Identifier \(f\). Lire la variable à moyenner sous la forme \(f(X)\) pour un \(f\) explicite — par ex.\ \(f(n) = n^2\) pour \(\mathbb{E}(X^2)\), \(f(n) = 1/(n+1)\) pour \(\mathbb{E}(1/(X+1))\).
- Étape d'existence. Vérifier que \(\sum_n |f(x_n)| \mathbb{P}(X = x_n)\) converge, par la règle de d'Alembert, par comparaison, ou par une majoration directe de \(|f|\).
- Astuces de forme close. Utiliser des sommes connues — la somme géométrique et ses dérivées \(\sum n t^{n-1} = 1/(1-t)^2\), la série exponentielle \(\sum \lambda^n/n! = \mathrm{e}^\lambda\), la formule du binôme \(\sum \binom{n}{k} a^k = (1+a)^n\).
- Réduire un \(f\) polynomial. Si \(f\) est un polynôme, le développer et se ramener à des moments de degré inférieur calculés un à un.
Compétences à pratiquer
- Calculer une espérance par transfert
I.3
Linéarité, positivité, croissance
La formule de transfert en main, toutes les propriétés classiques de l'espérance à support fini se transposent au cas dénombrable ; on vérifie seulement que l'hypothèse de convergence absolue est préservée par l'opération. Les démonstrations des deux résultats fondamentaux — la linéarité et la formule du produit pour des variables indépendantes — reposent sur la formule de transfert appliquée au couple \((X \virgule Y)\) et sont admises à ce niveau.
Proposition — Espérance d'une constante
Pour tout \(c \in \mathbb{R}\), la variable aléatoire constante \(X \colon \omega \mapsto c\) admet une espérance finie avec \(\mathbb{E}(c) = c\). Théorème — Linéarité de l'espérance
Soient \(X, Y\) deux variables aléatoires discrètes réelles, toutes deux d'espérance finie, et \(\lambda, \mu \in \mathbb{R}\). Alors \(\lambda X + \mu Y\) admet une espérance finie et $$ \mathbb{E}(\lambda X + \mu Y) \,=\, \lambda \, \mathbb{E}(X) + \mu \, \mathbb{E}(Y). $$
Admise (hors programme). On applique la formule de transfert au couple \((X \virgule Y)\) avec \(f(x \virgule y) = \lambda x + \mu y\) ; l'étape d'existence utilise l'inégalité triangulaire \(|\lambda x + \mu y| \le |\lambda||x| + |\mu||y|\) et la finitude de \(\mathbb{E}(|X|)\) et \(\mathbb{E}(|Y|)\).
Exemple — Espérance d'une somme d'indicatrices
Pour des événements \(A_1 \virgule \dots \virgule A_n\), l'espérance de la variable de comptage \(N = \sum_{i=1}^n \mathbf{1}_{A_i}\) (le nombre d'événements réalisés) est $$ \mathbb{E}(N) \,=\, \sum_{i=1}^n \mathbb{E}(\mathbf{1}_{A_i}) \,=\, \sum_{i=1}^n \mathbb{P}(A_i). $$ Aucune indépendance n'est requise ; la linéarité vaut pour toute loi jointe. C'est la façon la plus efficace de calculer l'espérance d'une somme de contributions à valeurs dans \(\{0 \virgule 1\}\). Exemple — Combinaison affine
Pour \(X\) d'espérance finie et \(a \virgule b \in \mathbb{R}\), \(\mathbb{E}(aX + b) = a \, \mathbb{E}(X) + b\) : appliquer la linéarité avec la variable constante \(b\), d'espérance \(b\). Proposition — Positivité, croissance, domination
Soient \(X, Y\) des variables aléatoires discrètes réelles. - Positivité : si \(X\) admet une espérance finie et \(X \ge 0\), alors \(\mathbb{E}(X) \ge 0\).
- Croissance : si \(X\) et \(Y\) admettent une espérance finie et \(X \le Y\), alors \(\mathbb{E}(X) \le \mathbb{E}(Y)\).
- Domination : si \(|X| \le Y\) et \(Y\) admet une espérance finie, alors \(X\) admet aussi une espérance finie, et \(|\mathbb{E}(X)| \le \mathbb{E}(|X|) \le \mathbb{E}(Y)\).
- Test d'annulation : si \(X\) admet une espérance finie, \(X \ge 0\) et \(\mathbb{E}(X) = 0\), alors \(X = 0\) presque sûrement.
- (1) Chaque valeur \(x\) de \(X\) est \(\ge 0\), donc chaque terme \(x \, \mathbb{P}(X = x) \ge 0\) ; une série convergente à termes positifs a une somme positive.
- (2) Appliquer (1) à la variable positive \(Y - X\) et utiliser la linéarité : \(\mathbb{E}(Y) - \mathbb{E}(X) = \mathbb{E}(Y - X) \ge 0\).
- (3) Le fait que \(|X| \le Y\) avec \(Y\) intégrable force \(X\) intégrable (c'est-à-dire \(\sum_x |x| \mathbb{P}(X = x) < +\infty\)) est admis (hors programme) : il repose sur la formule de transfert appliquée à \(|X|\) et \(Y\) et sur la comparaison des deux espérances positives \(\mathbb{E}(|X|) \le \mathbb{E}(Y)\) valable dans \([0 \virgule +\infty]\), et non sur une comparaison terme à terme des deux lois. L'intégrabilité acquise, l'inégalité triangulaire sur la série de définition absolument convergente donne \(|\mathbb{E}(X)| = |\sum_x x \mathbb{P}(X = x)| \le \sum_x |x| \mathbb{P}(X = x) = \mathbb{E}(|X|)\), et en appliquant (2) aux variables intégrables \(|X| \le Y\) on obtient \(\mathbb{E}(|X|) \le \mathbb{E}(Y)\).
- (4) \(\mathbb{E}(X) = \sum_x x \, \mathbb{P}(X = x) = 0\) avec des termes positifs force chaque terme \(x \, \mathbb{P}(X = x) = 0\), soit \(\mathbb{P}(X = x) = 0\) pour tout \(x > 0\) : donc \(X = 0\) presque sûrement.
Compétences à pratiquer
- Calculer une espérance par linéarité
I.4
Indépendance et formule du produit
La propriété algébrique phare des variables indépendantes : leurs espérances se multiplient. Le résultat fonde l'identité de Bienaymé pour la variance d'une somme indépendante (sous-section 2.3) et la formule du produit pour les fonctions génératrices (sous-section 3.2).
Théorème — Indépendance et produit des espérances
Soient \(X, Y\) deux variables aléatoires discrètes réelles indépendantes, toutes deux d'espérance finie. Alors \(XY\) admet une espérance finie et $$ \mathbb{E}(XY) \,=\, \mathbb{E}(X) \, \mathbb{E}(Y). $$
Admise (hors programme). On applique la formule de transfert au couple \((X \virgule Y)\) avec \(f(x \virgule y) = xy\) ; l'indépendance factorise la loi jointe \(\mathbb{P}(X = x \virgule Y = y) = \mathbb{P}(X = x) \mathbb{P}(Y = y)\), et la série d'existence se factorise en \(\left(\sum_x |x| \mathbb{P}(X = x)\right)\left(\sum_y |y| \mathbb{P}(Y = y)\right) < +\infty\).
Exemple — Deux Bernoulli indépendantes
Pour \(X, Y \sim \mathcal{B}(p)\) indépendantes, \(\mathbb{E}(XY) = \mathbb{E}(X) \mathbb{E}(Y) = p \cdot p = p^2\). C'est aussi direct : \(XY\) prend la valeur \(1\) exactement lorsque \(X = 1\) et \(Y = 1\), de probabilité \(p^2\), donc \(XY \sim \mathcal{B}(p^2)\) et \(\mathbb{E}(XY) = p^2\). Exemple — L'indépendance est nécessaire
Soient \(X \sim \mathcal{B}(1/2)\) et \(Y = 1 - X\). Alors \(\mathbb{E}(X) = \mathbb{E}(Y) = 1/2\), mais \(XY \equiv 0\) (si \(X = 1\) alors \(Y = 0\), et si \(X = 0\) alors \(XY = 0\)). Donc \(\mathbb{E}(XY) = 0 \ne 1/4 = \mathbb{E}(X) \mathbb{E}(Y)\) : la formule du produit est en défaut sans indépendance. L'écart \(\mathbb{E}(XY) - \mathbb{E}(X) \mathbb{E}(Y)\) sera baptisé covariance à la sous-section 2.3. Proposition — Produit de \(n\) variables indépendantes
Soient \(X_1 \virgule \dots \virgule X_n\) des variables aléatoires discrètes réelles mutuellement indépendantes, chacune d'espérance finie. Alors \(X_1 X_2 \cdots X_n\) admet une espérance finie et $$ \mathbb{E}(X_1 X_2 \cdots X_n) \,=\, \mathbb{E}(X_1) \, \mathbb{E}(X_2) \cdots \mathbb{E}(X_n). $$
Par récurrence sur \(n\). Pour \(n = 2\), c'est le Théorème précédent. Pour \(n \ge 3\), les variables \(X_1 \cdots X_{n-1}\) et \(X_n\) sont indépendantes (une fonction des \(n - 1\) premières est indépendante de la dernière, par le lemme des coalitions vu dans Variables aléatoires discrètes et lois usuelles) ; appliquer le Théorème au couple, puis l'hypothèse de récurrence.
Compétences à pratiquer
- Appliquer l'indépendance pour calculer \(\mathbb{E}(XY)\)
I.5
Espérances des lois usuelles
Le catalogue que tout étudiant doit connaître par cœur, dérivé ici une fois et utilisé dans tout le reste du chapitre.
Théorème — Espérances des lois usuelles
Soit \(X\) de l'une des lois suivantes. Alors \(X\) admet une espérance finie, égale à : - \(\mathcal{B}(p)\) (Bernoulli) sur \(\{0 \virgule 1\}\), \(p \in [0 \virgule 1]\) : \(\mathbb{E}(X) = p\).
- \(\mathcal{B}(n \virgule p)\) (binomiale) sur \(\{0 \virgule \dots \virgule n\}\), \(n \ge 1\), \(p \in [0 \virgule 1]\) : \(\mathbb{E}(X) = np\).
- \(\mathcal{U}(\{1 \virgule \dots \virgule n\})\) (uniforme), \(n \ge 1\) : \(\mathbb{E}(X) = (n+1)/2\).
- \(\mathcal{G}(p)\) (géométrique) sur \(\mathbb{N}^*\), \(0 < p < 1\) : \(\mathbb{E}(X) = 1/p\).
- \(\mathcal{P}(\lambda)\) (Poisson) sur \(\mathbb{N}\), \(\lambda > 0\) : \(\mathbb{E}(X) = \lambda\).
- Bernoulli. \(\mathbb{E}(X) = 0 \cdot (1 - p) + 1 \cdot p = p\).
- Binomiale. Une binomiale est une somme \(X = X_1 + \dots + X_n\) de \(n\) Bernoulli \(\mathcal{B}(p)\) indépendantes (vu dans Variables aléatoires discrètes et lois usuelles). Par linéarité, \(\mathbb{E}(X) = n \, \mathbb{E}(X_1) = np\).
- Uniforme. \(\mathbb{E}(X) = \sum_{k=1}^n k/n = \frac{1}{n} \cdot \frac{n(n+1)}{2} = \frac{n+1}{2}\).
- Géométrique. \(\mathbb{E}(X) = \sum_{n \ge 1} n (1-p)^{n-1} p = p \cdot \frac{1}{(1 - (1-p))^2} = \frac{p}{p^2} = \frac{1}{p}\) (dérivée de la série géométrique).
- Poisson. \(\mathbb{E}(X) = \sum_{n \ge 0} n \mathrm{e}^{-\lambda} \frac{\lambda^n}{n!} = \mathrm{e}^{-\lambda} \lambda \sum_{n \ge 1} \frac{\lambda^{n-1}}{(n-1)!} = \mathrm{e}^{-\lambda} \lambda \, \mathrm{e}^\lambda = \lambda\) (réindexation puis série exponentielle).
Méthode — Calculer l'espérance d'une loi non standard
Trois voies, par ordre de préférence.- Décomposer en indicatrices ou en sommes connues. Si \(X = \sum_i X_i\) (ou une fonction de variables usuelles), utiliser la linéarité (sous-section 1.3) pour se ramener à des espérances élémentaires. La binomiale via \(n\) Bernoulli est le prototype.
- Somme directe en forme close. Écrire \(\mathbb{E}(X) = \sum_x x \mathbb{P}(X = x)\) et utiliser les astuces standards : dérivée de la série géométrique, série exponentielle, formule du binôme.
- Fonction génératrice. Si la loi est à valeurs dans \(\mathbb{N}\) avec une fonction génératrice \(G_X\) en forme close, dériver une fois en \(1\) : \(\mathbb{E}(X) = G_X'(1^-)\) (sous-section 3.3). Particulièrement efficace pour les lois géométrique et de Poisson.
Compétences à pratiquer
- Calculer l'espérance d'une loi
II
Variance, covariance et écart-type
À partir de maintenant, toutes les variables aléatoires sont réelles. La variance mesure l'écart quadratique d'une variable à sa moyenne ; la covariance la généralise aux couples et donne la variance d'une somme (identité de Bienaymé). L'inégalité de Cauchy-Schwarz est la colonne vertébrale algébrique qui rend la covariance bien définie.
II.1
Moment d'ordre 2 et inégalité de Cauchy-Schwarz
Un moment d'ordre 2 est l'espérance de \(X^2\). On note \(X \in L^2\) comme raccourci pour « \(\mathbb{E}(X^2) < +\infty\) » — une notation commode, pas un nouveau cadre. L'inégalité de Cauchy-Schwarz majore \(\mathbb{E}(XY)\) par les moments d'ordre 2 de \(X\) et \(Y\) et garantit que les produits nécessaires à la covariance admettent une espérance finie.
Définition — \(L^1\) et \(L^2\)
Une variable aléatoire discrète réelle \(X\) est dite intégrable (« dans \(L^1\) »), notée \(X \in L^1\), lorsque \(\mathbb{E}(|X|) < +\infty\), soit lorsque \(X\) admet une espérance finie. Elle est dite de carré intégrable (« dans \(L^2\) »), notée \(X \in L^2\), lorsque \(\mathbb{E}(X^2) < +\infty\). Proposition — \(L^1\) et \(L^2\) sont stables par combinaisons linéaires
Soient \(X, Y\) des variables aléatoires discrètes réelles et \(\lambda \virgule \mu \in \mathbb{R}\). Alors : - \(X, Y \in L^1\) implique \(\lambda X + \mu Y \in L^1\).
- \(X, Y \in L^2\) implique \(\lambda X + \mu Y \in L^2\).
- (1) La variable dominante \(Z = |\lambda| |X| + |\mu| |Y|\) est intégrable : \(X, Y \in L^1\) et la linéarité donnent \(\mathbb{E}(Z) = |\lambda| \mathbb{E}(|X|) + |\mu| \mathbb{E}(|Y|) < +\infty\). Comme \(|\lambda X + \mu Y| \le Z\) avec \(Z\) intégrable, le critère de domination (point 3 ci-dessus) rend \(\lambda X + \mu Y\) intégrable, soit \(\lambda X + \mu Y \in L^1\).
- (2) La variable dominante \(W = 2\lambda^2 X^2 + 2\mu^2 Y^2\) est intégrable, car \(X, Y \in L^2\) donnent \(\mathbb{E}(W) = 2\lambda^2 \mathbb{E}(X^2) + 2\mu^2 \mathbb{E}(Y^2) < +\infty\). L'inégalité élémentaire \((a + b)^2 \le 2a^2 + 2b^2\) donne \((\lambda X + \mu Y)^2 \le W\), donc \((\lambda X + \mu Y)^2\) est intégrable par domination, soit \(\lambda X + \mu Y \in L^2\).
Théorème — Inégalité de Cauchy-Schwarz
Soient \(X, Y\) des variables aléatoires discrètes réelles dans \(L^2\). Alors \(XY \in L^1\) et $$ \mathbb{E}(XY)^2 \,\le\, \mathbb{E}(X^2) \, \mathbb{E}(Y^2). $$ De plus, il y a égalité si et seulement si \(\mathbb{E}(X^2) = 0\), ou \(\mathbb{E}(Y^2) = 0\), ou il existe un réel \(\alpha\) tel que \(X = \alpha Y\) presque sûrement.
On a d'abord \(XY \in L^1\) : par \(|XY| \le \frac{1}{2}(X^2 + Y^2)\) (réécriture de \((|X| - |Y|)^2 \ge 0\)), il vient \(\mathbb{E}(|XY|) \le \frac{1}{2}(\mathbb{E}(X^2) + \mathbb{E}(Y^2)) < +\infty\), donc \(XY \in L^1\) par domination.
Cas dégénéré \(\mathbb{E}(Y^2) = 0\). Le test d'annulation (sous-section 1.3) donne \(Y = 0\) presque sûrement, donc \(XY = 0\) presque sûrement et \(\mathbb{E}(XY) = 0\) : l'inégalité s'écrit \(0 \le 0\), une égalité. (Symétriquement si \(\mathbb{E}(X^2) = 0\).)
Cas générique \(\mathbb{E}(Y^2) > 0\). On considère, pour \(t \in \mathbb{R}\), le trinôme $$ P(t) \,=\, \mathbb{E}((X + tY)^2) \,=\, \mathbb{E}(X^2) + 2t \, \mathbb{E}(XY) + t^2 \mathbb{E}(Y^2). $$ Comme \((X + tY)^2 \ge 0\), la positivité de l'espérance donne \(P(t) \ge 0\) pour tout \(t\). Un trinôme positif a un discriminant négatif : \(4\mathbb{E}(XY)^2 - 4\mathbb{E}(X^2)\mathbb{E}(Y^2) \le 0\), l'inégalité annoncée. L'égalité signifie que le discriminant est nul, soit que \(P\) a une racine réelle \(t_0\) avec \(\mathbb{E}((X + t_0 Y)^2) = 0\), donc \(X = -t_0 Y\) presque sûrement par le test d'annulation : le cas de proportionnalité avec \(\alpha = -t_0\).
Corollaire — Une variable de carré intégrable est intégrable
Toute variable aléatoire discrète réelle \(X \in L^2\) est dans \(L^1\), avec \(\mathbb{E}(|X|) \le \sqrt{\mathbb{E}(X^2)}\).
Appliquer Cauchy-Schwarz à \(|X|\) et à la variable constante \(1\) (dans \(L^2\), avec \(\mathbb{E}(1) = 1\)) : \(\mathbb{E}(|X|)^2 \le \mathbb{E}(X^2) \cdot \mathbb{E}(1) = \mathbb{E}(X^2)\), donc \(\mathbb{E}(|X|) \le \sqrt{\mathbb{E}(X^2)} < +\infty\).
Exemple — La géométrique est dans \(L^2\)
Pour \(X \sim \mathcal{G}(p)\) avec \(0 < p < 1\), le calcul du moment d'ordre 2 de la sous-section 1.2 a donné \(\mathbb{E}(X^2) = (2-p)/p^2 < +\infty\), donc \(X \in L^2\). Exemple — Poisson est dans \(L^2\)
Pour \(X \sim \mathcal{P}(\lambda)\), le transfert avec \(f(n) = n^2 = n(n-1) + n\) donne $$ \mathbb{E}(X^2) \,=\, \sum_{n \ge 2} n(n-1) \frac{\mathrm{e}^{-\lambda} \lambda^n}{n!} + \mathbb{E}(X) \,=\, \lambda^2 + \lambda \,<\, +\infty, $$ donc \(X \in L^2\). (Le calcul donne aussi \(\mathbb{E}(X(X-1)) = \lambda^2\), utilisé à la sous-section 2.2.) Compétences à pratiquer
- Appliquer l'inégalité de Cauchy-Schwarz
II.2
Variance et formule de König-Huygens
La variance mesure l'écart quadratique à la moyenne. La formule de König-Huygens transforme la définition en l'identité calculatoire \(\mathrm{V}(X) = \mathbb{E}(X^2) - \mathbb{E}(X)^2\), en général plus simple à évaluer.
Définition — Variance, écart-type
Soit \(X\) une variable aléatoire discrète réelle dans \(L^2\). Sa variance est le réel positif $$ \mathrm{V}(X) \,=\, \mathbb{E}\!\left( (X - \mathbb{E}(X))^2 \right). $$ Son écart-type est \(\sigma(X) = \sqrt{\mathrm{V}(X)}\). La variable \(X\) est dite centrée lorsque \(\mathbb{E}(X) = 0\), et réduite lorsque \(\sigma(X) = 1\). Lorsque \(\sigma(X) > 0\), la variable \((X - \mathbb{E}(X))/\sigma(X)\) est centrée réduite. Proposition — Formule de König-Huygens
Pour toute variable aléatoire discrète réelle \(X \in L^2\), $$ \mathrm{V}(X) \,=\, \mathbb{E}(X^2) - \mathbb{E}(X)^2. $$
Développer le carré et utiliser la linéarité (avec \(\mathbb{E}(X)\) constante) : $$ \begin{aligned} \mathrm{V}(X) &\,=\, \mathbb{E}\!\left( X^2 - 2\mathbb{E}(X) X + \mathbb{E}(X)^2 \right) && \text{(développement)} \\
&\,=\, \mathbb{E}(X^2) - 2\mathbb{E}(X)\mathbb{E}(X) + \mathbb{E}(X)^2 && \text{(linéarité)} \\
&\,=\, \mathbb{E}(X^2) - \mathbb{E}(X)^2. \end{aligned} $$
Proposition — Règle affine et annulation de la variance
Soit \(X\) une variable aléatoire discrète réelle dans \(L^2\) et \(a \virgule b \in \mathbb{R}\). Alors : - \(\mathrm{V}(aX + b) = a^2 \, \mathrm{V}(X)\).
- \(\mathrm{V}(X) = 0\) si et seulement si \(X = \mathbb{E}(X)\) presque sûrement (i.e.\ \(X\) est presque sûrement constante).
- (1) \(\mathbb{E}(aX + b) = a\mathbb{E}(X) + b\) par linéarité, donc \(aX + b - \mathbb{E}(aX + b) = a(X - \mathbb{E}(X))\) ; en élevant au carré et en prenant l'espérance : \(\mathrm{V}(aX + b) = \mathbb{E}(a^2(X - \mathbb{E}(X))^2) = a^2 \mathrm{V}(X)\).
- (2) \(\mathrm{V}(X) = \mathbb{E}((X - \mathbb{E}(X))^2) = 0\) avec \((X - \mathbb{E}(X))^2 \ge 0\) force \((X - \mathbb{E}(X))^2 = 0\) presque sûrement par le test d'annulation (sous-section 1.3), soit \(X = \mathbb{E}(X)\) presque sûrement.
Exemple — Variances des cinq lois usuelles
Chaque variance est obtenue une fois via König-Huygens, et tabulée à la sous-section 4.3. - Bernoulli \(\mathcal{B}(p)\). \(\mathbb{E}(X^2) = p\), donc \(\mathrm{V}(X) = p - p^2 = p(1-p)\).
- Binomiale \(\mathcal{B}(n \virgule p)\). En dérivant \(\sum_k \binom{n}{k} x^k q^{n-k} = (x+q)^n\) deux fois on obtient \(\sum_k k(k-1)\binom{n}{k} x^{k-2} q^{n-k} = n(n-1)(x+q)^{n-2}\) ; en \(x = p\) (donc \(x + q = 1\)) et après multiplication par \(p^2\), \(\mathbb{E}(X(X-1)) = \sum_k k(k-1)\binom{n}{k} p^{k} q^{n-k} = n(n-1)p^2\). Avec \(\mathbb{E}(X) = np\), \(\mathbb{E}(X^2) = n(n-1)p^2 + np\), d'où \(\mathrm{V}(X) = np(1-p)\). (Retrouvée par l'identité de Bienaymé à la sous-section 2.3.)
- Uniforme \(\mathcal{U}(\{1 \virgule \dots \virgule n\})\). \(\mathbb{E}(X^2) = \frac{(n+1)(2n+1)}{6}\), \(\mathbb{E}(X) = \frac{n+1}{2}\), donc \(\mathrm{V}(X) = \frac{(n+1)(n-1)}{12} = \frac{n^2-1}{12}\).
- Géométrique \(\mathcal{G}(p)\). En utilisant \(\mathbb{E}(X) = 1/p\) et \(\mathbb{E}(X^2) = (2-p)/p^2\) : \(\mathrm{V}(X) = \frac{2-p}{p^2} - \frac{1}{p^2} = \frac{1-p}{p^2}\).
- Poisson \(\mathcal{P}(\lambda)\). En utilisant \(\mathbb{E}(X^2) = \lambda^2 + \lambda\) : \(\mathrm{V}(X) = \lambda^2 + \lambda - \lambda^2 = \lambda\).
Compétences à pratiquer
- Calculer une variance
II.3
Covariance et identité de Bienaymé
La covariance généralise la variance aux couples de variables. La formule de König-Huygens pour la covariance donne sa forme calculatoire ; la bilinéarité donne la variance d'une somme (identité de Bienaymé). La covariance est aussi le terme correctif exact à la formule du produit de la sous-section 1.4 en l'absence d'indépendance.
Définition — Covariance, variables décorrélées
Soient \(X, Y\) deux variables aléatoires discrètes réelles dans \(L^2\). La covariance de \(X\) et \(Y\) est le réel $$ \mathrm{Cov}(X \virgule Y) \,=\, \mathbb{E}\!\left( (X - \mathbb{E}(X))(Y - \mathbb{E}(Y)) \right), $$ bien définie car \((X - \mathbb{E}(X))(Y - \mathbb{E}(Y)) \in L^1\) par Cauchy-Schwarz (sous-section 2.1). On dit que \(X\) et \(Y\) sont décorrélées lorsque \(\mathrm{Cov}(X \virgule Y) = 0\). Proposition — Formule de König-Huygens pour la covariance
Pour tous \(X, Y\) variables aléatoires discrètes réelles dans \(L^2\), $$ \mathrm{Cov}(X \virgule Y) \,=\, \mathbb{E}(XY) - \mathbb{E}(X) \mathbb{E}(Y). $$ En particulier, \(\mathrm{Cov}(X \virgule X) = \mathrm{V}(X)\).
Développer et utiliser la linéarité (avec \(\mathbb{E}(X), \mathbb{E}(Y)\) constantes) : $$ \begin{aligned} \mathrm{Cov}(X \virgule Y) &\,=\, \mathbb{E}\!\left( XY - X\mathbb{E}(Y) - \mathbb{E}(X)Y + \mathbb{E}(X)\mathbb{E}(Y) \right) \\
&\,=\, \mathbb{E}(XY) - \mathbb{E}(X)\mathbb{E}(Y) - \mathbb{E}(X)\mathbb{E}(Y) + \mathbb{E}(X)\mathbb{E}(Y) \\
&\,=\, \mathbb{E}(XY) - \mathbb{E}(X)\mathbb{E}(Y). \end{aligned} $$
Proposition — Bilinéarité et symétrie de la covariance
L'application \((X \virgule Y) \mapsto \mathrm{Cov}(X \virgule Y)\) sur \(L^2 \times L^2\) est bilinéaire et symétrique, et vérifie \(\mathrm{Cov}(X \virgule X) = \mathrm{V}(X) \ge 0\). Cauchy-Schwarz appliqué aux variables centrées donne la majoration $$ |\mathrm{Cov}(X \virgule Y)| \,\le\, \sigma(X) \, \sigma(Y). $$
La bilinéarité vient de la linéarité de \(\mathbb{E}\) : chaque argument entre linéairement dans la forme de König-Huygens \(\mathrm{Cov}(X \virgule Y) = \mathbb{E}(XY) - \mathbb{E}(X)\mathbb{E}(Y)\). La symétrie se lit sur la définition. Et \(\mathrm{Cov}(X \virgule X) = \mathrm{V}(X) \ge 0\). La majoration est Cauchy-Schwarz appliqué aux variables centrées \(X - \mathbb{E}(X)\) et \(Y - \mathbb{E}(Y)\) : \(|\mathrm{Cov}(X \virgule Y)|^2 = \mathbb{E}((X - \mathbb{E}(X))(Y - \mathbb{E}(Y)))^2 \le \mathrm{V}(X)\mathrm{V}(Y) = \sigma(X)^2 \sigma(Y)^2\).
Proposition — Variables indépendantes décorrélées
Si \(X, Y\) sont deux variables aléatoires discrètes réelles indépendantes dans \(L^2\), alors \(\mathrm{Cov}(X \virgule Y) = 0\).Attention : la réciproque est fausse — décorrélées n'implique pas indépendantes (contre-exemple ci-dessous).
L'indépendance donne \(\mathbb{E}(XY) = \mathbb{E}(X)\mathbb{E}(Y)\) (Théorème de la sous-section 1.4) ; König-Huygens donne ensuite \(\mathrm{Cov}(X \virgule Y) = \mathbb{E}(XY) - \mathbb{E}(X)\mathbb{E}(Y) = 0\).
Exemple — Décorrélées mais dépendantes
Soient \(X \sim \mathcal{U}(\{-1 \virgule 0 \virgule 1\})\) et \(Y = X^2\). Alors \(\mathbb{E}(X) = 0\) et \(\mathbb{E}(XY) = \mathbb{E}(X^3) = \frac{(-1)^3 + 0 + 1^3}{3} = 0\), donc \(\mathrm{Cov}(X \virgule Y) = 0\) : les deux variables sont décorrélées. Pourtant \(Y\) est une fonction déterministe de \(X\), manifestement non indépendante de celui-ci (par exemple \(\mathbb{P}(X = 0 \virgule Y = 1) = 0 \ne \frac{1}{3} \cdot \frac{2}{3} = \mathbb{P}(X = 0)\mathbb{P}(Y = 1)\)). Théorème — Variance d'une somme — identité de Bienaymé
Pour des variables aléatoires discrètes réelles \(X_1 \virgule \dots \virgule X_n\) dans \(L^2\), $$ \mathrm{V}\!\left( \sum_{i=1}^n X_i \right) \,=\, \sum_{i=1}^n \mathrm{V}(X_i) + 2 \sum_{1 \le i < j \le n} \mathrm{Cov}(X_i \virgule X_j). $$ En particulier, si les \(X_1 \virgule \dots \virgule X_n\) sont deux à deux décorrélées (en particulier si elles sont mutuellement indépendantes), $$ \mathrm{V}\!\left( \sum_{i=1}^n X_i \right) \,=\, \sum_{i=1}^n \mathrm{V}(X_i). $$
En utilisant \(\mathrm{Cov}(X \virgule X) = \mathrm{V}(X)\), la bilinéarité et la symétrie de la covariance : $$ \begin{aligned} \mathrm{V}\!\left( \sum_i X_i \right) &\,=\, \mathrm{Cov}\!\left( \sum_i X_i \virgule \sum_j X_j \right) && \text{(la variance est \(\mathrm{Cov}\) sur la diagonale)} \\
&\,=\, \sum_{i, j} \mathrm{Cov}(X_i \virgule X_j) && \text{(bilinéarité)} \\
&\,=\, \sum_i \mathrm{V}(X_i) + 2 \sum_{i < j} \mathrm{Cov}(X_i \virgule X_j) && \text{(symétrie de \(\mathrm{Cov}\))}. \end{aligned} $$ La décorrélation deux à deux annule chaque terme croisé, ne laissant que la somme diagonale des variances.
Exemple — Variance d'une binomiale via Bienaymé
Décomposer \(X \sim \mathcal{B}(n \virgule p)\) en \(X = X_1 + \dots + X_n\) avec \(X_i \sim \mathcal{B}(p)\) indépendantes. Chaque \(X_i\) a une variance \(p(1-p)\) (sous-section 2.2). Par Bienaymé, $$ \mathrm{V}(X) \,=\, \sum_{i=1}^n \mathrm{V}(X_i) \,=\, np(1-p). $$ La même valeur que le calcul de König-Huygens de la sous-section 2.2 — deux routes vers un même résultat. Méthode — Calculer une variance
Trois voies ; prendre la moins chère.- König-Huygens. Calculer \(\mathbb{E}(X)\) et \(\mathbb{E}(X^2)\), puis \(\mathrm{V}(X) = \mathbb{E}(X^2) - \mathbb{E}(X)^2\). Utiliser la formule de transfert et les astuces de forme close de la sous-section 1.2.
- Identité de Bienaymé. Si \(X = X_1 + \dots + X_n\) avec les \(X_i\) deux à deux décorrélées (en particulier mutuellement indépendantes), calculer chaque \(\mathrm{V}(X_i)\) et sommer.
- Fonction génératrice. Pour \(X\) à valeurs dans \(\mathbb{N}\) avec un \(G_X\) connu, utiliser \(\mathrm{V}(X) = G_X''(1^-) + G_X'(1^-) - G_X'(1^-)^2\) (sous-section 3.3). Particulièrement efficace pour les lois géométrique et de Poisson.
Compétences à pratiquer
- Appliquer l'identité de Bienaymé et la covariance
III
Fonctions génératrices d'une variable aléatoire à valeurs dans \(\mathbb{N}\)
Pour une variable aléatoire à valeurs dans \(\mathbb{N}\), la fonction génératrice \(G_X(t) = \mathbb{E}(t^X) = \sum_{n \ge 0} \mathbb{P}(X = n) t^n\) est une série entière à coefficients positifs de masse totale \(1\). C'est l'outil adapté aux probabilités à valeurs dans \(\mathbb{N}\) pour trois raisons : elle détermine la loi de manière unique ; l'indépendance devient une multiplication, \(G_{X+Y} = G_X G_Y\) ; et les moments se lisent sur ses dérivées en \(1\). Le chapitre Séries entières fournit tous les faits analytiques utilisés ici.
III.1
Définition, rayon de convergence
La fonction génératrice est une série entière avec deux particularités : tous les coefficients \(\mathbb{P}(X = n)\) sont dans \([0 \virgule 1]\), et leur total \(\sum_n \mathbb{P}(X = n) = 1\). Ensemble, ils forcent le rayon de convergence à être au moins \(1\), de sorte que \(G_X\) est définie sur \([-1 \virgule 1]\) et infiniment dérivable sur \(]-1 \virgule 1[\).
Définition — Fonction génératrice
Soit \(X\) une variable aléatoire discrète avec \(X(\Omega) \subset \mathbb{N}\). La fonction génératrice de \(X\) est la série entière à coefficients positifs \(\mathbb{P}(X = n)\), $$ G_X(t) \,=\, \sum_{n = 0}^{+\infty} \mathbb{P}(X = n) \, t^n. $$ Par la formule de transfert, \(G_X(t) = \mathbb{E}(t^X)\) pour tout \(t\) où la série converge absolument. Proposition — Rayon et régularité de \(G_X\)
Le rayon de convergence \(R\) de \(G_X\) vérifie \(R \ge 1\). La fonction \(G_X\) est définie sur l'intervalle fermé \([-1 \virgule 1]\) et de classe \(\mathcal{C}^\infty\) sur l'intervalle ouvert \(]-1 \virgule 1[\), avec \(G_X(1) = 1\).
En \(t = 1\) la série \(\sum_n \mathbb{P}(X = n) = 1\) converge, donc \(R \ge 1\) ; la même majoration \(|\mathbb{P}(X = n) t^n| \le \mathbb{P}(X = n)\) montre la convergence absolue en \(t = -1\) aussi, donc \(G_X\) est définie sur \([-1 \virgule 1]\). Sur l'intervalle ouvert \(]-1 \virgule 1[ \subset ]-R \virgule R[\), une série entière est \(\mathcal{C}^\infty\) (chapitre Séries entières) ; c'est pourquoi la régularité n'est affirmée que sur l'intervalle ouvert. À l'extrémité \(t = 1\) la série converge, donc \(G_X(1) = \sum_n \mathbb{P}(X = n) = 1\) est définie, mais \(G_X\) peut ne pas y être dérivable : pour une loi telle que \(\mathbb{E}(X) = +\infty\) (par exemple la loi à queue lourde \(\mathbb{P}(X = n) = c/n^2\)) le rayon vaut exactement \(1\) et la dérivée à gauche \(G_X'(1^-)\) diverge. La définition aux deux extrémités est admise à ce niveau ; aucune régularité n'y est affirmée.
Proposition — La loi est déterminée par \(G_X\)
Pour tout \(n \in \mathbb{N}\), \(\mathbb{P}(X = n) = G_X^{(n)}(0)/n!\). En conséquence la loi de \(X\) est uniquement déterminée par \(G_X\) : deux variables aléatoires à valeurs dans \(\mathbb{N}\) de mêmes fonctions génératrices ont même loi.
Par la formule des coefficients de Taylor de la somme d'une série entière (chapitre Séries entières), \(G_X^{(n)}(0) = n! \, \mathbb{P}(X = n)\), d'où la formule. Du même \(G_X\) on lit la même suite de coefficients \((\mathbb{P}(X = n))\), ce qui est exactement la loi sur \(\mathbb{N}\).
Exemple — Fonctions génératrices des lois usuelles
Référence rapide (table complète à la sous-section 4.3) : \(\mathcal{B}(p) \to (1-p) + pt\) ; \(\mathcal{B}(n \virgule p) \to ((1-p) + pt)^n\) ; \(\mathcal{U}(\{1 \virgule \dots \virgule n\}) \to (t + t^2 + \dots + t^n)/n\) ; \(\mathcal{G}(p) \to pt/(1 - (1-p)t)\) ; \(\mathcal{P}(\lambda) \to \mathrm{e}^{\lambda(t-1)}\). Exemple — Le rayon peut dépasser \(1\)
Pour une loi à support fini (Bernoulli, binomiale, uniforme) la fonction génératrice est un polynôme, donc \(R = +\infty\). Pour \(\mathcal{G}(p)\) avec \(0 < p < 1\), \(G_X(t) = pt/(1 - qt)\) a pour rayon \(R = 1/q > 1\). Pour \(\mathcal{P}(\lambda)\), \(G_X(t) = \mathrm{e}^{\lambda(t-1)}\) a pour rayon \(R = +\infty\). Dans chaque cas \(R \ge 1\) comme exigé ; la valeur précise dépend de la queue de la loi. Compétences à pratiquer
- Calculer et utiliser une fonction génératrice
III.2
Indépendance et formule du produit
L'usage phare des fonctions génératrices : pour des variables indépendantes à valeurs dans \(\mathbb{N}\), les fonctions génératrices se multiplient. L'application est la détermination de la loi d'une somme indépendante sans jamais écrire la distribution jointe.
Théorème — Formule du produit pour les fonctions génératrices
Soient \(X, Y\) deux variables aléatoires discrètes indépendantes avec \(X(\Omega), Y(\Omega) \subset \mathbb{N}\), et \(R_X, R_Y\) les rayons de \(G_X, G_Y\). Alors pour tout \(t\) avec \(|t| < \min(R_X \virgule R_Y)\), $$ G_{X + Y}(t) \,=\, G_X(t) \, G_Y(t). $$
Par indépendance, \(\mathbb{P}(X + Y = n) = \sum_{k=0}^n \mathbb{P}(X = k) \mathbb{P}(Y = n - k)\). C'est exactement le coefficient de \(t^n\) dans le produit des deux séries entières \(G_X\) et \(G_Y\) (la règle du produit de Cauchy des séries entières, chapitre Séries entières, admise à ce niveau). Donc \(G_X(t) G_Y(t)\) et \(G_{X+Y}(t)\) sont deux séries entières de coefficients identiques, donc égales sur le disque de convergence commun.
Proposition — Extension à une somme finie
Pour \(X_1 \virgule \dots \virgule X_n\) des variables aléatoires discrètes mutuellement indépendantes à valeurs dans \(\mathbb{N}\), $$ G_{X_1 + \dots + X_n}(t) \,=\, G_{X_1}(t) \cdots G_{X_n}(t) $$ sur l'intersection des disques ouverts de convergence.
Récurrence sur \(n\), en appliquant la formule du produit et le lemme des coalitions (une fonction de \(X_1 \virgule \dots \virgule X_{n-1}\) est indépendante de \(X_n\)) comme dans la Proposition de la sous-section 1.4.
Proposition — Stabilité des familles de Poisson et binomiale
- Si \(X \sim \mathcal{P}(\lambda)\) et \(Y \sim \mathcal{P}(\mu)\) sont indépendantes, alors \(X + Y \sim \mathcal{P}(\lambda + \mu)\).
- Si \(X \sim \mathcal{B}(m \virgule p)\) et \(Y \sim \mathcal{B}(n \virgule p)\) sont indépendantes (même probabilité de succès \(p\)), alors \(X + Y \sim \mathcal{B}(m + n \virgule p)\).
- Poisson. \(G_{X+Y}(t) = \mathrm{e}^{\lambda(t-1)} \mathrm{e}^{\mu(t-1)} = \mathrm{e}^{(\lambda + \mu)(t-1)}\), la fonction génératrice de \(\mathcal{P}(\lambda + \mu)\) ; conclure par unicité de la loi (sous-section 3.1).
- Binomiale. \(G_{X+Y}(t) = ((1-p) + pt)^m ((1-p) + pt)^n = ((1-p) + pt)^{m+n}\), la fonction génératrice de \(\mathcal{B}(m + n \virgule p)\) ; conclure par unicité.
Méthode — Déterminer la loi de \(X + Y\) pour des variables indépendantes à valeurs dans \(\mathbb{N}\)
Trois étapes.- Calculer \(G_X(t)\) et \(G_Y(t)\). Utiliser la table de la sous-section 4.3, ou la définition \(\sum_n \mathbb{P}(X = n) t^n\).
- Multiplier. \(G_{X + Y}(t) = G_X(t) G_Y(t)\).
- Identifier. Si le produit correspond à une fonction génératrice usuelle, conclure la loi de \(X + Y\) par unicité ; sinon développer le produit en série entière et lire les coefficients comme \(\mathbb{P}(X + Y = n)\).
Compétences à pratiquer
- Déterminer la loi d'une somme via les fonctions génératrices
III.3
Moments à partir de la fonction génératrice
Les moments d'une variable à valeurs dans \(\mathbb{N}\) se lisent sur les dérivées de \(G_X\) en \(1\) (à gauche). On énonce les équivalences et les formules ; les implications réciproques (« \(G_X\) dérivable en \(1\) \(\Rightarrow\) \(X\) intégrable ») sont admises à ce niveau.
Théorème — Espérance à partir de la fonction génératrice
Soit \(X\) une variable aléatoire discrète avec \(X(\Omega) \subset \mathbb{N}\). Alors \(X\) admet une espérance finie si et seulement si \(G_X\) est dérivable à gauche en \(1\) avec une dérivée à gauche finie \(G_X'(1^-) \in \mathbb{R}\), et dans ce cas $$ \mathbb{E}(X) \,=\, G_X'(1^-) \,=\, \sum_{n \ge 1} n \, \mathbb{P}(X = n). $$
Sur \(]-1 \virgule 1[\) la série dérivée est \(G_X'(t) = \sum_{n \ge 1} n \, \mathbb{P}(X = n) t^{n-1}\) (chapitre Séries entières), à coefficients positifs. Pour \(t \in [0 \virgule 1)\), \(G_X'(t) = \sum_{n \ge 1} n \, \mathbb{P}(X = n) t^{n-1}\) croît vers \(\sum_{n \ge 1} n \, \mathbb{P}(X = n) = \mathbb{E}(X) \in [0 \virgule +\infty]\) lorsque \(t \to 1^-\). L'identification de cette limite à la dérivée à gauche \(G_X'(1^-)\), et l'implication réciproque, sont admises (la démonstration de la réciproque n'est pas exigible à ce niveau).
Théorème — Variance à partir de la fonction génératrice
Soit \(X\) une variable aléatoire discrète avec \(X(\Omega) \subset \mathbb{N}\). Alors \(X \in L^2\) si et seulement si \(G_X\) est deux fois dérivable à gauche en \(1\) avec des dérivées à gauche finies \(G_X'(1^-), G_X''(1^-) \in \mathbb{R}\), et dans ce cas $$ \mathbb{E}(X(X - 1)) \,=\, G_X''(1^-), \qquad \mathrm{V}(X) \,=\, G_X''(1^-) + G_X'(1^-) - G_X'(1^-)^2. $$
Appliquer le même argument de limite que dans le Théorème précédent à la série deux fois dérivée \(G_X''(t) = \sum_{n \ge 2} n(n-1) \mathbb{P}(X = n) t^{n-2}\), dont les coefficients positifs ont pour somme \(\mathbb{E}(X(X-1))\) ; l'identification de la limite à \(G_X''(1^-)\) est admise. Puis \(\mathbb{E}(X^2) = \mathbb{E}(X(X-1)) + \mathbb{E}(X)\) et König-Huygens donnent $$ \mathrm{V}(X) = \mathbb{E}(X^2) - \mathbb{E}(X)^2 = \big(G_X''(1^-) + G_X'(1^-)\big) - G_X'(1^-)^2. $$
Exemple — Géométrique : \(\mathbb{E}\) et \(\mathrm{V}\) à partir de \(G_X\)
Pour \(X \sim \mathcal{G}(p)\) avec \(0 < p < 1\), \(G_X(t) = pt/(1 - qt)\) où \(q = 1 - p\) (rayon \(1/q > 1\), donc \(G_X\) est \(\mathcal{C}^\infty\) en \(1\) et les dérivées à gauche sont des dérivées ordinaires) : $$ G_X'(t) = \frac{p}{(1 - qt)^2}, \quad G_X'(1) = \frac{1}{p} = \mathbb{E}(X) ; \qquad G_X''(t) = \frac{2pq}{(1 - qt)^3}, \quad G_X''(1) = \frac{2q}{p^2}, $$ $$ \mathrm{V}(X) = G_X''(1) + G_X'(1) - G_X'(1)^2 = \frac{2q}{p^2} + \frac{1}{p} - \frac{1}{p^2} = \frac{q}{p^2} = \frac{1-p}{p^2}. $$ Exemple — Poisson : \(\mathbb{E}\) et \(\mathrm{V}\) à partir de \(G_X\)
Pour \(X \sim \mathcal{P}(\lambda)\), \(G_X(t) = \mathrm{e}^{\lambda(t - 1)}\) (rayon \(+\infty\)) : $$ G_X'(t) = \lambda \mathrm{e}^{\lambda(t-1)}, \quad G_X'(1) = \lambda = \mathbb{E}(X) ; \qquad G_X''(1) = \lambda^2, $$ $$ \mathrm{V}(X) = \lambda^2 + \lambda - \lambda^2 = \lambda. $$ L'identité \(\mathbb{E}(X) = \mathrm{V}(X) = \lambda\) de la loi de Poisson tombe en deux lignes. Méthode — Calculer \(\mathbb{E}(X)\) et \(\mathrm{V}(X)\) via \(G_X\)
Quatre étapes.- Calculer \(G_X(t)\). À partir de la table de la sous-section 4.3, ou de la définition.
- Dériver. Calculer \(G_X'(t)\) et \(G_X''(t)\) sur la forme close.
- Évaluer en \(1\). Lire \(\mathbb{E}(X) = G_X'(1^-)\) et \(\mathbb{E}(X(X-1)) = G_X''(1^-)\). Pour une loi de rayon \(R > 1\) — ce qui est le cas des cinq lois usuelles — \(G_X\) est \(\mathcal{C}^\infty\) près de \(1\), donc ce sont des dérivées ordinaires en \(1\).
- Combiner. \(\mathrm{V}(X) = G_X''(1^-) + G_X'(1^-) - G_X'(1^-)^2\). Particulièrement efficace pour les lois géométrique et de Poisson.
Compétences à pratiquer
- Calculer \(\mathbb{E}\) et \(\mathrm{V}\) via la fonction génératrice
IV
Inégalités probabilistes et loi faible des grands nombres
Deux inégalités de queue — Markov et Bienaymé-Tchebychev — contrôlent la probabilité qu'une variable prenne des valeurs éloignées de sa moyenne, en n'utilisant que ses moments plutôt que sa loi entière. Leur conséquence phare est la loi faible des grands nombres, qui ajuste la moyenne empirique de variables indépendantes et identiquement distribuées à la moyenne théorique.
IV.1
Inégalités de Markov et de Bienaymé-Tchebychev
L'enchaînement est court : Markov ne nécessite que \(\mathbb{E}(X)\), et Bienaymé-Tchebychev s'en déduit en appliquant Markov à \((X - \mathbb{E}(X))^2\).
Théorème — Inégalité de Markov
Soit \(X\) une variable aléatoire discrète réelle avec \(X \ge 0\) et d'espérance finie. Alors pour tout \(a > 0\), $$ \mathbb{P}(X \ge a) \,\le\, \frac{\mathbb{E}(X)}{a}. $$
L'inégalité clef est ponctuelle sur \(\Omega\) : \(a \, \mathbf{1}_{\{X \ge a\}} \le X\). En effet, sur \(\{X < a\}\) le membre de gauche vaut \(0\) et celui de droite est \(\ge 0\) ; sur \(\{X \ge a\}\) le membre de gauche vaut \(a\) et celui de droite est \(\ge a\). Prendre l'espérance par croissance : \(a \, \mathbb{P}(X \ge a) = \mathbb{E}(a \mathbf{1}_{\{X \ge a\}}) \le \mathbb{E}(X)\), puis diviser par \(a > 0\).
Théorème — Inégalité de Bienaymé-Tchebychev
Soit \(X\) une variable aléatoire discrète réelle dans \(L^2\) et \(\varepsilon > 0\). Alors $$ \mathbb{P}(|X - \mathbb{E}(X)| \ge \varepsilon) \,\le\, \frac{\mathrm{V}(X)}{\varepsilon^2}. $$
Appliquer Markov à la variable positive \(Y = (X - \mathbb{E}(X))^2\) (d'espérance finie \(\mathrm{V}(X)\)) avec seuil \(\varepsilon^2\) : $$ \mathbb{P}(|X - \mathbb{E}(X)| \ge \varepsilon) \,=\, \mathbb{P}((X - \mathbb{E}(X))^2 \ge \varepsilon^2) \,\le\, \frac{\mathbb{E}((X - \mathbb{E}(X))^2)}{\varepsilon^2} \,=\, \frac{\mathrm{V}(X)}{\varepsilon^2}. $$
Exemple — Une borne numérique sur un écart
Pour \(X \sim \mathcal{G}(1/4)\), \(\mathbb{E}(X) = 4\) et \(\mathrm{V}(X) = (3/4)/(1/16) = 12\). Bienaymé-Tchebychev avec \(\varepsilon = 10\) : $$ \mathbb{P}(|X - 4| \ge 10) \,\le\, \frac{12}{100} \,=\, 0{,}12. $$ Une borne grossière mais peu chère : elle n'utilise que la moyenne et la variance. La queue exacte \(\mathbb{P}(X \ge 14) = (3/4)^{13} \approx 0{,}024\) est bien plus petite — le prix de l'usage de deux moments au lieu de la loi entière. Exemple — Visualiser Bienaymé-Tchebychev comme une bande centrale
La masse de la loi se concentre sur la bande centrale \([\mu - \varepsilon \virgule \mu + \varepsilon]\) autour de \(\mu = \mathbb{E}(X)\) ; les deux queues hors de la bande portent une masse cumulée au plus égale à \(\mathrm{V}(X)/\varepsilon^2\). 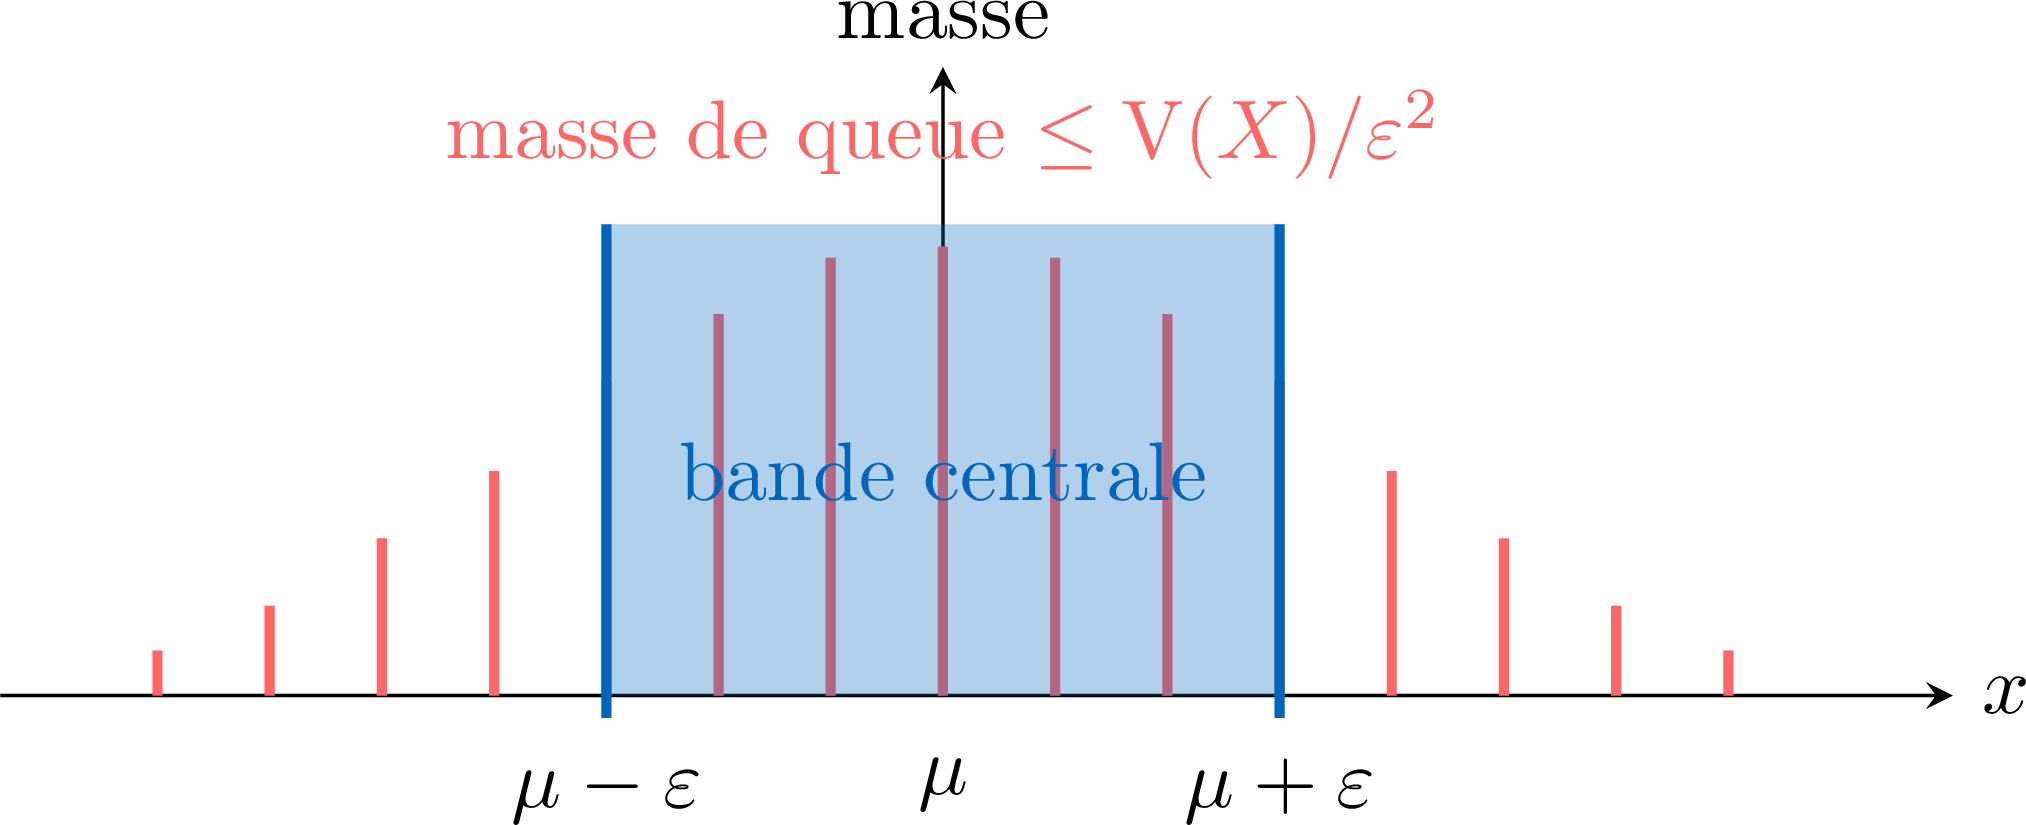
Méthode — Majorer une probabilité par Markov ou Bienaymé-Tchebychev
Deux schémas.- Markov sur \(X \ge 0\). Pour majorer \(\mathbb{P}(X \ge a)\) avec \(X\) positive : estimer \(\mathbb{E}(X)\), diviser par \(a\). Peu cher, souvent peu serré, toujours disponible.
- Bienaymé-Tchebychev pour les écarts à la moyenne. Pour majorer \(\mathbb{P}(|X - \mathbb{E}(X)| \ge \varepsilon)\) avec \(X \in L^2\) : estimer \(\mathrm{V}(X)\), diviser par \(\varepsilon^2\). La borne décroît en \(1/\varepsilon^2\) avec l'écart — plus serrée que Markov sur \(|X - \mathbb{E}(X)|\). Ce sont les outils standards pour établir une inégalité de concentration.
Compétences à pratiquer
- Majorer une probabilité par Markov ou Bienaymé-Tchebychev
IV.2
La loi faible des grands nombres
La moyenne empirique de variables indépendantes et identiquement distribuées de variance finie converge, en probabilité, vers l'espérance commune. La démonstration tient en une ligne : Bienaymé-Tchebychev appliqué à \(S_n/n\), dont la variance décroît en \(\sigma^2/n\) par l'identité de Bienaymé.
Théorème — Loi faible des grands nombres
Soit \((X_n)_{n \ge 1}\) une suite de variables aléatoires discrètes réelles indépendantes et identiquement distribuées de variance finie, d'espérance commune \(m = \mathbb{E}(X_1)\) et de variance commune \(\sigma^2 = \mathrm{V}(X_1)\). Posons \(S_n = X_1 + \dots + X_n\). Alors pour tout \(\varepsilon > 0\), $$ \mathbb{P}\!\left( \left| \frac{S_n}{n} - m \right| \ge \varepsilon \right) \,\le\, \frac{\sigma^2}{n \varepsilon^2} \,\xrightarrow[n \to \infty]{}\, 0. $$
La linéarité donne \(\mathbb{E}(S_n/n) = \frac{1}{n} \sum_{i=1}^n \mathbb{E}(X_i) = m\). Les variables étant indépendantes (a fortiori deux à deux décorrélées), l'identité de Bienaymé donne \(\mathrm{V}(S_n) = \sum_{i=1}^n \mathrm{V}(X_i) = n\sigma^2\), d'où \(\mathrm{V}(S_n/n) = \frac{1}{n^2} \cdot n\sigma^2 = \sigma^2/n\). Bienaymé-Tchebychev appliqué à \(S_n/n\) : $$ \mathbb{P}\!\left( \left| \frac{S_n}{n} - m \right| \ge \varepsilon \right) \,\le\, \frac{\mathrm{V}(S_n/n)}{\varepsilon^2} \,=\, \frac{\sigma^2}{n \varepsilon^2} \,\xrightarrow[n \to \infty]{}\, 0. $$ (Seules la décorrélation deux à deux et une espérance et variance communes sont utilisées : la conclusion vaut verbatim sous cette hypothèse plus faible.)
Exemple — Fréquence empirique d'une suite de Bernoulli
Soit \((X_i)_{i \ge 1}\) i.i.d.\ \(\mathcal{B}(p)\) (par ex.\ des lancers indépendants d'une pièce biaisée). Chaque \(X_i\) a \(\mathbb{E}(X_i) = p\) et \(\mathrm{V}(X_i) = p(1-p)\). La fréquence empirique des \(1\) parmi les \(n\) premiers essais est \(S_n/n\), et la loi faible donne, pour tout \(\varepsilon > 0\), $$ \mathbb{P}\!\left( \left| \frac{S_n}{n} - p \right| \ge \varepsilon \right) \,\le\, \frac{p(1-p)}{n \varepsilon^2} \,\xrightarrow[n \to \infty]{}\, 0. $$ C'est la justification formelle de « probabilité = fréquence à long terme » : pour \(n\) grand, la fréquence empirique est à \(\varepsilon\) près de \(p\) avec une probabilité arbitrairement proche de \(1\). L'histogramme de \(S_n/n\) se concentre en \(p\) à mesure que \(n\) croît. 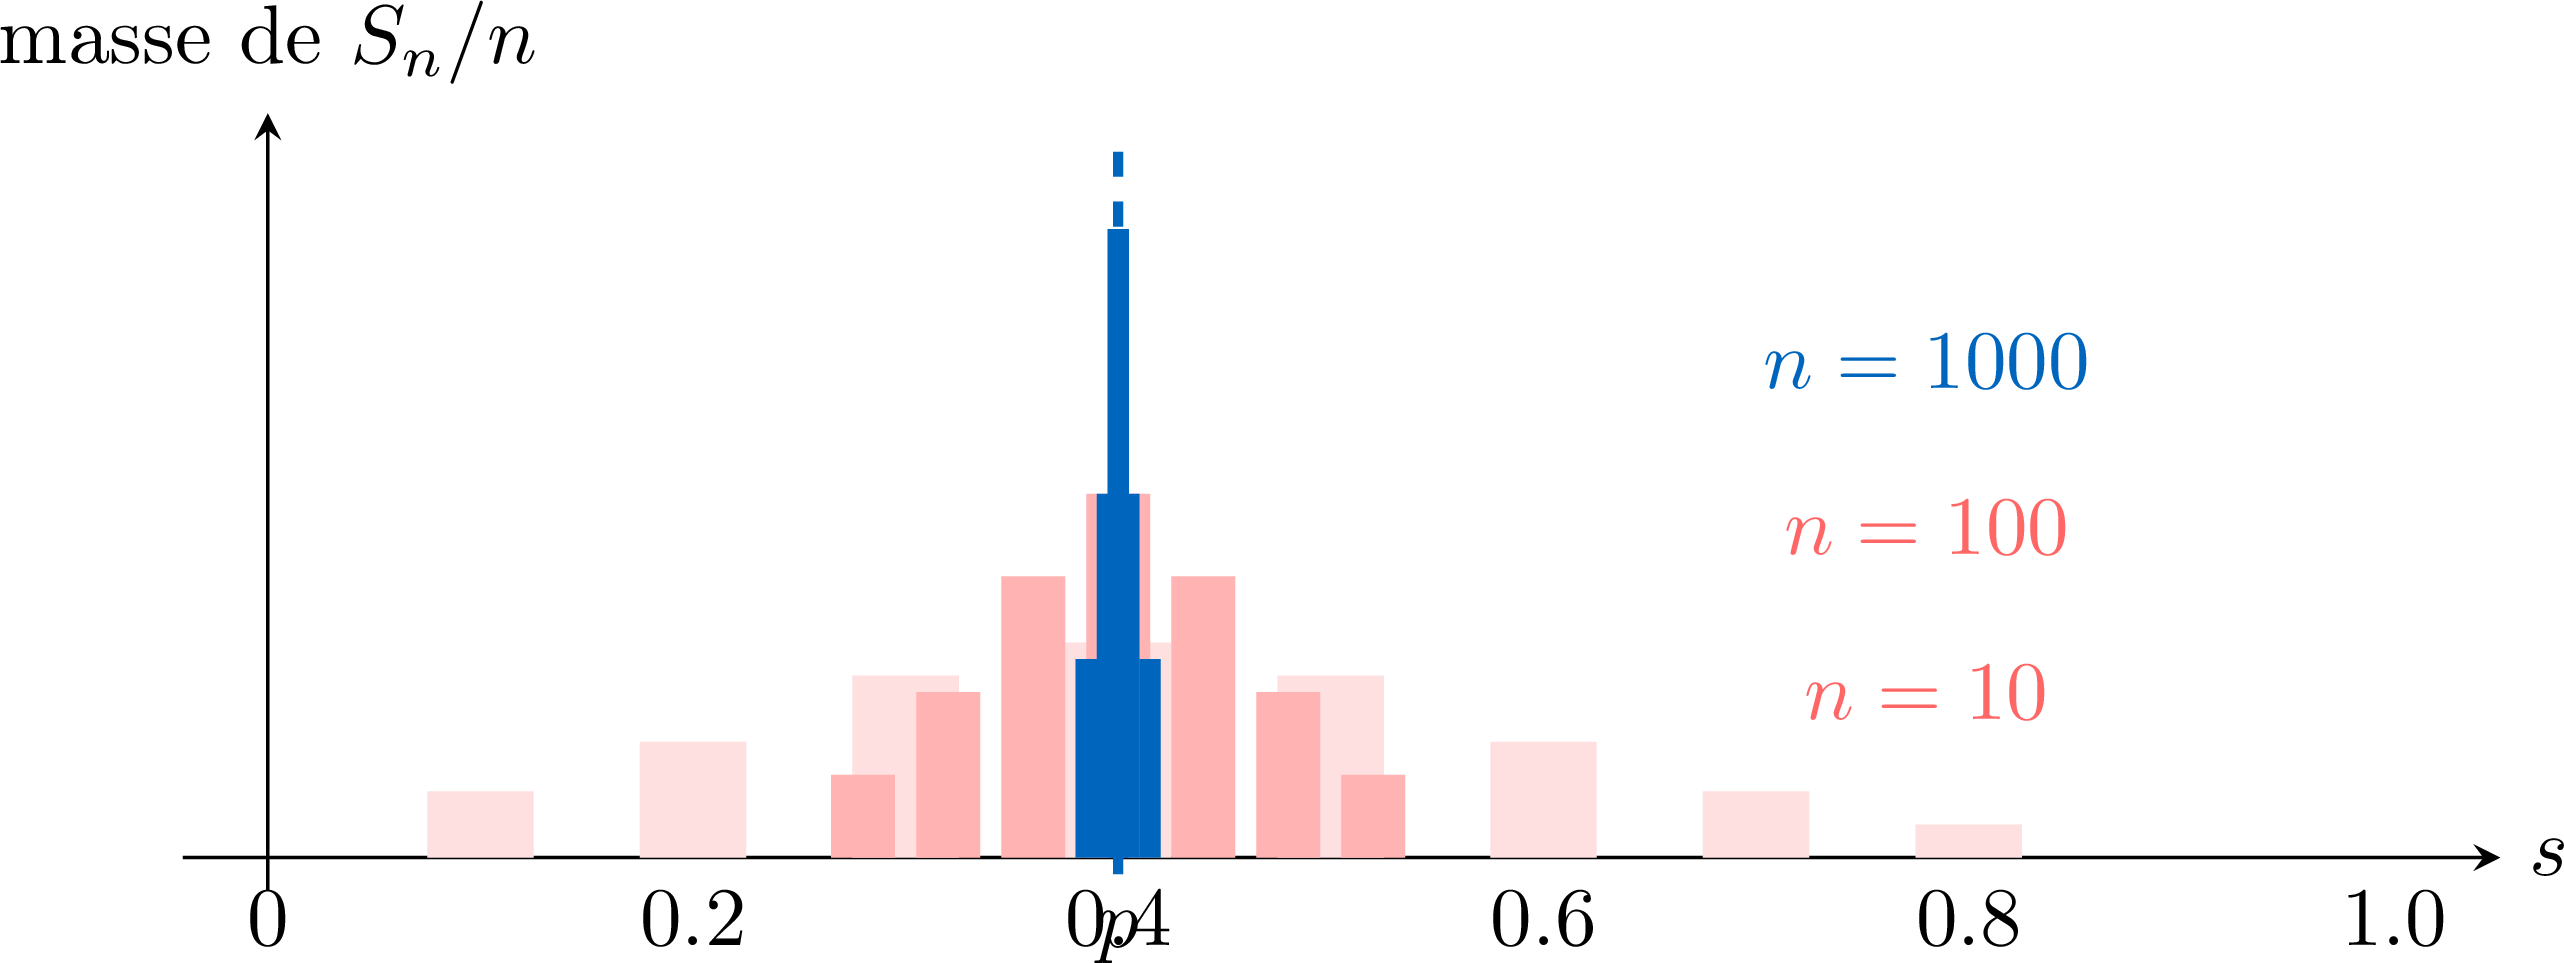
Méthode — Appliquer la loi faible des grands nombres
Quatre étapes.- Identifier la famille. Reconnaître \(S_n = X_1 + \dots + X_n\) avec les \(X_i\) i.i.d.\ (ou au moins deux à deux décorrélées et identiquement distribuées) de variance finie.
- Calculer \(m\) et \(\sigma^2\). Trouver \(m = \mathbb{E}(X_1)\) et \(\sigma^2 = \mathrm{V}(X_1)\) par les méthodes des sous-section 1.5 et sous-section 2.2.
- Appliquer la borne. \(\mathbb{P}(|S_n/n - m| \ge \varepsilon) \le \sigma^2/(n\varepsilon^2)\) pour tout \(\varepsilon > 0\).
- Conclure. La borne tend vers \(0\), donc \(S_n/n\) converge en probabilité vers \(m\). Pour une précision cible \((\varepsilon \virgule \delta)\), exiger \(\sigma^2/(n\varepsilon^2) \le \delta\), soit \(n \ge \sigma^2/(\delta\varepsilon^2)\).
Compétences à pratiquer
- Appliquer la loi faible des grands nombres
IV.3
Synthèse : les lois usuelles
Une table de référence à mémoriser : le support, l'espérance, la variance et la fonction génératrice des cinq lois usuelles, chacune dérivée une fois dans les sections précédentes.
Table de synthèse — les lois usuelles
| Loi | Notation | \(G_X(t)\) | \(\mathbb{E}(X)\) | \(\mathrm{V}(X)\) |
| Bernoulli | \(\mathcal{B}(p)\) | \((1-p) + pt\) | \(p\) | \(p(1-p)\) |
| Binomiale | \(\mathcal{B}(n \virgule p)\) | \(((1-p) + pt)^n\) | \(np\) | \(np(1-p)\) |
| Uniforme | \(\mathcal{U}(\{1 \virgule \dots \virgule n\})\) | \((t + \dots + t^n)/n\) | \((n+1)/2\) | \((n^2-1)/12\) |
| Géométrique | \(\mathcal{G}(p)\) | \(pt/(1 - (1-p)t)\) | \(1/p\) | \((1-p)/p^2\) |
| Poisson | \(\mathcal{P}(\lambda)\) | \(\mathrm{e}^{\lambda(t-1)}\) | \(\lambda\) | \(\lambda\) |
Compétences à pratiquer
- Utiliser la table de synthèse
V
Pour aller plus loin : problèmes de synthèse de niveau concours
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section