Éducation Nationale Française · PTSI
Applications linéaires
Une application linéaire est l'application qui préserve la structure entre deux espaces vectoriels. Elle est aux espaces vectoriels ce que les morphismes de groupes sont aux groupes et les morphismes d'anneaux aux anneaux : une fonction qui commute avec les deux opérations de la structure — addition et multiplication par un scalaire. Les applications linéaires sont les « ponts » le long desquels les familles génératrices, les familles libres, les bases et les décompositions en somme directe se transportent d'un espace vectoriel vers un autre.
En dimension finie, le théorème du rang relie deux nombres attachés à une application linéaire \(f : E \to F\) — la dimension de \(\mathrm{Ker}\,f\) (combien de degrés de liberté s'effondrent) et le rang \(\mathrm{rg}(f) = \dim \mathrm{Im}\,f\) (combien de degrés de liberté atterrissent dans \(F\)). Leur somme vaut \(\dim E\) : une loi de conservation des degrés de liberté qui régit presque tous les arguments de dimension du chapitre.
Le chapitre se termine par deux applications géométriques : projecteurs et symétries associés à une décomposition en somme directe, et formes linéaires et hyperplans, qui décrivent les sous-espaces de codimension \(1\). Tout au long, \(\mathbb{K}\) désigne \(\mathbb{R}\) ou \(\mathbb{C}\) (hypothèse nécessaire dans la démonstration de la caractérisation des symétries, où l'on divise par \(2\)). L'étude systématique du dual et des bases duales est hors programme (« L'étude de la dualité est hors programme ») ; les formes coordonnées ne sont introduites qu'en tant qu'outil pratique pour écrire des équations d'hyperplans.
I
Applications linéaires : définition et structure
I.1
Définition d'une application linéaire
La définition de départ est courte : une application linéaire est une fonction d'un espace vectoriel dans un espace vectoriel qui respecte les combinaisons linéaires. Deux opérations à préserver — l'addition et la multiplication par un scalaire — donnent deux axiomes, que nous regrouperons sous peu en une unique condition « à un scalaire ».
Définition — Application linéaire
Soient \(E\) et \(F\) deux \(\mathbb{K}\)-espaces vectoriels. Une application \(f : E \to F\) est dite linéaire si $$ \forall (x, y) \in E^2,\ \forall \lambda \in \mathbb{K} : \quad f(x + y) = f(x) + f(y) \quad \text{et} \quad f(\lambda x) = \lambda f(x). $$ L'ensemble des applications linéaires de \(E\) dans \(F\) est noté \(\textcolor{colordef}{\mathcal{L}(E, F)}\). Une application linéaire de \(E\) dans lui-même est appelée un endomorphisme de \(E\) ; l'ensemble des endomorphismes de \(E\) est noté \(\textcolor{colordef}{\mathcal{L}(E)}\). Une application linéaire \(E \to \mathbb{K}\) est appelée une forme linéaire sur \(E\). Conséquence immédiate. Pour toute \(f \in \mathcal{L}(E, F)\), \(f(0_E) = 0_F\) : en effet \(f(0_E) = f(0 \cdot 0_E) = 0 \cdot f(0_E) = 0_F\).
Proposition — Linéarité en un scalaire
Soit \(f : E \to F\) une application entre deux \(\mathbb{K}\)-espaces vectoriels. Alors \(f\) est linéaire si et seulement si $$ \forall (x, y) \in E^2,\ \forall \lambda \in \mathbb{K} : \quad f(\lambda x + y) = \lambda f(x) + f(y). $$ - Sens direct. Supposons \(f\) linéaire. Alors \(f(\lambda x + y) = f(\lambda x) + f(y) = \lambda f(x) + f(y)\) d'après les deux axiomes.
- Sens réciproque. Supposons que \(f\) vérifie l'identité « à un scalaire ». Déduisons les deux axiomes originaux en trois étapes.
- Étape 1 — \(f(0_E) = 0_F\). Appliquons l'identité avec \(\lambda = 1\) et \(x = y = 0_E\) : \(f(0_E + 0_E) = f(0_E) + f(0_E)\), soit \(f(0_E) = 2 f(0_E)\), donc \(f(0_E) = 0_F\).
- Étape 2 — multiplication par un scalaire. Appliquons l'identité avec \(y = 0_E\) et \(x \in E\), \(\lambda \in \mathbb{K}\) quelconques : \(f(\lambda x) = \lambda f(x) + f(0_E) = \lambda f(x)\).
- Étape 3 — addition. Appliquons l'identité avec \(\lambda = 1\) et \(x, y \in E\) quelconques : \(f(x + y) = f(x) + f(y)\).
Méthode — Montrer qu'une application est linéaire
Pour démontrer que \(f : E \to F\) est linéaire : vérifier l'identité « à un scalaire » \(f(\lambda x + y) = \lambda f(x) + f(y)\) pour \(x, y \in E\) et \(\lambda \in \mathbb{K}\) quelconques. Une vérification remplace les deux axiomes. Méthode — Montrer qu'une application n'est pas linéaire
Pour démontrer que \(f\) n'est pas linéaire : exhiber un défaut — soit \(f(0_E) \ne 0_F\), soit un couple concret \((x, y)\) tel que \(f(x + y) \ne f(x) + f(y)\), soit un couple concret \((\lambda, x)\) tel que \(f(\lambda x) \ne \lambda f(x)\). Exemple
L'identité \(\mathrm{Id}_E\) est un endomorphisme de \(E\). Plus généralement, pour tout \(\lambda \in \mathbb{K}\), l'homothétie \(\lambda \mathrm{Id}_E : x \mapsto \lambda x\) est un endomorphisme de \(E\). En dimension \(1\), les endomorphismes de \(E\) sont exactement les homothéties : si \((e)\) est une base et \(f(e) = \lambda e\), alors \(f(x e) = x f(e) = \lambda (x e)\), donc \(f = \lambda \mathrm{Id}_E\). Exemple
L'application \(f : \mathbb{R}^2 \to \mathbb{R}^3\) définie par \(f(x, y) = (2x - y, 3x + 2y, x + y)\) est linéaire. Vérification. Pour \((x, y), (x', y') \in \mathbb{R}^2\) et \(\lambda \in \mathbb{R}\), $$ \begin{aligned} f(\lambda (x, y) + (x', y')) &= f(\lambda x + x', \lambda y + y') \\ &= \bigl(2(\lambda x + x') - (\lambda y + y'), 3(\lambda x + x') + 2(\lambda y + y'), (\lambda x + x') + (\lambda y + y')\bigr) \\ &= \lambda (2x - y, 3x + 2y, x + y) + (2x' - y', 3x' + 2y', x' + y') \\ &= \lambda f(x, y) + f(x', y'). \end{aligned} $$
Exemple
Les deux applications \(g, h : \mathbb{R}^2 \to \mathbb{R}\) définies par \(g(x, y) = x + y + 1\) et \(h(x, y) = x^2 + y^2\) ne sont pas linéaires. Pour \(g\) : \(g(0, 0) = 1 \ne 0\), donc \(g(0_{\mathbb{R}^2}) \ne 0_\mathbb{R}\).
Pour \(h\) : \(h(2, 2) = 8\), mais \(2 h(1, 1) = 4\), donc \(h(2 \cdot (1, 1)) \ne 2 h(1, 1)\).
Exemple
Pour \(a \in \mathbb{K}\) fixé, l'application d'évaluation \(\mathrm{ev}_a : \mathbb{K}[X] \to \mathbb{K}\), \(P \mapsto P(a)\), est une forme linéaire sur \(\mathbb{K}[X]\). La dérivation \(D : \mathbb{K}[X] \to \mathbb{K}[X]\), \(P \mapsto P'\), est un endomorphisme de \(\mathbb{K}[X]\).
Exemple
L'application d'intégration \(\mathcal{C}([0, 1], \mathbb{R}) \to \mathbb{R}\), \(f \mapsto \int_0^1 f(t)\,\mathrm{d}t\), est une forme linéaire sur \(\mathcal{C}([0, 1], \mathbb{R})\) par linéarité de l'intégrale. Sur un intervalle \(I\), la dérivation \(\mathcal{C}^1(I, \mathbb{R}) \to \mathcal{C}(I, \mathbb{R})\), \(f \mapsto f'\), est une application linéaire par linéarité de la dérivée.
Compétences à pratiquer
- Reconnaître une application linéaire
- Vérifier directement la linéarité
I.2
Applications linéaires de référence et exemples géométriques
La linéarité se comprend mieux géométriquement. Les transformations géométriques usuelles de \(\mathbb{R}^2\) et \(\mathbb{R}^3\) qui fixent l'origine — rotations, homothéties, symétries et projections parallèlement à une direction fixée — sont des applications linéaires. Elles constituent les prototypes géométriques à garder en tête tout au long du chapitre.
Exemple — Rotation de \(\mathbb{R}^2\)
Pour \(\theta \in \mathbb{R}\), la rotation de \(\mathbb{R}^2\) d'angle \(\theta\) centrée à l'origine est l'application $$ R_\theta : (x, y) \longmapsto (x \cos \theta - y \sin \theta, x \sin \theta + y \cos \theta). $$ Elle est linéaire : chaque coordonnée de \(R_\theta(x, y)\) est une combinaison linéaire de \(x\) et \(y\). 
Exemple — Homothétie
Pour \(\lambda \in \mathbb{K}\), l'homothétie de \(\mathbb{R}^2\) de rapport \(\lambda\) centrée à l'origine est $$ h_\lambda : (x, y) \longmapsto (\lambda x, \lambda y) = \lambda \cdot (x, y). $$ Elle est linéaire — c'est un cas particulier de l'homothétie \(\lambda \mathrm{Id}_{\mathbb{R}^2}\) de la sous-section précédente. Exemple — Symétrie axiale
La symétrie axiale de \(\mathbb{R}^2\) par rapport à l'axe des \(x\) est l'application $$ s : (x, y) \longmapsto (x, -y). $$ Elle est linéaire. (Une figure géométrique de symétrie apparaît plus loin dans le chapitre, dans la partie sur les Projecteurs et symétries, dans le cadre tridimensionnel.) Exemple — Projection de \(\mathbb{R}^3\) sur un plan
La projection de \(\mathbb{R}^3\) sur le plan \(z = 0\) parallèlement à l'axe \(Oz\) est l'application $$ p : (x, y, z) \longmapsto (x, y, 0). $$ Elle est linéaire : la troisième coordonnée est supprimée, les deux premières sont conservées. 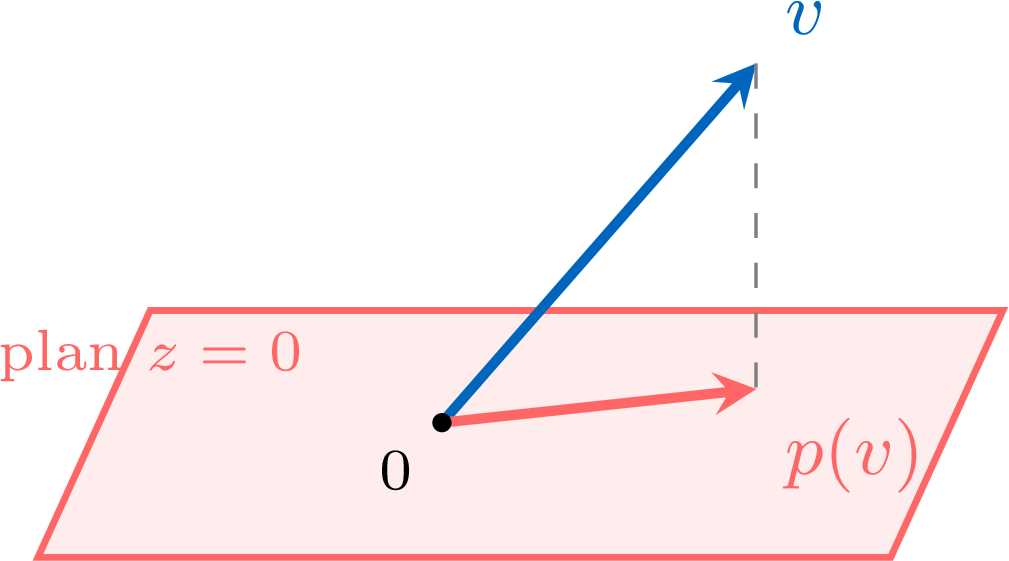
Méthode — Reconnaître une application linéaire géométrique
Les transformations géométriques qui fixent l'origine — rotations, homothéties, symétries axiales et centrales, projections dans \(\mathbb{R}^2\) et \(\mathbb{R}^3\) — sont linéaires. Inversement, une transformation qui ne fixe pas l'origine (translation, application affine à terme constant non nul) n'est pas linéaire. Compétences à pratiquer
- Identifier des applications linéaires de référence
I.3
Opérations sur les applications linéaires
Deux opérations sont disponibles sur les applications linéaires. D'abord l'addition et la multiplication par un scalaire des fonctions : elles font de \(\mathcal{L}(E\,;\,F)\) un \(\mathbb{K}\)-espace vectoriel. Ensuite la composition : lorsque les espaces s'enchaînent, la composée de deux applications linéaires est encore linéaire, et sur un même espace \(E\) la composition permet de composer à volonté les endomorphismes, avec l'identité \(\mathrm{Id}_E\) pour élément neutre. La composition se comporte bien vis-à-vis de l'addition et des scalaires, mais elle n'est pas commutative en général. Enfin, l'inverse d'une application linéaire bijective est automatiquement linéaire, de sorte que les endomorphismes bijectifs de \(E\) forment un ensemble remarquable \(\mathrm{GL}(E) \subset \mathcal{L}(E)\).
Proposition — \(\mathcal{L}(E\virgule\ F)\) est un espace vectoriel
Soient \(E\) et \(F\) deux \(\mathbb{K}\)-espaces vectoriels. Alors \(\mathcal{L}(E, F)\) est un \(\mathbb{K}\)-espace vectoriel : c'est un sous-espace de \(F^E\) (l'espace de toutes les applications \(E \to F\)), de zéro l'application nulle \(x \mapsto 0_F\).
L'application nulle est linéaire : \(0(\lambda x + y) = 0_F = \lambda \cdot 0_F + 0_F = \lambda \cdot 0(x) + 0(y)\), donc \(\mathcal{L}(E, F)\) est non vide. Soient \(f, g \in \mathcal{L}(E, F)\) et \(\mu \in \mathbb{K}\). Pour \(x, y \in E\) et \(\lambda \in \mathbb{K}\), $$ \begin{aligned} (\mu f + g)(\lambda x + y) &= \mu f(\lambda x + y) + g(\lambda x + y) && \text{(définition de \(\mu f + g\))} \\
&= \mu (\lambda f(x) + f(y)) + (\lambda g(x) + g(y)) && \text{(linéarité de \(f\) et \(g\))} \\
&= \lambda (\mu f(x) + g(x)) + (\mu f(y) + g(y)) && \text{(réorganisation)} \\
&= \lambda (\mu f + g)(x) + (\mu f + g)(y). \end{aligned} $$ Donc \(\mu f + g \in \mathcal{L}(E, F)\). Donc \(\mathcal{L}(E, F)\) est un sous-espace de \(F^E\).
Théorème — Composition d'applications linéaires
Soient \(E, F, G\) trois \(\mathbb{K}\)-espaces vectoriels, \(f \in \mathcal{L}(E, F)\) et \(g \in \mathcal{L}(F, G)\). Alors \(g \circ f \in \mathcal{L}(E, G)\). La composition est bilinéaire : pour \(f, f' \in \mathcal{L}(E, F)\), \(g, g' \in \mathcal{L}(F, G)\), \(\lambda \in \mathbb{K}\), $$ g \circ (f + f') = g \circ f + g \circ f', \quad (g + g') \circ f = g \circ f + g' \circ f, \quad g \circ (\lambda f) = \lambda (g \circ f) = (\lambda g) \circ f. $$
Pour \(x, y \in E\) et \(\lambda \in \mathbb{K}\), $$ (g \circ f)(\lambda x + y) = g(f(\lambda x + y)) = g(\lambda f(x) + f(y)) = \lambda g(f(x)) + g(f(y)) = \lambda (g \circ f)(x) + (g \circ f)(y). $$ Donc \(g \circ f\) est linéaire. La bilinéarité s'en déduit directement : \((g \circ (f + f'))(x) = g(f(x) + f'(x)) = g(f(x)) + g(f'(x))\) par linéarité de \(g\), et de même pour les autres identités.
Définition — Isomorphisme
Une application linéaire \(f \in \mathcal{L}(E, F)\) bijective est appelée un isomorphisme. Lorsque \(E = F\), un endomorphisme bijectif est appelé un automorphisme. L'ensemble des automorphismes de \(E\) est noté \(\textcolor{colordef}{\mathrm{GL}(E)}\), le groupe linéaire de \(E\). Exemple
L'identité \(\mathrm{Id}_E : E \to E\) est un automorphisme de \(E\) (donc \(\mathrm{Id}_E \in \mathrm{GL}(E)\)) ; son inverse est \(\mathrm{Id}_E\) elle-même. Plus généralement, pour \(\lambda \in \mathbb{K}^*\), l'homothétie \(\lambda \mathrm{Id}_E\) est un automorphisme de \(E\) d'inverse \(\frac{1}{\lambda} \mathrm{Id}_E\). L'application \(\mathbb{R}^2 \to \mathbb{R}^2\), \((x, y) \mapsto (y, x)\) (échange des coordonnées) est un automorphisme : elle est linéaire, bijective, et égale à son propre inverse. Théorème — L'inverse d'un isomorphisme est linéaire
Soit \(f \in \mathcal{L}(E, F)\) un isomorphisme. Alors \(f^{-1} : F \to E\) est également linéaire, donc \(f^{-1} \in \mathcal{L}(F, E)\).
Soient \(y, y' \in F\) et \(\lambda \in \mathbb{K}\). Posons \(x := f^{-1}(y)\) et \(x' := f^{-1}(y')\), de sorte que \(y = f(x)\) et \(y' = f(x')\). Par linéarité de \(f\), $$ f(\lambda x + x') = \lambda f(x) + f(x') = \lambda y + y'. $$ En appliquant \(f^{-1}\) aux deux membres : \(\lambda x + x' = f^{-1}(\lambda y + y')\), soit \(f^{-1}(\lambda y + y') = \lambda f^{-1}(y) + f^{-1}(y')\). Donc \(f^{-1}\) est linéaire.
Théorème — Composition des endomorphismes
Soit \(E\) un \(\mathbb{K}\)-espace vectoriel. Sur \(\mathcal{L}(E)\), la composition \(\circ\) possède les propriétés suivantes : - elle est associative : \((f \circ g) \circ h = f \circ (g \circ h)\) ;
- elle est distributive sur l'addition, à gauche et à droite : \(f \circ (g + h) = f \circ g + f \circ h\) et \((f + g) \circ h = f \circ h + g \circ h\) ;
- elle est compatible avec les scalaires : \(\lambda (f \circ g) = (\lambda f) \circ g = f \circ (\lambda g)\) pour \(\lambda \in \mathbb{K}\) ;
- elle admet \(\mathrm{Id}_E\) pour élément neutre : \(f \circ \mathrm{Id}_E = \mathrm{Id}_E \circ f = f\).
L'associativité, le rôle d'élément neutre de \(\mathrm{Id}_E\), et le fait que la composée de deux endomorphismes soit encore un endomorphisme sont les propriétés générales de la composition des applications, déjà établies. Les deux distributivités sont des vérifications d'une ligne utilisant la linéarité : pour \(x \in E\), $$ (f \circ (g + h))(x) = f(g(x) + h(x)) = f(g(x)) + f(h(x)) = (f \circ g + f \circ h)(x) $$ par linéarité de \(f\) (distributivité à gauche), et $$ ((f + g) \circ h)(x) = f(h(x)) + g(h(x)) = (f \circ h + g \circ h)(x) $$ directement par définition de \(f + g\) (distributivité à droite). Les compatibilités avec les scalaires se vérifient de la même façon par linéarité. La non-commutativité est exhibée dans l'exemple ci-dessous.
Exemple — Non-commutativité dans \(\mathcal{L}(\mathbb{R}[X])\)
Sur \(\mathbb{R}[X]\), considérons la dérivation \(D : P \mapsto P'\) et la multiplication par \(X\), \(M : P \mapsto X P\). Les deux sont des endomorphismes. Calculons : $$ (D \circ M)(P) = D(X P) = P + X P', \qquad (M \circ D)(P) = M(P') = X P'. $$ La différence \((D \circ M)(P) - (M \circ D)(P) = P\) pour tout \(P\), soit \(D \circ M - M \circ D = \mathrm{Id}_{\mathbb{R}[X]}\). Donc \(D\) et \(M\) ne commutent pas, et \(\mathcal{L}(\mathbb{R}[X])\) est non commutatif. Méthode — Calculer puissances et polynômes d'un endomorphisme
Pour \(f \in \mathcal{L}(E)\) et \(n \in \mathbb{N}^*\), on note \(f^n := f \circ f \circ \cdots \circ f\) (\(n\) fois), avec \(f^0 := \mathrm{Id}_E\). La composition étant associative et distributive sur l'addition, on manipule les expressions \(P(f) = a_n f^n + \cdots + a_1 f + a_0 \mathrm{Id}_E\) (pour \(P = a_n X^n + \cdots + a_0 \in \mathbb{K}[X]\)) selon les règles de calcul habituelles, en traitant \(f\) comme une indéterminée et \(\mathrm{Id}_E\) comme la constante \(1\). Formule du binôme \((f + g)^n\) : valide uniquement lorsque \(f \circ g = g \circ f\). Même précaution pour la factorisation de \(f^n - g^n\) et la somme géométrique : elles exigent que \(f\) et \(g\) commutent.
Compétences à pratiquer
- Composer des applications linéaires , calculer dans \(\mathcal{L}(E)\)
I.4
Image et noyau
À toute application linéaire \(f : E \to F\) sont attachés deux sous-espaces naturels : l'image, dans \(F\), de tout ce que \(f\) produit ; et le noyau, dans \(E\), de tout ce que \(f\) envoie sur \(0_F\). Leur lien avec l'injectivité et la surjectivité est direct : le noyau détecte l'injectivité (il est égal à \(\{0\}\) ssi \(f\) est injective), et l'image détecte la surjectivité (elle vaut \(F\) ssi \(f\) est surjective).
Définition — Image
Soit \(f \in \mathcal{L}(E, F)\). L'image d'un sous-espace \(A\) de \(E\) est l'ensemble $$ f(A) := \{f(a) : a \in A\} \subset F. $$ L'image de \(f\) est \(\textcolor{colordef}{\mathrm{Im}\,f := f(E)} = \{f(x) : x \in E\}\). Conséquence immédiate. \(f\) est surjective si et seulement si \(\mathrm{Im}\,f = F\).
Définition — Image réciproque et noyau
Soit \(f \in \mathcal{L}(E, F)\). L'image réciproque d'une partie \(B \subset F\) est l'ensemble $$ f^{-1}(B) := \{x \in E : f(x) \in B\}. $$ La notation \(f^{-1}(B)\) ne suppose pas \(f\) bijective : c'est une définition d'ensemble, pas la valeur d'une application réciproque. Le noyau de \(f\) est l'image réciproque de \(\{0_F\}\) : $$ \textcolor{colordef}{\mathrm{Ker}\,f := f^{-1}(\{0_F\}) = \{x \in E : f(x) = 0_F\}}. $$ Proposition — Image d'un sous-espace est un sous-espace
Soient \(f \in \mathcal{L}(E, F)\) et \(A\) un sous-espace de \(E\). Alors \(f(A)\) est un sous-espace de \(F\). En particulier, \(\mathrm{Im}\,f\) est un sous-espace de \(F\).
\(0_F = f(0_E) \in f(A)\) car \(0_E \in A\), donc \(f(A)\) est non vide. Soient \(y, y' \in f(A)\) et \(\lambda \in \mathbb{K}\) : écrivons \(y = f(a)\) et \(y' = f(a')\) avec \(a, a' \in A\). Alors \(\lambda y + y' = \lambda f(a) + f(a') = f(\lambda a + a')\) par linéarité de \(f\), et \(\lambda a + a' \in A\) car \(A\) est un sous-espace. Donc \(\lambda y + y' \in f(A)\), donc \(f(A)\) est un sous-espace de \(F\).
Proposition — Image réciproque d'un sous-espace est un sous-espace
Soient \(f \in \mathcal{L}(E, F)\) et \(B\) un sous-espace de \(F\). Alors \(f^{-1}(B)\) est un sous-espace de \(E\). En particulier, \(\mathrm{Ker}\,f\) est un sous-espace de \(E\).
\(f(0_E) = 0_F \in B\), donc \(0_E \in f^{-1}(B)\), donc \(f^{-1}(B)\) est non vide. Soient \(x, x' \in f^{-1}(B)\) et \(\lambda \in \mathbb{K}\) : \(f(\lambda x + x') = \lambda f(x) + f(x') \in B\) car \(f(x), f(x') \in B\) et \(B\) est un sous-espace. Donc \(\lambda x + x' \in f^{-1}(B)\), donc \(f^{-1}(B)\) est un sous-espace de \(E\).
Proposition — Image d'un \(\mathrm{Vect}\)
Soient \(f \in \mathcal{L}(E, F)\) et \(X\) une partie non vide de \(E\). Alors $$ f(\mathrm{Vect}(X)) = \mathrm{Vect}(f(X)), $$ où \(f(X) = \{f(x) : x \in X\}\). En particulier, si \((e_i)_{i \in I}\) est une famille génératrice de \(E\), alors \(\mathrm{Im}\,f = \mathrm{Vect}\bigl((f(e_i))_{i \in I}\bigr)\).
Double inclusion.
- \((\subset)\) Soit \(y \in f(\mathrm{Vect}(X))\) : écrivons \(y = f(x)\) avec \(x \in \mathrm{Vect}(X)\), soit \(x = \lambda_1 x_1 + \cdots + \lambda_r x_r\) pour certains \(x_i \in X\) et \(\lambda_i \in \mathbb{K}\). Alors \(y = f(x) = \lambda_1 f(x_1) + \cdots + \lambda_r f(x_r) \in \mathrm{Vect}(f(X))\).
- \((\supset)\) Soit \(z \in \mathrm{Vect}(f(X))\) : \(z = \mu_1 f(x_1) + \cdots + \mu_r f(x_r) = f(\mu_1 x_1 + \cdots + \mu_r x_r)\) pour certains \(x_i \in X\) et \(\mu_i \in \mathbb{K}\). Comme \(\mu_1 x_1 + \cdots + \mu_r x_r \in \mathrm{Vect}(X)\), on a \(z \in f(\mathrm{Vect}(X))\).
Proposition — Le noyau détecte l'injectivité
Soit \(f \in \mathcal{L}(E, F)\). Alors $$ f \text{ est \textcolor{colorprop}{injective}} \iff \mathrm{Ker}\,f = \{0_E\}. $$ - \((\Rightarrow)\) Supposons \(f\) injective. Comme \(f(0_E) = 0_F\), le seul élément de \(E\) envoyé sur \(0_F\) est \(0_E\), donc \(\mathrm{Ker}\,f = \{0_E\}\).
- \((\Leftarrow)\) Supposons \(\mathrm{Ker}\,f = \{0_E\}\). Soient \(x, y \in E\) tels que \(f(x) = f(y)\). Alors \(f(x - y) = f(x) - f(y) = 0_F\), donc \(x - y \in \mathrm{Ker}\,f = \{0_E\}\), donc \(x = y\). Donc \(f\) est injective.
Exemple — Noyau et image de \(D : P \mapsto P'\)
Sur \(\mathbb{K}[X]\), la dérivation \(D : P \mapsto P'\) admet pour noyau \(\mathrm{Ker}\,D = \mathbb{K}\) (les constantes : \(P' = 0\) ssi \(P\) est constant) et pour image \(\mathrm{Im}\,D = \mathbb{K}[X]\) (tout polynôme admet une primitive obtenue terme à terme : une primitive de \(\sum a_k X^k\) est \(\sum \frac{a_k}{k+1} X^{k+1}\)). Donc \(D\) est surjective mais non injective. Exemple — Noyau et image d'une application \(\mathbb{R}^3 \to \mathbb{R}^2\)
Soit \(f : \mathbb{R}^3 \to \mathbb{R}^2\), \((x, y, z) \mapsto (2x + y - z, x - y)\). Noyau. Résoudre \(f(x, y, z) = 0\) : \(\{2x + y - z = 0,\ x - y = 0\}\), qui donne \(y = x\) et \(z = 3x\). Donc $$ \mathrm{Ker}\,f = \{(x, x, 3x) : x \in \mathbb{R}\} = \mathrm{Vect}\bigl((1, 1, 3)\bigr), \quad \dim \mathrm{Ker}\,f = 1. $$ Image. Comme \((e_1, e_2, e_3)\) est une base de \(\mathbb{R}^3\), \(\mathrm{Im}\,f = \mathrm{Vect}\bigl(f(e_1), f(e_2), f(e_3)\bigr) = \mathrm{Vect}\bigl((2, 1), (1, -1), (-1, 0)\bigr)\). Les vecteurs \((2, 1)\) et \((1, -1)\) ne sont pas proportionnels, donc ils sont libres dans \(\mathbb{R}^2\), donc \(\mathrm{Im}\,f = \mathbb{R}^2\). Donc \(f\) est surjective.
Méthode — Calculer image et noyau
Pour calculer \(\mathrm{Ker}\,f\) : résoudre le système linéaire \(f(x) = 0_F\) composante par composante ; l'espace des solutions est le noyau. Pour calculer \(\mathrm{Im}\,f\) lorsque \(E\) possède une base finie \((e_1, \ldots, e_n)\) : par la proposition « image d'un \(\mathrm{Vect}\) », \(\mathrm{Im}\,f = \mathrm{Vect}\bigl(f(e_1), \ldots, f(e_n)\bigr)\) ; on extrait ensuite une base de \(\mathrm{Im}\,f\) parmi ces \(n\) images via l'algorithme de la base extraite de Espaces vectoriels de dimension finie.
Compétences à pratiquer
- Calculer image et noyau
- Utiliser le noyau pour l'injectivité
II
Détermination d'une application linéaire
II.1
Caractérisation par l'image d'une base
Une application linéaire entre deux espaces vectoriels est entièrement déterminée par ses valeurs sur une base de l'espace de départ : connaître \(u(e_i)\) pour chaque vecteur \(e_i\) d'une base suffit à calculer \(u(x)\) pour tout \(x \in E\). Inversement, prescrire librement les images des vecteurs de base définit de manière unique une application linéaire. Cette dualité « base \(\mapsto\) image de base » est le principe de construction le plus utilisé du chapitre.
Théorème — Application linéaire déterminée par l'image d'une base
Soient \(E, F\) deux \(\mathbb{K}\)-espaces vectoriels, \((e_i)_{i \in I}\) une base de \(E\), et \((y_i)_{i \in I}\) une famille quelconque de vecteurs de \(F\) indexée par le même \(I\). Alors il existe une unique \(u \in \mathcal{L}(E, F)\) telle que $$ \forall i \in I : \quad u(e_i) = y_i. $$
Analyse–synthèse.
- Analyse (unicité). Si une telle \(u\) existe, alors pour \(x \in E\) de décomposition unique \(x = \sum_{i \in I} x_i e_i\) (somme finie puisque \((e_i)\) est une base), la linéarité de \(u\) impose $$ u(x) = u\Bigl(\sum_i x_i e_i\Bigr) = \sum_i x_i u(e_i) = \sum_i x_i y_i. $$ Donc \(u\) est entièrement déterminée par la famille \((y_i)\), donc unique.
- Synthèse (existence). Définissons \(u : E \to F\) par \(u(x) := \sum_i x_i y_i\) où \((x_i)\) sont les coordonnées de \(x\) dans \((e_i)\). Pour \(x = \sum_i x_i e_i\) et \(x' = \sum_i x'_i e_i\), l'unicité des coordonnées donne \(\lambda x + x' = \sum_i (\lambda x_i + x'_i) e_i\), donc $$ u(\lambda x + x') = \sum_i (\lambda x_i + x'_i) y_i = \lambda \sum_i x_i y_i + \sum_i x'_i y_i = \lambda u(x) + u(x'). $$ Donc \(u\) est linéaire. Enfin \(u(e_j) = \sum_i \delta_{ij} y_i = y_j\) pour tout \(j\).
Méthode — Définir une application linéaire en la prescrivant sur une base
Pour définir une application linéaire \(u \in \mathcal{L}(E, F)\) lorsque \(E\) admet une base \((e_i)\) : prescrire les images \(u(e_i) \in F\) librement (aucune contrainte entre elles). Le théorème garantit qu'une unique application linéaire \(u\) prolonge ces prescriptions à tout \(E\). Exemple
Définissons \(u : \mathbb{R}^3 \to \mathbb{R}^2\) par \(u(e_1) = (2, 3)\), \(u(e_2) = (1, 0)\), \(u(e_3) = (1, -1)\), où \((e_1, e_2, e_3)\) est la base canonique de \(\mathbb{R}^3\). Alors pour \((x, y, z) \in \mathbb{R}^3\), $$ u(x, y, z) = x \cdot (2, 3) + y \cdot (1, 0) + z \cdot (1, -1) = (2x + y + z, 3x - z). $$ Compétences à pratiquer
- Définir une application linéaire par l'image d'une base
II.2
Caractérisation par les restrictions à une somme directe
Au lieu de prescrire les valeurs vecteur par vecteur sur une base, on peut prescrire des « morceaux » de \(u\) sur chacun des facteurs d'une somme directe \(E = E_1 \oplus \cdots \oplus E_p\). Le même argument d'analyse–synthèse s'applique, cette fois avec la décomposition unique de chaque \(x \in E\) en somme de vecteurs de chacun des \(E_i\).
Théorème — Application linéaire déterminée par ses restrictions à une somme directe
Soit \(E = E_1 \oplus E_2 \oplus \cdots \oplus E_p\) une décomposition en somme directe, \(F\) un \(\mathbb{K}\)-espace vectoriel, et \(u_i \in \mathcal{L}(E_i, F)\) une application linéaire pour chaque \(i \in \llbracket 1, p \rrbracket\). Alors il existe une unique \(u \in \mathcal{L}(E, F)\) telle que $$ \forall i \in \llbracket 1, p \rrbracket : \quad u_{|E_i} = u_i. $$
Analyse–synthèse sur la décomposition unique \(x = x_1 + \cdots + x_p\) avec \(x_i \in E_i\).
- Analyse. Si une telle \(u\) existe, alors \(u(x) = u(x_1 + \cdots + x_p) = u(x_1) + \cdots + u(x_p) = u_1(x_1) + \cdots + u_p(x_p)\), donc \(u\) est uniquement déterminée par les \(u_i\).
- Synthèse. Définissons \(u(x) := u_1(x_1) + \cdots + u_p(x_p)\). La décomposition \(x = x_1 + \cdots + x_p\) étant unique, \(u\) est bien définie. Linéarité : pour \(x, x' \in E\) avec \(x = \sum x_i\), \(x' = \sum x'_i\), et \(\lambda \in \mathbb{K}\), \(\lambda x + x' = \sum (\lambda x_i + x'_i)\) (la somme directe est préservée par combinaison linéaire), donc \(u(\lambda x + x') = \sum u_i(\lambda x_i + x'_i) = \lambda \sum u_i(x_i) + \sum u_i(x'_i) = \lambda u(x) + u(x')\). Enfin, pour \(x \in E_i\), sa décomposition n'a que le \(i\)-ème facteur non nul, donc \(u(x) = u_i(x)\).
Méthode — Définir une application linéaire par morceaux sur une somme directe
Pour définir \(u \in \mathcal{L}(E, F)\) lorsque \(E = F_1 \oplus F_2\) : prescrire les restrictions \(u_{|F_1}\) et \(u_{|F_2}\) indépendamment. Les deux morceaux se prolongent uniquement en une application linéaire sur tout \(E\). C'est la construction standard pour les projecteurs, les symétries, et toute application dont le comportement est décrit séparément sur deux sous-espaces supplémentaires. Exemple
Dans \(\mathbb{R}^3 = F \oplus G\) avec \(F = \{(x, y, 0) : x, y \in \mathbb{R}\}\) (le plan \(z = 0\)) et \(G = \mathrm{Vect}\bigl((0, 0, 1)\bigr)\) (l'axe \(z\)), définissons \(u \in \mathcal{L}(\mathbb{R}^3)\) par \(u_{|F} = \mathrm{Id}_F\) et \(u_{|G} = 0\). Alors \(u(x, y, z) = (x, y, 0)\) : c'est la projection sur \(F\) parallèlement à \(G\) (un projecteur — voir la partie Projecteurs et symétries plus loin). Compétences à pratiquer
- Définir une application linéaire par morceaux sur une somme directe
II.3
Isomorphismes et dimension
L'image d'une base par une application linéaire capture l'injectivité, la surjectivité et la bijectivité. En dimension finie, cela mène au résultat du programme selon lequel deux espaces sont isomorphes si et seulement s'ils ont la même dimension : en particulier, tout \(\mathbb{K}\)-espace vectoriel de dimension finie \(n\) est isomorphe à \(\mathbb{K}^n\).
Théorème — Application linéaire et image d'une base
Soient \(E\) un \(\mathbb{K}\)-espace vectoriel de dimension finie, \((e_1, \ldots, e_n)\) une base de \(E\), \(F\) un \(\mathbb{K}\)-espace vectoriel (non supposé de dimension finie), et \(u \in \mathcal{L}(E, F)\). Posons \(y_i := u(e_i)\) pour \(i \in \llbracket 1, n \rrbracket\). Alors : - \(u\) est injective \(\iff\) \((y_1, \ldots, y_n)\) est libre dans \(F\) ;
- \(u\) est surjective \(\iff\) \((y_1, \ldots, y_n)\) engendre \(F\) ;
- \(u\) est bijective \(\iff\) \((y_1, \ldots, y_n)\) est une base de \(F\).
On utilise \(\mathrm{Im}\,u = \mathrm{Vect}(y_1, \ldots, y_n)\) (proposition « image d'un \(\mathrm{Vect}\) ») et la proposition « le noyau détecte l'injectivité ».
- Surjective \(\iff\) \((y_i)\) engendre \(F\). Direct depuis \(\mathrm{Im}\,u = \mathrm{Vect}(y_1, \ldots, y_n)\) : \(u\) surjective \(\iff\) \(\mathrm{Im}\,u = F\) \(\iff\) \((y_i)\) engendre \(F\).
- Injective \(\iff\) \((y_i)\) libre. Pour \(\lambda_1, \ldots, \lambda_n \in \mathbb{K}\), \(u(\sum \lambda_i e_i) = \sum \lambda_i y_i\). Donc \(\mathrm{Ker}\,u = \{\sum \lambda_i e_i : \sum \lambda_i y_i = 0_F\}\). Donc \(\mathrm{Ker}\,u = \{0_E\}\) (\(u\) injective) ssi \(\sum \lambda_i y_i = 0_F\) implique tous les \(\lambda_i = 0\), soit ssi \((y_i)\) est libre.
- Bijective \(\iff\) \((y_i)\) base. Bijective = injective + surjective ; base = libre + génératrice. Combiner les deux points précédents.
Théorème — Un isomorphisme préserve la dimension
Soient \(E\) un \(\mathbb{K}\)-espace vectoriel de dimension finie et \(F\) un \(\mathbb{K}\)-espace vectoriel. (i) Si \(E\) et \(F\) sont isomorphes, alors \(F\) est de dimension finie et \(\dim F = \dim E\).
(ii) Inversement, deux \(\mathbb{K}\)-espaces vectoriels de dimension finie de même dimension sont isomorphes. En particulier, tout \(\mathbb{K}\)-espace vectoriel de dimension finie \(n\) est isomorphe à \(\mathbb{K}^n\).
- (i) Soit \(u : E \to F\) un isomorphisme et \((e_1, \ldots, e_n)\) une base de \(E\). Par le théorème précédent appliqué à \(u\) bijective, \((u(e_1), \ldots, u(e_n))\) est une base de \(F\). Donc \(F\) a une base de cardinal \(n\), donc \(F\) est de dimension finie avec \(\dim F = n = \dim E\).
- (ii) Supposons \(\dim E = \dim F = n\). Choisissons une base \((e_1, \ldots, e_n)\) de \(E\) et une base \((f_1, \ldots, f_n)\) de \(F\). Par le théorème « base \(\mapsto\) image de base » appliqué à la famille \((f_1, \ldots, f_n)\), il existe une unique application linéaire \(u : E \to F\) avec \(u(e_i) = f_i\). Par le théorème précédent, \(u\) est bijective ; donc \(u\) est un isomorphisme.
En particulier, tout \(E\) de dimension \(n\) est isomorphe à \(\mathbb{K}^n\) (de dimension \(n\) via la base canonique).
Compétences à pratiquer
- Utiliser un isomorphisme pour calculer une dimension
II.4
Dimension de \(\mathcal{L}(E\virgule\ F)\)
Proposition — Dimension de \(\mathcal{L}(E\virgule\ F)\)
Soient \(E\) et \(F\) deux \(\mathbb{K}\)-espaces vectoriels de dimension finie. Alors \(\mathcal{L}(E, F)\) est de dimension finie et $$ \textcolor{colorprop}{\dim \mathcal{L}(E, F) = \dim E \times \dim F}. $$
Posons \(p = \dim E\) et fixons une base \((e_1, \ldots, e_p)\) de \(E\). Par le théorème « base \(\mapsto\) image de base », l'application $$ \Phi : \mathcal{L}(E, F) \longrightarrow F^p, \qquad u \longmapsto (u(e_1), \ldots, u(e_p)) $$ est bijective (existence + unicité du prolongement linéaire de tout \(p\)-uplet d'images). Elle est aussi linéaire : \(\Phi(\lambda u + v) = ((\lambda u + v)(e_1), \ldots) = (\lambda u(e_1) + v(e_1), \ldots) = \lambda \Phi(u) + \Phi(v)\). Donc \(\Phi\) est un isomorphisme entre \(\mathcal{L}(E, F)\) et \(F^p\). Par le théorème précédent, \(\dim \mathcal{L}(E, F) = \dim F^p = p \dim F\) (résultat « dimension d'un produit » d'Espaces vectoriels de dimension finie) \(= \dim E \times \dim F\).
Exemple
\(\dim \mathcal{L}(\mathbb{R}^3, \mathbb{R}^2) = 3 \times 2 = 6\). \(\dim \mathcal{L}(\mathbb{R}_3[X], \mathbb{R}^2) = 4 \times 2 = 8\) (puisque \(\dim \mathbb{R}_3[X] = 4\)).
\(\dim \mathcal{L}(E) = (\dim E)^2\) pour tout \(E\) de dimension finie.
Compétences à pratiquer
- Calculer la dimension de \(\mathcal{L}(E\virgule\ F)\)
III
Applications linéaires en dimension finie : théorème du rang
III.1
Rang d'une application linéaire
Pour une application linéaire de rang fini, on définit le rang comme la dimension de l'image. Le rang capture combien de la cible \(F\) est « effectivement atteinte » par \(f\). Lorsque l'espace de départ \(E\) est de dimension finie, le rang est automatiquement majoré par \(\dim E\) (on ne peut créer plus de dimensions que ce dont on part) et par \(\dim F\) (on ne peut atteindre plus que ce que la cible offre).
Définition — Rang d'une application linéaire
Soit \(f \in \mathcal{L}(E, F)\). On dit que \(f\) est de rang fini si \(\mathrm{Im}\,f\) est un sous-espace de dimension finie de \(F\). Dans ce cas, le rang de \(f\) est $$ \textcolor{colordef}{\mathrm{rg}(f) := \dim \mathrm{Im}\,f}. $$ Proposition — Bornes du rang
Soit \(f \in \mathcal{L}(E, F)\) de rang fini. Alors : - (a) Si \(F\) est de dimension finie, \(\textcolor{colorprop}{\mathrm{rg}(f) \le \dim F}\), avec égalité ssi \(f\) est surjective.
- (b) Si \(E\) est de dimension finie, \(f\) est automatiquement de rang fini et \(\textcolor{colorprop}{\mathrm{rg}(f) \le \dim E}\).
(a) \(\mathrm{Im}\,f \subset F\) et les deux sont de dimension finie, donc \(\mathrm{rg}(f) = \dim \mathrm{Im}\,f \le \dim F\) (théorème « dimension d'un sous-espace » d'Espaces vectoriels de dimension finie), avec égalité ssi \(\mathrm{Im}\,f = F\), soit ssi \(f\) est surjective.
(b) Si \(E\) admet une base \((e_1, \ldots, e_n)\), alors \(\mathrm{Im}\,f = \mathrm{Vect}(f(e_1), \ldots, f(e_n))\) est engendré par \(n\) vecteurs, donc de dimension finie avec \(\mathrm{rg}(f) \le n = \dim E\).
(b) Si \(E\) admet une base \((e_1, \ldots, e_n)\), alors \(\mathrm{Im}\,f = \mathrm{Vect}(f(e_1), \ldots, f(e_n))\) est engendré par \(n\) vecteurs, donc de dimension finie avec \(\mathrm{rg}(f) \le n = \dim E\).
Exemple
Calculons \(\mathrm{rg}(f)\) pour \(f : \mathbb{R}^3 \to \mathbb{R}^3\), \((x, y, z) \mapsto (x + y, y + z, x + z)\). \(\mathrm{Im}\,f = \mathrm{Vect}\bigl(f(e_1), f(e_2), f(e_3)\bigr) = \mathrm{Vect}\bigl((1, 0, 1), (1, 1, 0), (0, 1, 1)\bigr)\). Pour en extraire une base : \((1, 0, 1)\) et \((1, 1, 0)\) ne sont pas proportionnels, donc libres. \((0, 1, 1)\) est-il dans leur sous-espace engendré ? Supposons $$ (0, 1, 1) = a (1, 0, 1) + b (1, 1, 0) = (a + b, b, a). $$ Alors \(b = 1\) et \(a = 1\), donc \(a + b = 2\), contradiction avec la première coordonnée \(0\). Ainsi \((0, 1, 1) \notin \mathrm{Vect}\bigl((1, 0, 1), (1, 1, 0)\bigr)\). Les trois vecteurs sont libres, donc \(\mathrm{rg}(f) = 3\) et \(f\) est surjective (et bijective).
Proposition — Rang d'une composée
Soient \(f \in \mathcal{L}(E, F)\) et \(g \in \mathcal{L}(F, G)\), toutes deux de rang fini. Alors \(g \circ f\) est de rang fini et $$ \textcolor{colorprop}{\mathrm{rg}(g \circ f) \le \min\bigl(\mathrm{rg}(f),\ \mathrm{rg}(g)\bigr)}. $$ De plus : - si \(g_{|\mathrm{Im}\,f}\) est injective, alors \(\mathrm{rg}(g \circ f) = \mathrm{rg}(f)\) ;
- si \(f\) est surjective, alors \(\mathrm{rg}(g \circ f) = \mathrm{rg}(g)\).
Majoration par \(\mathrm{rg}(g)\). \(\mathrm{Im}(g \circ f) = g(\mathrm{Im}\,f) \subset \mathrm{Im}\,g\), donc \(\mathrm{rg}(g \circ f) \le \mathrm{rg}(g)\).
Majoration par \(\mathrm{rg}(f)\). La restriction \(g_{|\mathrm{Im}\,f} : \mathrm{Im}\,f \to G\) a pour image \(\mathrm{Im}\,(g_{|\mathrm{Im}\,f}) = g(\mathrm{Im}\,f) = \mathrm{Im}(g \circ f)\). Appliquons la borne (b) de « bornes du rang » à \(g_{|\mathrm{Im}\,f}\) (dont la source est \(\mathrm{Im}\,f\), de dimension \(\mathrm{rg}(f)\)) : \(\mathrm{rg}(g_{|\mathrm{Im}\,f}) \le \dim \mathrm{Im}\,f\). Comme \(\mathrm{rg}(g_{|\mathrm{Im}\,f}) = \dim \mathrm{Im}(g \circ f) = \mathrm{rg}(g \circ f)\) et \(\dim \mathrm{Im}\,f = \mathrm{rg}(f)\), on obtient \(\mathrm{rg}(g \circ f) \le \mathrm{rg}(f)\).
Majoration par \(\mathrm{rg}(f)\). La restriction \(g_{|\mathrm{Im}\,f} : \mathrm{Im}\,f \to G\) a pour image \(\mathrm{Im}\,(g_{|\mathrm{Im}\,f}) = g(\mathrm{Im}\,f) = \mathrm{Im}(g \circ f)\). Appliquons la borne (b) de « bornes du rang » à \(g_{|\mathrm{Im}\,f}\) (dont la source est \(\mathrm{Im}\,f\), de dimension \(\mathrm{rg}(f)\)) : \(\mathrm{rg}(g_{|\mathrm{Im}\,f}) \le \dim \mathrm{Im}\,f\). Comme \(\mathrm{rg}(g_{|\mathrm{Im}\,f}) = \dim \mathrm{Im}(g \circ f) = \mathrm{rg}(g \circ f)\) et \(\dim \mathrm{Im}\,f = \mathrm{rg}(f)\), on obtient \(\mathrm{rg}(g \circ f) \le \mathrm{rg}(f)\).
- Si \(g_{|\mathrm{Im}\,f}\) est injective, alors \(g_{|\mathrm{Im}\,f} : \mathrm{Im}\,f \to \mathrm{Im}(g \circ f)\) est bijective (surjective sur son image par construction). Donc \(\dim \mathrm{Im}(g \circ f) = \dim \mathrm{Im}\,f\), soit \(\mathrm{rg}(g \circ f) = \mathrm{rg}(f)\).
- Si \(f\) est surjective, alors \(\mathrm{Im}\,f = F\), donc \(\mathrm{Im}(g \circ f) = g(F) = \mathrm{Im}\,g\), donc \(\mathrm{rg}(g \circ f) = \mathrm{rg}(g)\).
Compétences à pratiquer
- Calculer le rang d'une application linéaire
III.2
Forme géométrique du théorème du rang
Le cœur géométrique du théorème du rang est le suivant : la restriction de \(f\) à tout supplémentaire de \(\mathrm{Ker}\,f\) est un isomorphisme sur \(\mathrm{Im}\,f\). Une fois ce résultat établi (aucune hypothèse de dimension finie n'est requise), la formule du rang en découle en une ligne dans le cas de la dimension finie.
Théorème — Forme géométrique du théorème du rang
Soient \(E, F\) deux \(\mathbb{K}\)-espaces vectoriels (non supposés de dimension finie) et \(f \in \mathcal{L}(E, F)\). Soit \(S\) un supplémentaire de \(\mathrm{Ker}\,f\) dans \(E\) (i.e. \(E = \mathrm{Ker}\,f \oplus S\)). Alors la restriction \(f_{|S} : S \to \mathrm{Im}\,f\) est un isomorphisme. 
- Injectivité de \(f_{|S}\). \(\mathrm{Ker}\,f_{|S} = \mathrm{Ker}\,f \cap S = \{0_E\}\) puisque \(E = \mathrm{Ker}\,f \oplus S\) est une somme directe.
- Surjectivité de \(f_{|S}\) sur \(\mathrm{Im}\,f\). Soit \(y \in \mathrm{Im}\,f\) : choisissons \(x \in E\) avec \(f(x) = y\). Décomposons \(x = k + s\) avec \(k \in \mathrm{Ker}\,f\) et \(s \in S\). Alors \(y = f(x) = f(k) + f(s) = 0 + f(s) = f(s) = f_{|S}(s)\). Donc tout \(y \in \mathrm{Im}\,f\) est atteint par \(f_{|S}\).
Compétences à pratiquer
- Appliquer la forme géométrique du théorème du rang
III.3
Théorème du rang
Théorème — Théorème du rang
Soient \(E\) un \(\mathbb{K}\)-espace vectoriel de dimension finie et \(f \in \mathcal{L}(E, F)\). Alors \(\mathrm{Im}\,f\) est de dimension finie et $$ \boldsymbol{\dim E = \dim \mathrm{Ker}\,f + \mathrm{rg}(f)}. $$
\(\mathrm{Ker}\,f\) est un sous-espace de \(E\), de dimension finie. Par le théorème d'existence d'un supplémentaire (Espaces vectoriels de dimension finie), \(\mathrm{Ker}\,f\) admet un supplémentaire \(S\) dans \(E\) : \(E = \mathrm{Ker}\,f \oplus S\), avec \(\dim S = \dim E - \dim \mathrm{Ker}\,f\) (somme des dimensions pour une somme directe). Par la forme géométrique (théorème précédent), \(f_{|S} : S \to \mathrm{Im}\,f\) est un isomorphisme, donc \(\mathrm{Im}\,f\) est de dimension finie avec \(\dim \mathrm{Im}\,f = \dim S\). En combinant, $$ \mathrm{rg}(f) = \dim \mathrm{Im}\,f = \dim S = \dim E - \dim \mathrm{Ker}\,f. $$
Corollaire — Rang égal à \(\dim E\) ssi \(f\) injective
Soient \(E\) de dimension finie et \(f \in \mathcal{L}(E, F)\). Alors $$ \mathrm{rg}(f) = \dim E \iff f \text{ est \textcolor{colorprop}{injective}}. $$
Par le théorème du rang, \(\mathrm{rg}(f) = \dim E - \dim \mathrm{Ker}\,f\). Donc \(\mathrm{rg}(f) = \dim E\) \(\iff\) \(\dim \mathrm{Ker}\,f = 0\) \(\iff\) \(\mathrm{Ker}\,f = \{0_E\}\) \(\iff\) \(f\) injective.
Méthode — Calculer \(\dim \mathrm{Im}\ f\) via le théorème du rang
Lorsque \(E\) est de dimension finie, le théorème du rang donne la formule directe \(\dim \mathrm{Im}\,f = \dim E - \dim \mathrm{Ker}\,f\). Calculer \(\mathrm{Ker}\,f\) (résoudre le système linéaire homogène) suffit alors à lire le rang, sans exhiber une base de \(\mathrm{Im}\,f\). Exemple
Pour \(f : \mathbb{R}^3 \to \mathbb{R}^2\), \((x, y, z) \mapsto (2x + y - z, x - y)\) (exemple ci-dessus) : on a trouvé \(\dim \mathrm{Ker}\,f = 1\). Par le théorème du rang, \(\mathrm{rg}(f) = 3 - 1 = 2 = \dim \mathbb{R}^2\), donc \(f\) est surjective — cohérent avec le calcul direct \(\mathrm{Im}\,f = \mathbb{R}^2\). Exemple
Soit \(u : \mathbb{R}^3 \to \mathbb{R}^3\) défini par \(u(x, y, z) = (x + 2y - z, 2x - y + 8z, x + y + z)\). Noyau. Résolvons le système homogène \(\{x + 2y - z = 0,\ 2x - y + 8z = 0,\ x + y + z = 0\}\) (élimination de Gauss) : depuis \(L_1 - L_3\), \(y - 2z = 0\), donc \(y = 2z\) ; depuis \(L_3\) avec \(y = 2z\) : \(x = -2z - z = -3z\) ; vérification dans \(L_2\) : \(2(-3z) - 2z + 8z = 0\) \(\checkmark\). Donc \(\mathrm{Ker}\,u = \mathrm{Vect}\bigl((-3, 2, 1)\bigr)\) et \(\dim \mathrm{Ker}\,u = 1\).
Rang. Par le théorème du rang, \(\mathrm{rg}(u) = 3 - 1 = 2\). Donc \(u\) n'est ni injective ni surjective ; \(\mathrm{Im}\,u\) est un plan de \(\mathbb{R}^3\).
Compétences à pratiquer
- Appliquer le théorème du rang
- Majorer le rang d'une composée
III.4
Équivalence inj \(\iff\) surj \(\iff\) bij en dimension finie égale
Lorsque la source et le but ont même dimension finie, les trois propriétés — injective, surjective, bijective — coïncident. Il suffit de vérifier la plus simple des trois ; ce raccourci spectaculaire est l'un des résultats les plus utilisés du chapitre.
Théorème — Injective \(\iff\) surjective \(\iff\) bijective en dimension finie égale
Soient \(E\) et \(F\) deux \(\mathbb{K}\)-espaces vectoriels de dimension finie avec \(\dim E = \dim F\), et \(f \in \mathcal{L}(E, F)\). Alors $$ \boldsymbol{f \text{ injective} \iff f \text{ surjective} \iff f \text{ bijective}}. $$
Par le théorème du rang, \(\mathrm{rg}(f) = \dim E - \dim \mathrm{Ker}\,f\).
- \(f\) injective \(\iff\) \(\dim \mathrm{Ker}\,f = 0\) \(\iff\) \(\mathrm{rg}(f) = \dim E = \dim F\) \(\iff\) \(f\) surjective.
- \(f\) bijective \(\iff\) \(f\) injective et surjective \(\iff\) (par la chaîne ci-dessus) \(f\) injective \(\iff\) \(f\) surjective.
Théorème — Inversibilité à gauche et à droite en dimension finie
Soient \(E\) de dimension finie et \(f \in \mathcal{L}(E)\). Alors $$ f \in \mathrm{GL}(E) \iff f \text{ est \textcolor{colorprop}{inversible à gauche} dans } \mathcal{L}(E) \iff f \text{ est \textcolor{colorprop}{inversible à droite} dans } \mathcal{L}(E). $$ - Si \(g \circ f = \mathrm{Id}_E\) (inversible à gauche), alors \(f\) est injective : \(f(x) = 0 \Rightarrow g(f(x)) = g(0) = 0 \Rightarrow x = (g \circ f)(x) = 0\). Par le théorème précédent (puisque \(\dim E = \dim E\)), \(f\) est bijective, donc dans \(\mathrm{GL}(E)\). Le même \(g\) doit valoir \(f^{-1}\) (multiplier \(g \circ f = \mathrm{Id}_E\) à droite par \(f^{-1}\)).
- Si \(f \circ h = \mathrm{Id}_E\) (inversible à droite), alors \(f\) est surjective. Par le théorème précédent, \(f\) est bijective. De même \(h = f^{-1}\).
- Inversement, \(f \in \mathrm{GL}(E)\) donne à la fois un inverse à gauche et à droite (tous deux égaux à \(f^{-1}\)).
Méthode — Diviser par deux le travail en dimension finie égale
Lorsque \(\dim E = \dim F\) (finie), vérifier la plus simple de « injective » ou « surjective » — la bijectivité suit. Pour un endomorphisme de \(E\) (dim finie), vérifier l'injectivité seule (soit \(\mathrm{Ker}\,f = \{0_E\}\)) suffit à démontrer \(f \in \mathrm{GL}(E)\). Exemple
L'application \(\varphi : \mathbb{R}^3 \to \mathbb{R}^3\), \((x, y, z) \mapsto (x + y, -x + y, z)\) est un automorphisme de \(\mathbb{R}^3\). Démonstration. \(\varphi\) est linéaire (chaque coordonnée est une combinaison linéaire de \(x, y, z\)). Noyau : résoudre \(\{x + y = 0,\ -x + y = 0,\ z = 0\}\), donne \(x = y = z = 0\), donc \(\mathrm{Ker}\,\varphi = \{0\}\). Donc \(\varphi\) est injective ; comme \(\dim \mathbb{R}^3 = \dim \mathbb{R}^3\), \(\varphi\) est bijective.
Exemple
Soit \(\psi : \mathbb{K}_n[X] \to \mathbb{K}_n[X]\), \(P \mapsto X P' + P(0)\) (avec \(n \ge 1\)). Bien définie et linéaire. Si \(\deg P \le n\), alors \(\deg P' \le n - 1\), donc \(\deg (X P') \le n\) ; \(P(0)\) est une constante. Donc \(X P' + P(0) \in \mathbb{K}_n[X]\), et la linéarité est immédiate.
Injective. Supposons \(\psi(P) = 0\), soit \(X P' + P(0) = 0\). Alors \(X P' = -P(0)\) est une constante ; mais \(X P'\) n'a pas de terme constant (s'annule en \(0\)), donc \(P(0) = 0\) et \(X P' = 0\), donc \(P' = 0\), donc \(P\) est constant. Combiné avec \(P(0) = 0\) : \(P = 0\).
Par le théorème « dim égale », \(\psi\) est bijective, donc un automorphisme de \(\mathbb{K}_n[X]\).
Compétences à pratiquer
- Utiliser l'équivalence inj \(\iff\) surj \(\iff\) bij
IV
Endomorphismes : projecteurs et symétries
IV.1
Projecteurs
Un projecteur est l'idée géométrique de « projeter sur un sous-espace, parallèlement à un sous-espace supplémentaire ». Concrètement : étant donné \(E = F \oplus G\), le projecteur sur \(F\) parallèlement à \(G\) garde la partie \(F\) et tue la partie \(G\). La caractérisation algébrique \(p^2 = p\) capture exactement les projecteurs, et la décomposition image/noyau \(\mathrm{Im}\,p \oplus \mathrm{Ker}\,p = E\) permet de retrouver la décomposition initiale.
Définition — Projecteur
Soient \(E\) un \(\mathbb{K}\)-espace vectoriel et \(F, G\) deux sous-espaces supplémentaires de \(E\) (i.e. \(E = F \oplus G\)). La projection sur \(F\) parallèlement à \(G\) (ou projecteur sur \(F\) dans la direction \(G\)) est l'application \(p : E \to E\) qui à \(x = f + g\) (\(f \in F\), \(g \in G\), décomposition unique) associe $$ p(x) := f. $$ Propriétés immédiates (par unicité de la décomposition) : - \(p\) est linéaire (théorème « application linéaire déterminée par ses restrictions à une somme directe » appliqué à \(p_{|F} = \mathrm{Id}_F\) et \(p_{|G} = 0\)) ;
- \(p^2 = p\) (\(p(f) = f\) pour \(f \in F\), donc \(p(p(x)) = p(f) = f = p(x)\)) ;
- \(F = \mathrm{Im}\,p = \mathrm{Ker}(p - \mathrm{Id}_E) = \{x \in E : p(x) = x\}\) ;
- \(G = \mathrm{Ker}\,p\).

Théorème — Caractérisation algébrique des projecteurs
Soit \(p : E \to E\) une application. Alors \(p\) est un projecteur si et seulement si \(p\) est linéaire et \(p^2 = p\). Dans ce cas, \(\mathrm{Im}\,p\) et \(\mathrm{Ker}\,p\) sont supplémentaires dans \(E\), et \(p\) est la projection sur \(\mathrm{Im}\,p\) parallèlement à \(\mathrm{Ker}\,p\). La décomposition concrète est $$ \forall x \in E : \quad x = \underbrace{p(x)}_{\in \mathrm{Im}\,p} + \underbrace{(x - p(x))}_{\in \mathrm{Ker}\,p}. $$ - \((\Rightarrow)\) Si \(p\) est un projecteur pour une décomposition \(E = F \oplus G\), les propriétés immédiates listées dans la définition donnent \(p\) linéaire et \(p^2 = p\).
- \((\Leftarrow)\) Supposons \(p\) linéaire et \(p^2 = p\). Pour tout \(x \in E\), écrivons \(x = p(x) + (x - p(x))\). Alors \(p(x) \in \mathrm{Im}\,p\), et \(p(x - p(x)) = p(x) - p^2(x) = p(x) - p(x) = 0\), donc \(x - p(x) \in \mathrm{Ker}\,p\). Donc \(E = \mathrm{Im}\,p + \mathrm{Ker}\,p\).
Somme directe. Soit \(y \in \mathrm{Im}\,p \cap \mathrm{Ker}\,p\). Écrivons \(y = p(z)\) pour un \(z\) ; alors \(0 = p(y) = p(p(z)) = p^2(z) = p(z) = y\). Donc \(\mathrm{Im}\,p \cap \mathrm{Ker}\,p = \{0\}\), donc \(E = \mathrm{Im}\,p \oplus \mathrm{Ker}\,p\).
La décomposition ci-dessus montre que \(p\) garde la partie \(\mathrm{Im}\,p\) de \(x\), donc \(p\) est le projecteur sur \(\mathrm{Im}\,p\) parallèlement à \(\mathrm{Ker}\,p\).
Méthode — Montrer qu'un endomorphisme est un projecteur
Pour démontrer que \(p \in \mathcal{L}(E)\) est un projecteur : vérifier \(p^2 = p\) sur l'entrée générique. Le théorème de caractérisation algébrique donne alors automatiquement les sous-espaces supplémentaires \(F = \mathrm{Im}\,p\) et \(G = \mathrm{Ker}\,p\). Exemple — Projecteur sur le plan \(z \equal 0\) de \(\mathbb{R}^3\)
Considérons \(p : \mathbb{R}^3 \to \mathbb{R}^3\), \((x, y, z) \mapsto (x, y, 0)\). Linéarité. Chaque composante de \(p(x, y, z)\) est une combinaison linéaire de \(x, y, z\).
\(p^2 = p\). \(p \circ p (x, y, z) = p(x, y, 0) = (x, y, 0) = p(x, y, z)\).
Par la caractérisation algébrique des projecteurs, \(p\) est un projecteur.
Image et noyau. \(\mathrm{Im}\,p = \{(x, y, 0) : x, y \in \mathbb{R}\}\) (le plan \(z = 0\)) ; \(\mathrm{Ker}\,p = \{(0, 0, z) : z \in \mathbb{R}\}\) (l'axe \(Oz\)). Donc \(p\) est la projection sur le plan \(z = 0\) parallèlement à l'axe \(Oz\).
Compétences à pratiquer
- Montrer que \(p^2 \equal p\) caractérise un projecteur
- Déterminer \(\mathrm{Im}\) et \(\mathrm{Ker}\) d'un projecteur
IV.2
Symétries
Définition — Symétrie
Soit \(E = F \oplus G\) et soit \(x = f + g\) (\(f \in F\), \(g \in G\)) la décomposition unique. La symétrie par rapport à \(F\) parallèlement à \(G\) est l'application \(s : E \to E\) définie par $$ s(x) := f - g. $$ Propriétés immédiates : - \(s\) est un automorphisme linéaire de \(E\) avec \(s^2 = \mathrm{Id}_E\) (donc \(s^{-1} = s\)) ;
- \(F = \mathrm{Ker}(s - \mathrm{Id}_E) = \{x \in E : s(x) = x\}\) ;
- \(G = \mathrm{Ker}(s + \mathrm{Id}_E) = \{x \in E : s(x) = -x\}\).

Théorème — Caractérisation algébrique des symétries
Soit \(s : E \to E\) une application. Alors \(s\) est une symétrie si et seulement si \(s\) est linéaire et \(s^2 = \mathrm{Id}_E\). Dans ce cas, \(\mathrm{Ker}(s - \mathrm{Id}_E)\) et \(\mathrm{Ker}(s + \mathrm{Id}_E)\) sont supplémentaires dans \(E\), et \(s\) est la symétrie par rapport à \(\mathrm{Ker}(s - \mathrm{Id}_E)\) parallèlement à \(\mathrm{Ker}(s + \mathrm{Id}_E)\). - \((\Rightarrow)\) La définition ci-dessus donne \(s\) linéaire et \(s^2 = \mathrm{Id}_E\).
- \((\Leftarrow)\) Supposons \(s\) linéaire et \(s^2 = \mathrm{Id}_E\). Posons \(F := \mathrm{Ker}(s - \mathrm{Id}_E)\) et \(G := \mathrm{Ker}(s + \mathrm{Id}_E)\), deux sous-espaces de \(E\). Décomposons tout \(x \in E\) comme $$ x = \underbrace{\frac{x + s(x)}{2}}_{\text{notons } f} + \underbrace{\frac{x - s(x)}{2}}_{\text{notons } g}. $$ Comme \(\mathbb{K} = \mathbb{R}\) ou \(\mathbb{C}\) (convention du chapitre), la division par \(2\) est permise. Vérifions \(f \in F\) : \(s(f) = \tfrac{1}{2}(s(x) + s^2(x)) = \tfrac{1}{2}(s(x) + x) = f\), donc \((s - \mathrm{Id})(f) = 0\). Vérifions \(g \in G\) : \(s(g) = \tfrac{1}{2}(s(x) - s^2(x)) = \tfrac{1}{2}(s(x) - x) = -g\), donc \((s + \mathrm{Id})(g) = 0\). Donc \(E = F + G\).
Somme directe. Si \(y \in F \cap G\), alors \(s(y) = y\) et \(s(y) = -y\), donc \(y = -y\) d'où \(2y = 0\), donc \(y = 0\) (division par \(2\)). Donc \(F \cap G = \{0\}\), \(E = F \oplus G\).
La décomposition \(x = f + g\) ci-dessus donne \(s(x) = s(f) + s(g) = f + (-g) = f - g\), donc \(s\) est la symétrie par rapport à \(F\) parallèlement à \(G\).
Méthode — Montrer qu'un endomorphisme est une symétrie
Pour démontrer que \(s \in \mathcal{L}(E)\) est une symétrie : vérifier \(s^2 = \mathrm{Id}_E\) sur l'entrée générique. Les sous-espaces supplémentaires sont alors \(F = \mathrm{Ker}(s - \mathrm{Id}_E)\) (vecteurs fixes) et \(G = \mathrm{Ker}(s + \mathrm{Id}_E)\) (vecteurs envoyés sur leur opposé). Exemple — Symétrie axiale de \(\mathbb{R}^2\)
Considérons \(s : \mathbb{R}^2 \to \mathbb{R}^2\), \((x, y) \mapsto (x, -y)\). Linéarité. Chaque composante de \(s(x, y)\) est une combinaison linéaire de \(x, y\).
\(s^2 = \mathrm{Id}\). \(s \circ s (x, y) = s(x, -y) = (x, y)\).
Par la caractérisation algébrique des symétries, \(s\) est une symétrie.
Sous-espaces propres. \(\mathrm{Ker}(s - \mathrm{Id}) = \{(x, y) : (x, -y) = (x, y)\} = \{(x, 0) : x \in \mathbb{R}\}\) (l'axe des \(x\)) ; \(\mathrm{Ker}(s + \mathrm{Id}) = \{(x, y) : (x, -y) = (-x, -y)\} = \{(0, y) : y \in \mathbb{R}\}\) (l'axe des \(y\)). Donc \(s\) est la symétrie par rapport à l'axe des \(x\) parallèlement à l'axe des \(y\).
Compétences à pratiquer
- Montrer que \(s^2 \equal \mathrm{Id}\) caractérise une symétrie
IV.3
Lien projecteur \(\leftrightarrow\) symétrie
Un projecteur et une symétrie associés à la même décomposition \(E = F \oplus G\) sont liés par une relation affine en une ligne : \(s = 2p - \mathrm{Id}_E\) passe du projecteur à la symétrie, \(p = (s + \mathrm{Id}_E)/2\) revient en arrière. Cela rend l'un disponible à partir de l'autre dans les calculs et les démonstrations.
Méthode — Construire l'un à partir de l'autre
Projecteur \(\to\) symétrie : si \(p\) est le projecteur sur \(F\) parallèlement à \(G\), alors \(s := 2p - \mathrm{Id}_E\) est la symétrie par rapport à \(F\) parallèlement à \(G\). Symétrie \(\to\) projecteur : si \(s\) est la symétrie par rapport à \(F\) parallèlement à \(G\), alors \(p := (s + \mathrm{Id}_E)/2\) est le projecteur sur \(F\) parallèlement à \(G\).
Vérification (projecteur \(\to\) symétrie). \(s^2 = (2p - \mathrm{Id})^2 = 4 p^2 - 4 p + \mathrm{Id} = 4 p - 4 p + \mathrm{Id} = \mathrm{Id}\) car \(p^2 = p\). Donc \(s\) est une symétrie par la caractérisation algébrique ; de plus, pour \(x = f + g\) (\(f \in F\), \(g \in G\)), \(s(x) = 2p(x) - x = 2f - (f + g) = f - g\) — exactement la symétrie par rapport à \(F\) parallèlement à \(G\).
Vérification (symétrie \(\to\) projecteur). Réciproquement, si \(s^2 = \mathrm{Id}_E\) et \(p = (s + \mathrm{Id}_E)/2\), alors $$ p^2 = \frac{(s + \mathrm{Id})^2}{4} = \frac{s^2 + 2s + \mathrm{Id}}{4} = \frac{2 \mathrm{Id} + 2s}{4} = \frac{s + \mathrm{Id}}{2} = p. $$ Donc \(p\) est un projecteur ; de plus \(p(x) = \tfrac{s(x) + x}{2} = \tfrac{(f - g) + (f + g)}{2} = f\) : exactement le projecteur sur \(F\) parallèlement à \(G\).
Exemple — La transposition est une symétrie
Sur \(\mathcal{M}_n(\mathbb{R})\), la transposition \(t : M \mapsto M^\top\) vérifie \(t^2 = \mathrm{Id}\) (la transposition est involutive). Donc \(t\) est une symétrie. Noyau de \(t - \mathrm{Id}\). \(t(M) = M\) signifie \(M = M^\top\) : \(M\) est symétrique. Donc \(\mathrm{Ker}(t - \mathrm{Id}) = \mathcal{S}_n(\mathbb{R})\) (matrices symétriques).
Noyau de \(t + \mathrm{Id}\). \(t(M) = -M\) signifie \(M^\top = -M\) : \(M\) est antisymétrique. Donc \(\mathrm{Ker}(t + \mathrm{Id}) = \mathcal{A}_n(\mathbb{R})\) (matrices antisymétriques).
Corollaire. Comme \(\mathcal{M}_n(\mathbb{R}) = \mathrm{Ker}(t - \mathrm{Id}) \oplus \mathrm{Ker}(t + \mathrm{Id})\) par la caractérisation algébrique, on retrouve $$ \mathcal{M}_n(\mathbb{R}) = \mathcal{S}_n(\mathbb{R}) \oplus \mathcal{A}_n(\mathbb{R}). $$
Exemple — Décomposition pair/impair
Sur \(\mathbb{R}^\mathbb{R}\), l'application \(\sigma : f \mapsto f \circ (x \mapsto -x)\) (qui envoie \(f\) sur la fonction \(x \mapsto f(-x)\)) est linéaire, et \(\sigma^2(f) = f\). Donc \(\sigma\) est une symétrie. \(\mathrm{Ker}(\sigma - \mathrm{Id})\) = fonctions paires \(\mathcal{P}\) ; \(\mathrm{Ker}(\sigma + \mathrm{Id})\) = fonctions impaires \(\mathcal{I}\). Donc \(\mathbb{R}^\mathbb{R} = \mathcal{P} \oplus \mathcal{I}\). Définissons $$ f_{\mathrm{paire}}(x) = \frac{f(x) + f(-x)}{2}, \qquad f_{\mathrm{impaire}}(x) = \frac{f(x) - f(-x)}{2}. $$ Alors \(f = f_{\mathrm{paire}} + f_{\mathrm{impaire}}\).
Compétences à pratiquer
- Lier projecteur et symétrie
V
Formes linéaires et hyperplans
V.1
Formes linéaires et formes coordonnées
Une forme linéaire est une application linéaire à valeurs dans le corps de base \(\mathbb{K}\). En dimension finie, une base étant fixée, toute forme linéaire est de la même nature : une combinaison linéaire \(a_1 x_1 + \cdots + a_n x_n\) des coordonnées. Les \(a_i\) sont uniques et égaux aux valeurs de la forme sur les vecteurs de base. L'étude systématique du dual \(\mathcal{L}(E, \mathbb{K})\) et des bases duales est hors programme (« L'étude de la dualité est hors programme ») ; les formes coordonnées n'apparaissent ici qu'en tant qu'outil pratique pour écrire des équations d'hyperplans.
Définition — Forme linéaire
Soit \(E\) un \(\mathbb{K}\)-espace vectoriel. Une forme linéaire sur \(E\) est une application linéaire \(\varphi : E \to \mathbb{K}\). Proposition — Formes coordonnées
Soit \(E\) un \(\mathbb{K}\)-espace vectoriel de dimension finie de base \(\mathcal{B} = (e_1, \ldots, e_n)\). - (a) Pour chaque \(i \in \llbracket 1, n \rrbracket\), l'application $$ \mathrm{co}_i : E \longrightarrow \mathbb{K}, \quad x = x_1 e_1 + \cdots + x_n e_n \longmapsto x_i $$ est une forme linéaire sur \(E\), appelée la \(i\)-ème forme coordonnée dans \(\mathcal{B}\).
- (b) Toute forme linéaire \(\varphi\) sur \(E\) s'écrit de manière unique comme combinaison linéaire des formes coordonnées : $$ \textcolor{colorprop}{\varphi(x_1 e_1 + \cdots + x_n e_n) = a_1 x_1 + \cdots + a_n x_n} \quad \text{avec} \quad a_i := \varphi(e_i). $$
- (a) Linéarité de \(\mathrm{co}_i\) : la coordonnée de \(\lambda x + y\) sur \(e_i\) vaut \(\lambda\) fois la coordonnée de \(x\) plus la coordonnée de \(y\) (unicité des coordonnées dans une base).
- (b) Existence. Pour \(x = \sum x_i e_i\), la linéarité de \(\varphi\) donne \(\varphi(x) = \sum x_i \varphi(e_i) = \sum a_i x_i\) avec \(a_i := \varphi(e_i)\).
Unicité. Si \(\varphi(x) = b_1 x_1 + \cdots + b_n x_n\) pour tout \(x\), alors évaluer en \(e_j\) donne \(\varphi(e_j) = b_j\). Donc \(b_j = a_j\) pour tout \(j\).
Hors programme — dualité
L'étude systématique du dual \(\mathcal{L}(E, \mathbb{K})\) et des bases duales est hors programme : « L'étude de la dualité est hors programme. » On utilise les formes coordonnées de manière opérationnelle — uniquement pour écrire des équations d'hyperplans ci-dessous.
Méthode — Identifier une forme linéaire sur \(\mathbb{K}^n\)
Toute forme linéaire sur \(\mathbb{K}^n\) est du type \((x_1, \ldots, x_n) \mapsto a_1 x_1 + \cdots + a_n x_n\) pour un unique \(n\)-uplet \((a_1, \ldots, a_n) \in \mathbb{K}^n\). Lire directement les coefficients via \(a_i = \varphi(e_i)\) sur la base canonique. Exemple
Sur \(\mathbb{R}^3\), définissons \(\varphi(x, y, z) = 2x + y - 3z\). Le triplet des coefficients est \((a_1, a_2, a_3) = (2, 1, -3)\), avec \(a_i = \varphi(e_i)\). Comme \(\varphi\) est non nulle, son noyau \(\{(x, y, z) : 2x + y - 3z = 0\}\) est un hyperplan de \(\mathbb{R}^3\) (voir ci-dessous). Exemple
Sur \(\mathbb{R}_2[X]\), considérons les trois formes linéaires \(\varphi_0 : P \mapsto P(0)\), \(\varphi_1 : P \mapsto P(1)\), \(\delta : P \mapsto P'(0)\). Ensemble, elles déterminent un polynôme : les trois conditions \(P(0) = 0\), \(P(1) = 0\), \(P'(0) = 0\) imposent \(P = 0\) dans \(\mathbb{R}_2[X]\). Esquisse. Écrivons \(P = a + b X + c X^2\). Alors \(P(0) = a\), \(P'(0) = b\), \(P(1) = a + b + c\). Les trois conditions donnent \(a = 0\), \(b = 0\), \(a + b + c = c = 0\). Donc \(P = 0\).
Compétences à pratiquer
- Écrire les formes coordonnées dans une base donnée
V.2
Hyperplans
Définition — Hyperplan
Soit \(E\) un \(\mathbb{K}\)-espace vectoriel. Un hyperplan de \(E\) est le noyau d'une forme linéaire non nulle sur \(E\) : $$ H = \mathrm{Ker}\,\varphi \quad \text{avec} \quad \varphi \in \mathcal{L}(E, \mathbb{K}) \setminus \{0\}. $$ Théorème — Caractérisation géométrique des hyperplans
Soit \(H\) un sous-espace de \(E\). Les propositions suivantes sont équivalentes : - (i) \(H\) est un hyperplan de \(E\) ;
- (ii) \(H\) admet un supplémentaire qui est une droite, soit il existe \(v \in E\) avec \(E = H \oplus \mathrm{Vect}(v)\).
- (i) \(\Rightarrow\) (ii). Supposons \(H = \mathrm{Ker}\,\varphi\) avec \(\varphi \ne 0\). Choisissons \(v \in E\) avec \(\varphi(v) \ne 0\). Montrons \(E = H \oplus \mathrm{Vect}(v)\).
- Somme égale à \(E\). Pour \(x \in E\), écrivons \(x = \bigl(x - \tfrac{\varphi(x)}{\varphi(v)} v\bigr) + \tfrac{\varphi(x)}{\varphi(v)} v\). En appliquant \(\varphi\) au premier morceau, par linéarité : \(\varphi\bigl(x - \tfrac{\varphi(x)}{\varphi(v)} v\bigr) = \varphi(x) - \tfrac{\varphi(x)}{\varphi(v)} \varphi(v) = \varphi(x) - \varphi(x) = 0\), donc le premier morceau est dans \(H\) ; le second est manifestement dans \(\mathrm{Vect}(v)\).
- Somme directe. Si \(y \in H \cap \mathrm{Vect}(v)\), écrivons \(y = \alpha v\). Alors \(0 = \varphi(y) = \alpha \varphi(v)\), donc \(\alpha = 0\) (puisque \(\varphi(v) \ne 0\)), donc \(y = 0\).
- (ii) \(\Rightarrow\) (i). Supposons \(E = H \oplus \mathrm{Vect}(v)\) pour un \(v \ne 0\). Définissons \(\varphi : E \to \mathbb{K}\) sur la somme directe par \(\varphi_{|H} = 0\) et \(\varphi(v) = 1\) ; le théorème « restrictions à une somme directe » plus haut donne une unique application linéaire \(\varphi\). Alors \(\varphi\) est non nulle (\(\varphi(v) = 1\)), et \(\mathrm{Ker}\,\varphi = H\) car tout \(x = h + \alpha v\) vérifie \(\varphi(x) = \alpha\), qui est \(0\) ssi \(\alpha = 0\) ssi \(x \in H\).
Méthode — Reconnaître un hyperplan
En dimension finie \(n\), un hyperplan est un sous-espace de codimension \(1\), soit de dimension \(n - 1\). De manière équivalente : l'ensemble des solutions d'une seule équation linéaire non triviale en les coordonnées. Exemple
Dans \(\mathbb{R}^4\), l'ensemble \(H = \{(x, y, z, t) : 2 x + y - z + t = 0\}\) est un hyperplan de dimension \(3\). C'est le noyau de la forme linéaire non nulle \(\varphi(x, y, z, t) = 2 x + y - z + t\). Exemple
Dans \(\mathbb{R}_3[X]\) (dimension \(4\)), l'ensemble \(H = \{P \in \mathbb{R}_3[X] : P(0) = P(1)\}\) est un hyperplan : c'est le noyau de la forme linéaire non nulle \(\varphi : P \mapsto P(1) - P(0)\), donc \(\dim H = 3\). Compétences à pratiquer
- Identifier un hyperplan
V.3
Équations d'un hyperplan : comparaison
Proposition — Deux équations du même hyperplan sont proportionnelles
Soit \(H\) un hyperplan de \(E\) et soient \(\varphi, \psi\) deux formes linéaires non nulles de \(E\) de noyau \(H\). Alors il existe \(\lambda \in \mathbb{K}^*\) tel que $$ \textcolor{colorprop}{\psi = \lambda \varphi}. $$ Autrement dit, deux équations d'un même hyperplan sont proportionnelles.
Choisissons \(v \notin H\) (existe puisque \(H \ne E\)). Alors \(\varphi(v) \ne 0\) et \(\psi(v) \ne 0\). Posons \(\lambda := \psi(v) / \varphi(v) \in \mathbb{K}^*\) et considérons \(\psi - \lambda \varphi\) :
- sur \(H\) : \(\psi - \lambda \varphi\) s'annule (les deux \(\psi\) et \(\varphi\) s'annulent) ;
- en \(v\) : \((\psi - \lambda \varphi)(v) = \psi(v) - \lambda \varphi(v) = \psi(v) - \psi(v) = 0\).
Compétences à pratiquer
- Comparer deux équations d'un hyperplan
V.4
Intersection d'hyperplans
Théorème — Intersection de \(p\) hyperplans
Soient \(E\) un \(\mathbb{K}\)-espace vectoriel de dimension finie \(n \ge 1\), et \(p \in \llbracket 1, n \rrbracket\). - (i) L'intersection de \(p\) hyperplans de \(E\) est un sous-espace de \(E\) de dimension au moins \(n - p\).
- (ii) Inversement, tout sous-espace de \(E\) de dimension \(n - p\) est l'intersection de \(p\) hyperplans de \(E\).
- (i) Soient \(H_1, \ldots, H_p\) \(p\) hyperplans de \(E\), d'équations \(\varphi_1, \ldots, \varphi_p\) (formes linéaires non nulles). Considérons l'application linéaire $$ \Phi : E \longrightarrow \mathbb{K}^p, \quad x \longmapsto (\varphi_1(x), \ldots, \varphi_p(x)). $$ Alors \(\mathrm{Ker}\,\Phi = \bigcap_{i=1}^p \mathrm{Ker}\,\varphi_i = \bigcap H_i\). Par le théorème du rang, \(\dim \mathrm{Ker}\,\Phi = n - \mathrm{rg}(\Phi) \ge n - p\) puisque \(\mathrm{rg}(\Phi) \le \dim \mathbb{K}^p = p\).
- (ii) Soit \(G\) un sous-espace de \(E\) de dimension \(n - p\). Choisissons une base \((e_1, \ldots, e_{n-p})\) de \(G\) et complétons-la (théorème de la base incomplète, prérequis Espaces vectoriels de dimension finie) en une base \((e_1, \ldots, e_n)\) de \(E\). Dans cette base, un vecteur \(x = \sum x_i e_i\) est dans \(G\) si et seulement si \(x_{n-p+1} = \cdots = x_n = 0\). Les \(p\) formes coordonnées \(\mathrm{co}_{n-p+1}, \ldots, \mathrm{co}_n\) de la proposition « formes coordonnées » sont des formes linéaires non nulles, donc leurs noyaux sont \(p\) hyperplans de \(E\). Leur intersection est exactement \(G\).
Méthode — Décrire un sous-espace par des équations linéaires
Pour décrire un sous-espace \(G\) de \(E\) (dim \(n\)) de dim \(n - p\) : écrire un système de \(p\) équations linéaires linéairement indépendantes en les coordonnées. Chaque équation définit un hyperplan ; \(G\) est leur intersection. Inversement, la dimension de l'espace des solutions d'un système linéaire de \(p\) équations en \(n\) inconnues est au moins \(n - p\), avec égalité lorsque les \(p\) équations sont linéairement indépendantes (réduction de Gauss à \(p\) pivots, chapitre Systèmes linéaires). Exemple
Dans \(\mathbb{R}^3\), la droite \(D = \{(x, y, z) : x = y \text{ et } z = 0\}\) est l'intersection de deux hyperplans (plans) : \(H_1 = \{x - y = 0\}\) et \(H_2 = \{z = 0\}\). Par le théorème, \(\dim D \ge 3 - 2 = 1\). Inversement \(D\) est paramétrée par \((t, t, 0)\), donc \(\dim D = 1\) exactement. Compétences à pratiquer
- Intersection d'hyperplans
Aller à la section