Éducation Nationale Française · ECGappliquées
Lois discrètes usuelles
Ce chapitre est un inventaire des lois discrètes usuelles — les lois nommées qui décrivent les expériences aléatoires les plus courantes et qu'il faut connaître par cœur. Chaque loi vient avec son ensemble de valeurs \(X(\Omega)\), ses probabilités \(P(X = k)\), et son espérance et sa variance. On s'appuie partout sur la boîte à outils générale du chapitre Variables aléatoires discrètes : une loi est une liste de valeurs avec leurs probabilités de somme \(1\), l'espérance \(E(X)\) et la variance \(V(X) = E(X^2) - (E(X))^2\) (Koenig-Huygens), et la fonction de répartition \(F_X(x) = P(X \le x)\). On sépare les lois en deux familles : les lois finies (certaine, uniforme, Bernoulli, binomiale), dont le support est un ensemble fini, et les lois infinies (géométrique, Poisson), dont le support est infini et dont l'espérance est donc une série. La loi binomiale porte la formule du binôme \((a + b)^n\). On note \(X \hookrightarrow \mathcal{L}\) pour « \(X\) suit la loi \(\mathcal{L}\) ».
I
Lois discrètes finies
I.1
La loi certaine
La loi la plus simple de toutes : une variable aléatoire qui prend toujours la même valeur. Elle n'a rien d'aléatoire, mais elle se trouve au bas de l'échelle de variabilité — sa variance est nulle, et réciproquement une variance nulle la caractérise.
Définition — Loi certaine
Soit \(a \in \mathbb{R}\). Une v.a.\ discrète \(X\) suit la loi certaine égale à \(a\) lorsque $$ \textcolor{colordef}{X(\Omega) = \{a\} \quad \text{et} \quad P(X = a) = 1.} $$ De manière équivalente \(X = a\) presque sûrement. Une telle variable est aussi appelée variable aléatoire constante (ou presque sûrement certaine). Proposition — Espérance et variance de la loi certaine
Si \(X = a\) presque sûrement, alors \(X\) admet espérance et variance, avec $$ \textcolor{colorprop}{E(X) = a \qquad \text{et} \qquad V(X) = 0.} $$ Réciproquement, si \(V(X) = 0\) alors \(X\) est presque sûrement certaine : il existe \(a \in X(\Omega)\) tel que \(P(X = a) = 1\). Donc « \(V(X) = 0\) » caractérise la loi certaine.
\(E(X) = a \cdot P(X = a) = a \cdot 1 = a\). Puis \(V(X) = E((X - a)^2)\), et \((X - a)^2 = 0\) presque sûrement, donc \(V(X) = 0\). La réciproque (variance nulle \(\Rightarrow\) presque sûrement constante) est le résultat « cas \(V(X) = 0\) » démontré au chapitre Variables aléatoires discrètes.
Exemple
Soit \(X = 5\) presque sûrement. Alors \(E(X) = 5\), \(V(X) = 0\), et \(F_X\) est l'échelon qui saute de \(0\) à \(1\) en \(x = 5\). Compétences à pratiquer
- Manipuler la loi certaine
I.2
La loi uniforme
La loi uniforme sur un ensemble d'entiers consécutifs modélise un tirage où toutes les valeurs sont équiprobables — un dé équilibré, un nombre tiré au hasard dans \(\{1, \dots, n\}\). On traite d'abord \(\llbracket 1, n \rrbracket\), puis on en déduit le cas général \(\llbracket a, b \rrbracket\) par une translation.
Définition — Loi uniforme sur \(\llbracket 1\virgule n \rrbracket\)
Soit \(n \in \mathbb{N}^*\). Une v.a.\ discrète \(X\) suit la loi uniforme sur \(\llbracket 1, n \rrbracket\), notée $$ \textcolor{colordef}{X \hookrightarrow \mathcal{U}(\llbracket 1, n \rrbracket),} $$ quand \(X(\Omega) = \llbracket 1, n \rrbracket = \{1, 2, \dots, n\}\) et, pour tout \(k \in \llbracket 1, n \rrbracket\), $$ \textcolor{colordef}{P(X = k) = \frac{1}{n}.} $$ Plus généralement, pour \(a, b \in \mathbb{Z}\) avec \(a \le b\), \(X \hookrightarrow \mathcal{U}(\llbracket a, b \rrbracket)\) quand \(X(\Omega) = \llbracket a, b \rrbracket\) et \(P(X = k) = \dfrac{1}{b - a + 1}\) pour chaque \(k \in \llbracket a, b \rrbracket\) (il y a \(b - a + 1\) entiers dans \(\llbracket a, b \rrbracket\)). Proposition — Espérance et variance de la loi uniforme
Si \(X \hookrightarrow \mathcal{U}(\llbracket 1, n \rrbracket)\), alors $$ \textcolor{colorprop}{E(X) = \frac{n + 1}{2}, \qquad V(X) = \frac{n^2 - 1}{12}.} $$ Si \(X \hookrightarrow \mathcal{U}(\llbracket a, b \rrbracket)\), alors $$ \textcolor{colorprop}{E(X) = \frac{a + b}{2}, \qquad V(X) = \frac{(b - a + 1)^2 - 1}{12}.} $$
Pour \(\mathcal{U}(\llbracket 1, n \rrbracket)\), espérance par la formule et l'identité \(\sum_{k=1}^n k = \frac{n(n+1)}{2}\) (chapitre Méthodes de calcul) : $$ \begin{aligned} E(X) &= \sum_{k=1}^{n} k \cdot \frac{1}{n} && \text{(définition)} \\
&= \frac{1}{n} \cdot \frac{n(n + 1)}{2} = \frac{n + 1}{2}. && \text{(}\textstyle\sum k\text{)} \end{aligned} $$ Pour la variance, transfert avec \(\sum_{k=1}^n k^2 = \frac{n(n+1)(2n+1)}{6}\) : $$ \begin{aligned} E(X^2) &= \frac{1}{n} \sum_{k=1}^{n} k^2 = \frac{(n + 1)(2n + 1)}{6}, && \text{(}\textstyle\sum k^2\text{)} \\
V(X) &= E(X^2) - (E(X))^2 && \text{(Koenig-Huygens)} \\
&= \frac{(n + 1)(2n + 1)}{6} - \frac{(n + 1)^2}{4} = \frac{n^2 - 1}{12}. \end{aligned} $$ Le cas général \(\llbracket a, b \rrbracket\) s'en déduit en posant \(Y = X - a + 1 \hookrightarrow \mathcal{U}(\llbracket 1, b - a + 1 \rrbracket)\) et en utilisant \(E(X) = E(Y) + a - 1\), \(V(X) = V(Y)\) (une translation ne change pas la variance).
Exemple — Dé équilibré
Un dé équilibré à six faces : \(X \hookrightarrow \mathcal{U}(\llbracket 1, 6 \rrbracket)\), donc \(P(X = k) = \frac{1}{6}\) pour chaque \(k\), \(E(X) = \frac{6 + 1}{2} = 3{,}5\) et \(V(X) = \frac{36 - 1}{12} = \frac{35}{12} \approx 2{,}92\). Compétences à pratiquer
- Manipuler la loi uniforme
I.3
La loi de Bernoulli \(\mathcal{B}(p)\)
La loi de Bernoulli est la loi d'une unique épreuve succès/échec : une expérience à deux issues, succès (codé \(1\)) de probabilité \(p\), et échec (codé \(0\)) de probabilité \(1 - p\). C'est la brique de base à partir de laquelle on construit les lois binomiale et géométrique.
Définition — Loi de Bernoulli \(\mathcal{B}(p)\)
Soit \(p \in {]0, 1[}\). Une v.a.\ discrète \(X\) suit la loi de Bernoulli de paramètre \(p\), notée $$ \textcolor{colordef}{X \hookrightarrow \mathcal{B}(p),} $$ quand \(X(\Omega) = \{0, 1\}\) et $$ \textcolor{colordef}{P(X = 1) = p, \qquad P(X = 0) = 1 - p.} $$ La valeur \(1\) code un succès (probabilité \(p\)), la valeur \(0\) un échec (probabilité \(1 - p\)). Une telle épreuve est appelée épreuve de Bernoulli. Proposition — Espérance et variance de \(\mathcal{B}(p)\)
Si \(X \hookrightarrow \mathcal{B}(p)\), alors $$ \textcolor{colorprop}{E(X) = p \qquad \text{et} \qquad V(X) = p(1 - p).} $$
Direct depuis la définition (une somme finie sur \(\{0, 1\}\)) : $$ \begin{aligned} E(X) &= 0 \cdot (1 - p) + 1 \cdot p = p, && \text{(définition)} \\
E(X^2) &= 0^2 \cdot (1 - p) + 1^2 \cdot p = p, && \text{(}X^2 = X \text{ sur } \{0,1\}\text{)} \\
V(X) &= E(X^2) - (E(X))^2 && \text{(Koenig-Huygens)} \\
&= p - p^2 = p(1 - p). \end{aligned} $$
Exemple — Indicatrice d'un événement
Pour un événement \(A\) avec \(P(A) = p\), l'indicatrice \(\mathbf{1}_A\) (qui vaut \(1\) si \(A\) se réalise, \(0\) sinon) suit \(\mathcal{B}(p)\). Donc \(E(\mathbf{1}_A) = P(A)\) : l'espérance d'une indicatrice est la probabilité de l'événement. Compétences à pratiquer
- Manipuler la loi de Bernoulli
I.4
La loi binomiale \(\mathcal{B}(n\virgule p)\)
La loi binomiale compte le nombre de succès dans \(n\) répétitions indépendantes de la même épreuve de Bernoulli de paramètre \(p\) — le « schéma de Bernoulli » d'ordre \(n\). Le nombre de façons de placer \(k\) succès parmi \(n\) épreuves est le coefficient binomial \(\binom{n}{k}\) (chapitre Probabilités sur un ensemble fini), ce qui explique l'apparition des coefficients binomiaux dans la loi.
Définition — Loi binomiale \(\mathcal{B}(n\virgule p)\)
Soient \(n \in \mathbb{N}^*\) et \(p \in {]0, 1[}\). Une v.a.\ discrète \(X\) suit la loi binomiale de paramètres \(n\) et \(p\), notée $$ \textcolor{colordef}{X \hookrightarrow \mathcal{B}(n, p),} $$ quand \(X(\Omega) = \llbracket 0, n \rrbracket\) et, pour tout \(k \in \llbracket 0, n \rrbracket\), $$ \textcolor{colordef}{P(X = k) = \binom{n}{k} p^k (1 - p)^{n - k}.} $$ Le modèle : répéter \(n\) fois, indépendamment, la même épreuve de Bernoulli de probabilité de succès \(p\) ; alors \(X = \) « nombre de succès » suit \(\mathcal{B}(n, p)\). Proposition — Espérance et variance de \(\mathcal{B}(n\virgule p)\)
Si \(X \hookrightarrow \mathcal{B}(n, p)\), alors $$ \textcolor{colorprop}{E(X) = np \qquad \text{et} \qquad V(X) = np(1 - p).} $$ Exemple — Nombre de six en cinq lancers
On lance un dé équilibré \(n = 5\) fois ; soit \(X\) le nombre de six. Chaque lancer est un succès (« un six ») avec probabilité \(p = \frac{1}{6}\), indépendamment, donc \(X \hookrightarrow \mathcal{B}(5, \frac{1}{6})\). Par exemple $$ P(X = 2) = \binom{5}{2} \left( \frac{1}{6} \right)^2 \left( \frac{5}{6} \right)^3 = 10 \cdot \frac{1}{36} \cdot \frac{125}{216} = \frac{1250}{7776} \approx 0{,}16, $$ et \(E(X) = 5 \cdot \frac{1}{6} = \frac{5}{6}\), \(V(X) = 5 \cdot \frac{1}{6} \cdot \frac{5}{6} = \frac{25}{36}\). Théorème — Formule du binôme de Newton
Pour tous réels \(a, b\) et tout \(n \in \mathbb{N}\), $$ \textcolor{colorprop}{(a + b)^n = \sum_{k=0}^{n} \binom{n}{k} a^k b^{n - k}.} $$
Par récurrence sur \(n\). Initialisation \(n = 0\) : \((a + b)^0 = 1\) et la somme se réduit à \(\binom{0}{0} a^0 b^0 = 1\). Hérédité. On suppose la formule au rang \(n\). Avec la règle de Pascal \(\binom{n}{k - 1} + \binom{n}{k} = \binom{n + 1}{k}\) (chapitre Probabilités sur un ensemble fini), $$ \begin{aligned} (a + b)^{n + 1} &= (a + b)(a + b)^n \\
&= (a + b) \sum_{k=0}^{n} \binom{n}{k} a^k b^{n - k} && \text{(hypothèse de récurrence)} \\
&= \sum_{k=0}^{n} \binom{n}{k} a^{k + 1} b^{n - k} + \sum_{k=0}^{n} \binom{n}{k} a^k b^{n + 1 - k} && \text{(développer)} \\
&= \sum_{j=1}^{n + 1} \binom{n}{j - 1} a^j b^{n + 1 - j} + \sum_{k=0}^{n} \binom{n}{k} a^k b^{n + 1 - k} && \text{(changement } j = k + 1\text{)} \\
&= \sum_{k=0}^{n + 1} \left( \binom{n}{k - 1} + \binom{n}{k} \right) a^k b^{n + 1 - k} && \text{(fusion ; termes de bord)} \\
&= \sum_{k=0}^{n + 1} \binom{n + 1}{k} a^k b^{n + 1 - k}. && \text{(Pascal)} \end{aligned} $$
Exemple — La loi binomiale somme à \(1\)
La formule du binôme confirme que \(\mathcal{B}(n, p)\) est une loi valide. Avec \(a = p\) et \(b = 1 - p\) : $$ \sum_{k=0}^{n} \binom{n}{k} p^k (1 - p)^{n - k} = (p + (1 - p))^n = 1^n = 1. $$ Proposition — Lien avec \(\mathcal{B}(n\virgule a / (a + b))\)
Soient \(a, b > 0\) et \(n \in \mathbb{N}^*\). En divisant la formule du binôme par \((a + b)^n\) et en posant \(p = \dfrac{a}{a + b}\) (donc \(1 - p = \dfrac{b}{a + b}\)), $$ \textcolor{colorprop}{\sum_{k=0}^{n} \binom{n}{k} \left( \frac{a}{a + b} \right)^k \left( \frac{b}{a + b} \right)^{n - k} = 1.} $$ Le membre de gauche est exactement \(\sum_k P(X = k)\) pour \(X \hookrightarrow \mathcal{B}\bigl(n, \frac{a}{a + b}\bigr)\) : la formule du binôme est l'identité « somme de la loi binomiale égale \(1\) » déguisée. Méthode — Reconnaître une loi finie usuelle
- Certaine : \(X\) prend une seule valeur \(a\) avec probabilité \(1\) (\(E = a\), \(V = 0\)).
- Uniforme : \(X\) prend \(n\) valeurs entières consécutives, toutes équiprobables (\(P = 1/n\)).
- Bernoulli : une seule épreuve succès/échec, \(X \in \{0, 1\}\), \(P(X = 1) = p\).
- Binomiale : compter le nombre de succès dans \(n\) répétitions indépendantes de la même épreuve de Bernoulli ; alors \(X \hookrightarrow \mathcal{B}(n, p)\), \(E = np\), \(V = np(1 - p)\). Les deux piliers sont l'indépendance et le caractère identique des épreuves.
Compétences à pratiquer
- Manipuler la loi binomiale et la formule du binôme
II
Les lois certaine et de Bernoulli via la fonction de répartition
II.1
Lire la fonction de répartition
La fonction de répartition \(F_X(x) = P(X \le x)\) du chapitre Variables aléatoires discrètes lit une loi finie comme une fonction en escalier. On lit les deux cas les plus simples — les lois certaine et de Bernoulli — comme modèle ; la même image en escalier s'applique à toute loi finie.
Exemple — Fonction de répartition d'une v.a.\ certaine
Soit \(X = a\) presque sûrement, \(a \in \mathbb{R}\). Alors \(F_X(x) = 0\) pour \(x < a\) et \(F_X(x) = 1\) pour \(x \ge a\) — l'échelon de Heaviside en \(a\). Exemple — Fonction de répartition d'une v.a.\ de Bernoulli
\(X \hookrightarrow \mathcal{B}(p)\) avec \(p \in {]0, 1[}\) a \(X(\Omega) = \{0, 1\}\), \(P(X = 0) = 1 - p\), \(P(X = 1) = p\). Alors $$ F_X(x) = \begin{cases} 0 & \text{si } x < 0, \\
1 - p & \text{si } 0 \le x < 1, \\
1 & \text{si } x \ge 1. \end{cases} $$ Deux sauts de hauteurs \(1 - p\) et \(p\), de somme \(1\). Compétences à pratiquer
- Lire la fonction de répartition des lois certaine et de Bernoulli
III
La loi géométrique \(\mathcal{G}(p)\)
III.1
Définition et moments
La première loi discrète infinie : la loi géométrique modélise le rang du premier succès dans un processus de Bernoulli sans mémoire — on répète la même épreuve indépendamment jusqu'au premier succès, et on compte combien d'épreuves cela a pris. Son support est \(\mathbb{N}^*\) (infini), donc son espérance est une série, évaluée à l'aide de la série géométrique du chapitre Séries numériques.
Définition — Loi géométrique \(\mathcal{G}(p)\)
Soit \(p \in {]0, 1[}\). Une v.a.\ discrète \(X\) suit la loi géométrique de paramètre \(p\), notée $$ \textcolor{colordef}{X \hookrightarrow \mathcal{G}(p),} $$ quand \(X(\Omega) = \mathbb{N}^*\) et, pour tout \(k \in \mathbb{N}^*\), $$ \textcolor{colordef}{P(X = k) = p (1 - p)^{k-1}.} $$ Le cadre qui produit une telle loi est « répéter la même expérience indépendamment, à probabilité de succès \(p\) à chaque essai ; \(X\) = rang du premier succès ». L'« indépendance » et la « probabilité de succès constante \(p\) » sont toutes deux essentielles : sans indépendance, \(P(X = k) = p(1-p)^{k-1}\) ne serait plus valide. Proposition — \(\mathcal{G}(p)\) est une loi valide
Pour \(p \in {]0, 1[}\), \(\sum_{k \ge 1} p (1 - p)^{k-1} = 1\).
Posons \(q = 1 - p \in {]0, 1[}\). Par la série géométrique (chapitre Séries numériques), $$ \sum_{k=1}^{+\infty} p q^{k-1} = p \sum_{k=1}^{+\infty} q^{k-1} = p \cdot \frac{1}{1 - q} = \frac{p}{p} = 1. $$
Exemple — Lancer un dé équilibré jusqu'au premier six
On lance un dé équilibré ; \(X\) = rang du premier \(6\). Chaque lancer est un succès (\(6\)) avec probabilité \(p = 1/6\), indépendamment. Alors \(X \hookrightarrow \mathcal{G}(1/6)\) : $$ P(X = 1) = \frac{1}{6}, \quad P(X = 2) = \frac{5}{6} \cdot \frac{1}{6} = \frac{5}{36}, \quad P(X = 3) = \left( \frac{5}{6} \right)^2 \cdot \frac{1}{6} = \frac{25}{216}. $$ Proposition — Espérance et variance de \(\mathcal{G}(p)\)
Si \(X \hookrightarrow \mathcal{G}(p)\), alors \(X\) admet espérance et variance, avec $$ \textcolor{colorprop}{E(X) = \frac{1}{p}, \qquad V(X) = \frac{1 - p}{p^2}.} $$
Posons \(q = 1 - p\). Espérance. Par transfert (existence et valeur) : la série $$ \sum_{k \ge 1} k \cdot p q^{k-1} = p \sum_{k \ge 1} k q^{k-1} $$ converge absolument (termes positifs, série géométrique dérivée première en \(q \in {]0, 1[}\), chapitre Séries numériques). Donc \(X\) a une espérance et $$ \begin{aligned} E(X) &= \sum_{k=1}^{+\infty} k \cdot p q^{k-1} && \text{(Définition / transfert)} \\
&= p \sum_{k=1}^{+\infty} k q^{k-1} && \text{(factoriser } p\text{)} \\
&= p \cdot \frac{1}{(1 - q)^2} && \text{(géométrique dérivée première, ch.~\textit{Séries numériques})} \\
&= p \cdot \frac{1}{p^2} = \frac{1}{p}. \end{aligned} $$ Moment d'ordre 2. On décompose \(k^2 = k(k - 1) + k\) pour utiliser la géométrique dérivée seconde. La série \(\sum k(k-1) p q^{k-1}\) converge absolument (termes positifs, géométrique dérivée seconde en \(q \in {]0, 1[}\)). Avec l'étape précédente, \(E(X^2)\) existe et $$ \begin{aligned} E(X(X - 1)) &= \sum_{k=1}^{+\infty} k(k - 1)\, p q^{k-1} && \text{(transfert)} \\
&= p q \sum_{k=2}^{+\infty} k(k - 1)\, q^{k-2} && \text{(factoriser } pq\text{ ; le terme } k = 1 \text{ est nul)} \\
&= p q \cdot \frac{2}{(1 - q)^3} && \text{(géométrique dérivée seconde)} \\
&= p q \cdot \frac{2}{p^3} = \frac{2 q}{p^2} = \frac{2(1 - p)}{p^2}. \end{aligned} $$ Par linéarité, \(E(X^2) = E(X(X - 1)) + E(X) = 2(1 - p)/p^2 + 1/p = (2 - 2p + p)/p^2 = (2 - p)/p^2\). Variance par Koenig-Huygens. $$ V(X) = E(X^2) - (E(X))^2 = \frac{2 - p}{p^2} - \frac{1}{p^2} = \frac{1 - p}{p^2}. $$
Exemple — Application numérique au dé
\(X \hookrightarrow \mathcal{G}(1/6)\) : \(E(X) = 6\) (en moyenne, six lancers pour obtenir le premier \(6\)), \(V(X) = (5/6) / (1/36) = 30\), \(\sigma(X) = \sqrt{30} \approx 5{,}48\).
La fonction de répartition d'une loi géométrique a une forme close : c'est \(1\) moins la probabilité de « \(\lfloor x \rfloor\) échecs d'affilée », une somme géométrique finie.
Proposition — Fonction de répartition de \(\mathcal{G}(p)\)
Pour \(X \hookrightarrow \mathcal{G}(p)\) et \(x \in \mathbb{R}\), $$ \textcolor{colorprop}{F_X(x) = \begin{cases} 0 & \text{si } x < 1, \\
1 - (1 - p)^{\lfloor x \rfloor} & \text{si } x \ge 1, \end{cases}} $$ où \(\lfloor x \rfloor\) est la partie entière de \(x\).
Pour \(x < 1\), \([X \le x] = \emptyset\) (car \(X \ge 1\) toujours), donc \(F_X(x) = 0\). Pour un entier \(k \ge 1\), posons \(q = 1 - p\) : $$ \begin{aligned} F_X(k) &= \sum_{j=1}^{k} p q^{j-1} && \text{(Définition de } F_X\text{ ; somme finie)} \\
&= p \cdot \frac{1 - q^k}{1 - q} && \text{(somme géométrique finie)} \\
&= 1 - q^k = 1 - (1 - p)^k. \end{aligned} $$ Pour un \(x \ge 1\) non entier, \(X(\Omega) \subset \mathbb{N}^*\) donne \([X \le x] = [X \le \lfloor x \rfloor]\), donc \(F_X(x) = F_X(\lfloor x \rfloor) = 1 - (1 - p)^{\lfloor x \rfloor}\).
Méthode — Reconnaître une loi géométrique
Le motif distinctif : répéter une expérience indépendamment à probabilité de succès constante \(p\), jusqu'au premier succès ; \(X\) est le rang de ce premier succès. Alors \(X \hookrightarrow \mathcal{G}(p)\), et les formules \(E(X) = 1/p\), \(V(X) = (1 - p)/p^2\), \(F_X(k) = 1 - (1 - p)^k\) s'appliquent. Les deux piliers sont l'indépendance des essais et la constance de la probabilité de succès \(p\). Compétences à pratiquer
- Manipuler la loi géométrique \(\mathcal{G}(p)\)
IV
La loi de Poisson \(\mathcal{P}(\lambda)\)
IV.1
Définition et moments
La loi de Poisson modélise un comptage d'événements rares — le nombre d'occurrences indépendantes rares dans une fenêtre fixée : fautes de frappe sur une page, appels téléphoniques en une heure, particules émises par une source en une seconde. Son paramètre \(\lambda > 0\) est à la fois le comptage moyen et la variance. Son support est \(\mathbb{N}\) (infini), et ses probabilités somment à \(1\) grâce à la série exponentielle du chapitre Séries numériques. On peut remarquer que \(\mathcal{P}(\lambda)\) est la loi « limite » de \(\mathcal{B}(n, \lambda / n)\) quand \(n\) grandit, lorsque la probabilité de succès est petite et le nombre d'essais grand — une notion précisée en deuxième année.
Définition — Loi de Poisson \(\mathcal{P}(\lambda)\)
Soit \(\lambda > 0\). Une v.a.\ discrète \(X\) suit la loi de Poisson de paramètre \(\lambda\), notée $$ \textcolor{colordef}{X \hookrightarrow \mathcal{P}(\lambda),} $$ quand \(X(\Omega) = \mathbb{N}\) et, pour tout \(k \in \mathbb{N}\), $$ \textcolor{colordef}{P(X = k) = e^{-\lambda} \frac{\lambda^k}{k!}.} $$ Proposition — \(\mathcal{P}(\lambda)\) est une loi valide
Pour \(\lambda > 0\), \(\sum_{k \ge 0} e^{-\lambda} \lambda^k / k! = 1\).
On factorise \(e^{-\lambda}\) et on applique la série exponentielle (chapitre Séries numériques, admise) : $$ \sum_{k=0}^{+\infty} e^{-\lambda} \frac{\lambda^k}{k!} = e^{-\lambda} \sum_{k=0}^{+\infty} \frac{\lambda^k}{k!} = e^{-\lambda} \cdot e^{\lambda} = 1. $$
Exemple — Modélisation
Nombre d'appels reçus à un petit centre d'appels en une heure (moyenne \(\lambda = 3\) par heure) : sous l'hypothèse d'indépendance des événements rares, \(X \hookrightarrow \mathcal{P}(3)\), et $$ P(X = 0) = e^{-3} \approx 0{,}050, \qquad P(X = 1) = 3 e^{-3} \approx 0{,}149, \qquad P(X = 2) = \frac{9}{2} e^{-3} \approx 0{,}224. $$ 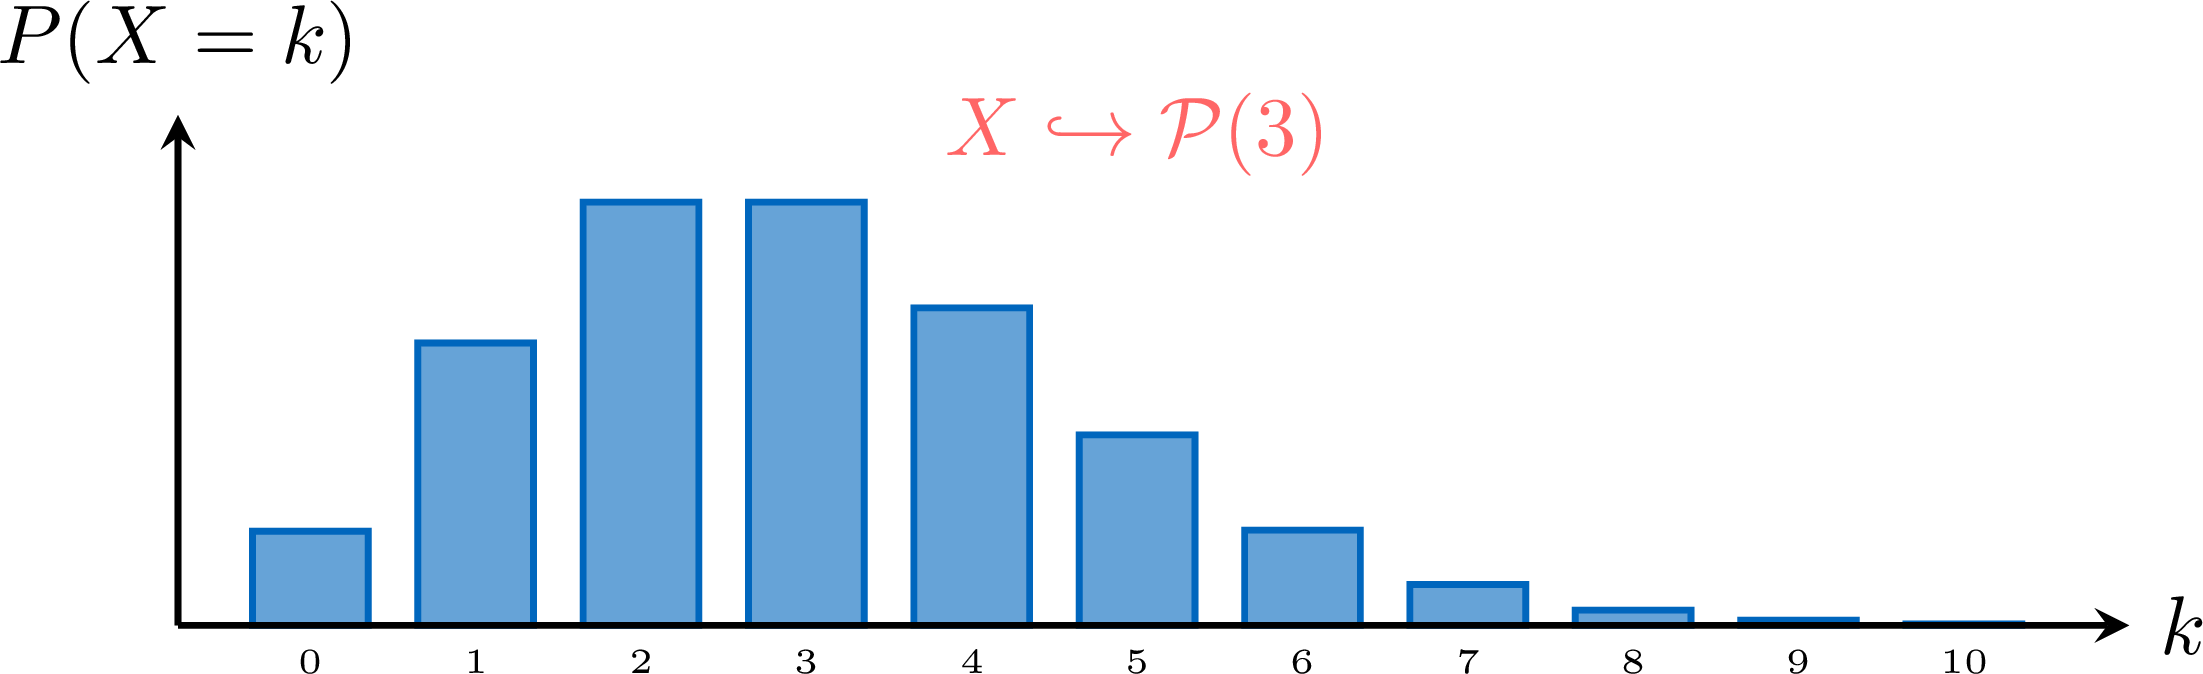
Proposition — Espérance et variance de \(\mathcal{P}(\lambda)\)
Si \(X \hookrightarrow \mathcal{P}(\lambda)\), alors \(X\) admet espérance et variance, avec $$ \textcolor{colorprop}{E(X) = \lambda, \qquad V(X) = \lambda.} $$
Espérance. Par transfert, \(E(X) = \sum_{k \ge 0} k e^{-\lambda} \lambda^k / k!\) sous réserve de convergence absolue. La série est à termes positifs et coïncide avec la queue de la série exponentielle après un décalage d'un cran : $$ \begin{aligned} \sum_{k=0}^{+\infty} k\, e^{-\lambda} \frac{\lambda^k}{k!} &= e^{-\lambda} \sum_{k=1}^{+\infty} k \cdot \frac{\lambda^k}{k!} && \text{(le terme } k = 0 \text{ est nul)} \\
&= e^{-\lambda} \sum_{k=1}^{+\infty} \frac{\lambda^k}{(k - 1)!} && \text{(simplifier } k / k! = 1 / (k - 1)!\text{)} \\
&= e^{-\lambda} \lambda \sum_{k=1}^{+\infty} \frac{\lambda^{k-1}}{(k - 1)!} && \text{(factoriser un } \lambda \text{)} \\
&= e^{-\lambda} \lambda \sum_{j=0}^{+\infty} \frac{\lambda^j}{j!} && \text{(changement } j = k - 1\text{)} \\
&= e^{-\lambda} \lambda \cdot e^{\lambda} = \lambda. && \text{(série exponentielle)} \end{aligned} $$ La série exponentielle converge pour tout argument réel (chapitre Séries numériques, admise), donc la convergence absolue requise par le théorème de transfert est acquise ; \(X\) admet une espérance égale à \(\lambda\). Moment d'ordre 2. On décompose \(k^2 = k(k - 1) + k\). De même, $$ \begin{aligned} E(X(X - 1)) &= \sum_{k=0}^{+\infty} k(k - 1)\, e^{-\lambda} \frac{\lambda^k}{k!} && \text{(transfert)} \\
&= e^{-\lambda} \sum_{k=2}^{+\infty} \frac{\lambda^k}{(k - 2)!} && \text{(}k = 0, 1 \text{ contribuent nul ; simplifier } k(k-1)/k! = 1/(k-2)!\text{)} \\
&= e^{-\lambda} \lambda^2 \sum_{k=2}^{+\infty} \frac{\lambda^{k-2}}{(k - 2)!} && \text{(factoriser } \lambda^2\text{)} \\
&= e^{-\lambda} \lambda^2 \cdot e^{\lambda} = \lambda^2. \end{aligned} $$ Donc \(E(X^2) = E(X(X - 1)) + E(X) = \lambda^2 + \lambda\). Variance par Koenig-Huygens. $$ V(X) = E(X^2) - (E(X))^2 = \lambda^2 + \lambda - \lambda^2 = \lambda. $$
Exemple — Application numérique au centre d'appels
\(X \hookrightarrow \mathcal{P}(3)\) : \(E(X) = 3\), \(V(X) = 3\), \(\sigma(X) = \sqrt{3} \approx 1{,}73\). Donc en moyenne \(3\) appels par heure avec un écart-type d'environ \(\pm \sqrt{3}\). Méthode — Reconnaître une loi de Poisson
Le motif distinctif : un comptage d'événements rares et indépendants dans une fenêtre fixée de temps, de longueur, de surface, etc. ; le paramètre \(\lambda\) est le comptage moyen, qui est aussi la variance. Alors \(X \hookrightarrow \mathcal{P}(\lambda)\), \(E(X) = V(X) = \lambda\), et \(P(X = k) = e^{-\lambda} \lambda^k / k!\). Compétences à pratiquer
- Manipuler la loi de Poisson \(\mathcal{P}(\lambda)\)
V
Python — simulation et statistiques empiriques
V.1
Simuler les lois usuelles
Le programme rattache la simulation des lois discrètes usuelles et le calcul de statistiques empiriques à ce chapitre. On utilise la bibliothèque
numpy.random, abrégée rd, pour tirer des échantillons des lois des §§1–4, et numpy pour lire la moyenne, la variance et les fréquences empiriques.
Méthode — Simuler une expérience avec \texttt{rd.random}
rd.random() renvoie un tirage uniforme dans \([0, 1[\). Pour simuler une Bernoulli de paramètre \(p\) : \begin{verbatim} import numpy.random as rd def bernoulli(p): return 1 if rd.random() < p else 0 \end{verbatim} Pour simuler une loi géométrique \(\mathcal{G}(p)\) par expérience directe (lancer jusqu'au premier succès) : \begin{verbatim} def geometric(p): k = 1 while rd.random() >= p: k += 1 return k \end{verbatim} Méthode — Simuler les lois discrètes usuelles
numpy.random fournit des échantillonneurs prêts à l'emploi, paramétrés par la taille d'échantillon \(N\) : \begin{verbatim} rd.binomial(n, p, size=N) # B(n, p) rd.geometric(p, size=N) # G(p), rang du premier succès dans N* (convention numpy) rd.poisson(lam, size=N) # P(lambda) \end{verbatim} Chaque appel renvoie un tableau de taille \(N\) de tirages indépendants suivant la loi correspondante. La convention de rd.geometric correspond à notre \(\mathcal{G}(p)\) (rang du premier succès, valeurs dans \(\mathbb{N}^*\)). Méthode — Calculer les statistiques empiriques d'un échantillon
À partir d'un échantillon X (un tableau numpy [x_1, ..., x_N] renvoyé par un échantillonneur rd) : \begin{verbatim} import numpy as np freq = [np.mean(X == k) for k in range(K)] # frequences empiriques P(X=k) mean = np.mean(X) # moyenne empirique -> E(X) var = np.mean((X - mean)**2) # variance empirique -> V(X) ecart = np.sqrt(var) # ecart-type empirique import matplotlib.pyplot as plt plt.hist(X, bins='auto') # histogramme \end{verbatim} Quand la taille d'échantillon \(N\) grandit, les fréquences empiriques se rapprochent de la loi vraie et la moyenne empirique se rapproche de l'espérance \(E(X)\) ; cette stabilisation est précisée en deuxième année.
Pour aller plus loin
Ce chapitre complète le catalogue des lois discrètes usuelles de l'année. La deuxième année revisite ces lois sur deux fronts : elle étudie les couples de variables aléatoires \((X, Y)\) — loi conjointe, lois marginales, et l'espérance d'un produit sous indépendance — et elle démontre les résultats de stabilisation derrière l'heuristique « moyenne empirique \(\to E(X)\) » du §5 et l'approximation des événements rares \(\mathcal{B}(n, \lambda / n) \to \mathcal{P}(\lambda)\) esquissée au §4, à travers la loi des grands nombres et les théorèmes d'approximation.
Compétences à pratiquer
- Simuler des lois discrètes en Python
VI
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section