Éducation Nationale Française · PC
Espérance, variance et fonctions génératrices
Ce chapitre fait partie du bloc de probabilités PC, avec un lien vers son équivalent MP pour le contenu standard. Portée PC uniquement ; le matériel MP hors programme est silencieusement omis.
Rappel des Familles sommables
Tout au long de ce chapitre nous utilisons le cadre des familles sommables vu en MPSI Familles sommables : une famille \((a_i)_{i \in I}\) indexée par un ensemble \(I\) au plus dénombrable est dite sommable lorsque \(\sum_{i \in I} |a_i| < +\infty\), c'est-à-dire \((a_i) \in \ell^1(I)\). La somme \(\sum_{i \in I} a_i\) est alors bien définie et indépendante de toute énumération de \(I\) (invariance par permutation). Les quatre outils que nous rappellerons à chaque étape de ce chapitre sont : (i) le théorème de sommation par paquets (version positive et \(\ell^1\)), (ii) Fubini pour les sommes doubles sur un produit d'ensembles d'indices dénombrables, (iii) le test de comparaison « \(|a_i| \le b_i\) avec \((b_i) \in \ell^1\) implique \((a_i) \in \ell^1\) », (iv) le produit de Cauchy de deux suites de \(\ell^1(\mathbb{N})\). Les trois premiers fondent la définition de l'espérance, la linéarité, la formule de transfert et la formule du produit pour des variables indépendantes ; le quatrième fonde l'identité multiplicative des fonctions génératrices au \(\S\) III.
I
Espérance d'une variable aléatoire discrète
La première section étend la définition de l'espérance de MPSI des supports finis \(X(\Omega)\) aux supports dénombrables infinis. La seule difficulté est que la somme \(\sum_x x \mathbb{P}(X = x)\) devient potentiellement infinie ; on lui demande d'être absolument sommable (\(\ell^1\)). La formule de transfert \(\mathbb{E}(f(X)) = \sum_x f(x) \mathbb{P}(X = x)\) est le cheval de bataille de tout calcul concret ; la linéarité, la positivité et la formule du produit pour des variables indépendantes en découlent.
I.1
Définition ; existence
Quand la somme \(\sum_x x \mathbb{P}(X = x)\) a-t-elle un sens ? L'image \(X(\Omega)\) étant au plus dénombrable, la somme porte sur au plus une infinité dénombrable de termes ; on demande l'absolue sommabilité de la famille \((x \mathbb{P}(X = x))_{x \in X(\Omega)}\) comme condition de bonne définition — exactement \(\ell^1\) au sens du rappel d'ouverture. La valeur \(\mathbb{E}(X)\) est alors la somme (signée) de cette famille, indépendante de toute énumération de \(X(\Omega)\).
Définition — Espérance finie, espérance
Soit \(X\) une variable aléatoire discrète à valeurs dans \(\mathbb{K} = \mathbb{R}\) ou \(\mathbb{C}\). On dit que \(X\) admet une espérance finie (ou est intégrable) lorsque la famille \((x \mathbb{P}(X = x))_{x \in X(\Omega)}\) appartient à \(\ell^1(X(\Omega))\), soit $$ \sum_{x \in X(\Omega)} |x| \, \mathbb{P}(X = x) \,<\, +\infty. $$ On appelle alors espérance de \(X\) le réel ou complexe $$ \mathbb{E}(X) \,=\, \sum_{x \in X(\Omega)} x \, \mathbb{P}(X = x), $$ bien défini et indépendant de toute énumération de \(X(\Omega)\) par invariance par permutation des sommes de \(\ell^1\) (MPSI Familles sommables). Proposition — Cohérence avec le cas MPSI à support fini
Lorsque \(X(\Omega)\) est fini, toute variable aléatoire discrète réelle ou complexe \(X\) admet une espérance finie, et la valeur est la somme finie usuelle \(\mathbb{E}(X) = \sum_{x \in X(\Omega)} x \, \mathbb{P}(X = x)\) rappelée de MPSI Espérance, variance, covariance. Exemple — V.a. discrète bornée
Si \(|X| \le M\) sur \(\Omega\) pour une constante \(M \ge 0\), alors pour tout \(x \in X(\Omega)\) on a \(|x| \le M\), donc \(\sum_x |x| \mathbb{P}(X = x) \le M \sum_x \mathbb{P}(X = x) = M < +\infty\). Donc \(X\) admet une espérance finie. Application : l'indicatrice \(\mathbf{1}_A\) d'un événement \(A \in \mathcal{A}\) prend ses valeurs dans \(\{0 \virgule 1\}\), donc \(\mathbb{E}(\mathbf{1}_A) = 0 \cdot \mathbb{P}(A^c) + 1 \cdot \mathbb{P}(A) = \mathbb{P}(A)\). Exemple — Les lois usuelles à support dans \(\mathbb{N}\) admettent une espérance finie
Pour \(X \sim \mathcal{G}(p)\) avec \(0 < p < 1\), la famille \((n (1-p)^{n-1} p)_{n \ge 1}\) est dans \(\ell^1\) : la règle de d'Alembert \(((n+1)(1-p)^n p)/(n (1-p)^{n-1} p) = (1-p)(n+1)/n \to 1 - p < 1\), donc la série converge absolument. Donc \(X\) admet une espérance finie, de valeur \(1/p\) qui sera établie au sous-section 1.5. Pour \(X \sim \mathcal{P}(\lambda)\), la famille \((n \mathrm{e}^{-\lambda} \lambda^n/n!)_{n \ge 0}\) est dans \(\ell^1\) : la règle de d'Alembert \(((n+1) \lambda)/(n(n+1)) = \lambda/n \to 0 < 1\). La valeur \(\mathbb{E}(\mathcal{P}(\lambda)) = \lambda\) est également établie au sous-section 1.5. Exemple — Une loi à queue lourde sans espérance finie
Posons \(\mathbb{P}(X = n) = c/n^2\) pour \(n \ge 1\), avec \(c = 1/\zeta(2) = 6/\pi^2\) pour que \(\sum_{n \ge 1} \mathbb{P}(X = n) = 1\). Alors \(\sum_{n \ge 1} n \mathbb{P}(X = n) = c \sum_{n \ge 1} 1/n = +\infty\) (série harmonique). Donc \((n \mathbb{P}(X = n)) \notin \ell^1\) et \(X\) n'admet pas d'espérance finie : la queue lourde \(\mathbb{P}(X = n) \sim c/n^2\) alloue tant de masse aux grands \(n\) que la moyenne serait infinie. Proposition — Identité de la queue pour les v.a.\ à valeurs dans \(\mathbb{N}\)
Soit \(X\) une v.a.r.\ discrète avec \(X(\Omega) \subset \mathbb{N}\). Alors \(X\) admet une espérance finie si et seulement si la série (à termes positifs) \(\sum_{n \ge 1} \mathbb{P}(X \ge n)\) converge, et dans ce cas $$ \mathbb{E}(X) \,=\, \sum_{n \ge 1} \mathbb{P}(X \ge n) \,=\, \sum_{n \ge 0} \mathbb{P}(X > n). $$ Exemple — Décomposition en escalier de la somme de queue
Visualisation de l'identité. Le graphe de la fonction de survie \(n \mapsto \mathbb{P}(X \ge n)\) sur \(\mathbb{N}^*\) est un escalier décroissant ; son aire totale (somme des hauteurs) vaut \(\mathbb{E}(X)\). 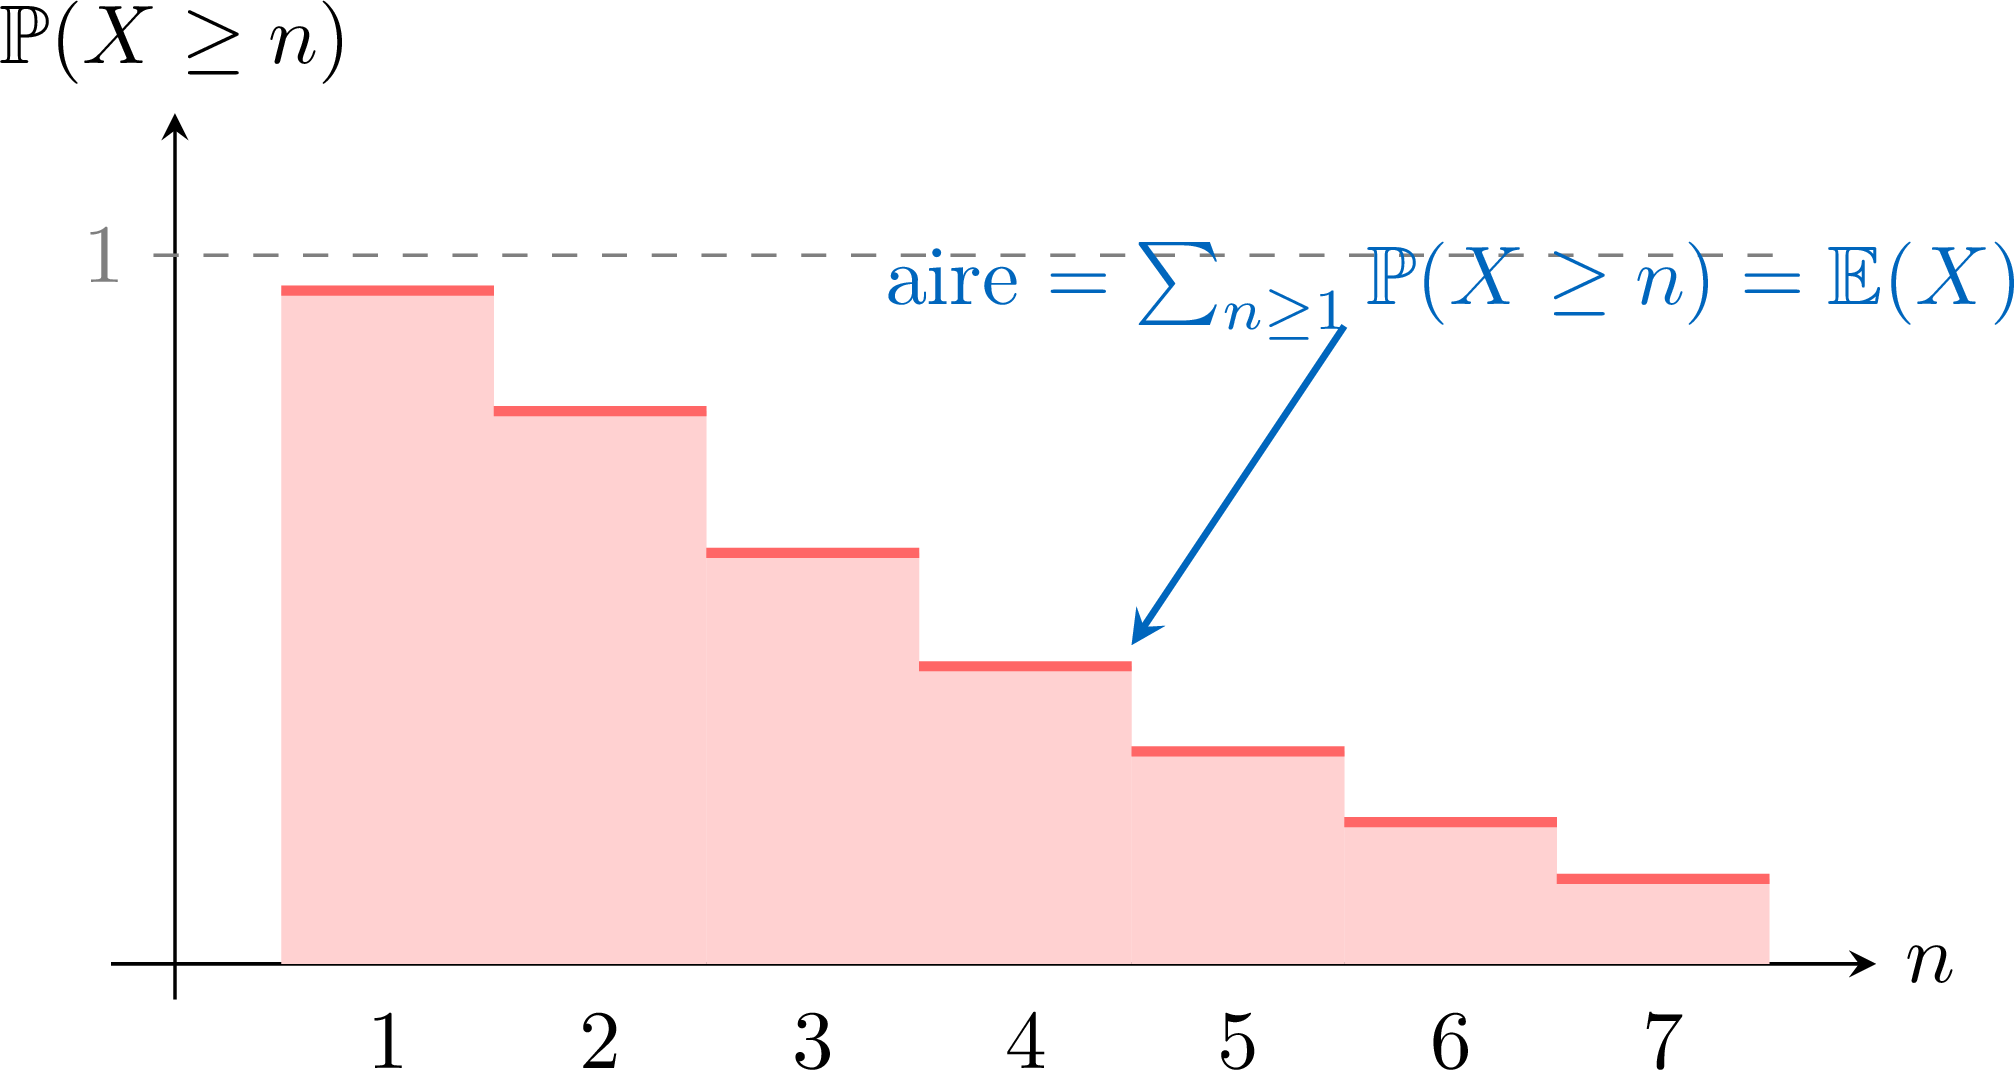
On calcule directement par Fubini positif sur la famille \((\mathbb{P}(X = k))_{(n \virgule k) \in \mathbb{N}^* \times \mathbb{N}, \, n \le k}\), à termes positifs partout : $$ \begin{aligned} \sum_{n \ge 1} \mathbb{P}(X \ge n) &\,=\, \sum_{n \ge 1} \sum_{k \ge n} \mathbb{P}(X = k) && \text{(définition de \(\mathbb{P}(X \ge n)\))} \\
&\,=\, \sum_{k \ge 1} \mathbb{P}(X = k) \cdot \# \{n \ge 1 \,:\, n \le k\} && \text{(Fubini positif)} \\
&\,=\, \sum_{k \ge 1} k \, \mathbb{P}(X = k). \end{aligned} $$ Les deux membres sont à valeurs dans \([0 \virgule +\infty]\), celui de gauche est la série de queue et celui de droite vaut \(\mathbb{E}(X) \in [0 \virgule +\infty]\) sur la v.a.r.\ à valeurs entières positives (la famille \((k \mathbb{P}(X = k))_{k \ge 1}\) étant à termes positifs, sa somme a un sens dans \([0 \virgule +\infty]\) sans hypothèse \(\ell^1\)). Les deux sont simultanément finis ou infinis, d'où l'équivalence ; lorsqu'ils sont finis ils ont même valeur.
Méthode — Décider si \(X\) admet une espérance finie
Trois voies, à utiliser tour à tour. - Raccourci par borne. Si \(|X| \le M\) sur \(\Omega\), alors \(X\) admet immédiatement une espérance finie (Exemple précédent). Cela couvre \(\mathcal{B}(p), \mathcal{B}(n \virgule p), \mathcal{U}(\{1 \virgule \dots \virgule n\})\) d'un coup.
- Calculer la somme positive. Pour un support non borné, écrire la série positive \(\sum_{x \in X(\Omega)} |x| \, \mathbb{P}(X = x)\) et étudier sa convergence par règle de d'Alembert, comparaison avec une série de Riemann ou géométrique connue, ou dérivation terme à terme d'une expression close (géométrique, exponentielle).
- Identité de la queue (v.a.\ à valeurs dans \(\mathbb{N}\)). Lorsque \(X(\Omega) \subset \mathbb{N}\) et que la distribution \(\mathbb{P}(X = n)\) est désagréable mais que la probabilité de queue \(\mathbb{P}(X \ge n)\) admet une forme close, appliquer la Proposition précédente : \(X\) admet une espérance finie ssi \(\sum_{n \ge 1} \mathbb{P}(X \ge n)\) converge, et cette somme vaut alors \(\mathbb{E}(X)\).
Compétences à pratiquer
- Déterminer si \(X\) admet une espérance finie
I.2
La formule de transfert
Le cheval de bataille du chapitre. Pour calculer \(\mathbb{E}(f(X))\), il n'est pas nécessaire de déterminer la loi de la nouvelle variable \(Y = f(X)\) — une somme sur \(X(\Omega)\) pondérée par \(\mathbb{P}(X = x)\) suffit, à condition que la famille \((f(x) \mathbb{P}(X = x))_x\) soit \(\ell^1\). On applique alors le même test d'absolue sommabilité et la même mécanique \(\ell^1\) que pour \(\mathbb{E}(X)\) lui-même.
Théorème — Formule de transfert
Soit \(X\) une variable aléatoire discrète à valeurs dans \(\mathbb{K} = \mathbb{R}\) ou \(\mathbb{C}\) et \(f \colon X(\Omega) \to \mathbb{K}\) une fonction quelconque. Alors \(f(X)\) admet une espérance finie si et seulement si la famille \((f(x) \mathbb{P}(X = x))_{x \in X(\Omega)}\) est dans \(\ell^1(X(\Omega))\), et dans ce cas $$ \mathbb{E}(f(X)) \,=\, \sum_{x \in X(\Omega)} f(x) \, \mathbb{P}(X = x). $$ Le même énoncé s'applique verbatim à une v.a.r.\ discrète à valeurs vectorielles \(X = (X_1 \virgule \dots \virgule X_r)\) avec \(f \colon X(\Omega) \to \mathbb{K}\), puisque la jointe \(X\) est elle-même une v.a.r.\ discrète d'image \(X(\Omega) \subset X_1(\Omega) \times \dots \times X_r(\Omega)\) au plus dénombrable (MP Variables aléatoires discrètes). C'est la forme utilisée aux sous-section 1.3 et sous-section 1.4 pour dériver la linéarité et la formule du produit via \(f(x_1 \virgule x_2) = \lambda x_1 + \mu x_2\) et \(f(x_1 \virgule x_2) = x_1 x_2\) respectivement.
Posons \(Y = f(X)\), variable aléatoire discrète d'image \(Y(\Omega) = f(X(\Omega))\) au plus dénombrable. Pour chaque \(y \in Y(\Omega)\), l'événement \(\{Y = y\}\) se partitionne en union disjointe \(\{Y = y\} = \bigsqcup_{x \in f^{-1}(\{y\}) \cap X(\Omega)} \{X = x\}\), donc par \(\sigma\)-additivité de \(\mathbb{P}\) (MPSI Espaces probabilisés), $$ \mathbb{P}(Y = y) \,=\, \sum_{x \in f^{-1}(\{y\}) \cap X(\Omega)} \mathbb{P}(X = x). $$ Appliquer la sommation par paquets (rappelée de MPSI Familles sommables) à la famille positive \((|f(x)| \mathbb{P}(X = x))_{x \in X(\Omega)}\), regroupée par les ensembles de niveaux de \(f\) : $$ \sum_{x \in X(\Omega)} |f(x)| \, \mathbb{P}(X = x) \,=\, \sum_{y \in Y(\Omega)} |y| \sum_{x \in f^{-1}(\{y\})} \mathbb{P}(X = x) \,=\, \sum_{y \in Y(\Omega)} |y| \, \mathbb{P}(Y = y). $$ D'où les deux conditions \(\ell^1\) équivalentes : \((f(x) \mathbb{P}(X = x))_x \in \ell^1\) ssi \((y \mathbb{P}(Y = y))_y \in \ell^1\) ssi \(f(X) = Y\) admet une espérance finie. Lorsque cette condition commune est vérifiée, la même sommation par paquets sans valeur absolue donne l'égalité annoncée.
Exemple — Moment d'ordre 2 d'une géométrique
Pour \(X \sim \mathcal{G}(p)\) avec \(0 < p < 1\), appliquer le transfert avec \(f(n) = n^2\). La série positive \(\sum_{n \ge 1} n^2 (1-p)^{n-1} p\) converge (rapport de d'Alembert \((1-p)(n+1)^2/n^2 \to 1 - p < 1\)), donc \(X^2\) admet une espérance finie. Pour la calculer, on utilise \(n^2 = n(n-1) + n\) et la géométrique deux fois dérivée : \(\sum_{n \ge 0} t^n = 1/(1-t)\), donc \(\sum_{n \ge 1} n t^{n-1} = 1/(1-t)^2\) et \(\sum_{n \ge 2} n(n-1) t^{n-2} = 2/(1-t)^3\) pour \(|t| < 1\). Évaluation en \(t = 1 - p\) : $$ \mathbb{E}(X) \,=\, p \sum_{n \ge 1} n (1-p)^{n-1} \,=\, p \cdot \frac{1}{p^2} \,=\, \frac{1}{p}, \quad \mathbb{E}(X(X-1)) \,=\, p \sum_{n \ge 1} n(n-1)(1-p)^{n-1} \,=\, p(1-p) \cdot \frac{2}{p^3} \,=\, \frac{2(1-p)}{p^2}, $$ d'où $$ \mathbb{E}(X^2) \,=\, \mathbb{E}(X(X-1)) + \mathbb{E}(X) \,=\, \frac{2(1-p)}{p^2} + \frac{1}{p} \,=\, \frac{2 - p}{p^2}. $$ (La valeur \(\mathbb{E}(X) = 1/p\) est reprise dans le Théorème de synthèse du sous-section 1.5.) Exemple — Espérance de \(1/(X+1)\) pour une loi de Poisson
Pour \(X \sim \mathcal{P}(\lambda)\), appliquer le transfert avec \(f(n) = 1/(n+1)\). Alors $$ \mathbb{E}\!\left(\frac{1}{X+1}\right) \,=\, \sum_{n \ge 0} \frac{\mathrm{e}^{-\lambda} \lambda^n}{(n+1)!} \,=\, \frac{\mathrm{e}^{-\lambda}}{\lambda} \sum_{n \ge 0} \frac{\lambda^{n+1}}{(n+1)!} \,=\, \frac{\mathrm{e}^{-\lambda}}{\lambda} \left( \mathrm{e}^\lambda - 1 \right) \,=\, \frac{1 - \mathrm{e}^{-\lambda}}{\lambda}. $$ Une quantité naturelle dans certaines mises à jour bayésiennes (l'« estimateur plus-un »). Méthode — Calculer une espérance par transfert
Cinq étapes fiables. - Identifier \(f\). Lire la variable à intégrer sous la forme \(f(X)\) pour un \(f \colon X(\Omega) \to \mathbb{K}\) explicite — par ex.\ \(f(n) = n^2\) pour \(\mathbb{E}(X^2)\), \(f(n) = (-1)^n\) pour \(\mathbb{E}((-1)^X)\), \(f(n) = 1/(n+1)\) pour \(\mathbb{E}(1/(X+1))\).
- Étape d'existence. Vérifier \((|f(x)| \mathbb{P}(X = x))_x \in \ell^1\) par règle de d'Alembert, comparaison, ou majoration directe de \(|f(x)|\).
- Astuces de forme close. Utiliser des sommes connues — dérivée de la géométrique \(\sum n t^{n-1} = 1/(1-t)^2\), exponentielle \(\sum \lambda^n/n! = \mathrm{e}^\lambda\), binôme \(\sum \binom{n}{k} p^k q^{n-k} = (p+q)^n\), versions deux fois dérivées de chacune.
- Linéarité à l'intérieur de \(f\). Si \(f\) est un polynôme \(f(n) = a_k n^k + \dots + a_0\), le développer et se ramener à des moments de degré inférieur calculés un à un.
- Vérification de l'ordre de grandeur. Le résultat doit être cohérent en grandeur et, pour \(X\) positive, satisfaire \(\mathbb{E}(f(X)) \ge 0\) lorsque \(f \ge 0\).
Compétences à pratiquer
- Calculer une espérance par transfert
I.3
Linéarité, positivité, croissance
La formule de transfert en main, toutes les propriétés classiques de l'espérance à support fini se transposent au cas dénombrable en vérifiant que l'hypothèse \(\ell^1\) est préservée par l'opération.
Proposition — Espérance d'une constante
Pour tout \(c \in \mathbb{K}\), la variable aléatoire constante \(X \colon \omega \mapsto c\) admet une espérance finie avec \(\mathbb{E}(c) = c\). Théorème — Linéarité de l'espérance
Soient \(X, Y\) deux variables aléatoires discrètes à valeurs dans \(\mathbb{K}\), toutes deux d'espérance finie, et \(\lambda, \mu \in \mathbb{K}\). Alors \(\lambda X + \mu Y\) admet une espérance finie et $$ \mathbb{E}(\lambda X + \mu Y) \,=\, \lambda \, \mathbb{E}(X) + \mu \, \mathbb{E}(Y). $$
On applique la formule de transfert à la v.a.r.\ jointe \((X \virgule Y) \colon \Omega \to \mathbb{K} \times \mathbb{K}\) avec \(f(x \virgule y) = \lambda x + \mu y\). L'image \((X \virgule Y)(\Omega) \subset X(\Omega) \times Y(\Omega)\) est au plus dénombrable (produit de deux ensembles au plus dénombrables). L'étape d'existence \(\ell^1\) : $$ \begin{aligned} \sum_{(x \virgule y)} |\lambda x + \mu y| \, \mathbb{P}(X = x \virgule Y = y) &\,\le\, |\lambda| \sum_{(x \virgule y)} |x| \, \mathbb{P}(X = x \virgule Y = y) + |\mu| \sum_{(x \virgule y)} |y| \, \mathbb{P}(X = x \virgule Y = y) \\
&\,=\, |\lambda| \sum_x |x| \, \mathbb{P}(X = x) + |\mu| \sum_y |y| \, \mathbb{P}(Y = y) \\
&\,<\, +\infty, \end{aligned} $$ la deuxième ligne par Fubini sur familles positives : sommer la jointe \(\mathbb{P}(X = x \virgule Y = y)\) sur \(y\) redonne la loi marginale de \(X\), soit \(\sum_y \mathbb{P}(X = x \virgule Y = y) = \mathbb{P}(X = x)\) (MP Variables aléatoires discrètes) ; et symétriquement pour la seconde somme. La finitude provient de l'hypothèse \(X, Y\) d'espérance finie. Donc \((\lambda X + \mu Y)\) admet une espérance finie. Le même argument de Fubini sans valeurs absolues donne $$ \mathbb{E}(\lambda X + \mu Y) = \sum_{(x \virgule y)} (\lambda x + \mu y) \, \mathbb{P}(X = x \virgule Y = y) = \lambda \, \mathbb{E}(X) + \mu \, \mathbb{E}(Y). $$
Exemple — Linéarité sur des indicatrices
Pour des événements \(A_1 \virgule \dots \virgule A_n \in \mathcal{A}\), l'espérance de la variable de comptage \(N = \sum_{i=1}^n \mathbf{1}_{A_i}\) (nombre d'événements réalisés) est $$ \mathbb{E}(N) \,=\, \sum_{i=1}^n \mathbb{E}(\mathbf{1}_{A_i}) \,=\, \sum_{i=1}^n \mathbb{P}(A_i). $$ Aucune indépendance n'est nécessaire ; la linéarité vaut pour toute loi jointe. C'est l'outil le plus efficace pour calculer \(\mathbb{E}\) d'une somme de contributions à valeurs dans \(\{0 \virgule 1\}\). Exemple — Combinaison affine
Pour \(X\) une v.a.r.\ discrète d'espérance finie et \(a \virgule b \in \mathbb{K}\), \(\mathbb{E}(a X + b) = a \, \mathbb{E}(X) + b\) (linéarité avec la constante \(b\), d'espérance \(b\) par la Proposition de la constante ci-dessus). Proposition — Positivité, croissance, inégalité triangulaire
Soient \(X, Y\) des v.a.r.\ discrètes réelles d'espérance finie. Alors : - Positivité : \(X \ge 0\) p.s.\ implique \(\mathbb{E}(X) \ge 0\).
- Croissance : \(X \le Y\) p.s.\ implique \(\mathbb{E}(X) \le \mathbb{E}(Y)\).
- Inégalité triangulaire : \(|\mathbb{E}(X)| \le \mathbb{E}(|X|)\), avec égalité si et seulement si \(X\) est de signe constant p.s.
- Test d'annulation : \(\mathbb{E}(|X|) = 0\) si et seulement si \(X = 0\) p.s.
- (1) Pour chaque \(x \in X(\Omega)\), soit \(x \ge 0\) (compatible avec \(X \ge 0\) p.s.), soit \(x < 0\) auquel cas \(\mathbb{P}(X = x) = 0\) (les valeurs négatives de \(X\) forment un ensemble négligeable sous \(X \ge 0\) p.s.). Dans les deux cas le terme \(x \mathbb{P}(X = x) \ge 0\) ; la somme de termes positifs est positive.
- (2) Appliquer (1) à la v.a.r.\ positive \(Y - X\) (linéarité : \(\mathbb{E}(Y - X) = \mathbb{E}(Y) - \mathbb{E}(X) \ge 0\)).
- (3) Terme à terme, \(\left| \sum_x x \mathbb{P}(X = x) \right| \le \sum_x |x| \mathbb{P}(X = x)\) (inégalité triangulaire sur chaque somme partielle finie, puis passage à la limite). L'égalité est atteinte ssi tous les termes non nuls \(x \mathbb{P}(X = x)\) ont le même signe, soit « \(X\) est de signe constant sur son support p.s. ».
- (4) \(\mathbb{E}(|X|) = \sum_x |x| \mathbb{P}(X = x) = 0\) avec des termes positifs force chaque terme \(|x| \mathbb{P}(X = x) = 0\), soit \(\mathbb{P}(X = x) = 0\) pour tout \(x \ne 0\), soit \(X = 0\) p.s. La réciproque est triviale.
Compétences à pratiquer
- Calculer une espérance par linéarité
I.4
Indépendance et formule du produit
Indépendance \(\Rightarrow\) produit des espérances. C'est la propriété algébrique phare des variables indépendantes : leur distribution jointe se factorise en un produit des marginales, et cette factorisation passe à l'espérance. Le résultat fonde l'identité de Bienaymé pour la variance d'une somme indépendante (sous-section 2.3) et la formule du produit de Cauchy pour les fonctions génératrices (sous-section 3.2).
Théorème — Indépendance et produit des espérances
Soient \(X, Y\) deux variables aléatoires discrètes réelles ou complexes indépendantes, toutes deux d'espérance finie. Alors \(XY\) admet une espérance finie et $$ \mathbb{E}(XY) \,=\, \mathbb{E}(X) \, \mathbb{E}(Y). $$
On applique la formule de transfert à \((X \virgule Y)\) avec \(f(x \virgule y) = xy\). L'hypothèse d'indépendance (MP Variables aléatoires discrètes) s'écrit \(\mathbb{P}(X = x \virgule Y = y) = \mathbb{P}(X = x) \mathbb{P}(Y = y)\) pour tout \((x \virgule y)\). L'étape d'existence \(\ell^1\) sur la famille positive \((|xy| \mathbb{P}(X = x \virgule Y = y))_{(x \virgule y)}\) : $$ \sum_{(x \virgule y)} |xy| \, \mathbb{P}(X = x) \mathbb{P}(Y = y) \,=\, \left( \sum_x |x| \mathbb{P}(X = x) \right) \left( \sum_y |y| \mathbb{P}(Y = y) \right) \,<\, +\infty, $$ la première égalité par Fubini sur la famille produit (MPSI Familles sommables), la finitude provenant de \(X, Y\) d'espérance finie. Donc \(XY\) admet une espérance finie. Le même argument de Fubini sans valeurs absolues donne $$ \mathbb{E}(XY) \,=\, \sum_{(x \virgule y)} x y \, \mathbb{P}(X = x) \mathbb{P}(Y = y) \,=\, \left( \sum_x x \mathbb{P}(X = x) \right) \left( \sum_y y \mathbb{P}(Y = y) \right) \,=\, \mathbb{E}(X) \mathbb{E}(Y). $$
Exemple — Deux Bernoulli indépendantes
Pour \(X, Y \sim \mathcal{B}(p)\) indépendantes, \(\mathbb{E}(XY) = \mathbb{E}(X) \mathbb{E}(Y) = p \cdot p = p^2\). C'est aussi calculable directement : \(XY\) suit elle-même \(\mathcal{B}(p^2)\) (la valeur \(1\) exige \(X = 1\) et \(Y = 1\), de probabilité \(p^2\)), donc \(\mathbb{E}(XY) = p^2\). Exemple — Piège : l'indépendance est nécessaire
Soient \(X \sim \mathcal{B}(1/2)\) et \(Y = 1 - X\). Alors \(\mathbb{E}(X) = \mathbb{E}(Y) = 1/2\) mais \(XY \equiv 0\) car \(X = 1 \Rightarrow Y = 0\) (donc \(XY = 0\)) et \(X = 0 \Rightarrow Y = 1\) (donc \(XY = 0 \cdot 1 = 0\)). Donc \(\mathbb{E}(XY) = 0 \ne 1/4 = \mathbb{E}(X) \mathbb{E}(Y)\) — la formule du produit est en défaut sans indépendance. L'écart \(\mathbb{E}(XY) - \mathbb{E}(X) \mathbb{E}(Y)\) sera baptisé covariance au sous-section 2.3. Corollaire — Extension à un produit fini
Soient \(X_1 \virgule \dots \virgule X_n\) des v.a.r.\ discrètes réelles ou complexes mutuellement indépendantes, chacune d'espérance finie. Alors \(X_1 X_2 \cdots X_n\) admet une espérance finie et $$ \mathbb{E}(X_1 X_2 \cdots X_n) \,=\, \mathbb{E}(X_1) \, \mathbb{E}(X_2) \cdots \mathbb{E}(X_n). $$
Récurrence sur \(n\). Pour \(n = 2\), c'est le Théorème précédent. Pour \(n \ge 3\) : par le lemme des coalitions (MP Variables aléatoires discrètes), les variables \(X_1 X_2 \cdots X_{n-1}\) et \(X_n\) sont indépendantes (un produit des \(n-1\) premières commute avec la dernière) ; appliquer le Théorème au couple, puis l'hypothèse de récurrence pour factoriser les \(n-1\) premières.
Compétences à pratiquer
- Appliquer l'indépendance pour calculer \(\mathbb{E}(XY)\)
I.5
Espérances des lois usuelles
Le catalogue que tout étudiant doit connaître par cœur, dérivé ici une fois et utilisé dans tout le reste du chapitre.
Théorème — Espérances des lois usuelles
Soit \(X\) de l'une des lois suivantes, avec les paramètres MP usuels. Alors \(X\) admet une espérance finie, égale à : - \(\mathcal{B}(p)\) (Bernoulli) sur \(\{0 \virgule 1\}\) de paramètre \(p \in [0 \virgule 1]\) : \(\mathbb{E}(X) = p\).
- \(\mathcal{B}(n \virgule p)\) (binomiale) sur \(\{0 \virgule \dots \virgule n\}\) avec \(n \ge 1, p \in [0 \virgule 1]\) : \(\mathbb{E}(X) = np\).
- \(\mathcal{U}(\{1 \virgule \dots \virgule n\})\) (uniforme) avec \(n \ge 1\) : \(\mathbb{E}(X) = (n+1)/2\).
- \(\mathcal{G}(p)\) (géométrique) sur \(\mathbb{N}^*\) avec \(p \in (0 \virgule 1)\) : \(\mathbb{E}(X) = 1/p\).
- \(\mathcal{P}(\lambda)\) (Poisson) sur \(\mathbb{N}\) avec \(\lambda > 0\) : \(\mathbb{E}(X) = \lambda\).
- Bernoulli. \(\mathbb{E}(X) = 0 \cdot (1 - p) + 1 \cdot p = p\).
- Binomiale. Décomposer \(X = X_1 + \dots + X_n\) avec \(X_i \sim \mathcal{B}(p)\) i.i.d.\ (MP Variables aléatoires discrètes : une binomiale est une somme de \(n\) Bernoulli indépendantes). Par linéarité, \(\mathbb{E}(X) = n \cdot \mathbb{E}(X_1) = np\).
- Uniforme. Direct : \(\mathbb{E}(X) = \sum_{k=1}^n k/n = (1/n) \cdot n(n+1)/2 = (n+1)/2\) (formule de Gauss).
- Géométrique. \(\mathbb{E}(X) = \sum_{n \ge 1} n (1-p)^{n-1} p = p \sum_{n \ge 1} n t^{n-1} \big|_{t = 1-p} = p \cdot 1/(1 - (1-p))^2 = p/p^2 = 1/p\) (dérivée de la série géométrique).
- Poisson. \(\mathbb{E}(X) = \sum_{n \ge 0} n \mathrm{e}^{-\lambda} \lambda^n / n! = \mathrm{e}^{-\lambda} \lambda \sum_{n \ge 1} \lambda^{n-1}/(n-1)! = \mathrm{e}^{-\lambda} \lambda \mathrm{e}^\lambda = \lambda\) (réindexation puis série exponentielle).
Méthode — Calculer l'espérance d'une loi non standard
Trois voies, par ordre de préférence. - Décomposer en indicatrices ou en sommes connues. Si \(X = \sum_i X_i\) (ou une fonction de variables usuelles), utiliser la linéarité (sous-section 1.3) pour se ramener à des espérances élémentaires. La binomiale via \(n\) Bernoulli est le prototype.
- Somme directe en forme close. Écrire \(\mathbb{E}(X) = \sum_x x \mathbb{P}(X = x)\) et utiliser les quatre astuces standards : dérivée de la géométrique (\(\sum n t^{n-1} = 1/(1-t)^2\)), identité de l'exponentielle (\(\sum \lambda^n/n! = \mathrm{e}^\lambda\)), identité du binôme (\(\sum \binom{n}{k} a^k = (1+a)^n\)), séries de Riemann pour les lois à décroissance en puissance.
- Fonction génératrice \(G_X'(1^-)\) (sous-section 3.3). Si la loi est à valeurs dans \(\mathbb{N}\) et que la fonction génératrice admet une forme close, dériver une fois en \(t = 1^-\). Particulièrement efficace pour les lois géométrique et de Poisson ; voir sous-section 3.3.
Compétences à pratiquer
- Calculer l'espérance d'une loi non standard
II
Variance, covariance, inégalités et loi faible
À partir de maintenant, toutes les variables aléatoires sont réelles sauf mention explicite contraire — l'ordre de \(\mathbb{R}\) est nécessaire pour \(X \ge 0\), \(X \le Y\), la variance \(\mathrm{V}(X) = \mathbb{E}((X - \mathbb{E}(X))^2)\) et les inégalités de Markov et de Bienaymé-Tchebychev. La variance mesure l'écart quadratique à la moyenne ; la covariance généralise aux paires et donne la variance d'une somme (identité de Bienaymé) ; Markov et Bienaymé-Tchebychev contrôlent les queues d'une loi à partir des seuls moments ; la loi faible des grands nombres — résultat phare de la section — ajuste les moyennes empiriques à la moyenne théorique.
II.1
Moment d'ordre 2, Cauchy-Schwarz
Un moment d'ordre 2 est l'espérance de \(X^2\). La notation \(X \in L^2\) est un raccourci pour « \(\mathbb{E}(X^2) < +\infty\) » — une notation, pas l'introduction d'un cadre d'analyse fonctionnelle (le programme n'exige pas les espaces \(L^p\) pour \(p\) général). L'inégalité de Cauchy-Schwarz est la colonne vertébrale algébrique de la variance et de la covariance à venir.
Définition — \(L^1\) et \(L^2\) comme notations
Une v.a.r.\ discrète réelle \(X\) est dite intégrable (ou « dans \(L^1\) »), et on note \(X \in L^1\), lorsque \(\mathbb{E}(|X|) < +\infty\) — soit lorsque \(X\) admet une espérance finie au sens du sous-section 1.1. Elle est dite de carré intégrable (ou « dans \(L^2\) »), et on note \(X \in L^2\), lorsque \(\mathbb{E}(X^2) < +\infty\). Proposition — \(L^1\) et \(L^2\) sont stables par combinaisons linéaires
Soient \(X, Y\) des v.a.r.\ discrètes réelles et \(\lambda \virgule \mu \in \mathbb{R}\). Alors : - \(X, Y \in L^1\) implique \(\lambda X + \mu Y \in L^1\).
- \(X, Y \in L^2\) implique \(\lambda X + \mu Y \in L^2\).
- (1) Majorer \(|\lambda X + \mu Y| \le |\lambda| |X| + |\mu| |Y|\) p.s., prendre l'espérance par linéarité + croissance : \(\mathbb{E}(|\lambda X + \mu Y|) \le |\lambda| \mathbb{E}(|X|) + |\mu| \mathbb{E}(|Y|) < +\infty\).
- (2) Utiliser l'inégalité scalaire élémentaire \((a + b)^2 \le 2 a^2 + 2 b^2\) : \((\lambda X + \mu Y)^2 \le 2 \lambda^2 X^2 + 2 \mu^2 Y^2\) p.s., puis \(\mathbb{E}((\lambda X + \mu Y)^2) \le 2 \lambda^2 \mathbb{E}(X^2) + 2 \mu^2 \mathbb{E}(Y^2) < +\infty\).
Théorème — Inégalité de Cauchy-Schwarz
Soient \(X, Y\) des v.a.r.\ discrètes réelles dans \(L^2\). Alors \(XY \in L^1\) et $$ |\mathbb{E}(XY)|^2 \,\le\, \mathbb{E}(X^2) \, \mathbb{E}(Y^2). $$
On a d'abord \(XY \in L^1\) : par \(|XY| \le (X^2 + Y^2)/2\) p.s.\ (réécriture de \((|X| - |Y|)^2 \ge 0\)), il vient \(\mathbb{E}(|XY|) \le (\mathbb{E}(X^2) + \mathbb{E}(Y^2))/2 < +\infty\), donc \(XY \in L^1\) par la Proposition précédente appliquée à \(X^2, Y^2\).
Cas dégénéré \(\mathbb{E}(Y^2) = 0\). Par le test d'annulation du sous-section 1.3, \(Y = 0\) p.s., donc \(XY = 0\) p.s.\ et \(\mathbb{E}(XY) = 0\) par le même test. L'inégalité \(|\mathbb{E}(XY)|^2 \le \mathbb{E}(X^2) \mathbb{E}(Y^2)\) devient \(0 \le 0\), qui est vraie. (Symétriquement si \(\mathbb{E}(X^2) = 0\).)
Cas générique \(\mathbb{E}(Y^2) > 0\). On considère le polynôme en la variable réelle \(t\) : $$ P(t) \,=\, \mathbb{E}((X + tY)^2) \,=\, \mathbb{E}(X^2) + 2 t \, \mathbb{E}(XY) + t^2 \mathbb{E}(Y^2). $$ Le carré \((X + tY)^2 \ge 0\) p.s., donc par positivité de l'espérance \(P(t) \ge 0\) pour tout \(t \in \mathbb{R}\). Un trinôme positif a un discriminant négatif : \(4 (\mathbb{E}(XY))^2 - 4 \mathbb{E}(X^2) \mathbb{E}(Y^2) \le 0\), ce qui est l'inégalité annoncée.
Corollaire — \(L^2 \subset L^1\)
Toute v.a.r.\ discrète réelle \(X \in L^2\) est dans \(L^1\), avec \(\mathbb{E}(|X|) \le \sqrt{\mathbb{E}(X^2)}\).
On applique Cauchy-Schwarz avec \(X' = |X|\) et \(Y' = 1\) (la v.a.r.\ constante \(\omega \mapsto 1\), dans \(L^2\) avec \(\mathbb{E}(1) = 1\)) : \(|\mathbb{E}(|X| \cdot 1)|^2 \le \mathbb{E}(X^2) \cdot \mathbb{E}(1) = \mathbb{E}(X^2)\), donc \(\mathbb{E}(|X|) \le \sqrt{\mathbb{E}(X^2)} < +\infty\).
Exemple — La géométrique est dans \(L^2\)
Pour \(X \sim \mathcal{G}(p)\) avec \(0 < p < 1\), le calcul de moment d'ordre 2 du sous-section 1.2 (Exemple) a donné \(\mathbb{E}(X^2) = (2-p)/p^2 < +\infty\), donc \(X \in L^2\). Exemple — Poisson est dans \(L^2\)
Pour \(X \sim \mathcal{P}(\lambda)\), la formule de transfert avec \(f(n) = n^2 = n(n-1) + n\) donne $$ \mathbb{E}(X^2) \,=\, \sum_{n \ge 0} n^2 \frac{\mathrm{e}^{-\lambda} \lambda^n}{n!} \,=\, \sum_{n \ge 2} n(n-1) \frac{\mathrm{e}^{-\lambda} \lambda^n}{n!} + \mathbb{E}(X) \,=\, \lambda^2 \mathrm{e}^{-\lambda} \sum_{n \ge 2} \frac{\lambda^{n-2}}{(n-2)!} + \lambda \,=\, \lambda^2 + \lambda \,<\, +\infty, $$ donc \(X \in L^2\). (Le calcul donne aussi \(\mathbb{E}(X(X-1)) = \lambda^2\), utilisé au sous-section 2.2.) Compétences à pratiquer
- Appliquer Cauchy-Schwarz
II.2
Variance et formule de König-Huygens
La variance mesure l'écart quadratique à la moyenne. La formule de König-Huygens transforme la définition en l'identité calculatoire \(\mathrm{V}(X) = \mathbb{E}(X^2) - \mathbb{E}(X)^2\), souvent plus simple à évaluer que la définition.
Définition — Variance, écart-type
Soit \(X\) une v.a.r.\ discrète réelle dans \(L^2\). Sa variance est le réel positif $$ \mathrm{V}(X) \,=\, \mathbb{E}\!\left( (X - \mathbb{E}(X))^2 \right). $$ Son écart-type est \(\sigma(X) = \sqrt{\mathrm{V}(X)}\). Une variable \(X\) est dite centrée lorsque \(\mathbb{E}(X) = 0\), et réduite lorsque \(\mathrm{V}(X) = 1\). Proposition — Formule de König-Huygens pour la variance
Pour toute v.a.r.\ discrète réelle \(X \in L^2\), $$ \mathrm{V}(X) \,=\, \mathbb{E}(X^2) - \mathbb{E}(X)^2. $$
Développer le carré et utiliser la linéarité : $$ \begin{aligned} \mathrm{V}(X) &\,=\, \mathbb{E}\!\left( X^2 - 2 \mathbb{E}(X) X + \mathbb{E}(X)^2 \right) && \text{(développement)} \\
&\,=\, \mathbb{E}(X^2) - 2 \mathbb{E}(X) \mathbb{E}(X) + \mathbb{E}(X)^2 && \text{(linéarité, \(\mathbb{E}(X)\) constante)} \\
&\,=\, \mathbb{E}(X^2) - \mathbb{E}(X)^2. \end{aligned} $$
Proposition — Règle affine et annulation de la variance
Soit \(X\) une v.a.r.\ discrète réelle dans \(L^2\) et \(a \virgule b \in \mathbb{R}\). Alors : - \(\mathrm{V}(aX + b) = a^2 \, \mathrm{V}(X)\).
- \(\mathrm{V}(X) = 0\) si et seulement si \(X = \mathbb{E}(X)\) p.s.\ (i.e.\ \(X\) est constante p.s.).
- (1) \(\mathbb{E}(aX + b) = a \mathbb{E}(X) + b\) par linéarité (sous-section 1.3), donc \(aX + b - \mathbb{E}(aX + b) = a (X - \mathbb{E}(X))\). En élevant au carré et en prenant l'espérance : \(\mathrm{V}(aX + b) = \mathbb{E}(a^2 (X - \mathbb{E}(X))^2) = a^2 \mathrm{V}(X)\).
- (2) \(\mathrm{V}(X) = \mathbb{E}((X - \mathbb{E}(X))^2) = 0\) avec \((X - \mathbb{E}(X))^2 \ge 0\) force \((X - \mathbb{E}(X))^2 = 0\) p.s., soit \(X = \mathbb{E}(X)\) p.s.\ (par le test d'annulation du sous-section 1.3).
Exemple — Variances des 5 lois usuelles
Chaque variance est dérivée ici une fois via König-Huygens, et tabulée au sous-section 2.6. - Bernoulli \(\mathcal{B}(p)\). \(\mathbb{E}(X^2) = 0^2 (1-p) + 1^2 p = p\), donc \(\mathrm{V}(X) = p - p^2 = p(1-p)\).
- Binomiale \(\mathcal{B}(n \virgule p)\). Pour \(n = 1\), \(\mathcal{B}(1 \virgule p) = \mathcal{B}(p)\) déjà traitée (variance \(p(1-p)\)). Pour \(n \ge 2\), dériver deux fois en \(x\) l'identité polynomiale \(\sum_{k=0}^n \binom{n}{k} x^k q^{n-k} = (x + q)^n\) donne \(\sum_{k=2}^n k(k-1) \binom{n}{k} x^{k-2} q^{n-k} = n(n-1)(x+q)^{n-2}\) ; évaluer en \(x = p\) (de sorte que \((p+q)^{n-2} = 1\)) et multiplier par \(p^2\) : \(\sum_{k=0}^n k(k-1) \binom{n}{k} p^k q^{n-k} = n(n-1) p^2\) (les termes \(k = 0\) et \(k = 1\) s'annulent à gauche). Par la formule de transfert ceci vaut \(\mathbb{E}(X(X-1)) = n(n-1) p^2\). En ajoutant \(\mathbb{E}(X) = np\) : \(\mathbb{E}(X^2) = n(n-1) p^2 + np\), d'où \(\mathrm{V}(X) = n(n-1) p^2 + np - n^2 p^2 = np(1-p) = npq\). Le même résultat réapparaît au sous-section 2.3 via l'identité de Bienaymé — là comme illustration, ici comme calcul König-Huygens indépendant.
- Uniforme \(\mathcal{U}(\{1 \virgule \dots \virgule n\})\). \(\mathbb{E}(X^2) = (1/n) \sum_{k=1}^n k^2 = (n+1)(2n+1)/6\), \(\mathbb{E}(X) = (n+1)/2\), d'où \(\mathrm{V}(X) = (n+1)(2n+1)/6 - (n+1)^2/4 = (n+1)[(2n+1) \cdot 2 - 3(n+1)]/12 = (n+1)(n-1)/12 = (n^2 - 1)/12\).
- Géométrique \(\mathcal{G}(p)\) avec \(0 < p < 1\). En utilisant \(\mathbb{E}(X) = 1/p\) et \(\mathbb{E}(X^2) = (2-p)/p^2\) du sous-section 1.2 : \(\mathrm{V}(X) = (2-p)/p^2 - 1/p^2 = (1-p)/p^2 = q/p^2\).
- Poisson \(\mathcal{P}(\lambda)\). En utilisant \(\mathbb{E}(X^2) = \lambda^2 + \lambda\) de l'Exemple précédent : \(\mathrm{V}(X) = \lambda^2 + \lambda - \lambda^2 = \lambda\).
Compétences à pratiquer
- Calculer une variance
II.3
Covariance, bilinéarité, identité de Bienaymé
La covariance généralise la variance aux couples de variables. La formule de König-Huygens pour la covariance donne la forme calculatoire ; la bilinéarité donne la variance d'une somme (identité de Bienaymé). La covariance fournit aussi le terme correctif précis à la formule du produit en défaut du sous-section 1.4 en l'absence d'indépendance.
Définition — Covariance, coefficient de corrélation
Soient \(X, Y\) deux v.a.r.\ discrètes réelles dans \(L^2\). La covariance de \(X\) et \(Y\) est le réel $$ \mathrm{Cov}(X \virgule Y) \,=\, \mathbb{E}\!\left( (X - \mathbb{E}(X))(Y - \mathbb{E}(Y)) \right), $$ bien défini car \((X - \mathbb{E}(X))(Y - \mathbb{E}(Y)) \in L^1\) par Cauchy-Schwarz (sous-section 2.1). Lorsque \(\mathrm{V}(X) > 0\) et \(\mathrm{V}(Y) > 0\), le coefficient de corrélation est $$ \rho(X \virgule Y) \,=\, \frac{\mathrm{Cov}(X \virgule Y)}{\sigma(X) \, \sigma(Y)}. $$ On dit que \(X\) et \(Y\) sont décorrélées lorsque \(\mathrm{Cov}(X \virgule Y) = 0\). Proposition — Formule de König-Huygens pour la covariance
Pour tous \(X, Y\) v.a.r.\ discrètes réelles dans \(L^2\), $$ \mathrm{Cov}(X \virgule Y) \,=\, \mathbb{E}(XY) - \mathbb{E}(X) \mathbb{E}(Y). $$ En particulier, \(\mathrm{Cov}(X \virgule X) = \mathrm{V}(X)\).
Développer et utiliser la linéarité (avec \(\mathbb{E}(X)\), \(\mathbb{E}(Y)\) constantes) : $$ \begin{aligned} \mathrm{Cov}(X \virgule Y) &\,=\, \mathbb{E}\!\left( XY - X \mathbb{E}(Y) - \mathbb{E}(X) Y + \mathbb{E}(X) \mathbb{E}(Y) \right) \\
&\,=\, \mathbb{E}(XY) - \mathbb{E}(X) \mathbb{E}(Y) - \mathbb{E}(X) \mathbb{E}(Y) + \mathbb{E}(X) \mathbb{E}(Y) \\
&\,=\, \mathbb{E}(XY) - \mathbb{E}(X) \mathbb{E}(Y). \end{aligned} $$
Proposition — Bilinéarité, symétrie, semi-définie positive ; \(|\rho| \le 1\)
L'application \((X \virgule Y) \mapsto \mathrm{Cov}(X \virgule Y)\) sur \(L^2 \times L^2\) est bilinéaire, symétrique, et semi-définie positive : \(\mathrm{Cov}(X \virgule X) = \mathrm{V}(X) \ge 0\), avec égalité si et seulement si \(X\) est constante p.s. En conséquence, dès que \(\mathrm{V}(X), \mathrm{V}(Y) > 0\), $$ -1 \,\le\, \rho(X \virgule Y) \,\le\, 1. $$
La bilinéarité vient de la linéarité de \(\mathbb{E}\) : chaque argument entre linéairement dans la définition. La symétrie se lit directement sur la définition. Semi-définie positive : \(\mathrm{Cov}(X \virgule X) = \mathbb{E}((X - \mathbb{E}(X))^2) = \mathrm{V}(X) \ge 0\), avec annulation ssi \(X = \mathbb{E}(X)\) p.s.\ (Proposition règle affine + annulation du sous-section 2.2). La majoration \(|\rho| \le 1\) est Cauchy-Schwarz appliqué aux variables centrées \(X - \mathbb{E}(X), Y - \mathbb{E}(Y)\) (toutes deux dans \(L^2\)) : \(|\mathrm{Cov}(X \virgule Y)|^2 \le \mathrm{V}(X) \mathrm{V}(Y) = \sigma(X)^2 \sigma(Y)^2\), on divise par \(\sigma(X) \sigma(Y) > 0\).
Proposition — Variables indépendantes décorrélées
Si \(X, Y\) sont deux v.a.r.\ discrètes réelles indépendantes dans \(L^2\), alors \(\mathrm{Cov}(X \virgule Y) = 0\). Attention : la réciproque est fausse. Décorrélées n'implique pas indépendantes (contre-exemple ci-dessous).
L'indépendance donne \(\mathbb{E}(XY) = \mathbb{E}(X) \mathbb{E}(Y)\) (Théorème du sous-section 1.4) ; König-Huygens donne ensuite \(\mathrm{Cov}(X \virgule Y) = \mathbb{E}(XY) - \mathbb{E}(X) \mathbb{E}(Y) = 0\).
Exemple — Décorrélées mais dépendantes
Soient \(X \sim \mathcal{U}(\{-1 \virgule 0 \virgule 1\})\) et \(Y = X^2\). Alors \(\mathbb{E}(X) = 0\), \(\mathbb{E}(XY) = \mathbb{E}(X^3) = ((-1)^3 + 0^3 + 1^3)/3 = 0\), donc \(\mathrm{Cov}(X \virgule Y) = 0\) — les deux variables sont décorrélées. Pourtant \(Y\) est fonction déterministe de \(X\), manifestement non indépendante de \(X\) (par exemple, \(\mathbb{P}(X = 0 \virgule Y = 1) = 0 \ne (1/3)(2/3) = \mathbb{P}(X = 0) \mathbb{P}(Y = 1)\)). Théorème — Variance d'une somme — identité de Bienaymé
Pour des v.a.r.\ discrètes réelles \(X_1 \virgule \dots \virgule X_n\) dans \(L^2\), $$ \mathrm{V}\!\left( \sum_{i=1}^n X_i \right) \,=\, \sum_{i=1}^n \mathrm{V}(X_i) + 2 \sum_{1 \le i < j \le n} \mathrm{Cov}(X_i \virgule X_j). $$ En particulier, si les \(X_1 \virgule \dots \virgule X_n\) sont deux à deux décorrélées (a fortiori mutuellement indépendantes), $$ \mathrm{V}\!\left( \sum_{i=1}^n X_i \right) \,=\, \sum_{i=1}^n \mathrm{V}(X_i). $$
Par \(\mathrm{Cov}(X \virgule X) = \mathrm{V}(X)\), bilinéarité et symétrie de \(\mathrm{Cov}\) : $$ \begin{aligned} \mathrm{V}\!\left( \sum_i X_i \right) &\,=\, \mathrm{Cov}\!\left( \sum_i X_i \virgule \sum_j X_j \right) && \text{(par \(\mathrm{Cov}(\cdot \virgule \cdot) = \mathrm{V}\) sur la diagonale)} \\
&\,=\, \sum_{i \virgule j} \mathrm{Cov}(X_i \virgule X_j) && \text{(bilinéarité)} \\
&\,=\, \sum_i \mathrm{Cov}(X_i \virgule X_i) + \sum_{i \ne j} \mathrm{Cov}(X_i \virgule X_j) && \text{(séparation diagonale / hors diagonale)} \\
&\,=\, \sum_i \mathrm{V}(X_i) + 2 \sum_{i < j} \mathrm{Cov}(X_i \virgule X_j) && \text{(symétrie : \(\mathrm{Cov}(X_i \virgule X_j) = \mathrm{Cov}(X_j \virgule X_i)\))}. \end{aligned} $$ La décorrélation deux à deux annule chaque terme croisé, ne laissant que la somme diagonale des variances.
Exemple — Variance d'une binomiale via Bienaymé
Décomposer \(X \sim \mathcal{B}(n \virgule p)\) en \(X = X_1 + \dots + X_n\) avec \(X_i \sim \mathcal{B}(p)\) indépendantes (MP Variables aléatoires discrètes). Chaque \(X_i\) a une variance \(\mathrm{V}(X_i) = p(1-p) = pq\) (sous-section 2.2). Par Bienaymé, $$ \mathrm{V}(X) \,=\, \sum_{i=1}^n \mathrm{V}(X_i) \,=\, n p q. $$ Même réponse qu'au sous-section 2.2 par König-Huygens — deux routes vers le même résultat. Méthode — Calculer une variance
Trois voies ; prendre la moins chère. - König-Huygens. Calculer \(\mathbb{E}(X)\) et \(\mathbb{E}(X^2)\), puis \(\mathrm{V}(X) = \mathbb{E}(X^2) - \mathbb{E}(X)^2\). Utiliser la formule de transfert et les quatre astuces de forme close du sous-section 1.2 pour évaluer les deux espérances.
- Identité de Bienaymé. Si \(X = X_1 + \dots + X_n\) avec les \(X_i\) deux à deux décorrélées (en particulier mutuellement indépendantes), calculer \(\mathrm{V}(X_i)\) pour chacune et sommer.
- Fonction génératrice (sous-section 3.3). Pour \(X\) à valeurs dans \(\mathbb{N}\) avec une forme close de \(G_X\) connue, évaluer \(\mathrm{V}(X) = G_X''(1^-) + G_X'(1^-) - G_X'(1^-)^2\). Particulièrement efficace pour les lois géométrique et de Poisson ; voir sous-section 3.3.
Compétences à pratiquer
- Appliquer l'identité de Bienaymé
II.4
Inégalités de Markov et de Bienaymé-Tchebychev
Deux inégalités de queue ne nécessitant que des moments de \(X\) — pas sa loi entière — pour contrôler la probabilité que \(X\) prenne des valeurs éloignées de sa moyenne. L'enchaînement est : Markov à partir du seul \(\mathbb{E}(X)\), Bienaymé-Tchebychev à partir de \(\mathbb{E}(X)\) et \(\mathrm{V}(X)\) via Markov appliqué à \((X - \mathbb{E}(X))^2\).
Théorème — Inégalité de Markov
Soit \(X\) une v.a.r.\ discrète réelle avec \(X \ge 0\) p.s.\ et \(a > 0\). Avec \(\mathbb{E}(X) = \sum_{x \in X(\Omega)} x \, \mathbb{P}(X = x) \in [0 \virgule +\infty]\) la somme positive (possiblement infinie), l'inégalité est valide en arithmétique de \([0 \virgule +\infty]\) : $$ \mathbb{P}(X \ge a) \,\le\, \frac{\mathbb{E}(X)}{a}. $$ Lorsque \(X \in L^1\), la borne est finie et utile ; lorsque \(\mathbb{E}(X) = +\infty\), le membre de droite vaut \(+\infty\) et la borne est trivialement vraie.
L'inégalité clef est ponctuelle sur \(\Omega\) : $$ a \, \mathbf{1}_{\{X \ge a\}} \,\le\, X. $$ En effet, sur \(\{X < a\}\) le membre de gauche vaut \(0\) et celui de droite est \(\ge 0\) (puisque \(X \ge 0\)) ; sur \(\{X \ge a\}\) le membre de gauche vaut \(a\) et celui de droite est \(\ge a\). Prendre l'espérance par croissance (valable dans \([0 \virgule +\infty]\) pour les v.a.r.\ positives, sans hypothèse \(L^1\)) : \(a \, \mathbb{P}(X \ge a) = \mathbb{E}(a \mathbf{1}_{\{X \ge a\}}) \le \mathbb{E}(X)\), on divise par \(a > 0\).
Théorème — Inégalité de Bienaymé-Tchebychev
Soit \(X\) une v.a.r.\ discrète réelle dans \(L^2\) et \(\varepsilon > 0\). Alors $$ \mathbb{P}(|X - \mathbb{E}(X)| \ge \varepsilon) \,\le\, \frac{\mathrm{V}(X)}{\varepsilon^2}. $$
On applique Markov à la v.a.r.\ positive \(Y = (X - \mathbb{E}(X))^2\) avec seuil \(\varepsilon^2\) : $$ \mathbb{P}(|X - \mathbb{E}(X)| \ge \varepsilon) \,=\, \mathbb{P}((X - \mathbb{E}(X))^2 \ge \varepsilon^2) \,\le\, \frac{\mathbb{E}((X - \mathbb{E}(X))^2)}{\varepsilon^2} \,=\, \frac{\mathrm{V}(X)}{\varepsilon^2}. $$
Exemple — Borne numérique sur l'écart d'une géométrique
Pour \(X \sim \mathcal{G}(1/4)\), \(\mathbb{E}(X) = 4\) et \(\mathrm{V}(X) = (3/4)/(1/16) = 12\). Bienaymé-Tchebychev avec \(\varepsilon = 10\) : $$ \mathbb{P}(|X - 4| \ge 10) \,\le\, \frac{12}{100} \,=\, 0\virgule 12. $$ Une borne grossière mais peu chère à obtenir — elle ne requiert que la moyenne et la variance. La probabilité de queue exacte \(\mathbb{P}(X \ge 14) = (3/4)^{13}\) est bien plus petite, \(\approx 0\virgule 024\) ; la borne Bienaymé-Tchebychev est le prix payé pour n'utiliser que deux moments au lieu de la loi entière. Exemple — Visualisation en bande \(\varepsilon\) de Bienaymé-Tchebychev
L'image : la masse de la loi concentrée sur la bande centrale \([\mu - \varepsilon \virgule \mu + \varepsilon]\) autour de \(\mu = \mathbb{E}(X)\), les deux queues hors de la bande portant une masse totale au plus égale à \(\mathrm{V}(X)/\varepsilon^2\). 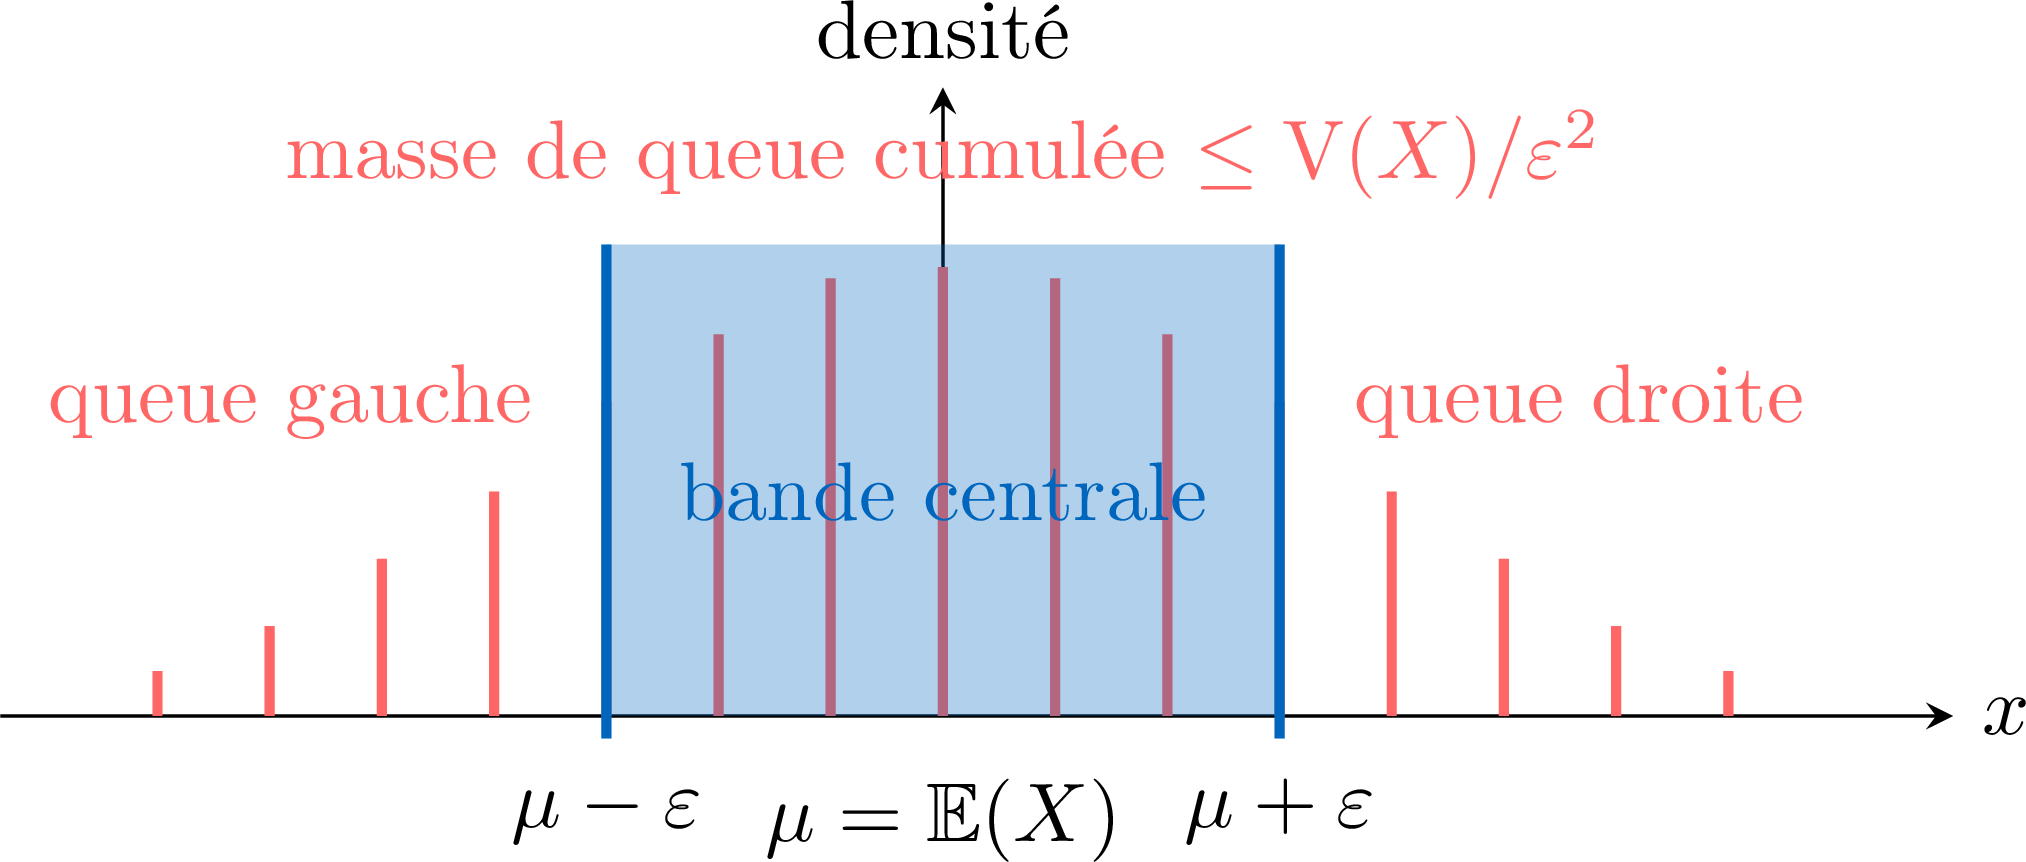
Méthode — Majorer une probabilité par Markov ou Bienaymé-Tchebychev
Trois schémas, par ordre de généralité. - Markov sur \(X \ge 0\). Pour majorer \(\mathbb{P}(X \ge a)\) avec \(X\) positive : estimer \(\mathbb{E}(X)\), diviser par \(a\). Peu cher, souvent peu serré, mais toujours disponible.
- Bienaymé-Tchebychev pour les écarts à la moyenne. Pour majorer \(\mathbb{P}(|X - \mathbb{E}(X)| \ge \varepsilon)\) avec \(X \in L^2\) : estimer \(\mathrm{V}(X)\), diviser par \(\varepsilon^2\). La borne décroît en \(1/\varepsilon^2\) avec la taille de l'écart — plus serrée que Markov sur \(|X - \mathbb{E}(X)|\).
- Markov sur une fonction positive de \(X\). Pour \(X\) ayant des moments supérieurs, appliquer Markov à \(\varphi(X) \ge 0\) pour \(\varphi \colon \mathbb{R} \to \mathbb{R}_+\) strictement croissante : alors \(\{X \ge a\} = \{\varphi(X) \ge \varphi(a)\}\) (la stricte monotonie donne l'égalité d'événements, non une simple inclusion), donc \(\mathbb{P}(X \ge a) = \mathbb{P}(\varphi(X) \ge \varphi(a)) \le \mathbb{E}(\varphi(X))/\varphi(a)\). Le choix \(\varphi(x) = \mathrm{e}^{tx}\) conduit aux bornes exponentielles de type Chernoff (hors programme, nommées seulement).
Compétences à pratiquer
- Majorer une probabilité par Markov ou Bienaymé-Tchebychev
II.5
Loi faible des grands nombres
La moyenne empirique de \(n\) variables aléatoires deux à deux décorrélées d'espérance commune \(m\) et de variance commune \(\sigma^2\) converge en probabilité vers \(m\) lorsque \(n \to \infty\). (Le cas « identiquement distribuées » est l'instance standard.) La démonstration tient en une ligne : Bienaymé-Tchebychev appliqué à \(S_n/n\), dont la variance décroît en \(\sigma^2/n\) par l'identité de Bienaymé.
Théorème — Loi faible des grands nombres — forme deux à deux décorrélée
Soit \((X_n)_{n \ge 1}\) une suite de v.a.r.\ discrètes réelles dans \(L^2\), deux à deux décorrélées, ayant toutes la même espérance \(m\) et la même variance \(\sigma^2\). Posons \(S_n = X_1 + \dots + X_n\). Alors pour tout \(\varepsilon > 0\), $$ \mathbb{P}\!\left( \left| \frac{S_n}{n} - m \right| \ge \varepsilon \right) \,\xrightarrow[n \to \infty]{}\, 0. $$
La linéarité donne \(\mathbb{E}(S_n/n) = (1/n) \sum_{i=1}^n \mathbb{E}(X_i) = m\). L'identité de Bienaymé dans sa forme deux à deux décorrélée (sous-section 2.3) donne \(\mathrm{V}(S_n) = \sum_{i=1}^n \mathrm{V}(X_i) = n \sigma^2\), d'où \(\mathrm{V}(S_n/n) = (1/n^2) \cdot n \sigma^2 = \sigma^2/n\). Bienaymé-Tchebychev appliqué à \(S_n/n\) : $$ \mathbb{P}\!\left( \left| \frac{S_n}{n} - m \right| \ge \varepsilon \right) \,\le\, \frac{\mathrm{V}(S_n/n)}{\varepsilon^2} \,=\, \frac{\sigma^2}{n \varepsilon^2} \,\xrightarrow[n \to \infty]{}\, 0. $$
Corollaire — Forme i.i.d.
En particulier, lorsque les \((X_n)\) sont indépendantes et identiquement distribuées (i.i.d.) d'espérance commune \(m\) et de variance commune \(\sigma^2 < +\infty\), la conclusion du Théorème est valide. C'est la version la plus utilisée en exercice.
Mutuellement indépendantes \(\Rightarrow\) deux à deux décorrélées (Proposition du sous-section 2.3) ; identiquement distribuées \(\Rightarrow\) mêmes \(m\) et \(\sigma^2\). Appliquer le Théorème.
Exemple — Fréquence empirique d'une suite de Bernoulli
C'est la justification formelle du principe de modélisation « probabilité = fréquence à long terme » : avec \(n\) assez grand, la fréquence empirique est à \(\varepsilon\) près de la probabilité théorique \(p\) avec une probabilité arbitrairement proche de \(1\). La figure ci-dessous montre l'histogramme de \(S_n/n\) à mesure que \(n\) croît : la masse se concentre en \(p\) quand \(n \to +\infty\). 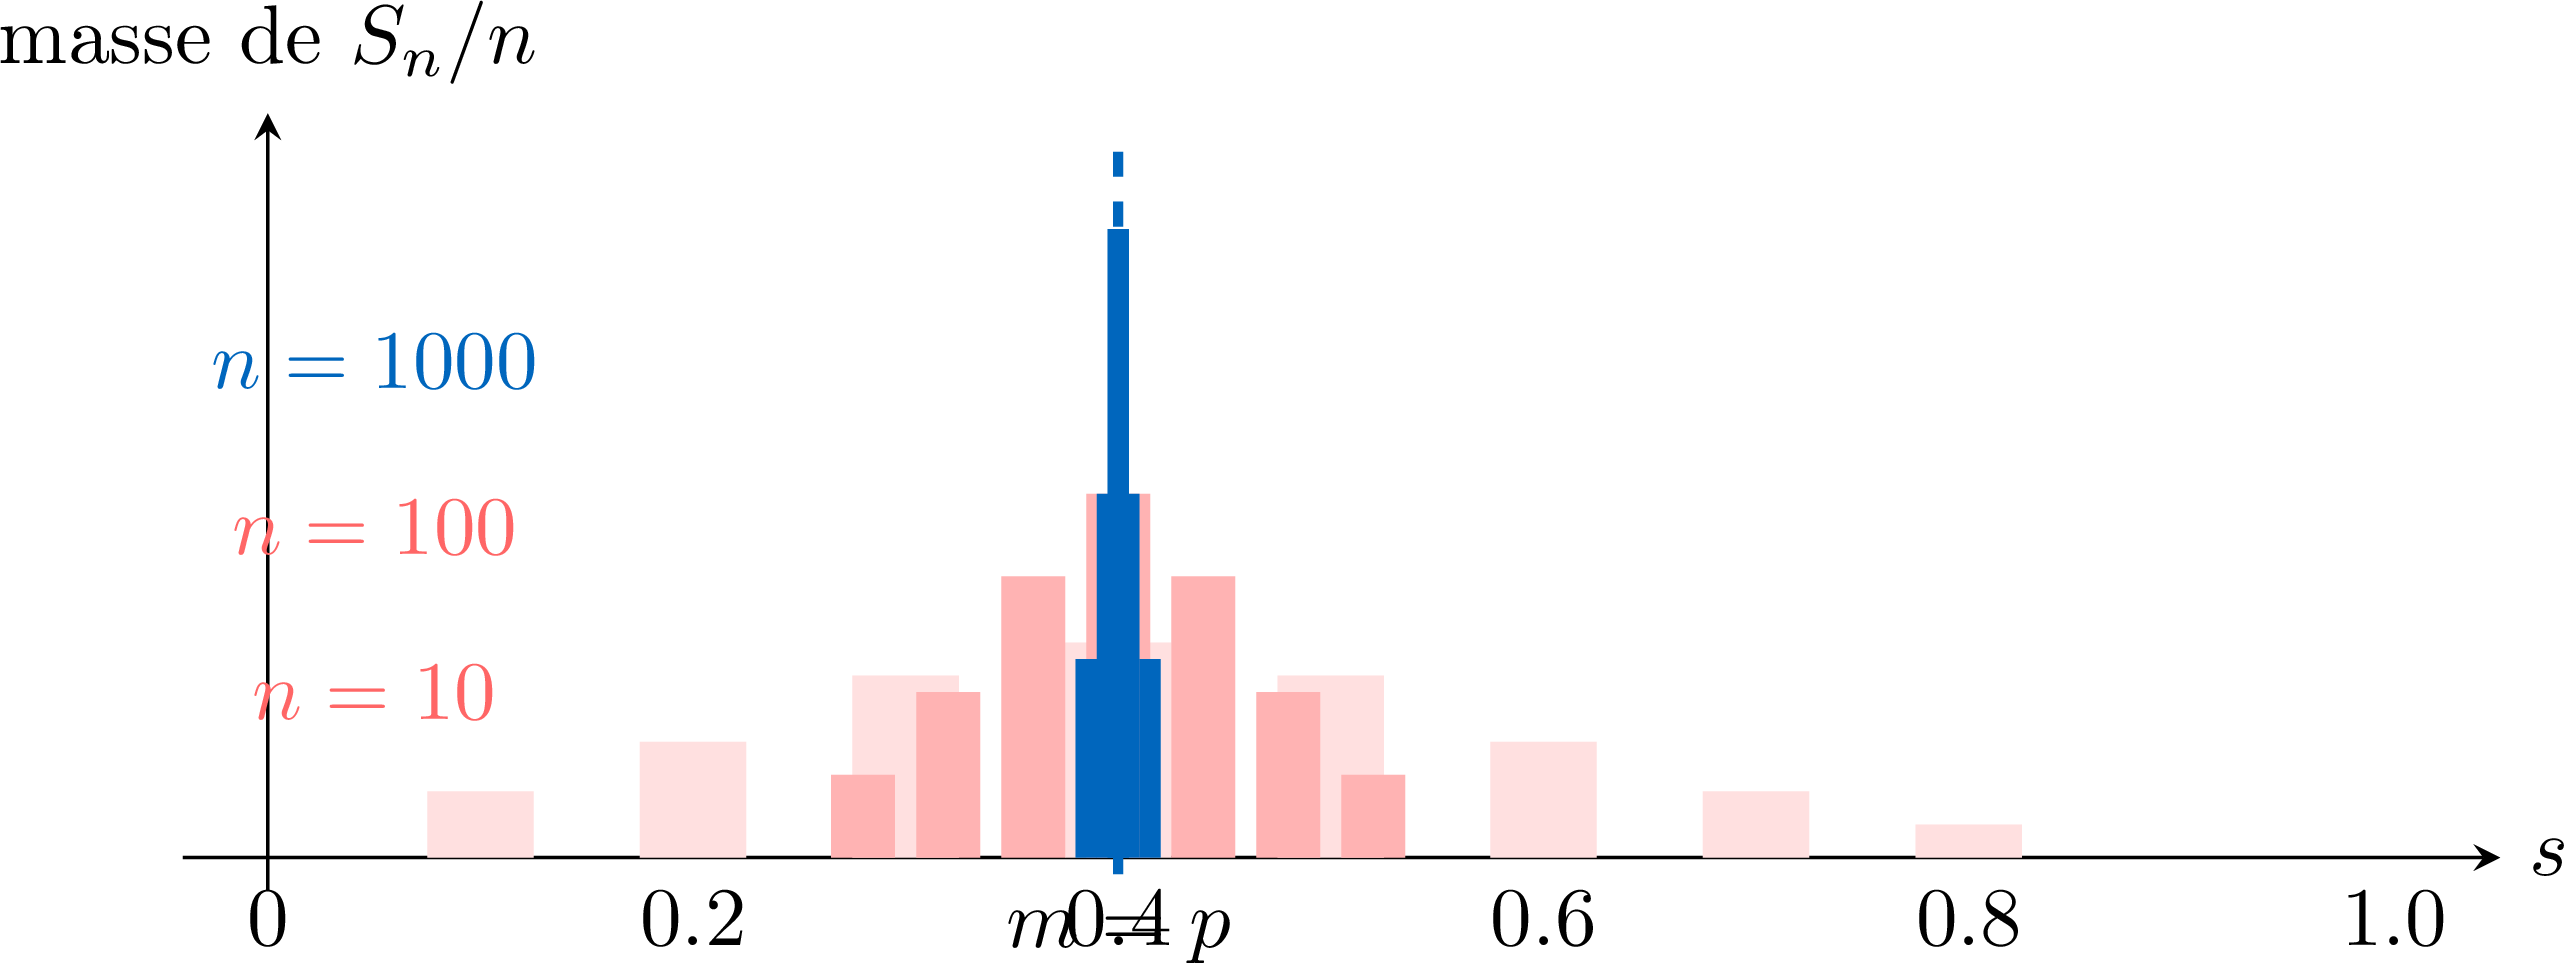
Méthode — Appliquer la loi faible des grands nombres à une suite concrète
Quatre étapes. - Identifier la famille. Reconnaître la somme \(S_n = X_1 + \dots + X_n\) où les \(X_i\) sont i.i.d.\ (ou au moins deux à deux décorrélées et identiquement distribuées) et ont une variance finie.
- Calculer \(m\) et \(\sigma^2\). Trouver \(m = \mathbb{E}(X_1)\) et \(\sigma^2 = \mathrm{V}(X_1)\) avec les méthodes des sous-section 1.5 et sous-section 2.3.
- Appliquer la borne. Pour tout \(\varepsilon > 0\), \(\mathbb{P}(|S_n/n - m| \ge \varepsilon) \le \sigma^2/(n \varepsilon^2)\).
- Conclure. La borne tend vers \(0\) lorsque \(n \to +\infty\), donc \(S_n/n\) converge en probabilité vers \(m\). Pour obtenir une taille d'échantillon numérique à partir d'une précision cible \((\varepsilon \virgule \delta)\) (« probabilité d'écart de \(\varepsilon\) au plus \(\delta\) »), exiger \(\sigma^2/(n \varepsilon^2) \le \delta\), soit \(n \ge \sigma^2/(\delta \varepsilon^2)\).
Au-delà du programme : espérance conditionnelle
Un raffinement naturel serait le « meilleur prédicteur \(L^2\) de \(Y\) connaissant la valeur de \(X\) », ce qui mène à la notion d'espérance conditionnelle \(\mathbb{E}(Y \mid X)\) — la fonction de \(X\) la plus proche de \(Y\) au sens de la moyenne quadratique. La notion d'espérance conditionnelle est hors programme dans ce cursus. Nous la mentionnons sur place ici comme prochaine étape naturelle au-delà de la loi faible des grands nombres, non développée ; c'est la porte d'entrée vers l'étude analytique des suites stochastiques dépendantes (chaînes de Markov, filtrations, arrêt optimal) traitées en probabilités de l'enseignement post-prépa.
Compétences à pratiquer
- Appliquer la loi faible des grands nombres
II.6
Synthèse : espérances et variances des lois usuelles
Une table de référence à mémoriser. Les valeurs sont dérivées une fois aux sous-section 1.5 (espérances) et sous-section 2.2 (variances).
Table de synthèse — lois usuelles
| Loi | Notation | Support | \(\mathbb{E}(X)\) | \(\mathrm{V}(X)\) |
| Bernoulli | \(\mathcal{B}(p)\) | \(\{0 \virgule 1\}\) | \(p\) | \(p(1-p)\) |
| Binomiale | \(\mathcal{B}(n \virgule p)\) | \(\{0 \virgule \dots \virgule n\}\) | \(np\) | \(np(1-p)\) |
| Uniforme | \(\mathcal{U}(\{1 \virgule \dots \virgule n\})\) | \(\{1 \virgule \dots \virgule n\}\) | \((n+1)/2\) | \((n^2-1)/12\) |
| Géométrique | \(\mathcal{G}(p)\) (\(0| \(\mathbb{N}^*\) | \(1/p\) | \((1-p)/p^2\) | |
| Poisson | \(\mathcal{P}(\lambda)\) (\(\lambda>0\)) | \(\mathbb{N}\) | \(\lambda\) | \(\lambda\) |
Compétences à pratiquer
- Reconnaître une loi usuelle à partir de ses moments
III
Fonctions génératrices d'une variable aléatoire à valeurs dans \(\mathbb{N}\)
Pour une variable aléatoire à valeurs dans \(\mathbb{N}\), la fonction génératrice \(G_X(t) = \mathbb{E}(t^X) = \sum_{n \ge 0} \mathbb{P}(X = n) t^n\) est une série entière à coefficients positifs de masse totale \(1\). Trois théorèmes en font l'outil approprié pour les probabilités à valeurs dans \(\mathbb{N}\) : (i) elle détermine la loi de manière unique (les coefficients sont les \(\mathbb{P}(X = n)\)) ; (ii) l'indépendance devient une multiplication, soit \(G_{X + Y} = G_X G_Y\) via le produit de Cauchy ; (iii) les moments se lisent sur les dérivées en \(t = 1\). Toute cette section est une application directe de MP Séries entières : chaque théorème cite le bon résultat depuis ce chapitre, et aucun résultat de Séries entières n'y est re-démontré.
III.1
Définition ; rayon de convergence
La fonction génératrice est une série entière avec deux particularités : tous les coefficients \(\mathbb{P}(X = n)\) sont dans \([0 \virgule 1]\), et leur masse totale est \(\sum_n \mathbb{P}(X = n) = 1\). Les deux ensemble forcent le rayon de convergence à être au moins \(1\) et la fonction à être définie et continue sur l'intervalle fermé \([-1 \virgule 1]\).
Définition — Fonction génératrice
Soit \(X\) une variable aléatoire discrète avec \(X(\Omega) \subset \mathbb{N}\). La fonction génératrice de \(X\) est la série entière à coefficients positifs \(\mathbb{P}(X = n)\), $$ G_X(t) \,=\, \sum_{n = 0}^{+\infty} \mathbb{P}(X = n) \, t^n. $$ Pour \(t\) à l'intérieur du disque de convergence, la série est absolument sommable et \(G_X(t) = \mathbb{E}(t^X)\) par la formule de transfert (sous-section 1.2) appliquée à \(f(n) = t^n\), la condition \(\ell^1\) étant \(\sum_n |t|^n \mathbb{P}(X = n) < +\infty\). Proposition — Rayon et régularité de \(G_X\)
Le rayon de convergence \(R\) de \(G_X\) vérifie \(R \ge 1\). La fonction \(G_X\) est bien définie et continue sur l'intervalle fermé \([-1 \virgule 1]\), et de classe \(\mathcal{C}^\infty\) sur l'intervalle ouvert \(]-1 \virgule 1[\). De plus \(G_X(1) = 1\). - Convergence normale sur \([-1 \virgule 1]\) par M-test direct. Pour tout \(t \in [-1 \virgule 1]\) et tout \(n \ge 0\), $$ |\mathbb{P}(X = n) \, t^n| \,\le\, \mathbb{P}(X = n), $$ et la série numérique \(\sum \mathbb{P}(X = n) = 1\) converge. Par le M-test de Weierstrass (rappelé de MP Suites et séries de fonctions), la série de fonctions \(\sum_n \mathbb{P}(X = n) t^n\) converge normalement sur \([-1 \virgule 1]\). En particulier elle converge (absolument) pour tout \(t \in [-1 \virgule 1]\), donc \(R \ge 1\).
- Continuité sur \([-1 \virgule 1]\). Chaque fonction \(t \mapsto \mathbb{P}(X = n) t^n\) est continue sur \(\mathbb{R}\), donc sur \([-1 \virgule 1]\). La convergence normale entraîne la convergence uniforme sur \([-1 \virgule 1]\), donc la fonction somme \(G_X\) est continue sur \([-1 \virgule 1]\) (MP Suites et séries de fonctions : continuité d'une limite uniforme sur un segment).
- \(\mathcal{C}^\infty\) sur \(]-1 \virgule 1[\). L'intervalle ouvert \(]-1 \virgule 1[\) est contenu dans le disque ouvert de convergence \(]-R \virgule R[\) puisque \(R \ge 1\), donc MP Séries entières sous-section 3.1 s'applique directement.
- \(G_X(1) = 1\). Direct : \(G_X(1) = \sum_n \mathbb{P}(X = n) = 1\).
Proposition — Unicité de la loi à partir de \(G_X\)
Pour tout \(n \in \mathbb{N}\), \(\mathbb{P}(X = n) = G_X^{(n)}(0)/n!\). En conséquence la loi de \(X\) est uniquement déterminée par \(G_X\) : deux variables aléatoires à valeurs dans \(\mathbb{N}\) de mêmes fonctions génératrices ont même loi.
Par MP Séries entières sous-section 3.1 (formule de Taylor des coefficients d'une série entière), la dérivée \(n\)-ième de la somme en \(0\) vaut \(n!\) fois le \(n\)-ième coefficient : \(G_X^{(n)}(0) = n! \, \mathbb{P}(X = n)\), d'où la formule. L'unicité en découle : du même \(G_X\) on lit la même suite de coefficients \((\mathbb{P}(X = n))\), ce qui est exactement la loi sur \(\mathbb{N}\).
Exemple — Fonctions génératrices des lois usuelles
Tabulées au sous-section 3.4 ci-dessous. Référence rapide pour le moment : \(\mathcal{B}(p) \to (1-p) + pt\) ; \(\mathcal{B}(n \virgule p) \to ((1-p) + pt)^n\) ; \(\mathcal{U}(\{1 \virgule \dots \virgule n\}) \to (t - t^{n+1})/(n(1 - t))\) ; \(\mathcal{G}(p)\) avec \(0 < p < 1 \to pt/(1 - (1-p)t)\) ; \(\mathcal{P}(\lambda) \to \mathrm{e}^{\lambda(t - 1)}\). Exemple — \(R\) peut être strictement plus grand que \(1\)
Pour toute loi à support fini (Bernoulli, binomiale, uniforme), la fonction génératrice est un polynôme en \(t\), donc \(R = +\infty\). Pour \(\mathcal{G}(p)\) avec \(0 < p < 1\), \(G_X(t) = pt/(1 - qt)\) a pour rayon \(R = 1/q > 1\) (singularité en \(t = 1/q\), hors de \([-1 \virgule 1]\)). Pour \(\mathcal{P}(\lambda)\), \(G_X(t) = \mathrm{e}^{\lambda(t - 1)}\) a pour rayon \(R = +\infty\) (série exponentielle). Dans chaque cas, \(R \ge 1\) comme l'exige la Proposition ; la valeur précise de \(R\) dépend du comportement de la queue de la loi. Compétences à pratiquer
- Calculer une fonction génératrice
III.2
Indépendance et formule du produit
La propriété algébrique phare : pour des variables aléatoires indépendantes à valeurs dans \(\mathbb{N}\), les fonctions génératrices se multiplient. La démonstration tient en une ligne — produit de Cauchy de deux séries entières à coefficients dans \(\ell^1\) (MP Séries entières sous-section 1.3, qui rappelle elle-même MPSI Familles sommables). L'application est le calcul de la loi d'une somme indépendante sans jamais écrire la distribution jointe.
Théorème — Formule du produit pour les fonctions génératrices
Soient \(X, Y\) deux variables aléatoires discrètes indépendantes avec \(X(\Omega), Y(\Omega) \subset \mathbb{N}\), et soient \(R_X, R_Y\) les rayons de \(G_X, G_Y\). Alors pour tout \(t\) avec \(|t| < \min(R_X \virgule R_Y)\), $$ G_{X + Y}(t) \,=\, G_X(t) \, G_Y(t). $$
Fixons \(|t| < \min(R_X \virgule R_Y)\). Les deux suites \((\mathbb{P}(X = n) t^n)_n\) et \((\mathbb{P}(Y = n) t^n)_n\) sont dans \(\ell^1(\mathbb{N})\) puisque \(t\) est strictement à l'intérieur de chaque rayon de convergence. Par le théorème du produit de Cauchy de MP Séries entières sous-section 1.3 (lui-même un rappel de MPSI Familles sommables), le produit de deux telles séries entières est la série entière de coefficient $$ c_n \,=\, \sum_{k = 0}^n \mathbb{P}(X = k) \mathbb{P}(Y = n - k), \qquad G_X(t) G_Y(t) \,=\, \sum_n c_n t^n. $$ Or par indépendance (MP Variables aléatoires discrètes), $$ \mathbb{P}(X + Y = n) \,=\, \sum_{k = 0}^n \mathbb{P}(X = k \virgule Y = n - k) \,=\, \sum_{k = 0}^n \mathbb{P}(X = k) \mathbb{P}(Y = n - k) \,=\, c_n. $$ Les deux séries entières ont des coefficients identiques, donc des sommes égales : $$ G_X(t) G_Y(t) \,=\, \sum_n c_n t^n \,=\, \sum_n \mathbb{P}(X + Y = n) t^n \,=\, G_{X + Y}(t). $$
Corollaire — Extension à une somme finie
Pour \(X_1 \virgule \dots \virgule X_n\) des variables aléatoires discrètes mutuellement indépendantes à valeurs dans \(\mathbb{N}\), $$ G_{X_1 + \dots + X_n}(t) \,=\, G_{X_1}(t) \, G_{X_2}(t) \cdots G_{X_n}(t) $$ sur l'intersection des disques ouverts de convergence.
Récurrence sur \(n\) avec le lemme des coalitions (MP Variables aléatoires discrètes, utilisé comme dans le Corollaire du sous-section 1.4).
Proposition — Stabilité des familles Poisson et binomiale
- Si \(X \sim \mathcal{P}(\lambda)\) et \(Y \sim \mathcal{P}(\mu)\) sont indépendantes, alors \(X + Y \sim \mathcal{P}(\lambda + \mu)\).
- Si \(X \sim \mathcal{B}(m \virgule p)\) et \(Y \sim \mathcal{B}(n \virgule p)\) sont indépendantes (même probabilité de succès \(p\)), alors \(X + Y \sim \mathcal{B}(m + n \virgule p)\).
- Poisson. \(G_X(t) = \mathrm{e}^{\lambda(t - 1)}\) et \(G_Y(t) = \mathrm{e}^{\mu(t - 1)}\), toutes deux de rayon \(R = +\infty\). Par la formule du produit, \(G_{X + Y}(t) = G_X(t) G_Y(t) = \mathrm{e}^{\lambda(t - 1)} \mathrm{e}^{\mu(t - 1)} = \mathrm{e}^{(\lambda + \mu)(t - 1)}\), qui est la fonction génératrice de \(\mathcal{P}(\lambda + \mu)\). Par unicité de la loi à partir de \(G_X\) (Proposition du sous-section 3.1), \(X + Y \sim \mathcal{P}(\lambda + \mu)\).
- Binomiale. \(G_X(t) = ((1 - p) + pt)^m\), \(G_Y(t) = ((1 - p) + pt)^n\). Par la formule du produit, \(G_{X + Y}(t) = ((1 - p) + pt)^{m + n}\), qui est la fonction génératrice de \(\mathcal{B}(m + n \virgule p)\). Par unicité, \(X + Y \sim \mathcal{B}(m + n \virgule p)\).
Méthode — Déterminer la loi de \(X + Y\) pour des variables indépendantes à valeurs dans \(\mathbb{N}\)
Trois étapes. - Calculer \(G_X(t)\) et \(G_Y(t)\). Utiliser la table du sous-section 3.4 pour les lois usuelles, ou appliquer la définition \(\sum_n \mathbb{P}(X = n) t^n\) directement.
- Multiplier. La formule du produit donne \(G_{X + Y}(t) = G_X(t) G_Y(t)\).
- Identifier. Si le résultat correspond à une fonction génératrice usuelle (table sous-section 3.4), conclure la loi de \(X + Y\) par unicité. Sinon, développer \(G_X(t) G_Y(t)\) en série entière en \(t\) et lire les coefficients comme \(\mathbb{P}(X + Y = n)\).
Compétences à pratiquer
- Déterminer la loi de \(X + Y\) par \(G_X G_Y\)
III.3
Moments à partir de la fonction génératrice
Les moments de \(X\) se lisent sur les dérivées de \(G_X\) en \(t = 1\) à gauche. L'équivalence « \(X\) admet une espérance finie \(\Leftrightarrow\) \(G_X\) est dérivable à gauche en \(1\) » est pilotée par la positivité et démontrée de manière autonome via un petit lemme positif d'Abel (énoncé et démontré ci-dessous) — on n'invoque pas le théorème de convergence radiale d'Abel général de MP Séries entières (hors programme).
Proposition — Lemme d'Abel positif
Soit \((a_n)_{n \ge 0}\) une suite de réels positifs telle que la série entière \(\varphi(t) = \sum_{n \ge 0} a_n t^n\) ait un rayon de convergence au moins égal à \(1\). Posons \(S = \sum_{n \ge 0} a_n \in [0 \virgule +\infty]\). Alors \(\varphi\) est définie sur \([0 \virgule 1)\), à valeurs dans \([0 \virgule +\infty)\) avec \(\varphi(t) \le S\) lorsque \(S < +\infty\), et $$ \lim_{t \to 1^-} \varphi(t) \,=\, S \qquad \text{(dans \([0 \virgule +\infty]\)).} $$
L'hypothèse de rayon \(R \ge 1\) assure que \(\varphi\) converge absolument sur \([0 \virgule 1)\) (intérieur du disque ouvert de convergence). Sandwich bilatéral sur les sommes partielles positives. Borne supérieure. Pour \(t \in [0 \virgule 1)\) et tout \(n\), \(a_n t^n \le a_n\), donc \(\varphi(t) \le \sum_n a_n = S\). Lorsque \(S < +\infty\), \(\varphi(t) \le S < +\infty\). Dans tous les cas \(\limsup_{t \to 1^-} \varphi(t) \le S\). Borne inférieure. Pour tout \(N \in \mathbb{N}\), la somme partielle finie \(\sum_{n = 0}^N a_n t^n\) converge vers \(\sum_{n = 0}^N a_n\) lorsque \(t \to 1^-\) (continuité d'un polynôme). Comme \(a_n \ge 0\), \(\varphi(t) \ge \sum_{n = 0}^N a_n t^n\), donc \(\liminf_{t \to 1^-} \varphi(t) \ge \sum_{n = 0}^N a_n\). En prenant \(N \to +\infty\) : \(\liminf_{t \to 1^-} \varphi(t) \ge S\). Les deux bornes donnent la limite.
Théorème — Espérance à partir de la fonction génératrice
Soit \(X\) une v.a.r.\ discrète avec \(X(\Omega) \subset \mathbb{N}\). Alors \(X\) admet une espérance finie si et seulement si \(G_X\) est dérivable à gauche en \(1\), et dans ce cas $$ \mathbb{E}(X) \,=\, G_X'(1^-) \,=\, \lim_{t \to 1^-} G_X'(t) \,=\, \sum_{n \ge 1} n \, \mathbb{P}(X = n). $$
Deux étapes. Étape 1 : Abel positif sur \(G_X'\). La série entière dérivée \(G_X'(t) = \sum_{n \ge 1} n \, \mathbb{P}(X = n) \, t^{n - 1}\) a le même rayon de convergence que \(G_X\) (MP Séries entières sous-section 3.1, rappelé), donc un rayon \(\ge 1\) (puisque \(G_X\) a un rayon \(\ge 1\), Proposition du sous-section 3.1 ci-dessus). Les coefficients \(a_n = n \, \mathbb{P}(X = n)\) sont positifs et leur somme formelle est \(\sum_{n \ge 1} n \, \mathbb{P}(X = n) = \mathbb{E}(X) \in [0 \virgule +\infty]\) (« identité de la queue » du sous-section 1.1, ou directement la définition de \(\mathbb{E}\) pour les v.a.r.\ à valeurs dans \(\mathbb{N}\) positives). L'hypothèse de rayon \(\ge 1\) du lemme d'Abel positif est satisfaite, donc : $$ \lim_{t \to 1^-} G_X'(t) \,=\, \mathbb{E}(X) \in [0 \virgule +\infty]. $$ Étape 2 : identification avec la dérivée à gauche. Pour \(t \in [0 \virgule 1)\), le taux d'accroissement est $$ \varphi(t) \,=\, \frac{G_X(1) - G_X(t)}{1 - t} \,=\, \sum_{n \ge 0} \mathbb{P}(X = n) \cdot \frac{1 - t^n}{1 - t} \,=\, \sum_{n \ge 1} \mathbb{P}(X = n) (1 + t + \dots + t^{n - 1}). $$ Par le théorème des accroissements finis appliqué à \(G_X\) sur \([t \virgule 1]\) (valide car \(G_X\) est \(\mathcal{C}^\infty\) sur \(]-1 \virgule 1[\) et continue sur \([-1 \virgule 1]\)), il existe \(c_t \in (t \virgule 1)\) avec \(\varphi(t) = G_X'(c_t)\). La dérivée \(G_X'\) est croissante sur \([0 \virgule 1)\) (car \(G_X''(t) = \sum n(n-1) \mathbb{P}(X = n) t^{n-2} \ge 0\) sur \([0 \virgule 1)\), coefficients positifs), donc par encadrement $$ G_X'(t) \,\le\, G_X'(c_t) \,=\, \varphi(t) \,\le\, \lim_{s \to 1^-} G_X'(s) \,=\, \mathbb{E}(X). $$ \(G_X'(t)\) et la borne supérieure tendent toutes deux vers \(\mathbb{E}(X)\) quand \(t \to 1^-\), donc \(\varphi(t) \to \mathbb{E}(X)\). En combinant : \(G_X'(1^-) = \lim_{t \to 1^-} \varphi(t) = \mathbb{E}(X)\). L'équivalence « \(G_X\) dérivable à gauche en \(1\) \(\Leftrightarrow\) \(\mathbb{E}(X) < +\infty\) » se lit directement : \(\varphi(t) \to \mathbb{E}(X) \in [0 \virgule +\infty]\) est finie si et seulement si \(\mathbb{E}(X) < +\infty\).
Théorème — Variance à partir de la fonction génératrice
Soit \(X\) une v.a.r.\ discrète avec \(X(\Omega) \subset \mathbb{N}\). Alors \(X \in L^2\) si et seulement si \(G_X\) est deux fois dérivable à gauche en \(1\), et dans ce cas $$ \mathbb{E}(X(X - 1)) \,=\, G_X''(1^-), \qquad \mathrm{V}(X) \,=\, G_X''(1^-) + G_X'(1^-) - G_X'(1^-)^2. $$
Même argument « Abel sur séries positives » que dans le Théorème précédent, appliqué à la série deux fois dérivée $$ G_X''(t) \,=\, \sum_{n \ge 2} n(n - 1) \, \mathbb{P}(X = n) \, t^{n - 2} \qquad \text{sur \(]-1 \virgule 1[\) (MP \textit{Séries entières} \S 3.1)}. $$ Les coefficients positifs \(n(n-1) \mathbb{P}(X = n)\) ont pour somme formelle \(\mathbb{E}(X(X - 1)) \in [0 \virgule +\infty]\). Le lemme d'Abel positif donne \(\lim_{t \to 1^-} G_X''(t) = \mathbb{E}(X(X-1))\) ; l'argument TAF + monotonie du Théorème précédent identifie cette limite à la dérivée seconde à gauche \(G_X''(1^-)\).
Équivalence des moments factoriels. On observe que \(\mathbb{E}(X^2) = \mathbb{E}(X(X - 1)) + \mathbb{E}(X)\), où pour \(X\) à valeurs dans \(\mathbb{N}\) chaque entier positif \(n\) vérifie \(n \le n(n-1) + 1\) (trivialement : \(n = 0 \Rightarrow n(n-1)+1 = 1\) ; \(n \ge 1 \Rightarrow n(n-1)+1 \ge n\)). Donc \(\mathbb{E}(X) \le \mathbb{E}(X(X-1)) + 1\) par croissance ; d'où \(\mathbb{E}(X(X-1)) < +\infty \Rightarrow \mathbb{E}(X) < +\infty\). Combiné avec \(\mathbb{E}(X^2) = \mathbb{E}(X(X-1)) + \mathbb{E}(X)\) et \(L^2 \subset L^1\) (Corollaire du sous-section 2.1) : $$ \mathbb{E}(X(X-1)) < +\infty \,\iff\, \mathbb{E}(X^2) < +\infty \,\iff\, X \in L^2. $$ C'est exactement l'équivalence annoncée avec la dérivabilité seconde. La formule de la variance découle ensuite de König-Huygens : $$ \mathrm{V}(X) \,=\, \mathbb{E}(X^2) - \mathbb{E}(X)^2 \,=\, \big( G_X''(1^-) + G_X'(1^-) \big) - G_X'(1^-)^2 \,=\, G_X''(1^-) + G_X'(1^-) - G_X'(1^-)^2. $$
Équivalence des moments factoriels. On observe que \(\mathbb{E}(X^2) = \mathbb{E}(X(X - 1)) + \mathbb{E}(X)\), où pour \(X\) à valeurs dans \(\mathbb{N}\) chaque entier positif \(n\) vérifie \(n \le n(n-1) + 1\) (trivialement : \(n = 0 \Rightarrow n(n-1)+1 = 1\) ; \(n \ge 1 \Rightarrow n(n-1)+1 \ge n\)). Donc \(\mathbb{E}(X) \le \mathbb{E}(X(X-1)) + 1\) par croissance ; d'où \(\mathbb{E}(X(X-1)) < +\infty \Rightarrow \mathbb{E}(X) < +\infty\). Combiné avec \(\mathbb{E}(X^2) = \mathbb{E}(X(X-1)) + \mathbb{E}(X)\) et \(L^2 \subset L^1\) (Corollaire du sous-section 2.1) : $$ \mathbb{E}(X(X-1)) < +\infty \,\iff\, \mathbb{E}(X^2) < +\infty \,\iff\, X \in L^2. $$ C'est exactement l'équivalence annoncée avec la dérivabilité seconde. La formule de la variance découle ensuite de König-Huygens : $$ \mathrm{V}(X) \,=\, \mathbb{E}(X^2) - \mathbb{E}(X)^2 \,=\, \big( G_X''(1^-) + G_X'(1^-) \big) - G_X'(1^-)^2 \,=\, G_X''(1^-) + G_X'(1^-) - G_X'(1^-)^2. $$
Exemple — Géométrique : \(\mathbb{E}\) et \(\mathrm{V}\) à partir de \(G_X\)
Pour \(X \sim \mathcal{G}(p)\) avec \(0 < p < 1\), \(G_X(t) = pt/(1 - qt)\) où \(q = 1 - p\). $$ G_X'(t) \,=\, \frac{p(1 - qt) - pt(-q)}{(1 - qt)^2} \,=\, \frac{p}{(1 - qt)^2}, \qquad G_X'(1) \,=\, \frac{p}{p^2} \,=\, \frac{1}{p} \,=\, \mathbb{E}(X) \checkmark $$ $$ G_X''(t) \,=\, \frac{2pq}{(1 - qt)^3}, \qquad G_X''(1) \,=\, \frac{2pq}{p^3} \,=\, \frac{2q}{p^2} $$ $$ \mathrm{V}(X) \,=\, G_X''(1) + G_X'(1) - G_X'(1)^2 \,=\, \frac{2q}{p^2} + \frac{1}{p} - \frac{1}{p^2} \,=\, \frac{2q + p - 1}{p^2} \,=\, \frac{q}{p^2} \,=\, \frac{1 - p}{p^2} \checkmark $$ Mêmes réponses qu'aux sous-section 1.5 et sous-section 2.2, calculées sans sommer de séries. Exemple — Poisson : \(\mathbb{E}\) et \(\mathrm{V}\) à partir de \(G_X\)
Pour \(X \sim \mathcal{P}(\lambda)\), \(G_X(t) = \mathrm{e}^{\lambda(t - 1)}\). $$ G_X'(t) \,=\, \lambda \mathrm{e}^{\lambda(t - 1)}, \qquad G_X'(1) \,=\, \lambda \,=\, \mathbb{E}(X) \checkmark $$ $$ G_X''(t) \,=\, \lambda^2 \mathrm{e}^{\lambda(t - 1)}, \qquad G_X''(1) \,=\, \lambda^2 $$ $$ \mathrm{V}(X) \,=\, G_X''(1) + G_X'(1) - G_X'(1)^2 \,=\, \lambda^2 + \lambda - \lambda^2 \,=\, \lambda \checkmark $$ L'identité « \(\mathbb{E} = \mathrm{V}\) » de la loi de Poisson tombe en deux lignes. Méthode — Calculer \(\mathbb{E}(X)\) et \(\mathrm{V}(X)\) via \(G_X\)
Quatre étapes. - Calculer \(G_X(t)\). Utiliser la table du sous-section 3.4 pour les lois usuelles, ou dériver directement à partir de la définition \(\sum_n \mathbb{P}(X = n) t^n\).
- Calculer \(G_X'(t)\) et \(G_X''(t)\). Appliquer les règles usuelles de dérivation sur la forme close de \(G_X\).
- Évaluer la limite à gauche en \(t = 1\). Lire \(\mathbb{E}(X) = G_X'(1^-)\) et \(\mathbb{E}(X(X-1)) = G_X''(1^-)\). Pour les lois de rayon \(R > 1\) (Bernoulli, binomiale, uniforme, Poisson, ou toute géométrique avec \(0 < p < 1\) puisque alors \(R = 1/q > 1\)), \(G_X\) se prolonge en \(\mathcal{C}^\infty\) à un voisinage de \(1\), donc \(G_X'(1^-) = G_X'(1)\) et \(G_X''(1^-) = G_X''(1)\) comme dérivées ordinaires.
- Combiner. \(\mathrm{V}(X) = G_X''(1^-) + G_X'(1^-) - G_X'(1^-)^2\). Particulièrement efficace pour \(\mathcal{G}(p)\) et \(\mathcal{P}(\lambda)\) où la fonction génératrice admet une forme close compacte (évite les astuces de séries des sous-section 1.5 et sous-section 2.2).
Compétences à pratiquer
- Calculer \(\mathbb{E}\) et \(\mathrm{V}\) via \(G_X\)
III.4
Fonctions génératrices des lois usuelles
Le catalogue que tout étudiant doit connaître par cœur. Chaque fonction génératrice est dérivée une fois via la définition ou via les développements usuels de MP Séries entières sous-section 4.2.
Théorème — Fonctions génératrices des lois usuelles
Soit \(X\) de l'une des lois MP usuelles sur \(\mathbb{N}\). Alors : - \(\mathcal{B}(p)\) : \(G_X(t) = (1-p) + p t\), \(R = +\infty\) (polynôme).
- \(\mathcal{B}(n \virgule p)\) : \(G_X(t) = ((1-p) + p t)^n\), \(R = +\infty\) (polynôme de degré \(n\)).
- \(\mathcal{U}(\{1 \virgule \dots \virgule n\})\) : \(G_X(t) = (t - t^{n+1})/(n(1 - t)) = (t + t^2 + \dots + t^n)/n\), \(R = +\infty\) (polynôme après simplification).
- \(\mathcal{G}(p)\) avec \(0 < p < 1\) : \(G_X(t) = p t/(1 - q t)\) pour \(|t| < 1/q\), \(R = 1/q\).
- \(\mathcal{P}(\lambda)\) : \(G_X(t) = \mathrm{e}^{\lambda (t - 1)}\), \(R = +\infty\).
Calculs directs en utilisant la définition \(G_X(t) = \sum_n \mathbb{P}(X = n) t^n\) et les développements usuels de MP Séries entières sous-section 4.2.
- Bernoulli. \(G_X(t) = \mathbb{P}(X = 0) + \mathbb{P}(X = 1) t = (1 - p) + p t\).
- Binomiale. Par la formule du binôme, \(G_X(t) = \sum_{k = 0}^n \binom{n}{k} p^k (1-p)^{n-k} t^k = ((1-p) + pt)^n\). (Alternative : utiliser la formule du produit sur la décomposition i.i.d.\ \(\mathcal{B}(n \virgule p) = \sum_{i=1}^n \mathcal{B}(p)\), prendre la puissance \(n\)-ième de \(G_{\mathcal{B}(p)}(t) = (1-p) + pt\).)
- Uniforme. \(G_X(t) = (1/n) \sum_{k=1}^n t^k = (1/n) \cdot t (1 - t^n)/(1 - t) = (t - t^{n+1})/(n(1 - t))\) pour \(t \ne 1\) (et la valeur en \(t = 1\) se prolonge à \(1\) par continuité, ce qui coïncide avec \(\mathbb{P}(\Omega) = 1\)).
- Géométrique. \(G_X(t) = \sum_{n \ge 1} p (1-p)^{n-1} t^n = p t \sum_{n \ge 0} (qt)^n = p t/(1 - qt)\) pour \(|qt| < 1\), soit \(|t| < 1/q\), donc \(R = 1/q\).
- Poisson. \(G_X(t) = \sum_{n \ge 0} \mathrm{e}^{-\lambda} (\lambda^n/n!) t^n = \mathrm{e}^{-\lambda} \sum_{n \ge 0} (\lambda t)^n/n! = \mathrm{e}^{-\lambda} \mathrm{e}^{\lambda t} = \mathrm{e}^{\lambda(t - 1)}\) pour tout \(t \in \mathbb{R}\).
Table de synthèse — fonctions génératrices des lois usuelles
| Loi | Notation | \(G_X(t)\) | \(R\) | \(\mathbb{E}(X)\) | \(\mathrm{V}(X)\) |
| Bernoulli | \(\mathcal{B}(p)\) | \((1-p) + p t\) | \(+\infty\) | \(p\) | \(p(1-p)\) |
| Binomiale | \(\mathcal{B}(n \virgule p)\) | \(((1-p) + p t)^n\) | \(+\infty\) | \(np\) | \(np(1-p)\) |
| Uniforme | \(\mathcal{U}(\{1 \virgule \dots \virgule n\})\) | \((t - t^{n+1})/(n(1-t))\) | \(+\infty\) | \((n+1)/2\) | \((n^2-1)/12\) |
| Géométrique | \(\mathcal{G}(p)\) (\(0| \(p t/(1 - q t)\) | \(1/q\) | \(1/p\) | \(q/p^2\) | |
| Poisson | \(\mathcal{P}(\lambda)\) (\(\lambda>0\)) | \(\mathrm{e}^{\lambda(t-1)}\) | \(+\infty\) | \(\lambda\) | \(\lambda\) |
Pour aller plus loin
Le programme PC s'arrête ici. Les extensions MP (cadres plus abstraits, modes de convergence supplémentaires, espérance conditionnelle) sont signalées mais non exigibles au niveau PC.
Compétences à pratiquer
- Reconnaître une loi à partir de sa fonction génératrice
IV
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section