Éducation Nationale Française · MPI
Variables aléatoires discrètes
Un espace probabilisé est désormais en place : le chapitre Espaces probabilisés a construit le triplet \((\Omega, \mathcal{A}, \mathbb{P})\) — un univers de résultats, une tribu d'événements, une probabilité avec sa \(\sigma\)-additivité. Ce chapitre étudie les objets qui lisent un nombre sur chaque résultat : les variables aléatoires. Le chapitre de MPSI Variables aléatoires sur un univers fini les a traitées lorsque \(\Omega\) est fini ; on franchit ici l'unique pas décisif — une variable aléatoire discrète, dont la liste de valeurs est finie ou dénombrable.
Le chapitre a trois sections. La première définit la variable aléatoire discrète et sa loi : la loi oublie l'espace sous-jacent et ne garde que les probabilités \(\mathbb{P}(X = x)\). La deuxième étudie comment plusieurs variables aléatoires se côtoient — couples, lois marginales, puis indépendance, lemme des coalitions et suites i.i.d. La troisième introduit les deux lois infinies que le programme distingue : la loi géométrique, temps d'attente d'un premier succès, et la loi de Poisson, loi des événements rares.
Notations permanentes. \((\Omega, \mathcal{A}, \mathbb{P})\) est un espace probabilisé, fixé dans tout le chapitre — sauf là où un résultat construit explicitement un autre espace probabilisé. \(X, Y\) désignent des variables aléatoires ; \(X(\Omega)\) est l'ensemble (au plus dénombrable) des valeurs ; \(\{X = x\}\) est l'événement « \(X\) prend la valeur \(x\) », de probabilité \(\mathbb{P}(X = x)\). On note \(\bigsqcup\) une réunion disjointe, \(q = 1 - p\), \(\mathbf{1}_A\) l'indicatrice d'un événement \(A\). Les notions d'espace probabilisé, de tribu, de \(\sigma\)-additivité, de système complet d'événements, de probabilité conditionnelle et d'indépendance d'événements sont celles d'Espaces probabilisés ; la variable aléatoire finie, sa loi et les lois finies usuelles sont celles de Variables aléatoires sur un univers fini.
I
Variables aléatoires discrètes et leur loi
I.1
Variables aléatoires discrètes
Dans Variables aléatoires sur un univers fini, une variable aléatoire était une application \(X : \Omega \to E\) depuis un univers fini ; toute partie de \(\Omega\) était un événement, donc aucune question de mesurabilité ne se posait. Ici \(\Omega\) est un espace probabilisé général, et le pas franchi est double : l'image \(X(\Omega)\) est autorisée à être dénombrable, et il faut exiger que chaque \(\{X = x\}\) soit bien un événement.
Définition — Variable aléatoire discrète
Soit \(E\) un ensemble non vide. Une variable aléatoire discrète sur \((\Omega, \mathcal{A}, \mathbb{P})\) à valeurs dans \(E\) est une application \(X : \Omega \to E\) telle que l'image \(X(\Omega)\) est au plus dénombrable (finie ou dénombrable) et que, pour tout \(x \in X(\Omega)\), l'ensemble \(X^{-1}(\{x\})\) appartient à \(\mathcal{A}\). Cet ensemble est l'événement noté \(\{X = x\}\).
Pour une partie \(A \subset E\), \(\{X \in A\} = X^{-1}(A)\) est encore un événement, et \(\mathbb{P}(X = x)\) désigne la probabilité de \(\{X = x\}\). Le plus souvent \(E\) est un ensemble de nombres (\(E \subset \mathbb{R}\), fréquemment \(E = \mathbb{N}\)) : les comparaisons comme \(\{X > k\}\) et les sommes de variables aléatoires utilisées plus loin ont alors un sens.
Ce cours ne traite que des variables aléatoires discrètes. Les « variables à densité », dont les valeurs remplissent tout un intervalle, sont hors du programme de MP.
Ce cours ne traite que des variables aléatoires discrètes. Les « variables à densité », dont les valeurs remplissent tout un intervalle, sont hors du programme de MP.
Exemple — Une variable aléatoire finie
On lance un dé ; \(\Omega = \{1, \dots, 6\}\). L'application \(X\) envoyant un lancer sur \(0\) s'il est pair et sur \(1\) s'il est impair est une variable aléatoire discrète : \(X(\Omega) = \{0, 1\}\) est fini. Toute variable aléatoire finie de Variables aléatoires sur un univers fini est une variable aléatoire discrète — le cas fini est inclus. Exemple — Une image dénombrable
Sur l'espace probabilisé discret \((\mathbb{N}^*, \mathcal{P}(\mathbb{N}^*), \mathbb{P})\) avec \(\mathbb{P}(\{k\}) = 2^{-k}\) — une probabilité car \(\sum_{k \geq 1} 2^{-k} = 1\) — prenons \(X = \operatorname{id}_{\mathbb{N}^*}\). Alors \(X\) est une variable aléatoire discrète d'image \(X(\Omega) = \mathbb{N}^*\), dénombrable, et \(\mathbb{P}(X = k) = 2^{-k}\). L'image est véritablement infinie : aucun modèle fini ne la produit. Exemple — Indicatrice, et le cas d'un univers discret
L'indicatrice \(\mathbf{1}_A\) d'un événement \(A\) — égale à \(1\) sur \(A\), à \(0\) ailleurs — est une variable aléatoire discrète : \(X(\Omega) \subset \{0, 1\}\), et \(\{\mathbf{1}_A = 1\} = A\), \(\{\mathbf{1}_A = 0\} = \overline{A}\) sont des événements. Plus généralement, lorsque \(\Omega\) est au plus dénombrable et \(\mathcal{A} = \mathcal{P}(\Omega)\), toute application \(X : \Omega \to E\) est une variable aléatoire discrète : \(X(\Omega)\) est l'image d'un ensemble au plus dénombrable, donc au plus dénombrable, et tout \(X^{-1}(\{x\})\) appartient à \(\mathcal{P}(\Omega) = \mathcal{A}\). Proposition — L'événement \(\{X \in A\}\)
Soit \(X\) une variable aléatoire discrète à valeurs dans \(E\). Pour toute partie \(A \subset E\), l'ensemble \(\{X \in A\}\) est un événement.
Une valeur de \(X\) prise dans \(A\) est une valeur prise dans \(A \cap X(\Omega)\), donc $$ \{X \in A\} = \bigcup_{x \in A \cap X(\Omega)} \{X = x\}. $$ L'ensemble d'indices \(A \cap X(\Omega)\) est une partie de l'ensemble au plus dénombrable \(X(\Omega)\), donc au plus dénombrable ; chaque \(\{X = x\}\) est un événement par la définition d'une variable aléatoire discrète. Une tribu est stable par réunion au plus dénombrable, donc \(\{X \in A\}\) est un événement.
Proposition — Le système complet associé à \(X\)
Soit \(X\) une variable aléatoire discrète. La famille \((\{X = x\})_{x \in X(\Omega)}\) est un système complet d'événements : ses membres sont deux à deux incompatibles et leur réunion vaut \(\Omega\).
Chaque \(\{X = x\}\) est un événement, et l'ensemble d'indices \(X(\Omega)\) est au plus dénombrable. Pour \(x \neq x'\), un résultat \(\omega\) ne peut vérifier à la fois \(X(\omega) = x\) et \(X(\omega) = x'\), donc \(\{X = x\} \cap \{X = x'\} = \varnothing\) : les événements sont deux à deux incompatibles. Enfin tout \(\omega \in \Omega\) a une valeur \(X(\omega) \in X(\Omega)\), donc \(\omega \in \{X = X(\omega)\}\) ; ainsi \(\bigsqcup_{x \in X(\Omega)} \{X = x\} = \Omega\).
Proposition — Image d'une variable aléatoire par une fonction
Soit \(X\) une variable aléatoire discrète à valeurs dans \(E\), et soit \(f\) une application définie sur \(X(\Omega)\). Alors \(f(X) = f \circ X\) est une variable aléatoire discrète.
L'image \(f(X)(\Omega) = f(X(\Omega))\) est l'image d'un ensemble au plus dénombrable, donc au plus dénombrable. Pour une valeur \(y\), \(\{f(X) = y\} = \{X \in f^{-1}(\{y\})\}\), qui est un événement par la Proposition précédente. Donc \(f(X)\) vérifie les deux conditions de la définition.
Méthode — Décrire une variable aléatoire discrète
Pour manier une variable aléatoire discrète, deux données suffisent : son image \(X(\Omega)\) — la liste des valeurs possibles — et, pour chaque \(x \in X(\Omega)\), l'événement \(\{X = x\}\) décrit en termes de l'expérience. La probabilité \(\mathbb{P}(X = x)\) se calcule alors événement par événement. Pour vérifier qu'une application est une variable aléatoire discrète, vérifier les deux conditions : une image au plus dénombrable, et chaque \(\{X = x\}\) un événement.
Les événements \(\{X = x\}\) pavent l'univers : chaque résultat tombe dans exactement l'un d'eux. La figure montre cette partition. 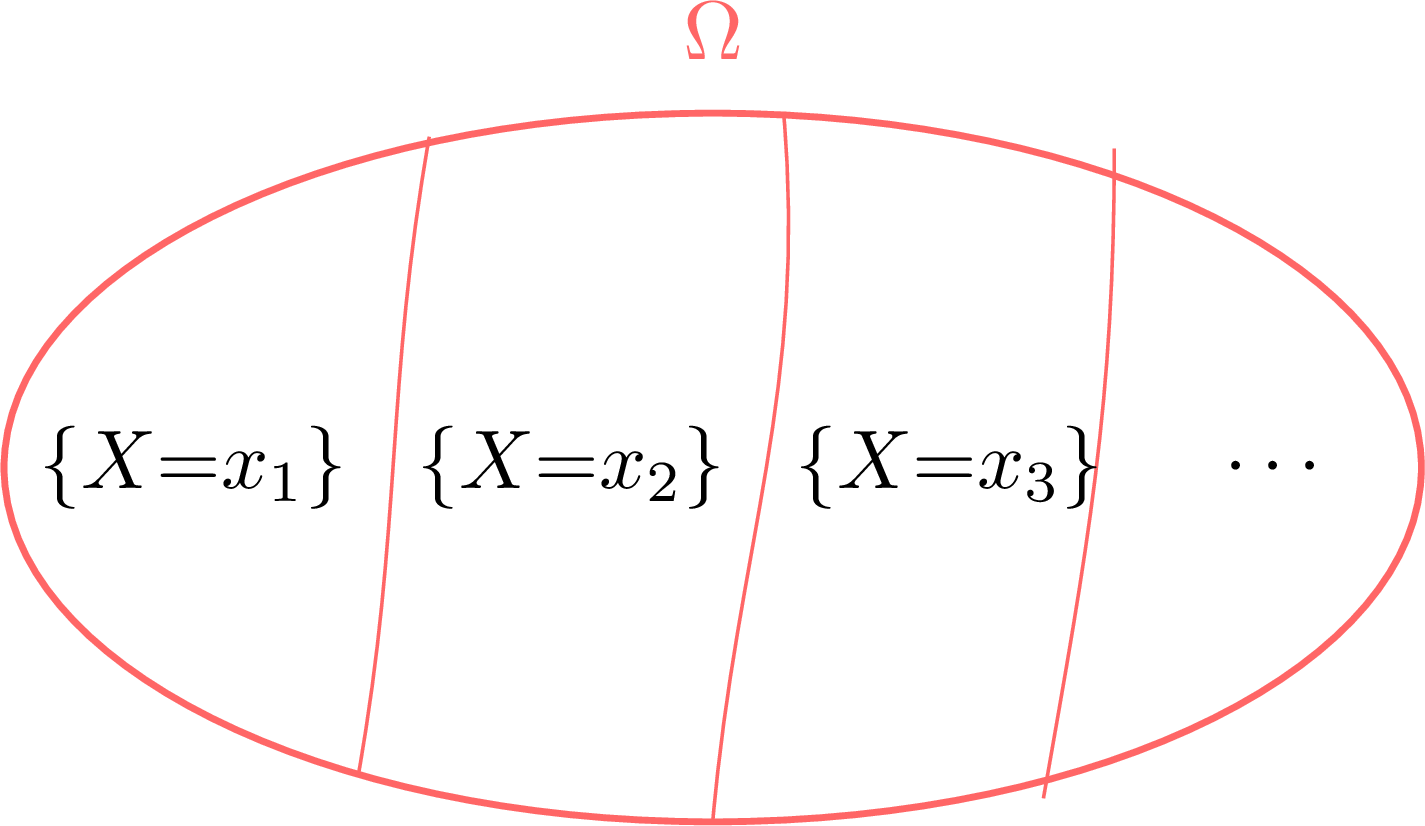
Tout résultat \(\omega\) est dans exactement une case \(\{X = x\}\), celle pour laquelle \(x = X(\omega)\).
Compétences à pratiquer
- Identifier une variable aléatoire discrète
I.2
La loi d'une variable aléatoire discrète
Deux expériences peuvent être modélisées sur des espaces probabilisés très différents et pourtant faire se comporter une variable aléatoire exactement de la même manière. Ce qui est commun est saisi par la loi : elle oublie \(\Omega\) et ne garde que les probabilités \(\mathbb{P}(X = x)\).
Définition — Loi d'une variable aléatoire discrète
Soit \(X\) une variable aléatoire discrète à valeurs dans \(E\). La loi de \(X\), notée \(\mathbb{P}_X\), est l'application \(A \mapsto \mathbb{P}(X \in A)\) définie sur les parties de \(E\). La famille \((\mathbb{P}(X = x))_{x \in X(\Omega)}\) est la distribution de \(X\), et le support de \(X\) est \(\{x \in X(\Omega) : \mathbb{P}(X = x) > 0\}\). Théorème — La loi est une probabilité
La loi \(\mathbb{P}_X\) est une probabilité sur \((E, \mathcal{P}(E))\), donnant la masse \(0\) à toute partie disjointe de \(X(\Omega)\). Elle est entièrement déterminée par la distribution : pour tout \(A \subset E\), $$ \textcolor{colorprop}{\mathbb{P}_X(A) = \sum_{x \in A \cap X(\Omega)} \mathbb{P}(X = x).} $$
Pour \(A \subset E\), la décomposition \(\{X \in A\} = \bigsqcup_{x \in A \cap X(\Omega)}\{X = x\}\) est une réunion disjointe sur un ensemble d'indices au plus dénombrable, donc la \(\sigma\)-additivité donne \(\mathbb{P}_X(A) = \sum_{x \in A \cap X(\Omega)} \mathbb{P}(X = x)\). En particulier \(\mathbb{P}_X(A) = 0\) lorsque \(A \cap X(\Omega) = \varnothing\), et \(\mathbb{P}_X(E) = \sum_{x \in X(\Omega)} \mathbb{P}(X = x) = \mathbb{P}(\Omega) = 1\).
\(\mathbb{P}_X\) est une probabilité sur \((E, \mathcal{P}(E))\) : elle est à valeurs dans \([0,1]\), \(\mathbb{P}_X(E) = 1\), et pour une suite \((A_n)\) de parties deux à deux disjointes, \(\{X \in \bigsqcup A_n\} = \bigsqcup\{X \in A_n\}\), donc \(\mathbb{P}_X(\bigsqcup A_n) = \sum \mathbb{P}_X(A_n)\) par la \(\sigma\)-additivité de \(\mathbb{P}\). Comme \(\mathbb{P}_X(A)\) est, par la formule encadrée, une somme des \(\mathbb{P}(X = x)\), la loi est déterminée par la distribution.
\(\mathbb{P}_X\) est une probabilité sur \((E, \mathcal{P}(E))\) : elle est à valeurs dans \([0,1]\), \(\mathbb{P}_X(E) = 1\), et pour une suite \((A_n)\) de parties deux à deux disjointes, \(\{X \in \bigsqcup A_n\} = \bigsqcup\{X \in A_n\}\), donc \(\mathbb{P}_X(\bigsqcup A_n) = \sum \mathbb{P}_X(A_n)\) par la \(\sigma\)-additivité de \(\mathbb{P}\). Comme \(\mathbb{P}_X(A)\) est, par la formule encadrée, une somme des \(\mathbb{P}(X = x)\), la loi est déterminée par la distribution.
Exemple — Lire une loi sur un modèle
On lance deux fois une pièce équilibrée ; \(X\) compte les piles. Alors \(X(\Omega) = \{0, 1, 2\}\) et, les quatre résultats étant équiprobables, \(\mathbb{P}(X = 0) = \tfrac14\), \(\mathbb{P}(X = 1) = \tfrac12\), \(\mathbb{P}(X = 2) = \tfrac14\). La loi de \(X\) est cette distribution ; c'est la loi binomiale \(\mathcal{B}(2, \tfrac12)\) rappelée de Variables aléatoires sur un univers fini. Définition — Égalité en loi
Deux variables aléatoires discrètes \(X\) et \(Y\), éventuellement définies sur des espaces probabilisés différents mais à valeurs dans le même ensemble \(E\), suivent la même loi, ce qu'on note \(X \sim Y\), lorsque \(\mathbb{P}(X = x) = \mathbb{P}(Y = x)\) pour tout \(x \in E\) — avec la convention \(\mathbb{P}(X = x) = 0\) pour \(x \notin X(\Omega)\), l'événement \(\{X = x\}\) étant alors vide. On note \(X \sim \mathcal{L}\) pour « \(X\) suit la loi \(\mathcal{L}\) ». Exemple — Même loi, et pourtant non égales
On lance \(n \geq 1\) fois une pièce équilibrée. Soit \(X\) le nombre de piles et \(Y\) le nombre de faces. Par la symétrie pile \(\leftrightarrow\) face, \(X\) et \(Y\) suivent la même loi, \(\mathcal{B}(n, \tfrac12)\). Pourtant \(X\) et \(Y\) ne sont pas égales en tant que variables aléatoires : sur le résultat « que des piles », \(X = n\) alors que \(Y = 0\). Même loi ne signifie pas même variable aléatoire. Théorème — Une variable aléatoire pour une distribution donnée
Soit \(E\) un ensemble au plus dénombrable et \((p_x)_{x \in E}\) une famille de réels avec \(p_x \geq 0\) et \(\sum_{x \in E} p_x = 1\). Alors il existe un espace probabilisé et une variable aléatoire discrète sur celui-ci dont la distribution est \((p_x)\).
Par la correspondance distribution discrète–probabilité rappelée d'Espaces probabilisés, la famille \((p_x)\) définit une probabilité \(\mathbb{P}\) sur l'espace probabilisable \((E, \mathcal{P}(E))\) par \(\mathbb{P}(A) = \sum_{x \in A} p_x\). Sur cet espace l'application identité \(X = \operatorname{id}_E\) est une variable aléatoire discrète : \(X(E) = E\) est au plus dénombrable, et tout \(X^{-1}(\{x\}) = \{x\}\) appartient à \(\mathcal{P}(E)\). Sa distribution est \(\mathbb{P}(X = x) = \mathbb{P}(\{x\}) = p_x\).
Méthode — Déterminer la loi d'une variable aléatoire discrète
Procéder en deux temps. D'abord décrire l'image \(X(\Omega)\). Puis, pour chaque \(x \in X(\Omega)\), calculer \(\mathbb{P}(X = x)\) — par dénombrement de résultats équiprobables, par conditionnement, ou en décomposant \(\{X = x\}\) sur un système complet. Une vérification qu'aucune probabilité n'est perdue : \(\sum_{x \in X(\Omega)} \mathbb{P}(X = x)\) doit valoir \(1\).
Une distribution discrète se représente par un diagramme en bâtons : un bâton de hauteur \(\mathbb{P}(X = x)\) au-dessus de chaque valeur \(x\). 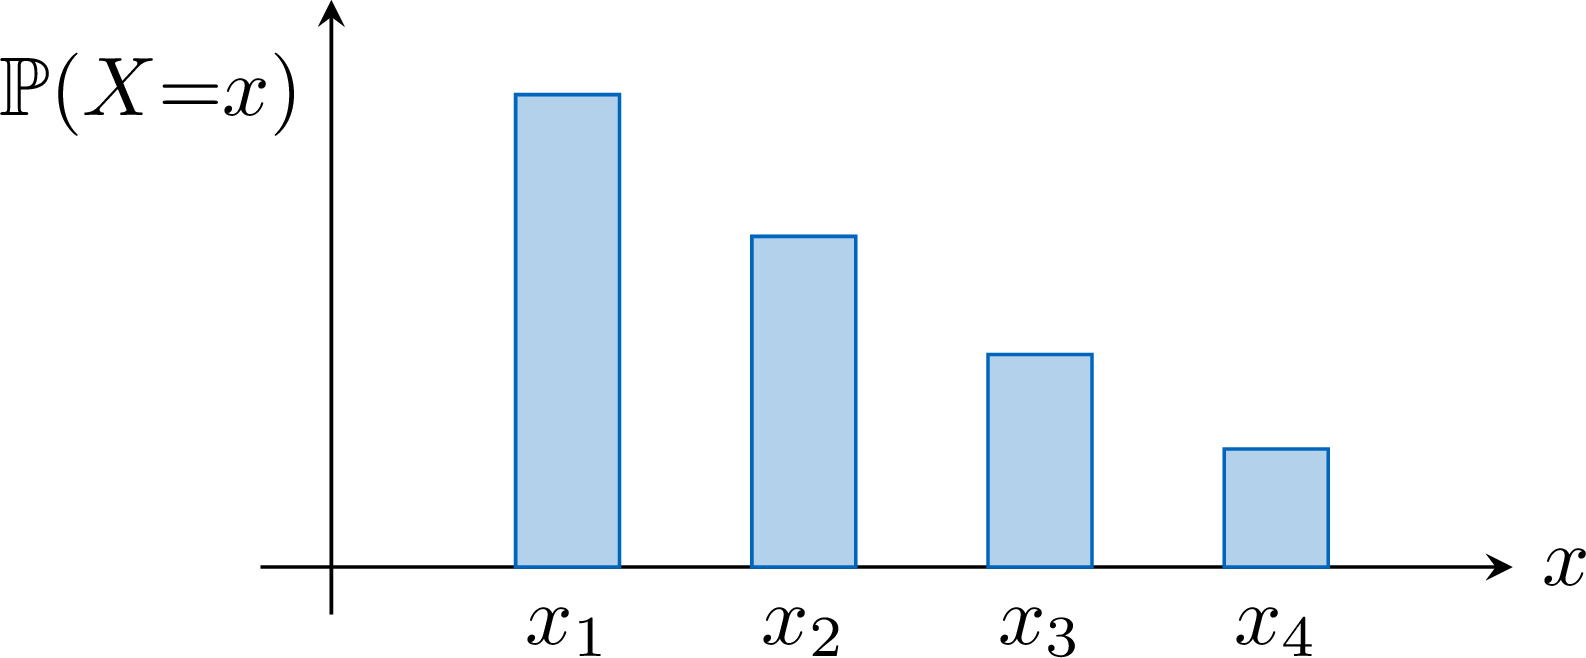
Les hauteurs des bâtons sont positives et de somme \(1\).
Compétences à pratiquer
- Calculer la loi d'une variable aléatoire
I.3
Couples de variables aléatoires et lois marginales
Deux variables aléatoires sur le même espace peuvent être regardées ensemble. La loi conjointe voit le couple \((X, Y)\) comme un seul objet ; les lois marginales voient \(X\) et \(Y\) chacune seule ; la loi conditionnelle fixe une valeur de \(Y\) et observe \(X\).
Définition — Couple, lois conjointe, marginales et conditionnelle
Soient \(X\) et \(Y\) des variables aléatoires discrètes sur \((\Omega, \mathcal{A}, \mathbb{P})\). Le couple est l'application \((X, Y) : \omega \mapsto (X(\omega), Y(\omega))\) — une variable aléatoire discrète, comme le montre la Proposition ci-dessous. Sa loi est la loi conjointe, déterminée par la famille \((\mathbb{P}(X = x, Y = y))\) où \(\{X = x, Y = y\} = \{X = x\} \cap \{Y = y\}\). Les lois de \(X\) et de \(Y\) sont alors les lois marginales du couple. Pour \(y\) tel que \(\mathbb{P}(Y = y) > 0\), la loi conditionnelle de \(X\) sachant \(\{Y = y\}\) est l'application \(x \in X(\Omega) \mapsto \mathbb{P}(X = x \mid Y = y)\), elle-même une distribution de probabilités sur \(X(\Omega)\). Ces notions relèvent au cas discret les notions correspondantes du cas fini de Variables aléatoires sur un univers fini. Proposition — Le couple est une variable aléatoire discrète
Le couple \((X, Y)\) est une variable aléatoire discrète à valeurs dans \(E \times F\) (\(X\) étant à valeurs dans \(E\), \(Y\) dans \(F\)) ; plus généralement tout \(n\)-uplet \((X_1, \dots, X_n)\), et tout \(f(X_1, \dots, X_n)\) avec \(f\) définie sur l'image du \(n\)-uplet, en est une. La famille \((\{X = x\} \cap \{Y = y\})_{(x,y) \in (X,Y)(\Omega)}\) est un système complet d'événements.
L'image \((X, Y)(\Omega)\) est contenue dans \(X(\Omega) \times Y(\Omega)\), produit de deux ensembles au plus dénombrables, donc au plus dénombrable. Pour une valeur \((x, y)\), \(\{(X, Y) = (x, y)\} = \{X = x\} \cap \{Y = y\}\) est une intersection de deux événements, donc un événement. Donc \((X, Y)\) est une variable aléatoire discrète. Les deux mêmes arguments — une image au plus dénombrable, chaque ensemble de niveau un événement — s'appliquent à un \(n\)-uplet \((X_1, \dots, X_n)\), et alors \(f(X_1, \dots, X_n)\) est une variable aléatoire discrète par la Proposition « image par une fonction ». Enfin, \((X, Y)\) étant une variable aléatoire discrète, la famille de ses ensembles de niveau est un système complet d'événements.
Théorème — Loi marginale à partir de la loi conjointe
Pour tout \(x \in X(\Omega)\), $$ \textcolor{colorprop}{\mathbb{P}(X = x) = \sum_{y \in Y(\Omega)} \mathbb{P}(X = x, Y = y).} $$ La loi conjointe détermine ainsi les deux marginales.
La famille \((\{Y = y\})_{y \in Y(\Omega)}\) est un système complet d'événements. La formule des probabilités totales (Espaces probabilisés), appliquée à l'événement \(\{X = x\}\) sur ce système complet, donne $$ \mathbb{P}(X = x) = \sum_{y \in Y(\Omega)} \mathbb{P}(\{X = x\} \cap \{Y = y\}) = \sum_{y \in Y(\Omega)} \mathbb{P}(X = x, Y = y). $$
Exemple — Un tableau conjoint et ses marginales
Soit \((X, Y)\) de loi conjointe donnée par le tableau (lignes \(x \in \{0,1\}\), colonnes \(y \in \{0,1\}\)) : $$ \begin{array}{c|cc} & y=0 & y=1 \\
\hline x=0 & 0{,}1 & 0{,}3 \\
x=1 & 0{,}4 & 0{,}2 \end{array} $$ En sommant chaque ligne : \(\mathbb{P}(X = 0) = 0{,}1 + 0{,}3 = 0{,}4\), \(\mathbb{P}(X = 1) = 0{,}4 + 0{,}2 = 0{,}6\). En sommant chaque colonne : \(\mathbb{P}(Y = 0) = 0{,}5\), \(\mathbb{P}(Y = 1) = 0{,}5\). Exemple — Les marginales ne déterminent pas la loi conjointe
Les deux lois conjointes $$ \begin{array}{c|cc} & y=0 & y=1 \\
\hline x=0 & 0{,}25 & 0{,}25 \\
x=1 & 0{,}25 & 0{,}25 \end{array} \qquad \begin{array}{c|cc} & y=0 & y=1 \\
\hline x=0 & 0{,}5 & 0 \\
x=1 & 0 & 0{,}5 \end{array} $$ ont les mêmes marginales — \(\mathbb{P}(X = 0) = \mathbb{P}(X = 1) = \tfrac12\) et de même pour \(Y\) — et pourtant ce sont des lois conjointes différentes. Les marginales seules ne permettent pas de retrouver la loi conjointe. Exemple — Une loi conditionnelle
Sur le premier tableau de l'Exemple « tableau conjoint », la loi conditionnelle de \(X\) sachant \(\{Y = 0\}\) se lit sur la colonne \(y = 0\) et se renormalise par \(\mathbb{P}(Y = 0) = 0{,}5\) : $$ \mathbb{P}(X = 0 \mid Y = 0) = \frac{0{,}1}{0{,}5} = 0{,}2, \qquad \mathbb{P}(X = 1 \mid Y = 0) = \frac{0{,}4}{0{,}5} = 0{,}8. $$ Ces deux nombres ont pour somme \(1\) : la loi conditionnelle est elle-même une probabilité sur \(X(\Omega)\). Méthode — Manier une distribution conjointe
Disposer la distribution conjointe en tableau, une case \(\mathbb{P}(X = x, Y = y)\) par couple. Une marginale s'obtient en sommant toute une ligne (pour \(X\)) ou toute une colonne (pour \(Y\)) — une somme qui est une série lorsque les images sont infinies. Une loi conditionnelle de \(X\) sachant \(\{Y = y\}\), définie lorsque \(\mathbb{P}(Y = y) > 0\), est la colonne \(y\) divisée par sa somme \(\mathbb{P}(Y = y)\). Toujours vérifier que le tableau entier somme à \(1\).
La distribution conjointe est un tableau ; les marginales en sont les sommes de lignes et de colonnes. 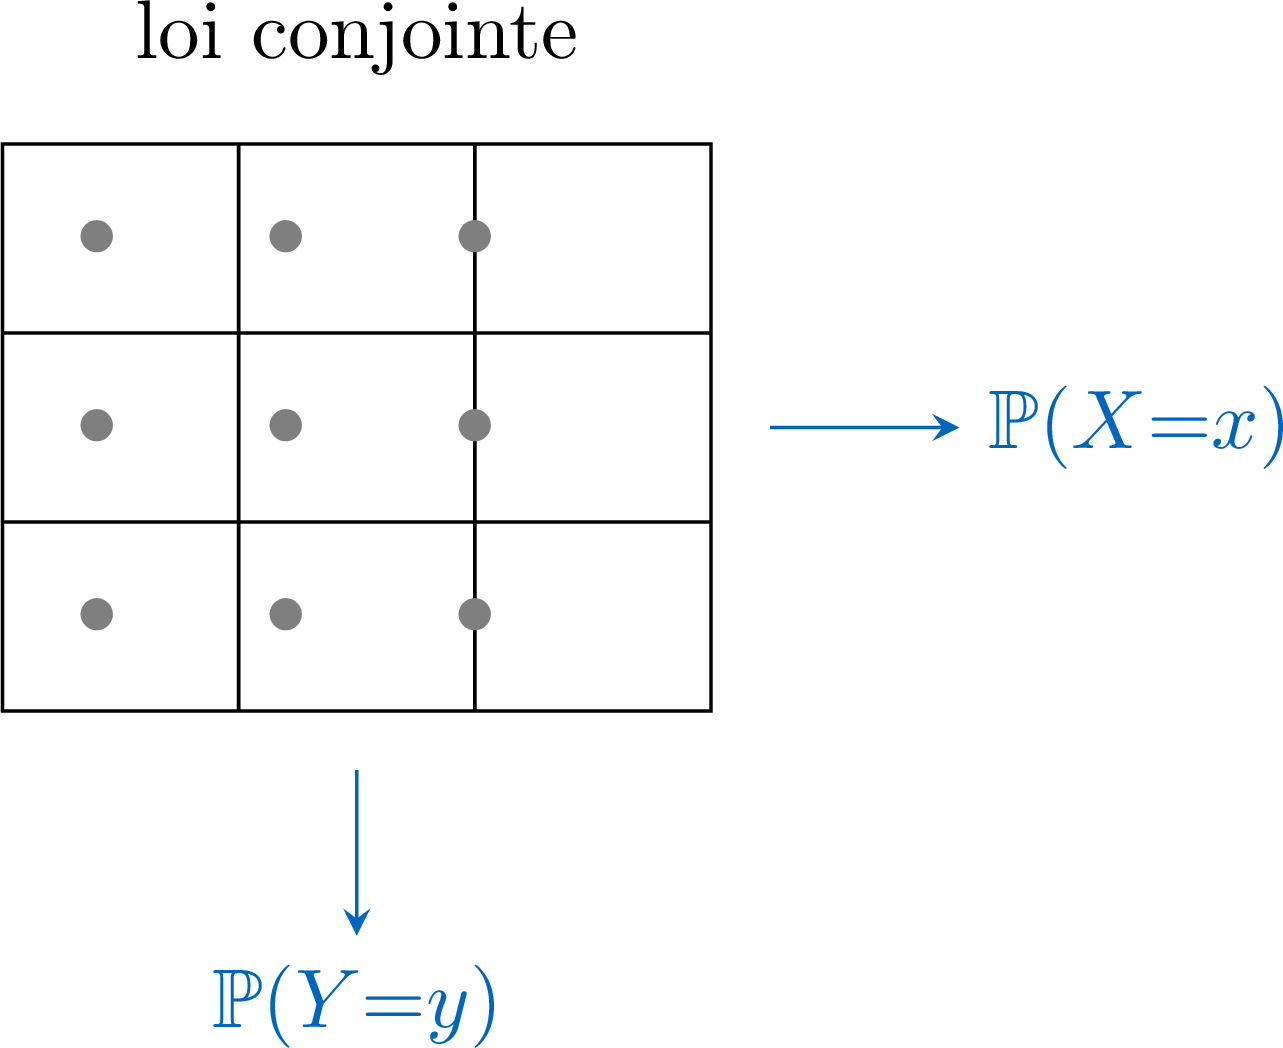
Chaque \(\bullet\) est une probabilité conjointe \(\mathbb{P}(X = x, Y = y)\) ; une somme de ligne est une marginale de \(X\), une somme de colonne une marginale de \(Y\).
Compétences à pratiquer
- Calculer lois conjointe et marginales
II
Variables aléatoires indépendantes
II.1
Indépendance de deux variables aléatoires
Le chapitre Espaces probabilisés a appelé deux événements \(A, B\) indépendants lorsque \(\mathbb{P}(A \cap B) = \mathbb{P}(A)\,\mathbb{P}(B)\). Deux variables aléatoires sont indépendantes lorsque cela vaut pour tout couple d'événements qu'elles décrivent : connaître la valeur de l'une ne dit rien de l'autre.
Définition — Indépendance de deux variables aléatoires
Les variables aléatoires discrètes \(X\) et \(Y\) sont indépendantes, ce qu'on note \(X \perp Y\), lorsque pour toutes parties \(A \subset X(\Omega)\) et \(B \subset Y(\Omega)\) les événements \(\{X \in A\}\) et \(\{Y \in B\}\) sont indépendants : $$ \mathbb{P}(X \in A,\ Y \in B) = \mathbb{P}(X \in A)\,\mathbb{P}(Y \in B). $$ Théorème — Caractérisation de l'indépendance
\(X\) et \(Y\) sont indépendantes si et seulement si $$ \textcolor{colorprop}{\mathbb{P}(X = x,\ Y = y) = \mathbb{P}(X = x)\,\mathbb{P}(Y = y) \quad \text{pour tous } x \in X(\Omega),\ y \in Y(\Omega).} $$ Autrement dit, l'indépendance peut se vérifier sur les seules valeurs.
Si \(X \perp Y\), prendre \(A = \{x\}\) et \(B = \{y\}\) dans la définition donne aussitôt l'égalité encadrée.
Réciproquement, supposons \(\mathbb{P}(X = x, Y = y) = \mathbb{P}(X = x)\,\mathbb{P}(Y = y)\) pour tous \(x, y\), et soient \(A \subset X(\Omega)\), \(B \subset Y(\Omega)\). En décomposant \(\{X \in A, Y \in B\}\) sur les valeurs et par \(\sigma\)-additivité, $$ \mathbb{P}(X \in A,\ Y \in B) = \sum_{(x,y) \in A \times B} \mathbb{P}(X = x,\ Y = y) = \sum_{(x,y) \in A \times B} \mathbb{P}(X = x)\,\mathbb{P}(Y = y). $$ Les termes sommés sont positifs, donc la somme double se factorise en un produit de deux sommes : $$ \mathbb{P}(X \in A,\ Y \in B) = \Bigl(\sum_{x \in A} \mathbb{P}(X = x)\Bigr)\Bigl(\sum_{y \in B} \mathbb{P}(Y = y)\Bigr) = \mathbb{P}(X \in A)\,\mathbb{P}(Y \in B). $$ D'où \(X \perp Y\).
Réciproquement, supposons \(\mathbb{P}(X = x, Y = y) = \mathbb{P}(X = x)\,\mathbb{P}(Y = y)\) pour tous \(x, y\), et soient \(A \subset X(\Omega)\), \(B \subset Y(\Omega)\). En décomposant \(\{X \in A, Y \in B\}\) sur les valeurs et par \(\sigma\)-additivité, $$ \mathbb{P}(X \in A,\ Y \in B) = \sum_{(x,y) \in A \times B} \mathbb{P}(X = x,\ Y = y) = \sum_{(x,y) \in A \times B} \mathbb{P}(X = x)\,\mathbb{P}(Y = y). $$ Les termes sommés sont positifs, donc la somme double se factorise en un produit de deux sommes : $$ \mathbb{P}(X \in A,\ Y \in B) = \Bigl(\sum_{x \in A} \mathbb{P}(X = x)\Bigr)\Bigl(\sum_{y \in B} \mathbb{P}(Y = y)\Bigr) = \mathbb{P}(X \in A)\,\mathbb{P}(Y \in B). $$ D'où \(X \perp Y\).
Exemple — Un couple indépendant
On lance deux dés équilibrés, \(X\) et \(Y\) les deux résultats. Les résultats étant équiprobables, \(\mathbb{P}(X = x, Y = y) = \tfrac{1}{36}\) pour tout \((x, y)\), tandis que \(\mathbb{P}(X = x) = \mathbb{P}(Y = y) = \tfrac16\). Comme \(\tfrac{1}{36} = \tfrac16 \cdot \tfrac16\), la caractérisation donne \(X \perp Y\) : la loi conjointe est le produit des marginales. Exemple — Un couple dépendant
Sur le premier tableau de l'Exemple « tableau conjoint », \(\mathbb{P}(X = 0, Y = 0) = 0{,}1\), alors que \(\mathbb{P}(X = 0)\,\mathbb{P}(Y = 0) = 0{,}4 \times 0{,}5 = 0{,}2\). Les deux diffèrent, donc la caractérisation échoue pour \((x, y) = (0, 0)\) : \(X\) et \(Y\) ne sont pas indépendantes. Une seule valeur où la loi produit échoue suffit à écarter l'indépendance. Proposition — L'indépendance se conserve par fonctions
Si \(X \perp Y\), alors pour toutes fonctions \(f\) sur \(X(\Omega)\) et \(g\) sur \(Y(\Omega)\), les variables aléatoires \(f(X)\) et \(g(Y)\) sont indépendantes.
Soient \(A \subset f(X)(\Omega)\) et \(B \subset g(Y)(\Omega)\). Alors \(\{f(X) \in A\} = \{X \in f^{-1}(A)\}\) et \(\{g(Y) \in B\} = \{Y \in g^{-1}(B)\}\). Comme \(X \perp Y\), les événements \(\{X \in f^{-1}(A)\}\) et \(\{Y \in g^{-1}(B)\}\) sont indépendants, donc $$ \mathbb{P}(f(X) \in A,\ g(Y) \in B) = \mathbb{P}(X \in f^{-1}(A))\,\mathbb{P}(Y \in g^{-1}(B)) = \mathbb{P}(f(X) \in A)\,\mathbb{P}(g(Y) \in B). $$ D'où \(f(X) \perp g(Y)\).
Méthode — Démontrer ou réfuter l'indépendance
Pour démontrer \(X \perp Y\) : par la caractérisation, vérifier \(\mathbb{P}(X = x, Y = y) = \mathbb{P}(X = x)\,\mathbb{P}(Y = y)\) pour tout couple de valeurs — de façon équivalente, le tableau conjoint est le produit de ses marginales. Pour la réfuter, exhiber un couple \((x, y)\) où l'égalité échoue.
L'indépendance a une lecture visuelle : le tableau conjoint est la « table de multiplication » des deux marginales. 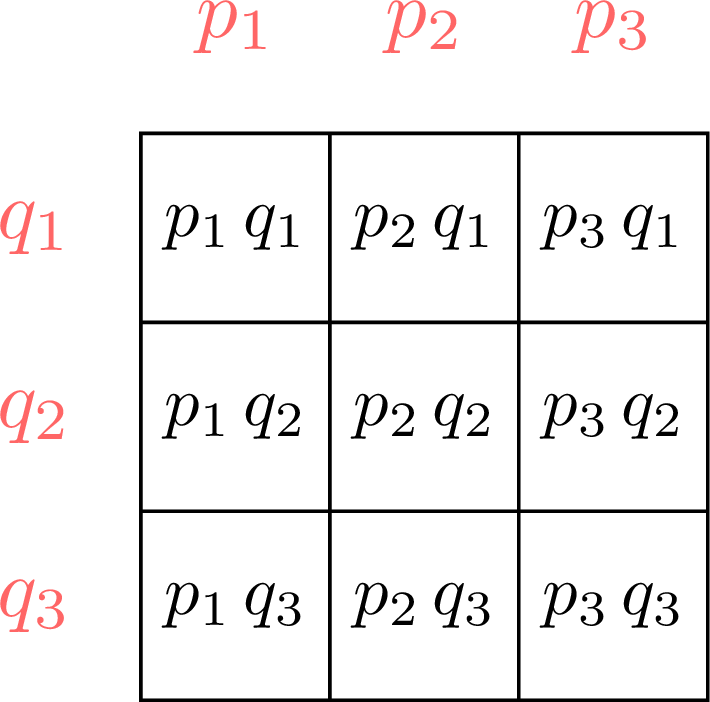
Lorsque \(X \perp Y\), la case \((x, y)\) contient \(\mathbb{P}(X = x)\,\mathbb{P}(Y = y)\) — le produit des entrées marginales.
Compétences à pratiquer
- Démontrer l'indépendance de deux variables
II.2
Indépendance mutuelle et lemme des coalitions
Pour plus de deux variables aléatoires, la bonne notion est l'indépendance mutuelle — une seule formule produit portant sur toutes les variables à la fois. Le lemme des coalitions permet alors de regrouper des paquets disjoints et de traiter chaque paquet comme une seule variable indépendante.
Définition — Indépendance mutuelle
Les variables aléatoires discrètes \(X_1, \dots, X_n\) sont mutuellement indépendantes lorsque, pour toutes parties \(A_1 \subset X_1(\Omega), \dots, A_n \subset X_n(\Omega)\), $$ \mathbb{P}(X_1 \in A_1,\ \dots,\ X_n \in A_n) = \prod_{i=1}^n \mathbb{P}(X_i \in A_i). $$ Proposition — Caractérisation sur les valeurs
\(X_1, \dots, X_n\) sont mutuellement indépendantes si et seulement si, pour tous \(x_1 \in X_1(\Omega), \dots, x_n \in X_n(\Omega)\), $$ \textcolor{colorprop}{\mathbb{P}(X_1 = x_1,\ \dots,\ X_n = x_n) = \prod_{i=1}^n \mathbb{P}(X_i = x_i).} $$
L'indépendance mutuelle avec \(A_i = \{x_i\}\) donne l'égalité encadrée. Réciproquement, supposons cette égalité pour toutes les valeurs, et fixons \(A_1, \dots, A_n\). En décomposant \(\{X_1 \in A_1, \dots, X_n \in A_n\}\) sur les valeurs et par \(\sigma\)-additivité, $$ \mathbb{P}(X_1 \in A_1, \dots, X_n \in A_n) = \sum_{x_1 \in A_1} \cdots \sum_{x_n \in A_n} \prod_{i=1}^n \mathbb{P}(X_i = x_i). $$ Les termes étant positifs, la somme multiple se factorise en \(\prod_{i=1}^n \bigl(\sum_{x_i \in A_i} \mathbb{P}(X_i = x_i)\bigr) = \prod_{i=1}^n \mathbb{P}(X_i \in A_i)\). Donc les variables sont mutuellement indépendantes.
Exemple — Deux à deux est plus faible que mutuelle
Soient \(X, Y\) des variables indépendantes, chacune uniforme sur \(\{0, 1\}\), et posons \(Z = X \oplus Y\), la parité (somme modulo \(2\)). Chacune de \(X, Y, Z\) est uniforme sur \(\{0, 1\}\), et deux quelconques des trois sont indépendantes — une courte vérification sur les quatre résultats équiprobables. Mais les trois ne sont pas mutuellement indépendantes : \(\mathbb{P}(X = 0, Y = 0, Z = 0) = \tfrac14\) (le résultat \(X = Y = 0\) force \(Z = 0\)), alors que \(\mathbb{P}(X = 0)\,\mathbb{P}(Y = 0)\,\mathbb{P}(Z = 0) = \tfrac18\). L'indépendance mutuelle est strictement plus forte que l'indépendance deux à deux. Théorème — Lemme des coalitions
Soient \(X_1, \dots, X_n\) mutuellement indépendantes, et soient \(I_1, \dots, I_r\) des parties non vides deux à deux disjointes de \(\{1, \dots, n\}\). Pour chaque \(j\), soit \(Y_j = f_j\bigl((X_i)_{i \in I_j}\bigr)\) pour une fonction \(f_j\) définie sur l'image du \(n\)-uplet \((X_i)_{i \in I_j}\). Alors \(Y_1, \dots, Y_r\) sont mutuellement indépendantes.
La démonstration a deux étapes.
- Les paquets sont mutuellement indépendants. Pour chaque \(j\), soit \(V_j = (X_i)_{i \in I_j}\) le \(n\)-uplet des variables du \(j\)-ième groupe. Fixons une valeur \(v_j\) pour chaque \(V_j\) ; elle prescrit une valeur \(x_i\) pour tout \(i \in I_j\). Comme les \(I_j\) sont disjoints, l'événement \(\{V_1 = v_1, \dots, V_r = v_r\}\) est l'événement \(\{X_i = x_i \text{ pour tout } i \in I_1 \cup \dots \cup I_r\}\). Sa probabilité, par l'indépendance mutuelle de \(X_1, \dots, X_n\) appliquée avec \(A_i = \{x_i\}\) pour \(i \in I_1 \cup \dots \cup I_r\) et \(A_i = X_i(\Omega)\) (contribuant un facteur \(1\)) pour tout autre indice, vaut \(\prod_j \prod_{i \in I_j} \mathbb{P}(X_i = x_i)\). La sous-famille \((X_i)_{i \in I_j}\) est elle-même mutuellement indépendante — en choisissant l'image entière \(X_i(\Omega)\) pour tout indice hors de \(I_j\) dans la formule d'indépendance mutuelle, on y obtient un facteur \(1\) — donc la caractérisation sur les valeurs s'applique à l'intérieur du paquet et \(\prod_{i \in I_j} \mathbb{P}(X_i = x_i) = \mathbb{P}(V_j = v_j)\) ; ainsi le produit est \(\prod_j \mathbb{P}(V_j = v_j)\). Par la caractérisation sur les valeurs, \(V_1, \dots, V_r\) sont mutuellement indépendantes.
- Fonctions des paquets. Chaque \(Y_j\) est une fonction de \(V_j\), \(Y_j = f_j(V_j)\). Fixons des valeurs \(y_1, \dots, y_r\). En décomposant chaque \(\{Y_j = y_j\} = \{V_j \in f_j^{-1}(\{y_j\})\}\) sur les valeurs de \(V_j\) et par l'indépendance mutuelle de \(V_1, \dots, V_r\) établie à la première étape, $$ \mathbb{P}(Y_1 = y_1, \dots, Y_r = y_r) = \sum_{v_1 \in f_1^{-1}(\{y_1\}) \cap V_1(\Omega)} \cdots \sum_{v_r \in f_r^{-1}(\{y_r\}) \cap V_r(\Omega)} \prod_{j=1}^r \mathbb{P}(V_j = v_j). $$ Les termes étant positifs, la somme multiple se factorise en \(\prod_{j=1}^r \bigl(\sum_{v_j} \mathbb{P}(V_j = v_j)\bigr) = \prod_{j=1}^r \mathbb{P}(Y_j = y_j)\). Par la caractérisation sur les valeurs, \(Y_1, \dots, Y_r\) sont mutuellement indépendantes.
Exemple — Regrouper trois en deux
Soient \(X_1, X_2, X_3\) mutuellement indépendantes. Prenons \(I_1 = \{1, 2\}\) et \(I_2 = \{3\}\), avec \(Y_1 = X_1 + X_2\) et \(Y_2 = X_3\). Le lemme des coalitions donne que \(X_1 + X_2\) et \(X_3\) sont indépendantes : une somme construite sur un groupe est indépendante de toute variable d'un groupe disjoint. Méthode — Utiliser l'indépendance mutuelle
Pour établir l'indépendance mutuelle, vérifier l'unique formule produit sur les valeurs. Ne jamais se contenter de vérifications deux à deux — l'exemple de la parité montre que l'indépendance deux à deux ne donne pas l'indépendance mutuelle. Pour traiter une fonction de plusieurs variables indépendantes, découper les indices en groupes disjoints et appliquer le lemme des coalitions : chaque fonction de groupe devient une variable indépendante. Compétences à pratiquer
- Appliquer le lemme des coalitions
II.3
Suites de variables aléatoires i.i.d.
Modéliser une expérience répétée — lancer une pièce encore et encore — demande une suite infinie de variables aléatoires, toutes indépendantes et toutes de même loi. Une telle suite est un objet central de la théorie des probabilités.
Définition — Suite indépendante, suite i.i.d.
Une suite \((X_n)_{n \in \mathbb{N}}\) de variables aléatoires discrètes est indépendante lorsque toute sous-famille finie \(X_{n_1}, \dots, X_{n_k}\) est mutuellement indépendante. C'est une suite de variables aléatoires indépendantes et identiquement distribuées — en abrégé, une suite i.i.d. — lorsqu'elle est indépendante et que toutes les \(X_n\) suivent la même loi. Théorème — Existence d'une suite indépendante
Étant donné une suite \((\mathcal{L}_n)_{n \in \mathbb{N}}\) de lois discrètes sur des ensembles au plus dénombrables, il existe un espace probabilisé et une suite indépendante \((X_n)\) de variables aléatoires discrètes sur celui-ci avec \(X_n \sim \mathcal{L}_n\) pour tout \(n\). Lorsque toutes les \(\mathcal{L}_n\) sont égales, cela produit une suite i.i.d. Ce résultat d'existence est admis : sa démonstration est hors programme.
La construction d'un tel espace probabilisé est délicate ; la démonstration de ce résultat d'existence est hors programme. Le théorème est ce qui autorise, dans toutes les probabilités, la phrase « soit \((X_n)\) une suite i.i.d. de loi \(\mathcal{L}\) ».
Exemple — Le pile ou face infini
En prenant chaque \(\mathcal{L}_n\) égale à la loi de Bernoulli \(\mathcal{B}(p)\), le théorème d'existence fournit une suite i.i.d. \((X_n)\) avec chaque \(X_n \sim \mathcal{B}(p)\) : c'est le modèle d'une suite sans fin de lancers indépendants d'une pièce tombant sur pile avec probabilité \(p\). Exemple — Lancers de dé infinis
En prenant chaque \(\mathcal{L}_n\) égale à la loi uniforme sur \(\{1, \dots, 6\}\), le théorème fournit une suite i.i.d. modélisant une suite sans fin de lancers indépendants d'un dé équilibré. Méthode — Modéliser par une suite i.i.d.
Une expérience répétée à l'identique et de façon indépendante — lancers successifs, tirages successifs avec remise — se modélise par une suite i.i.d. \((X_n)\), \(X_n\) le résultat de la \(n\)-ième épreuve. Le théorème d'existence garantit un espace probabilisé la portant, on peut donc écrire « soit \((X_n)\) i.i.d. de loi \(\mathcal{L}\) » sans construire l'espace.
Une suite i.i.d. est une rangée d'épreuves identiques, indépendantes, disposées le long du temps. 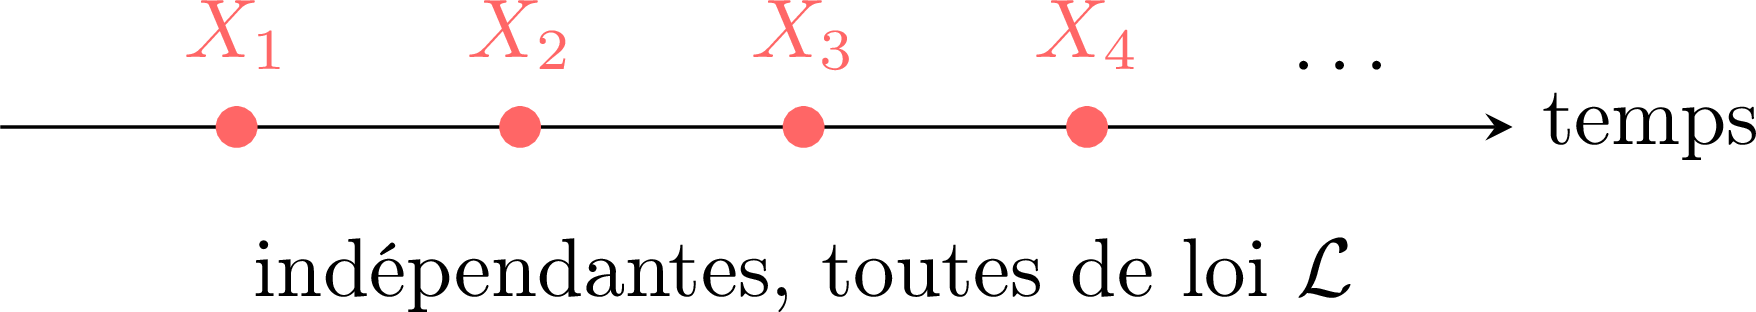
Chaque \(X_n\) suit la même loi \(\mathcal{L}\), et toute sous-famille finie est mutuellement indépendante.
Compétences à pratiquer
- Modéliser par une suite i.i.d.
III
Les lois discrètes usuelles
III.1
La loi géométrique
Rappelons les lois finies usuelles de Variables aléatoires sur un univers fini : la loi uniforme sur un ensemble fini ; la loi de Bernoulli \(\mathcal{B}(p)\), avec \(\mathbb{P}(X = 1) = p\) et \(\mathbb{P}(X = 0) = q\) ; la loi binomiale \(\mathcal{B}(n, p)\), avec \(\mathbb{P}(X = k) = \binom{n}{k} p^k q^{n-k}\). La loi géométrique est la première loi véritablement infinie : le nombre d'épreuves qu'on attend pour un premier succès.
Définition — Loi géométrique
Soit \(p \in {]0, 1[}\) et \(q = 1 - p\). Une variable aléatoire discrète \(X\) suit la loi géométrique de paramètre \(p\), ce qu'on note \(X \sim \mathcal{G}(p)\), lorsque \(X(\Omega) = \mathbb{N}^*\) et $$ \forall k \in \mathbb{N}^*, \qquad \mathbb{P}(X = k) = q^{k-1} p. $$ La série géométrique donne \(\sum_{k \geq 1} q^{k-1} p = \dfrac{p}{1 - q} = 1\), c'est donc bien une distribution de probabilités. Par égalité en loi, toute variable aléatoire discrète ayant cette distribution est dite suivre \(\mathcal{G}(p)\). Proposition — La loi géométrique comme temps d'attente
Soit \(p \in {]0, 1[}\), soit \((X_n)_{n \geq 1}\) une suite i.i.d. de Bernoulli\((p)\), et soit \(T\) le rang du premier succès : \(T = \min\{n \geq 1 : X_n = 1\}\), avec la convention \(\min\varnothing = +\infty\). Alors \(T\) est a priori à valeurs dans \(\mathbb{N}^* \cup \{+\infty\}\), avec \(\mathbb{P}(T = +\infty) = 0\) ; la variable \(\widetilde T\) égale à \(T\) là où \(T\) est fini et à \(1\) sur l'événement négligeable \(\{T = +\infty\}\) est à valeurs dans \(\mathbb{N}^*\), égale à \(T\) presque sûrement, et suit \(\textcolor{colorprop}{\mathcal{G}(p)}\).
Pour \(k \in \mathbb{N}^*\), l'événement \(\{T = k\}\) est « les \(k-1\) premières épreuves échouent et la \(k\)-ième réussit », soit \(\{X_1 = 0, \dots, X_{k-1} = 0, X_k = 1\}\). Par l'indépendance mutuelle de \(X_1, \dots, X_k\), $$ \mathbb{P}(T = k) = \mathbb{P}(X_1 = 0) \cdots \mathbb{P}(X_{k-1} = 0)\,\mathbb{P}(X_k = 1) = q^{k-1} p. $$ Ensuite, \(\{T > n\} = \{X_1 = 0, \dots, X_n = 0\}\) a pour probabilité \(q^n\), et \(\{T = +\infty\} = \bigcap_{n \geq 1}\{T > n\}\) est une intersection décroissante ; par continuité monotone \(\mathbb{P}(T = +\infty) = \lim_n q^n = 0\). Donc \(\widetilde T = T\) sur l'événement \(\{T < +\infty\}\) de probabilité \(1\) — elles sont égales presque sûrement — et \(\widetilde T\) est à valeurs dans \(\mathbb{N}^*\) avec \(\mathbb{P}(\widetilde T = k) = \mathbb{P}(T = k) = q^{k-1} p\), soit \(\widetilde T \sim \mathcal{G}(p)\).
Exemple — Attendre un six
On lance un dé équilibré jusqu'au premier six. Le rang du premier six suit \(\mathcal{G}(\tfrac16)\) : la probabilité qu'il faille exactement \(k\) lancers est \(\bigl(\tfrac56\bigr)^{k-1}\tfrac16\) — \(k - 1\) non-six puis un six. Proposition — Queue de la loi géométrique
Si \(X \sim \mathcal{G}(p)\), alors pour tout \(k \in \mathbb{N}\), $$ \textcolor{colorprop}{\mathbb{P}(X > k) = q^k.} $$
L'événement \(\{X > k\}\) est la réunion disjointe \(\bigsqcup_{n > k}\{X = n\}\), donc la \(\sigma\)-additivité et la série géométrique donnent $$ \mathbb{P}(X > k) = \sum_{n = k+1}^{+\infty} q^{n-1} p = q^k p \sum_{m = 0}^{+\infty} q^m = q^k p \cdot \frac{1}{1 - q} = q^k, $$ où l'on a utilisé le changement d'indice \(m = n - k - 1\).
Proposition — Caractérisation par l'absence de mémoire
Soit \(X\) une variable aléatoire discrète à valeurs dans \(\mathbb{N}^*\) avec \(\mathbb{P}(X > n) > 0\) pour tout \(n\). Alors \(X\) suit une loi géométrique si et seulement si $$ \textcolor{colorprop}{\forall n, k \in \mathbb{N}, \qquad \mathbb{P}(X > n + k \mid X > n) = \mathbb{P}(X > k).} $$ - Si \(X \sim \mathcal{G}(p)\). Par la Proposition sur la queue, \(\mathbb{P}(X > m) = q^m\) pour tout \(m\). Comme \(\{X > n + k\} \subset \{X > n\}\), la probabilité conditionnelle vaut \(\mathbb{P}(X > n + k \mid X > n) = \mathbb{P}(X > n+k)/\mathbb{P}(X > n) = q^{n+k}/q^n = q^k = \mathbb{P}(X > k)\).
- Réciproquement. Posons \(q = \mathbb{P}(X > 1)\). Comme \(X\) est à valeurs dans \(\mathbb{N}^*\), \(\mathbb{P}(X > 0) = 1\). La relation d'absence de mémoire, écrite \(\mathbb{P}(X > n + k) = \mathbb{P}(X > n)\,\mathbb{P}(X > k)\), donne par récurrence sur \(n\) que \(\mathbb{P}(X > n) = q^n\). Les événements \(\{X > n\}\) décroissent, d'intersection vide — aucune valeur de \(X\), qui est à valeurs dans \(\mathbb{N}^*\), ne dépasse tout entier — donc par continuité décroissante \(q^n = \mathbb{P}(X > n) \to 0\), ce qui force \(q < 1\) ; et \(q = \mathbb{P}(X > 1) > 0\) par hypothèse. Alors pour \(k \in \mathbb{N}^*\), $$ \mathbb{P}(X = k) = \mathbb{P}(X > k - 1) - \mathbb{P}(X > k) = q^{k-1} - q^k = q^{k-1}(1 - q), $$ donc \(X \sim \mathcal{G}(1 - q)\).
Exemple — La loi géométrique oublie le passé
Soit \(X \sim \mathcal{G}(\tfrac16)\) le rang du premier six lorsqu'on lance un dé équilibré. Après dix lancers sans six, le nombre de lancers supplémentaires jusqu'au premier six suit encore \(\mathcal{G}(\tfrac16)\), exactement comme au départ : \(\mathbb{P}(X > 10 + k \mid X > 10) = \mathbb{P}(X > k)\). La loi géométrique est sans mémoire — les échecs passés ne changent rien à l'attente à venir. Méthode — Identifier et utiliser la loi géométrique
Un « rang du premier succès » dans une suite d'épreuves indépendantes identiques suit une loi géométrique — la reconnaître à la forme \(\mathbb{P}(X = k) = q^{k-1}p\) sur \(\mathbb{N}^*\). Pour une probabilité de queue, utiliser directement \(\mathbb{P}(X > k) = q^k\). Pour démontrer qu'une variable à valeurs dans \(\mathbb{N}^*\) est géométrique sans calculer sa distribution, il suffit de vérifier l'absence de mémoire.
Les bâtons d'une loi géométrique décroissent en une progression géométrique de raison \(q\). 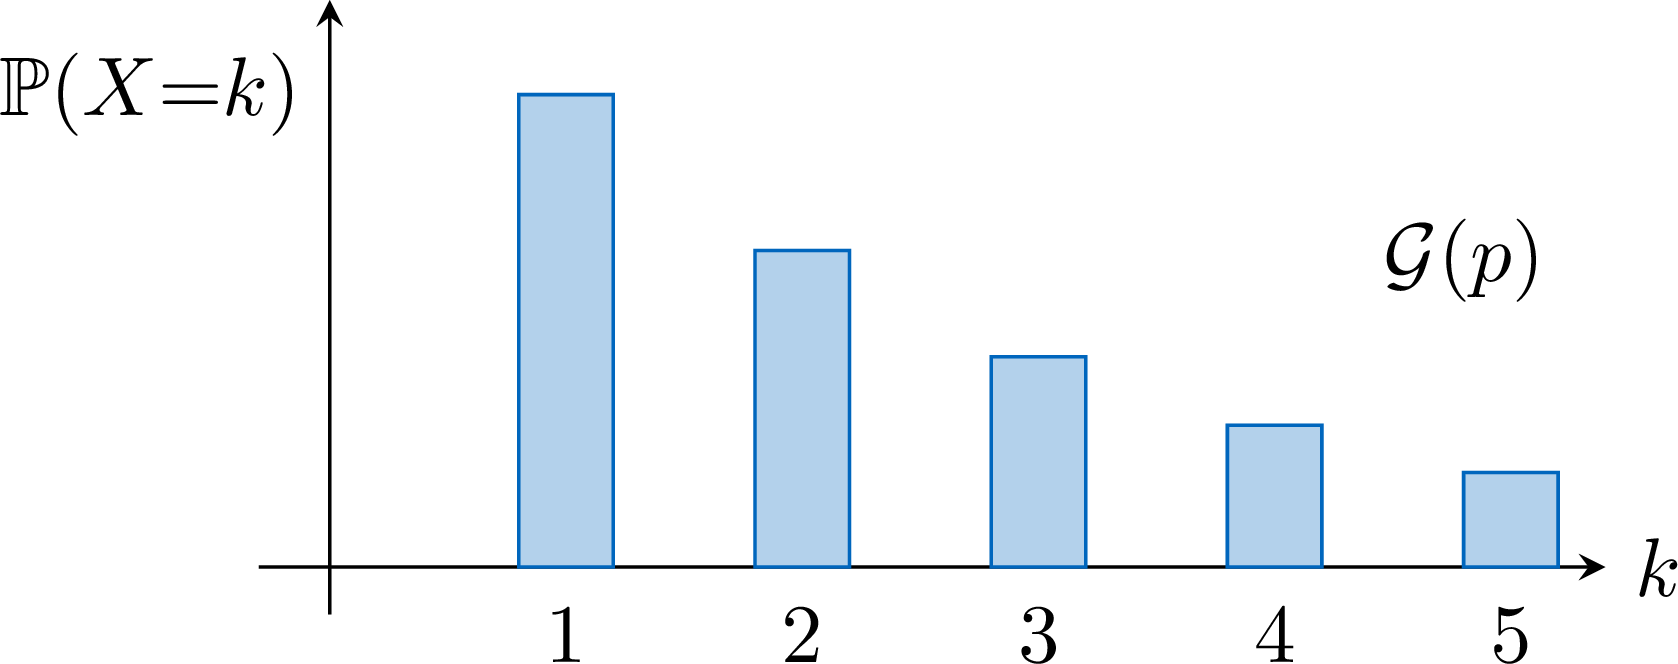
Chaque bâton vaut \(q\) fois le précédent : \(\mathbb{P}(X = k+1) = q\,\mathbb{P}(X = k)\).
Compétences à pratiquer
- Manipuler la loi géométrique
III.2
La loi de Poisson
Contrairement à la binomiale, la loi de Poisson n'est pas introduite à ce niveau par un modèle de dénombrement direct, mais par une limite. Lorsqu'une binomiale \(\mathcal{B}(n, p)\) a beaucoup d'épreuves, chacune rare, sa distribution se fixe sur la loi de Poisson — la loi des événements rares.
Définition — Loi de Poisson
Soit \(\lambda > 0\). Une variable aléatoire discrète \(X\) suit la loi de Poisson de paramètre \(\lambda\), ce qu'on note \(X \sim \mathcal{P}(\lambda)\), lorsque \(X(\Omega) = \mathbb{N}\) et $$ \forall k \in \mathbb{N}, \qquad \mathbb{P}(X = k) = e^{-\lambda}\,\frac{\lambda^k}{k!}. $$ La série exponentielle donne \(\sum_{k \geq 0} e^{-\lambda} \lambda^k / k! = e^{-\lambda} e^{\lambda} = 1\), c'est donc bien une distribution de probabilités. Par égalité en loi, toute variable aléatoire discrète ayant cette distribution est dite suivre \(\mathcal{P}(\lambda)\). Exemple — Un modèle de Poisson
Le nombre d'appels parvenant à un standard en une heure est classiquement modélisé par une loi de Poisson : chacun d'un très grand nombre d'appelants potentiels appelle dans cette heure avec une minuscule probabilité, indépendamment. Le même modèle convient au nombre de coquilles sur une page ou au nombre de particules qu'une source émet en une seconde — beaucoup d'occasions indépendantes, chacune rare. Théorème — La loi de Poisson comme limite de la binomiale
Soient \((X_n)_{n \geq 1}\) des variables aléatoires discrètes avec \(X_n \sim \mathcal{B}(n, p_n)\), \(p_n \in [0, 1]\), et supposons \(n p_n \to \lambda\) avec \(\lambda > 0\). Alors pour tout \(k \in \mathbb{N}\) fixé, $$ \textcolor{colorprop}{\mathbb{P}(X_n = k) \xrightarrow[n \to +\infty]{} e^{-\lambda}\,\frac{\lambda^k}{k!}.} $$
Fixons \(k \in \mathbb{N}\). Comme \(n p_n \to \lambda\) est fini, \(p_n \to 0\) ; donc pour \(n\) grand, \(n \geq k\) et \(p_n < 1\). Pour de tels \(n\), $$ \mathbb{P}(X_n = k) = \binom{n}{k} p_n^k (1 - p_n)^{n-k} = \frac{n(n-1)\cdots(n-k+1)}{k!}\, p_n^k\, (1 - p_n)^{n-k}, $$ le cas \(k = 0\) valant avec le produit vide égal à \(1\). Quand \(n \to +\infty\), le produit \(n(n-1)\cdots(n-k+1) \sim n^k\), donc \(n(n-1)\cdots(n-k+1)\,p_n^k \sim (n p_n)^k \to \lambda^k\). Et \((1 - p_n)^{n-k} = \exp\bigl((n-k)\ln(1 - p_n)\bigr)\) avec \((n-k)\ln(1 - p_n) \sim -(n - k) p_n \sim -n p_n \to -\lambda\), donc \((1 - p_n)^{n-k} \to e^{-\lambda}\). En multipliant les limites, $$ \mathbb{P}(X_n = k) \xrightarrow[n \to +\infty]{} \frac{\lambda^k}{k!}\, e^{-\lambda}. $$
Exemple — Une approximation numérique
Pour \(\mathcal{B}(n, p)\) avec \(n = 100\) et \(p = 0{,}02\), donc \(n p = 2\), la probabilité binomiale d'exactement \(k = 1\) est \(\binom{100}{1}(0{,}02)(0{,}98)^{99} \approx 0{,}2707\), tandis que la valeur de Poisson \(e^{-2} \cdot 2 \approx 0{,}2707\) lui est presque identique. Avec beaucoup d'épreuves, chacune rare, la loi de Poisson \(\mathcal{P}(n p)\) remplace fidèlement \(\mathcal{B}(n, p)\). Méthode — Identifier la loi de Poisson
Un comptage d'occurrences rares indépendantes — appels, coquilles, désintégrations — se modélise par une loi de Poisson ; la reconnaître à la forme \(\mathbb{P}(X = k) = e^{-\lambda}\lambda^k/k!\) sur \(\mathbb{N}\). Lorsqu'une binomiale \(\mathcal{B}(n, p)\) a un grand \(n\) et un petit \(p\), la loi de Poisson \(\mathcal{P}(n p)\) en donne une approximation commode — asymptotique, exacte seulement à la limite, justifiée par le théorème ci-dessus pour chaque \(k\) fixé.
La figure superpose une loi binomiale et sa limite de Poisson : avec \(n\) grand et \(p\) petit, les deux diagrammes en bâtons coïncident presque. 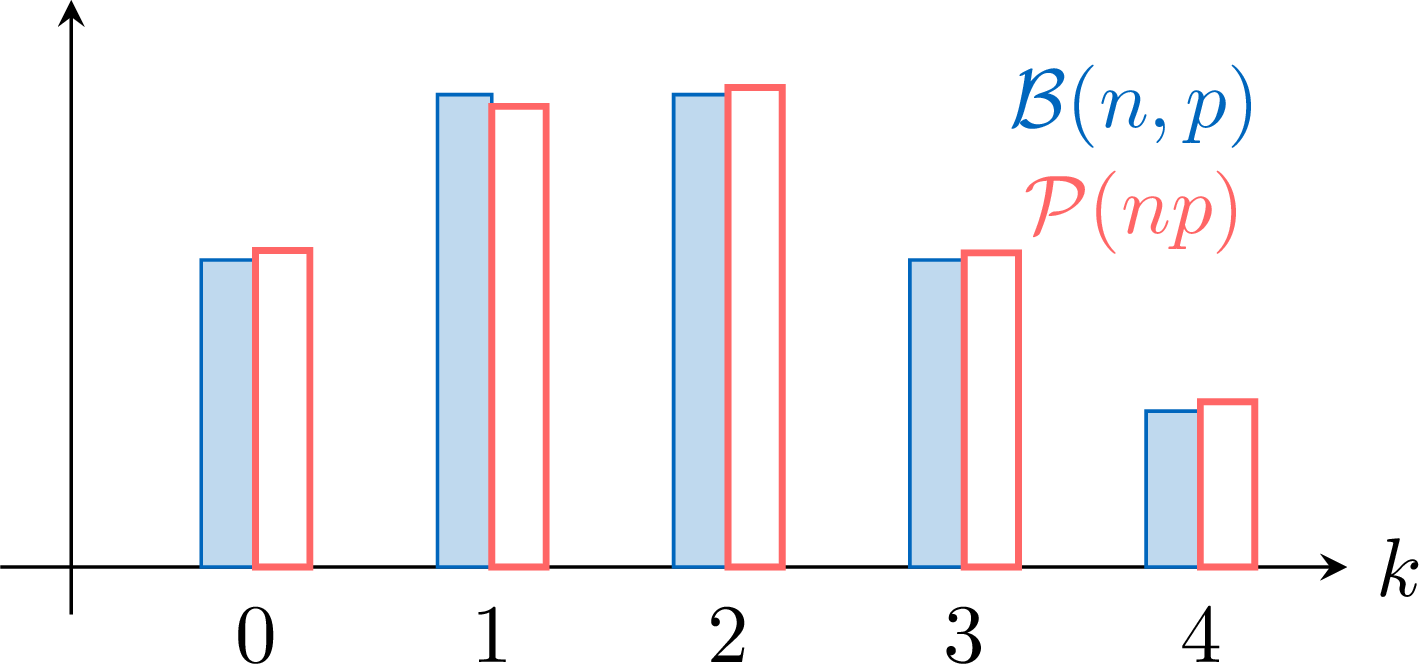
Les bâtons pleins sont \(\mathcal{B}(n, p)\), les bâtons en trait \(\mathcal{P}(n p)\) : pour \(n\) grand et \(p\) petit ils sont presque égaux en tout \(k\).
Pour aller plus loin
Ce chapitre a mis en place la variable aléatoire discrète, sa loi, et la manière dont plusieurs d'entre elles interagissent. Le chapitre suivant attache un unique nombre à une variable aléatoire — son espérance — et en construit la variance, la covariance et la loi des grands nombres, le cœur quantitatif des probabilités.
Compétences à pratiquer
- Identifier la loi de Poisson
IV
Pour aller plus loin
Compétences à pratiquer
- Problèmes de synthèse
Aller à la section